下一代搜索智能体评测基准!美团开源LoHoSearch,用知识图谱校准AI能力认知

过去一年,我们见证了 Search Agent 能力的显著演进。在 BrowseComp 等评测上,顶尖模型准确率从最初的30%区间迅速攀升至90%以上。然而,当基准迅速饱和,其区分模型能力的价值也随之递减。
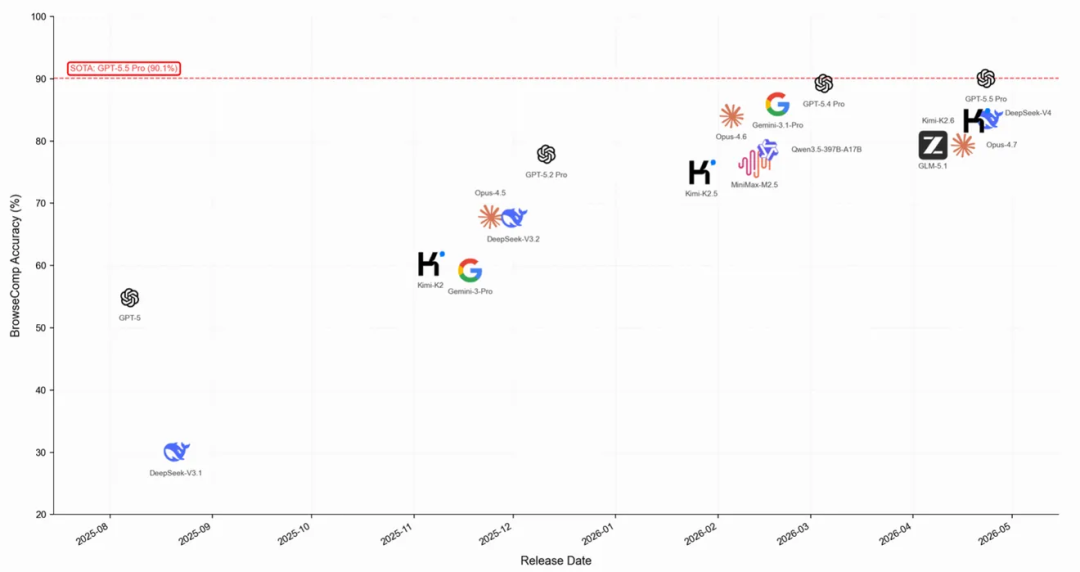
图1:BrowseComp 准确率进展曲线

BrowseComp 的题目由人工设计,局限在于只能基于标注者已知的实体和关系构思,无法站在全局知识网络视角判断:哪些条件真的难检索?哪些约束的候选空间足够大?正是这种局限,让我们开始思考另一种可能性:能不能让机器自己来出题?

美团 LongCat 团队在最新论文中提出的 LoHoSearch 基准,就是把这种可能性变成了现实。

LoHoSearch 的核心"硬核"看点

  • 知识图谱自动化构造。 以覆盖762万维基百科实体的知识图谱为基础自动生成题目,替代人工出题。基准含544道经人工核验的题目,覆盖11个领域。
  • 双维度难度控制。 在生成中系统控制搜索空间与结构复杂度。构建出难度显著高于现有基准的挑战性问题。
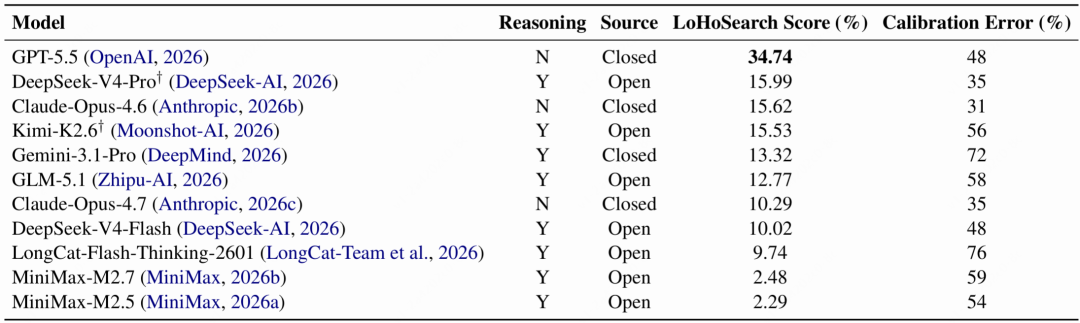
  • 当前模型性能表现。 已评测模型中,GPT-5.5准确率为34.74%;现有上下文管理策略在LoHoSearch上提升幅度为6.8%,低于在BrowseComp上的14.03%。

01 设计原理:让机器出题,需要几部?

机器出题的前提,是让机器拥有全局视野。整个构建流程可以分为四个环节:建图 → 控制难度 → 质量把关 → 数据概览。下面逐一展开。

1.1 建图:搭建知识图谱,让机器获得全局视野

LoHoSearch 的第一步,是从完整的英文维基百科出发搭建一张大规模知识图谱:

  • 762 万个实体(每个维基页面是一个实体节点)
  • 2.65 亿条有向边(页面正文中指向其他维基页面的超链接)
  • 每个实体的类型取自其 Wikidata P31 类别,实体热度用入度来衡量

这张图谱为后续在全局视角下挑选"难题"提供了基础。
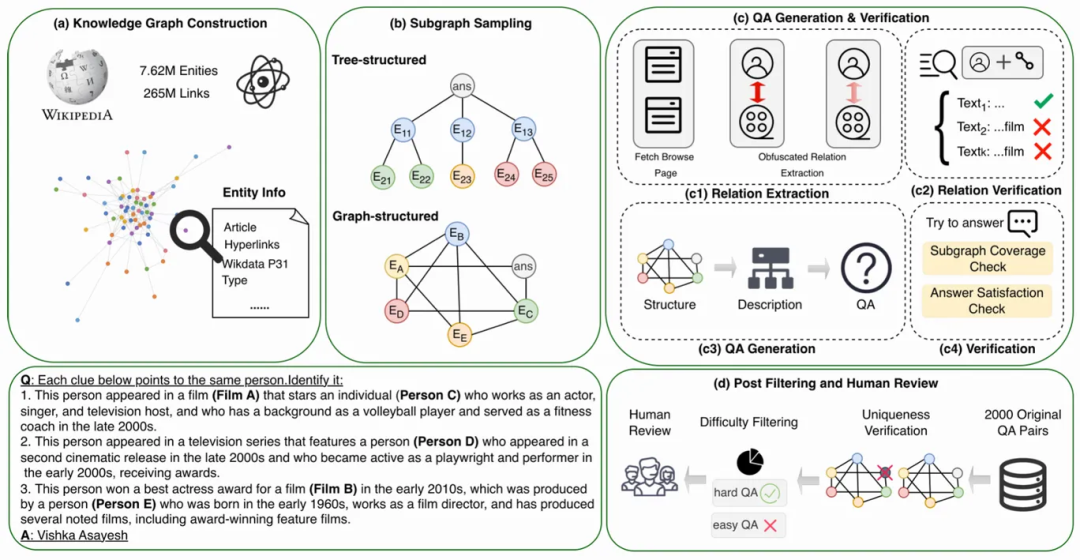
图2:LoHoSearch 数据构造流程总览(知识图谱构建 → 子图采样 → QA 生成与验证 → 后置过滤与人工复核)

有了图谱之后,下一个问题是:什么样的题目才算"难"?LoHoSearch 从两个维度来定义难度。

1.2 控制难度:搜索空间和结构复杂度两个维度

决定搜索难度的核心有两个维度,而它们恰恰是人工出题最难把控的:

  • 搜索空间:满足一个条件的候选实体有多少。候选越多,排除成本越高。
  • 结构复杂度:要同时满足多少条件才能锁定答案。条件越多、咬合越紧,求解链条越长。

针对这两个维度,LoHoSearch 设计了两种子图结构:
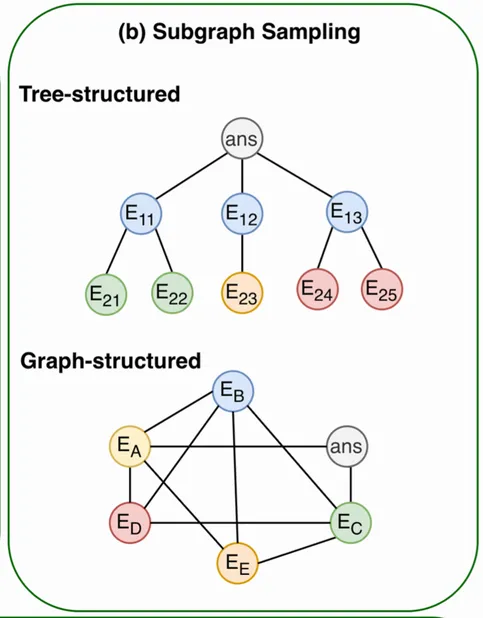
  • 树结构主要通过放大"搜索空间"来制造难度。
  • 图结构则在巨大搜索空间之上,通过引入环形依赖和交叉约束,进一步叠加了"结构复杂度"。

1.3 质量把关:从生成到验证,层层把关

子图采样完成后,还需要转换为可阅读的自然语言题目。整个转换与验证流程分为三层:

  • 题目生成:从子图抽取维基描述,改写为自然语言问题。
  • 自动验证:检查问题是否完整覆盖子图关系,并由搜索智能体验证标准答案满足所有条件。
  • 筛选与复核:排除多答案题和易答题,再由人工审核。

经过三层筛选,自动化流程的整体质量表现如下:75.5% 的题目直接通过人工复核,22.3% 经标注员微调后接受,仅有 2.2% 因严重问题被丢弃。

1.4 数据概览:544道题目,11个主题领域

LoHoSearch 最终收录 544 道 经人工核验的题目。对比树结构和图结构可以看出,图结构子图明显更稠密——节点更多、边数接近前者的两倍,这正对应它更高的结构复杂度。题目内容覆盖音乐、地理与地点、影视、体育等 11 个主题领域。
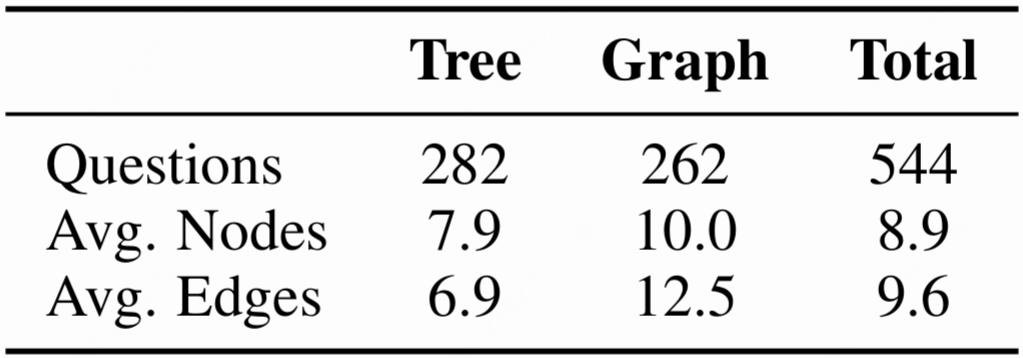
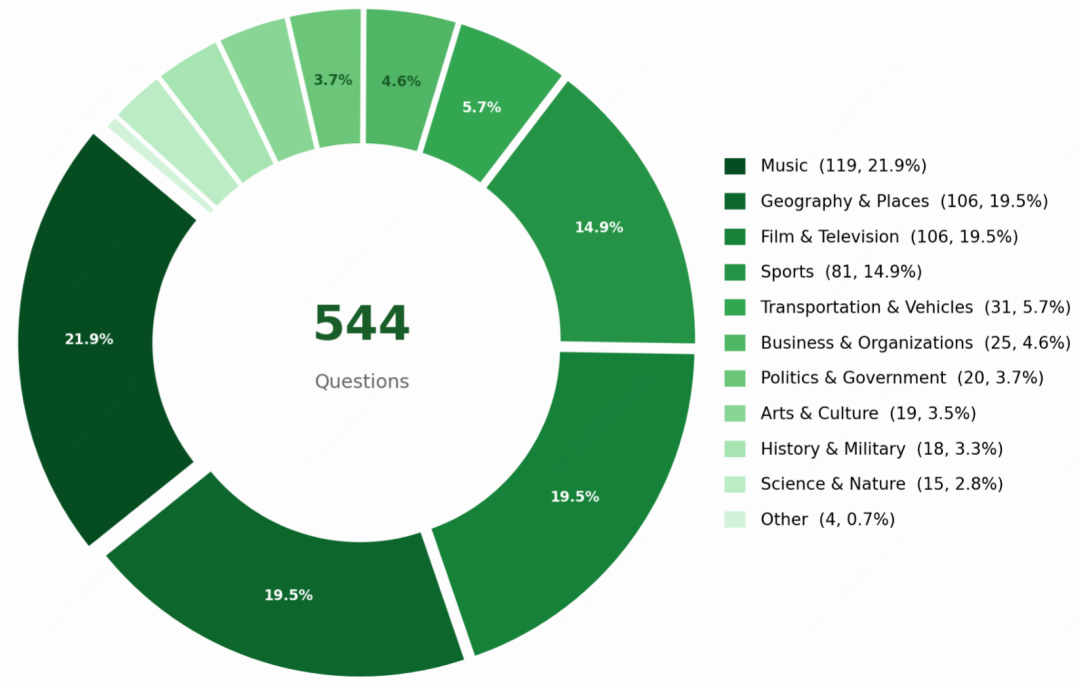
表1:LoHoSearch 数据统计

图3:LoHoSearch 的领域分布

表2:各模型在 LoHoSearch 上的性能表现(%)

最强模型 GPT-5.5 准确率仅 34.74%,DeepSeek-V4-Pro、Claude-Opus-4.6 和 Kimi-K2.6 集中在 15.53%–15.99%,其余模型均低于 14%。这与它们在 BrowseComp 上 80% 以上的表现形成鲜明对照——LoHoSearch 对当前最先进搜索智能体构成了实质挑战。

洞察一:解一道题,平均工具调用从 35 次增至 61 次

用 DeepSeek-V4-Flash 作为探针对比两个基准:同一模型在 BrowseComp 上准确率 58.84%,在 LoHoSearch 上仅 10.02%。
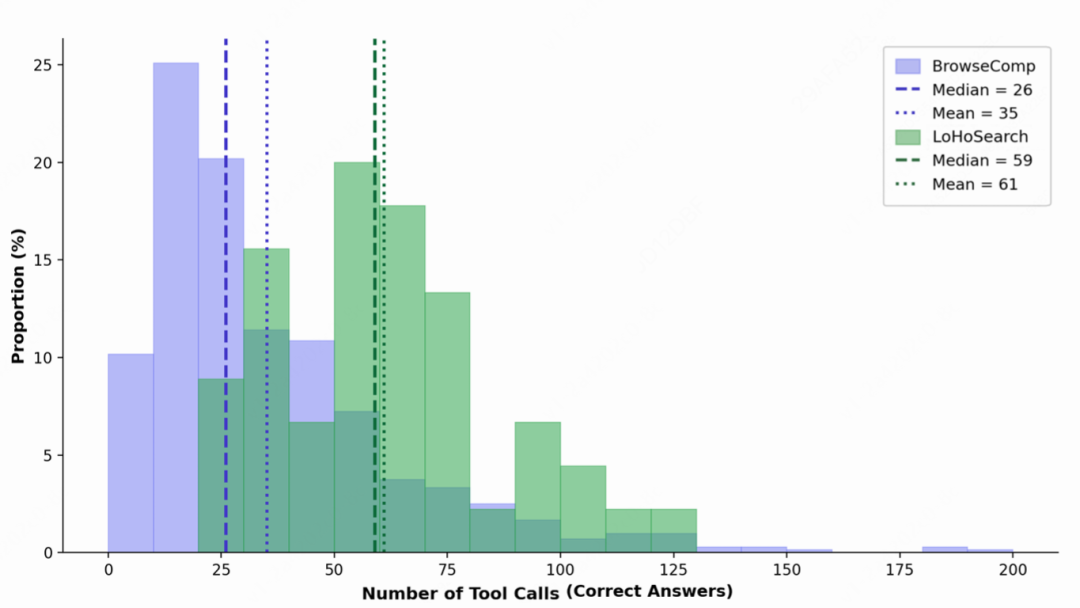
图4:BrowseComp 与 LoHoSearch 正确轨迹的工具调用次数分布

解一道 LoHoSearch 题目,平均工具调用从 35 次增至 61 次(+74%),中位数从 26 次升至 59 次。图结构题目准确率仅 8.01%,远低于树结构的 11.89%,印证了结构复杂度是独立于搜索空间之外的额外难度来源。

洞察二:重复采样收益可观,但天花板依然很低

对 DeepSeek-V4-Flash 采样 16 个独立回答,结果如图 5 所示。
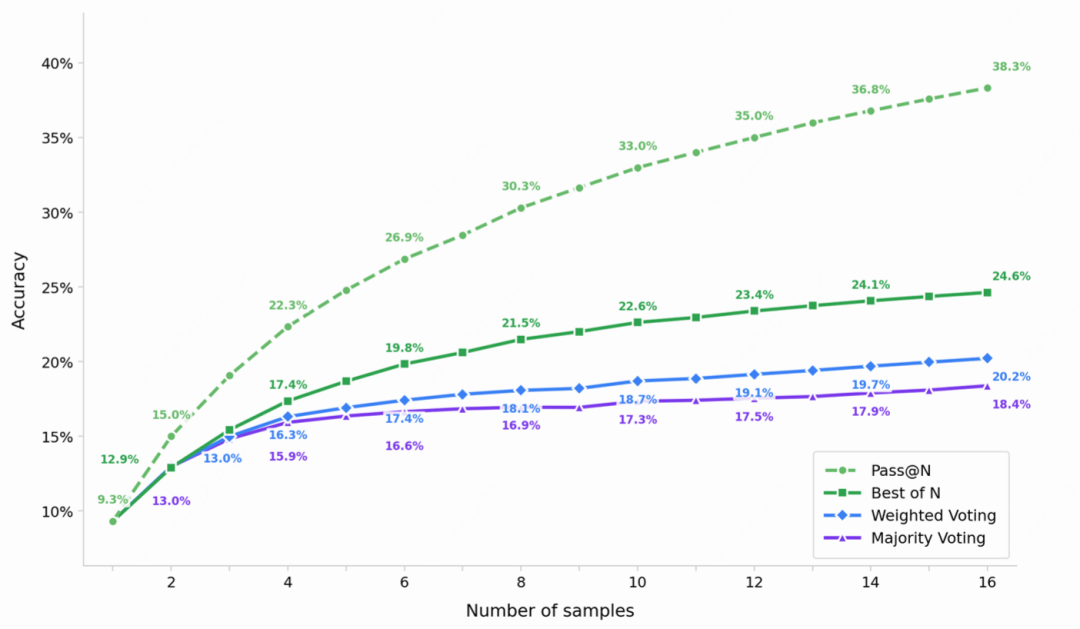
图5:并行采样下 pass@N 及三种答案聚合策略的表现

pass@N 从 N=1 的 9.3% 升至 N=16 的 38.3%,重复采样收益可观,但 38.3% 仍处低位。尝试 16 次仍有六成以上题目无法攻克。三种聚合策略中 best-of-N 表现最优(24.6%),远低于 pass@16 上界,说明模型在答案置信度校准上存在明显不足。

洞察三:现有的上下文管理策略,在这里已失真

以标准 ReAct 为基线,测试 Summary 和 Discard-all 两种策略,并加入 Verify 模块。
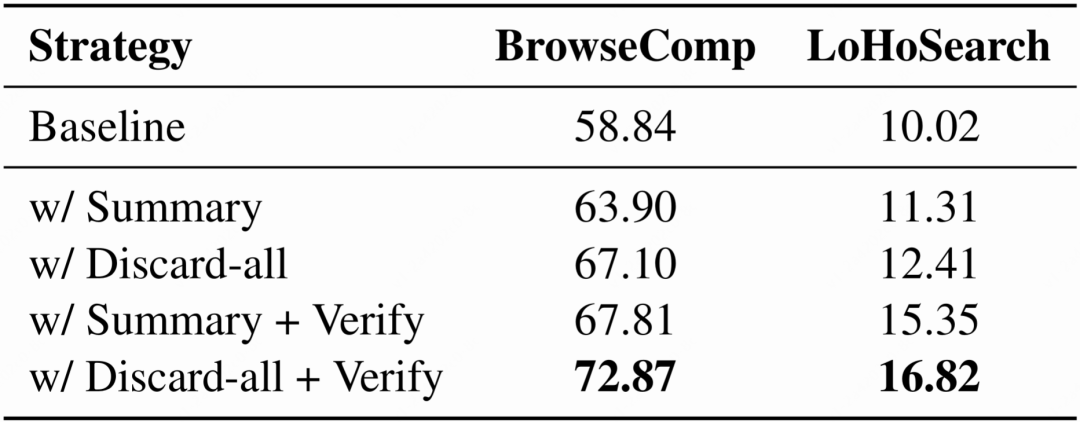
表3:基于 DeepSeek-V4-Flash 的上下文管理策略消融实验

表现最佳的组合(Discard-all + Verify)将成绩从 10.02% 提至 16.82%,绝对提升仅 6.8 个百分点,而同一套策略在 BrowseComp 上可带来 14 个百分点的增益。收益收窄的原因在于 LoHoSearch 需要更长的推理链,简单的轨迹压缩或重启无法解决长程搜索中的信息丢失问题——这使其成为下一代上下文管理技术更有价值的试验场。

洞察四:知识图谱是系统化构造高难度题目不可或缺的基础

对比两个基准中"隐藏实体"的特征可以发现:
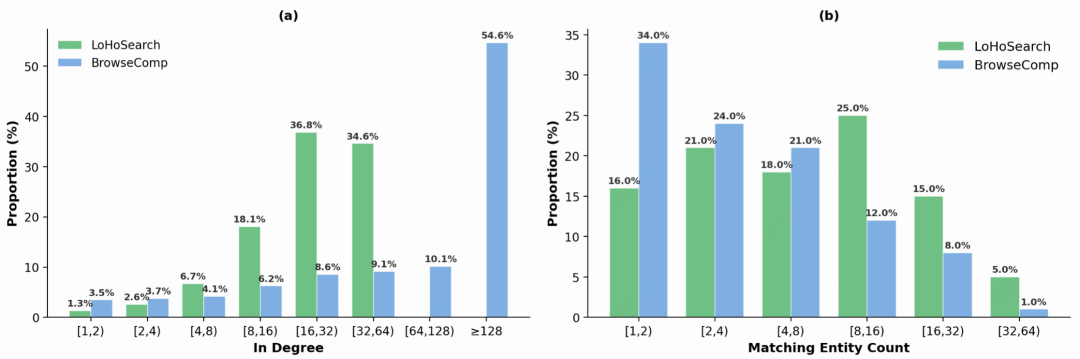
图6:隐藏实体分析(a) 隐藏实体的入度分布;(b) 相同流行度下关系搜索空间对比

其一,BrowseComp 的隐藏实体流行度明显更高,人工出题难以精确控制实体知名度,导致实体偏易。

其二,即便将流行度控制在同一水平,LoHoSearch 的关系搜索空间仍显著更大,实体推断难度远高于 BrowseComp。

这说明人工构建存在系统性局限,知识图谱是系统化构造高难度题目不可或缺的基础。

02 总结:为下一代智能搜索提供新标尺

LoHoSearch 的价值体现在三项具体贡献上:

  • 基于知识图谱的自动化构造流程。 以覆盖762万实体的知识图谱为基础自动生成题目,系统控制搜索空间与结构复杂度,突破人工出题的难度上限。
  • 更具区分度的评测标准。 最强模型 GPT-5.5 准确率仅 34.74%,正确轨迹所需工具调用次数是 BrowseComp 的 1.7 倍。LoHoSearch 为搜索智能体建立了更具区分度的评测标尺。
  • 面向上下文管理研究的挑战性平台。 最优策略仅带来 6.8% 的提升,远低于其在 BrowseComp 上 14.03% 的增益,表明 LoHoSearch 可成为推动下一代上下文管理技术研究的理想试验场。

LoHoSearch 已全面开源,欢迎各大模型前来接受"长程搜索"大考。

开源链接

| 本文系美团技术团队出品,著作权归属美团。欢迎出于分享和交流等非商业目的转载或使用本文内容,敬请注明“内容转载自美团技术团队”。本文未经许可,不得进行商业性转载或者使用。任何商用行为,请发送邮件至 tech@meituan.com 申请授权。

相关推荐

美团 LongCat-2.5 开源:从看见,到抵达

美团正式开源 LongCat-2.5,采用MIT协议,支持商用推理部署与二次训练,无需额外授权。

美团技术团队 291

美团正式发布 LongCat-2.5:面向智能体任务的原生多模态模型

美团正式发布 LongCat-2.5,这是一个面向长程智能体任务的原生多模态模型。模型总参数量为 1.6 万亿,每个 token 激活约 480 亿参数,在 LongCat-2.0 的基础上进一步强化了原生视觉理解与智能体编程能力。

美团技术团队 2490

如何在“不能出错”的系统里使用 AI Coding?分布式存储实践与边界

AI 能让代码写得更快,但在「不能出错」的分布式存储系统里,如何确保提效不变成风险?本文结合美团基础技术部在 AI 评审、问题排查和自动化开发中的真实实践,分享 AI 能帮上什么忙、容易在哪些地方犯错,以及哪些地方仍需要人来把关。比「多写代码」更重要的,是让代码和结论经得起验证。希望这些经验能为复杂系统中的 AI 应用提供参考,在享受效率提升的同时,守住质量与稳定性的底线。

美团技术团队 353

从 LOOP 到图探索 —— 算法模型的 AutoResearch 自进化系统架构演进之路

算法工程师的一天是“改代码—提交训练—等待—看日志—决定下一步”,过程中还经常被打断。我们团队从 Karpathy 的 AutoResearch 出发,经过三次架构重构,搭建出一套可在企业云端训练平台使用的算法研究自进化系统。本文分享这套系统的设计理念、架构演进与可信度设计,希望对大家有所帮助或启发。

美团技术团队 484

SLM 生成式高并发推理引擎:延迟约束下的有效吞吐优化

本文为SLM(Small Language Model, 小参数量语言模型0.5~1B)在搜推场景的大规模落地提供了一套高性能、可复用的工程实践。

美团技术团队 577

MTFM:美团统一推荐基座大模型在外卖多业务场景的落地实践

美团在 MTGR 基础上提出统一推荐基座大模型 MTFM,首次实现外卖多个主要业务的统一精排模型。围绕规模可扩展性、场景可延展性与架构高效性三大挑战,MTFM以异构 Tokenizer 与动态掩码实现多场景特征免对齐,通过混合注意力与 Target Scale-Up 提升模型 Scaling 能力,借鉴 LLM 优化实践提升深层网络训练效果,并以 User-Level 训练范式与定制算子保证系统开销可控。美团外卖多个业务订单量提升 2.06%~6.68% 不等,推理成本降低 24%。

美团技术团队 714

《Agent 评测白皮书》系列01:Agent 评测全览

我们推出了《Agent评测白皮书》系列博客,体系化地为大家讲解评测的落地指南,分为《评测全览》、《冷启动篇》、《扩量篇》、《自进化篇》等共4篇,本文为系列的第一篇。

美团技术团队 681

美团智播——数字人直播技术创新与实践

美团智播,是面向本地生活场景的AI数字人直播解决方案,融合大模型、数字人与多模态交互技术,提供丰富的行业专属数字人形象,支持真人1:1复刻与门店实景定制,30秒生成直播素材,3分钟完成开播配置,7×24小时稳定上播。过去一年,依托生成式AI技术,数字人直播月日均GTV同比增长82.12%,月日均观看人次同比增长163.44%,开播场次提升11倍,充分验证了AI数字人直播在本地生活商业闭环中的实际价值。

美团技术团队 919

GeoRA: 为RLVR设计的LoRA——ACL 2026杰出论文解析

本文介绍了一种专为 RLVR 设计的低秩训练方法,以及它在业务 Agentic RL 中的落地经验。

美团技术团队 691

美团搜索3.0:LLM 语义表征在排序模型的探索与应用

美团搜索团队正依托团垂融合新架构与生成式大模型新技术,全面重构本地生活搜索底座。本系列技术博客将持续介绍美团搜索 3.0 的技术探索,本文聚焦 LLM 语义表征在服务零售排序场景上的三期实践——从单点特征验证到系统性表征体系构建,再到跨场景迁移复用,探索语义匹配信号在搜索排序中的应用路径。

美团技术团队 924

KDD‘26 美团学术论文精选及KDD Cup‘26 DataAgents赛道冠军思路解读

本文精选了美团技术团队被 KDD 2026 收录的 8 篇论文进行分享,这些论文覆盖了推荐大模型、生成与奖励建模框架、智能体搜索、Transformer 框架、元泛化框架等技术领域。

美团技术团队 966

Agent评测漫谈 —— 由浅入深讲解Agent评测

本篇博客是一篇科普文章,由浅入深的介绍Agent评测。其中前两章系统介绍了评测是什么,以及如何建立评测体系;其中第二章是美团图灵Agent评测团队深入美团各业务团队BP总结出的实践经验,是我们在两年实践过程中逐步打磨出来的认知。第三章重点介绍了龙虾/爱马仕这类长程Agent框架的出现对评测带来的变化。

美团技术团队 1081

美团正式发布 CatPaw:全场景 AI Agent,从个人提效到企业智能化

搭载 LongCat 2.0 的美团全场景 AI Agent 平台 CatPaw 正式上线,将模型能力从“跑得动”推向“用得好”。CatPaw 提供开箱即用的 AI 智能工作台与企业级 Agent 开发托管能力。

美团技术团队 1020

让AI离开温室,走向动态世界:MineExplorer揭示顶级多模态大模型被忽视的能力断层

美团 LongCat 团队构建了MineExplorer——首个在开放世界中做到分钟级长程任务的评测基准,系统性地评测多模态大模型在需要长程规划、并包含隐藏前置条件的任务中的真实能力。

美团技术团队 868

直播回放·含 ACL‘26 杰出论文 | 美团 AI 顶会论文 32 篇精讲

2026 年,美团技术团队数十篇论文被 ACL、SIGIR、ICML、KDD 等顶会收录。我们精选 32 篇,进行了 5 大专场直播。

美团技术团队 899

正式开源!美团 LongCat-2.0 同步开放国产卡推理代码

美团 LongCat-2.0 总参数 1.6T,平均激活约 48B,为真实的 Agentic Coding 任务而生,架构上创新性引入 LongCat 稀疏注意力和 N-gram Embedding,提升长上下文处理效率与 Token 级表示能力的同时,结合动态激活进一步强化了代码理解、生成以及执行的表现。

美团技术团队 864

美团 LongCat-2.0 正式发布:在国产算力集群上完成全流程训练与推理的万亿参数模型

6月30日,美团正式发布新一代万亿参数大模型 LongCat-2.0,并将对外开源。

美团技术团队 1213

LongCat 开源 VitaBench 2.0:长期动态智能体基准新标杆

VitaBench 2.0 是首个真实生活场景下面向长期动态用户建模的智能体评测基准,它系统性地评测大语言模型在长期、真实、动态的用户互动中个性化与主动性的能力

美团技术团队 1117

ICML 2026 | 美团技术团队学术论文精选

ICML(International Conference on Machine Learning,国际机器学习大会)是机器学习领域最具影响力的国际顶级学术会议之一。

美团技术团队 850

美团海报生成 AIGC 技术创新与实践

美团智能创作团队围绕海报生成 AIGC 构建了完整技术体系,打造「生成-编辑-评判」技术闭环,目前已在美团外卖、品牌 IP 等场景落地,已全部开源。

美团技术团队 2060

从月球漫步到赛博都市,WBench 测出了世界模型的边界

美团 LongCat 团队提出了 WBench,它是首个面向交互式视频世界模型的系统性多轮评测基准。它就像一台“CT扫描仪”,能精准定位当前世界模型在从“被动观看”到“主动交互”的过程中,到底卡在了哪里。

美团技术团队 1243

报名|ACL‘26 美团中稿精选:从能力评测到推理优化,构建生成新范式

本文分享了美团技术团队被 ACL 顶会收录的其中 6 篇论文,技术方向覆盖大模型评测、复杂流程推理、竞赛级数学思维优化、强化学习优化、生成式推荐等领域。

美团技术团队 1516

从高拟真到真可用,LongCat-Video-Avatar 1.5 正式开源

LongCat-Video-Avatar 1.5 即便在复杂商业场景里,也能稳定、自然地输出高质量内容,让数字人视频生成从彩排室的完美演练,走向千人千面的真实舞台。

美团技术团队 1590

美团跑腿 Skill:一句话,骑手来帮忙

美团跑腿 Skill 支持所有 Claw 客户端,包括 OpenClaw 本地版、火山引擎等云部署版、QClaw 等第三方客户端。

美团技术团队 1859

美团 LongCat 开源 General 365:树立推理评测新标尺

General 365 将推理评测从专业知识依赖中剥离出来,让我们直观地看到了大模型在真实世界的通用推理任务上的短板。

美团技术团队 2083

用Agent评测思路管理AI Coding —— 31万行代码AI重构的实践

当团队 90% 以上的代码由 AI 生成,31 万行的复杂业务系统还在高速膨胀,你会发现一个反直觉的事实:AI Coding 不会自动收敛复杂度 —— 没有统一规范的约束,不同人用 AI 写出的代码风格各异,系统反而会加速腐化。本文记录了我们如何在不停止业务交付的前提下,完成这场重构。

美团技术团队 2428

LARYBench 发布:定义具身动作表征 ImageNet,首次度量从人类视频学习的泛化表征

LARYBench (Latent Action Representation Yielding Benchmark),一个指引从大规模的视觉数据学习到通用的隐式动作表征的系统化评测基准。实验结果表明:在动作泛化和控制精度上,通用视觉模型的表现均显著优于专门为具身智能设计的动作专家模型,具身动作表征可以从大规模人类视频数据中涌现。

美团技术团队 2201

突破零样本TTS音色克隆上限:LongCat-AudioDiT 的声音克隆艺术

能不能让 AI 直接学会声音本身的规律,跳过中间环节?为破解这一技术瓶颈,美团 LongCat 团队正式发布 LongCat-AudioDiT。在该模型中,我们彻底抛弃梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音(Text-to-Speech, TTS),从根源阻断数据转换的级联误差。

美团技术团队 1600

LongCat-Flash-Prover:AI 攻克数学定理证明,不仅要“算得对”,更要“证得严”

如何让 AI 从“猜答案”走向“严谨证明”,成为复杂推理具有挑战的课题。我们开源了专门用于数学形式化与定理证明的模型 —— LongCat-Flash-Prover。

美团技术团队 1802

美团发布原生多模态 LongCat-Next:当视觉和语音成为AI的母语

LongCat-Next 是我们在通往物理世界 AI 道路上的一次探索。我们把研究思路的核心——LongCat-Next 模型和它的离散分词器全部开源,希望更多开发者能基于它,构建真正能感知、理解并作用于真实世界的AI。

美团技术团队 2131
上一篇: 直播回放·含 ACL‘26 杰出论文 | 美团 AI 顶会论文 32 篇精讲
下一篇: 让AI离开温室,走向动态世界:MineExplorer揭示顶级多模态大模型被忽视的能力断层
美团技术团队
美团技术团队 企业官方账号 企业官方账号
博客等级 码龄10年 3万+粉丝 754原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值