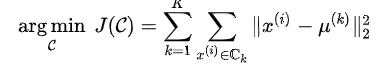常见的面试问题———机器学习篇(持续更新)

机器学习面试准备(持续更新)--- 优秀博文传送门,收集优秀资源 优秀博文传送门,收集优秀资源 阅读详情
  1. SVM 和 LR 的区别和联系  当面试官问LR与SVM的问题时,他们会问些什么_Matrix_cc的博客-优快云博客
  2. SVM推导,及使用对偶的原因,SVM 核函数选择 SVM 高频面试题 - 知乎
  3. svm 对缺失数据敏感吗,为什么,决策树呢。
  4. 决策树是如何处理缺失数据的。决策树是如何处理不完整数据的? - 知乎
  5. svm 如何处理多分类
  6. 为什么 svm 采用最大间隔。答:鲁棒,对未知数据泛化更好
  7. svm 选取样本问题,如何增加样本点。
  8. 什么时候选择 svm 算法,什么时候选择决策树算法。答: svm 更适合处理特征多的样本。 而决策树处理特征多的样本时容易发生过拟合。
  9.  贝叶斯是线性分类器吗
  10. LR 可不可以做非线性分类,如何理解线性模型中的线性:LR本身是个线性模型,虽然加上了sigmoid函数,但是它的分类平面是线性的,可以做非线性分类,需要做一个非线性映射 逻辑斯蒂回归能否解决非线性分类问题? - 辛俊波的回答 - 知乎
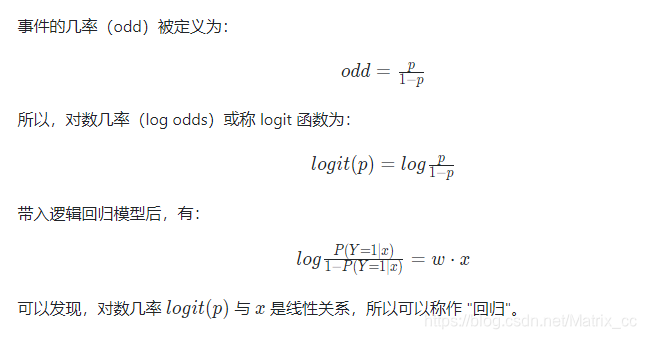
  11. 逻辑斯特回归是分类模型,为什么叫回归:
  12. LR可不可以用MSE作为损失函数?为什么 不可以,原因
  13. LR怎么解决过拟合?1、减少特征的数量:1)手动选择需要保留的数据   2) 使用模型选择的算法  2、正规化:保留所有特征,但是减小参数θ 的大小。
  14. 比较 LR 和 GBDT,什么情景下 GBDT 不如 LR 
  15. LR的特征为什么要离散化?1、计算简单  2、简化模型  3、增强模型的泛化能力,不易受噪声的影响
  16. 1. 比较 LR 和 GBDT:(1) LR 是一种线性模型,而 GBDT 是一种非线性的树模型,因此通常为了增强模型的非线性表达能力,使用 LR 模型之前会有非常繁重的特征工程任务;(2) LR 是单模型,而 GBDT 是集成模型,通常来说,在数据低噪的情况下,GBDT 的效果都会优于 LR;(3) LR 采用梯度下降方法进行训练,需要对特征进行归一化操作,而 GBDT 在训练的过程中基于 gini 系数选择特征,计算最优的特征值切分点,可以不用做特征归一化。
  17. 2.GBDT 不如 LR 的地方:
  18. 一方面,当需要对模型进行解释的时候,GBDT 显然会比 LR 更加 “黑盒”,因为我们不可能去解释每一棵树。相比之下。LR 的特征权重能够很直观地反映出特征对不同类样本的贡献程度,也正因为如此好理解,很多时候我们可以根据 LR 模型得到的分析结论做出更有说服力的营销和运营策略;另一方面,LR 模型的大规模并行训练已经非常成熟,模型迭代速度很快,业务人员可以很快得到模型的反馈,并对模型进行针对性的修正。而 GBDT 这样的串行集成方式让它的并行十分困难,在大数据规模下训练速度十分缓慢。
  19. bagging 和 boosting 的区别  答案
  20. 偏差小,方差大说明什么?说明是过拟合,需要降低模型复杂度。反之呢?欠拟合,需要增加模型复杂度。
  21. 有哪些算法需要进行归一化?机器学习算法在什么情况下需要归一化?_Running_you-优快云博客_什么时候需要归一化
  22. 决策树,GBDT,随机森林的区别
  23. 介绍一下 xgboost,xgboost 和 GBDT 的区别,优缺点  XGBoost 原理 及 常见面试题 - 知乎机器学习算法中 GBDT 和 XGBOOST 的区别有哪些? - 知乎
  24. XGBoost是怎么选择最佳分裂点的?决策树和GBDT呢?1)XGBoost是使用贪心算法来分裂,两个 for 循环,第一个 for 遍历所有特征,第二个 for 找出最佳的特征值作为分裂点选分裂点的依据 score 为分裂前后损失函数的减少量,根据每次分裂后产生的增益,最终选择增益最大的那个特征的特征值作为最佳分裂点。分裂后两侧的值相加或减去分裂前的值  2)决策树是使用Gini系数来进行划分。3)GBDT是使用回归树,回归树的划分方法是对于任意划分特征 A,对应的任意划分点 s 两边划分成的数据集 D1 和 D2,求出使 D1 和 D2 各自集合的平方损失最小,同时 D1 和 D2 的平方损失之和最小所对应的特征和特征值划分点。
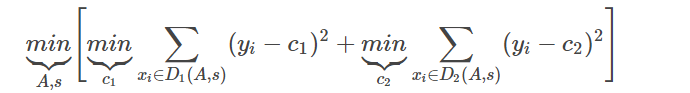
  25. XGBoost怎么处理缺失值?1)在某列特征上寻找分裂节点时,不会对缺失的样本进行遍历,只会对非缺失样本上的特征值进行遍历,这样减少了为稀疏离散特征寻找分裂节点的时间开销。2)另外,为了保证完备性,对于含有缺失值的样本,会分别把它分配到左叶子节点和右叶子节点,然后再选择分裂后增益最大的那个方向,作为预测时特征值缺失样本的默认分支方向。3)如果训练集中没有缺失值,但是测试集中有,那么默认将缺失值划分到右叶子节点方向。
  26. XGBoost怎么并行的?树的生成是并行的吗?
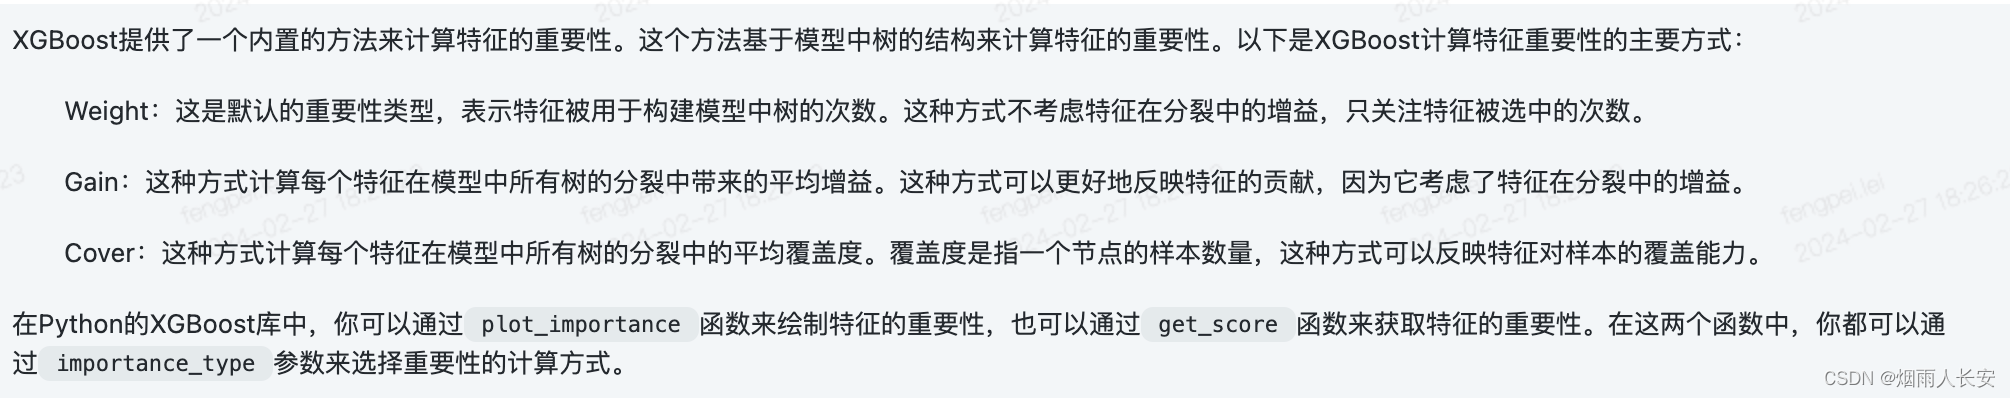
  27. Xgboost的特征重要性是怎么做的?
  28. GBDT为什么使用回归树,为啥不用分类树? 原因是 GBDT 每次拟合的都是梯度值(连续值),因此要使用回归树
  29. 如何判断分类器的好坏(分类器的评价指标)
  30. 介绍 Kmeans 算法,Kmeans是否收敛?为什么能收敛?K-Means 优化的目标是每个样本离其所属类中心点的距离平方和,,在每一步迭代过程中分为两个步骤:更新中心点以及更新样本的所属类。这两个步骤都会使目标函数减小。因此一定会收敛。也可以把 K-Means 看做 EM 算法的特例,EM 算法是可以保证收敛的。
  31. 样本不均衡的处理方法:权重调整,采样(过采样和欠采样),SMOTE方法(合成新的少数类样本,合成的策略是对每个少数类样本a,从它的最近邻中随机选一个样本b,然后在a、b之间的连线上随机选一点作为新合成的少数类样本,过采样:SMOTE算法_YJ语的博客-优快云博客_smote算法),对样本不均衡不敏感的指标(F1),focal_loss: focal loss 的两个性质算是核心,其实就是用一个合适的函数去度量难分类和易分类样本对总的损失的贡献。 增加一个调节因子降低易分类样本权重,聚焦于困难样本的训练
  32. EM 算法
  33. 精确率,准确率,召回率和ROC、AUC  准确率、精确率、召回率、F1值、ROC/AUC整理笔记_学习容易上瘾-优快云博客_准确率 召回率
  34. PR曲线 【机器学习】一文读懂分类算法常用评价指标 | 郭耀华's Blog
  35. AUC原理和计算方法 AUC的计算方法_SCUT_Sam-优快云博客_auc计算公式
  36. AUC的物理意义:任取一对(正、负)样本,正样本的 score 大于负样本的 score 的概率,代码实现AUC  AUC代码实现
  37. 贝叶斯和朴素贝叶斯的区别
  38. 分类树和回归树的区别
  39. 决策树的原理
  40. 什么是生产模型和判别模型
  41. PCA和LDA两者的区别   机器学习(十六)— LDA和PCA降维 - 深度机器学习 - 博客园
  42. 目标函数,损失函数,代价函数之间的区别?
  43. 目标函数是最终需要优化的函数,其中包括经验损失和结构损失。
  44. obj=loss+Ω
  45. 经验损失 (loss) 就是传说中的损失函数或者代价函数。结构损失 (Ω) 就是正则项之类的来控制模型复杂程度的函数。
  46. 什么算法需要归一化,什么不用?归一化的作用是什么?面试题总结(2)——机器学习哪些算法需要归一化_u014535528的博客-优快云博客
  47. 多分类和多标签的区别,多分类和多标签的损失函数一般怎么选择?
  48. KL散度与交叉熵的区别  KL散度与交叉熵区别与联系_Dby_freedom的博客-优快云博客_kl散度和交叉熵的区别
  49. 为什么要做特征归一化/标准化?为什么要做特征归一化/标准化? - shine-lee - 博客园
机器学习_八股 这里称J(a,b)为损失函数,明显可以看出它是个二次函数,即凸函数,所以有最小值。当J(a,b)取最小值的时候,f(x)和y的差异最小,然后我们可以通过J(a,b)取最小值来确定a和b的值。 阅读详情

相关推荐

【4】机器学习算法面试八股

通过对训练数据样本以及属性进行有放回的抽样(针对某一个属性随机选择样本)这里有两种,一种是每次都是有放回的采样,有些样本是重复的,组成和原始数据集样本个数一样的数据集;另外一种是不放回的抽样,抽取出大约60%的训练信息。由此生成一颗CART树,剩下的样本信息作为袋外数据,用来当作验证集计算袋外误差测试模型;把抽取出的样本信息再放回到原数据集中,再重新抽取一组训练信息,再以此训练数据集生成一颗CART树。这样依次生成多颗CART树,多颗树组成森林,并且他们的生成都是通过随机采样的训练数据生成,因此叫随机森林。

weixin_44125042的博客 888

51 个基本的机器学习面试问题和答案

介绍机器学习相关的面试题与答案

m0_51118916的博客 1万+

【8】机器学习算法面试八股

python生成器是一个返回可以迭代对象的函数,可以被用作控制循环的迭代行为。生成器类似于返回值为数组的一个函数,这个函数可以接受参数,可以被调用,一般的函数会返回包括所有数值的数组,生成器一次只能返回一个值,这样消耗的内存将会大大减小。使用了 yield 的函数被称为生成器(generator)调用一个生成器函数,返回的是一个迭代器对象。

weixin_44125042的博客 549

机器学习面试-常见题目

机器学习常见面试问题汇总

weixin_39982225的博客 5570

深度学习和机器学习面试常见问题集锦

如何解决梯度消失和梯度爆炸的问题? 问题类型 问题定义 解决措施 梯度消失 根据链式法则,如果每一层神经元对上一层的输出的偏导乘上权重的结果都小于1的话,那么即使这个结果是0.99,在经过足够多层传播之后,误差对输入层的偏导会趋于0. 使用Relu和batch normalization以及循环神经网络里面的LSTM和GRU都可以解决这个问题 梯度爆炸 根据链式法则,如果每...

Peter清风 406

CV面试题(持续更新!!!)

CV面试题 1、反卷积 反卷积又叫做转置卷积,在计算机中计算的时候,转置卷积先将卷积核转为稀疏矩阵C的形式,然后计算的时候正向传播的时候左乘这个稀疏矩阵C的转置,反向传播的时候左乘这个稀疏矩阵C。 一般的卷积运算可以看成是一个其中非零元素为权重的稀疏矩阵C与输入的图像进行矩阵相乘,反向传播时的运算实质为C的转置与loss对输出y的导数矩阵的矩阵相乘 反卷积的运算过程与卷积正好相反,是正向传播时左乘...

justsolow的博客 2万+

常见的机器学习面试问题(持续更新中)

卷及神经网络中的权值共享 输入层和隐层之间若按照全连接方式去连接,权值w的维数太大,为了减少权值w的维数,可以采用隐层的每个神经元与输入层中的10*10个神经元相连,这样就大大减少了w的维数。进一步,如果我们让隐层每个神经元对用的10*10的权重w都相同,那么最后我们的权重w就只有10*10,但是这样子做未免也太粗糙了,提取的特征肯定很少,在此基础上,可以多加几个10*10大小的w就可以了,比如...

hywel_xue的博客 1605

语音识别方向秋招面试记录(持续更新)

面试记录 LSTM+BPTT 1次 (字节跳动 AI-Lab语音识别实习;) CTC 1 次 (字节跳动 AI-Lab语音识别实习;)

dhj_tsukuba的博客 4481

【机器学习】【深度学习】【人工智能】【算法工程师】面试问题汇总(持续更新)

微信公众号 1. 算法 【1】动态规划经典题目总结 2. 数据结构 2.1 数组和字符串 【1】【算法】删除一个数组中为0的元素 【2】牛客网在线编程专题《剑指offer-面试题34》丑数 【3】牛客网在线编程专题《剑指offer-面试题4》替换空格 【4】牛客网在线编程专题《剑指offer》(1)二维数组中的查找 2.2 链表 【1】牛客网在线编程专题《剑指offer-面试...

Microstrong 4174

机器学习面试简答题(持续更新)

1.请详细说说支持向量机(support vector machine,SVM)的原理 SVM就是在原始数据的样本空间中找到一个最大间隔的划分超平面,将样本进行分类。 超平面的确定只与支持向量有关,通过最大化支持向量到超平面的距离,来确定超平面的位置。 求解最大化距离时,可以使用拉格朗日乘数法将问题转化为其对偶问题。 ...

爱喝舒化奶的博客 2360

机器学习、基础算法、python常见面试题必知必答系列大全:(面试问题持续更新)

机器学习、基础算法、python常见面试题必知必答系列大全:(面试问题持续更新)

丨汀、的博客 2192

机器学习算法岗:常见面试问题及解答整理,持续更新

一、决策树ID3和C4.5的差别?各自优点? 首先,要知道 ID3和C4.5 是什么,他们和CART算法都是决策树的启发方法。 注:CART利用基尼指数来划分训练子集。 基尼指数(基尼不纯度):表示在样本集合中一个随机选中的样本被分错的概率。 因为从所有可能的决策树中选取最优决策树,这是一个NP完全问题,很难在多项式时间内求解(或者根本不存在这样的解)。所以现实中决策树学习算法采用启发式方法,近似求解这一最优化问题。所谓的启发式方法就是递归的选择最优特征,并根据该特征对训练数据进行分割。 ID3算法:

weixin_44414948的博客 4062

superpowers-中文使用说明

《obra/superpowers:AI辅助开发的流程纪律工具集》 摘要:obra/superpowers是一套面向AI辅助软件开发的系统化流程规范,包含14个核心技能,强调"先理解后行动"的纪律性开发方法。该工具集定义了从头脑风暴到代码评审的完整工作流,要求严格遵循测试驱动开发、子代理隔离执行等原则。核心特色包括:1) 任何实现前必须完成设计和评审;2) 采用红-绿-重构的TDD循环;3) 复杂任务通过独立子代理串行处理;4) 所有产出需经过双重验证(规格合规+代码质量)。该工具集特别注重文档化和可验证性

qq_22786633的博客 765

Redis 常见面试题汇总(持续更新)

本文总结了常见Redis面试题,持续更新

青灯文案的博客 4346

案例分析|一篇文章带你看懂养鸡场智慧管理系统

养鸡场智慧管理系统是为了满足现代化养鸡业对精细化管理的需求而设计的一款专业软件。随着科技的发展和农业产业的升级,传统的手工记录和管理方式已无法满足高效、准确和实时的数据跟踪需求。本软件旨在通过集成各种功能模块,帮助养鸡场主实现从鸡苗孵化、饲养管理、饲料控制到销售结算等全链条的智能化操作。该系统的核心目标是提升养鸡场的运营效率和盈利能力,通过自动化数据处理,减少人工误差,节省时间和精力。例如,孵化报表和记录模块可以帮助管理者实时监控孵化过程,及时调整策略;

muyu2980的专栏 930

基于STM32H750的便携式双通道示波器与信号发生器AFE设计

示波器和信号发生器是电子测量与嵌入式系统调试的基础仪器,其核心在于模拟前端(AFE)对宽动态范围、高精度采样与低失真输出的协同实现。原理上需兼顾输入信号调理(衰减/放大/偏置)、ADC/DAC接口匹配、触发同步及电源完整性设计。技术价值体现在以低成本器件达成±15V输入/±10V输出、16位等效采样精度与85kHz带宽的工程平衡。典型应用场景包括电机驱动波形观测、传感器信号验证、电源环路测试及通信电平分析。本方案聚焦STM32H750平台,深度融合硬件拓扑与片上资源特性,为嵌入式教学与原型开发提供可复现、易

weixin_35755188的博客 107

ML_CV面试求职1,持续更新20190710

目录Subject1: 面试过亚马逊、特斯拉、三星、优步、华为等大公司(20190710)偏差和方差之间的协调(权衡)是什么?什么是梯度下降?解释过拟合和欠拟合以及如何与之对抗?你如何对抗维度的诅咒?什么是正则化,我们为什么要使用它,并给出一些常见方法的例子?解释主成分分析法 (PCA)?为什么在神经网络中ReLU比Sigmoid更好更常用 ?什么是数据标准化,我们为什么需要它?解释降维,在哪里会...

王远的博客 279

Ubuntu docker镜像中下载安装 DPABI(DPARSF)

在Ubuntu服务器的docker镜像中用MATLAB运行DPABI(以及使用DPARSF的功能)。

Pandako's Blog 1722

【持续更新】面试复习整理

写在前面 基本都是从网上solo来的题目,也有一些平时看到感觉会被问的整理进去的题目 主要为了毕业面试…… NLP/机器学习方向的算法岗面试问题整理 问题答案均持续更新,持续到23年3月份吧,如果我还没找到工作的话 NLP word2vec的tricky是什么 word2vec的两个模型是什么,分别使用了什么损失函数 CBOW和skip-Gram的区别,哪个模型更好,哪个模型计算复杂度高 transformer/bert/ernie等等等等 机器学习 基本概念 生成模型和判别模型 参数模型和非

YY_Tina的博客 2133

【翼型】基于Matlab的NACA翼型气动性能仿真与优化【附源码】

本文详细介绍了如何使用Matlab进行NACA翼型的气动性能仿真与优化。内容涵盖从生成NACA翼型坐标、利用面板法快速估算升阻力,到进阶的粘性流模拟与优化设计入门。通过清晰的代码示例和分步指南,帮助读者掌握基于Matlab的翼型分析与优化流程,为飞行器或叶片设计提供实用工具和方法。

weixin_29032489的博客 408

GD32F303 Keil 工程项目从零搭建实战指南

本文是一份详细的GD32F303 Keil工程项目从零搭建实战指南。文章阐述了亲手搭建工程的重要性,并逐步指导开发者完成从环境准备、目录规划、工程创建、文件添加、关键配置到编译调试的全过程。重点讲解了如何正确选择启动文件、添加外设库、配置头文件路径和全局宏,旨在帮助开发者深入理解工程结构,掌握GD32F303开发的核心技能,实现从“会用”到“懂”的跨越。

weixin_29190651的博客 404

【剑指offer】高频ML/DL面试题

代码层面: 完成强化学习算法(CPG PPO A3C Q-learning DQN)在贪吃蛇环境的应用(即作出控制贪吃蛇的智能体) 在github上找到对应算法的代码并跑通代码 阅读理解代码的实现逻辑,对代码中用到的重要函数查阅和理解 对算法的调试和优化,使贪吃蛇智能体取得更好的分数 理论层面 阅读并理解五大算法的论文(需配合贪吃蛇代码的完成顺序) 对分布式相关知识的学习:按顺序完成学习A3C DPPO IMPALA seed-rl的论文及其相关文章 成果验收 (1)考察智能体在贪吃蛇的得分 三个算.

发现问题,并解决问题,批判性思维 9892

【学前须知】推荐阅读顺序

AUTOSAR学习笔记专栏文章推荐阅读顺序

weixin_47571898的博客 744

机器学习岗面试题目汇总「持续更新」

机器学习算法岗面试常见题汇总

weixin_42065178的博客 2578

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

ML-CaPsule:为数据科学爱好者打造的全方位机器学习学习平台

ML-CaPsule是由GitHub用户Niketkumardheeryan创建的开源项目。它的核心目标是为那些没有导师或指导,但渴望学习机器学习的人提供一个全面的学习环境。通过这个项目,学习者可以系统地学习机器学习、深度学习以及相关技术,并通过各种实际项目来巩固所学知识,最终达到面试就绪的水平。ML-CaPsule为数据科学爱好者提供了一个全面、系统的学习平台。无论你是刚刚踏入这个领域的新手,还是希望提升技能的从业者,这个项目都能为你提供宝贵的资源和指导。

Nifc666的博客 1013

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

上一篇: Python实现矩阵转置的三种方法,不使用API和numpy
下一篇: 常见的面试问题————NLP篇(持续更新)
烟雨人长安
博客等级 码龄10年 871粉丝 53原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值