机器学习历史简介

人工智能(AI)与机器学习(ML):塑造未来的技术引擎 人工智能是一种模拟、延伸和扩展人类智能的理论、方法、技术及应用系统。它旨在让计算机能够像人类一样思考、学习,并能在各种环境下自主地做出决策。AI的发展经历了从最初的符号主义、连接主义到如今的深度学习等多个阶段,每一次的突破都极大地推动了科技的进步。尽管AI与ML技术取得了巨大的进步,但它们仍然面临着诸多挑战。首先,数据的获取和标注是一个巨大的问题。高质量的标注数据是机器学习模型训练的关键,但数据的获取和标注往往需要耗费大量的人力和时间。其次,模型的泛化能力也是一个需要解决的问题。 阅读详情

#机器学习简史
----
###原文:[http://www.erogol.com/brief-history-machine-learning/](http://www.erogol.com/brief-history-machine-learning/)  
####翻译:[CACppuccino](https://github.com/CACppuccino)  
####特别感谢:Song

##译者前言  
回顾历史,能够让我们更加清晰地看清ML的去向。更重要的是,AI的历史无数次证明,没有一个流派会永远辉煌,也没有一个流派会一直沉寂。  
本文将以定义的方式,简介而较为准确地介绍 ML 中各个算法流派的历史。由于文章著成于2014年,部分算法的优化上可能有了更大的进展及突破。特在此注明。
##正文  
![](http://www.erogol.com/wp-content/uploads/2014/05/test.jpg)   
*机器学习时间轴*!
  
  自从科学、技术与人工智能拥有了最初的观点,科学家们跟随着Blaise Pascal和Von Leibniz的脚步,思考是否有一种机器,拥有与人类相同的智能。著名作者如Jules Verne,Frank Baum(绿野仙踪),Marry Shelly(弗兰肯斯坦),George Lucas(星球大战)幻想着人造人有着与人类相似甚至更强的能力,在不同情况下拥有着人性化的能力。   
![](http://www.erogol.com/wp-content/uploads/2014/05/Arts_et_Metiers_Pascaline_dsc03869.jpg)  
*Pascal的机器表演加减法*  
  
  机器学习(Machine Learning)是人工智能(AI)非常热门的一个方向,无论是在学术界还是工业界。公司,大学投入了大量的资源来提升他们在这方面的知识。近期的在此领域的进步,在很多任务中取得了实实在在的成果。  
  在这里我将分享一个机器学习的时间轴,并标注出其中的一些里程碑(尽管不一定完全)。  
  向着机器学习前进的第一步是由Hebb在1949年迈出的,基于一个神经心理学的学习公式。它被称为Hebbian学习原理。简单来讲,它加紧了节点和递归神经网络的相关性。
  它记住了所有网络上的共性并在之后如同人的记忆一般工作。正式地来讲,关于它的论述如下:  
  >让我们假设一个反射活动的持久性或重复性倾向于引诱持续的细胞发生改变从而增加它的稳定性。...
  当一个神经细胞A的轴突足够近来使细胞B兴奋并重复或持续地参与激活它,一些增长的过程或新陈代谢的改变会在其中一个或双方细胞中发生。
  这样的话,A的效率在刺激B的同时会升高。[1]  
  
  在1952年,Arthur Samuel在IBM研发出了会下跳棋的程序。该程序能够观察位置并学习得出一个
  模糊的模型,指导其为以后的情况作出更好的移动。Samuel与程序下了很多次棋,并发现程序能够随着时间的增长而下的更好。  
  Samuel借此反驳了公众关于机器执行的命令不能够超出所写代码并如人类一般学习的认知。他创造了“机器学习(machine learning)”这一术语,并定义:   
 
>一个通过不明确编程就使计算机拥有某种能力的研究领域。  
  
  1957年,Rosenblatt的Perceptron是第二个以神经科学为背景提出的模型,并与当今的机器学习模型
  相似。这在当时,是一个非常激动人心的发现,并比Hebbian的理念更加具有适用性。
  Rosenblatt是这样介绍感知器Perceptron的:  

>Perceptron是用于展示一些总体上的智能系统的基本特性而设计的,不是针对
  个别生物所拥有的太特别和未知的情况。[2]  

  3年之后,Widrow[4]制定了三角洲学习规则用于实际中训练感知器(Perceptron)的过程。这也被称为最小平方问题。两个理念的结合
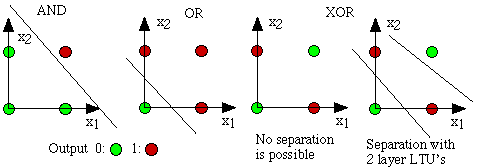
  产生了一个不错的线性分类器。然而,Percptron 带来的兴奋因 Minsky[3] 的出现而在1969年戛然而止。他提出了著名的亦或问题和Perceptrons在该线性不可分割数据分布的无力。正是Minsky使神经网络社区的发展停滞。之后,神经网络的研究者们的活动一直处于休眠状态知道20世纪80年代。  
  ![](http://www.cs.ru.nl/~ths/rt2/col/h10/draw-LTUdecis.GIF)  
  *亦或图*  

在1981年之前,社区一直未再作出更多的前进,直到 Werbos[6] 通过神经网络下的BP算法提出多层感知器(MLP),尽管BP的概念被 Linnainmaa[5] 于1970年以“逆向自动区分模型”提出过。BP算法仍然是如今神经网络架构中重要的成分之一。有这些新思想的提出,神经网络的研究又一次加速。在1985-1986年神经网络的研究者们成功地展示了以BP训练出的MLP(Rumelhart,Hinton,Willianms[7]-Hetch,Nielsen[8])。   

  ![](http://www.erogol.com/wp-content/uploads/2014/05/Hetch_Nielsen_NN.png)
*来自Hetch和Nielsen*  

  另一方面,决策树这一著名的机器学习算法被J.R.Quinlan[9]于1986年提出,详细来说是ID3算法。这是机器学习另一主流闪现灵。火花的重要象征点。更重要的是,ID3被实现为一个能够解决更多实际生活应用问题的软件,基于其简洁的规则和清晰的推理,与黑盒下的神经网络模型恰恰相反。  
  在ID3之后,更多的改变与提升涌现出来(如ID4,回归树,分类与回归树(CART)等等)并且在至今的机器学习中仍然是活跃的话题之一。  
  ![](http://www.erogol.com/wp-content/uploads/2014/05/Quinlan_ID3.png)   
*一个简单决策树(来源Quinlan[9])*   
  机器学习的一大重要突破来源于支持向量机(SVM),由 Vapnik 和 Cortes[10] 于1995年在非常有力的理论依据和经验结果下得出。正是这时,机器学习社区分为了神经网络(NN)和支持向量机(SVM)两大拥护群体。然而,对于神经网络的支持者来说,在Kernelized于近2000年提出新版本SVM后,竞争的优势并不在他们这里。SVM在原来许多神经网络成功的案例中取得了更好的成绩。同时,SVM能够利用所有之前凸优化,广义边际理论和核心来对抗NN模型。因此,它能够从不同的领域得到巨大的理论和实践的发展。  
  ![](http://www.erogol.com/wp-content/uploads/2014/05/SVM_Vapnik.png)  
  *二维分类问题(来源Vapnik和Cortes[10])*  
NN 又一次遭受重击是源于 Hochreiter 的于1991的论文[40]和 Hochreiter 与其他人合作于2001的论文[11],说明了 NN 的神经单元在应用了BP学习之后饱和带来的梯度损失。简单来讲,NN神经元由于饱和会在训练一段时间后出现冗余,因此NN倾向于在较短的训练时期内出现过度拟合问题。  
  之前,另一个名为Adaboost机器学习模型被Freund和Schapire于1997年提出,描述为弱分类器的增强组合。这份论文在当时为其作者带来了哥德尔奖(Godel Prize)。Adaboost通过提供更多重要的硬性实例来训练一套易于训练的弱分类器。该模型至今仍然是如脸部识别和侦察的基础。它同时也是PAC(Probably Approximately Correct)学习理论的一种实现。总体来讲,所谓的弱分类器是被选择为简单的决定步骤(单个决策树节点)。它们如此介绍Adaboost:  
  
>我们所学习的这个模型,可以被看做是一个线上善于学习的预测模型,至一个总体的理论决策设置的更广泛、抽象的拓展...[11]
  
  另一个于2001年被Breiman[12]提出的合成模型,能够合成多个决策树,而每个决策树是由实例的一套随机子集决策,并且每个节点是通过参数的一个随机子集产生的。由于它本身的特性,它被称为随机森林(Random Forests,RF)。RF也有理论和实际经验来证明对过度拟合的耐性。即使是AdaBoost也显示出了对于处理过度拟合的上的短板和对数据中异常实例处理的无力,而RF对这些问题有着更强大的处理能力。RF在许多不同的任务中取得了成功,在Kaggle的比赛中也是如此。([Kaggle网站:https://www.kaggle.com/competitions](https://www.kaggle.com/competitions) 译者注)。  

>随机森林(RF)一组决策树的组合,每一棵树依赖于一个独立抽样得到的随机向量的值,并且森林中的每个树的分布是相同的。森林收敛的通常错误如在树的数目增加时会达到极限。[12]  
 
  当时间逐渐来到今天时,一个神经网络的新时代——深度学习——来临了。该术语指参考NN神经网络模型并使用大量连续的神经层。神经网络的第三次大概崛起于2005年,借助于从过去到现在的不同发现而被Hinton,LeCun,Bengio,Andrew Ng和其他可贵的研究者们实现除了。以下列出了部分重要的标题:  
  
GPU programming  
Convolutional NNs [18][20][40]  
Deconvolutional Networks [21]  
Optimization algorithms  
Stochastic Gradient Descent [19][22]  
BFGS and L-BFGS [23]  
Conjugate Gradient Descent [24]  
Backpropagation [40][19]  
Rectifier Units  
Sparsity [15][16]  
Dropout Nets [26]  
Maxout Nets  [25]  
Unsupervised NN models [14]  
Deep Belief Networks [13]  
Stacked Auto-Encoders [16][39]  
Denoising NN models [17]  在
  在这些(和一些没有罗列在这里)的思想的结合下,神经网络模型拥有了完成许多任务的能力,如物体识别,演讲识别,自然语言处理等。然而,要强调的是,这并不代表着其他机器学习流派的终结。即使深度学习的成功例子在快速增加,仍有着很多的批评指向模型的训练代价和对外源参数的调整能力。更进一步,SVM仍然由于其简易性而被广泛运用。(这样说可能会引起巨大的争议:)-作者注)   
  -在结束之前,我要触及另一个年轻的机器学习分支。在万维网和社交媒体的增长下,一个新术语-大数据-产生了并对机器学习有着巨大的影响。由于大数据带来的巨大问题,许多强力的机器学习算法由于某些原因而变得无力(当然对大型科技公司不是问题)。因此,研究者们研发出了一套新的模型,被称为Bandit算法[27-38](用于线上学习)使学习更简单,更能够适应大数据规模问题。  
  若本文有任何问题,欢迎联系我并及时指出。  
  ---------------------------------------  
##References 

[1] Hebb D. O., The organization of behaviour.New York: Wiley & Sons.

[2]Rosenblatt, Frank. "The perceptron: a probabilistic model for information storage and organization in the brain." Psychological review 65.6 (1958): 386.

[3]Minsky, Marvin, and Papert Seymour. "Perceptrons." (1969).

[4]Widrow, Hoff "Adaptive switching circuits." (1960): 96-104.

[5]S. Linnainmaa. The representation of the cumulative rounding error of an algorithm as a Taylor
expansion of the local rounding errors. Master’s thesis, Univ. Helsinki, 1970.

[6] P. J. Werbos. Applications of advances in nonlinear sensitivity analysis. In Proceedings of the 10th
IFIP Conference, 31.8 - 4.9, NYC, pages 762–770, 1981.

[7] Rumelhart, David E., Geoffrey E. Hinton, and Ronald J. Williams. Learning internal representations by error propagation. No. ICS-8506. CALIFORNIA UNIV SAN DIEGO LA JOLLA INST FOR COGNITIVE SCIENCE, 1985.

[8] Hecht-Nielsen, Robert. "Theory of the backpropagation neural network." Neural Networks, 1989. IJCNN., International Joint Conference on. IEEE, 1989.

[9] Quinlan, J. Ross. "Induction of decision trees." Machine learning 1.1 (1986): 81-106.

[10] Cortes, Corinna, and Vladimir Vapnik. "Support-vector networks." Machine learning 20.3 (1995): 273-297.

[11] Freund, Yoav, Robert Schapire, and N. Abe. "A short introduction to boosting."Journal-Japanese Society For Artificial Intelligence 14.771-780 (1999): 1612.

[12] Breiman, Leo. "Random forests." Machine learning 45.1 (2001): 5-32.

[13] Hinton, Geoffrey E., Simon Osindero, and Yee-Whye Teh. "A fast learning algorithm for deep belief nets." Neural computation 18.7 (2006): 1527-1554.

[14] Bengio, Lamblin, Popovici, Larochelle, "Greedy Layer-Wise
Training of Deep Networks", NIPS’2006

[15] Ranzato, Poultney, Chopra, LeCun " Efficient Learning of  Sparse Representations with an Energy-Based Model ", NIPS’2006

[16] Olshausen B a, Field DJ. Sparse coding with an overcomplete basis set: a strategy employed by V1? Vision Res. 1997;37(23):3311–25. Available at: http://www.ncbi.nlm.nih.gov/pubmed/9425546.

[17] Vincent, H. Larochelle Y. Bengio and P.A. Manzagol, Extracting and Composing Robust Features with Denoising Autoencoders, Proceedings of the Twenty-fifth International Conference on Machine Learning (ICML‘08), pages 1096 - 1103, ACM, 2008.

[18] Fukushima, K. (1980). Neocognitron: A self-organizing neural network model for a mechanism of pattern recognition unaffected by shift in position. Biological Cybernetics, 36, 193–202.

[19] LeCun, Yann, et al. "Gradient-based learning applied to document recognition."Proceedings of the IEEE 86.11 (1998): 2278-2324.

[20] LeCun, Yann, and Yoshua Bengio. "Convolutional networks for images, speech, and time series." The handbook of brain theory and neural networks3361 (1995).

[21] Zeiler, Matthew D., et al. "Deconvolutional networks." Computer Vision and Pattern Recognition (CVPR), 2010 IEEE Conference on. IEEE, 2010.

[22] S. Vishwanathan, N. Schraudolph, M. Schmidt, and K. Mur- phy. Accelerated training of conditional random fields with stochastic meta-descent. In International Conference on Ma- chine Learning (ICML ’06), 2006.

[23] Nocedal, J. (1980). ”Updating Quasi-Newton Matrices with Limited Storage.” Mathematics of Computation 35 (151): 773782. doi:10.1090/S0025-5718-1980-0572855-

[24] S. Yun and K.-C. Toh, “A coordinate gradient descent method for l1- regularized convex minimization,” Computational Optimizations and Applications, vol. 48, no. 2, pp. 273–307, 2011.

[25] Goodfellow I, Warde-Farley D. Maxout networks. arXiv Prepr arXiv …. 2013. Available at: http://arxiv.org/abs/1302.4389. Accessed March 20, 2014.

[26] Wan L, Zeiler M. Regularization of neural networks using dropconnect. Proc …. 2013;(1). Available at: http://machinelearning.wustl.edu/mlpapers/papers/icml2013_wan13. Accessed March 13, 2014.

[27] Alekh Agarwal, Olivier Chapelle, Miroslav Dudik, John Langford, A Reliable Effective Terascale Linear Learning System, 2011

[28] M. Hoffman, D. Blei, F. Bach, Online Learning for Latent Dirichlet Allocation, in Neural Information Processing Systems (NIPS) 2010.

[29] Alina Beygelzimer, Daniel Hsu, John Langford, and Tong Zhang Agnostic Active Learning Without Constraints NIPS 2010.

[30] John Duchi, Elad Hazan, and Yoram Singer, Adaptive Subgradient Methods for Online Learning and Stochastic Optimization, JMLR 2011 & COLT 2010.

[31] H. Brendan McMahan, Matthew Streeter, Adaptive Bound Optimization for Online Convex Optimization, COLT 2010.

[32] Nikos Karampatziakis and John Langford, Importance Weight Aware Gradient Updates UAI 2010.

[33] Kilian Weinberger, Anirban Dasgupta, John Langford, Alex Smola, Josh Attenberg, Feature Hashing for Large Scale Multitask Learning, ICML 2009.

[34] Qinfeng Shi, James Petterson, Gideon Dror, John Langford, Alex Smola, and SVN Vishwanathan, Hash Kernels for Structured Data, AISTAT 2009.

[35] John Langford, Lihong Li, and Tong Zhang, Sparse Online Learning via Truncated Gradient, NIPS 2008.

[36] Leon Bottou, Stochastic Gradient Descent, 2007.

[37] Avrim Blum, Adam Kalai, and John Langford Beating the Holdout: Bounds for KFold and Progressive Cross-Validation. COLT99 pages 203-208.

[38] Nocedal, J. (1980). "Updating Quasi-Newton Matrices with Limited Storage". Mathematics of Computation 35: 773–782.

[39] D. H. Ballard. Modular learning in neural networks. In AAAI, pages 279–284, 1987.

[40] S. Hochreiter. Untersuchungen zu dynamischen neuronalen Netzen. Diploma thesis, Institut f ̈ur In-
formatik, Lehrstuhl Prof. Brauer, Technische Universit ̈at M ̈unchen, 1991. Advisor: J. Schmidhuber.

Core ML简介及实时目标检测及Caffe TensorFlow coremltools模型转换 Core ML简介及实时目标检测,Caffe、Tensorflow与Core ML模型转换、Vision库的使用 转载请注明出处 http://blog.youkuaiyun.com/u014205968/article/details/79220659 本篇文章首先会简要介绍iOS 11推出的Core ML机器学习框架,接着会以实际的已经训练好的Caffe、Tensorflow模型为例,讲解coreml 阅读详情

相关推荐

人工智能AI 机器学习ML 深度学习DL 和 神经网络NN 的关系

人工智能 机器学习 深度学习 神经网络 的关系

自动驾驶汽车和机器人技术爱好者 1971

世界模型【论文】

Agent可以在自己的梦境中学习吗? 概述 我们探索建立支撑流行强化学习环境的生成型神经网络模型,我们的世界模型可以以无监督的方式快速训练,以学习针对环境的压缩时空表示。通过使用从世界模型中提取的特征作为agent的输入,我们可以训练一个非常紧凑和简单的策略,可以解决所要求的任务,甚至可以完全在其世界模型生成的梦境中训练agent,并将此策略迁移到实际环境。 介绍 世界模特,来自斯科特麦...

wilbertzhou的专栏 7333

机器学习发展历史回顾

其它机器学习、深度学习算法的全面系统讲解可以阅读《机器学习-原理、算法与应用》,清华大学出版社,雷明著,由SIGAI公众号作者倾力打造。 书的购买链接 书的勘误,优化,源代码资源 机器学习是现阶段解决很多人工智能问题的主流方法,作为一个独立的方向,正处于高速发展之中。最早的机器学习算法可以追溯到20世纪初,到今天为止,已经过去了100多年。从1980年机器学习称为一个独立的方向开始算起,到现在...

SIGAI_优快云的博客 2万+

神经网络和深度学习简史(一)

“深度学习这一朵浪花在计算机语言学的海上已经被研究了多年,但2015年似乎有一股海啸般的力量把自然语言处理(NLP)推到了世人面前”-----------Dr. Christopher D. Manning, Dec 2015  科研某一个领域的所有已知方法被一种突如其来新发现而完全取代,如同被“海啸”袭击了一样,这听起来像是一个奇异的故事。然而这种灾难性的比喻用来形容近几年的深度学习再恰当不过

neujs的博客 6242

ML4T工作流程:从ML模型到策略回测(交易中的机器学习)

除了大量活跃的个人交易者社区,也有几家银行和交易公司使用backtrader来原型和测试新策略,然后将其移植到生产就绪的平台,如Java。例如,您可以使用我们在本书中遇到的scikit-learn等通用ML库设计和测试生成信号的ML模型,并将模型输出输入单独的回测引擎。这些对象相互作用,以便于输入数据的处理和因子计算,制定和执行策略,接收和执行订单,以及跟踪和度量业绩。简单地说,回测引擎遍历历史价格(和其他数据),将当前值传递给您的算法,收到订单作为回报,并跟踪所得仓位及其价值。

weixin_41908924的博客 1610

ML.NET 自动机器学习(AutoML)完全指南

随着机器学习技术在各行各业的广泛应用,如何快速构建高质量的机器学习模型已成为开发团队面临的核心挑战。传统机器学习流程需要开发者具备深厚的算法知识、丰富的调参经验以及对数据预处理的深刻理解,这无疑提高了机器学习的应用门槛。ML.NET 作为微软推出的开源机器学习框架,其内置的 AutoML(自动机器学习)功能彻底改变了这一局面。

痴迷于AI技术,AI 生态的小猿猴 868

ML简史

在科学技术刚刚萌芽的时候,科学家Blaise Pascal和Von Leibniz就想到了有朝一日能够实现人工智能。即让机器拥有像人一样的智能。 机器学习是AI中一条重要的发展线,在工业界和学术界都异常火爆。企业、大学都在投入大量的资源来做机器学习方面的研究。最近,机器学习在很多任务上都有了重大的进步,达到或者超越了人类的水平(例如,交通标志的识别[1],ML达到了98.98%,已超越了人类)。

雨石 4558

5、探索 TensorFlow:机器学习的强大工具

本文介绍了 Google 开源的机器学习框架 TensorFlow,详细探讨了其特性、历史背景、安装与初步使用方法,以及在机器学习中的广泛应用。内容涵盖张量表示、计算流程图、自动微分机制、可视化工具 TensorBoard 和交互式开发工具 Jupyter 的使用。同时,文章还介绍了机器学习的主要类型及其适用问题,并列举了不同算法对应的实际应用场景。通过本文,读者可以全面了解 TensorFlow 的基本概念和开发流程,为后续深入学习和实践打下基础。

c6d7e8f9g的博客 103

人工智能与生物智能:生物学知识为AI带来革命

1.背景介绍 人工智能(Artificial Intelligence,AI)是计算机科学的一个分支,研究如何使计算机能够像人类一样思考、学习和解决问题。生物智能(Biological Intelligence,BI)则是指生物系统中的智能,包括人类、动物、植物和微生物等。近年来,生物学知识在人工智能领域的应用逐渐崛起,为人工智能带来了革命性的变革。 生物学知识为人工智能带来革命性的变革,主要...

AI天才研究院 4119

深入探索人工智能与机器学习的多维世界

本文探讨了《人工智能:机器学习简介》一书的丰富内容,涵盖了从人工智能的历史、逻辑智能、概率智能到神经智能等多个方面。书中不仅介绍了人工智能的基本概念和方法,还详细讨论了各类智能应用和最新技术发展,如贝叶斯网络、决策分析、无监督学习、强化学习以及深度学习等。作者通过丰富的实例和深入的分析,为我们揭示了人工智能在现代社会中的广泛应用和深远影响。

weixin_28729843的博客 446

WinCC与施耐德PLC的Modbus TCP通信实战指南

本文详细解析了西门子WinCC与施耐德PLC通过Modbus TCP协议实现通信的完整实战流程。内容涵盖硬件网络配置、Modbus地址映射核心规则、WinCC驱动连接建立、变量创建及高级数据访问技巧,并提供了常见故障排查思路,帮助工程师高效解决跨品牌设备通信难题。

weixin_29194693的博客 995

机器学习(一) 历史

@[TOC](机器学习(一) 历史) 引言 “机器学习” 这一名词在我们视线内出现的评率越来越高, 与之相伴的有 “人工智能” 、“深度学习” 等名词. 关于这三者的认识,我们可以大致理解为 “人工智能>机器学习>深度学习” 实际上, 机器学习是一种实现人工智能的手段, 而深度学习是一类机器学习算法.

qk320723的博客 3565

CODESYS做Modbus TCP主站踩坑记:从IP配置到数据映射的完整避坑指南

本文详细记录了在CODESYS中配置Modbus TCP主站的全过程,从IP配置到数据映射的常见问题及解决方案。重点解析了网络适配器选择、Slave ID误解、地址偏移陷阱等关键问题,并提供了实用的调试技巧和性能优化建议,帮助工业通信开发者高效避坑。

weixin_30642561的博客 624

MLOps(Machine Learning Operations)简介,历史,及用途

MLOps简介与核心价值 MLOps(Machine Learning Operations)是将DevOps实践应用于机器学习系统的工程化方法,旨在标准化和简化ML生命周期管理。它通过持续集成、交付和自动化部署,解决模型规模化、生产化和持续维护的挑战。MLOps的发展经历了探索期、萌芽期和标准化期,现已成为管理大型AI系统的关键学科。 核心价值包括: 加速模型迭代:自动化缩短实验到生产的周期。 提升模型质量:通过持续集成、验证和监控确保可靠性。 规模化协作:通过模型注册中心、特征库等工具优化团队协作。 保

小宝哥Code的专栏 1047

Win7/Win10双系统兼容指南:Arduino IDE 1.8.19与2.3.2的安装避坑全攻略

本文详细解析了在Win7/Win10双系统环境下安装和配置Arduino IDE 1.8.19与2.3.2版本的完整指南,特别针对ESP32开发环境的深度配置和COM端口常见问题提供了实用解决方案。通过版本对比、安装优化和性能调优,帮助开发者高效搭建稳定的物联网开发环境。

weixin_30500105的博客 186

毕设案例|保安公司智慧管理系统的建设与开发方案

"保安公司智慧管理系统是一款专为保安行业设计的高效信息化解决方案,其核心功能涵盖了从人力资源管理到业务运营的各个方面。系统以Java作为开发语言,结合SpringMVC框架,确保了稳定性和可扩展性,而MySQL数据库则提供了强大的数据存储和处理能力。首先,系统允许用户设置各类保安,如门卫、巡逻员等,实现精细化分类管理。其次,保安信息管理模块包括详细的人事档案、资格证书、培训记录等,便于人员追踪和考核。部门和城市设置方便公司层级管理和异地项目管理。岗位设置与时间安排精确到分钟,确保排班科学合理。

muyu2980的专栏 935

使用Python进行机器学习-有用的资源

使用Python进行机器学习-有用的资源 (Machine Learning With Python - Useful Resources) Advertisements 广告 Previous Page 上一页 Next Page 下一页 The following resources contain additional information on Ma...

cunzai1985的博客 163

腾讯Android开发面试准备指南及参考答案

腾讯元宝高级Android开发职位面试准备指南 该职位要求扎实的Kotlin基础、架构设计能力和性能优化经验,重点关注Android客户端开发。面试流程约3轮,支持线上面试,流程较快。候选人需准备以下核心内容: 基础技术:Kotlin特性、Android开发生命周期、多线程编程 架构设计:MVVM/MVI模式应用、组件化解耦方案 性能优化:流畅度提升、内存管理、启动时间优化等实战案例 加分技能:Jetpack Compose开发、音视频处理、跨平台开发经验 建议结合项目经验准备具体案例,突出技术深度和问题解

郑伟强dev的专栏 1192

AI - 机器学习(Machine Learning)与深度学习(Deep Learning)资料汇总

本文转自: http://blog.youkuaiyun.com/zhongwen7710/article/details/45331915列出的内容比较多,我自己还在看。我计划接下来看能否按照类别和难易程度做下整理,方便网友们查看。《Brief History of Machine Learning》介绍:这是一篇介绍机器学习历史的文章,介绍很全面,从感知机、神经网络、决策树、SVM、Adaboost到随...

gaoming 4438

Autosar EcuM配置-初始化及下电执行函数-基于ETAS软件

Autosar EcuM学习笔记-上电初始化执行函数及下电前执行函数,本文介绍在EcuM中的配置及使用。

赞的博客 847

rk3399开发环境的介绍

由于Bluez的介绍文档有限,以及对Linux 系统/驱动概念、D-Bus 通信和蓝牙协议都有要求,加上网络上其实没有一个完整的介绍Bluez系列的文档,所以不管是蓝牙初学者还是蓝牙从业人员,都有不小的难度,学习曲线也相对较陡,所以我有了这个想法,专门对Bluez做一个系统性的介绍,尽可能的涵盖所有内容。

朝气蓬勃 708

NumPy 2.x 完全指南【一】简介

NumPy 作为一个高效的多维数组科学计算库,广泛应用于人工智能(AI)的各个领域中,提供了基础数据结构、高效计算等能力,几乎贯穿了数据处理、模型训练、算法实现和结果分析的等各个环节,是我们在入门 AI 时必须学习和掌握的一个基础库。

记录知识、锤炼自我 1709

用群辉NAS打造影视墙(Jellyfin篇)

之前的文章提到过,用群辉NAS组建影视播放系统可以采用官方提供的Video Station套件,不过影视信息配比较差,响应速度也欠佳,今天我们就聊聊别的套件。在影音媒体方面,常见的还有Emby、Plex、Jellyfin。本文主讲Jellfin的原因是它胜在免费,而且功能比较齐全,完全够用。详细信息可以参考Jellyfin的官网:https://jellyfin.org/

dgnankai的专栏 7320

Python 简介

Python是一种解释型、面向对象、动态和高级编程语言。它可以进行快速的开发,具有简单而易于学习的语法,并且拥有基础库以及大量第三方模块,使得在Python上进行软件开发变得容易和便利。Python可以运行在多个操作系统(如Windows、Linux、macOS等)上,并且被广泛应用于Web开发、数据分析 、机器学习、人工智能等领域。Python的历史可以追溯到1989年,由Guido van Rossum创建。当时,Guido在荷兰的CWI(荷兰计算机科学研究所)工作。

Kali与编程 832

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

【Designing ML Systems】第 2 章 :机器学习系统设计简介

既然我们已经浏览了现实世界中 ML 系统的概述,我们就可以开始实际设计 ML 系统的有趣部分了。重申第一章,ML 系统设计采用系统方法来处理 MLOps,这意味着我们将整体考虑 ML 系统,以确保所有组件——业务需求、数据堆栈、基础设施、部署、监控等.—和他们的利益相关者可以一起工作以满足指定的目标和要求。我们将从对目标的讨论开始本章。在我们开发机器学习系统之前,我们必须了解为什么需要这个系统。如果这个系统是为企业构建的,它必须由业务目标驱动,需要将其转化为 ML 目标,以指导 ML 模型的开发。一旦每个人

sikh_0529的博客 1215

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

解锁C#新技能:用ML.NET开启机器学习之旅

ML.NET作为一款专为.NET 开发者打造的机器学习框架,以其跨平台、功能丰富、开发门槛低等显著优势,为.NET 开发者开启了通往机器学习领域的便捷之门。无论是在图像分类、文本分类,还是目标检测等众多应用场景中,ML.NET都展现出了强大的实用性和高效性。对于广大.NET 开发者而言,学习和使用ML.NET不仅能够提升自身的技术能力,拓宽职业发展道路,还能为自己的项目注入智能元素,使其在市场竞争中脱颖而出。如果你对机器学习充满好奇,渴望将其融入到自己的.NET 开发工作中,那么不妨从现在开始,尝试使用。

大雨淅淅的博客 1899

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

下一篇: [英]Haskell and Genetic Algorithm solving Sudoku
LordCup
博客等级 码龄10年 1粉丝 2原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值