java实现-深度优先搜索

【Java算法之dfs 与bfs详解】 Java算法之dfs 与bfs1. dfs1.1 递归1.2 非递归2. bfs2.1 常见两类问题 1. dfs 深度优先遍历(Depth First Search, 简称 DFS) 深度优先遍历各个节点,需要使用到栈(Stack)这种数据结构。Stack的特点是是先进后出,首先将右节点压入栈中,在将左节点压入栈中,这样出栈顺序就是先左节点再右节点。 DFS是图论里面的一种搜索算法,他可以由一个根节点出发,遍历所有的子节点,进而把图中所有的可以构成树的集合都搜索一遍,达到全局搜索的目的。所以很多问题都可以 阅读详情

目录

1、定义

2、DFS思想

3、java实现深度优先搜索

3、1 DFS访问无向图

3、2 DFS访问树(不一定是二叉树)

1、思想

2、树的实现

3、递归实现DFS遍历树(更容易理解,还是就记这个吧,天啊噜)

4、非递归实现DFS遍历树(栈)


1、定义

维基百科:深度优先搜索算法(英语:Depth-First-Search,DFS)是一种用于遍历或搜索树或图的算法。

这个算法会尽可能深的搜索树的分支。当节点v的所在边都己被探寻过,搜索将回溯到发现节点v的那条边的起始节点。

这一过程一直进行到已发现从源节点可达的所有节点为止。如果还存在未被发现的节点,则选择其中一个作为源节点并重复以上过程,整个进程反复进行直到所有节点都被访问为止。[1](p603)这种算法不会根据图的结构等信息调整执行策略[来源请求]。

深度优先搜索是图论中的经典算法,利用深度优先搜索算法可以产生目标图的拓扑排序表[1](p612),利用拓扑排序表可以方便的解决很多相关的图论问题,如无权最长路径问题等等。


2、DFS思想

  • DFS的思想:从一个顶点V0开始,沿着一条路一直走到底,如果发现不能到达目标解,那就返回到上一个节点,然后从另一条路开始走到底。 
  • DFS适合此类题目:给定初始状态跟目标状态,要求判断从初始状态到目标状态是否有解。
     

感觉和回溯法具有相同的思想:

  • 回溯法适合的问题:有多个状态,并且每个状态具有多个选项;选择了一个选项后,进入下一步,然后又面临新的选项;重复选择,直到到达最终的状态。
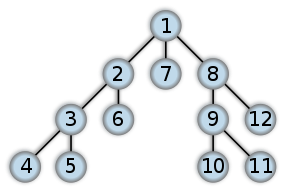
  • 形象地用树状结构表示思想:

èç¹æç´¢ç顺åº

节点表示状态;节点间的连线表示选项;树的叶节点表示最终状态;

如果叶节点满足约束条件,则找到一个可行方案;

反之,不满足约束条件则需要回溯到它的父节点,然后尝试其他选项。如果父节点的所有选项都尝试过了,能找到最好可行方案最好,不能找到的话,就再次回溯到父节点的父节点。如果所有节点、连线都尝试了还没满足约束条件的话,该问题无解。(像极了人生,只不过人生不能回溯)

参考剑指offer第11题:


3、java实现深度优先搜索

3、1 DFS访问无向图

参考算法第四版p340,递归遍历所有顶点,在访问一个顶点时:

  • 将其标记为visited;
  • 递归地访问它的所有没有被访问过的邻居节点。

例如,在下图中,我们从顶点2开始遍历。当我们到达顶点0时,我们寻找它的所有相邻顶点。2也是0的相邻顶点。如果我们不标记访问过的顶点,那么2将再次被处理,它将成为一个非终止过程。下图的深度优先遍历是2、0、1、3。
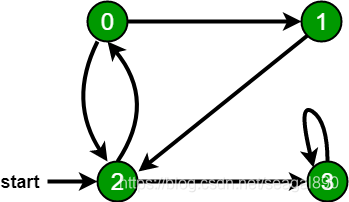
 

分析:

  • 上图有4个结点(顶点):0,1,2,3
  • 边的数量:6
  • 边的表示:(0,1)(0,2)(1,2)(2,0)(2,3)(3,3)

(1)顶点 v选择一个与v相邻的未被访问的顶点w
(2)并从w出发以深度优先搜索
(3)若一个顶点v的所有相邻顶点都被访问过了,则退回到最近被访问过、且有未被访问的w顶点!!!
(4)然后从w出发继续进行深度优先搜索
(5)当从任何已经访问的顶点出发,不再有未访问的顶点时,搜索终止
 

邻接表:如果我们想构造出这个图,可以采用邻接表表示。以下代码基于LinkList实现邻接表。


package Sword;

import java.util.Iterator;
import java.util.LinkedList;

public class DFS {
	public static void main(String[] args) {
		DFS g = new DFS(4);
		 
		g.addEdge(0, 1);
		g.addEdge(0, 2);
		g.addEdge(1, 2);
		g.addEdge(2, 0);
		g.addEdge(2, 3);
		g.addEdge(3, 3);
 
		System.out.println("下面是DFS搜索结果 " + "(从2号结点开始)");
		g.DFSTravel(2);

	}

	// ---- DFS访问无向图------------------------------------------------------

	// 结点
	private int v;
	

	// 邻接表
	LinkedList<Integer> neighbor[];

	// 图的构造方法
	DFS(int cv) {
		this.v = cv;
		
		neighbor = new LinkedList[cv];
		for (int i = 0; i < cv; ++i)
			neighbor[i] = new LinkedList();
	}

	// 向图中cv点添加边(cv,m)
	public void addEdge(int cv, int w) {
		neighbor[cv].add(w);
	}

	// 回溯函数
	public void DFSUtil(int cv, boolean[] visited) {
		// 标记当前结点为已访问(visited)并输出
		visited[cv] = true;
		System.out.print(cv + " ");

		// 访问当前的结点的所有邻接结点
		Iterator<Integer> i = neighbor[cv].listIterator();
		while (i.hasNext()) {
			int n = i.next();
			if (!visited[n])
				DFSUtil(n, visited);
		}
	}

	// DFS traversal. 用来回溯调用 DFSUtil()函数
	public void DFSTravel(int cv) {
		// 标记所有节点为未访问状态( not visited),设置初始值为false。
		boolean[] visited = new boolean[this.v];
		// 回溯 DFS traversal
		DFSUtil(cv, visited);
	}

}

仿真结果:

下面是DFS搜索结果 (从2号结点开始)
2 0 1 3 

3、2 DFS访问树(不一定是二叉树)

1、思想

  • DFS遍历树,可以使用递归(分为三种,前中后序遍历)或者非递归(使用栈),思想就是尽可能深地遍历完树的子节点。沿着树的深度遍历树的节点,尽可能深的搜索树的分支。当节点v的所在边都己被探寻过,搜索将回溯到发现节点v的那条边的起始节点。这一过程一直进行到已发现从源节点可达的所有节点为止。如果还存在未被发现的节点,则选择其中一个作为源节点并重复以上过程,整个进程反复进行直到所有节点都被访问为止。属于盲目搜索。
  • 相比较而言,而广度搜索BFS是尽可能按层遍历完子节点。

2、树的实现

树是一种特殊的有向图。列举一种表示方式:

public class TreeNode<V> {

    private V value;
    private List<TreeNode<V>> childList;//子节点列表

    public TreeNode(V value) {
        this.value = value;
    }

    public TreeNode(V value, List<TreeNode<V>> childList) {
        this.value = value;
        this.childList = childList;
    }

    public V getValue() {
        return value;
    }

    public void setValue(V value) {
        this.value = value;
    }

    public List<TreeNode<V>> getChildList() {
        return childList;
    }

    public void setChildList(List<TreeNode<V>> childList) {
        this.childList = childList;
    }
}

3、递归实现DFS遍历树(更容易理解,还是就记这个吧,天啊噜)

public static <V> void dfs(TreeNode<V> tree, int depth) {
    if (tree != null) {
        //打印节点值以及深度
        System.out.println(tree.getValue().toString() + ",   " + depth);
        if (tree.getChildList() != null && !tree.getChildList().isEmpty()) {
            for (TreeNode<V> item : tree.getChildList()) {
                dfs(item, depth + 1);
            }
        }
    }
}


一般来说,递归实现DFS 算法又分为如下三种:

1). 前序遍历(Pre-Order Traversal,根 - 左 - 右) :指先访问根,然后访问子树的遍历方式

private static <V> void dfs(TreeNode<V> tree, int depth) {
    if (d != null) {
        //打印节点值以及深度
        System.out.println(tree.getValue().toString() + ",   " + depth);
        if (tree.getChildList() != null && !tree.getChildList().isEmpty()) {
            for (TreeNode<V> item : tree.getChildList()) {
                dfs(item, depth + 1);
            }
        }
    }
}


2). 后序遍历(Post-Order Traversal, 左 - 右 - 根):指先访问子树,然后访问根的遍历方式

private static <V> void dfs(TreeNode<V> tree, int depth) {
    if (d != null) {
        if (tree.getChildList() != null && !tree.getChildList().isEmpty()) {
            for (TreeNode<V> item : tree.getChildList()) {
                dfs(item, depth + 1);
            }
        }
        //打印节点值以及深度
        System.out.println(tree.getValue().toString() + ",   " + depth);
    }
}


3). 中序遍历(In-Order Traversal, 左 - 根 - 右):指先访问左(右)子树,然后访问根,最后访问右(左)子树的遍历方式。

中序遍历一般是用二叉树实现:

private static <V> void dfs(TreeNode<V> root, int depth) {
    if (root.getLeft() != null){
        dfs(root.getLeft(), depth + 1);
    }
    //打印节点值以及深度
    System.out.println(d.getValue().toString() + ",   " + depth);
    if (root.getRight() != null){
        dfs(root.getRight(), depth + 1);
    }
}

4、非递归实现DFS遍历树(栈)

深度优先遍历各个节点,可以使用堆(Stack)这种数据结构。stack的特点是是先进后出。对于右图例子,整个遍历过程如下:

  • 首先将A节点压入堆中,stack(A);
  • 将A节点弹出,同时将A的子节点C,B压入堆中,此时B在堆的顶部,stack(B,C);
  • 将B节点弹出,同时将B的子节点E,D压入堆中,此时D在堆的顶部,stack(D,E,C);
  • 将D节点弹出,没有子节点压入,此时E在堆的顶部,stack(E,C);
  • 将E节点弹出,同时将E的子节点I压入,stack(I,C);
  • ...依次往下,最终遍历完成

对于右图来说深度优先遍历的结果就是:A,B,D,E,I,C,F,G,H.(假设先走子节点的的左侧)。

public static <V> void dfsNotRecursive(TreeNode<V> tree) {
    if (tree != null) {
        //次数之所以用 Map 只是为了保存节点的深度,
        //如果没有这个需求可以改为 Stack<TreeNode<V>>
        Stack<Map<TreeNode<V>, Integer>> stack = new Stack<>();
        Map<TreeNode<V>, Integer> root = new HashMap<>();
        root.put(tree, 0);
        stack.push(root);
        while (!stack.isEmpty()) {
            Map<TreeNode<V>, Integer> item = stack.pop();
            TreeNode<V> node = item.keySet().iterator().next();
            int depth = item.get(node);
            //打印节点值以及深度
            System.out.println(tree.getValue().toString() + ",   " + depth);
            if (node.getChildList() != null && !node.getChildList().isEmpty()) {
                for (TreeNode<V> treeNode : node.getChildList()) {
                    Map<TreeNode<V>, Integer> map = new HashMap<>();
                    map.put(treeNode, depth + 1);
                    stack.push(map);
                }
            }
        }
    }
}


 

Java-DFS(深度优先搜索) 原理深度优先搜索的基本思路是从一个节点开始,依次访问它的每一个邻居节点,直到达到一个没有未被访问的邻居的节点为止。这个过程可以使用递归或者栈来实现。其特点是尽可能深入每一个分支,然后再回溯。DFS算法常用于解决以下类型的问题:在实际使用中,图的表示通常有以下几种方式:在下面的示例中,我们使用邻接表来表示图,因为它存储效率更高,适合大多数情况。以下是通过递归方式实现深度优先搜索的详细代码,并附带注释以帮助理解每个部分的功能 栈的实现方式不直接依赖于系统的调用栈,这对于深度大、可能导致栈溢出的情况特别有用 阅读详情

相关推荐

递归遍历:深度优先搜索算法的实现(Java版)

它以深度为优先原则,从初始节点出发,沿着路径直到不能继续前进,然后返回上一个节点,选择另一条路径再次前进。DFSUtil方法是递归的核心实现,它接受当前节点和一个visited数组作为参数,并递归地调用自身来遍历当前节点的邻接节点。在遍历过程中,我们将当前节点标记为已访问,并输出节点的值。在main函数中,我们创建了一个图对象g,并添加了几条边,然后调用DFS方法从起始节点开始进行深度优先搜索遍历。最后,我们公开了一个对外的DFS方法,它接受起始节点作为参数,并在该节点上调用DFSUtil方法进行遍历。

ByteWhisper的博客 334

Java实现深度优先搜索

图的遍历就是访问图中的每个节点并且每个节点只访问一次。但图中有那么多节点,要如何进行访问就是一个问题,所以我们需要有特定的策略来进行访问这些节点。我们将要访问的节点成为头节点,相邻节点称为表节点;头节点中存储数据和第一个表节点,表节点中存储头节点的下标和头节点的下一个相邻节点;从初始节点开始出发访问,访问该节点的第一个相邻节点,然后以该相邻节点为起点,继续访问其相邻节点,反复持续该过程直到图中所有节点已全部被访问;,注意:深度优先搜索的顺序不是唯一的,这取决于访问起点和表节点的顺序。在main方法中测试。

m0_52884709的博客 2423

恶意代码分析实战——使用Apatedns和Inetsim模拟网络环境

恶意代码分析实战——使用Apatedns和Inetsim模拟网络环境 注:本次实验主要是《恶意代码分析实战》一书中进入动态恶意代码分析篇章的开始,主要通过Apatedns以及Inetsim来模拟为恶意代码提供其需要的网络环境,本次实验以Lab01-03.exe为例。 一、实验环境及工具。 Vmware虚拟机:win10(win7)、kali 主要工具:Apatedns、Inetsim 二、工具的安装下载 1、Apatedns:需安装至windows虚拟机客户端(win10,win7均可) 下载地址:http

妙蛙种子吃了都会妙妙秒的妙脆角的博客 7935

DFS深度优先搜索—Java版

精讲深度优先搜索,模板即是思想,用模板无难题!

Cheney的博客 2351

机器视觉/将HIK海康面阵相机连接Halcon软件

本文简述了如何将海康面阵相机连接到Halcon软件中进行实时取图的过程。

Dahe.qu 4866

FOC无刷电机磁编码器机械角度与电角度自动对齐校准及电机极对数自动获取的方法

本文提出磁编码器机械角度与电角度自动对齐校准方法及电机极对数自动获取方案。通过通直流电流使转子定向,读取机械角度并计算电角度偏移量,实现精确对齐;同时利用低速旋转时检测反电动势过零点次数,结合机械角度变化量自动计算极对数。核心算法包括转子定向、偏移量计算、极对数推导等步骤,并提供了基于STM32的C语言实现代码。该方法适用于工业伺服、机器人等高精度控制场景,需注意负载安全、参数调整和误差处理。两种自动化流程可有效解决电机安装调试中的角度对齐和参数识别问题。

qq_29653575的博客 2484

深度优先搜索及java实现

深度优先搜索是图里面一种基础的搜索算法,英文简写DFS(depth First Search),深度优先搜索采用的方式是“”耿直boy型恋爱方式”--不撞南墙不回头,本文采用的图如下图所示: 下面是DFS优先搜索的java实现,涉及到图Graph类、顶点Vertex类: import java.util.ArrayList; import java.util.List; //图类 pu...

johnhuster的专栏 1332

解决usbisp不识别无法烧录Atmega328P,Arduino不识别问题

如果使用Arduino IDE里面的烧录,可能会遇到一个问题,就是不识别国产这种廉价的USBISP 点击烧录引导程序,会遭遇到找不到USB设备的问题,选哪个都会提示找不到,比如选择USBasp could not find USB device with vid=0x16c0 pid=0x5dc vendor='www.fischl.de' product='USBasp' 因此,我们需要使用到progisp这一个软件的1.72版本 选择好芯片的型号后,调用编译好的HEX文...

arenascat的博客 7436

java实现深度优先搜索 (DFS) 算法

度优先搜索(Depth First Search,DFS)算法是一种用于遍历或搜索图或树的算法。这种算法从一个节点开始,沿着一条路径尽可能深地搜索,直到遇到不能继续前进的节点时返回上一个节点,然后继续搜索其他路径。然后,我们实现了递归和迭代版本的DFS。递归版本的DFS使用了一个辅助函数DFSUtil来进行递归的深度优先搜索。在Main函数中,我们创建了一个具有6个顶点的图,并添加了几条边。接着,我们分别调用了递归和迭代版本的DFS来进行深度优先搜索。本示例中,我们首先创建了一个Graph类表示图。

小筱在线博客 1638

12.工具高级参数CogCalibNPointToNPointTool

CogCalibNPointToNPointTool是一种多点2D坐标校正工具,用于将图像像素坐标转换为物理世界坐标。该工具通过两组点(图像坐标点和物理坐标点)计算最佳转换关系,并将结果保存供后续使用。操作步骤包括获取图像、添加坐标点对、计算转换参数。校正结果会显示平移、缩放、旋转等参数及RMS误差值,较大的误差可能表明点位置不准确或自由度不足。该工具广泛应用于机器视觉领域,通过9点标定等案例可验证坐标转换的准确性并优化参数设置。

203

第 8 篇:TMC2240 电机正反转实现|DIR 引脚控制 + 代码优化(稳定不抖动)

本文详细介绍了TMC2240电机驱动芯片的正反转实现方法,重点解决方向切换时的抖动和冲击问题。文章首先明确了硬件连接、基础配置和使能状态三个前提条件,然后阐述了DIR引脚电平控制方向的核心原理,提供了STM32的GPIO配置代码。针对方向切换时的电流冲击问题,作者提出了"停止-延迟-切换-启动"的平滑切换逻辑,并给出了包含方向枚举、转速控制和方向切换函数的完整代码实现方案。通过这种优化方法,可以有效避免电机在正反转切换时产生的抖动、冲击声和发热问题,实现稳定的双向控制。文章还提示了后续可

BackCatK Chen的博客 2074

java实现深度优先搜索

package com.lishilin; import com.sun.istack.internal.NotNull; import java.util.*; public class Dfs { public static class Node implements Comparable<Node> { private String name; privat...

qq_41738049的博客 770

Sprd Android 13 备忘 OTA升级app没更新到目标版本,恢复出厂才生效修改这个值

【代码】Sprd Android 13 备忘 OTA升级app没更新到目标版本,恢复出厂才生效修改这个值。

m0_60898338的博客 679

深度优先搜索实现无向图环的检测(java实现)

一、问题描述 如何检测无向图中环?注意:本题中不考虑自环和平行环 二、解决思路 由于深度优先搜索性质,我们可以用它来检测环。假设当前访问顶点为v,访问v之前访问的顶点为prev,则prev为v的前驱节点。设w为v的后继节点,且w != prev并且w已被访问了,则可以判断图中存在环;假设第一访问的顶点的父节点为其本身,我们以图1 为例进行讲解: 第一步:我们先访问0号顶点,此时v = 0 , prev = 0,w = 1。满足w != prev,但不满足w以访问,继续执行下一步;如下图:

qq_39559641的博客 2221

【Python爬虫系列】_005.浏览器开发者工具(详解)

Elements(元素)分析当前页面节点,用来辅助书写BS或者XPath这里面的数据与源代码有区别,不一定准确(避坑)Console(控制台)这个除了查看错误信息、打印调试信息(console.log())、写一些测试脚本以外,还可以当作Javascript API查看用例如我想查看console都有哪些方法和属性,我可以直接在Console中输入"console"并执行后续学js逆向的时候需要用到Sources(源代码)与在网页页面,鼠标右键——查看网页源代码 内容一致。

weixin_50296259的博客 422

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

java 深度优先搜索多种实现方式_算法之深度优先搜索

戳上面的蓝字关注我们哦!本文作者:丹丘生文末阅读原文获取文中示例代码一、引言研究算法,写算法是很枯燥的过程;但是找到规律以及通用之处,会发现它是如此简单,如此妙不可言,前提是需要有耐心。本人不喜欢一上来就是扒拉扒拉一些概念然后弄个经典例题之后闪人。个人喜欢循序渐进,从小问题引出要用的算法;深度优先搜索和广度优先搜索是搜索算法里面比较基础的算法,理解以及实现非常容易,当然说归说,如何容易,且看下文。...

weixin_33246767的博客 873

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

深度优先搜索(DFS)算法:原理、应用与 Java 实现

深度优先搜索(DFS)是一种重要的图遍历算法,具有广泛的应用场景。通过递归或迭代实现,DFS 可以有效地探索图中的所有节点。

小L的博客 2481

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

(算法入门)基本图论-深度优先搜索之JAVA实现

DFS与BFS较为简单,是图论的基础。在以后的实验中,不管是动态规划、贪心算法、回溯法都会以DFS或BFS为基础,应当是我们每个人都要掌握的。 在这里分享一个关于DFS的JAVA实现算法。 深度优先搜索的算法描述如下: 从图中某顶点v出发: (1)访问顶点v; (2)依次从v的未被访问的邻接点出发,对图进行深度优先遍历;直至图中和v有路径相通的顶点都被访问; (3)若此时图

涂修竹的专栏 2750

深度优先搜索算法及java实现——针对无向无权图

图是一种比树更宽泛和复杂的数据结构,树只是图的一种特殊形式。图有很多种划分方式,针对不同的划分方式可以分为连通图/非连通图、有向图/无向图、带权图/非带权图等。图与树不同,树一般都有固定的结构,如二叉树,一个节点最多有两个子节点,因此可以通过在节点对象中添加两个属性用来存储子节点的引用(类似于边),以此方式实现二叉树。或者是用数组的方式实现数(也就是堆结构)。但是对于图来说,它的邻接顶点的个数是不...

ASN_forever的博客 2226

Java实现深度优先搜索和广度优先搜索

最近快要找工作了,复习了下数据结构,就想着

追梦少年 1090

Java深度优先搜索(DFS)算法实现

深度优先搜索是一种常用的图遍历算法,可以用于寻找路径、解决迷宫等问题。本篇博客通过Java语言实现了深度优先搜索算法,并展示了一个示例应用。希望读者能通过本文的学习,对深度优先搜索算法有一定的了解和掌握。

qq_31532979的贺公子之数据科学与艺术博客,致力于科技向善,拥抱开源,要用技术的影响力来领导团队,而不是威权和职位! 773

深度优先搜索的Python、JAVA、C++语言实现

具体讲解: Python的实现 转载至优快云博主 郭畅小渣渣 的《Python实现深度优先与宽度优先搜索算法》,侵权立删。 网址:https://blog.youkuaiyun.com/qq_40276310/article/details/80668401?depth_1-utm_source=distribute.pc_relevant.none-task&utm_source=distrib...

559

JAVA实现全排列深度优先搜索算法

参考《啊哈!算法》一书,P79页。 题目要求: 将N张牌放在N个桶里面,问有多少种放法?本质是全排列问题。 个人理解: 使用深度优先搜索方法,初始时不能理解为什么会产生回溯,个人理解为断点处的再执行。例如代码中使用函数递归,dfs(1)中调用dfs(2),dfs(2)中调用dfs(3)等等。 for(int i =1;i<=n;i++) { if(book[i] == 0) { arr[step] = i; book[i] = 1; dfs(step+1);

tzy_33220的博客 630

深度优先搜索(DFS)以及相应的java实现代码

深度优先搜索(Depth First Search,DFS) 主要思想 深度优先搜索是从起点开始,按照某种权重规则,选择优先级最高的路径,从而到达下一个结点,而后在上一步选择的基础上进行下一步优先级最高的选择,反复进行类似探索。 最终会遇到两种情况: 就是找到了终点(目标),即结束搜索 碰到了“绝路”,也就是前面没有路了。此时“回头”选择离此次最近的另外一条路(相当于我开始是一个方向走到头,发现没有路了,则返回到最近的分叉路口处选择另一条路。),再继续上述探索,如果直至最后回到起点,发现我已经没有未走过

pingfanderen5的博客 1421

用JAVA实现深度优先搜索

深度优先与广度优先搜索代码实现很相似,前者是利用了栈这种数据结构;而后者是利用了队列这种数据结构。下面看看代码是怎么实现的 /*****************************深度优先***********************************/      基本思路:   1、找到初始结点,标记,然后入栈;                           2、找到和初始

昌汉明的专栏 2382

使用Java实现的深度优先搜索(DFS)

visited.contains(neighbor)) {//如果邻接点未被访问过,则递归访问。//使用hashSet来记录已访问过的节点。//处理当前节点的逻辑。//实现的深度优先搜索(DFS)和广度优先搜索(BFS)算法的示例代码。//标记节点是否被访问过。//标记当前节点为已访问。//遍历当前节点的临节点。

m0_45127365的博客 422
上一篇: 股神
下一篇: java - 广度优先搜索 - 遍历树 - 持续更新
Longtermevolution
博客等级 码龄9年 113粉丝 249原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值