RAG模式到底有8种?还是9种?还是25种?

RAG分类总结 ✅ 实现成本低(仅需向量数据库+基础LLM)✅ 适用于简单事实型问答(如FAQ、知识库查询) 阅读详情

首先一句话通俗解释什么是RAG? 全称: Retrieval-Augmented Generation (检索增强生成) :RAG是一种结合信息检索与大语言模型生成的架构。

检索增强生成 (RAG) 是一种变革性的生成式人工智能架构,它将大型语言模型 (LLM) 与外部知识检索相结合,以生成更准确、更贴近实际且更具上下文相关性的响应。随着企业不断推进将生成式人工智能嵌入业务流程,RAG 提供了一种无需持续重新训练大型模型即可应对重大风险(包括信息错乱、知识陈旧和领域特定性)的方法。

RAG系统的组成部分:

图片

检索增强生成(RAG)

从宏观层面来看,RAG系统由三个模块组成:

查询编码器:对输入进行编码x转换为查询表示q用于检索相关文档。这可以是神经编码器,也可以是基于规则的模板。

检索器:给定查询q检索器获取文档的排名列表。d1,d2,…,dk来自语料库𝒞.寻回犬可能数量稀少(例如,BM25  (Robertson 等人,2009) ),密集(例如,DPR  (Karpukhin 等人,2020) )、混合型或生成型。

生成器:生成器对输入的条件x以及检索到的文件d我产生最终输出是这通常是一个预训练的Transformer模型(例如,T5  (Raffel等人,2020),BART  ( Lewis等人,2020a),GPT  (Brown等人,2020)

图片

检索增强生成(RAG)中的生成过程可以表示为对条件分布进行建模

x表示输入内容 (例如:问题或提示)

d表示从语料库检索到的文档 𝒞

y表示生成的响应内容

检索增强生成(RAG)框架通过文档检索,利用外部知识访问来增强大型语言模型(LLM)。

图片

检索增强生成 (RAG) 工作流程

RAG架构分类:根据现有系统的架构侧重点对其进行分类——检索中心型、生成器中心型、混合型和鲁棒性导向型设计

图片

当你在豆某包或者千某问上搜索,到2026年为止,RAG按照复杂与演进大致分为4类 :

1.Naive RAG(基础 / 朴素 RAG)

2.Advanced RAG(高级 RAG)

3.Graph RAG(图谱 RAG)

4.Agentic RAG(智能体 RAG)

也有说RAG可分类为:

1.Naive RAG (基础/朴素RAG)

2.Advanced RAG (高级RAG)

3.Modular RAG (模块化RAG)

btw:但是这种说法不一定准确哈

按照技术实现方式分为8种:

1.Naive RAG(基础)

2.HyDE(假设文档嵌入)

3.Corrective RAG(纠正式)

4.Self-RAG(自反思)

5.Graph RAG(图谱)

6.Hybrid RAG(混合:向量 + 关键词 + 图谱

7.Adaptive RAG(自适应:按查询复杂度动态选策略)

8.Agentic RAG(智能体)

更有甚者说是25种RAG架构:

1.Corrective RAG 纠错型RAG

2.Speculative RAG

3.Agenetic RAG

4.Self-RAG

5.Adaptive RAG

6.Refeed Retrieval Feedback RAG

7.Realm (Retrieval-Augmented Language Model) RAG

8.Raptor (Tree-Organized Retrieval) RAG

9.Replug (Retrieval Plugin) RAG

10.Memo RAG

11.Attention-Based RAG

12.RETRO (Retrieval-Enhanced Transformer) RAG

13.Auto RAG

14.Cost-Constrained RAG

15.ECO RAG

16.Rule-Based RAG

17.Conversational RAG

18.Iterative RAG

19.HybridAI RAG

20.Generative AI RAG

21.XAI (Explainable AI) RAG

22.Context Cache in LLM RAG

23.Grokking RAG: The Intuitive Learner

24.Replug Retrieval Feedback

25.Attention Unet RAG

图片

RAG 技术分层架构全景

后续会针对这25种RAG架构模式做详细介绍

本篇基于什么是RAG?RAG设计模式展开介绍 

下面详细介绍基于《Retrieval-Augmented Generation for Large Language Models: A Survey》这篇论文提到的三种RAG模式的实现方式:

A:Naive RAG 朴素RAG

步骤:加载->分块->嵌入->检索->生成

重点:简单相似度搜索 ,不进行优化

    from langchain.text_splitter import CharacterTextSplitter from langchain.vectorstores import Chroma from langchain.embeddings import OpenAIEmbeddings from langchain_openai import ChatOpenAI 
    # 1. 加载并分割数据text_splitter = CharacterTextSplitter(chunk_size= 500 , chunk_overlap= 100 ) texts = text_splitter.split_text( "文档内容在此处 " ) 
    # 2. 创建嵌入并存储到向量数据库中embeddings = OpenAIEmbeddings() db = Chroma.from_texts(texts, embeddings) 
    # 3. 检索文档retriever = db.as_retriever() 
    # 4. 使用 LLM 生成响应llm = ChatOpenAI(model= "gpt-4o" ) query = "什么是 LangChain?" docs = retriever.get_relevant_documents(query) context = "\n\n" .join([doc.page_content for doc in docs]) response = llm.invoke( f"Context: {context} \nQuestion: {query} " ) print (response)

    示例输出:

    输入查询: 什么是langchain?

    回复:“LangChain 是一个框架,用于构建将语言模型与向量数据库等工具相结合的应用程序,以实现检索增强生成 (RAG)。它简化了将数据集成到语言学习模型 (LLM) 工作流程中的过程。

    朴素RAG的局限性:

    阶段

    挑战

    检索阶段

    - 可能召回不相关的文本片段。- 受限于相似度计算,可能遗漏关键细节。

    生成阶段

    - 存在幻觉风险(编造事实)。- 可能生成不一致或冗余的回答。

    增强阶段

    - 难以将信息进行连贯整合。- 输出内容可能缺乏风格一致性。

    B. Advanced RAG 高级RAG

    步骤:预处理->多查询->检索->后处理->生成

    重点:增加查询优化、重新排名和上下文压缩

      from langchain.text_splitter import CharacterTextSplitter from langchain.vectorstores import Qdrant from langchain.embeddings import OpenAIEmbeddings from langchain_openai import ChatOpenAI from langchain.prompts import PromptTemplate from langchain.rerankers import Reranker 
      # 1. 预检索优化 🛠️ text_splitter = CharacterTextSplitter(chunk_size= 500 , chunk_overlap= 100 ) texts = text_splitter.split_text( "高级文档内容." ) 
      embeddings = OpenAIEmbeddings() db = Qdrant.from_texts(texts, embeddings)   # 使用 Qdrant 实现灵活检索
      # 2. 查询优化 🔍 query_variations = [     "解释 LangChain 概念." ,     "LangChain 的用例是什么?" ] “     LangChain 如何简化工作流程?” # 
      3. 检索和重排序 ✂️ retriever = db.as_retriever() all_docs = [] for query in query_variations:   # 多查询方法    docs = retriever.get_relevant_documents(query)     all_docs.extend(docs) 
      # 重排序结果reranker = Reranker() ranking_docs = reranker.rank(all_docs, query) 
      # 4. 上下文压缩 🔧 context = "\n\n" .join([doc.page_content for doc in ranking_docs[: 3 ]])   # 选择前 3 个文档
      # 5. 使用优化后的输入生成响应llm = ChatOpenAI(model= "gpt-4o" ) prompt = PromptTemplate.from_template( "基于上下文的答案:\n{context}\n问题:{query}" ) response = llm.invoke(prompt.format ( context=context, query= "什么是 LangChain?" )) print (response)

      优化索引:

      技术手段

      核心用途

      分块策略

       🧩

      将数据拆分为可管理的片段,以实现高效处理。

      数据清洗

       🧹

      去除噪声干扰,确保用于索引的文本片段具备高质量。

      多表示索引

       🗂️

      存储多种视角的数据(文本、语义向量),以更好地捕捉上下文信息。

      自查询检索

       🤖

      在检索前内部生成优化查询,以提升结果的相关性。

      父文档检索

       📖

      检索完整文档而非孤立片段,以实现更优的上下文整合。

      检索前优化与检索后优化的权衡取舍:

      流程

      优势

      劣势

      检索前 (Pre-Retrieval)

      ✅ 搜索速度更快。✅ 结果更聚焦,减少噪声干扰。✅ 实现更简单。

      ❌ 预处理成本高。❌ 灵活性受限。❌ 存在过滤掉有用数据的风险。

      检索后 (Post-Retrieval)

      ✅ 可灵活优化结果。✅ 支持纠错处理。✅ 能适配查询意图。

      ❌ 需要更多计算资源。❌ 依赖初始检索的质量。❌ 配置更复杂。

      C. Modular RAG 模块化RAG

      步骤:模块化设置->路由->动态查询->上下文融合->生成

      重点:支持特定任务模块、路由和内存集成

      优点:1.即插即用的咯灵活性2.动态查询处理3.任务特定精确度4.可扩展且面向未来

        from langchain_community.document_loaders import WebBaseLoader from langchain.vectorstores import Pinecone from langchain.embeddings import OpenAIEmbeddings from langchain.chains import RetrievalQA from langchain.prompts import PromptTemplate from langchain_openai import ChatOpenAI from langchain.memory import ConversationBufferMemory from langchain.retrievers.multi_query import MultiQueryRetriever 
        # 1. 模块化数据加载 🔄 loader = WebBaseLoader( "https://example.com/article" ) data = loader.load() 
        # 2. 灵活索引 📦 text_splitter = CharacterTextSplitter(chunk_size= 500 , chunk_overlap= 100 ) texts = text_splitter.split_documents(data) 
        embeddings = OpenAIEmbeddings() vector_store = Pinecone.from_documents(texts, embeddings) 
        # 3. 高级查询路由 🌐 multi_retriever = MultiQueryRetriever.from_llm(     retriever=vector_store.as_retriever(), llm=ChatOpenAI(model= "gpt-4o" ) ) 
        # 4. 特定任务提示 🎯 custom_prompt = PromptTemplate(template= """回答以下问题:{context}问题:{question}""" ) 
        # 5. 内存模块 🧠 memory = ConversationBufferMemory(return_messages= True ) 
        # 6. 动态问答链 ⚡ qa_chain = RetrievalQA.from_chain_type(     llm=ChatOpenAI(model= "gpt-4o" ),     retriever=multi_retriever,     memory=memory,     chain_type_kwargs={ "prompt" : custom_prompt} ) 
        # 7. 执行灵活管道响应 = qa_chain.run( "LangChain 的主要特性是什么?" ) print (response)

        模块化RAG的优势:

        特性

        优势

        可适应性 🔄

        可针对不同任务替换或重新配置模块,确保可扩展性与复用性。

        精准检索 🎯

        采用多查询扩展与自查询机制,提升检索准确率。

        任务专属优化 🛠️

        使流水线适配问答、摘要或知识图谱等专业化工作流。

        动态查询路由 🚦

        自动将查询路由至最相关的数据源与检索方法。

        记忆集成 🧠

        追踪多轮查询间的上下文历史,支持迭代优化与多步骤工作流。

        以下是 Modular RAG 在幕后所做的工作:

        1. 路由模块🚦 → 决定此查询是否需要网络搜索、内部文档或API 数据。
        2. 多查询扩展 🔗 → 生成3-5 个问题变体,以涵盖不同的角度。
        3. 并行检索 🔍 →同时在多个数据源(向量存储、API 等)中运行搜索。
        4. 重新排名📊 → 选择排名靠前的数据块,并删除重复或无意义的结果。
        5. 内存 🧠 → 检查过去的查询以获取上下文 — 此查询是否建立在先前的问题之上?
        6. LLM 答案 🎯 → 整合最佳信息并撰写最终回复——清晰、简洁、切中要点。

        步骤一:导入所需库

          from langchain.vectorstores import Qdrant   # 用于嵌入的向量存储from langchain.embeddings import OpenAIEmbeddings   # 嵌入模型from langchain.text_splitter import RecursiveCharacterTextSplitter   # 将文档分割成块from langchain.chains import RetrievalQA   # 检索增强生成 (RAG) from langchain.prompts import ChatPromptTemplate   # 提示模板from langchain.chat_models import ChatOpenAI   # 基于 GPT 的 LLM

          步骤二:设置模块化组件

            # 加载并准备数据text = "您的文档内容..."   # 替换为您的输入数据splitter = RecursiveCharacterTextSplitter(chunk_size= 500 , chunk_overlap= 100 ) chunks = splitter.create_documents([text]) 
            # 嵌入和向量存储embeddings = OpenAIEmbeddings() vector_db = Qdrant.from_documents(chunks, embeddings, collection_name= "modular_rag_demo" ) 
            # 检索器配置

            步骤三:多查询模块

              from langchain.prompts import PromptTemplate from langchain.chains import LLMChain 
              # 多查询提示query_template = """生成给定查询的三个变体:查询:{question}
              变体:1. ... 2. ... 3. ... """ prompt = PromptTemplate(input_variables=[ "question" ], template=query_template) 
              # 生成多查询扩展llm = ChatOpenAI(model= "gpt-4o" ) query_chain = LLMChain(prompt=prompt, llm=llm) query_variations = query_chain.run({ "question" : "总结2023年的气候政策" })

              步骤四:检索和排序数据

                # 检索每个变体的文档retrieved_docs =  [ ] for query in query_variations.split ( "\n" ) :     retrieved_docs.extend ( retriever.get_relevant_documents ( query ) ) 
                # 重新排序并压缩上下文context =  "\n\n" .join ( doc.page_content [ : 200 ] for doc in retrieved_docs )   # 压缩到 200 个字符

                步骤五:使用 LLM 生成输出

                  # 创建提示模板template = """上下文:{context}
                  问题:{question}
                  答案:""" chat_prompt = ChatPromptTemplate.from_template(template) 
                  # 生成回复response = llm.invoke(chat_prompt.format ( context =context, question= "总结2023年的气候政策" )) print (response)

                  输出示例📝

                  输入查询:
                  “总结2026年的气候政策。”

                  输出答案:
                  “2026年的气候政策重点在于推广可再生能源、制定更严格的碳排放法规以及达成国际气候协议,以将全球变暖幅度控制在1.5摄氏度以内。感谢您的提问!

                  refer: https://arxiv.org/html/2506.00054v1#S2

                  最后

                  从0到1!大模型(LLM)最全学习路线图,建议收藏!

                  想入门大模型(LLM)却不知道从哪开始? 我根据最新的技术栈和我自己的经历&理解,帮大家整理了一份LLM学习路线图,涵盖从理论基础到落地应用的全流程!拒绝焦虑,按图索骥~~
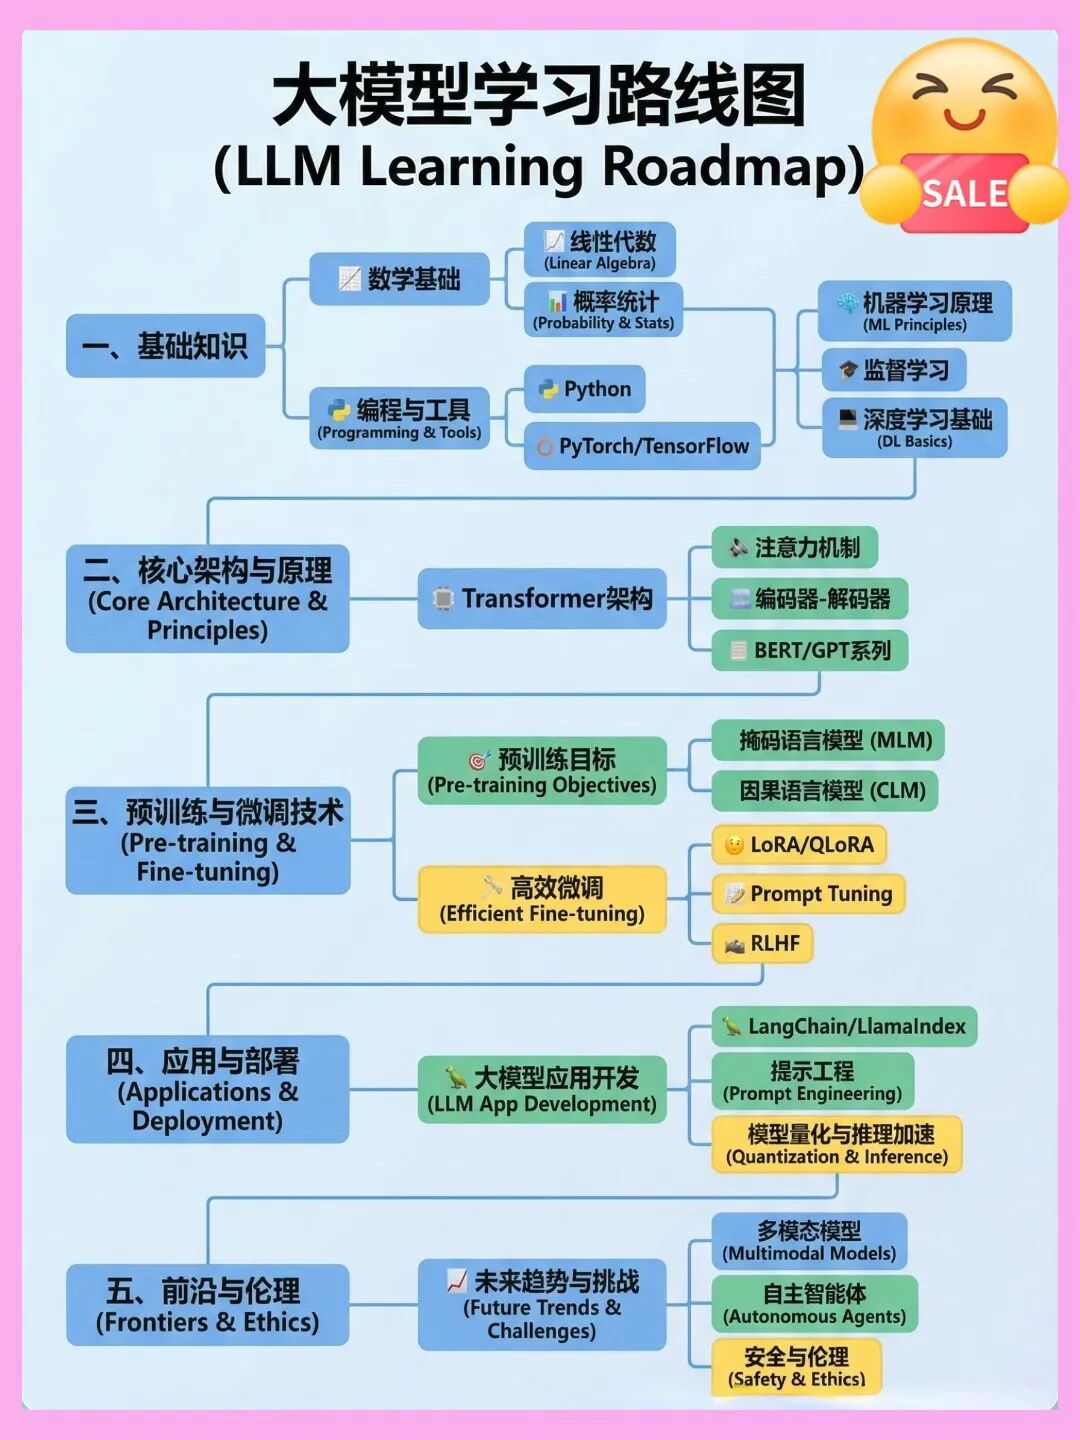
                  因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

                  因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

                  因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

                  因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

                  因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

                  因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

                  因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

                  BM25在RAG中的工程价值:轻量、可控、可审计的精准检索 BM25是一种基于词频-逆文档频率与文档长度归一化的经典关键词检索模型,其核心原理是通过TF、IDF和长度惩罚实现可解释的打分排序。相比黑盒语义检索,BM25具备零训练、低资源消耗、结果可追溯等技术优势,在事实型问答、结构化知识库、边缘部署及合规审计等场景中展现出不可替代的工程价值。尤其在RAG架构中,它常作为首层高效过滤器,与小模型(如Gemma-2B)协同构成‘精准召回+轻量生成’的高性价比流水线。本文聚焦BM25在真实LLM应用中的落地实践,涵盖中文分词适配、字段加权、索引优化及与agentic AI 阅读详情

                  相关推荐

                  BM42 vs BM25实战对比:Qdrant混合搜索在RAG系统中的性能提升实测

                  本文通过实测对比BM42与BM25在Qdrant混合搜索中的表现,揭示BM42通过注意力机制重构IDF计算逻辑,在RAG系统中实现高达18%的准确率提升。实验数据显示,BM42在短文本场景下显著优于传统BM25,尤其在Recall@100指标上提升19.7%。文章还提供了Qdrant混合搜索的实战配置和性能优化建议,助力开发者提升检索效率。

                  weixin_28256233的博客 221

                  大模型入门到进阶:什么是 RAG?为什么需要 RAG?RAG 的流程

                  学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频,免费分享!

                  star_nwe的博客 3万+

                  BM25+向量+重排序:企业级Hybrid RAG落地实战

                  混合检索(Hybrid Search)是提升RAG系统召回率与准确率的关键技术路径,其核心在于融合关键词匹配的精确性与语义向量的泛化能力。BM25擅长捕捉技术术语、时间、数值等结构化线索,而向量检索可理解同义替换、抽象描述等语义关系;二者协同需解决异构分数归一化、动态权重分配与干扰项清洗三大难题。重排序(Rerank)作为最终决策层,能显著抑制高分离题结果,提升Top-1答案命中率。本文基于真实企业场景,详解BM25与向量双路召回、归一化加权、轻量级reranker精排的端到端实现,覆盖中文分词优化、chu

                  baichuan9723的博客 463

                  大模型应用RAG系列(1)初识RAG

                  之前我们在讲大模型的应用方向和架构时,有提到RAG、Agent、Fine-Tune。在作者写大模型专题的文章时,也是边学习,边梳理,边总结。在这个过程中,大模型在各个方向都不断地快速发展,对应的paper、理论、方向也是不断地涌现出来。

                  AAI666666的博客 1803

                  (13-1)RAG基础知识介绍:RAG模型概述

                  RAG(Retrieval-Augmented Generation)是一种自然语言处理模型架构,旨在结合检索和生成两个关键的NLP(Natural Language Processing)任务。RAG模型可以应用于诸如问答系统、文本摘要、对话系统等多个领域。在本章的内容中,将详细讲解RAG的基础知识,介绍RAG技术的原理和架构知识,为读者步入后面知识的学习打下基础。

                  码农三叔 4478

                  LLM应用架构之检索增强(RAG,retrieval-augmented generation)的缘起与架构介绍

                  原创 ullyAI工程化收录于合集#领域技术13个#LLM应用架构3个动手点关注本文是LLM应用架构系列的第一篇,将介绍LLM应用开发里最常见的一种架构模式RAG( Retrieval Augmented Generation),它被广泛应用于知识问答,智能助手等常见LLM应用场景中。在后续文章中还将介绍该模式落地实际过程中的一些常见问题及改进思路,欢迎关注“AI工程化”,持续为大家更新。

                  具身机器人和通用AI 6722

                  Hybrid RAG实战:语义+BM25双轨检索系统搭建指南

                  RAG(检索增强生成)是当前知识问答与文档智能的核心范式,其效果高度依赖底层检索能力。纯向量检索虽能理解语义相似性,却在精确匹配术语、代码符号、法规编号、医学编码等离散关键词时严重失准;而BM25作为经典关键词检索算法,凭借词频与逆文档频率建模,在字面匹配上具备天然鲁棒性。Hybrid RAG并非简单拼接两种结果,而是通过归一化评分、动态权重策略与交叉验证增强,构建语义理解与关键词锁定协同互补的双轨机制。本文聚焦本地可部署的轻量级实现,覆盖文档分块适配、BM25 tokenization避坑、语义距离校准、

                  weixin_30954265的博客 358

                  高通camera:PDAF的配置与测试

                  确认相关log日志都已经打开了之后,判断是在3A算法中没有应用到PDAF,可能是之前在调试AF效果的时候关闭了PDAF,打开效果文件对应的文件夹,在\kamorta_lce_S5K3P9\Scenario.Default\XML\STATS。在log中搜索af_pdaf_proc_pd_single,这个函数是pdaf算法中的,源码被封装了,这里看不到,因此只能通过log打印出来的参数来分析pd是否正确,主要参数有pd ,defocus,confidence。PDAF的配置与测试。

                  arvin_xiong的博客 2487

                  RAG入门:一文搞懂向量RAG、BM25、知识图谱(GraphRAG)、SAG、PageIndex工作逻辑、演进

                  你可能看过很多关于RAG的文章,介绍某种新的技术、新的理念,都说要干翻RAG。 在我看来这大都是吸引人眼球的噱头,事实上这些很多都属于广义上的RAG。

                  m0_59164520的博客 171

                  SAR动目标检测三剑客:DPCA/ATI/STAP技术选型指南(含2023最新实验数据对比)

                  本文深入对比了SAR动目标检测三大主流技术DPCA、ATI与STAP的核心原理与性能差异。基于2023年最新实验数据,分析了它们在最小可检测速度、测速精度、计算复杂度及对通道失配敏感度等方面的优劣,并结合海洋监视与城市交通监控等典型场景,提供了具体的技术选型指南与工程落地考量。

                  m5n6o7的博客 294

                  Android 10 根文件系统和编译系统(十):Android.mk编译动态库

                  配套系列教学视频链接: Android 10.0 AOSP源码编译: 2-AOSP源码开发环境搭建 Android 10.0 根文件系统和编译系统: 3-Android根文件系统和编译系统 说明 系统:AOSP Android10.0 设备:Android模拟器 前言 本文章重点讲解Android.mk如何控制编译源码编译成动态库 ...

                  ldswfun的专栏 932

                  BM25 算法详解:从原理到代码实现,掌握搜索与 RAG 的核心检索技术

                  本文详细介绍了BM25算法,这是一种用于衡量查询与文档相关性的经典排序算法。文章从TF-IDF的局限性出发,指出BM25通过解决词频非线性增长、文档长度归一化和词语重要性差异三大问题,成为搜索引擎和RAG系统的核心检索技术。 核心内容包括: BM25的三大核心思想:词频饱和函数、逆文档频率和文档长度惩罚机制 完整数学公式解析及各参数含义 直观类比:将BM25比作严格的"老师打分系统" 代码实现示例,展示分词、建索引和检索流程 BM25通过平衡词频、文档长度和词语稀有度,实现了比TF-IDF更精准的相关性评估

                  zzzzz77777aaaaaa的博客 568

                  《从0到1:CTFer成长之路》书籍配套题目-[第二章 web进阶]文件上传

                  [第二章 web进阶]文件上传开始行动绕过第1个限制绕过第2个限制 介绍:记录一下笔记,方便以后迅速回忆使用。 《从0到1:CTFer成长之路》书籍配套题目,来源网站:《从0到1:CTFer成长之路》 先看一下题目源码: <?php header("Content-Type:text/html; charset=utf-8"); // 每5分钟会清除一次目录下上传的文件 require_once('pclzip.lib.php'); if(!$_FILES){ echo '

                  weixin_46703850的博客 3411

                  【BM25规模扩展研究技术解析】为何1000万Token后经典检索反超Agentic RAG

                  摘要 一项2026年的研究发现,当语料规模超过1000万Token时,传统BM25检索方法反超Agentic RAG系统,在600.8M Token的全规模语料上领先19.8分。研究采用28层严格嵌套的语料阶梯设计,控制变量探究检索范式的规模效应。结果显示:在小规模语料(1.7M Token)下File-System Agent表现最佳;但随着语料扩大,BM25凭借全局词法排序优势保持稳定性能,而Agentic RAG因路径探索困难导致准确率下降。研究指出,Agent推理更适合作为全局检索后的精排阶段,而非

                  独立思考,明辨是非 232

                  【C#程序员入门AI】AI应用的操作系统:Semantic Kernel 2026实战

                  用户ID用户信息

                  人工智能AI技术 1249

                  【Linux】Windows11 安装 WSL2 并运行 Ubuntu 22.04 详细操作步骤

                  Windows 11 安装 WSL2 和 Ubuntu 22.04 指南 本文详细介绍在 Windows 11 上安装 WSL2 和 Ubuntu 22.04 的完整步骤,包括: WSL2 与 VirtualBox 的性能对比优势 系统版本检查与升级方法 两种安装方式(一键安装和手动安装) Ubuntu 22.04 的安装与配置 存储位置管理及迁移技巧 常用 WSL2 命令速查表 文章还提供了性能优化建议和常见问题解决方案,适合开发者和 Linux 爱好者快速搭建高效的开发环境。

                  No8g攻城狮的博客 2万+

                  RAG(一):Agentic RAG、AUTO-RAG、ChunkRAG、FastRAG、Graph RAG、HtmlRAG

                  概述、Agentic RAG:类型、实现、其他;AUTO-RAG、ChunkRAG、FastRAG:架构、Graph RAG、HtmlRAG。

                  lonelymanontheway的博客 1339

                  【2026年华为暑期实习-非AI方向(通软&嵌软&测试&算法&数据科学)- 7月15日-第二题- 手机多载波冲突选择】(题目+思路+Java&C++&Python解析+在线测试)

                  摘要 本文提出了一种解决手机基站载波选择问题的回溯算法。给定N个载波,每个载波具有带宽和所属频段,要求选择最多K个载波,满足:1) 不选择同一频段的多个载波;2) 不选择冲突频段的载波;3) 总带宽最大化。算法通过预处理冲突关系,使用位掩码优化冲突检查,按编号顺序回溯枚举所有可能组合。当找到更大带宽或相同带宽但字典序更小的组合时更新答案。该方法在N≤25和K≤8的约束下高效可行,并通过样例验证了正确性。输出为最大总带宽和对应的最优载波编号序列。

                  m0_73659489的博客 71

                  【RAG过滤排序技巧】HiFi-RAG 超越Gemini NeurIPS25冠军

                  层次化过滤+大模型排序,Rag效果超过Gemini,实现性能与准确率的平衡。

                  weixin_37763484的博客 1414

                  WINCC7.3破解文件

                  WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

                  NTscan扫描工具

                  ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

                  RAG不要只靠向量检索!实战BM25+RRF混合检索解决政策文档数字、条款召回不准

                  传统纯向量检索擅长语义匹配,能够很好处理同义改写,但是面对政策文档中大量日期、数字、条款编号、申报材料名称这类精确实体时召回效果很差。 本文完整实现一套混合检索方案:使用 jieba 分词 + rank‑bm25 实现关键词检索,Milvus 提供向量语义检索,通过 RRF 倒数排名融合对两路检索结果合并排序;利用asyncio.gather并行执行两路检索,统一数据结构,增加 trace 全链路调试,编写独立测试脚本。兼顾语义理解与关键词精确命中,解决政策 RAG 召回不准的痛点。

                  FH000017的博客 589

                  LinePhone3.2.7(android端最新版本) sip客户端

                  SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

                  BM25检索原理与实战:轻量、可解释、CPU友好的RAG基石

                  BM25是一种基于词频、逆文档频率和文档长度归一化的经典信息检索模型,其核心原理在于通过TF饱和效应、IDF平滑计算和智能长度校准,在不依赖深度学习的前提下实现高精度关键词匹配。相比向量检索,BM25具备零GPU开销、毫秒级响应、完全可解释等显著技术价值,特别适用于FAQ库、产品文档、API手册等结构化知识场景。本文结合rank_bm25与Whoosh框架,详解从内存索引到磁盘持久的工程落地路径,并深入探讨其在RAG流水线中作为检索基座的关键作用——它不是过时的替代品,而是现代AI应用稳健交付的底层压舱石。

                  angel192939的博客 379

                  复分析 阿尔福斯(Ahlfors) 第三版答案 英文

                  答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

                  LLM之RAG理论(七)| 高提升RAG检索的四种方法

                  LoRA是大模型微调的技术之一,它来自论文《LoRA: Low-Rank Adaptation of Large Language Models》[9],基本原理是冻结大模型参数,在原始模型中添加少量的可训练参数AB矩阵来适应特定领域知识,由于微调的参数量较少,比较适合低资源的场景和用户。有时候直接对原问题生成答案效果不佳,这时我们可以通过要求LLM首先将用户的查询分解为子问题,然后,文档检索器可以检索每个较小的问题,这样可以提供更丰富的上下文。对于每个检索到的文档集,都会生成相应子问题的答案。

                  wshzd的博客 2391

                  【RAG】34-RAG优化方法:探讨RAG的优化策略,提升RAG性能的技术与策略

                  RAG优化方法是一种针对Region Adjacency Graph(RAG,区域邻接图)性能提升的系统性策略。本文将深入探讨RAG优化方法的核心技术和策略,为相关领域的研究者和工程师提供有价值的参考和指导。

                  rengang66的博客 620
                  上一篇: 台大李宏毅OpenClaw原理课来了!
                  下一篇: 2026智能体(AI Agent )面试&学习指南:100道高频真题,覆盖原理、工程、架构、应用
                  黑客大白
                  博客等级 码龄5年 1万+粉丝 3206原创
                  评论
                  成就一亿技术人!
                  拼手气红包6.0元
                  还能输入1000个字符
                   
                   条评论被折叠 查看
                  添加红包

                  请填写红包祝福语或标题

                  个

                  红包个数最小为10个

                  元

                  红包金额最低5元

                  当前余额3.43元 前往充值 >
                  需支付:10.00元
                  成就一亿技术人!
                  领取后你会自动成为博主和红包主的粉丝 规则
                  hope_wisdom
                  发出的红包
                  实付元
                  使用余额支付
                  点击重新获取
                  扫码支付
                  钱包余额 0

                  抵扣说明:

                  1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
                  2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

                  余额充值