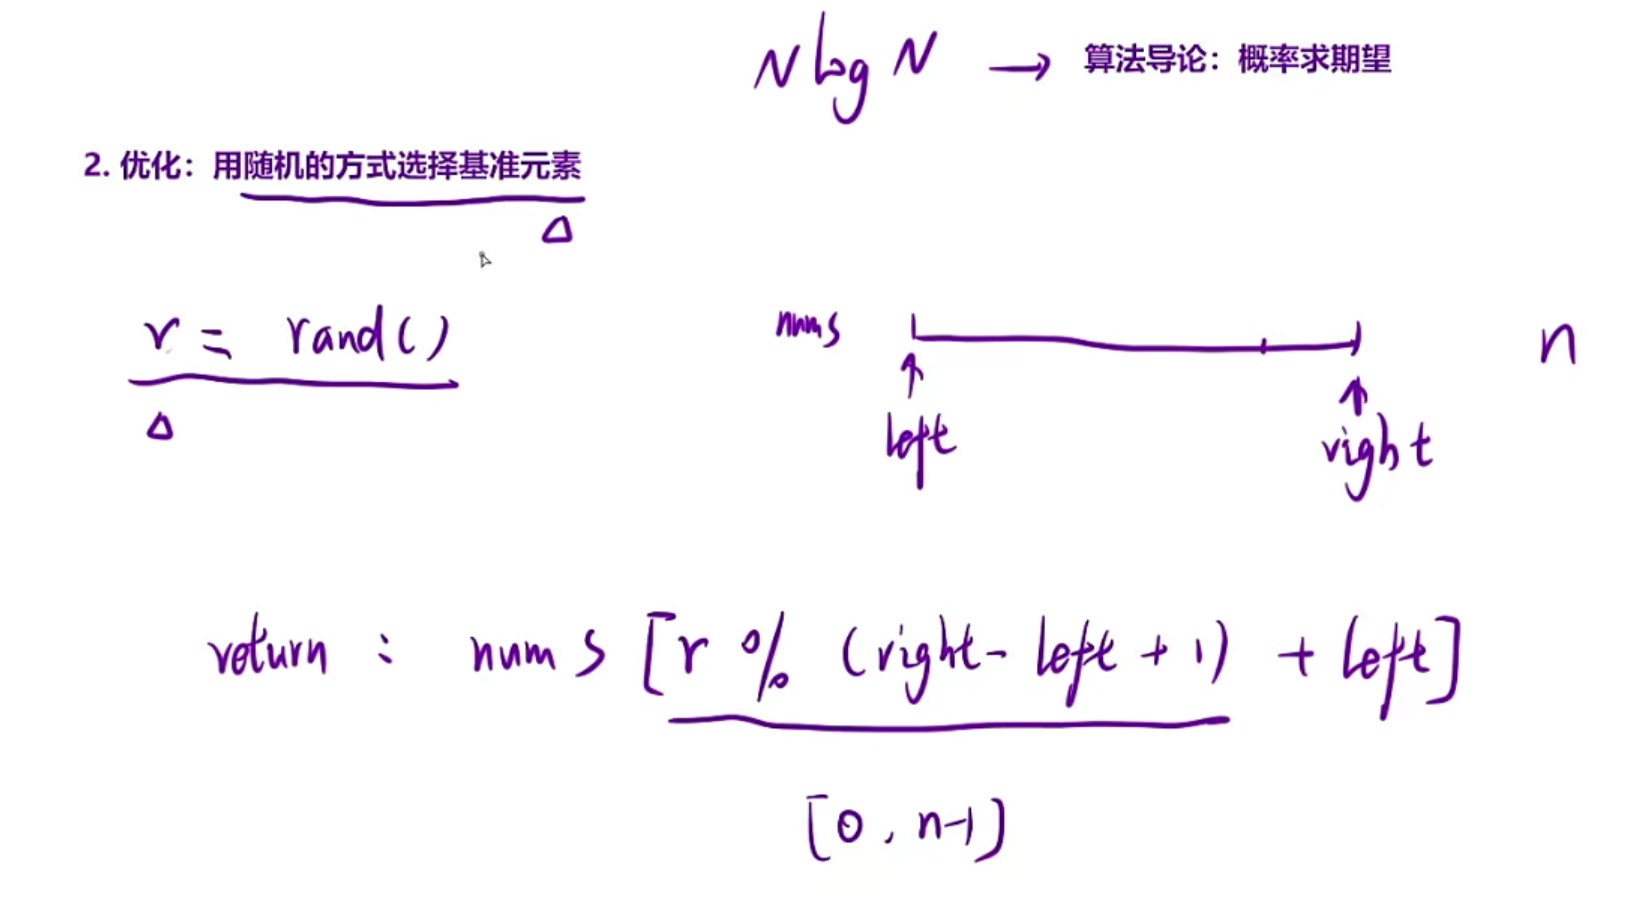
分治思想之快排优化:三分区防退化与剪枝降复杂度

Big O实战指南:从算法复杂度到线上性能瓶颈的精准诊断 Big O符号是描述算法随输入规模增长的渐近时间复杂度的核心工具,它剥离常数因子与低阶项,聚焦决定系统性态的最高阶增长规律。理解O(1)、O(log n)、O(n)、O(n log n)和O(n²)等常见复杂度的本质差异,有助于识别代码中的性能红区——例如嵌套循环隐含的平方级爆炸风险,或哈希表在哈希碰撞下的退化陷阱。其技术价值不仅在于理论分析,更在于驱动工程决策:指导索引设计、缓存策略、数据结构选型及近似算法引入。典型应用场景包括实时榜单聚合、共同好友计算、向量相似搜索等高并发、大数据量服务。本文以真实故障 阅读详情

摘要

对于分治,相信大家都不陌生,在数据结构精讲中的排序算法----快排和归并都运用到了这个思想,就是把一个大问题划分为相同或者相似的小问题,通过快速解决小问题从而达到解决大问题

分治策略通常分为三个阶段:

  1. 分解(Divide):将原问题拆分成若干个规模较小、结构与原问题相似的子问题;
  2. 解决(Conquer):递归求解子问题(若子问题规模足够小,则直接求解);
  3. 合并(Combine):将子问题的解合并为原问题的解。

这里由于leetcode的传统快排解决的时候数据可能会超时,此篇先复习快排,然后优化快排

对于优选算法第一篇中有个移动0其实就是运用了快排的思想,但是如果是移动0来完成快排的话可能会超时,因为数组仅仅被你划分成两部分(快排的时间复杂度为O(nlogn),但是如果有重复元素的话使用移动0的思想来划分数组时间复杂度会退化,因为你如果是重复元素的话,选择key的时候,划分完,所有的元素都相等,所以会跑到key的左边,然后数据全都在左边,又在数组中选key,所以依次循环下来时间复杂度为O(N^2),所以在leetcode一些特例当中是跑不过的,所以要有别的算法来优化一下)

声明:如果对快排不了解的可以去我的数据结构精讲当中了解一下排序算法

例题讲解

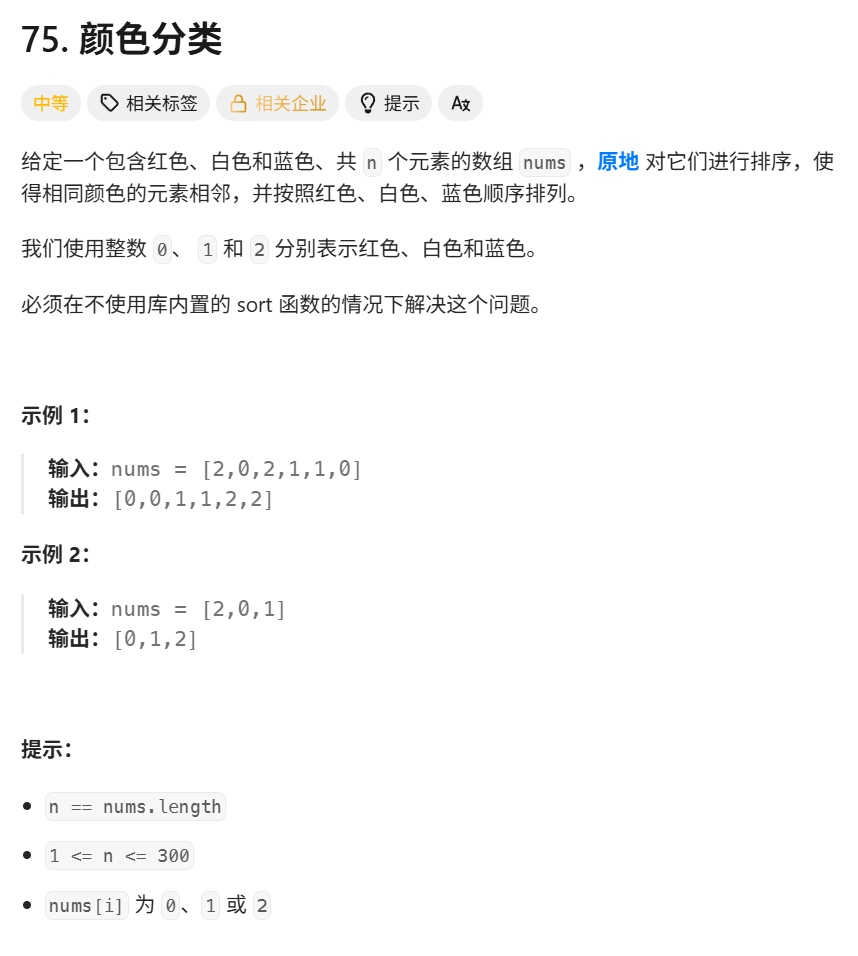
leetcode75颜色分类

通过这道题预先了解数组划分的思想,方便后续实现快排,这里的数组划分是分成了三块
算法原理讲解:

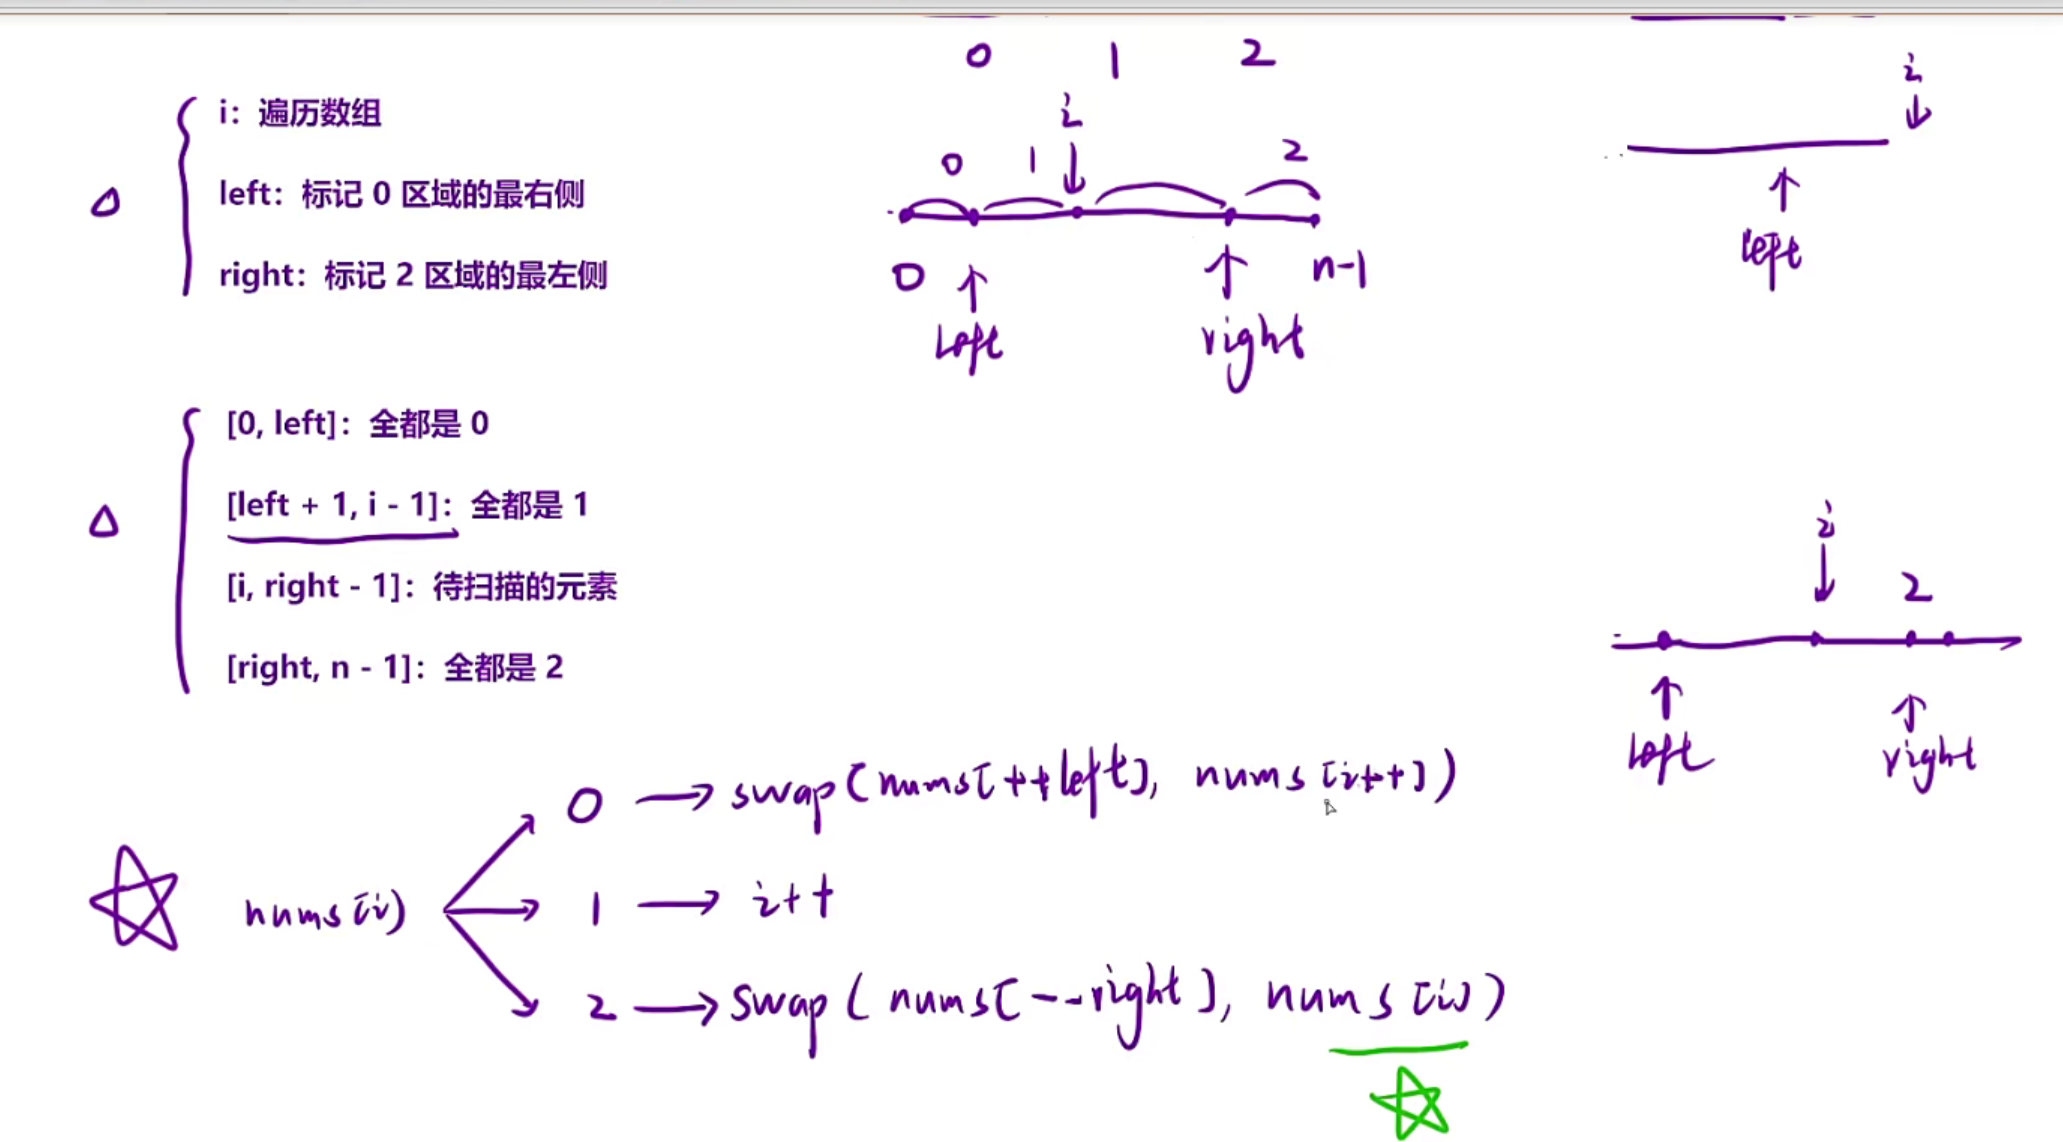
借用移动0的思想,可以采用三指针,即left right i指针,left标记左边区间  【0,left】的区域全是0

right标记右区间【right,n-1】全是2,自然中间【left+1,right-1】都是1,i指针就是遍历数组
细节问题

如果nums[i]==2,那此时是和--right进行交换,此时i不需要++,因为交换完之后,i位置的元素没有进行检查过

代码

class Solution {
public:
    void sortColors(vector<int>& nums) {
        int n=nums.size();
        int i=0,left=-1,right=n;
        while(i<right){
            if(nums[i]==0){
                swap(nums[++left],nums[i++]);
            }
            else if(nums[i]==1){
                i++;
            }
            else{
                swap(nums[--right],nums[i]);
            }
        }
    }
};

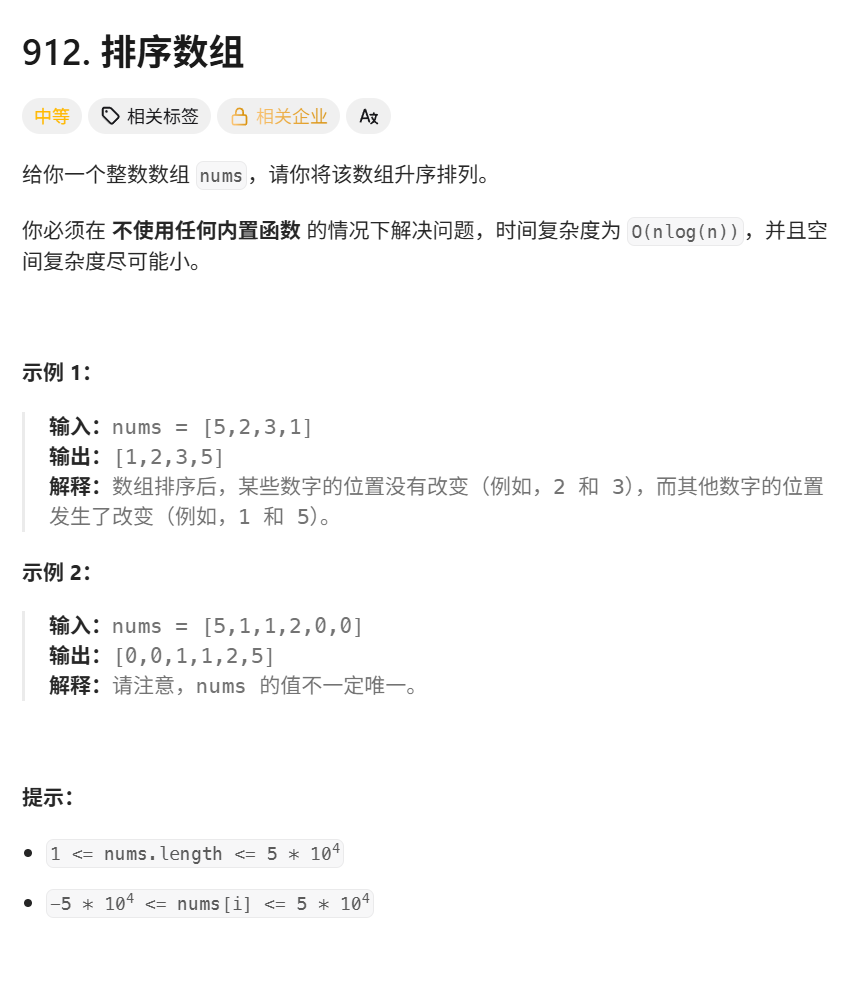
leetcode912排序数组

通过75例题的数组划分的思想来实现快排
算法原理讲解
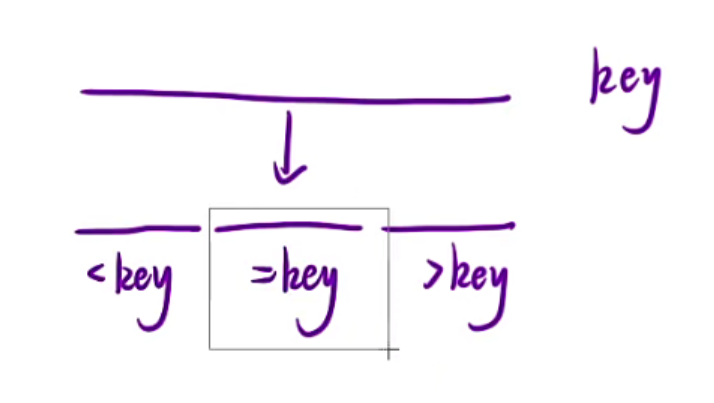
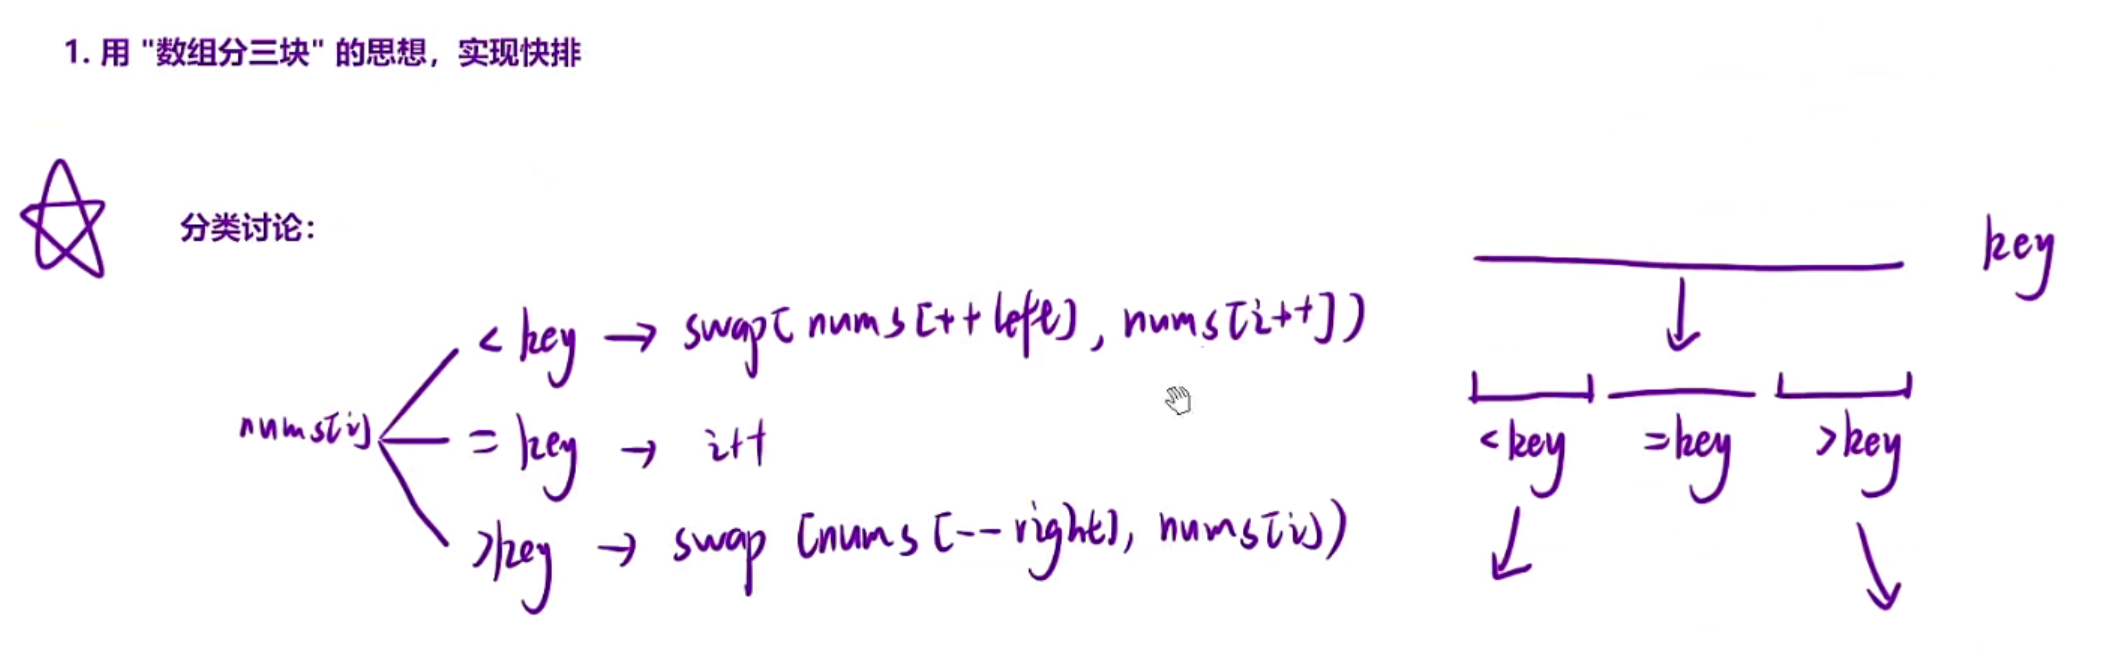
这里是使用三指针划分成三块,如果你是移动0那里就是划分成两快,左边<=key,右边>key,所以会导致如果是相同元素的话时间复杂度会退化,为什么使用三指针不会退化,原因就在于我们中间相等的区域是不会进行递归的,只递归左边和右边而已,所以如果你全都是相等元素,我左右两边区间递归进去直接就return了,此时时间复杂度仅仅为O(n)

选择一个key,然后划分成三部分区间,然后再依次递归左区间右区间即可
代码实现

class Solution {
public:
    // 生成 [l, r] 范围内的随机索引
    int randnumber(int l, int r) {
        return rand() % (r - l + 1) + l; // 正确生成 [l, r] 区间的随机索引
    }
    void sort(vector<int>& tmp, int l, int r) {
        if (l >= r)
            return;

        int key = tmp[randnumber(l, r)];

        int left = l - 1,i=l, right = r + 1;
        while (i < right) {
            if (tmp[i] < key) {
                swap(tmp[++left], tmp[i++]);
            } else if (tmp[i] == key) {
                i++;
            } else {
                swap(tmp[--right], tmp[i]);
            }
        }
        sort(tmp, l, left);
        sort(tmp, right, r);
    }
    vector<int> sortArray(vector<int>& nums) {
        // 先选择一个基准值,然后小于基准值的在区间左边,大于在右边
        // 随机选择基准值法
        srand(time(0));
        int n = nums.size();
        sort(nums, 0, n - 1);
        return nums;
    }
};

leetcode215数组中的第K个最大元素
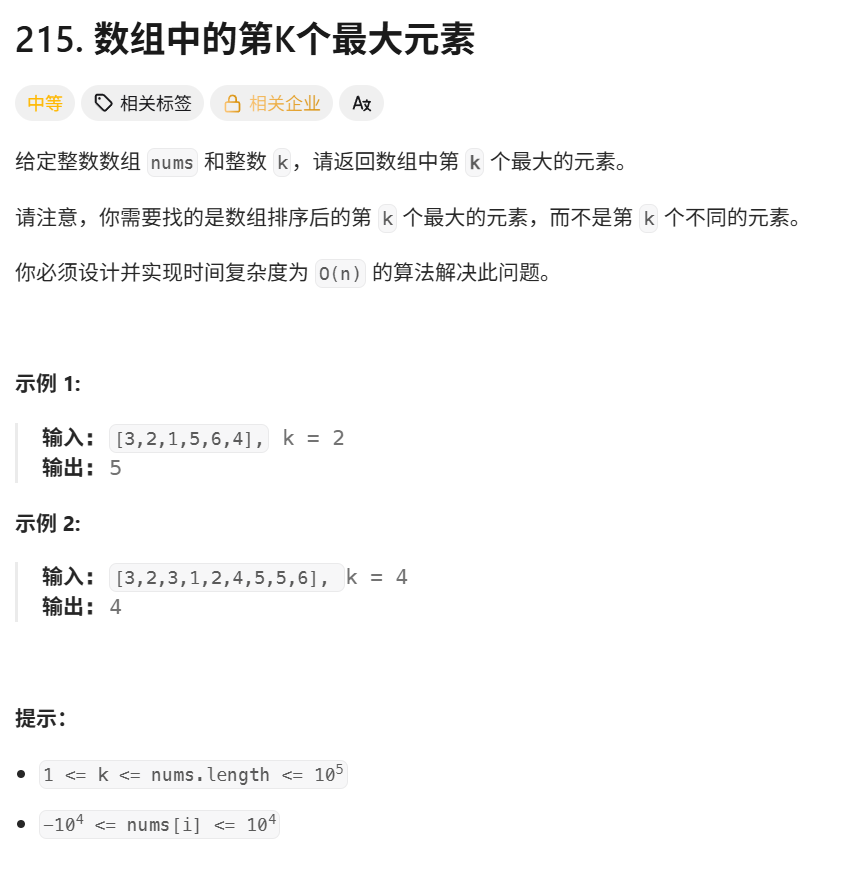
很明显topK问题再堆排序那里我们是学过的,但是这道题要求时间复杂度为O(N),对于我们熟知的算法,基本上是没有O(n)时间复杂度的算法,那此时就需要对排序算法进行优化

算法原理讲解

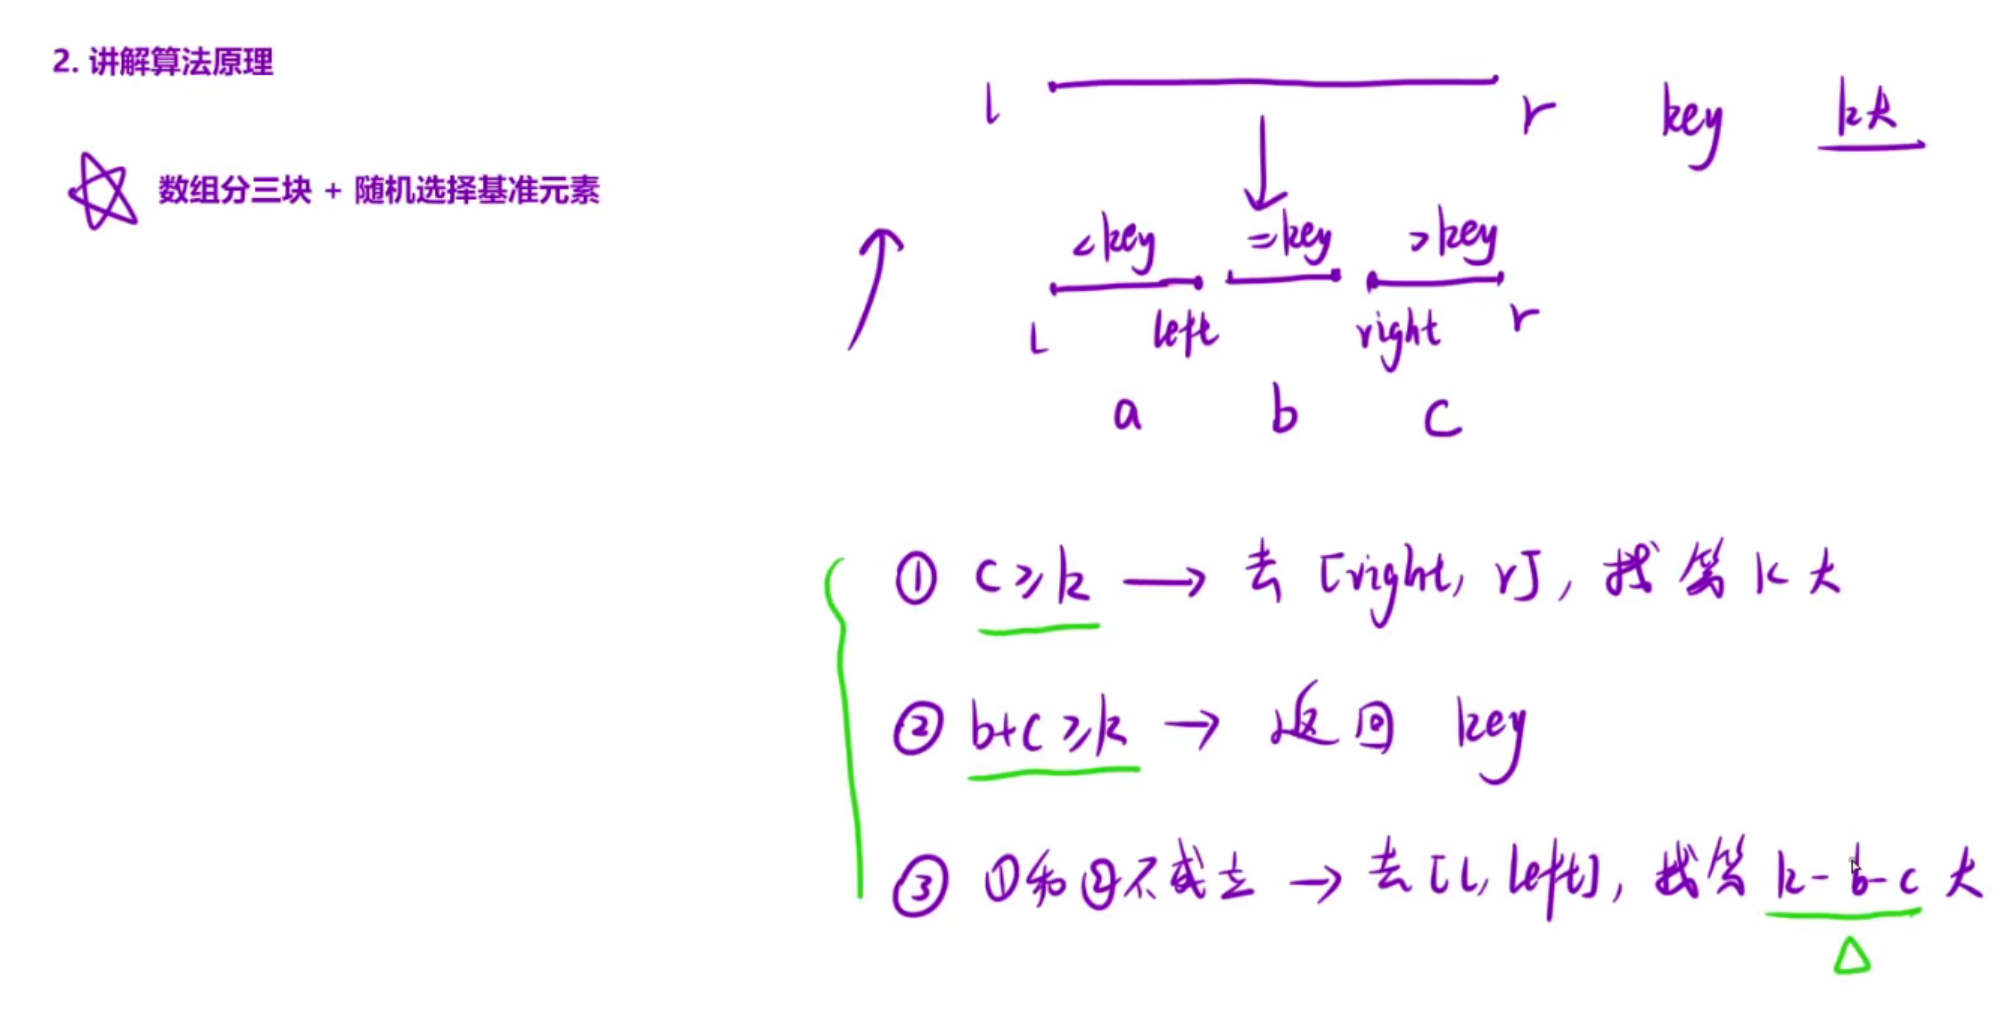
这里我们选择优化快排,对于快排前面几道题我们学过划分数组,采用划分数组+随机选择基准值的方法,这里的优化方案就是:在传统的快排当中我们需要递归左右两部分区间,这里仅仅需要判断一下第k大的元素可能在哪个区间,然后递归某一部分即可
代码

class Solution {
public:
    // 生成 [l, r] 范围内的随机索引
    int randnumber(int l, int r) {
        return rand() % (r - l + 1) + l; // 正确生成 [l, r] 区间的随机索引
    }
    int sort(vector<int>& tmp, int l, int r, int k) {
        if (l >= r)
            return tmp[l];

        int key = tmp[randnumber(l, r)];

        int left = l - 1, i = l, right = r + 1;
        while (i < right) {
            if (tmp[i] < key) {
                swap(tmp[++left], tmp[i++]);
            } else if (tmp[i] == key) {
                i++;
            } else {
                swap(tmp[--right], tmp[i]);
            }
        }
        // 此时已经划分好数组了
        if (r - right+1>= k) {
            return sort(tmp, right, r, k);
        } else if (r-left>= k) {
            return key;
        } else {
            return sort(tmp, l, left, k-r+left);
        }
    }
    int findKthLargest(vector<int>& nums, int k) {
        srand(time(NULL));
        int n = nums.size();
        return sort(nums, 0, n - 1, k);
    }
};

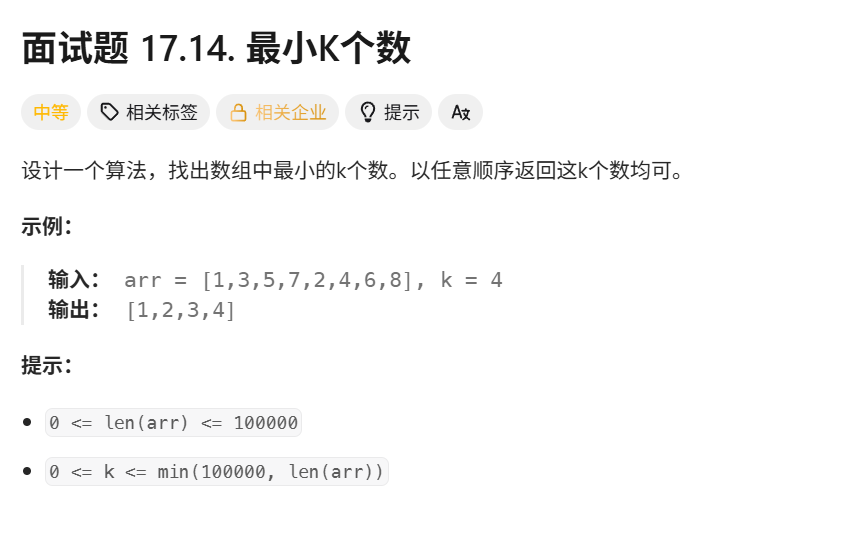
leetcode面试题17.14.最小的k个数
算法原理讲解:

1.直接排序+选数即可 时间复杂度O(nlogn)

2.堆 构建一个k个数的大堆  时间复杂度O(nlogK)

3.优化版-剪枝版快排   时间复杂度O(n)
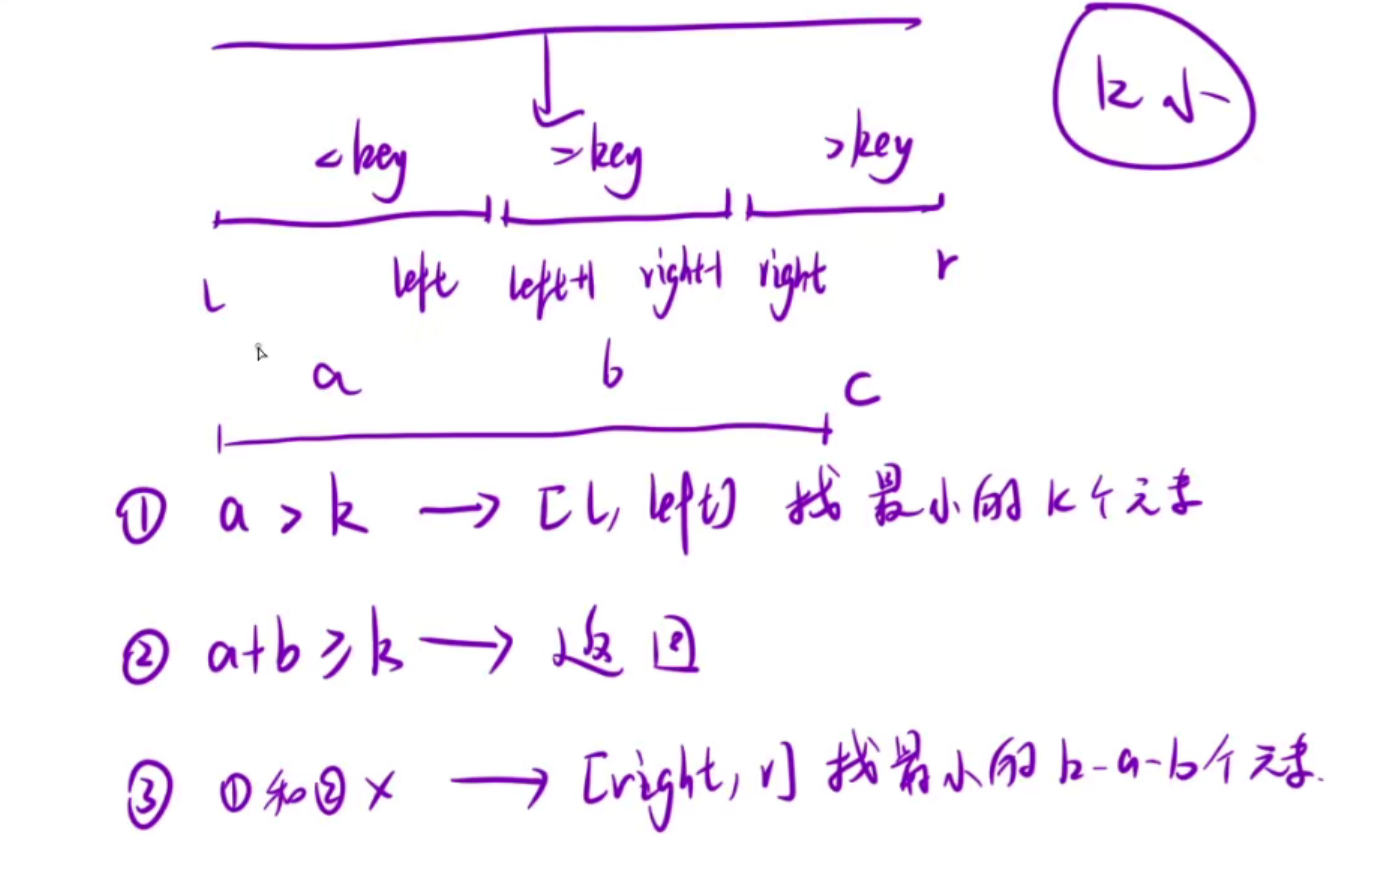
代码

class Solution {
public:
    // 生成 [l, r] 范围内的随机索引
    int randnumber(int l, int r) {
        return rand() % (r - l + 1) + l; // 正确生成 [l, r] 区间的随机索引
    }
    void sort(vector<int>& tmp, int l, int r, int k) {
        if (l >= r)
            return ;

        int key = tmp[randnumber(l, r)];

        int left = l - 1, i = l, right = r + 1;
        while (i < right) {
            if (tmp[i] < key) {
                swap(tmp[++left], tmp[i++]);
            } else if (tmp[i] == key) {
                i++;
            } else {
                swap(tmp[--right], tmp[i]);
            }
        }
        // 此时已经划分好数组了,升序
        int a=left-l+1;
        int b=right-1-left;
        if (a>= k) {
            sort(tmp,l,left,k);
        } else if (a+b >= k) {
            return ;
        } else {
            sort(tmp, right, r, k - a - b);
        }
    }
    vector<int> smallestK(vector<int>& arr, int k) {
        srand(time(NULL));
        int n=arr.size();
        sort(arr,0,n-1,k);
        return {arr.begin(),arr.begin()+k};
    }
};

总结

本篇主要是讲解分治的思想,通过快排来理解,快排的时间复杂度是O(nlogn),主要区分是分为三部分还是两部分(两部分时间复杂度可能会退化),在利用剪枝的思想去优化快排,不是递归左右区间,而是选择某一区间进行递归,时间复杂度变为O(N),具体的推导过程需要查看算法导论

  1. 三分区是快排防退化的关键:无论排序还是 TopK 问题,三分区能高效处理重复元素,是 leetcode 避免超时的核心。
  2. 剪枝递归实现 O (n) 时间复杂度:TopK 类问题(第 K 大 / 最小 k 个)无需完整排序,通过判断目标元素所在区间,仅递归单个子问题,总时间复杂度从 O (nlogn) 优化至 O (n)。
  3. 通用工具函数:随机生成 [l, r] 区间索引(rand()%(r-l+1)+l),需在入口函数中初始化一次种子(srand(time(0))),避免重复初始化导致随机数失效。

猿辅导算法岗笔试复盘:从基础算法到动态规划的进阶之路 算法面试与笔试的考察核心,往往不在于偏题怪题,而在于对基础数据结构和经典算法原理的深度理解。无论是字符串匹配中KMP的next数组推导,还是排序算法在不同数据规模下的复杂度权衡,都体现了扎实的基本功在工程实践与求职考核中的关键价值。动态规划的优化策略与贪心算法边界条件的判断,更是区分候选人能力层次的分水岭。这些技术原理广泛适用于在线教育、推荐系统、资源调度等真实业务场景,也是教育科技公司校招笔试的高频考察方向。本文从经典算法概念出发,结合笔试实战经验,系统梳理了算法岗笔试中的高频考点、解题策略与常见陷阱,帮 阅读详情

相关推荐

排序算法与动态规划空间压缩:面试高频题精讲

排序算法与动态规划是算法面试的两大基石。快速排序的分治思想、归并排序的稳定性、堆排序的TopK应用,构成了排序题的核心框架;而动态规划的空间压缩,则通过滚动数组分析状态依赖,将0-1背包、LCS等问题的空间复杂度从二维降至一维。理解这些原理不仅能应对面试中的变形题,还能迁移到工程实践——从MySQL的ORDER BY实现到Redis有序集合的底层设计,都离不开对排序与时空取舍的理解。本文从基础概念出发,梳理排序面试题的常见变形与动态规划空间压缩的思维跃迁,帮助读者构建从'能写出来'到'能写好'的算法能力。

weixin_33769125的博客 342

Big O时间复杂度实战指南:工程师的性能直觉养成

时间复杂度是衡量算法随数据规模增长而变化的数学工具,其核心原理在于抽象掉硬件、常数和低阶项,聚焦主导增长趋势。它并非理论空谈,而是支撑数据库索引优化、Redis缓存设计、前端虚拟滚动和高并发接口容量预判的技术基石。理解O(1)的摊还本质、O(log n)的二分魔力、O(n)的线性边界、O(n log n)的分治黄金律以及O(n²)的红色警戒线,能帮助开发者在写for循环前就预判系统瓶颈。尤其当面对哈希表退化、SQL执行计划误导、JS隐式O(n)操作或渲染重排开销时,Big O提供了一套去噪后的决策框架——让

weixin_33672109的博客 381

Android与Flutter算法面试全攻略:从KMP到LRU的避坑指南

数据结构与算法是移动开发面试中绕不开的基石,尤其在Android和Flutter岗位的考察中,面试官更看重候选人能否将基础理论灵活应用于工程实践。从数组、链表到二叉树,从哈希表、双指针到排序算法,这些经典知识点不仅出现在白板题中,更渗透在源码机制和渲染流程里。例如KMP字符串匹配如何高效解决文本检索,动态规划怎样优化重叠子问题,LRU缓存策略又如何支撑图片加载框架的内存管理——理解这些原理,才能应对面试官层层递进的追问。移动端算法面的出题逻辑并非追求竞赛级难度,而是围绕高频题型的变形与工程场景的结合。本文复

weixin_34110749的博客 393

分治:求第k小的数

非常值得多次复习的题目。有快速排序,最好记忆下来,时间复杂度为O(n log n)。通过三分区+三长度比较,确定第k小在哪个三之一。

2403_86817821的博客 253

LeetCode刷题实战指南:非科班程序员的算法进阶之路

动态规划之所以有效,是因为它避免了重复计算那些已经被解决过的子问题。这种“记忆化”特性正是区别于普通递归的关键所在。最优子结构(Optimal Substructure)指的是一个问题的最优解包含其子问题的最优解。例如,在最短路径问题中,从A到C的最短路径必然经过从A到B的最短路径(如果路径经过B)。这一性质允许我们通过组合局部最优解得到全局最优解。重叠子问题(Overlapping Subproblems)表示在递归求解过程中,某些子问题会被多次调用。以斐波那契数列为例:$$

weixin_30923011的博客 1082

C++继承与多态 - 继承多态原理01

C++继承多态原理讲解

大秦坑王的专栏 2978

C++ 分治 归并排序 归并排序VS快速排序 力扣 912. 排序数组 题解 每日一题

该文围绕力扣 912 题 “排序数组”,以归并排序为核心展开二刷解析。先说明二刷价值,即通过归并排序补充快排未覆盖的知识点,建立场景适配能力、拓宽算法优化思路并铺垫后续学习基础。接着阐述归并排序 “先拆分、再合并” 的原理,对比其与快排在分治顺序、遍历顺序等维度的差异。然后提供两种代码实现方案,分析临时数组复用策略及效率,还进行了时间和空间复杂度分析。最后总结归并排序要点,并预告下道相关题目。

Q741_147的博客 726

实战分享:如何用YOLOv5s+BIFPN高效检测隧道裂缝(附数据集获取)

本文详细介绍了如何利用YOLOv5s结合BIFPN(双向特征金字塔网络)构建高效的隧道裂缝智能检测系统。文章从高质量数据集构建、针对性数据增强、模型架构选型与调优,到工程化部署全链路进行了实战分享,旨在为基础设施自动化巡检提供兼顾精度与速度的解决方案。

weixin_29062823的博客 380

【优选算法篇】快速排序模型——从数组划分到快速选择

本文探讨了优化快速排序算法的关键技术:三指针划分与随机化基准选择。针对传统快排处理重复元素或有序数组时效率低下的问题,提出将数组划分为"小于"、"等于"、"大于"三块,并通过随机选择基准来避免最坏情况。文章以LeetCode题目为例,详细解析了三指针算法(荷兰国旗问题)的实现原理,并给出了万能快排模板代码。此外,还介绍了快速选择算法在O(N)时间复杂度内解决第K大元素问题的应用,通过数学归纳证明了其效率。这些优化技术显著提升了排序算法在各类场景下的性能表现。

半截诗的博客~ 488

给STM32F103的7寸屏找个新UI:LVGL 8.2裸机移植保姆级教程(附避坑清单)

本文详细介绍了如何将LVGL 8.2裸机移植到STM32F103开发板,特别针对7寸大屏(800×480分辨率)进行优化配置。从环境准备、工程搭建到显示驱动移植、内存优化与性能调优,提供完整的解决方案和避坑清单,帮助开发者快速实现美观的用户界面。

weixin_29181861的博客 413

408王道考研【数据结构】思维导图(章节详细可下载xmind文件)

由于图片太多,不一一放上来了,还有部分章节【查找、排序、B树B+树等】在百度网盘,可以关注我的公众号领取【完整的图片+xmind文件】,如想要获取xmind文件的同学可以关注我的个人公众号“小柒很爱喵”,回复“数据结构导图”,可获得以上导图原图和xmind文件(可修改导图内容、查看导图隐藏的笔记与备注,即上图带杠杠的地方是我进一步助于理解的解释)。 希望对你们...

weixin_41950078的博客 7988

十大排序总结

的复杂度,其中快排表现最好,是原址的不用开辟辅助空间,在内存中排序,但数据海量时空间开销大;堆排序也是原址的,但是常数复杂度因子较大,不具备优势,但适用于海量数据。如果不均匀,那么个别桶中的元素会远多于其他桶,桶内元素用比较排序,极端情况下全部元素都挤在一个桶中,会变成退化到。级别(k是最大数的位数)是整数数值型排序里既快又稳的,无论元素分布如何,只开放固定的辅助空间(10个桶),但是如果主元不是中位数,那么性能会大幅下降,特别的,如果每次主元都在数组的一侧,复杂度将退化到。

weixin_73453526的博客 973

用逻辑分析仪实测EM4095:125kHz RFID耳标解码的电压与脉宽玄学

本文通过逻辑分析仪实测EM4095芯片,深入解析125kHz RFID耳标解码中的电压与脉宽关联现象。揭示了供电电压对曼彻斯特编码脉宽的影响规律,并提供了一套可落地的调试方法论,包括信号链路解析、逻辑分析仪配置技巧及系统级稳定性提升方案,帮助开发者解决解码不稳定问题。

weixin_30629653的博客 328

工业级算法思维:从复杂度分析到真实场景选型

算法是程序员与计算机达成高效协作的底层契约,其本质不是数学推导或代码实现,而是对计算资源(时间、空间、能耗、可维护性)的系统性权衡。理解Big O不仅是掌握渐进复杂度,更是建立资源预算意识;选择红黑树还是跳表,取决于QPS、内存限制与调试成本的四维权衡;哈希去重、冷启动推荐、OTA分块升级等高频工程问题,背后都是数据结构与算法策略的精准匹配。本文聚焦真实工业场景,融合XXH3哈希、Fibonacci堆、Bloom Filter分层过滤等关键技术实践,揭示如何将算法从应试知识转化为可落地、可验证、可演进的工程

weixin_34166472的博客 754

ESP32-CAM实战:从零构建高精度QR二维码识别系统

本文详细介绍了如何使用ESP32-CAM构建高精度QR二维码识别系统,涵盖硬件配置、开发环境搭建、二维码识别库选择与优化、完整系统实现及实战问题排查。通过优化识别算法和电源管理,系统可实现快速、稳定的二维码识别,适用于物联网设备绑定等场景。

weixin_42524703的博客 433

三部对接 sora-2:OpenAI 最新视频模型快速接入指南

本文介绍OpenAI最新视频生成模型Sora-2的接入方案,重点解析其Chat格式调用功能。开发者可通过在提示词中嵌入"横屏/竖屏""时长""清晰度"等要求快速生成视频。文章分三部分:1)基础准备(环境配置与API密钥获取);2)核心调用(提供Python/Java示例代码);3)结果查询与优化建议。Sora-2支持多语言调用,简化了视频生成流程,适用于短视频、广告创意等场景。

2501_93565190的博客 3426

算法修炼二十一层:从数据结构到核心思想,构建程序员内功基石

在计算机科学中,数据结构与算法是衡量程序员技术深度的核心标尺,它们共同构成了软件系统的性能基石与设计灵魂。其原理在于通过精心组织数据(数据结构)和定义明确的操作步骤(算法),以最优的时空效率解决特定问题。掌握它们的技术价值巨大,不仅能提升代码效率,解决大规模数据处理难题,更是通过大厂面试、设计高性能系统的关键。从数组、链表等基础容器的理解,到递归、分治、动态规划等核心思想的运用,其应用场景贯穿于数据库索引、网络路由、推荐系统等几乎所有软件领域。本文以“练气二十一层”为隐喻,系统梳理了包括哈希表、二叉搜索树、

weixin_30432579的博客 311

scratch经典游戏主题源码分享,包含了20多款经典游戏

经典游戏案例:1、360度角度射击游戏 2、捕鱼达人 3、超级马里奥 4、超级玛丽 5、吃豆人相关 6、穿着喷气背包的海龟 7、大鱼吃小鱼 8、俄罗斯方块 9、飞机大战 10、愤怒的小鸟 11、黄金矿工 12、节奏大师 13、连连看 14、迷宫游戏 15、跑酷游戏 16、扫雷 17、水果忍者 18、坦克大战 19、推箱子 20、消除泡泡 21、保卫萝卜 22、植物大战僵尸

IT_Scratch的博客 1万+

2016年腾讯研发笔试题深度解析:算法与C++基础考点全覆盖

算法与数据结构是技术面试中衡量工程师基础能力的核心标尺,也是解决复杂工程问题的底层工具。理解数据结构的特性、算法复杂度的分析方法及C++底层实现原理,能帮助工程师在系统性能调优和线上问题排查中做出更精准的取舍。实际业务中,快排思想可优化海量数据排序,动态规划模型能抽象业务逻辑,栈与哈希表则支撑着函数调用和频次控制等高频场景。通过剖析经典笔试题的解题思路与隐藏评分点,能够系统梳理算法思维与工程实践能力。2016年腾讯研发工程师笔试题正是一套覆盖算法、数据结构、C++与操作系统的经典题目,至今仍极具参考价值,值

cuiji1279的博客 363

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

算法探秘:从最小K个数到恢复空格的思维跃迁

算法是数字时代的炼金术,它能在数据矿脉中提炼真金(最小K个数),也能在混沌字符中重建秩序(恢复空格)。今天,我们将拆解两大经典问题:一个考验高效筛选的智慧,一个挑战动态规划的巧思。无需一行代码,仅凭逻辑推演和思维实验,带你感受算法设计的艺术之美!给定一个包含正整数、负整数和0的数组,要求找出其中最小的K个数。返回的结果可以是任意顺序。1. 问题本质与核心挑战目标:在无序数组中高效提取最小的k个元素。痛点:当数组规模达 10^5 时,暴力排序(O(n log n))将消耗巨额算力。专业视角:本质是选择问题(S

司徒鸿的博客 1068

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

2019算法岗笔试复盘:数据结构、机器学习与工程算法高频考点全解析

算法工程师校招笔试的底层逻辑始终围绕数据结构、算法设计与机器学习原理展开,从KMP的next数组推演到堆排序的复杂度分析,从KL散度与ELBO的概率推导到PID控制与卡尔曼滤波的状态估计,命题趋势强调对基础原理的深度理解而非简单调用。在备战算法岗位时,理解贪心、动态规划、粒子群与模拟退火等经典算法的适用边界,掌握XGBoost、反向传播、BM25等模型的核心思想,能够显著提升解题效率。本文基于2019年校招真题复盘,梳理高频考点、常见变形与避坑经验,帮助备考者建立相互关联的知识网络,从容应对笔试中的推导题与

weixin_34037515的博客 684

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

工程师必备核心算法:从排序查找到动态规划的实战指南

算法是计算机科学的核心,它通过一系列明确的指令解决特定问题,其效率直接影响软件性能。理解算法原理,如分治、动态规划、贪心等思想,是优化程序、设计高效系统的基石。在工程实践中,数据结构与算法相辅相成,哈希表以空间换时间实现快速查找,堆(优先队列)高效管理优先级,而图算法则解决了路径规划与依赖调度等复杂问题。这些技术广泛应用于搜索引擎、推荐系统、实时计算等场景。本文聚焦于开发中最常遇到的算法,例如快速排序、二分查找、双指针、滑动窗口、动态规划、回溯以及并查集,并结合哈希表、堆等数据结构,深入剖析其核心思想、实现

weixin_34293911的博客 276

小米校招算法工程师笔试题全解析:从KMP到机器学习

算法工程师的校招笔试不仅考察代码能力,更检验对数据结构与机器学习原理的深度理解。以KMP算法为例,next数组的推导体现了对字符串匹配本质的掌握;而排序算法的变种、链表边界处理,则是工程实现的基本功。在机器学习部分,聚类算法、KNN、粒子群优化等概念的高频出现,说明岗位要求候选人既能理解模型假设,又能解释损失函数的设计逻辑。这类题目旨在筛选具备扎实理论基础与实战问题拆解能力的候选人。本文以小米2020校招算法工程师笔试题为例,逐题剖析考点与解题思路,帮助求职者构建从基础算法到模型优化的完整知识体系,并应对笔

weixin_34211761的博客 342

2025阿里算法岗面试高频题解析与备战策略

算法面试中,对基础原理的深度理解往往比刷题数量更重要。以KMP算法为例,next数组的构建体现了利用已知信息避免重复计算的核心思想;而KL散度与ELBO的推导,则是理解VAE等生成模型损失函数的关键。从经典算法到机器学习理论,再到PID控制、粒子群优化等工业界常见算法,这些知识点共同构成了算法工程师的底层能力框架。它们不仅应用于搜索引擎、推荐系统、AI内容生成等实际业务场景,也正成为大厂筛选中考察候选人思维深度的高频切入点。理解从概念到原理再到技术价值的完整链条,能帮助求职者更好地应对系统设计、模型推导与业

weixin_34279246的博客 342

算法工程师面试实战:从KMP到XGBoost的高频考点全解析

在算法工程师的面试中,数据结构与算法的底层原理始终是核心考察点。以字符串匹配为例,KMP算法通过next数组避免回溯,将时间复杂度降至线性,这类经典算法的变体考察往往贯穿全程;而面对海量数据场景,Dijkstra堆优化、Top K堆解法等技巧则考验候选人的工程优化思维。在机器学习领域,从GBDT到XGBoost的演进体现了对损失函数二阶近似的价值,粒子群算法等群智能优化也为非凸问题提供了启发式方案。在业务落地中,Redis分布式锁、Kafka消息队列及规则引擎Rete算法等中间件技术,成为评估工程能力的重要

weixin_29973493的博客 689

算法修炼十八层:从数据结构到核心算法,程序员入门心法全解析

在计算机科学中,数据结构与算法是构建高效程序的基石。数据结构如数组、链表、哈希表等,定义了数据的组织、存储与访问方式,其核心原理在于通过特定的逻辑结构管理内存,以实现对数据的快速增删改查。掌握这些基础结构,能显著提升程序性能,是解决实际工程问题的关键。算法则是在数据结构之上,定义了一系列解决问题的清晰指令,如排序、查找、递归和动态规划等,其价值在于以最优的时空复杂度处理数据。这些技术广泛应用于搜索引擎、推荐系统、数据库索引及网络通信等场景。本文以“练气十八层”为隐喻,系统拆解了算法入门必须掌握的十八个核心基

weixin_30466039的博客 388
上一篇: 排序算法:高效数据处理的核心
下一篇: 分治-归并:高效解决逆序对问题
Fcw0551
博客等级 码龄2年 330粉丝 115原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值