通用4D世界模型NeoVerse面世:单目视频秒变4D大片,推理提速8倍

导读: 想象一下,只需要一段普通手机拍摄的单目视频,AI就能瞬间为你构建出一个可交互、可编辑、可全视角观看的4D世界。

近日,来自中科院自动化所(CASIA)与CreateAI的研究团队联合发布了最新的通用4D世界模型——NeoVerse。该模型彻底打破了以往4D建模对专业多视角数据或复杂位姿预处理的依赖,通过学习互联网上100万条“野外”单目视频,实现了从视频重建到高保真生成的跨越式进化。

一、论文概述

论文名称:NeoVerse: Enhancing 4D World Model with in-the-wild Monocular Videos

项目地址:https://neoverse-4d.github.io/

论文链接:https://www.lab4ai.cn/paper/detail/reproductionPaper?utm_source=csdn_neoverse&id=b0ed5cd25f0249c187a6bcfefae16673
NeoVerse 的思路是把这件事做成一条可规模化的训练范式,让模型能够利用海量野外视频持续变强。

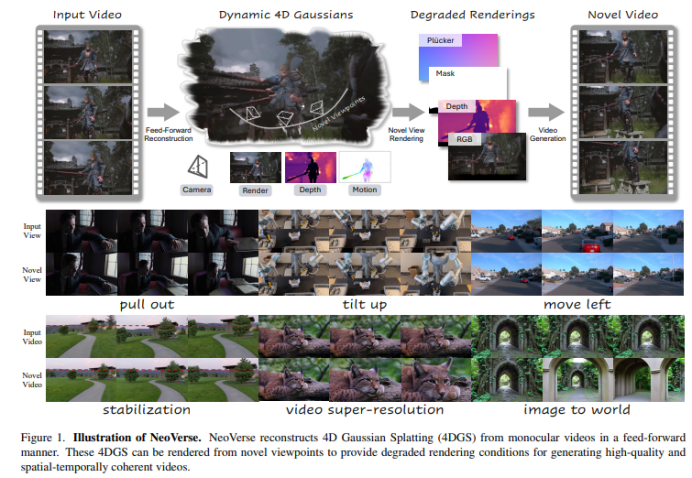
论文在 图 1 给出清晰的流程:先前向重建动态 4D 高斯表示(4DGS),再从新视角渲染得到低质量的退化渲染,将其作为条件输入生成模型;训练时以原视频作为目标,使生成模型学会从低质量新视角渲染生成高质量的新视角结果。
二、为什么需要 NeoVerse

4D 世界模型是融合3D 空间维度(长、宽、高)与 1D 时间维度的场景建模技术,核心是对动态场景进行时空一体化表征,既还原三维空间结构,又捕捉时间维度的运动变化,实现对真实世界的动态数字化复刻。

为什么之前的 4D 世界模型很难利用到海量野外视频?论文认为有两大原因:

  1. 数据可扩展性有限:不少工作依赖难采集的多机位动态数据,导致泛化与能力上限被数据类型锁死。

  2. 训练可扩展性有限:另一类方法需要繁重的离线预处理(例如离线深度、离线重建、额外 3D 检测等),这会导致计算负担重、训练方案僵化。

NeoVerse 的核心思路就是针对这两点“对症下药”:把整条从重建到生成的训练pipeline设计为可扩展、可端到端的形式,使模型能够直接利用“廉价且多样”的野外单目视频持续学习,而不是被数据形态或离线流程拖住。

三、核心技术

总体框架

如果只靠生成模型直接从单目视频“脑补”新视角,为什么容易漂、闪、细节虚?

NeoVerse 的策略是把任务拆成两步:先用重建端给出一个几何上自洽的动态世界骨架(4DGS),再用生成端把“骨架渲染出来但有缺陷的画面”提升成高质量视频。

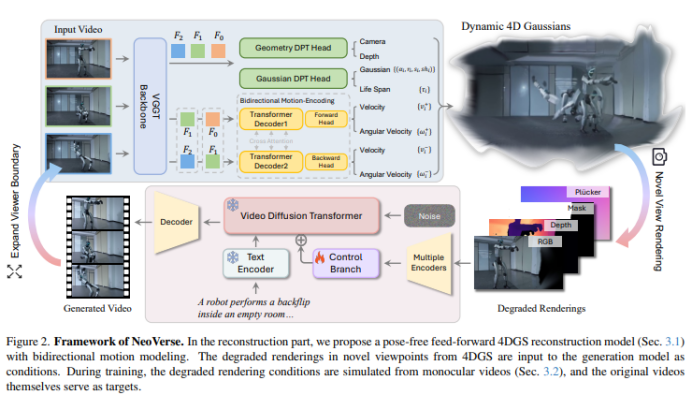
图 2 讲的就是这条链路:重建端是 pose-free、feed-forward 的 4DGS 重建;生成端把 4DGS 在新视角渲染得到的 degraded renderings(退化渲染)作为条件输入扩散模型;训练时用“退化条件→原视频帧”为监督对,使模型学会从低质量渲染生成高质量结果。
为什么要“双向运动建模”

很多人会直觉认为:动态重建只要“逐帧估”就行。但单目视频里最难的是时间一致性:既要让物体在 t→t+1 连贯,也要让它在 t→t−1 同样合理,否则中间帧插值会抖、会错位。

论文解释得很明确:他们显式区分 t→t+1 与 t→t−1 的瞬时运动,用双向预测来服务“时间插值”(而不只是为了多一个分支)。 公式 (1) 表明,把帧特征沿时间切成两段,分别做一次 Cross-Attention,得到前向 motion feature和后向 motion feature,分别刻画“往前一帧怎么动”和“往后一帧怎么动”。
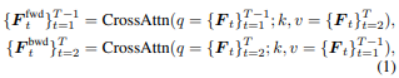
公式 (2) 表明,每个高斯点不只是“位置/旋转/尺度/颜色”这种静态属性,还带着双向线速度

$$v_i^+,\ v_i^-$$,双向角速度$$w_i^+,\ w_i^- $$,以及一个生命周期$$\tau_i$$。这意味着:模型不仅知道“点在哪里”,还知道“它往前/往后会怎么走”,并且知道“这个点在时间上该持续多久”。

训练为什么能更快

这里的关键不是“少算几帧”,而是:少算的同时还要保证时序正确。论文里说得很清楚:长视频若逐帧在线重建会成为训练瓶颈,所以只取 K 个关键帧做重建输入,但渲染覆盖全部 N 帧,因为渲染比网络计算高效。

那非关键帧怎么来?公式 (3)(4)(5) 的意义是:用双向速度/角速度把关键帧的高斯“平移/旋转”到任意时间戳(默认短时间内运动近似线性)。

尤其公式 (5) 里的$$\tau_i$$很重要:它控制 opacity 的衰减,让高斯点在时间上自然淡入淡出,避免某些点突然出现/消失造成闪烁;论文中同时解释了 $$\tau_i-1$$时衰减几乎没有,否则,$$\tau_i$$ 衰减迅速。
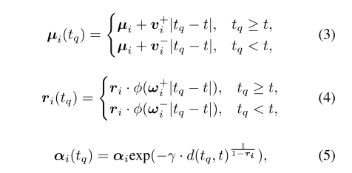
没有多视角真值,训练对从哪来?

单目视频没有多视角 GT,生成模型凭什么学会“把新视角渲染变好”?

生成模型需要学习“从低质量新视角渲染到高质量新视角”的映射,因此必须构造这种训练对;多视角数据好办,但野外单目视频就得自己模拟退化。

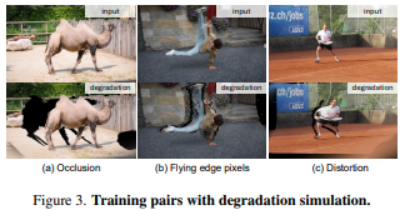
图 3 画的三类退化不是随便挑的,它们基本对应单目重建/渲染最常见的错误形态:

遮挡缺失(图 3 - a):用深度判断从新轨迹看哪些高斯不可见,直接裁剪掉再渲染回原视角,得到“该缺的地方缺掉”的遮挡退化。

飞点与畸变(图 3 - b、c):先在新轨迹渲染深度并做平均滤波,再按滤波深度调整高斯中心;渲染回原视角会出现边缘飞点,滤波核更大还能模拟更宽的畸变。

这一步的价值在于:它让模型见过“野外单目重建真实会出现的坏条件”,训练就不再依赖昂贵的多机位数据,从而更可规模化。
生成端为什么“既听镜头指挥、又能修伪影”

要让扩散模型真正“听懂镜头轨迹”,仅有 RGB 远远不够。论文把条件做成多模态:RGB、Depth、由 opacity 二值化的 Mask(指示空洞区域),并额外计算 Plücker embedding 来显式提供 3D 相机运动信息。

然后引入一个控制分支来注入这些条件,并且训练时只训练控制分支、冻结原视频生成模型——这样做一方面为了训练效率,另一方面让整个方案能接入更强的蒸馏/LoRA 加速生成。

四、实验与应用

重建效果

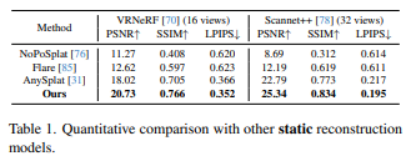
先明确一点:这里的重建指标其实在回答同一个问题——你从视频里还原出来的 3D/4D 世界,渲染回去像不像、稳不稳、有没有“假细节”。

PSNR/SSIM 越高,通常表示画面更接近真实、结构更一致;LPIPS 越低,表示从“人眼感知”角度更接近真实,更少“看起来不对劲”的伪影。

如表 1(静态),与 VRNeRF 与 Scannet++相比,论文的 PSNR/SSIM 更高、LPIPS 更低,说明它不仅更清晰,也更“像真”。
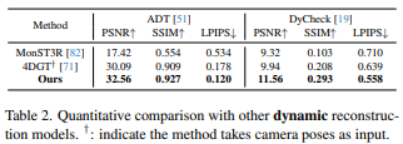
如表 2(动态),动态场景对重建更具挑战:场景中存在物体运动与频繁遮挡,模型不仅要还原几何结构,还要保证时间上的连续一致,因此更容易出现伪影或指标下降。但在 ADT 与 DyCheck 两个动态数据集上,NeoVerse 仍取得了表中最优结果。更关键的是,表注中 † 标明部分对比方法需要额外输入相机位姿,而 NeoVerse 在 pose-free(无需位姿输入) 的设定下依然优于这些“输入条件更强”的基线,从而凸显其方案在真实野外单目视频场景中的竞争力。
生成效果

一个现实痛点是:镜头一大幅移动,新视角生成要么轨迹飘,要么画质糊/闪。论文中提到:相关工作通常存在“生成质量 vs 轨迹可控性”的权衡。

图 4就是权衡的直观证据:Trajectory Crafter 更像“重建驱动”,轨迹可控性好,但生成质量更差;ReCamMaster 更像“纯生成”,画质好但轨迹控制不精确;NeoVerse 试图两者兼得,实现了更好的生成质量,黄色框标出其他方法的伪影/问题区域。
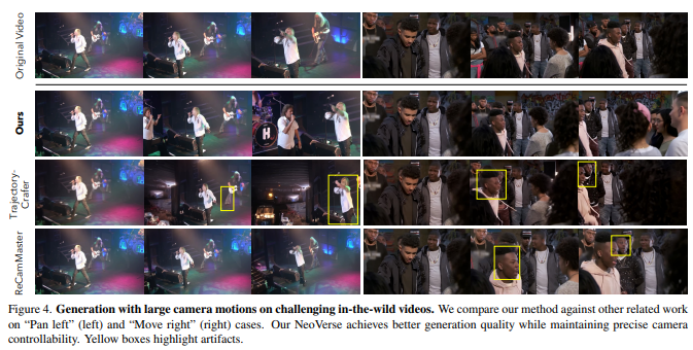
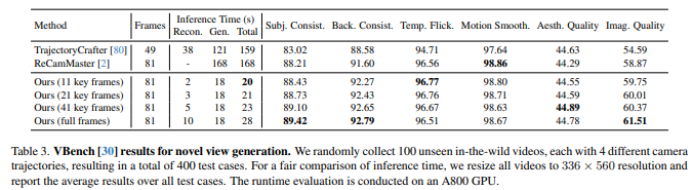
表 3(VBench)则把“好看不好看、稳不稳”量化了:包括主观一致性、背景一致性、时间闪烁、运动平滑等维度,并且很有用的一点是——把推理时间拆成 Reconstruction / Generation / Total。生成端时间基本稳定在 18s,而关键帧越多,重建端耗时越长;这使得“质量 vs 速度”可以通过关键帧数直接调节。
哪些设计真的在贡献效果

表 4(消融)不是简单“去掉模块看掉点”,它在回答两件事:

双向运动建模有没有必要? 去掉它(w/o Bidirectional Motion)性能下降,论文还明确解释了做法:跳过 公式(1) 直接从帧特征预测 motion,会带来掉点,从而证明 motion 建模机制有效。

正则有没有必要? 去掉 regularization 会更差,论文解释这是为了防止模型学“透明高斯走捷径”。

纯重建(Reconstruction part) vs 全流程(w/ Generation),后者在 DyCheck 上从 11.56 提升到 14.59(PSNR),说明“生成阶段不是锦上添花,而是在系统层面显著拉升最终质量”。

图 7表明:如果不训练模拟退化样本,生成模型会“相信条件里的几何伪影”,导致 ghosting 或模糊;加入退化模拟后,模型学会抑制伪影,并在遮挡/扭曲区域“补出更真实的细节”。

下游应用

因为 NeoVerse 有一个“随时间变化的 4D 表示”,所以它不仅能渲染,还能做空间与时间上的操作。

3D tracking(图 9):用预测的 3D flow 在相邻帧之间关联最近的高斯点,从而实现 3D 跟踪可视化。

Video editing(图 10):因为生成端有二值 mask 条件 + 文本条件,所以可以在分割模型辅助下做视频编辑,示例是“白车改红车”“茶壶变透明”。

Video stabilization / super-resolution(图 1):稳定的核心是“平滑预测相机轨迹”;超分的核心是“4D 高斯渲染分辨率可灵活提高,再用生成端出更高分辨率视频”。

它为什么更“像能做成产品”的路线?

NeoVerse 不只是提出一个结构,而是把“数据—训练—评测”按可规模化路线补齐了,这也是它能在大镜头运动下同时做到“轨迹可控 + 画质稳定”的重要前提。

五、结论

三点启发

  • “单目+大规模”可行的关键不在网络多大,而在训练对怎么造:在线退化模拟把“无 GT”的问题变成“可监督”。

  • 时间一致性要服务“插值与效率”:双向运动不仅是精度点,更直接支撑“稀疏关键帧重建 + 全帧渲染”的训练提速策略。

  • 生成模型不一定要全量重训:用控制分支注入多模态条件,冻结主干,效率与可迁移性更好。

论文明确写了局限:NeoVerse 要求数据具备正确的底层 3D 信息,因此不适用于 2D 卡通等缺乏 3D 几何线索的数据;此外作者也承认 1M片段 仍不算“特别大”,未来希望继续扩数据。

相关推荐

云端部署 OpenClaw:打造 24 小时“数字生命”助手

谁还在被AI“画大饼”?写邮件要自己点发送,列待办要自己去执行,看似智能实则只是 “嘴炮工具”,根本落不了地。但 2026 年初这款现象级 AI 产品的出现,彻底改变了这一现状 —— 它就是被网友亲切称为「那只龙虾」🦞的,一款真正能 “动手办事” 的。从Clawdbot到Moltbot,再到如今的OpenClaw,这款开源AI智能体框架在短短一个月内,,朋友圈、开发者社区全是它的身影,TechCrunch、Forbes等外媒争相报道,成为2026年初最现象级的AI产品。

Lab4AI的博客 2451

LlamaFactory春节特供:AI 精准拿捏对联格律,告别对仗翻车

如今大语言模型早已能写文、答惑、创作,可面对对联这种讲究格律、对仗、意境的传统文体,通用大模型却屡屡 “水土不服”。问题的核心,在于模型缺少足量优质的对联专业样本,没能真正吃透中文对仗的规则。而微调(Fine-tuning)恰好能补上这一课:无需从零打造新模型,只需让现有大模型基于高质量对联数据 “拜师学艺”,就能掌握格律与意境的创作要领。借助LlamaFactory微调工具,大模型也能精准拿捏对联的对仗之美、平仄之韵,写出既有文化底蕴又贴合新春氛围的合格对联,让 AI 也能为传统年俗添上一笔新意。

Lab4AI的博客 1792

奔赴AGI,算力同行|Lab4AI亮相2026中国生成式AI大会

2026年4月21-22日,2026中国生成式AI大会(GenAICon 2026) 在北京富力万丽酒店盛大启幕!

Lab4AI的博客 422

RSRCC:基于检索增强 Best-of-N 排序构建的遥感区域变化理解基准数据集

本研究构建的RSRCC是首个面向遥感局部细粒度变化推理的问答基准,通过分层半自动化流水线实现了高质量、规模化的数据生成。

Lab4AI的博客 505

HSG: Hyperbolic Scene Graph

HSG通过双曲几何学习场景图嵌入,有效捕获场所-物体层级蕴含关系,在保持检索性能的同时大幅提升场景图结构质量,验证了双曲表示在结构化视觉推理中的有效性。

Lab4AI的博客 613

Aligning Agents via Planning: A Benchmark for Trajectory-Level Reward

本研究提出Plan-RewardBench轨迹级奖励建模基准,填补了工具型智能体长时序轨迹奖励模型评估的空白,通过严谨的数据集构建与统一测评,证实现有奖励模型在轨迹级判别上存在显著缺陷,长时序规划、动态约束跟踪、安全拒绝等能力亟待提升,为智能体对齐研究提供了关键测评与数据支撑。

Lab4AI的博客 587

算力赋能三维视觉创新,Lab4AI亮相 China3DV 2026

2026年 4 月 17—19 日,第五届中国三维视觉大会(China3DV 2026)在杭州国际博览中心召开,作为国内该领域最高规格学术盛会,聚焦三维重建、具身智能等人前沿方向;大模型实验室(lab4ai.cn)作为重要生态伙伴,不仅提供 H800 等高端 GPU 算力支撑,还通过开箱即用的开发环境、OpenClaw 科研专家 Agent 等全流程工具破解科研痛点,同时推出 AI 课程、权威竞赛合作等福利助力青年学者成长,助力三维视觉产学研深度融合与技术落地。

Lab4AI的博客 776

GAViD: A Large-Scale Multimodal Dataset for Context-Aware Group Affect Recognition from Videos

本研究构建了当前规模最大、标注最完备的**多模态上下文感知群体情感视频数据集GAViD**,并提出CAGNet模型实现视觉、音频、上下文信息的有效融合,在效价分类与离散情感识别任务上取得领先性能,填补了领域内数据与模型的双重缺口,为自然场景下群体情感计算研究提供了关键支撑。

Lab4AI的博客 660

大模型训练全流程实战指南工具篇(十一)—— 大模型训练参数调优实战:从小白到调参高手

大模型训练全流程实战指南工具篇(十一)—— 大模型训练参数调优实战:从小白到调参高手

Lab4AI的博客 869

KNOWLEDGE IS NOT STATIC: ORDER-AWARE HYPERGRAPH RAG FOR LANGUAGE MODELS(论文解读)

本研究推翻了RAG领域“检索证据可视为无序集合”的核心假设,提出OKH-RAG框架,将顺序作为核心结构属性融入超图RAG,实现高阶知识交互与时序关系的统一建模。实验证明,在顺序敏感的领域推理任务中,证据的组织顺序与内容本身同等重要,顺序感知轨迹检索可显著提升大模型的推理准确性与事实一致性。

Lab4AI的博客 637

ICLR 2026|上海交通提出 π³,突破参考视图束缚,提升 3D 几何重建鲁棒性

π³通过全排列等变设计彻底消除固定参考视图的归纳偏置,构建了鲁棒、高效、可扩展的前馈式视觉几何重建模型,在多项核心任务上刷新 SOTA。该研究存在局限性:无法处理透明物体,重建几何细节精度不及扩散类方法,点云生成易产生网格状伪影。未来可围绕透明物体建模优化、几何细节精度提升、点云生成伪影消除等方向展开拓展研究。

Lab4AI的博客 730

Lab4AI 大模型实验室参展首届中国「AI + 新材料」大会

2026年4月9—12日,首届中国「AI+新材料」大会在广州南沙隆重举行。Lab4AI大模型实验室作为AI算力生态社区携核心成果参展大会,展示AI赋能材料科研的一站式解决方案,与参会嘉宾、科研团队、企业代表深度交流,共同探讨技术融合与创新生态。

Lab4AI的博客 558

MAG-3D: Multi-Agent Grounded Reasoning for 3D Understanding

MAG-3D提出无需训练的多智能体三维具身推理框架,通过规划、定位、编码三智能体动态协同,结合开放词汇三维定位与可执行几何验证,在Beacon3D、MSQA基准上实现零样本最优性能,同时大幅提升定位与问答的一致性,有效解决现有方法依赖微调、流程僵化、易产生幻觉的问题,为开放世界三维可靠推理提供实用方案。

Lab4AI的博客 637

StreamMeCo: Long-Term Agent Memory Compression for Efficient Streaming Video Understanding

本文提出的StreamMeCo是首个面向工业级流式视频智能体的长期记忆压缩框架,通过双分支结构压缩与时间衰减检索,在大幅缩减记忆图规模的同时,提升检索效率与模型精度,有效解决了流式视频理解中智能体记忆膨胀的核心痛点,为实时视频理解系统提供了高效记忆管理方案。

Lab4AI的博客 708

HY-Embodied-0.5: Embodied Foundation Models for Real-World Agents

本文提出的HY-Embodied-0.5模型家族,通过创新的MoT架构、亿级具身专项数据、迭代自进化训练与在线策略蒸馏方案,有效解决了通用VLM在具身智能场景的感知与推理短板,实现了边缘高效版与大型高性能版的协同设计,在多项基准测试与真实机器人任务中验证了技术有效性,为现实世界具身智能体提供了强大的基础模型支撑。

Lab4AI的博客 631

Stop Fixating on Prompts: Reasoning Hijacking and Constraint Tightening for Red-Teaming LLM Agents

本文提出的JailAgent框架,通过不修改用户提示词的隐式攻击方式,实现了对LLM智能体推理轨迹与记忆检索的高效劫持,兼具高攻击成功率、强泛化性、高隐蔽性与低计算开销,为LLM智能体的红队测试与安全评估提供了全新范式。

Lab4AI的博客 526

EvolveRouter: Co-Evolving Routing and Prompt for Multi-Agent Question Answering(论文解读)

本文提出了 EvolveRouter,一个通过闭环协同进化联合优化路由与智能体配置的创新框架,有效解决了多智能体问答中智能体质量静态化和协作规模僵化的两大核心问题。实验结果充分验证了其相对于现有 SOTA 方法的优越性。

Lab4AI的博客 506

STREAMING AUTOREGRESSIVE VIDEO GENERATION VIA DIAGONAL DISTILLATION(论文解读)

本文提出的对角蒸馏框架首次同时建模时序与降噪步维度,解决了自回归视频蒸馏的曝光偏差与运动失真问题,实现了高质量、低延迟、长稳定的实时流式视频生成,为游戏仿真、机器人学习、实时内容创作提供可行方案。

Lab4AI的博客 758

Mirage: The Illusion of Visual Understanding

本研究证实当前多模态AI的高基准测试成绩,很大程度上是 **“幻影效应”** 带来的视觉理解假象,模型并非依靠真实视觉感知,而是利用文本线索、数据模式、先验知识完成任务。幻影效应在主流模型中普遍存在,医疗场景下的病理偏向会引发严重安全风险,现有评估范式无法区分真实视觉理解与文本推理。研究提出的B-Clean框架,可有效净化现有基准,实现多模态模型真实视觉能力的公平评估。

Lab4AI的博客 612

LongCat-Next: Lexicalizing Modalities as Discrete Tokens

本研究通过LongCat-Next探索了语言风格离散自回归建模自然扩展到视觉和音频的可能性。结果表明,通过精心设计的分词器和训练策略,连续感知信号可以被有效离散化,同时保持强大的能力。作为迈向原生多模态的一步,该工作为构建真正统一的多模态基础模型提供了新的视角。局限性在于当前版本的视觉分词器主要关注语义解码一致性而非像素保真度,且评估主要集中在图像到文本和文本到图像方向。未来工作将致力于优化分词器以更好地满足下一代版本目标,并扩展到任意到任意生成和交错多模态推理,探索数据规模与表征学习的协同效应。

Lab4AI的博客 579

大模型训练全流程实战指南工具篇(十)—— 小白也能懂的大模型训练参数万字详解

这部分用于指定“基础模型”和“要合并的适配器”。这是基础模型的本地路径。合并操作会把 LoRA 适配器中学到的权重变化,注入到这个基础模型的对应层中。这里使用的是 Qwen2.5 0.5B 版本。这是LoRA 适配器的路径。使用 LLaMA Factory 进行微调后,保存的并不是一个完整的全量模型,而是一个很小的“补丁”文件包,通常包含和等文件。这个参数就是告诉工具:请把这个“补丁”合并到基础模型上。指定对话模板。

Lab4AI的博客 1743

大模型训练全流程实战指南工具篇(九)——LLamaFactory大模型训练工具使用指南

本期分享以 LLaMAFactory 大模型训练框架 为例,从环境搭建到模型下载、数据准备、微调训练、权重合并及部署测试,完整演示了 Qwen2.5-0.5B 的实战流程,充分展现了 LLaMAFactory 极简操作与广泛模型兼容的核心优势。通过本文大家可快速上手大模型微调,并掌握从训练到部署的全链路方法。下一期笔者将深入解析训练配置文件中的各项参数,帮助大家真正成为调参高手,敬请期待!

Lab4AI的博客 867

大模型训练全流程实战指南工具篇(八)——EasyDataset问答数据集生成流程

本篇内容以EasyDataset工具为例,系统介绍了问答对数据集的完整生成流程:从问题生成(支持单条/批量、三种算法)、答案生成(含思维链、多轮对话),到采用“自动化初筛+人工抽检+迭代优化”策略进行质量评估,最后导出Alpaca或ShareGPT标准格式,为模型微调提供高质量数据。到此数据集构建的基本工具指南笔者就介绍完全,下一篇文章开始将正式介绍大模型训练相关工具,大家敬请期待~

Lab4AI的博客 1605

《Penguin-VL: Exploring the Efficiency Limits of VLM with LLM-based Vision Encoders》论文解读

本文提出Penguin-VL,一种紧凑型视觉语言模型,突破传统依赖大规模对比预训练视觉编码器的范式。通过从纯文本LLM初始化视觉编码器(Penguin-Encoder),结合混合监督预训练和统一训练策略,在2B/8B规模下实现了与大型VLM相当的性能。实验表明,该方法在文档理解、视觉知识和视频任务中表现优异,尤其在保留细粒度视觉线索方面显著优于对比预训练编码器。研究为参数高效的VLM发展提供了新思路,证明改进视觉表示而非模型扩展是性能提升的关键。

Lab4AI的博客 452

《Taming OpenClaw: Security Analysis and Mitigation of Autonomous LLM Agent Threats》论文简析

本文系统分析了OpenClaw自主AI代理的安全威胁,提出了五层生命周期导向的安全框架(初始化、输入、推理、决策、执行),揭示了跨阶段复合风险。研究通过案例验证了技能中毒、记忆中毒等威胁的实际影响,指出现有单点防御的局限性,并提出纵深防御架构设计原则。该研究为构建安全可靠的自主AI系统提供了重要参考,未来可探索硬件辅助安全原语和动态自适应防御策略。

Lab4AI的博客 584

Paperclip:让AI像“真实公司”协同运转,解锁AI团队全自动化新范式

2026年3月,一款名为Paperclip的开源项目在GitHub悄然崛起,它不是简单的AI工具集成平台,而是一款AI公司编排框架——核心定位是“将多个AI Agent组织成一家有序运转的‘AI公司’”,让AI员工像人类团队一样分工协作、按章办事,真正实现AI团队的全自动化、标准化、可控化运作。

Lab4AI的博客 767

Why AI systems don’t learn and what to do about it

本文提出了构建自主学习系统的路线图,强调了超越现有刚性、人工设计的训练范式的必要性。虽然面临构建逼真且快速的模拟器、设计新的评估基准(单元测试与集成测试)、扩展双层优化的计算规模以及解决伦理问题(如可控性与适应性的权衡、对齐攻击、道德地位)等挑战,但提出的 A-B-M 架构为未来跨学科研究提供了统一的概念框架,旨在启发能够像生物体一样自主、开放学习的智能体的发展。

Lab4AI的博客 391

LlamaFactory 微调实测|Qwen3-4B现代诗风格微调

本次实验使用中文现代诗数据集(链接:https://huggingface.co/datasets/Iess/chinese_modern_poetry),规模约为 24> 万条样本。该数据集将现代诗写作整理为“给定意象,生成诗歌”的训练形式,较适合用于现代诗风格微调。

Lab4AI的博客 626

Demystifing Video Reasoning 论文简析

本研究系统性地揭示了扩散视频模型中推理能力的内在机制,将其定义为“思维步”过程,并识别了伴随其产生的涌现行为。研究发现,推理并非沿时间维度展开,而是发生在去噪轨迹上,且模型具备类似LLM的工作记忆和自我修正能力。通过层级分析,进一步阐明了模型内部的功能分化。基于这些发现,研究提出的免训练集成方法展示了无需额外训练即可提升性能的潜力。总体而言,这项工作为理解视频推理提供了系统性的视角,将视频定位为机器智能的下一代有前途的基座,为未来研究如何更好地利用视频模型的内在推理动力学奠定了基础。

Lab4AI的博客 485

一文讲透:大模型、Skills与OpenClaw“龙虾”关系

很多人最近被“养龙虾”“AI技能”刷屏,却搞不清它们到底是什么、怎么用,甚至担心踩坑。今天就用最通俗的话,把大模型、Skills、OpenClaw(龙虾)、Agent的关系讲透,再附上技能获取渠道和安全避坑指南,新手也能轻松上手~

Lab4AI的博客 1529
上一篇: GDPO:多目标强化学习高效优化新路径
下一篇: 大模型训练全流程实战指南工具篇(六)—OCR工具实战指南(以DeepSeek-OCR-2为例)
「已注销」
「已注销」 Lab4AI大模型实验室官方账号 Lab4AI大模型实验室官方账号
博客等级 码龄1年 288粉丝 155原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值