Study - mongodb 之 聚合

MongoDB BSON文档模型与模式自由设计原理 文档型数据库中的‘文档’并非传统文件,而是具备结构语义的数据活体单元;BSON作为MongoDB底层二进制数据格式,弥补了JSON在类型精度、二进制支持和扩展性上的根本缺陷,使文档成为可索引、可计算、可原子操作的原生数据实体。其设计支撑了延迟模式定义、嵌套建模、高效索引与聚合等核心能力,在电商、教育、IoT等高并发、多变Schema场景中展现出显著工程优势。理解BSON与文档模型的本质,是构建高性能、可演进NoSQL系统的前提。 阅读详情

aggregate

一般查询可以通过find()方法,但如果是比较复杂的查询或者数据统计的话,find可能就无能为力了,这时也许你需要的是aggregate

什么是聚合管道?

  • aggregation pipeline,直译为聚合管道,它可以对数据文档进行变换和组合
  • 聚合管道是基于数据流概念,数据进入管道经过一个或多个stage,每个stage对数据进行操作(筛选,投射,分组,排序,限制或跳过)后输出最终结果

官方示例

db.collection.aggregate()方法
  • 聚合管道查询使用的方法
  • 参数是数组,每个数组元素就是一个stage,stage中运用操作符对数据进行处理后再交由下一个stage,直到没有下个stage,就输出最终的结果,而数据的处理则是通过使用操作符
管道操作符

mongoDB中有许多操作符,在aggregate中每个stage可以使用的操作符叫做管道操作符

分类
  • 阶段操作符(Stage Operators)
    • 阶段操作符是使用于db.collection.aggregate()方法里面,数组参数中的第一层
  • 表达式操作符(Expression Operators)
    • 表达式操作符主要用于在管道中构建表达式时使用,使用类似于函数那样需要参数,主要用于$project操作符中,用于构建表达式
  • 累加器(Accumulators)
    • 当在group中使用时,累加器是针对每个分组使用的
    • 当在project中使用时,累加器则是针对每个字面量起作用

以下列举比较常用的管道操作符:

操作符含义
$project投射操作符,用于重构每一个文档的字段,可以提取字段,重命名字段,甚至可以对原有字段进行操作后新增字段
$match匹配操作符,用于对文档集合进行筛选
$group分组操作符,用于对文档集合进行分组
$unwind拆分操作符,用于将数组中的每一个值拆分为单独的文档
$sort排序操作符,用于根据一个或多个字段对文档进行排序
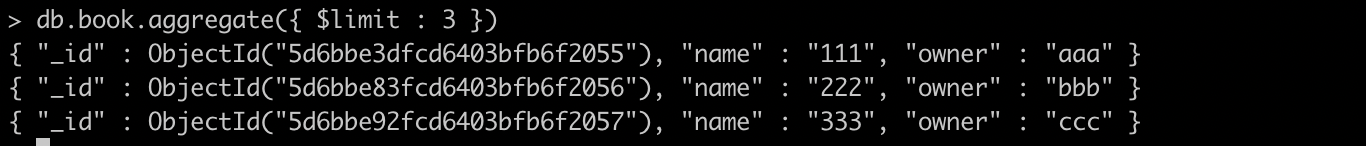
$limit限制操作符,用于限制返回文档的数量
$skip跳过操作符,用于跳过指定数量的文档
$lookup连接操作符,用于连接同一个数据库中另一个集合,并获取指定的文档,类似于populate
阶段操作符详解
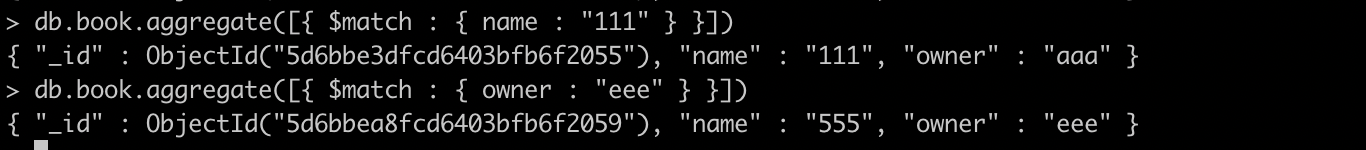
  • $match 匹配操作符
    用于对文档集合进行筛选

    { $match: { <query> } }
    
    • 查询name为“111”的书
    • 查询书的owner为“eee”的书
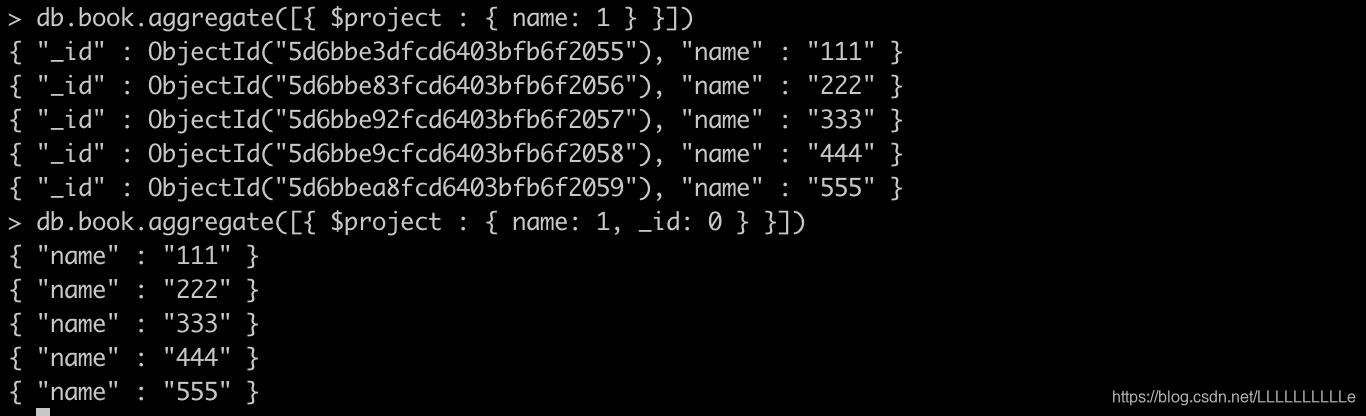
  • $project 投射操作符
    用于重构每一个文档的字段,可以提取字段,重命名字段,甚至可以对原有字段进行操作后新增字段

    { $project: { <specification(s)> } }
    

    specification的规则:

    规则描述
    _id: 0 or false不返回_id(默认返回)
    <字段名>: 1 or true选择需要返回什么字段
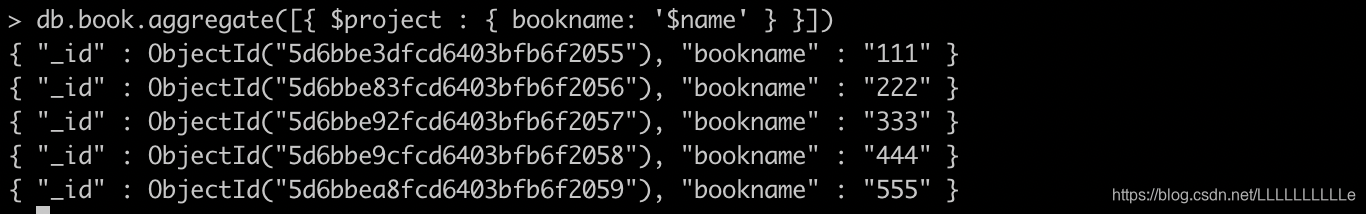
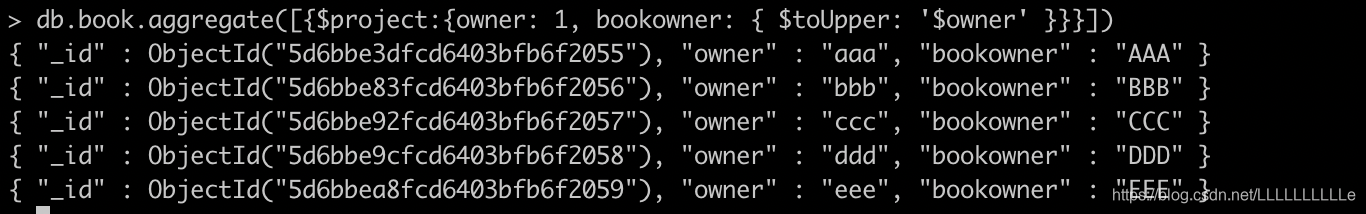
    <字段名>: 表达式使用表达式,可以用于重命名字段,或对其值进行操作,或新增字段
    <字段名>: 0 or false选择需要不返回什么字段,注意:当使用这种用法时,就不要用上面的方法
    • book集合投射name

    • 将book集合的name重命名为bookname

    • 返回新字段bookowner,并使用表达式让它的值为owner的大写

  • $sort 排序操作符

    用于根据一个或多个字段对文档进行排序

    { $sort: { <field1>: <sort order>, <field2>: <sort order> ... } }
    
  • $limit 限制操作符

    用于限制返回文档的数量

    { $limit: <positive integer> }
    
    • 返回3本book
  • $skip 跳过操作符

    用于跳过指定数量的文档

    { $skip: <positive integer> }
    
    • 跳过2本book
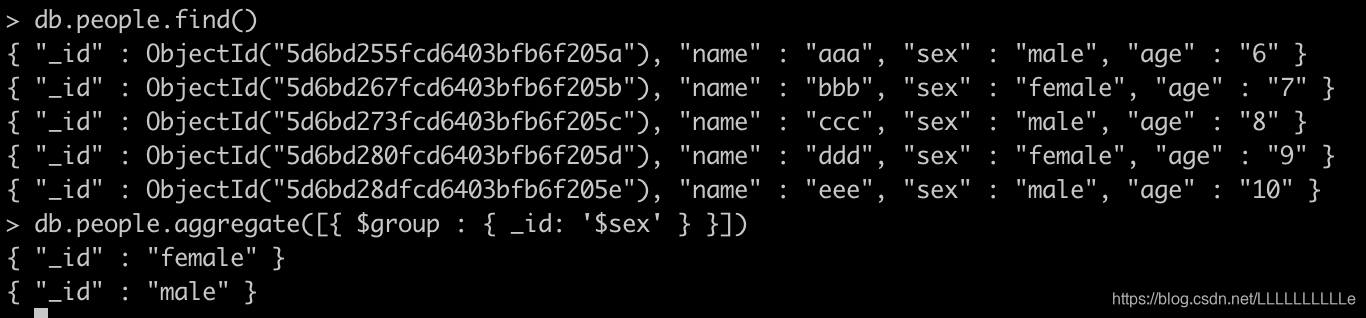
  • $group 分组操作符

    用于对文档集合进行分组

    { $group: { _id: <expression>, <field1>: { <accumulator1> : <expression1> }, ... } }
    

    注:_id是必须的,用作分组的依据条件

    • 将people按sex分组

阶段操作符

AI智能体结构化研究规范Knows:从信息混乱到知识图谱的工程实践 在人工智能与自动化研究领域,如何将非结构化的信息输出转化为机器可读、人类可高效利用的结构化知识,是提升智能体协作效率和产出可靠性的核心挑战。这涉及到从传统的自然语言输出范式,向语义化、模块化的数据结构转变。其技术原理在于通过定义标准化的数据模式(如JSON Schema),强制AI模型按照预设的实体类型、关系和元数据来组织发现,从而实现知识的可组合性、可验证性与可追溯性。这一实践对于构建自动化研究流水线、竞争情报系统和多智能体协作网络具有重要价值,能直接将信息消化时间从小时级降至分钟级。本文聚焦的Knows 阅读详情

相关推荐

GitHub趋势榜热门项目解析:AI工程化、开发工具与开源替代

在软件开发领域,持续追踪技术前沿与高效工具是开发者提升生产力的关键。从技术原理上看,开源社区的活跃项目往往反映了当前工程实践的痛点与范式转变。其技术价值在于通过优化工作流、降低使用门槛来解决普遍存在的效率与成本问题,例如在人工智能工程化领域,模型微调与高效推理工具正推动AI能力平民化;在开发体验层面,现代构建工具与全栈框架致力于实现极致的性能与开发效率。这些趋势广泛应用于快速原型开发、云原生基础设施管理、以及企业级软件的开源替代等场景。本文聚焦于GitHub趋势榜中的热门项目,深入探讨了AI智能体开发框架、

318

Mongoose的populate 查询

在使用MongoDB的时候 使用populate 方法来代替关系型数据库的join,在定义一个Schema的时候可以指定其中的字段(属性)是另一个Schema的引用,在查询文档的时候就可以使用populate方法通过引用Schema和id找到关联的另一个文档或者文档的指定字段值。下面是一个简单的例子。 //引入包 var mongoose = require('mongoose') var ap...

ppwwp的专栏 1462

超参数调优实战:从原理陷阱到生产级调优流水线

超参数调优是机器学习模型落地的关键环节,本质是在精度、训练速度与部署鲁棒性之间动态权衡的工程实践。其核心原理并非暴力搜索,而是对高维非凸、非均匀、强耦合的超参空间建模——learning rate与weight decay的交互、batch size与warmup step的绑定、dropout与数据规模的非线性关系,共同决定了模型能否稳定收敛。技术价值体现在将F1提升0.05即可带来千万级业务收益,或使工业质检漏检率日均下降百件。典型应用场景覆盖金融风控、医疗影像分割、边缘端TinyML部署及推荐系统优化

diankui6178的博客 460

mongoose实现mongo表关联(populate)

nodeDocker的博客 931

AD服务器搭建

一、角色安装1)打开服务器管理器,添加 角色和功能;2) 点 下一步;3)点 下一步;4)点 下一步;5)点击安装;6-1)将此服务器提升为域控制器;6-2)点下一步;6)输入密码 点 下一步;7)自动生成LIXF,点击下一步;8)确认目录,点下一步;8)确认安装条件,点安装; 8)安装成功,点关闭;...

潇峰的博客 6458

十一、机器学习进阶知识:径向基神经网络(RBFNN)的实现(Python,附源码及数据集)

本文对径向基神经网络(RBFNN)的理论基础及建模步骤进行介绍,之后使用Python实现基于RBFNN的数据预测,通俗易懂,适合新手学习,附源码及实验数据集。

weixin_42051846的博客 1万+

使用Mongoose的populate方法实现多表关联查询

MongoDB在3.2以上的版本有类似于 join 的 $lookup 聚合操作符,其实 Mongoose 有一个更强大的替代方法,叫做populate ( ),它允许你在其他集合中引用文档,实现更简洁优雅的查询操作。 还是以内容管理系统为例,有文章分类、文章详情、文章作者三张表,UML图如下: 业务需求如下:查询文章信息,并显示文章的分类以及文章的作者信息,下面用 populate 来实......

分享前端工程化、AI 应用、Agent 开发与大模型实践! 5068

Unity机械拆装实战:5步搞定发动机模型交互式装配(附完整代码)

本文详细介绍了在Unity中实现高交互性机械拆装仿真的完整流程。以发动机模型为例,通过5个核心步骤:项目初始化与模型准备、核心交互实现、智能装配逻辑、场景管理与相机控制、进阶优化与扩展,系统讲解了从零构建交互式装配功能的方法,并提供了完整的代码示例。

weixin_28049429的博客 218

Eggjs笔记:详解Mongoose的聚合管道以及populate实现关联查询

基于mongodb的聚合管道 此处忽略之前mongodb在eggjs中需要配置的步骤,前文已有说明,现在开始在controller中调用(应该封装到service中的,仅作为示例) const result = await this.app.mongo.aggregate('order', { pipeline: [ { $lookup: {...

Wang的专栏 2096

Ansys Lumerical实战:5步搞定Mach-Zehnder调制器多物理场仿真(附眼图分析技巧)

本文详细介绍了使用Ansys Lumerical进行行波马赫-曾德尔调制器多物理场仿真的完整流程。通过CHARGE、MODE和INTERCONNECT三大模块的协同工作,从电学参数提取、光学射频特性分析到系统级眼图评估,分步解析了高效仿真与性能优化的核心技巧,为硅光调制器设计提供了实战指南。

weixin_29056781的博客 547

STM407ZET6+OV5640调试心得

最近一个项目用了STMF407ZET6 +OV5640,调试了好几天做些总结; STMF407ZET6 开发板用的是正点原子的开发板,OV5640摄像头用的是秉火摄像头; 这其中有一个大坑,开发板的DCMI接口跟摄像头的接口不一样,要重新用杜邦线进行连接; 本人是在正点原子的“”15,ATK-OV5640摄像头模块“”源码上进行修改的。

kingseacjh的专栏 8326

Study - mongodb 之 聚合(2)

累加器 累加器本来只能使用与group下,但是版本3.2或以上,部分累加器还能使用于group下,但是版本3.2或以上,部分累加器还能使用于group下,但是版本3.2或以上,部分累加器还能使用于project 当在$group中使用时,累加器是针对每个分组使用的 当在$project中使用时,累加器则是针对每个字面量起作用 常用累加器 操作符 简述 $sum 求和操作符,v3...

LLLLLLLLLLe的博客 250

NuPlayer 之 Renderer

触发postDrainAudioQueue_l()或postDrainVideoQueue()开始渲染。解码器输出数据 → NuPlayer::Decoder::onMessageReceived。音频数据存入mAudioQueue,视频数据存入mVideoQueue。• 每次写入后通过mNotifyConsumed通知解码器。• 通过AudioSink::write()写入音频设备。• 根据VSync信号和音频时钟调整渲染时机。• 通过Surface直接提交给显示系统。

aningxiaoxixi的博客 320

Study - MongoDB 浅析

是什么? 由C++语言编写的 是一个文档数据库 将数据存储为一个文档,数据结构由键值(key=>value)对组成 MongoDB 文档类似于 JSON 对象 字段值可以包含其他文档,数组及文档数组 MongoDB是一个NoSQL数据库系统: 一个数据库可以包含多个集合(Collection),每个集合对应于关系数据库中的表 而每个集合中可以存储一组由列标识的记录,列是可以自由...

LLLLLLLLLLe的博客 229

044、Edge Impulse的音频分类实战

上周调试一块STM32WBA52开发板,板载PDM麦克风死活采不到有效数据。示波器怼上去,时钟线波形漂亮得像教科书,数据线却像心电图——全是毛刺。折腾半天发现是电源纹波干扰,给麦克风单独加了个LC滤波,世界清净了。这种坑,做音频分类的嵌入式工程师迟早要踩一遍。

2401_88858637的博客 58

使用CloudCompare和CANUPO进行点云分类的编程指南

在本文中,我们将介绍如何使用CloudCompare和CANUPO库进行点云分类的编程。CloudCompare是一款功能强大的开源点云处理软件,而CANUPO是一个用于点云分类和分割的C++库。这只是一个简单的点云分类示例,CANUPO库还提供了其他更高级的功能和算法,以满足各种点云分类需求。该函数接受点云数据、地面点掩码和非地面点掩码作为输入,并将分类结果存储在这两个掩码向量中。完成安装后,我们可以开始编写点云分类的代码。最后,我们遍历点云数据,并根据地面点和非地面点的掩码将结果打印出来。

ByteWhisper的博客 1060

MongoDB(三)之SpringBoot整合

MongoDB是一个基于分布式文件存储的数据库。由C++语言编写。旨在为WEB应用提供可扩展的高性能数据存储解决方案。MongoDB是一个介于关系数据库和非关系数据库之间的产品,是非关系数据库当中功能最丰富,最像关系数据库的,它支持的数据结构非常松散,是类似json的bson格式,因此可以存储比较复杂的数据类型。MongoDB最大的特点是它支持的查询语言非常强大,其语法有点类似于面向对象的查询语言,几乎可以实现类似关系数据库单表查询的绝大部分功能,而且还支持对数据建立索引。 03、配置文件 properti

PeterMrWang的博客 1286

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

fluent study

入门 基于Fluentd实现日志聚合与分析 - I'm yunlong fluent · ELKstack 中文指南 使用Fluentd + MongoDB构建实时日志收集系统 - 茄子_2008 - 博客园 Fluentd (td-agent) 日志收集系统 - ...

176

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

MongoDB向量搜索实战:从零搭建生产级语义检索系统

向量数据库是支撑RAG、智能搜索与推荐系统的核心基础设施。其本质是将高维嵌入向量(Embedding)通过近似最近邻(ANN)算法实现高效相似度检索,关键技术原理涵盖HNSW图索引、余弦相似度计算与混合查询融合。相比专用向量库,MongoDB凭借原生$vectorSearch聚合阶段、强一致事务支持及元数据联合过滤能力,在企业级场景中展现出显著的工程落地优势——尤其适合已使用MongoDB作为主库、追求低运维成本与快速迭代的团队。本文聚焦How to Store and Query Embeddings i

weixin_34292402的博客 344

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

bestvike study 2--自学数据库(1)

数据类型用于指定特定所包含数据的规则,决定了数据保存在列里的方式,包括分配给列的宽度,以及值是否可以是字母、数字、日期和时间等。

qq_51186720的博客 909

2024年大数据最全bestvike study 2--自学数据库(1),带你彻底弄明白

数据类型用于指定特定所包含数据的规则,决定了数据保存在列里的方式,包括分配给列的宽度,以及值是否可以是字母、数字、日期和时间等。

2401_84184638的博客 1048

2024年最全bestvike study 2--自学数据库(1),大数据开发开发必须会的技能

数据类型用于指定特定所包含数据的规则,决定了数据保存在列里的方式,包括分配给列的宽度,以及值是否可以是字母、数字、日期和时间等。

2401_84167046的博客 766

Python数据分析实战:学员学习进度统计与可视化全流程

数据分析是处理海量信息、提取业务价值的关键技术,其核心原理在于通过数据采集、清洗、聚合与建模,将原始数据转化为可操作的洞察。在Python生态中,Pandas库凭借其强大的DataFrame结构和向量化计算能力,成为数据清洗与聚合分析的首选工具,广泛应用于教育科技、用户行为分析等领域。结合Matplotlib进行可视化,可以直观呈现趋势与模式,为学情预警、个性化推荐等场景提供决策支持。本文以学员学习进度统计为具体案例,详细演示了如何使用Pandas进行数据聚合,并生成包含学习时长、任务完成度等多维度的结构化

cunfuxiao7305的博客 488

2024年大数据最全bestvike study 2--自学数据库(1)(1),2024年最新字节大数据开发高工面试

数据类型用于指定特定所包含数据的规则,决定了数据保存在列里的方式,包括分配给列的宽度,以及值是否可以是字母、数字、日期和时间等。

2301_82241942的博客 465
上一篇: Study - mongodb 一些操作符 & 方法
下一篇: Study - mongodb 之 聚合(2)
OOOOOOh~
博客等级 码龄9年 92粉丝 80原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值