


一。前述
上次分析了客户端源码,这次分析mapper源码让大家对hadoop框架有更清晰的认识
二。代码
自定义代码如下:
public class MyMapper extends  Mapper<Object, Text, Text, IntWritable>{


       private final static IntWritable one = new IntWritable(1);
       private Text word = new Text();

       public void map(Object key, Text value, Context context) throws IOException, InterruptedException {


         StringTokenizer itr = new StringTokenizer(value.toString());


         while (itr.hasMoreTokens()) {
           word.set(itr.nextToken());
           context.write(word, one);
         }
       }
继承Mapper源码如下:
public class Mapper<KEYIN, VALUEIN, KEYOUT, VALUEOUT> {

  /**
   * The <code>Context</code> passed on to the {@link Mapper} implementations.
   */
  public abstract class Context
    implements MapContext<KEYIN,VALUEIN,KEYOUT,VALUEOUT> {
  }

  /**
   * Called once at the beginning of the task.
   */
  protected void setup(Context context
                       ) throws IOException, InterruptedException {
    // NOTHING
  }

  /**
   * Called once for each key/value pair in the input split. Most applications
   * should override this, but the default is the identity function.
   */
  @SuppressWarnings("unchecked")
  protected void map(KEYIN key, VALUEIN value,
                     Context context) throws IOException, InterruptedException {
    context.write((KEYOUT) key, (VALUEOUT) value);
  }

  /**
   * Called once at the end of the task.
   */
  protected void cleanup(Context context
                         ) throws IOException, InterruptedException {
    // NOTHING
  }

  /**
   * Expert users can override this method for more complete control over the
   * execution of the Mapper.
   * @param context
   * @throws IOException
   */
  public void run(Context context) throws IOException, InterruptedException {
    setup(context);
    try {
      while (context.nextKeyValue()) {
        map(context.getCurrentKey(), context.getCurrentValue(), context);
      }
    } finally {
      cleanup(context);
    }
  }
}
解析:我们重新了map方法,所以传进run方法中才能不断执行。
MapperTask源码解析:
Container封装了一个脚本命令,通过远程调用启动Yarnchild,如果是MapTask任务,然后把反射城MapTask的对象,启动mapTask的run方法
Maptask中的run方法:
public void run(final JobConf job, final TaskUmbilicalProtocol umbilical)
    throws IOException, ClassNotFoundException, InterruptedException {
    this.umbilical = umbilical;

    if (isMapTask()) {
      // If there are no reducers then there won't be any sort. Hence the map
      // phase will govern the entire attempt's progress.
      if (conf.getNumReduceTasks() == 0) {//假如没有reduce阶段
        mapPhase = getProgress().addPhase("map", 1.0f);
      } else {
        // If there are reducers then the entire attempt's progress will be
        // split between the map phase (67%) and the sort phase (33%).
        mapPhase = getProgress().addPhase("map", 0.667f);
        sortPhase  = getProgress().addPhase("sort", 0.333f);//假如有reduce阶段需要排序,说明没有reduce任务则不需要排序
      }
    }
 if (useNewApi) {
      runNewMapper(job, splitMetaInfo, umbilical, reporter);//用新api
    } else {
      runOldMapper(job, splitMetaInfo, umbilical, reporter);
    }
    done(umbilical, reporter);
  }
runNewMapper解析:
private <INKEY,INVALUE,OUTKEY,OUTVALUE>
  void runNewMapper(final JobConf job,
                    final TaskSplitIndex splitIndex,
                    final TaskUmbilicalProtocol umbilical,
                    TaskReporter reporter
                    ) throws IOException, ClassNotFoundException,
                             InterruptedException {
    // make a task context so we can get the classes
    org.apache.hadoop.mapreduce.TaskAttemptContext taskContext =
      new org.apache.hadoop.mapreduce.task.TaskAttemptContextImpl(job, //我们自定义的job
                                                                  getTaskID(),
                                                                  reporter);//创建上下文
    // make a mapper
    org.apache.hadoop.mapreduce.Mapper<INKEY,INVALUE,OUTKEY,OUTVALUE> mapper =
      (org.apache.hadoop.mapreduce.Mapper<INKEY,INVALUE,OUTKEY,OUTVALUE>)
        ReflectionUtils.newInstance(taskContext.getMapperClass(), job);//反射把自定的Mapper类反射出来  对应解析1
    // make the input format
    org.apache.hadoop.mapreduce.InputFormat<INKEY,INVALUE> inputFormat =
      (org.apache.hadoop.mapreduce.InputFormat<INKEY,INVALUE>)
        ReflectionUtils.newInstance(taskContext.getInputFormatClass(), job);//反射把自定的InputFormat类反射出来 对应解析2
    // rebuild the input split
    org.apache.hadoop.mapreduce.InputSplit split = null;
    split = getSplitDetails(new Path(splitIndex.getSplitLocation()),//每一个切片条目对应的是一个MapTask 每个切片中对应的4个东西(文件归属,偏移量,长度,位置信息)
        splitIndex.getStartOffset());
    LOG.info("Processing split: " + split);

    org.apache.hadoop.mapreduce.RecordReader<INKEY,INVALUE> input =
      new NewTrackingRecordReader<INKEY,INVALUE>//对应解析3
        (split, inputFormat, reporter, taskContext);//上面准备的输入格式化和切片为输入准备,拿到流,怎么读按文本方式读,行级

    job.setBoolean(JobContext.SKIP_RECORDS, isSkipping());
    org.apache.hadoop.mapreduce.RecordWriter output = null;

    // get an output object
    if (job.getNumReduceTasks() == 0) {
      output =
        new NewDirectOutputCollector(taskContext, job, umbilical, reporter);
    } else {
      output = new NewOutputCollector(taskContext, job, umbilical, reporter);
    }

    org.apache.hadoop.mapreduce.MapContext<INKEY, INVALUE, OUTKEY, OUTVALUE>
    mapContext =
      new MapContextImpl<INKEY, INVALUE, OUTKEY, OUTVALUE>(job, getTaskID(), //对应解析4
          input, output, //mapContext即上下文对象封装了输入输出,所以可通过上下文拿到值 则可以得出Mapper类中的content的getCurrentyKey实际上是取得输入对象的LineRecorder
          committer,
          reporter, split);

    org.apache.hadoop.mapreduce.Mapper<INKEY,INVALUE,OUTKEY,OUTVALUE>.Context
        mapperContext =
          new WrappedMapper<INKEY, INVALUE, OUTKEY, OUTVALUE>().getMapContext(
              mapContext);
 try {
      input.initialize(split, mapperContext);//输入 对应解析5
      mapper.run(mapperContext);//run  对应解析6
      mapPhase.complete();
      setPhase(TaskStatus.Phase.SORT);
      statusUpdate(umbilical);
      input.close();
      input = null;
      output.close(mapperContext);//输出
      output = null;
    } finally {
      closeQuietly(input);
      closeQuietly(output, mapperContext);
    }
  }
解析1源码
 @SuppressWarnings("unchecked")
  public Class<? extends Mapper<?,?,?,?>> getMapperClass()
     throws ClassNotFoundException {
    return (Class<? extends Mapper<?,?,?,?>>)
      conf.getClass(MAP_CLASS_ATTR, Mapper.class);//用户配置则从配置中取,如果没设置取默认。
  }
解析2源码
 public Class<? extends InputFormat<?,?>> getInputFormatClass()
     throws ClassNotFoundException {
    return (Class<? extends InputFormat<?,?>>)
      conf.getClass(INPUT_FORMAT_CLASS_ATTR, TextInputFormat.class);//如果用户设置取用户的,没有则取TextinputfRrmat!!!
  }
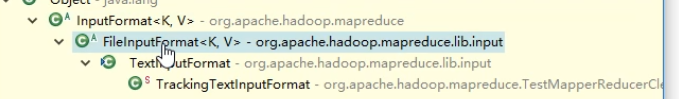
结论:框架默认使用的是TextInputFormat!!!
补充:继承关系InputFormat>FileInputformat>textInputformat
解析3源码:
static class NewTrackingRecordReader<K,V>
    extends org.apache.hadoop.mapreduce.RecordReader<K,V> {
    private final org.apache.hadoop.mapreduce.RecordReader<K,V> real;
    private final org.apache.hadoop.mapreduce.Counter inputRecordCounter;
    private final org.apache.hadoop.mapreduce.Counter fileInputByteCounter;
    private final TaskReporter reporter;
    private final List<Statistics> fsStats;

    NewTrackingRecordReader(org.apache.hadoop.mapreduce.InputSplit split,
        org.apache.hadoop.mapreduce.InputFormat<K, V> inputFormat,
        TaskReporter reporter,
        org.apache.hadoop.mapreduce.TaskAttemptContext taskContext)
        throws InterruptedException, IOException {
      this.reporter = reporter;
      this.inputRecordCounter = reporter
          .getCounter(TaskCounter.MAP_INPUT_RECORDS);
      this.fileInputByteCounter = reporter
          .getCounter(FileInputFormatCounter.BYTES_READ);

      List <Statistics> matchedStats = null;
      if (split instanceof org.apache.hadoop.mapreduce.lib.input.FileSplit) {
        matchedStats = getFsStatistics(((org.apache.hadoop.mapreduce.lib.input.FileSplit) split)
            .getPath(), taskContext.getConfiguration());
      }
      fsStats = matchedStats;

      long bytesInPrev = getInputBytes(fsStats);
      this.real = inputFormat.createRecordReader(split, taskContext);解析3.1 源码 real来源Linerecordere
      long bytesInCurr = getInputBytes(fsStats);
      fileInputByteCounter.increment(bytesInCurr - bytesInPrev);
    }
解析3.1 源码
public class TextInputFormat extends FileInputFormat<LongWritable, Text> {

  @Override
  public RecordReader<LongWritable, Text>
    createRecordReader(InputSplit split,
                       TaskAttemptContext context) {
    String delimiter = context.getConfiguration().get(
        "textinputformat.record.delimiter");
    byte[] recordDelimiterBytes = null;
    if (null != delimiter)
      recordDelimiterBytes = delimiter.getBytes(Charsets.UTF_8);
    return new LineRecordReader(recordDelimiterBytes);//返回Linerorder,行读取器
  }
解析4源码:
 public MapContextImpl(Configuration conf, TaskAttemptID taskid,
                        RecordReader<KEYIN,VALUEIN> reader,//reader即输入对象
                        RecordWriter<KEYOUT,VALUEOUT> writer,
                        OutputCommitter committer,
                        StatusReporter reporter,
                        InputSplit split) {
    super(conf, taskid, writer, committer, reporter);
    this.reader = reader;
    this.split = split;
  }
 /**
   * Get the input split for this map.
   */
  public InputSplit getInputSplit() {
    return split;
  }

  @Override
  public KEYIN getCurrentKey() throws IOException, InterruptedException {
    return reader.getCurrentKey();//调用输入的input 包含一个Linerecorder对象
  }

  @Override
  public VALUEIN getCurrentValue() throws IOException, InterruptedException {
    return reader.getCurrentValue();
  }

  @Override
  public boolean nextKeyValue() throws IOException, InterruptedException {
    return reader.nextKeyValue();
  }
解析5源码:
public void initialize(InputSplit genericSplit,
                         TaskAttemptContext context) throws IOException {
    FileSplit split = (FileSplit) genericSplit;
    Configuration job = context.getConfiguration();
    this.maxLineLength = job.getInt(MAX_LINE_LENGTH, Integer.MAX_VALUE);
    start = split.getStart();//切片的起始位置
    end = start + split.getLength();//切片的结束位置
    final Path file = split.getPath();

    // open the file and seek to the start of the split
    final FileSystem fs = file.getFileSystem(job);
    fileIn = fs.open(file);

    CompressionCodec codec = new CompressionCodecFactory(job).getCodec(file);
    if (null!=codec) {
      isCompressedInput = true;
      decompressor = CodecPool.getDecompressor(codec);
      if (codec instanceof SplittableCompressionCodec) {
        final SplitCompressionInputStream cIn =
          ((SplittableCompressionCodec)codec).createInputStream(
            fileIn, decompressor, start, end,
            SplittableCompressionCodec.READ_MODE.BYBLOCK);
        in = new CompressedSplitLineReader(cIn, job,
            this.recordDelimiterBytes);
        start = cIn.getAdjustedStart();
        end = cIn.getAdjustedEnd();
        filePosition = cIn;
      } else {
        in = new SplitLineReader(codec.createInputStream(fileIn,
            decompressor), job, this.recordDelimiterBytes);
        filePosition = fileIn;
      }
    } else {
      fileIn.seek(start);//很多mapper 去读对应的切片数量
      in = new UncompressedSplitLineReader(
          fileIn, job, this.recordDelimiterBytes, split.getLength());
      filePosition = fileIn;
    }
    // If this is not the first split, we always throw away first record
    // because we always (except the last split) read one extra line in
    // next() method.
    if (start != 0) {//除了第一个切片
      start += in.readLine(new Text(), 0, maxBytesToConsume(start));//匿名写法 输入初始化的时候 对于非第一个切片 读一行放空,算出长度,然后更新起始位置为第二行  这样每一个切片处理完的时候再多处理一行,这样就能保证还原。!!!
    }
    this.pos = start;
  }
解析6实际上调用的就是Mapper中的run方法。
public void run(Context context) throws IOException, InterruptedException {
    setup(context);
    try {
      while (context.nextKeyValue()) {/解析6.1
        map(context.getCurrentKey(), context.getCurrentValue(), context);
      }
    } finally {
      cleanup(context);
    }
  }
}
解析6.1追踪后实际上调用的是LineRewcorder中的NextKeyValue方法
public boolean nextKeyValue() throws IOException {
    if (key == null) {
      key = new LongWritable();//Key中要放置偏移量
    }
    key.set(pos);//偏移量
    if (value == null) {
      value = new Text();//默认
    }
    int newSize = 0;
    // We always read one extra line, which lies outside the upper
    // split limit i.e. (end - 1)
    while (getFilePosition() <= end || in.needAdditionalRecordAfterSplit()) {
      if (pos == 0) {
        newSize = skipUtfByteOrderMark();
      } else {
        newSize = in.readLine(value, maxLineLength, maxBytesToConsume(pos));//读到真的值了
        pos += newSize;
      }

      if ((newSize == 0) || (newSize < maxLineLength)) {
        break;
      }

      // line too long. try again
      LOG.info("Skipped line of size " + newSize + " at pos " +
               (pos - newSize));
    }
    if (newSize == 0) {
      key = null;
      value = null;
      return false;
    } else {
      return true;
    }
  }
@Override//由nextkeyValue更新值所以直接取值这块  这种取值方式叫做引用传递!!!
  public LongWritable getCurrentKey() {
    return key;
  }

  @Override
  public Text getCurrentValue() {
    return value;
  }
持续更新中。。。。,欢迎大家关注我的公众号LHWorld.


 934


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


