爬虫转大模型实战:采集能力还在,为什么权限日志成了最大短板?

Mythos能力包:大模型从模型交付到能力治理的范式跃迁 大模型正从‘模型即产品’走向‘能力即服务’的新阶段,其核心是将复杂推理能力解耦为可验证、可计量、可管控的原子化单元。这种能力原子化设计依托输入输出契约、资源稳定性保障与确定性失败模式三大工程原则,支撑起受控发布(Gated Release)机制——通过准入审计、沙箱验证与生产熔断三重闸门,实现安全、合规、按需的能力交付。技术价值不再体现于通用基准分数提升,而在于特定场景下如跨文档因果追溯、金融义务识别等高价值任务的精准提效与风险收敛。Mythos正是这一演进路径的典型代表,标志着AI能力进入精细化治理与场景 阅读详情

聊《我用爬虫经验做了次 AI 项目,最先失效的是旧方法》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

摘要:从爬虫转做大模型应用,很多人以为信息采集能力可以直接复用。但实际项目里,最先翻车的往往不是爬取环节,而是权限控制、日志追踪和可观测性。本文结合一个真实的知识库项目,拆解爬虫技能在大模型时代的延续与断裂,给出学习路线的取舍建议。

---

目录

  • 爬虫技能的价值:别急着丢掉老本行
  • 数据清洗:从"能抓"到"能喂"
  • 代码解释:关键代码的实现原理
  • 知识库构建:RAG语料生产的断点在哪
  • 合规边界:爬虫的灰色地带在大模型里会更明显
  • 总结:学习路线的取舍

---

爬虫技能的价值:别急着丢掉老本行

文章插图 1

转大模型之前,我也走过弯路。看到招聘JD上写"熟悉RAG、向量数据库、LangChain",第一反应是赶紧学这些新东西,爬虫经验好像不值钱了。

但实际项目做下来,发现爬虫阶段培养的能力并没有消失,只是换了个形式延续。

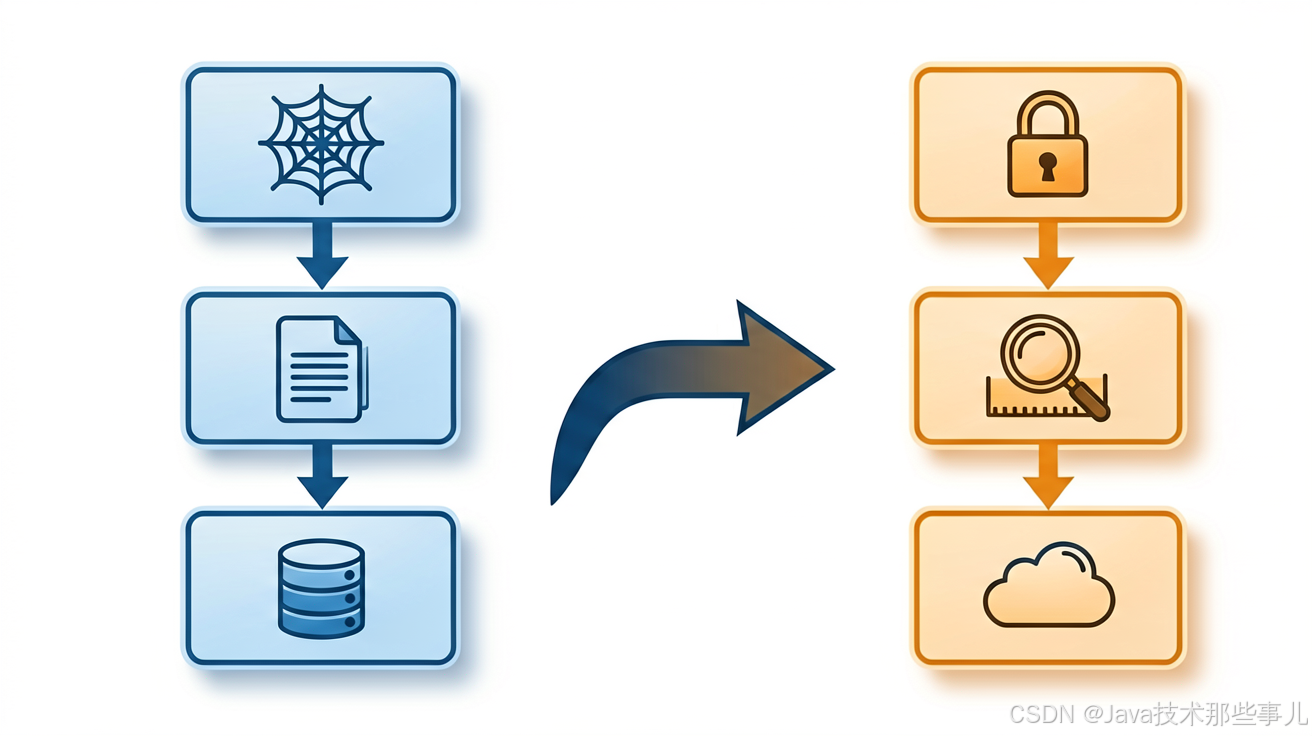
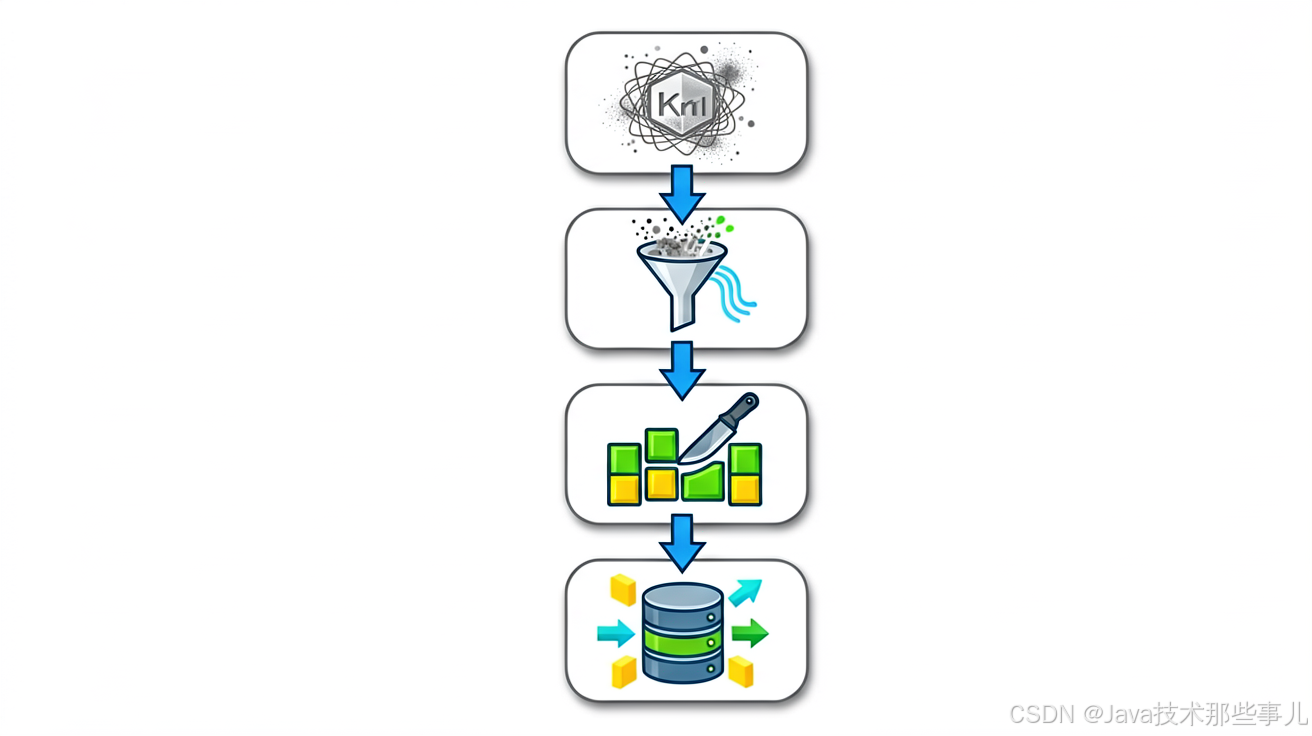
我做过一个企业内部知识库项目,需求是从十几个内部系统(OA、ERP、Wiki)采集文档,构建RAG语料库。整个流程分三步:

1. 数据采集:爬虫负责从各系统抓取文档,处理登录态、反爬策略、增量同步
2. 数据清洗:解析HTML、PDF、Word,提取正文,去除噪音
3. 向量化入库:切片、Embedding、存入向量数据库

前两步完全是爬虫的老本行。真正卡壳的地方在第三步之后——当模型开始返回结果时,权限控制和日志追踪成了新难题。

爬虫阶段你只需要考虑"能不能抓到",但大模型应用要考虑"谁能看到什么"、"为什么返回这个答案"、"调用链出了什么问题"。

这是第一个思维转换:从采集思维转向服务思维。

---

数据清洗:从"能抓"到"能喂"
文章插图 2

爬虫的数据清洗目标是提取有效信息,RAG的数据清洗目标是让切片可被向量模型理解。两者有重叠,但侧重点不同。

我遇到的一个具体场景:从内部Wiki采集的技术文档,HTML结构杂乱,包含大量导航、侧边栏、广告位。爬虫阶段我只需要提取正文,但RAG阶段需要保证切片后的文本语义完整。

import re
from langchain.text_splitter import RecursiveCharacterTextSplitter

def clean_and_chunk(raw_text: str, chunk_size: int = 512, chunk_overlap: int = 64) -> list:
    # 清理HTML标签和多余空白
    cleaned = re.sub(r'<[^>]+>', '', raw_text)
    cleaned = re.sub(r'\s+', ' ', cleaned).strip()

    # 按段落切分,保持语义完整
    paragraphs = [p.strip() for p in cleaned.split('\n') if p.strip()]

    # 递归字符切分器,避免切断句子
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=chunk_size,
        chunk_overlap=chunk_overlap,
        length_function=len,
        separators=['\n\n', '\n', '。', '.', ' ', '']
    )

    chunks = splitter.split_text(cleaned)
    return chunks

这段代码的输入是爬虫抓回的原始文本,输出是适合Embedding的切片。关键逻辑在于separators的优先级顺序——先尝试按段落切,不行再按句子,最后才按字符切。这是爬虫阶段不会考虑的:切片质量直接影响检索效果。

爬虫阶段的清洗目标是"提取正文",RAG阶段的清洗目标是"保持语义"。这个转变很多人没意识到,导致向量检索效果很差。

---
优快云资料领取方式

代码解释:关键代码的实现原理

下面对文中两段关键代码做详细拆解,帮助理解实现原理。

代码一:数据清洗与切片

输入:raw_text(含HTML标签的原始文本)、chunk_size(默认512字符)、chunk_overlap(默认64字符)

核心逻辑:

第一步用正则 re.sub(r'<[^>]+>', '', raw_text) 剥离所有HTML标签,再用 re.sub(r'\s+', ' ', cleaned) 把连续空白压缩成单个空格。这一步和爬虫阶段的清洗类似,但RAG阶段对"干净"的定义更严格——残留的换行符可能导致切片边界混乱。

第二步按 \n 分割段落,过滤空行。这里有个细节:爬虫阶段可能直接对整个文档切分,但RAG阶段先按段落分组,是为了让 RecursiveCharacterTextSplitter 在切分时优先保持段落完整。

第三步调用 LangChain 的递归切分器。separators 列表决定了切分优先级:先尝试 \n\n(段落间),再尝试 \n(行内),然后是中文句号 。、英文句号 .,最后才按空格和字符硬切。chunk_overlap=64 保证相邻切片有64字符重叠,避免关键信息被切断在边界上。

输出:list[str],每个元素是一段语义相对完整的文本,长度不超过 chunk_size。

异常处理:函数本身没有显式 try-except,但实际使用时需要处理三种情况:空文本(返回空列表)、超长段落(会被递归切分到字符级)、特殊字符(正则已处理大部分,但极端情况下可能产生异常编码)。生产环境建议在外层加一层校验。

代码二:权限检查装饰器

输入:被装饰的查询函数、user_id、query 及额外参数

核心逻辑:

这是一个典型的装饰器模式。@wraps(func) 保留原函数的元信息(名称、文档字符串),避免调试时混淆。

权限检查分两步:先调用 get_user_permissions(user_id) 获取用户权限集合,再用 check_query_permission(query, user_permissions) 判断当前查询是否越权。这里的关键是权限检查必须发生在查询执行之前,否则可能泄露敏感信息。

日志记录贯穿全程:查询开始记 info 日志并记录时间戳,成功时记录耗时,失败时记录异常堆栈。exc_info=True 确保异常信息完整输出,这对排查问题至关重要。

输出:与原函数相同的返回值,或在权限不足时抛出 PermissionError。

异常处理:try-except 捕获所有异常,记录错误日志后重新抛出(raise),不吞掉异常。这样做的好处是调用方仍能感知错误,同时日志系统保留了完整上下文。

---

知识库构建:RAG语料生产的断点在哪

这是我踩坑最深的地方。

真实案例

公司内部技术知识库项目,爬取了5000+篇技术文档,构建了完整的RAG链路。Demo阶段效果很好,检索准确率85%,模型回答质量也不错。但上线后,问题接踵而至。

排查过程

第一天上线,用户反馈"为什么这个答案不对"。我开始排查:

1. 现象:用户问的是"如何配置Redis集群",返回的答案是关于"Redis基础命令"
2. 验证动作:检查向量数据库,发现相关文档确实存在,相似度分数也正常
3. 进一步排查:检查日志,发现检索请求的权限token和Demo阶段不同
4. 排除结果:Demo用的是管理员权限,生产环境用的是普通用户权限。某些文档在普通用户权限下被过滤掉了,导致检索结果不完整

失败原因

| 错误类型 | 具体表现 | 排查方法 |
|---------|---------|---------|
| 业务错误 | 权限配置导致文档过滤 | 对比不同角色的检索结果 |
| 配置错误 | 向量模型与切片策略不匹配 | 检查chunk_size和模型上下文长度 |
| 环境错误 | 生产环境网络延迟导致超时 | 监控API响应时间 |

这个案例暴露了一个核心问题:Demo和生产的差距不在代码,而在工程化能力。

爬虫阶段你只需要处理"数据对不对",但大模型应用还要处理"谁能访问"、"访问日志怎么记录"、"出了问题怎么追踪"。

我后来在项目中加了完整的权限透传和日志追踪:

from functools import wraps
import logging
import time

logger = logging.getLogger(__name__)

def with_permission_check(func):
    @wraps(func)
    def wrapper(user_id, query, **kwargs):
        # 权限检查
        user_permissions = get_user_permissions(user_id)
        if not check_query_permission(query, user_permissions):
            logger.warning(f"用户 {user_id} 权限不足: {query}")
            raise PermissionError("无权访问该知识库")

        # 记录调用日志
        logger.info(f"用户 {user_id} 查询: {query}")
        start_time = time.time()

        try:
            result = func(user_id, query, **kwargs)
            logger.info(f"查询成功,耗时: {time.time() - start_time}s")
            return result
        except Exception as e:
            logger.error(f"查询失败: {e}", exc_info=True)
            raise

    return wrapper

适用边界

  • 个人Demo项目:可以先跳过权限和日志,专注RAG链路
  • 团队协作项目:权限和日志是必须的,否则维护成本会很高
  • 对外服务:合规要求更高,需要完整的审计日志

---

合规边界:爬虫的灰色地带在大模型里会更明显

爬虫阶段很多人会踩一些灰色地带:爬取公开数据但不遵守robots.txt、抓取用户数据但没有授权。这些问题在大模型时代会被放大。

我做知识库项目时,发现一个具体问题:爬取的某些技术文档来自第三方网站,虽然可以公开访问,但直接用于商业产品存在版权风险。

爬虫阶段的合规关注点是"能不能爬",大模型阶段的合规关注点是"能不能用"。这个转变很关键。

建议:

1. 数据来源合法化:优先使用自有数据或获得授权的数据
2. 用户隐私保护:不要在知识库中存储用户敏感信息
3. 合规审计:定期审查知识库的数据来源

---

总结:学习路线的取舍

从爬虫转大模型,我的建议是:

先补的:

  • 向量数据库基础(Milvus、Chroma、FAISS)
  • RAG架构理解(检索、重排序、生成)
  • 权限控制和日志追踪(这是Demo和生产的分水岭)

暂时放的:

  • 复杂的Agent框架(LangGraph、AutoGen等)
  • 模型微调(除非你有明确的业务需求)
  • 多模态RAG(文本已经够复杂了)

爬虫经验的核心价值在于数据处理能力和系统思维。这些能力在大模型时代依然有价值,只是应用场景变了。

最后说一句:别被"爬虫过时"的论调吓到。数据采集永远不会过时,只是从"抓取网页"变成了"整理知识"。真正稀缺的是能把数据变成可用知识的工程能力。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
AI大模型资料展示 1

AI大模型资料展示 2

AI大模型资料展示 3

AI大模型资料展示 4

AI大模型资料展示 5

需要这份AI大模型资料清单的话,在评论区回复「清单」即可;我会根据大家的问题继续补充对应的实战内容。
优快云官方大礼包

GLM-4国产大模型工程化落地:推理优化、商用授权与本地部署实战 大语言模型(LLM)的工程化落地,核心在于平衡模型能力、系统性能与合规可用性。从基础原理看,KV Cache管理、工具调用容错和细粒度授权机制,共同决定了模型能否在真实业务中‘敢用、好用、省心用’。技术价值体现在显著降低显存占用、提升API稳定性及支持嵌入式商用等关键能力;典型应用场景覆盖金融风控、政务知识库、医疗SaaS问答等对低延迟、高可靠、强审计有严苛要求的领域。本文聚焦GLM-4这一国产大模型新基座,深入解析其混合精度KV Cache压缩、原子化工具调用容错与分级商用授权三大技术锚点,为算法工程师、 阅读详情

相关推荐

电商预测性洞察:从数据到决策的七道实战关卡

预测性分析是现代电商运营的核心能力,其本质是将多源异构数据(如销售、用户行为、库存、物流)转化为可解释、可干预、可回溯的业务决策依据。它并非单纯追求算法准确率,而是强调在高噪声、高稀疏、高时效的电商数据环境中,通过模块化架构、领域知识驱动的特征工程与实时决策闭环,实现采购优化、动态库存预警、复购率预判等关键场景落地。本文聚焦Predictive Insights与e-Commerce深度融合的工程实践,详解如何让预测结果真正驱动一线动作——从数据可信度校验、行为语义翻译,到归因可视化、AB测试机制与人工兜底

weixin_33696822的博客 328

爬虫老手转大模型:数据能力凭什么从采集变成 RAG 的护城河

上周需求评审,产品经理甩过来一个"简单的小需求":给客服系统加个智能问答,能把过去两年的工单、FAQ 和内部文档都喂进去,让模型自动回复用户问题。团队里两个同学接了这个活。一个是大模型方向的新手,上来就装好 LangChain,调了个开源 Embedding 模型,数据往向量库一丢,Demo 跑通了,截图发群里,配文"搞定了"。另一个是有三年爬虫背景的同学,没急着写代码,先问了三句话:数据从哪来?质量怎么保证?权限和日志怎么设计?三周后,第一个 Demo 上线,客服反馈"答非所问的情况很多";

2601_96189167的博客 708

代码大模型安全测试:从Secure@k指标到工程化防护实践

代码大模型不同于通用大模型,其输出可直接执行,安全风险具有强破坏性。理解其安全机制需回归基础——它本质是基于提示词的语义意图识别系统,漏洞常隐匿于自然语言需求与代码生成之间的语义鸿沟中。Secure@k等量化指标突破了传统SAST/DAST对LLM生成代码的失效困境,将‘是否拒绝危险代码’转化为可测量、可归因的工程能力。该能力覆盖凭证硬编码、命令注入、反序列化等高频真实攻击场景,并深度适配Python、JavaScript等语言特异性风险。本文聚焦企业级落地,提供轻量测试集构建、本地化Secure@k自动化

cuanwei9356的博客 553

爬虫转大模型,真正拉开差距的不在模型,在数据采集

摘要:从爬虫转向大模型应用开发,很多人以为难点在模型调用或 Prompt 工程,但实际上真正拉开差距的是数据采集和处理的"脏活"。本文以一个法律文档分析工具的真实项目为例,拆解爬虫技能如何迁移到 RAG 系统、知识库构建和语料生产,同时补上权限、日志、可观测性这些 Demo 之后才暴露的工程短板。---爬虫转大模型,真正的竞争力不在模型调用,而在数据能力。具体体现在三个方面:第一,数据理解能力。知道数据从哪来、长什么样、有什么问题。这是爬虫经历带来的直觉,也是 RAG 系统能做好做差的分水岭。

LLM_9528的博客 697

云基础设施新范式:从资源租用到能力订阅的演进

云计算正经历从IaaS资源抽象向业务能力具象化的深层演进。传统云平台以vCPU、GB存储等原子资源为计费单元,依赖用户自主组装技术栈;而新一代基础设施通过eBPF网络优化、WASM轻量运行时和裸金属容器协同,将风控、AI推理、实时日志分析等高频场景封装为开箱即用的‘可编程能力单元’。这种Capability-as-a-Service模式显著降低技术决策半径,在保障SLA前提下实现成本下降40%+、交付周期压缩85%以上,尤其适用于高并发API、时序数据流与模型推理等确定性场景。

weixin_33984032的博客 369

GTM阶段竞争分析实战框架:从信源过滤到对抗指令

竞争分析不是竞品信息堆砌,而是支撑产品上市(GTM)决策的战略情报工作。其核心原理在于围绕定位、信息传递与转化路径,解构竞品在真实客户触点中的价值闭环。技术价值体现在将模糊洞察转化为可验证、可追溯、可执行的GTM动作,显著提升响应敏捷性与销售命中率。典型应用场景覆盖从0到1的认知抢占、1到10的转化拦截、10到100的生态压制三大阶段。本文聚焦GTM实战需求,系统拆解三层信源过滤网与逻辑验证方法,并输出可直接落地的对抗指令机制,助力团队构建高ROI的竞争分析作战体系。

weixin_33860528的博客 449

需求评审会上,PM问爬虫转大模型能干啥,我拿RAG语料生产打脸

摘要:爬虫工程师转大模型,最大的优势不是调 API,而是对"数据从哪里来、质量如何、能不能用"的直觉。本文以一次需求评审为引,讲清楚爬虫技能如何在 RAG 语料生产、数据清洗、知识库构建等环节变现,以及权限、日志、可观测这三笔账怎么算,踩过的坑和取舍都说清楚。---目录需求评审那堂课:爬虫背景的真正筹码爬虫技能在大模型项目里的三个变现点RAG 语料生产:从抓网页到喂模型数据清洗的取舍:不是洗得越干净越好知识库构建:权限和日志才是验收标准合规边界:爬虫转 AI 的红线总结:转型不是换技术栈,是换思维模型。

资料免费分享,点击名片 383

Hadoop+Spring Boot+爬虫:招聘信息分析系统实战全解析

数据挖掘是发现数据中潜在规律的核心手段,其落地依赖于海量数据的有效存储、清洗与计算。分布式计算框架Hadoop提供了可靠的HDFS存储与MapReduce离线处理能力,而Spring Boot作为成熟的后端服务框架,能够快速构建数据查询与可视化接口。在工程实践中,结合爬虫技术采集半结构化的网络数据,再经过数据清洗、聚类分析和关联规则挖掘,可以形成一条完整的“数据采集→存储计算→服务展示”链路。招聘信息分析正是这类技术架构的典型应用场景:面对岗位数据量大、字段杂、噪声高等挑战,借助Hadoop实现分布式清洗与

weixin_33889665的博客 369

爬虫转做大模型:别卷算法,先补齐权限与可观测的基建

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。最近面试了几个从爬虫转过来的朋友,大家都有一个共同的误区:觉得只要会写requests和,就能轻松上手 LLM 应用开发。甚至有人拿着跑通的 Demo 去面试,以为这就是核心竞争力。但现实很骨感。当你真正进入一家做 Agent 或者 RAG(检索增强生成)的团队时,你会发现,Demo 跑通只是冰山一角。

资料免费分享,点击名片 185

YOLO-FastestV2从零部署到移动端推理实战手册

本文详细介绍了YOLO-FastestV2从零开始的完整部署流程,涵盖环境搭建、模型训练、格式转换及移动端部署。通过实战步骤,指导开发者将这一轻量级目标检测模型成功部署到Android设备,实现实时推理。文章重点解析了PyTorch到NCNN的模型转换与优化,助力移动端AI应用开发。

l1k9j8h7g6的博客 670

使用 C# 实现大华监控摄像头的控制与数据处理

本文介绍了使用C#调用大华SDK(DHNetSDK.dll)开发监控系统的方法。主要内容包括:开发准备、DLL引用设置、SDK初始化与设备登录、视频预览窗口嵌入、云台控制、抓图录像等核心功能实现。通过P/Invoke技术封装SDK接口,开发者可以快速构建具有视频监控、设备控制功能的C#应用程序。文中还提供了代码示例、常见问题解决方案,以及视频帧智能分析的扩展建议,为开发大华监控系统的二次应用提供了完整的技术指南。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1283

爬虫老手做 RAG 总翻车?权限日志补齐前,别碰大模型工程

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。摘要很多爬虫开发者转做大模型应用时,习惯用“采集-清洗-入库”的线性思维去套 RAG(检索增强生成)。结果往往是:本地 Demo 跑通很爽,一上生产环境,Agent 因为权限越权、日志缺失或数据污染直接崩盘。本文不聊炫技,只聊从爬虫到 AI 数据工程的最痛断点:如何把“能抓到数据”变成“能安全、可观测地喂给模型”。重点剖析权限控制、结构化清洗和可观测性建设,给出转型期的取舍建议。---目录。

2601_96120158的博客 253

界面上下固定_基于ANSYS的胶粘结构界面开裂有限元计算

引言:目前工程上主要有螺栓,过盈,焊接和胶粘四种常用的连接方式,本文基于ANSYS Workbench环境,引入内聚力模型来实现对胶粘结构界面开裂失效的计算,文中的界面失效参数为随意给定,不是工程实际测试数据,仅起到演示作用!1.问题的描述如图所示给出了胶粘结构的三维模型,该胶粘结构由上下钢板组成,中间通过胶粘接到一起。(胶不需要建模,其影响主要通过内聚力模型实现)上下板的材料为结构钢,...

weixin_29473667的博客 1万+

数据采集该选动态IP还是静态IP?

摘要:在大数据采集场景中,动态IP与静态IP各有优势。静态IP稳定性强,适合长期任务和系统对接,但易被封禁;动态IP灵活抗封,适合高频采集,但会话持续性差。最佳实践是"动静结合":核心业务用静态IP保障稳定,大规模采集用动态IP池提升效率。选择关键在于匹配具体需求,同时需配合请求控制等综合策略,在效率与风控间取得平衡。(149字)

2301_80761287的博客 997

【YOLOv7-环境搭建】PyTorch安装后输出版本显示No module named ‘Torch’的解决方法

【YOLOv7-环境搭建】PyTorch安装后输出版本显示No module named ‘Torch’的解决方法:①检查PyCharm导入的环境是否错误②添加Torch包

qq_59942266的博客 4970

13、使用 Mathematica 撰写文本

本文详细介绍了如何使用 Mathematica 进行文本撰写与处理。内容涵盖文本输入、格式设置、结构化排版、超链接插入、翻译与拼写检查工具的使用,以及将笔记本导出为多种格式(如 PDF、HTML、LATEX 和 RTF)的方法。通过实例演示了创建专业文档的完整流程,包括样式设置、公式推导、标题编号、页眉页脚配置等操作。适合希望利用 Mathematica 编写学术论文、技术报告或教学资料的用户参考。

sony5的博客 208

大模型部署安全实践:从Qwen3.6-27B-FP8看全链路防护

在人工智能工程化实践中,模型部署是将算法能力转化为稳定服务的关键环节。其核心原理在于构建一个安全、可靠且高效的软件系统,以承载复杂的模型推理任务。这一过程的技术价值不仅在于实现功能,更在于保障服务的机密性、完整性和可用性,防止因安全漏洞导致的服务中断、数据泄露或经济损失。典型的应用场景包括云端API服务、企业内部知识库以及边缘计算设备等。随着像Qwen3.6-27B-FP8这类大参数、高性能模型的广泛应用,**模型部署**与**安全加固**已成为不可分割的一体两面。本文以具体实践为例,系统阐述了从环境隔离、

weixin_33910137的博客 525

【即插即用模块】Transformer篇 | AAAI 2026 | Circulant Attention:全新ViT自注意力范式,复杂度从O(N²) 降至O(NlogN)!

本文提出了一种基于频域优化的循环注意力模块(Circulant Attention),通过离散傅里叶变换(DFT)将传统自注意力中的矩阵乘法转化为频域元素乘法,显著降低了计算复杂度。该模块采用复数线性层适配频域特征,并引入门控调制机制增强表达能力,在保持全局依赖捕捉能力的同时,将复杂度从O(N²)降至O(NlogN)。实验表明,该模块在多种视觉任务中均能提升模型性能,且计算效率更高。适用于需要高效全局注意力的视觉Transformer架构,可作为传统自注意力的替代方案。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 153

代理IP团队化管理指南:API批量配IP与子账户权限实战

代理IP从个人工具演变为团队基础设施后,资源分配、权限隔离和成本归属成为核心管理难点。通过API批量配IP,团队可以将代理资源的申请、释放和标签绑定全部自动化,让配额调度从人工登记升级为系统策略;而子账户权限则能落实最小权限原则,实现独立Key、项目隔离和配额上限,避免互相挤兑与密钥泄露。一体化方案进一步打通控制台、审计、计费与告警,形成资源管理闭环。这类能力在数据采集、运营验证、测试仿真等场景中,显著提升稳定性并降低协作成本。选型时不应只看IP池大小,而应重点评估API能力、权限模型和一体化程度,才能真正

weixin_28839601的博客 172

咨询进阶——解读40页公司战略解码方法【附全文阅读】

战略解码是将企业战略转化为可执行计划的关键过程,强调垂直和水平一致性原则。通过KPI指标设计和目标分解,确保战略在各部门和岗位有效落地。解码过程包括战略澄清、目标牵引、绩效分解和承诺签订,输出战略解码图等文件。不同部门根据责任定位(如利润中心、绩效中心)采用差异化考核方式,实现战略有效执行。

cdfunlove的博客 150

【系统分析师】高分论文:论软件需求验证方法及应用

本文以某清算平台建设项目为例,探讨了软件需求验证方法的应用。该项目旨在隔离银行与支付公司的直接通信,满足央行监管要求。作为系统分析师,作者通过需求测试和需求评审两种方法确保需求质量。需求测试采用概念测试用例提前发现问题;需求评审通过正式与非正式形式多方确认需求。项目结合邮件评审、专家会议等方式,最终形成完善的需求文档。平台上线后运行良好,验证了需求管理的重要性。该案例表明,科学的需求验证是项目成功的关键保障。

数据知道的博客 8126

全栈数据科学家能力自检与实战成长地图

全栈数据科学家并非泛指掌握多种工具的技术通才,而是具备从商业问题定义、数据探查清洗、特征工程构建、模型开发验证,到服务部署监控及业务价值落地的全周期掌控力的专业角色。其核心在于理解‘问题流’闭环——将模糊业务诉求转化为可计算、可验证、可归因的数据任务,并在深度(如SQL分层建模、Flink水位线调优)、广度(覆盖数据价值链7大环节)与切换成本(跨环节快速定位根因)三维上动态平衡。该能力直接支撑实时风控、智能推荐、增长分析等高价值场景,尤其适用于已交付端到端数据产品、面临晋升或转型瓶颈的实战型数据从业者。

weixin_33674976的博客 329

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Python学习90%失败真相:环境配置与工程能力断层解析

Python是一门以实践为导向的通用编程语言,其核心价值在于解决真实问题而非掌握语法本身。理解Python解释器机制、虚拟环境原理和包管理逻辑,是构建稳定开发环境的基础;掌握pip、venv、conda等工具链的底层行为,才能规避依赖冲突与路径错误。技术价值体现在将代码从本地脚本升级为可部署、可监控、可协作的服务——这要求开发者具备调试思维、工程化意识和跨领域知识整合能力。典型应用场景包括自动化运维、工业PLC数据采集、AI模型服务封装及Web API开发。本文聚焦被主流培训长期忽视的硬核断层点,尤其围绕p

weixin_30745553的博客 319

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

3482个MCP Server中,真正值得用的只有这4类:实战避坑指南

MCP(Model Context Protocol)作为连接AI大模型与外部数据源、工具的标准接口协议,正快速改变开发者的工作方式。其原理是通过MCP Server封装具体服务,让Claude、Cursor等工具在对话中直接调用真实系统能力。面对npm、GitHub上数量激增的MCP Server,真正能稳定支撑业务场景的并不多。本文从数据库读写、浏览器自动化、设计协作、专业工具链四个维度展开,结合SQL Server配置、Computer Use与Playwright的选型对比、蓝湖MCP还原设计稿等真

weixin_34175509的博客 356

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Java+Python双引擎:AI应用与智能体开发实战路线解析

AI应用开发正从单一工具调用走向系统工程落地,企业真正缺的是能连接模型能力与业务系统的复合型工程师。理解大模型推理原理只是起点,掌握数据处理、Agent编排与Java服务治理的协同机制,才是实现智能体在生产环境稳定运行的关键。Python负责快速实验与模型调用,Java承载高并发与事务一致性,两者结合构成AI应用开发的核心技术栈。无论是构建RAG知识库还是设计多步骤Agent,都需要懂状态机设计、异常容错与接口集成。本文从双语言分工的底层逻辑出发,结合LangGraph等框架实践,梳理从环境配置到项目闭环的

weixin_29048309的博客 106

GEO如何控制AI搜索爬虫?robots.txt、noindex与训练抓取权限实战

GEO中的爬虫访问控制需区分搜索抓取与模型训练抓取,因二者目的不同。OpenAI的OAI-SearchBot与GPTBot、Google的Googlebot与Google-Extended可独立配置。robots.txt控制抓取权限,noindex控制索引,二者不可混淆;仅靠Disallow无法确保内容不被索引。配置时应避免通配符规则叠加错误,且需结合服务器认证保障安全。验证可通过Python robotparser工具及实际日志分析。关键在于:规则表达意图≠平台必然执行,需依平台文档精准配置。

AB 客·外贸 B2B GEO 系统化提供商的博客 240
上一篇: Codex写代码很顺,为什么联调时反而拖慢了团队?
下一篇: LangGraph 工作流:权限日志跟不上,Agent 上线第一天就翻车
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值