


本章介绍普里姆算法。和以往一样,本文会先对普里姆算法的理论论知识进行介绍,然后给出C语言的实现。后续再分别给出C++和Java版本的实现。
目录
1. 普里姆算法介绍
2. 普里姆算法图解
3. 普里姆算法的代码说明
4. 普里姆算法的源码转载请注明出处:http://www.cnblogs.com/skywang12345/
更多内容:数据结构与算法系列 目录
普里姆算法介绍
普里姆(Prim)算法,和克鲁斯卡尔算法一样,是用来求加权连通图的最小生成树的算法。
基本思想
对于图G而言,V是所有顶点的集合;现在,设置两个新的集合U和T,其中U用于存放G的最小生成树中的顶点,T存放G的最小生成树中的边。 从所有uЄU,vЄ(V-U) (V-U表示出去U的所有顶点)的边中选取权值最小的边(u, v),将顶点v加入集合U中,将边(u, v)加入集合T中,如此不断重复,直到U=V为止,最小生成树构造完毕,这时集合T中包含了最小生成树中的所有边。
普里姆算法图解
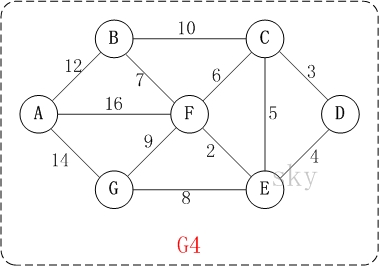
以上图G4为例,来对普里姆进行演示(从第一个顶点A开始通过普里姆算法生成最小生成树)。

初始状态:V是所有顶点的集合,即V={A,B,C,D,E,F,G};U和T都是空!
第1步:将顶点A加入到U中。
此时,U={A}。
第2步:将顶点B加入到U中。
上一步操作之后,U={A}, V-U={B,C,D,E,F,G};因此,边(A,B)的权值最小。将顶点B添加到U中;此时,U={A,B}。
第3步:将顶点F加入到U中。
上一步操作之后,U={A,B}, V-U={C,D,E,F,G};因此,边(B,F)的权值最小。将顶点F添加到U中;此时,U={A,B,F}。
第4步:将顶点E加入到U中。
上一步操作之后,U={A,B,F}, V-U={C,D,E,G};因此,边(F,E)的权值最小。将顶点E添加到U中;此时,U={A,B,F,E}。
第5步:将顶点D加入到U中。
上一步操作之后,U={A,B,F,E}, V-U={C,D,G};因此,边(E,D)的权值最小。将顶点D添加到U中;此时,U={A,B,F,E,D}。
第6步:将顶点C加入到U中。
上一步操作之后,U={A,B,F,E,D}, V-U={C,G};因此,边(D,C)的权值最小。将顶点C添加到U中;此时,U={A,B,F,E,D,C}。
第7步:将顶点G加入到U中。
上一步操作之后,U={A,B,F,E,D,C}, V-U={G};因此,边(F,G)的权值最小。将顶点G添加到U中;此时,U=V。
此时,最小生成树构造完成!它包括的顶点依次是:A B F E D C G。
普里姆算法的代码说明
以"邻接矩阵"为例对普里姆算法进行说明,对于"邻接表"实现的图在后面会给出相应的源码。
1. 基本定义

-
// 邻接矩阵 -
typedef struct _graph -
{ -
char vexs[MAX]; // 顶点集合 -
int vexnum; // 顶点数 -
int edgnum; // 边数 -
int matrix[MAX][MAX]; // 邻接矩阵 -
}Graph, *PGraph; -
// 边的结构体 -
typedef struct _EdgeData -
{ -
char start; // 边的起点 -
char end; // 边的终点 -
int weight; // 边的权重 -
}EData;
Graph是邻接矩阵对应的结构体。
vexs用于保存顶点,vexnum是顶点数,edgnum是边数;matrix则是用于保存矩阵信息的二维数组。例如,matrix[i][j]=1,则表示"顶点i(即vexs[i])"和"顶点j(即vexs[j])"是邻接点;matrix[i][j]=0,则表示它们不是邻接点。
EData是邻接矩阵边对应的结构体。
2. 普里姆算法
-
/* -
* prim最小生成树 -
* -
* 参数说明: -
* G -- 邻接矩阵图 -
* start -- 从图中的第start个元素开始,生成最小树 -
*/ -
void prim(Graph G, int start) -
{ -
int min,i,j,k,m,n,sum; -
int index=0; // prim最小树的索引,即prims数组的索引 -
char prims[MAX]; // prim最小树的结果数组 -
int weights[MAX]; // 顶点间边的权值 -
// prim最小生成树中第一个数是"图中第start个顶点",因为是从start开始的。 -
prims[index++] = G.vexs[start]; -
// 初始化"顶点的权值数组", -
// 将每个顶点的权值初始化为"第start个顶点"到"该顶点"的权值。 -
for (i = 0; i < G.vexnum; i++ ) -
weights[i] = G.matrix[start][i]; -
// 将第start个顶点的权值初始化为0。 -
// 可以理解为"第start个顶点到它自身的距离为0"。 -
weights[start] = 0; -
for (i = 0; i < G.vexnum; i++) -
{ -
// 由于从start开始的,因此不需要再对第start个顶点进行处理。 -
if(start == i) -
continue; -
j = 0; -
k = 0; -
min = INF; -
// 在未被加入到最小生成树的顶点中,找出权值最小的顶点。 -
while (j < G.vexnum) -
{ -
// 若weights[j]=0,意味着"第j个节点已经被排序过"(或者说已经加入了最小生成树中)。 -
if (weights[j] != 0 && weights[j] < min) -
{ -
min = weights[j]; -
k = j; -
} -
j++; -
} -
// 经过上面的处理后,在未被加入到最小生成树的顶点中,权值最小的顶点是第k个顶点。 -
// 将第k个顶点加入到最小生成树的结果数组中 -
prims[index++] = G.vexs[k]; -
// 将"第k个顶点的权值"标记为0,意味着第k个顶点已经排序过了(或者说已经加入了最小树结果中)。 -
weights[k] = 0; -
// 当第k个顶点被加入到最小生成树的结果数组中之后,更新其它顶点的权值。 -
for (j = 0 ; j < G.vexnum; j++) -
{ -
// 当第j个节点没有被处理,并且需要更新时才被更新。 -
if (weights[j] != 0 && G.matrix[k][j] < weights[j]) -
weights[j] = G.matrix[k][j]; -
} -
} -
// 计算最小生成树的权值 -
sum = 0; -
for (i = 1; i < index; i++) -
{ -
min = INF; -
// 获取prims[i]在G中的位置 -
n = get_position(G, prims[i]); -
// 在vexs[0...i]中,找出到j的权值最小的顶点。 -
for (j = 0; j < i; j++) -
{ -
m = get_position(G, prims[j]); -
if (G.matrix[m][n]<min) -
min = G.matrix[m][n]; -
} -
sum += min; -
} -
// 打印最小生成树 -
printf("PRIM(%c)=%d: ", G.vexs[start], sum); -
for (i = 0; i < index; i++) -
printf("%c ", prims[i]); -
printf("\n"); -
}
普里姆算法的源码
这里分别给出"邻接矩阵图"和"邻接表图"的普里姆算法源码。
/**
* C: prim算法生成最小生成树(邻接矩阵)
*
* @author skywang
* @date 2014/04/23
*/
#include <stdio.h>
#include <stdlib.h>
#include <malloc.h>
#include <string.h>
#define MAX 100 // 矩阵最大容量
#define INF (~(0x1<<31)) // 最大值(即0X7FFFFFFF)
#define isLetter(a) ((((a)>='a')&&((a)<='z')) || (((a)>='A')&&((a)<='Z')))
#define LENGTH(a) (sizeof(a)/sizeof(a[0]))
// 邻接矩阵
typedef struct _graph
{
char vexs[MAX]; // 顶点集合
int vexnum; // 顶点数
int edgnum; // 边数
int matrix[MAX][MAX]; // 邻接矩阵
}Graph, *PGraph;
/*
* 返回ch在matrix矩阵中的位置
*/
static int get_position(Graph g, char ch)
{
int i;
for(i=0; i<g.vexnum; i++)
if(g.vexs[i]==ch)
return i;
return -1;
}
/*
* 读取一个输入字符
*/
static char read_char()
{
char ch;
do {
ch = getchar();
} while(!isLetter(ch));
return ch;
}
/*
* 创建图(自己输入)
*/
Graph* create_graph()
{
char c1, c2;
int v, e;
int i, j, weight, p1, p2;
Graph* pG;
// 输入"顶点数"和"边数"
printf("input vertex number: ");
scanf("%d", &v);
printf("input edge number: ");
scanf("%d", &e);
if ( v < 1 || e < 1 || (e > (v * (v-1))))
{
printf("input error: invalid parameters!\n");
return NULL;
}
if ((pG=(Graph*)malloc(sizeof(Graph))) == NULL )
return NULL;
memset(pG, 0, sizeof(Graph));
// 初始化"顶点数"和"边数"
pG->vexnum = v;
pG->edgnum = e;
// 初始化"顶点"
for (i = 0; i < pG->vexnum; i++)
{
printf("vertex(%d): ", i);
pG->vexs[i] = read_char();
}
// 1. 初始化"边"的权值
for (i = 0; i < pG->vexnum; i++)
{
for (j = 0; j < pG->vexnum; j++)
{
if (i==j)
pG->matrix[i][j] = 0;
else
pG->matrix[i][j] = INF;
}
}
// 2. 初始化"边"的权值: 根据用户的输入进行初始化
for (i = 0; i < pG->edgnum; i++)
{
// 读取边的起始顶点,结束顶点,权值
printf("edge(%d):", i);
c1 = read_char();
c2 = read_char();
scanf("%d", &weight);
p1 = get_position(*pG, c1);
p2 = get_position(*pG, c2);
if (p1==-1 || p2==-1)
{
printf("input error: invalid edge!\n");
free(pG);
return NULL;
}
pG->matrix[p1][p2] = weight;
pG->matrix[p2][p1] = weight;
}
return pG;
}
/*
* 创建图(用已提供的矩阵)
*/
Graph* create_example_graph()
{
char vexs[] = {'A', 'B', 'C', 'D', 'E', 'F', 'G'};
int matrix[][9] = {
/*A*//*B*//*C*//*D*//*E*//*F*//*G*/
/*A*/ { 0, 12, INF, INF, INF, 16, 14},
/*B*/ { 12, 0, 10, INF, INF, 7, INF},
/*C*/ { INF, 10, 0, 3, 5, 6, INF},
/*D*/ { INF, INF, 3, 0, 4, INF, INF},
/*E*/ { INF, INF, 5, 4, 0, 2, 8},
/*F*/ { 16, 7, 6, INF, 2, 0, 9},
/*G*/ { 14, INF, INF, INF, 8, 9, 0}};
int vlen = LENGTH(vexs);
int i, j;
Graph* pG;
// 输入"顶点数"和"边数"
if ((pG=(Graph*)malloc(sizeof(Graph))) == NULL )
return NULL;
memset(pG, 0, sizeof(Graph));
// 初始化"顶点数"
pG->vexnum = vlen;
// 初始化"顶点"
for (i = 0; i < pG->vexnum; i++)
pG->vexs[i] = vexs[i];
// 初始化"边"
for (i = 0; i < pG->vexnum; i++)
for (j = 0; j < pG->vexnum; j++)
pG->matrix[i][j] = matrix[i][j];
// 统计边的数目
for (i = 0; i < pG->vexnum; i++)
for (j = 0; j < pG->vexnum; j++)
if (i!=j && pG->matrix[i][j]!=INF)
pG->edgnum++;
pG->edgnum /= 2;
return pG;
}
/*
* 返回顶点v的第一个邻接顶点的索引,失败则返回-1
*/
static int first_vertex(Graph G, int v)
{
int i;
if (v<0 || v>(G.vexnum-1))
return -1;
for (i = 0; i < G.vexnum; i++)
if (G.matrix[v][i]!=0 && G.matrix[v][i]!=INF)
return i;
return -1;
}
/*
* 返回顶点v相对于w的下一个邻接顶点的索引,失败则返回-1
*/
static int next_vertix(Graph G, int v, int w)
{
int i;
if (v<0 || v>(G.vexnum-1) || w<0 || w>(G.vexnum-1))
return -1;
for (i = w + 1; i < G.vexnum; i++)
if (G.matrix[v][i]!=0 && G.matrix[v][i]!=INF)
return i;
return -1;
}
/*
* 深度优先搜索遍历图的递归实现
*/
static void DFS(Graph G, int i, int *visited)
{
int w;
visited[i] = 1;
printf("%c ", G.vexs[i]);
// 遍历该顶点的所有邻接顶点。若是没有访问过,那么继续往下走
for (w = first_vertex(G, i); w >= 0; w = next_vertix(G, i, w))
{
if (!visited[w])
DFS(G, w, visited);
}
}
/*
* 深度优先搜索遍历图
*/
void DFSTraverse(Graph G)
{
int i;
int visited[MAX]; // 顶点访问标记
// 初始化所有顶点都没有被访问
for (i = 0; i < G.vexnum; i++)
visited[i] = 0;
printf("DFS: ");
for (i = 0; i < G.vexnum; i++)
{
//printf("\n== LOOP(%d)\n", i);
if (!visited[i])
DFS(G, i, visited);
}
printf("\n");
}
/*
* 广度优先搜索(类似于树的层次遍历)
*/
void BFS(Graph G)
{
int head = 0;
int rear = 0;
int queue[MAX]; // 辅组队列
int visited[MAX]; // 顶点访问标记
int i, j, k;
for (i = 0; i < G.vexnum; i++)
visited[i] = 0;
printf("BFS: ");
for (i = 0; i < G.vexnum; i++)
{
if (!visited[i])
{
visited[i] = 1;
printf("%c ", G.vexs[i]);
queue[rear++] = i; // 入队列
}
while (head != rear)
{
j = queue[head++]; // 出队列
for (k = first_vertex(G, j); k >= 0; k = next_vertix(G, j, k)) //k是为访问的邻接顶点
{
if (!visited[k])
{
visited[k] = 1;
printf("%c ", G.vexs[k]);
queue[rear++] = k;
}
}
}
}
printf("\n");
}
/*
* 打印矩阵队列图
*/
void print_graph(Graph G)
{
int i,j;
printf("Martix Graph:\n");
for (i = 0; i < G.vexnum; i++)
{
for (j = 0; j < G.vexnum; j++)
printf("%10d ", G.matrix[i][j]);
printf("\n");
}
}
/*
* prim最小生成树
*
* 参数说明:
* G -- 邻接矩阵图
* start -- 从图中的第start个元素开始,生成最小树
*/
void prim(Graph G, int start)
{
int min,i,j,k,m,n,sum;
int index=0; // prim最小树的索引,即prims数组的索引
char prims[MAX]; // prim最小树的结果数组
int weights[MAX]; // 顶点间边的权值
// prim最小生成树中第一个数是"图中第start个顶点",因为是从start开始的。
prims[index++] = G.vexs[start];
// 初始化"顶点的权值数组",
// 将每个顶点的权值初始化为"第start个顶点"到"该顶点"的权值。
for (i = 0; i < G.vexnum; i++ )
weights[i] = G.matrix[start][i];
// 将第start个顶点的权值初始化为0。
// 可以理解为"第start个顶点到它自身的距离为0"。
weights[start] = 0;
for (i = 0; i < G.vexnum; i++)
{
// 由于从start开始的,因此不需要再对第start个顶点进行处理。
if(start == i)
continue;
j = 0;
k = 0;
min = INF;
// 在未被加入到最小生成树的顶点中,找出权值最小的顶点。
while (j < G.vexnum)
{
// 若weights[j]=0,意味着"第j个节点已经被排序过"(或者说已经加入了最小生成树中)。
if (weights[j] != 0 && weights[j] < min)
{
min = weights[j];
k = j;
}
j++;
}
// 经过上面的处理后,在未被加入到最小生成树的顶点中,权值最小的顶点是第k个顶点。
// 将第k个顶点加入到最小生成树的结果数组中
prims[index++] = G.vexs[k];
// 将"第k个顶点的权值"标记为0,意味着第k个顶点已经排序过了(或者说已经加入了最小树结果中)。
weights[k] = 0;
// 当第k个顶点被加入到最小生成树的结果数组中之后,更新其它顶点的权值。
for (j = 0 ; j < G.vexnum; j++)
{
// 当第j个节点没有被处理,并且需要更新时才被更新。
if (weights[j] != 0 && G.matrix[k][j] < weights[j])
weights[j] = G.matrix[k][j];
}
}
// 计算最小生成树的权值
sum = 0;
for (i = 1; i < index; i++)
{
min = INF;
// 获取prims[i]在G中的位置
n = get_position(G, prims[i]);
// 在vexs[0...i]中,找出到j的权值最小的顶点。
for (j = 0; j < i; j++)
{
m = get_position(G, prims[j]);
if (G.matrix[m][n]<min)
min = G.matrix[m][n];
}
sum += min;
}
// 打印最小生成树
printf("PRIM(%c)=%d: ", G.vexs[start], sum);
for (i = 0; i < index; i++)
printf("%c ", prims[i]);
printf("\n");
}
void main()
{
Graph* pG;
// 自定义"图"(输入矩阵队列)
//pG = create_graph();
// 采用已有的"图"
pG = create_example_graph();
//print_graph(*pG); // 打印图
//DFSTraverse(*pG); // 深度优先遍历
//BFS(*pG); // 广度优先遍历
prim(*pG, 0); // prim算法生成最小生成树
}
/**
* C: prim算法生成最小生成树(邻接表)
*
* @author skywang
* @date 2014/04/23
*/
#include <stdio.h>
#include <stdlib.h>
#include <malloc.h>
#include <string.h>
#define MAX 100
#define INF (~(0x1<<31)) // 最大值(即0X7FFFFFFF)
#define isLetter(a) ((((a)>='a')&&((a)<='z')) || (((a)>='A')&&((a)<='Z')))
#define LENGTH(a) (sizeof(a)/sizeof(a[0]))
// 邻接表中表对应的链表的顶点
typedef struct _ENode
{
int ivex; // 该边的顶点的位置
int weight; // 该边的权
struct _ENode *next_edge; // 指向下一条弧的指针
}ENode, *PENode;
// 邻接表中表的顶点
typedef struct _VNode
{
char data; // 顶点信息
ENode *first_edge; // 指向第一条依附该顶点的弧
}VNode;
// 邻接表
typedef struct _LGraph
{
int vexnum; // 图的顶点的数目
int edgnum; // 图的边的数目
VNode vexs[MAX];
}LGraph;
/*
* 返回ch在matrix矩阵中的位置
*/
static int get_position(LGraph g, char ch)
{
int i;
for(i=0; i<g.vexnum; i++)
if(g.vexs[i].data==ch)
return i;
return -1;
}
/*
* 读取一个输入字符
*/
static char read_char()
{
char ch;
do {
ch = getchar();
} while(!isLetter(ch));
return ch;
}
/*
* 将node链接到list的末尾
*/
static void link_last(ENode *list, ENode *node)
{
ENode *p = list;
while(p->next_edge)
p = p->next_edge;
p->next_edge = node;
}
/*
* 创建邻接表对应的图(自己输入)
*/
LGraph* create_lgraph()
{
char c1, c2;
int v, e;
int i, p1, p2;
int weight;
ENode *node1, *node2;
LGraph* pG;
// 输入"顶点数"和"边数"
printf("input vertex number: ");
scanf("%d", &v);
printf("input edge number: ");
scanf("%d", &e);
if ( v < 1 || e < 1 || (e > (v * (v-1))))
{
printf("input error: invalid parameters!\n");
return NULL;
}
if ((pG=(LGraph*)malloc(sizeof(LGraph))) == NULL )
return NULL;
memset(pG, 0, sizeof(LGraph));
// 初始化"顶点数"和"边数"
pG->vexnum = v;
pG->edgnum = e;
// 初始化"邻接表"的顶点
for(i=0; i<pG->vexnum; i++)
{
printf("vertex(%d): ", i);
pG->vexs[i].data = read_char();
pG->vexs[i].first_edge = NULL;
}
// 初始化"邻接表"的边
for(i=0; i<pG->edgnum; i++)
{
// 读取边的起始顶点,结束顶点,权
printf("edge(%d): ", i);
c1 = read_char();
c2 = read_char();
scanf("%d", &weight);
p1 = get_position(*pG, c1);
p2 = get_position(*pG, c2);
// 初始化node1
node1 = (ENode*)malloc(sizeof(ENode));
node1->ivex = p2;
node1->weight = weight;
// 将node1链接到"p1所在链表的末尾"
if(pG->vexs[p1].first_edge == NULL)
pG->vexs[p1].first_edge = node1;
else
link_last(pG->vexs[p1].first_edge, node1);
// 初始化node2
node2 = (ENode*)malloc(sizeof(ENode));
node2->ivex = p1;
node2->weight = weight;
// 将node2链接到"p2所在链表的末尾"
if(pG->vexs[p2].first_edge == NULL)
pG->vexs[p2].first_edge = node2;
else
link_last(pG->vexs[p2].first_edge, node2);
}
return pG;
}
// 边的结构体(用来创建示例图)
typedef struct _edata
{
char start; // 边的起点
char end; // 边的终点
int weight; // 边的权重
}EData;
// 顶点
static char gVexs[] = {'A', 'B', 'C', 'D', 'E', 'F', 'G'};
// 边
static EData gEdges[] = {
// 起点 终点 权
{'A', 'B', 12},
{'A', 'F', 16},
{'A', 'G', 14},
{'B', 'C', 10},
{'B', 'F', 7},
{'C', 'D', 3},
{'C', 'E', 5},
{'C', 'F', 6},
{'D', 'E', 4},
{'E', 'F', 2},
{'E', 'G', 8},
{'F', 'G', 9},
};
/*
* 创建邻接表对应的图(用已提供的数据)
*/
LGraph* create_example_lgraph()
{
char c1, c2;
int vlen = LENGTH(gVexs);
int elen = LENGTH(gEdges);
int i, p1, p2;
int weight;
ENode *node1, *node2;
LGraph* pG;
if ((pG=(LGraph*)malloc(sizeof(LGraph))) == NULL )
return NULL;
memset(pG, 0, sizeof(LGraph));
// 初始化"顶点数"和"边数"
pG->vexnum = vlen;
pG->edgnum = elen;
// 初始化"邻接表"的顶点
for(i=0; i<pG->vexnum; i++)
{
pG->vexs[i].data = gVexs[i];
pG->vexs[i].first_edge = NULL;
}
// 初始化"邻接表"的边
for(i=0; i<pG->edgnum; i++)
{
// 读取边的起始顶点,结束顶点,权
c1 = gEdges[i].start;
c2 = gEdges[i].end;
weight = gEdges[i].weight;
p1 = get_position(*pG, c1);
p2 = get_position(*pG, c2);
// 初始化node1
node1 = (ENode*)malloc(sizeof(ENode));
node1->ivex = p2;
node1->weight = weight;
// 将node1链接到"p1所在链表的末尾"
if(pG->vexs[p1].first_edge == NULL)
pG->vexs[p1].first_edge = node1;
else
link_last(pG->vexs[p1].first_edge, node1);
// 初始化node2
node2 = (ENode*)malloc(sizeof(ENode));
node2->ivex = p1;
node2->weight = weight;
// 将node2链接到"p2所在链表的末尾"
if(pG->vexs[p2].first_edge == NULL)
pG->vexs[p2].first_edge = node2;
else
link_last(pG->vexs[p2].first_edge, node2);
}
return pG;
}
/*
* 深度优先搜索遍历图的递归实现
*/
static void DFS(LGraph G, int i, int *visited)
{
int w;
ENode *node;
visited[i] = 1;
printf("%c ", G.vexs[i].data);
node = G.vexs[i].first_edge;
while (node != NULL)
{
if (!visited[node->ivex])
DFS(G, node->ivex, visited);
node = node->next_edge;
}
}
/*
* 深度优先搜索遍历图
*/
void DFSTraverse(LGraph G)
{
int i;
int visited[MAX]; // 顶点访问标记
// 初始化所有顶点都没有被访问
for (i = 0; i < G.vexnum; i++)
visited[i] = 0;
printf("DFS: ");
for (i = 0; i < G.vexnum; i++)
{
if (!visited[i])
DFS(G, i, visited);
}
printf("\n");
}
/*
* 广度优先搜索(类似于树的层次遍历)
*/
void BFS(LGraph G)
{
int head = 0;
int rear = 0;
int queue[MAX]; // 辅组队列
int visited[MAX]; // 顶点访问标记
int i, j, k;
ENode *node;
for (i = 0; i < G.vexnum; i++)
visited[i] = 0;
printf("BFS: ");
for (i = 0; i < G.vexnum; i++)
{
if (!visited[i])
{
visited[i] = 1;
printf("%c ", G.vexs[i].data);
queue[rear++] = i; // 入队列
}
while (head != rear)
{
j = queue[head++]; // 出队列
node = G.vexs[j].first_edge;
while (node != NULL)
{
k = node->ivex;
if (!visited[k])
{
visited[k] = 1;
printf("%c ", G.vexs[k].data);
queue[rear++] = k;
}
node = node->next_edge;
}
}
}
printf("\n");
}
/*
* 打印邻接表图
*/
void print_lgraph(LGraph G)
{
int i,j;
ENode *node;
printf("List Graph:\n");
for (i = 0; i < G.vexnum; i++)
{
printf("%d(%c): ", i, G.vexs[i].data);
node = G.vexs[i].first_edge;
while (node != NULL)
{
printf("%d(%c) ", node->ivex, G.vexs[node->ivex].data);
node = node->next_edge;
}
printf("\n");
}
}
/*
* 获取G中边<start, end>的权值;若start和end不是连通的,则返回无穷大。
*/
int getWeight(LGraph G, int start, int end)
{
ENode *node;
if (start==end)
return 0;
node = G.vexs[start].first_edge;
while (node!=NULL)
{
if (end==node->ivex)
return node->weight;
node = node->next_edge;
}
return INF;
}
/*
* prim最小生成树
*
* 参数说明:
* G -- 邻接表图
* start -- 从图中的第start个元素开始,生成最小树
*/
void prim(LGraph G, int start)
{
int min,i,j,k,m,n,tmp,sum;
int index=0; // prim最小树的索引,即prims数组的索引
char prims[MAX]; // prim最小树的结果数组
int weights[MAX]; // 顶点间边的权值
// prim最小生成树中第一个数是"图中第start个顶点",因为是从start开始的。
prims[index++] = G.vexs[start].data;
// 初始化"顶点的权值数组",
// 将每个顶点的权值初始化为"第start个顶点"到"该顶点"的权值。
for (i = 0; i < G.vexnum; i++ )
weights[i] = getWeight(G, start, i);
for (i = 0; i < G.vexnum; i++)
{
// 由于从start开始的,因此不需要再对第start个顶点进行处理。
if(start == i)
continue;
j = 0;
k = 0;
min = INF;
// 在未被加入到最小生成树的顶点中,找出权值最小的顶点。
while (j < G.vexnum)
{
// 若weights[j]=0,意味着"第j个节点已经被排序过"(或者说已经加入了最小生成树中)。
if (weights[j] != 0 && weights[j] < min)
{
min = weights[j];
k = j;
}
j++;
}
// 经过上面的处理后,在未被加入到最小生成树的顶点中,权值最小的顶点是第k个顶点。
// 将第k个顶点加入到最小生成树的结果数组中
prims[index++] = G.vexs[k].data;
// 将"第k个顶点的权值"标记为0,意味着第k个顶点已经排序过了(或者说已经加入了最小树结果中)。
weights[k] = 0;
// 当第k个顶点被加入到最小生成树的结果数组中之后,更新其它顶点的权值。
for (j = 0 ; j < G.vexnum; j++)
{
// 获取第k个顶点到第j个顶点的权值
tmp = getWeight(G, k, j);
// 当第j个节点没有被处理,并且需要更新时才被更新。
if (weights[j] != 0 && tmp < weights[j])
weights[j] = tmp;
}
}
// 计算最小生成树的权值
sum = 0;
for (i = 1; i < index; i++)
{
min = INF;
// 获取prims[i]在G中的位置
n = get_position(G, prims[i]);
// 在vexs[0...i]中,找出到j的权值最小的顶点。
for (j = 0; j < i; j++)
{
m = get_position(G, prims[j]);
tmp = getWeight(G, m, n);
if (tmp < min)
min = tmp;
}
sum += min;
}
// 打印最小生成树
printf("PRIM(%c)=%d: ", G.vexs[start].data, sum);
for (i = 0; i < index; i++)
printf("%c ", prims[i]);
printf("\n");
}
void main()
{
LGraph* pG;
// 自定义"图"(自己输入数据)
//pG = create_lgraph();
// 采用已有的"图"
pG = create_example_lgraph();
//print_lgraph(*pG); // 打印图
//DFSTraverse(*pG); // 深度优先遍历
//BFS(*pG); // 广度优先遍历
prim(*pG, 0); // prim算法生成最小生成树
}



 3152


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


