【Hadoop】Hadoop(一)3.2.4集群搭建

hadoop集群安装指南-hadoop3.2.4版本 阅读详情

准备条件

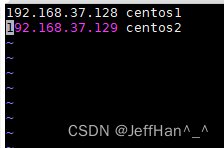
在进行Hadoop集群部署之前,我们需要事先准备好以下几个条件

修改Hadoop配置文件

在 hadoop解压目录下的 etc/hadoop下修改下面配置

core-site.xml

<!-- 设置默认使用的文件系统 Hadoop支持file、HDFS、GFS、ali|Amazon云等文件系统 -->
<property>
    <name>fs.defaultFS</name>
    <value>hdfs://centos1:8020</value>
</property>

<!-- 设置Hadoop本地保存数据路径 注意这个目录不存在会导致启动不起来-->
<property>
    <name>hadoop.tmp.dir</name>
    <value>/usr/local/hadoop/data</value>
</property>

<!-- 设置HDFS web UI用户身份 -->
<property>
    <name>hadoop.http.staticuser.user</name>
    <value>root</value>
</property>

<!-- 整合hive 用户代理设置 -->
<property>
    <name>hadoop.proxyuser.root.hosts</name>
    <value>*</value>
</property>

<property>
    <name>hadoop.proxyuser.root.groups</name>
    <value>*</value>
</property>

<!-- 文件系统垃圾桶保存时间 -->
<property>
    <name>fs.trash.interval</name>
    <value>1440</value>
</property>

hdfs-site.xml

<!-- 设置SecondNameNode进程运行机器位置信息 -->
<property>
    <name>dfs.namenode.secondary.http-address</name>
    <value>centos2:9868</value>
</property>

mapred-site.xml

<!-- 设置MR程序默认运行模式: yarn集群模式 local本地模式 -->
<property>
  <name>mapreduce.framework.name</name>
  <value>yarn</value>
</property>

<!-- MR程序历史服务地址 -->
<property>
  <name>mapreduce.jobhistory.address</name>
  <value>centos1:10020</value>
</property>
 
<!-- MR程序历史服务器web端地址 -->
<property>
  <name>mapreduce.jobhistory.webapp.address</name>
  <value>centos1:19888</value>
</property>

<property>
  <name>yarn.app.mapreduce.am.env</name>
  <value>HADOOP_MAPRED_HOME=${HADOOP_HOME}</value>
</property>

<property>
  <name>mapreduce.map.env</name>
  <value>HADOOP_MAPRED_HOME=${HADOOP_HOME}</value>
</property>

<property>
  <name>mapreduce.reduce.env</name>
  <value>HADOOP_MAPRED_HOME=${HADOOP_HOME}</value>
</property>

yarn-site.xml

<!-- 设置YARN集群主角色运行机器位置 -->
<property>
    <name>yarn.resourcemanager.hostname</name>
    <value>centos1</value>
</property>

<property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
</property>

<!-- 是否将对容器实施物理内存限制 -->
<property>
    <name>yarn.nodemanager.pmem-check-enabled</name>
    <value>false</value>
</property>

<!-- 是否将对容器实施虚拟内存限制。 -->
<property>
    <name>yarn.nodemanager.vmem-check-enabled</name>
    <value>false</value>
</property>

<!-- 开启日志聚集 -->
<property>
  <name>yarn.log-aggregation-enable</name>
  <value>true</value>
</property>

<!-- 设置yarn历史服务器地址 -->
<property>
    <name>yarn.log.server.url</name>
    <value>http://centos1:19888/jobhistory/logs</value>
</property>

<!-- 历史日志保存的时间 7天 -->
<property>
  <name>yarn.log-aggregation.retain-seconds</name>
  <value>604800</value>
</property>

修改workers

centos1
centos2

将修改好的文件发送到其他机器上

scp -r /usr/local/hadoop centos2:/usr/local

启动

格式化文件系统

hdfs namenode -format

在centos1上启动集群

cd /usr/local/hadoop

./sbin/start-dfs.sh

启动yarn

./sbin/start-yarn.sh

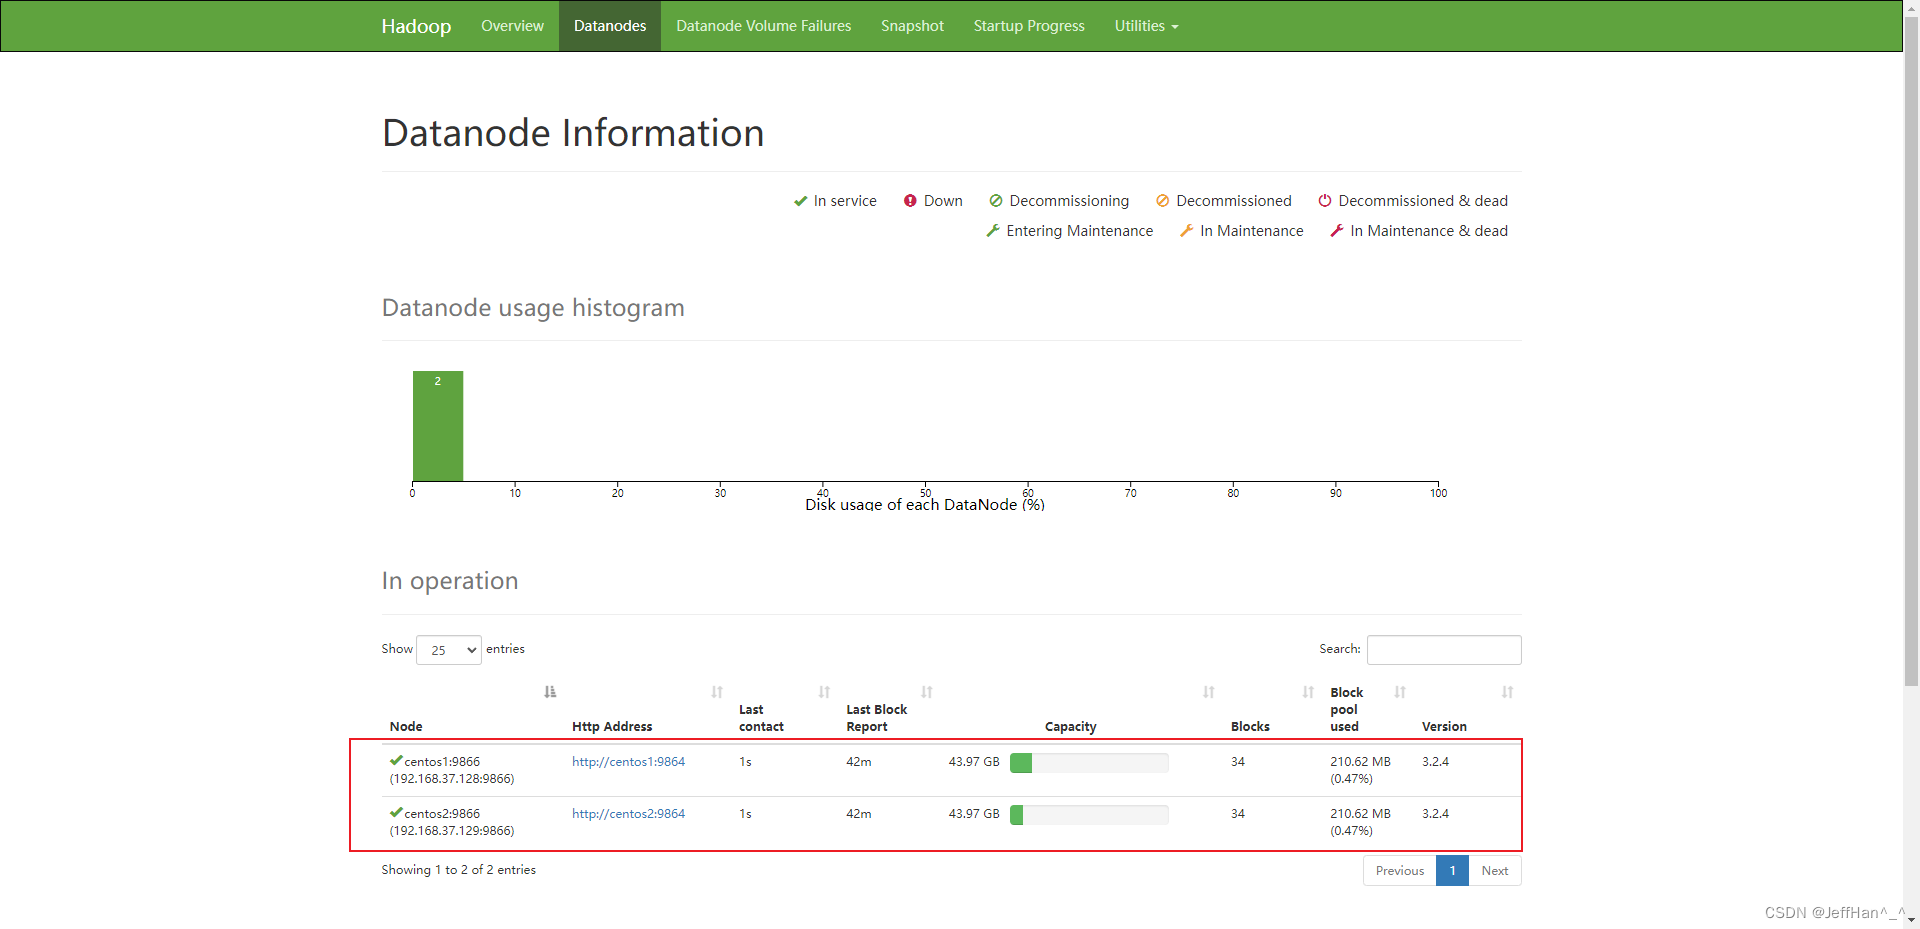
访问 http://192.168.37.128:9870
在这里插入图片描述
可以看到两台dataNode节点都在线

访问http://192.168.37.128:8088
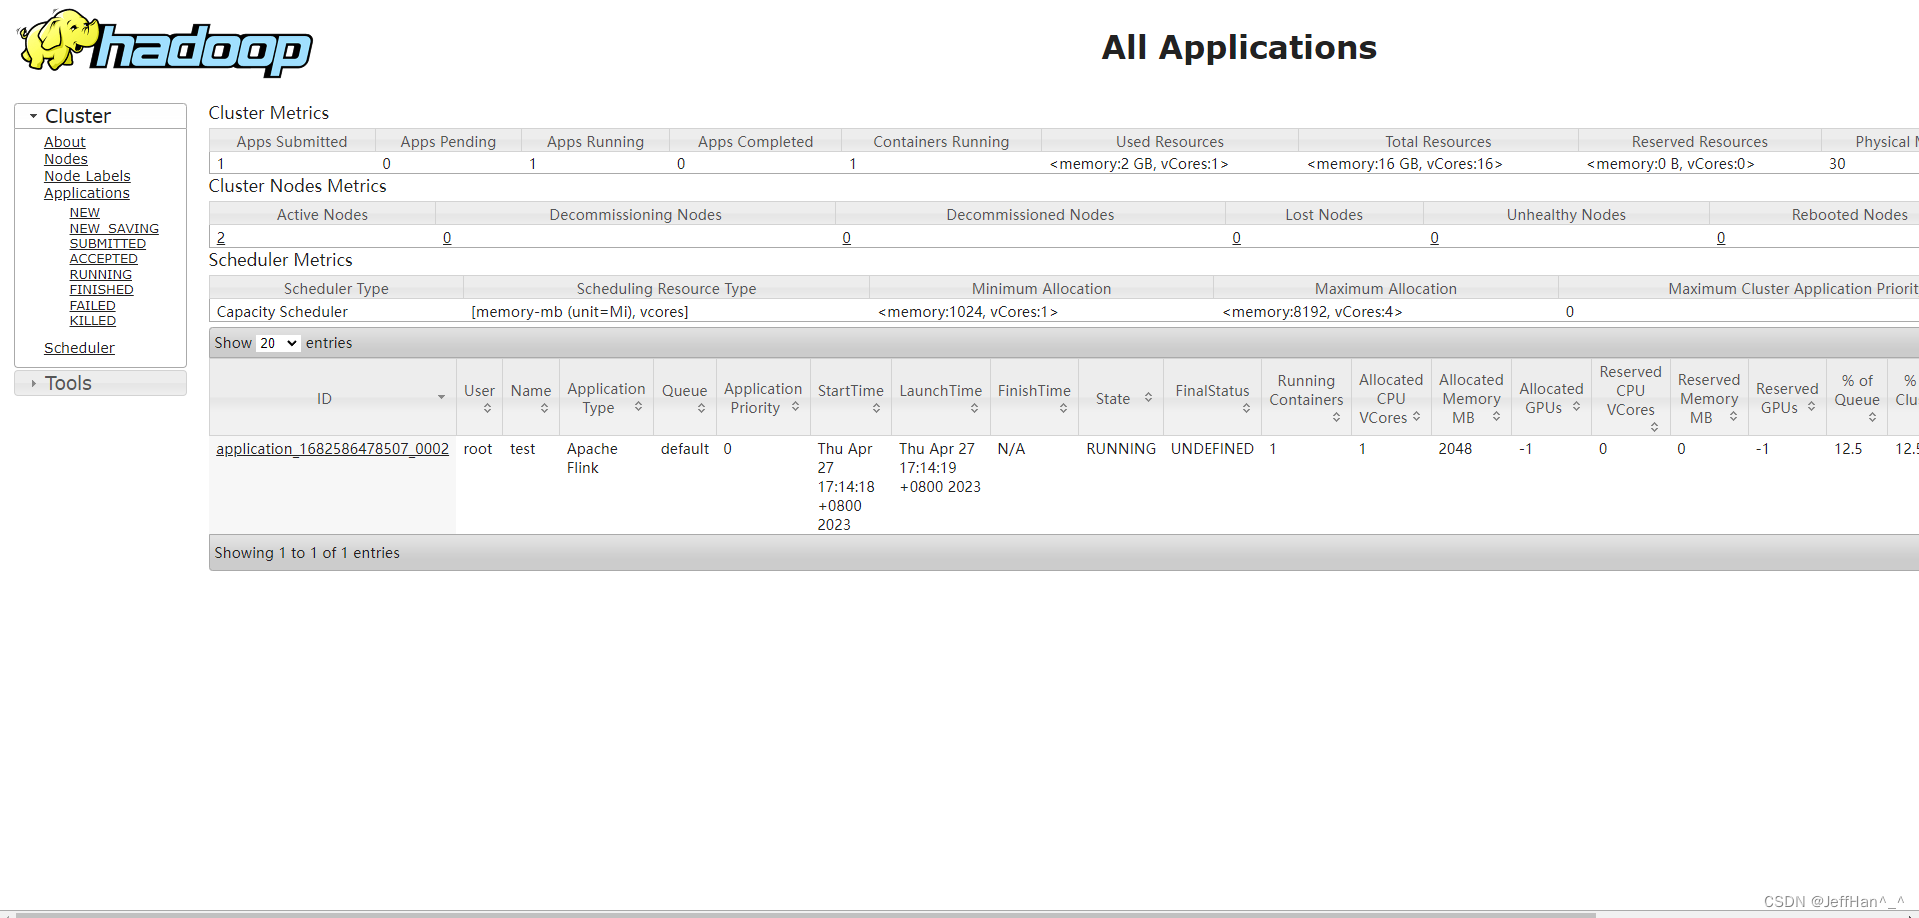
可以看到resourcemanager的管理界面也已经启动,我这里启动了一个Flink的yarn任务,所以可以看到一个Application

问题汇总

1.root用户登录无法启动问题
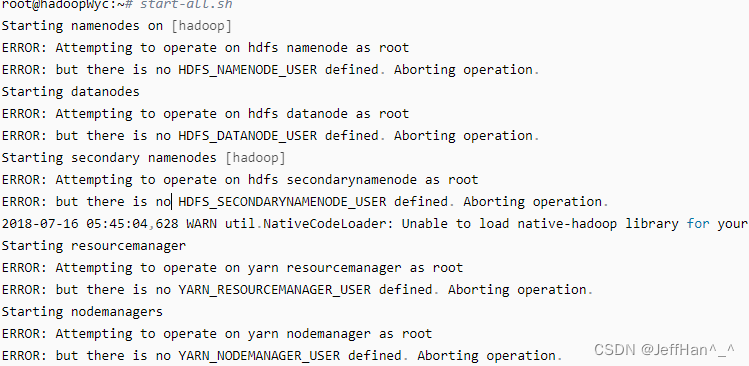
在这里插入图片描述

vi /etc/profile

添加以下配置

export HDFS_NAMENODE_USER=root
export HDFS_DATANODE_USER=root
export HDFS_SECONDARYNAMENODE_USER=root
export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root
source /etc/profile
2.启动时显示Permission denied (publickey,gssapi-keyex,gssapi-with-mic)
  1. 确保所有的虚拟机能够免密登录
  2. 由于我们在配置当中配置的是NameNode也作为DataNode,所以导致自己可能也会需要连自己,由此,我们也要将本机的公钥文件放入authorized_keys中
cd /root/.ssh

cat id_rsa.pub >> authorized_keys

Hadoop3.2.4+Hive3.1.2+sqoop1.4.7安装部署 Hive:Hadoop3.2.4+Hive3.1.2+sqoop1.4.7安装部署 阅读详情

相关推荐

hadoop3.2+zookeeper集群搭建

hadoop3.2集群搭建 版本选择 JDK:jdk1.8.0_141 zookeeper:apache-zookeeper-3.5.9 hadoop:hadoop-3.2.3 我这里是本机虚拟机搭建,使用三个节点,分别是node01、node02、node03

liu137612432的博客 2832

Hadoop 3.2.4 集群搭建详细图文教程

Hadoop 集群包括两个集群:HDFS 集群、YARN 集群。两个集群逻辑上分离、通常物理上在一起;两个集群都是标准的主从架构集群。逻辑上分离两个集群互相之间没有依赖、互不影响物理上在一起某些角色进程往往部署在同一台物理服务器上MapReduce 集群呢?MapReduce 是计算框架、代码层面的组件,没有集群之说。

誓言 2682

大数据导论实验一:搭建Hadoop集群

搭建Hadoop集群,要求至少是3个节点的真分布式集群系统,包含1个NameNode,两个DataNode。

weixin_47060391的博客 2753

分布式安装配置Hadoop3.2.4

本文介绍如何在Ubuntu系统中安装配置Hadoop。Hadoop是一个开源的分布式计算框架,它可以处理大规模的数据集。Hadoop的核心组件是Hadoop分布式文件系统(HDFS)和MapReduce编程模型。Hadoop还包括一些其他的子项目,如Hive,Pig,Spark等,提供了不同层次的数据处理能力。

Where runes of code shape the picture :) 1671

Hadoop2.4.1集群搭建

本文搭建Hadoop2.4.1分布式系统,包括NameNode ,ResourceManger HA,忽略了Web Application Proxy 和Job HistoryServer。  一概述(一)HDFS 1)基础架构 (1)NameNode(Master) 命名空间管理:命名空间支持对HDFS中的目录、文件和块做类似文件系统的创建、修改、删除、列

站在网络的肩膀上,自学成才 3562

hadoop生态圈(一):hadoop集群的搭建

目录 1 hadoop概述 1.1 hadoop是什么 1.2 hadoop的组成 1.2.1 hdfs架构概述 1.2.2 YARN概述 1.2.3 MapReduce架构概述 1.3大数据生态体系 1.4 推荐系统架构图 2 Hadoop集群搭建 2.1 虚拟机环境准备 2.2 安装jdk和hadoop 2.3 集群配置 3 集群启动 3.1 集群单点启动 3...

jiezou12138的博客 2076

hadoop3.2.2集群搭建

说明:本文以HDFS High Availability Using the Quorum Journal Manager模式搭建hadoop3.2.0集群。 环境 CentOS7、jdk1.8.0_181、zookeeper3.4.13、hadoop3.2.0 虚拟机安装CentOS7三台,如下: hostname IP storm 192.168.56.200 st...

LW_ICE 6945

hadoop-3.2.4.tar.gz

hadoop-3.2.4.tar.gz

hadoop3.x集群搭建

hadoop3.x集群搭建(亲测有效~) 之前集群搭建过hadoop2.6和2.7,但是听说hadoop3.x有新特性,减少了IO的次数,据介绍并行计算能力是spark的10倍。所以,笔者开始尝试搭建,找网上找了好多资料,结合自己的经验,终于搭建成功,花了从虚拟机安装到搭建hadoop框架花了两天时间,着实不容易哈哈。接下来,将一一介绍精简的配置搭建hadoop。 准备步骤 你需要准备3或者3...

qq_25542879的博客 6552

hadoop-3.2.4安装包,hadoop-3.2.4安装包

hadoop-3.2.4安装包,hadoop-3.2.4安装包

不会ps,你也可以成为ps高手,最强傻瓜式人像一键磨皮美白瘦脸美妆PS插件

比如:美肤是用来去斑点的,如果效果不太理想,就加大百分比,反之就减小。瘦脸如果脸胖的就打开,正常的就关闭。所谓的一键调节,要不只能调节一种效果,要不就是个预设,然后让你自己再调。同时,该软件还加入了贴心的批量处理功能,能同时处理上千张照片,让您喝着茶也能将工作做完。、自动检测照片中的人脸,包括鼻子,嘴巴,耳朵,眼睛和眉毛。、依托强大的脸部识别功能,可以高效的对人物全身皮肤进行智能识别,处理,使肤质平滑、过渡均匀。,这是网上下载的模糊照片,经过简单处理,你可以发现,眼睛变的更亮,皮肤更白,眼袋消失。

心语家园 - www.xinyucn.cc 2897

【Hadoop学习】一、Hadoop3.1.4完全分布式集群搭建

主机名:master.1与之前步骤相同,不同的是:1、虚拟机的内存是4g2、最大磁盘大小:40GB3、"/"的挂载点的容量为30g。

2401_89271417的博客 1626

世界模型和大语言模型结合开发自动驾驶算法

摘要:自动驾驶系统开发中,融合世界模型和大语言模型可显著提升效率和安全性。世界模型负责环境感知与预测(如目标检测、轨迹预测),而大语言模型优化代码生成、决策解释等环节。实施路径包括需求分析(1-2周)、模型开发(2-4个月)、模拟测试(1-2个月)、实车测试(2-3个月)和合规优化(1-2个月),总周期6-12个月。关键技术工具包括PyTorch/TensorFlow、CARLA模拟器和ROS系统,核心设计理念强调模块化、安全优先和敏捷迭代。示例代码展示了YOLO目标检测与大语言模型决策建议的集成方案。该方

ponygame的博客 826

CentOS7搭建Hadoop集群(V3.3.4)

hadoop集群搭建

Button的博客 3070

【项目分享】RailTracker: 火车票务数据采集与分析

从12306使用爬虫爬取火车站及车次信息、火车票价 通过本项目,我们将带领访问者手把手完成火车票数据采集、数据清洗、数据集成、可视化的一整个流程!

zhushatong的博客 3343

一种基于OpenPose和DNN的跌倒检测软件系统(中文&英文)

学习并实现一种跌倒检测模型,此模型基于OpenPose实现逐帧人体姿态检测,使用DNN识别人体动作。检测方式有在线与离线两种,本文主要测试了离线模式,测试效果较好。

Tongzhou_Li的博客 2643

hadoop 3.2 集群搭建

hadoop 集群 3.2 搭建过程其实很简单。 hadoop 官网地址:https://hadoop.apache.org/releases.html 选择自己想要的版本,我第一次搭建用的是2.7.5,虽然也搭建出来了,但是在web管理页面没有看到文件管理的相关按钮: 自我感觉不完美,后来看同事的集群,页面访问是有相关按钮的: 所以仔细对比了下配置文件,并未发现有什么异同,唯一不同...

qq_39314099的博客 2235

ZYNQ烧写程序到flash

1.打开SDK创建FBSl项目 点击finish 2.创建BootImage 导入fsbl.elf、.bin、.elf三个文件,Create Image 生成BOOT.bin文件 3.将BOOT文件烧录到FLASH image File选择2中生成的BOOT.bin文件,FSBL File选择fsbl.elf文件,连接好ZYNQ的Jtag,点击Program,即可烧录。 4.烧录程序到FLASH失败 如果是第一次烧录,需更改创建的fsbl工程下的main函数,在如下代码处加入BootModeRegi

qq_40603614的博客 8300

Hadoop3.0集群环境搭建

1 前言 项目中大部分数据存储在Hadoop分布式文件系统(HDFS)中,包括MPI并行用到的原始数据,因此我搭建了Hadoop集群进行测试。距离我搭建Hadoop集群也有几个月了,当时只记录下了主要步骤,有些细节可能被遗忘。不过我会用最通俗的语言还原搭建Hadoop3.0集群的流程,尽可能保证所有读者在看了我的文章后可以成功搭建出Hadoop集群。 2 准备工作 集群中两个节点(m...

secyb的博客 5510

IT:银行类金融科技岗笔试习题集合—四个模块包括【综合知识+EPI+英语+个性测评】持续更新,建议收藏

IT:银行类金融科技岗笔试习题集合—四个模块包括【综合知识+EPI+英语+个性测评】 导读:行测、综合知识、英语和性格测试。综合知识,包括货币学、金融、会计、计算机等内容。  行政能力测试,内容大家可以参考公务员考试,包括逻辑推理、数字推理、图形推理、文字推理。英语测试,包括语法和词汇30题、完型填空20题、10篇阅读理解50题,阅读理解文章特别长,生词特别多。 (1)、英语可以Ctrl+F...

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 2万+

2025.06.06【Ribo-seq】|riboWaltz:P-site定位与三碱基周期性分析流程

同学们,大家好!今天我们要学习的是riboWaltz——一款专为Ribo-seq(核糖体足迹测序)数据设计的R包,主要用于P-site定位优化和三碱基周期性分析。P-site的准确定位是Ribo-seq下游所有翻译组学分析的基础,riboWaltz为我们提供了系统、可视化、易用的解决方案。P-site定位优化:自动识别不同长度RPF的最佳P-site偏移量。三碱基周期性分析:可视化RPF在CDS、UTR等区域的分布,评估数据质量。多样本/多条件支持:可同时处理多个样本,便于批量分析和对比。

1789

Hadoop3 - 集群搭建

集群启动有两种方式,一种是在每台主机中启动相应的组件,另一种 hadoop 为我们提供了一键启停脚本,前提是配置好机器之间的SSH免密登录和workers文件。访问地址:http://resourcemanager_host:8088。访问地址:http://namenode_host:9870。集群,两者逻辑上分离,但物理上常在一起。进行了简单的介绍,并搭建了单机版的。,本篇文章继续搭建集群版本的。三台主机需具备 Java 环境。下面准备在三台服务器上安装。

小毕超博客 2452

Flink 运维监控与指标采集实战(Prometheus + Grafana 全流程)

Flink运维监控在实时计算场景中至关重要,因为Flink作业需要7×24小时稳定运行,对性能、资源、故障感知和状态变化的实时监控是保障系统稳定的关键。Flink自带的Metrics系统提供了基本的监控能力,但为了更全面的监控,Prometheus+Grafana成为最主流的解决方案。通过配置PrometheusReporter和Grafana仪表盘,可以实现对Flink作业的全面监控,包括CPU、内存、吞吐量、Checkpoint状态、KafkaSink性能等关键指标。此外,自定义指标采集和报警机制的配置

晴天彩虹雨的博客 1368

Hadoop3集群实战:从零开始的搭建之旅

本文主要讲述Hadoop的基础概念,以及Hadoop完全分布式集群的搭建过程。

孟林洁的博客 2492

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

hadoop3.2.4 集群环境搭建

实际运用中,hadoop的搭建一定是集群部署方式,所以这里搭建了下集群部署方式,也熟悉hadoop的集群搭建。这里我就没有新建用户来运行hadoop程序,严格来说不能直接用root运行hadoop程序,这里我就懒得弄了,就直接用root运行,用root运行方法前一篇文章有说,可以看看前面的文章。

qq_34526237的博客 1579

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

上一篇: 【Flink】Flink(一)单节点启动以及集群环境启动
下一篇: 【Flink】(二)Flink on Yarn模式启动Flink集群
JeffHan^_^
博客等级 码龄7年 1万+粉丝 134原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

JeffHan^_^

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值