


转发:https://www.cnblogs.com/yangecnu/p/Introduce-Hashtable.html
在前面的系列文章中,依次介绍了基于无序列表的顺序查找,基于有序数组的二分查找,平衡查找树,以及红黑树,下图是他们在平均以及最差情况下的时间复杂度:
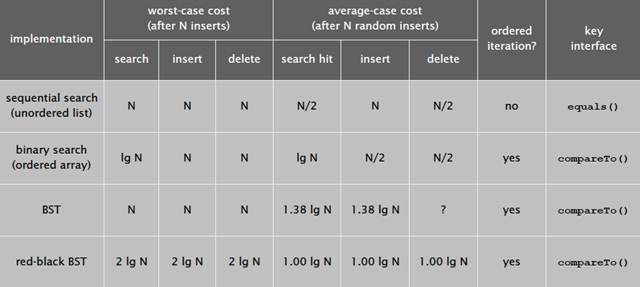
可以看到在时间复杂度上,红黑树在平均情况下插入,查找以及删除上都达到了lgN的时间复杂度。
那么有没有查找效率更高的数据结构呢,答案就是本文接下来要介绍了散列表,也叫哈希表(Hash Table)
什么是哈希表
哈希表就是一种以 键-值(key-indexed) 存储数据的结构,我们只要输入待查找的值即key,即可查找到其对应的值。
哈希的思路很简单,如果所有的键都是整数,那么就可以使用一个简单的无序数组来实现:将键作为索引,值即为其对应的值,这样就可以快速访问任意键的值。这是对于简单的键的情况,我们将其扩展到可以处理更加复杂的类型的键。
使用哈希查找有两个步骤:
- 使用哈希函数将被查找的键转换为数组的索引。在理想的情况下,不同的键会被转换为不同的索引值,但是在有些情况下我们需要处理多个键被哈希到同一个索引值的情况。所以哈希查找的第二个步骤就是处理冲突
- 处理哈希碰撞冲突。有很多处理哈希碰撞冲突的方法,本文后面会介绍拉链法和线性探测法。
哈希表是一个在时间和空间上做出权衡的经典例子。如果没有内存限制,那么可以直接将键作为数组的索引。那么所有的查找时间复杂度为O(1);如果没有时间限制,那么我们可以使用无序数组并进行顺序查找,这样只需要很少的内存。哈希表使用了适度的时间和空间来在这两个极端之间找到了平衡。只需要调整哈希函数算法即可在时间和空间上做出取舍。
哈希函数
哈希查找第一步就是使用哈希函数将键映射成索引。这种映射函数就是哈希函数。如果我们有一个保存0-M数组,那么我们就需要一个能够将任意键转换为该数组范围内的索引(0~M-1)的哈希函数。哈希函数需要易于计算并且能够均匀分布所有键。比如举个简单的例子,使用手机号码后三位就比前三位作为key更好,因为前三位手机号码的重复率很高。再比如使用身份证号码出生年月位数要比使用前几位数要更好。
在实际中,我们的键并不都是数字,有可能是字符串,还有可能是几个值的组合等,所以我们需要实现自己的哈希函数。
1. 正整数
获取正整数哈希值最常用的方法是使用除留余数法。即对于大小为素数M的数组,对于任意正整数k,计算k除以M的余数。M一般取素数。
2. 字符串
将字符串作为键的时候,我们也可以将他作为一个大的整数,采用保留除余法。我们可以将组成字符串的每一个字符取值然后进行哈希,比如
除余留数法:通过取k除以m的余数,将关键字k映射到m个槽中的某一个字上,散列函数为:h(k)=k mod m
比如:如果散列表的大小为12,所给关键字为100,则h(k)=4
即元素100--存到-->4号槽上。
public int GetHashCode(string str)
{
    char[] s = str.ToCharArray();
    int hash = 0;
    for (int i = 0; i < s.Length; i++)
    {
        hash = s[i] + (31 * hash);
    }
    return hash;
}
上面的哈希值是Horner计算字符串哈希值的方法,公式为:
h = s[0] · 31L–1 + … + s[L – 3] · 312 + s[L – 2] · 311 + s[L – 1] · 310
举个例子,比如要获取”call”的哈希值,字符串c对应的unicode为99,a对应的unicode为97,L对应的unicode为108,所以字符串”call”的哈希值为 3045982 = 99·313 + 97·312 + 108·311 + 108·310 = 108 + 31· (108 + 31 · (97 + 31 · (99)))
如果对每个字符去哈希值可能会比较耗时,所以可以通过间隔取N个字符来获取哈西值来节省时间,比如,可以 获取每8-9个字符来获取哈希值:
public int GetHashCode(string str)
{
    char[] s = str.ToCharArray();
    int hash = 0;
    int skip = Math.Max(1, s.Length / 8);
    for (int i = 0; i < s.Length; i+=skip)
    {
        hash = s[i] + (31 * hash);
    }
    return hash;
}
但是,对于某些情况,不同的字符串会产生相同的哈希值,这就是前面说到的哈希冲突(Hash Collisions),比如下面的四个字符串:

如果我们按照每8个字符取哈希的话,就会得到一样的哈希值。所以下面来讲解如何解决哈希碰撞:
避免哈希冲突
拉链法 (Separate chaining with linked lists)
通过哈希函数,我们可以将键转换为数组的索引(0-M-1),但是对于两个或者多个键具有相同索引值的情况,我们需要有一种方法来处理这种冲突。
一种比较直接的办法就是,将大小为M 的数组的每一个元素指向一个条链表,链表中的每一个节点都存储散列值为该索引的键值对,这就是拉链法。下图很清楚的描述了什么是拉链法。

图中,”John Smith”和”Sandra Dee” 通过哈希函数都指向了152 这个索引,该索引又指向了一个链表, 在链表中依次存储了这两个字符串。
该方法的基本思想就是选择足够大的M,使得所有的链表都尽可能的短小,以保证查找的效率。对采用拉链法的哈希实现的查找分为两步,首先是根据散列值找到等一应的链表,然后沿着链表顺序找到相应的键。 我们现在使用我们之前介绍符号表中的使用无序链表实现的查找表SequentSearchSymbolTable 来实现我们这里的哈希表。当然,您也可以使用.NET里面内置的LinkList。
首先我们需要定义一个链表的总数,在内部我们定义一个SequentSearchSymbolTable的数组。然后每一个映射到索引的地方保存一个这样的数组。
public class SeperateChainingHashSet<TKey, TValue> : SymbolTables<TKey, TValue> where TKey : IComparable<TKey>, IEquatable<TKey>
{
    private int M;//散列表大小
    private SequentSearchSymbolTable<TKey, TValue>[] st;//

    public SeperateChainingHashSet()
        : this(997)
    {

    }

    public SeperateChainingHashSet(int m)
    {
        this.M = m;
        st = new SequentSearchSymbolTable<TKey, TValue>[m];
        for (int i = 0; i < m; i++)
        {
            st[i] = new SequentSearchSymbolTable<TKey, TValue>();
        }
    }

    private int hash(TKey key)
    {
        return (key.GetHashCode() & 0x7fffffff) % M;
    }

    public override TValue Get(TKey key)
    {
        return st[hash(key)].Get(key);
    }

    public override void Put(TKey key, TValue value)
    {
        st[hash(key)].Put(key, value);
    }

}
可以看到,该实现中使用
- Get方法来获取指定key的Value值,我们首先通过hash方法来找到key对应的索引值,即找到SequentSearchSymbolTable数组中存储该元素的查找表,然后调用查找表的Get方法,根据key找到对应的Value。
- Put方法用来存储键值对,首先通过hash方法找到改key对应的哈希值,然后找到SequentSearchSymbolTable数组中存储该元素的查找表,然后调用查找表的Put方法,将键值对存储起来。
- hash方法来计算key的哈希值, 这里首先通过取与&操作,将符号位去除,然后采用除留余数法将key应到到0-M-1的范围,这也是我们的查找表数组索引的范围。
实现基于拉链表的散列表,目标是选择适当的数组大小M,使得既不会因为空链表而浪费内存空间,也不会因为链表太而在查找上浪费太多时间。拉链表的优点在于,这种数组大小M的选择不是关键性的,如果存入的键多于预期,那么查找的时间只会比选择更大的数组稍长,另外,我们也可以使用更高效的结构来代替链表存储。如果存入的键少于预期,索然有些浪费空间,但是查找速度就会很快。所以当内存不紧张时,我们可以选择足够大的M,可以使得查找时间变为常数,如果内存紧张时,选择尽量大的M仍能够将性能提高M倍。
线性探测法
线性探测法是开放寻址法解决哈希冲突的一种方法,基本原理为,使用大小为M的数组来保存N个键值对,其中M>N,我们需要使用数组中的空位解决碰撞冲突。如下图所示:
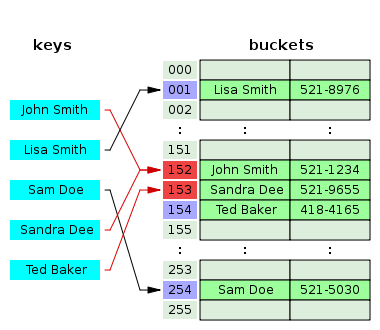
对照前面的拉链法,在该图中,”Ted Baker” 是有唯一的哈希值153的,但是由于153被”Sandra Dee”占用了。而原先”Snadra Dee”和”John Smith”的哈希值都是152的,但是在对”Sandra Dee”进行哈希的时候发现152已经被占用了,所以往下找发现153没有被占用,所以存放在153上,然后”Ted Baker”哈希到153上,发现已经被占用了,所以往下找,发现154没有被占用,所以值存到了154上。
开放寻址法中最简单的是线性探测法:当碰撞发生时即一个键的散列值被另外一个键占用时,直接检查散列表中的下一个位置即将索引值加1,这样的线性探测会出现三种结果:
- 命中,该位置的键和被查找的键相同
- 未命中,键为空
- 继续查找,该位置和键被查找的键不同。
实现线性探测法也很简单,我们只需要两个大小相同的数组分别记录key和value。
public class LinearProbingHashSet<TKey, TValue> : SymbolTables<TKey, TValue> where TKey : IComparable<TKey>, IEquatable<TKey>
{
    private int N;//符号表中键值对的总数
    private int M = 16;//线性探测表的大小
    private TKey[] keys;
    private TValue[] values;

    public LinearProbingHashSet()
    {
        keys = new TKey[M];
        values = new TValue[M];
    }

    private int hash(TKey key)
    {
        return (key.GetHashCode() & 0xFFFFFFF) % M;
    }

    public override TValue Get(TKey key)
    {
        for (int i = hash(key); keys[i] != null; i = (i + 1) % M)
        {
            if (key.Equals(keys[i])) { return values[i]; }
        }
        return default(TValue);
    }

    public override void Put(TKey key, TValue value)
    {
        int hashCode = hash(key);
        for (int i = hashCode; keys[i] != null; i = (i + 1) % M)
        {
            if (keys[i].Equals(key))//如果和已有的key相等,则用新值覆盖
            {
                values[i] = value;
                return;
            }
            //插入
            keys[i] = key;
            values[i] = value;
        }
    }
}
线性探查(Linear Probing)方式虽然简单,但是有一些问题,它会导致同类哈希的聚集。在存入的时候存在冲突,在查找的时候冲突依然存在。
性能分析
我们可以看到,哈希表存储和查找数据的时候分为两步,第一步为将键通过哈希函数映射为数组中的索引, 这个过程可以认为是只需要常数时间的。第二步是,如果出现哈希值冲突,如何解决,前面介绍了拉链法和线性探测法下面就这两种方法进行讨论:
对于拉链法,查找的效率在于链表的长度,一般的我们应该保证长度在M/8~M/2之间,如果链表的长度大于M/2,我们可以扩充链表长度。如果长度在0~M/8时,我们可以缩小链表。
对于线性探测法,也是如此,但是动态调整数组的大小需要对所有的值从新进行重新散列并插入新的表中。
不管是拉链法还是散列法,这种动态调整链表或者数组的大小以提高查询效率的同时,还应该考虑动态改变链表或者数组大小的成本。散列表长度加倍的插入需要进行大量的探测, 这种均摊成本在很多时候需要考虑。
哈希碰撞攻击
我们知道如果哈希函数选择不当会使得大量的键都会映射到相同的索引上,不管是采用拉链法还是开放寻址法解决冲突,在后面查找的时候都需要进行多次探测或者查找, 在很多时候会使得哈希表的查找效率退化,而不再是常数时间。下图清楚的描述了退化后的哈希表:
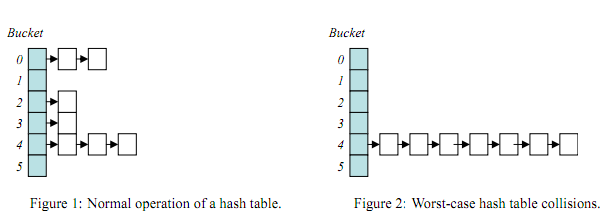
哈希表攻击就是通过精心构造哈希函数,使得所有的键经过哈希函数后都映射到同一个或者几个索引上,将哈希表退化为了一个单链表,这样哈希表的各种操作,比如插入,查找都从O(1)退化到了链表的查找操作,这样就会消耗大量的CPU资源,导致系统无法响应,从而达到拒绝服务供给(Denial of Service, Dos)的目的。之前由于多种编程语言的哈希算法的“非随机”而出现了Hash碰撞的DoS安全漏洞,在ASP.NET中也曾出现过这一问题。
在.NET中String的哈希值内部实现中,通过使用哈希值随机化来对这种问题进行了限制,通过对碰撞次数设置阈值,超过该阈值就对哈希函数进行随机化,这也是防止哈希表退化的一种做法。下面是BCL中string类型的GetHashCode方法的实现,可以看到,当碰撞超过一定次数的时候,就会开启条件编译,对哈希函数进行随机化。
[ReliabilityContract(Consistency.WillNotCorruptState, Cer.MayFail), SecuritySafeCritical, __DynamicallyInvokable]
public override unsafe int GetHashCode()
{
    if (HashHelpers.s_UseRandomizedStringHashing)
    {
        return InternalMarvin32HashString(this, this.Length, 0L);
    }
    fixed (char* str = ((char*) this))
    {
        char* chPtr = str;
        int num = 0x15051505;
        int num2 = num;
        int* numPtr = (int*) chPtr;
        int length = this.Length;
        while (length > 2)
        {
            num = (((num << 5) + num) + (num >> 0x1b)) ^ numPtr[0];
            num2 = (((num2 << 5) + num2) + (num2 >> 0x1b)) ^ numPtr[1];
            numPtr += 2;
            length -= 4;
        }
        if (length > 0)
        {
            num = (((num << 5) + num) + (num >> 0x1b)) ^ numPtr[0];
        }
        return (num + (num2 * 0x5d588b65));
    }
}
.NET中哈希的实现
我们可以通过在线源码查看.NET 中Dictionary,类型的实现,我们知道任何作为key的值添加到Dictionary中时,首先会获取key的hashcode,然后将其映射到不同的bucket中去:
public Dictionary(int capacity, IEqualityComparer<TKey> comparer) {
    if (capacity < 0) ThrowHelper.ThrowArgumentOutOfRangeException(ExceptionArgument.capacity);
    if (capacity > 0) Initialize(capacity);
    this.comparer = comparer ?? EqualityComparer<TKey>.Default;
}
在Dictionary初始化的时候,会如果传入了大小,会初始化bucket 就是调用Initialize方法:
private void Initialize(int capacity) {
    int size = HashHelpers.GetPrime(capacity);
    buckets = new int[size];
    for (int i = 0; i < buckets.Length; i++) buckets[i] = -1;
    entries = new Entry[size];
    freeList = -1;
}
我们可以看看Dictonary的Add方法,Add方法在内部调用了Insert方法:
private void Insert(TKey key, TValue value, bool add)
{
        if( key == null ) {
            ThrowHelper.ThrowArgumentNullException(ExceptionArgument.key);
        }

        if (buckets == null) Initialize(0);
        int hashCode = comparer.GetHashCode(key) & 0x7FFFFFFF;
        int targetBucket = hashCode % buckets.Length;

#if FEATURE_RANDOMIZED_STRING_HASHING
        int collisionCount = 0;
#endif

        for (int i = buckets[targetBucket]; i >= 0; i = entries[i].next) {
            if (entries[i].hashCode == hashCode && comparer.Equals(entries[i].key, key)) {
                if (add) {
                    ThrowHelper.ThrowArgumentException(ExceptionResource.Argument_AddingDuplicate);
                }
                entries[i].value = value;
                version++;
                return;
            }

#if FEATURE_RANDOMIZED_STRING_HASHING
            collisionCount++;
#endif
        }
        int index;
        if (freeCount > 0) {
            index = freeList;
            freeList = entries[index].next;
            freeCount--;
        }
        else {
            if (count == entries.Length)
            {
                Resize();
                targetBucket = hashCode % buckets.Length;
            }
            index = count;
            count++;
        }

        entries[index].hashCode = hashCode;
        entries[index].next = buckets[targetBucket];
        entries[index].key = key;
        entries[index].value = value;
        buckets[targetBucket] = index;
        version++;

#if FEATURE_RANDOMIZED_STRING_HASHING
        if(collisionCount > HashHelpers.HashCollisionThreshold && HashHelpers.IsWellKnownEqualityComparer(comparer))
        {
            comparer = (IEqualityComparer<TKey>) HashHelpers.GetRandomizedEqualityComparer(comparer);
            Resize(entries.Length, true);
        }
#endif

    }
首先,根据key获取其hashcode,然后将hashcode除以backet的大小取余映射到目标backet中,然后遍历该bucket存储的链表,如果找到和key相同的值,如果不允许后添加的键与存在的键相同替换值(add),则抛出异常,如果允许,则替换之前的值,然后返回。
如果没有找到,则将新添加的值放到新的bucket中,当空余空间不足的时候,会进行扩容操作(Resize),然后重新hash到目标bucket。这里面需要注意的是Resize操作比较消耗资源。
总结
前面几篇文章先后介绍了基于无序列表的顺序查找,基于有序数组的二分查找,平衡查找树,以及红黑树,本篇文章最后介绍了查找算法中的最后一类即符号表又称哈希表,并介绍了哈希函数以及处理哈希冲突的两种方法:拉链法和线性探测法。各种查找算法的最坏和平均条件下各种操作的时间复杂度如下图:
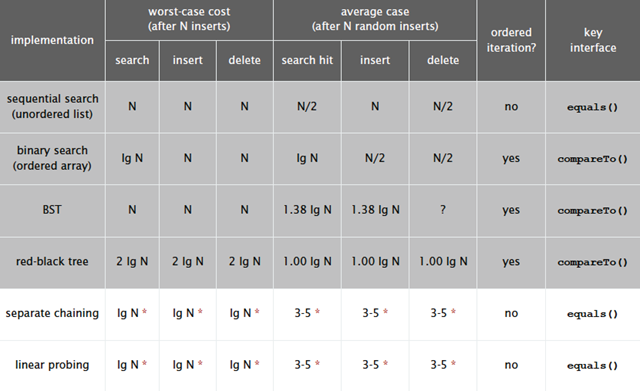
在实际编写代码中,如何选择合适的数据结构需要根据具体的数据规模,查找效率要求,时间和空间局限来做出合适的选择。希望本文以及前面的几篇文章对您有所帮助。

 3568


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


