


随着大语言模型的阶段性爆发以及图片生成的扩散模型惊艳表现,裹挟而来了一阵巨大的,史无前例的AIGC狂风骤雨,并随之而来的产业变革,职业焦虑,专业普及等等一系列的“灾难性”变化,处在风暴外的人很难独善其身,处在风暴中心的设计师们又该如何应对呢?
这篇SD防灾指南将尝试从图片生成模型stable diffusion和ta的生态切入,系统的指引我们从零到一的了解AIGC,熟悉ta,并驾驭ta,成为一个优秀的“災害對策精英”。
怎么开始??
防災指南会根据一个图片生产者从“小白”到成为“對策精英”的学习周期来分步讲述如何生图,并针对不同角色不同阶段单独有针对性更细致的文章攻略。所以指南更像是一个目录,wiki,和指南本身。但文章仍然有些长有点干,需要点耐心。
开始之前
所有文章都会尽量避免晦涩难懂,但因为行业起源,以及更有利于彼此交流和深入学习,大家还是需要对一些基本知识有一点了解,包括后续会出现的一些专业名词,就不再一一解释。

为什么是从SD开始?
当前主流的图片AIGC就是SD和Midjourney之争了,甚至在某些维度上让我想到iOS和Android。MJ做得很好,但我仍然希望你的入门和进阶都从SD入手。
- 可控性。AI出图最大的阻力就是可控性,包括图片质量的可控和图片内容的可控。图片生成得完整,好看是MJ的强项,普通人大概只需要这个需求发发朋友圈吹牛打屁,换换头像。而真正要做到心有所想,生而所得,MJ和它的用户都在努力,但把这一部分只交给关键词来控制很难。这里有更多控制变量的SD有巨大的优势。
- 开源性,战未来。并不是说闭源不好,提供良好的使用体验,黑盒去噪,是MJ努力降低图片AIGC的门槛的产品思路,但拥有越来越成熟丰富的开源生态的SD,也意味着会有越来越多的神级插件,越来越厉害的技术融合,进一步提高美术生产效率和精度。
- 灵活私密性,SD可以像MJ一样云端部署,随时随地可以访问。也可以本地部署,调用本地的算力,灵活的调整配置所需的生产环境。隐私性也是很多像游戏、影视等商业项目只考虑SD本地部署的重要原因。
- MJ很贵。呸,MJ很简单没挑战。呸,SD的知识体系很碎片,更需要一个开始。
有个不恰当的比如:MJ是自动挡的车,而SD就像手动挡的车。掌握后者大概率能轻松驾驭前者。也更容易二者兼修打组合拳。
准备工作
在决定使用SD来解决我们所需的生图需求后,也初步了解了AI和扩散模型的工作原理后我们需要开始准备第一部分了。
这里有三个比较重要的部分需要提前准备,并且这三部分决定了后面我们在生图能达到的质量高度和效率高度,他们分别是算力,工具和模型。
硬件

算力这个词听起来就很厌烦的,又是什么互联网黑话生造出来的破烂词,当然它和AI本就密不可分,我们的生产又本身离不开计算机,索性将这部分叫硬件部分。
也就是你需要准备一台电脑,这台电脑最好有一个独立的英伟达的显卡,显存最好是12G以上的。操作系统最好是windows的。
工具
准备好了硬件就要准备软件工具,与很多只能在云服务上使用的工具不同,SD借助开源工具,可以云端部署,也可以本地部署,使用上面提到的本地硬件来运行,这样更“私有”,也更灵活可控。
当然,你可能也需要忍受他们糟糕的用户体验和凌乱的界面。大概长这样。


目前主流的开源工具主要有2个。
-
Web UI Stable Diffusion WebUi 一个基于 Gradio 库的开源工具,由个人大神automatic1111开发,并在全球开发者贡献下,成为一个强大的最主流的生产工具。(上图1)
-
ComfyUI 流程图/模块化设计的 Stable Diffusion GUI,采用连线式交互,更接近现有游戏、影视的生产流程和交互方式,门槛更高,天花板也更高。(上图2)
我们主要使用WebUI这个工具,因为前者的生态更加完善,学习门槛相对更低。(后者因为解决了一些当前工作流的硬伤,可能在未来某个时间点爆发式的增长)。
模型

模型是aigc的灵魂,所有的生态都是围绕模型展开的,模型在某些维度上决定了出图的风格,内容和质量。
Tips:因为先有的是扩散模型,再有的现在大热的图像生产,再才诞生了WebUI这些围绕模型服务的工具,模式等(过去的模型并没达到这个高度,限定不追溯AI发展史防杠)
模型的获取主要源自:自己训练,和下载。
因为SD的开源性,我们可以自己通过训练集finetune(微调)或者Mix(融合)SD的大模型来得到一个特定风格化的模型,然后分享出来提供他人下载使用。从而得到越来越多丰富多彩的模型去解决我们的生产需求。


准备完毕,尝试生第一张图
你可以啥也不想,啥也不看,轻轻的用你的鼠标点击一下屏幕上那颗大大的,方方的,橘黄的生成按钮,在终端中会显示进度,右下角的区域就出现了一张图,它可能长这么个模样。

没有输入任何文字,调整任何参数,这个抽象的图好像还不赖~(你们选择的大模型如果比较写实,那这张图可能更抽象)好像是个不错的开始。
Step1. 先认参数
把大象装冰箱,得先把冰箱门打开。同样,想自己生图就需要先认识一下一张图片是由哪些参数得出的。上面我们点了生成按钮,在电脑右下角收获了一张图片,这张图片的下发有一堆参数(每一次生成都有一组参数在这个地方显示)

Steps: 20, Sampler: Euler a, CFGscale: 7, Seed: 2607380765, Size: 512x512, Modelhash: b6928134bb,Model:25D_mixProV3_v3, Clipskip: 2, ENSD: 31337, Version: v1.3.2
简单解释这些参数:
Steps:迭代次数,取值与采样方法有关。 代表迭代(渲染)步数。根据图片质量和内容复杂程度,取15-30之间,太高影响较小,也加大运算时间。回报递减,取决于采样器。
Sampler:采样方法(不同的采样方法有不同的效果和速度),Euler a就很好用,速度也很快。其他采样器也各有特点,需要我们在生产的过程中耐心去试。
CFGscale:图像与你的提示的匹配程度。增加这个值将导致图像更接近你的提示(根据模型),但它也在一定程度上降低了图像质量。可以用更多的采样步骤来抵消。默认为7,更小ai更具创造力,太高则容易过饱和和混乱,一般少调整。
Seed:保持这个值不变,可以多次生成相同(或相似)的图像。种子是决定生图结果的随机数。遇到随到不错的种子可以记住这个值下次还找你。通常-1随机。
Size:就是图片的尺寸。默认都是512x512。更大的图片也意味着需要更多的显存和更长的时间来生成。
Model:这是我们选择的模型。Modelhash:这是模型的身份证。
ENSD:对图像质量无任何提升, 只为ancestral采样方法产生不同的结果,无视。
Version:这是你的sd版本,不用关心。
Clip skip:这个参数的原理是十分复杂的,而且设置它很频繁,简单理解就是写实图设置1,二次元一些就设置2。有些制作精良的模型介绍也会给出clip skip值的影响。``

Step2. 再次认识WebUI

我把webUI的界面分成了几个区域,他们按照一定的逻辑归类。
**TAB功能模块:**每个标签在WebUI都是一个独立的功能,如文生图,图生图,训练,设置,以及很多独立的,功能强大的插件。
**关键词模块:**这里有2个面积巨大的输入框,分别是正向关键词和反向关键词。这里就是我们用文本控制出什么图的操作台了。
**设置模块:**有没有很熟悉,这里很多参数都是我们在生成一张图后,显示出来的参数,上面已经有一一介绍,这里通过uikit调整这些参数来控制最终生成的图片是什么样子的。(MJ策略性的隐藏了这部分)
**生成结果模块:**这里预留了一些空间,来实时预览我们的生图过程和展现生图结果,如果有多张图片也会罗列,有一些快捷功能可以操作图片。还有底部有图片参数详细信息和生图过程中的错误反馈。
**插件脚本模块:**最后就是插件脚本模块,在生图的前中后周期中都有不同的插件服务,这里会是主要的陈放之所。
Step3. 关键词和基础设置
我们在TAB功能模块区找到PNG图像信息(PNG info),切换过去然后将一张AI生成的PNG图片导入进去。我们也会得到这样的一组参数:


关键词shose, sleek glass thickness,transparent, holographic,smooth color background,cinematic lighting,4k, Negative prompt(low quality), (worst quality:1.4)
设置Steps: 20, Sampler: Euler a, CFG scale: 7, Seed: 3793992816, Size: 512x512, Model hash: 9aba26abdf, Model: deliberate_v2, Clip skip: 2, ENSD: 31337, Version: v1.3.2
复习一下上面的知识点。
这只鞋子的参数是:采样步数20(默认),采样器Eular a(默认),CFG7(默认),种子balabala,尺寸512(默认),Clip跳过2(默认),模型deliberate_v2。
除了模型和第一次的生成不同外,其他参数都一样的,起到生出这双科技质感的鞋子关键作用的是关键词+模型了。
关键词:
-
Prompt:对你想要生成的东西进行文字描述。正向关键词可以使用英文的自然语言描述,可以用单词,词组,颜文字,emoji…通过逗号,空格来分割。词汇的顺序,重复,权重,在模型中语义的自带权重等都会影响生图结果。
-
Negative prompt:用文字描述你不希望在图像中出现的东西。反向关键词与上面相同的格式语法,且2者互相 影响。如果填写了仍然出现可以适当的增加权重。格式为(),(()),(xxx:1.6),降权同理[],[[]].[xxx:1.4]。
这里只简单提及关键的影响和基础使用方法。
模型:
模型前面已经提及,在生图过程过,WebUI的工作都需要基于某一个大模型,所以在用户界面上,选模型是放在最靠前的位置。这也是WebUI当下面临的一个问题,随着模型越来越多成为条件因素而不是唯一基础,越来越多需要模型串并联的工作流成为主要的需求解法。
与模型相关联的还有一个参数是VAE。
VAE:是一种用于学习潜在表示的深度学习技术。它们也被用来绘制图像,在半监督学习中取得最先进的成果,以及在句子之间进行插值。对于小白用户,你可以简单理解它会影响你出图的色彩(其实是有误的,模型篇里有说)。
基础设置:
那是不是前面讲的一大堆参数就都默认不管就行了?
如果在对策入门早期,没有精力理解确实可以不用掌握,都默认即可。但不代表这部分是没用的,看我调整了采样器和采样步数后(仍然随机种子),又会得到下面这张图。
Steps: 40, Sampler: DDIM, CFGscale: 7, Seed: 1196435060, Size: 512x512, Modelhash: 9aba26abdf, Model: deliberate_v2, Clipskip: 2, ENSD: 31337, Version: v1.3.2
这些参数都会影响到我们的生图结果,受篇幅影响,具体每个参数会产生什么样的影响,这里就不做过多赘述了。
最后再补充一个经常使用的设置参数:
Batch count/Batch size:决定生成的图片数量。可以简单理解前者生几批图,后者每批生几张图。如果显存足够,则可以增加 Batch Size;否则,只能增加 Batch Count,得到的图片数量是两者之积(对于显存较小的情况,建议只修改 Batch Count)。
进阶部分
至此,恭喜你,你已经成功把大象装进了冰箱~ 至于想再装狮子老虎,就是进阶部分了。主要也就4个部分。分别是图生图(包括局部重绘),WebUI插件,小模型(LoRA、Embedding、Hypernetwork等),以及大小模型的训练finetune(俗称炼丹)。
图生图(img2img)&局部重绘(inpaint)
图生图其实本质仍然是文生图(txt2img),只是把上传的参考图转出成为了关键词信息,其他参数都与上面提到的文生图参数一致,当你把文生图熟练掌握后,图生图就显得十分简单了。
只多了1个与图片相关的设置:Denoise strength,而inpaint则是在图生图的基础上多了一组蒙版设置。
局部重绘在很多时候能在工作流程上提供很好的解决办法,将生成图片导入局部重绘中,对问题部分进行多次局部重绘,且可进行多次图生图。这里如果使用一些第三方插件如ps插件会更加自如,最新的ps官方也是使用相似的工作原理。
利用好图生图和局部重绘在复杂的工作流中将是一个很重要的技能。

插件
得益于良好的开源生态,我们能在webui上使用很多拓展工具,这些插件有的能改变工作体验,有些能实现某些革命性的解决问题的办法。受篇幅影响,我不在这里一一列举,只先管中窥豹一下它们的强大。
值得庆幸的是,很多整合包就整合了很多好用的插件(这也是懒人包的亮点之一,佬与佬的品味差距)比如:
**controlnet:**能用专门的轮廓识别、动作识别、景深识别等预处理模型让需要的对应图片牢牢的control住的神级插件!

**tagger:**可以通过图像识别,反推关键词的插件。

还有dreambooth训练插件,图片浏览插件,动画脚本等等,都是在已经很牛*的工具基础上又提高了生产上限。webui本身就提供了拓展功能,能在拓展页面自己选择需要的插件工具:

LoRA、Embedding、Hypernetwork
这部分要解释起来还很麻烦,但这些又是进阶的很重要的一部分,大概是很多人使用SD而不用MJ的最核心部分吧。
简单的说,他们就是一个个的微型模型。他们可以在一个模型上串联另一个模型的一部分特征,并且可以修改权重。
- **LoRA:**与下面二者不同,LoRA更接近完整的大模型,这个是出现最晚,但最强的概念。通过少量图片就能很好的微调大模型得到一个文件大小相对很小的模型文件。(大小几兆-两三百兆的.safetensors格式)
- **Embedding:**是Textual Inversion的结果,教 AI 用模型中的标签组成一个 人或者物品。更接近从模型中“找”。是去年还比较流行的炼丹方式,文件很小是优点(大小2kb的.pt格式)。
- **Hypernetwork:**中文叫超网,也是很成熟的一种技术,就像一层层盖棉被一样去改变模型的细节。通过调节权重来改变生成结果,适合调整风格。(大小100-300兆的.pt格式,根据层数决定)
通过将一个个的大模型与小模型的组合,就能得到很多不同的风格和创意结果。甚至我们很多人都猜测MidJourney的工作原理也是模型的串并联,能让结果的质量控制得很优秀。
炼丹
至于如何生产大小模型,想到过年那会儿我没日没夜,废寝忘食的炼丹,炸炉,炼丹…睁眼炼丹,闭眼睡觉的场景就不寒而栗…
其实当下我认为炼丹是一个投入产出比不高的行为。对硬件要求高,对训练集的版权许可又有法律和道德的约束。
Hello,New World
与很多代码学习的书籍会用写一个“hello world”的程序来开始一样,写到最后我会提供一套参数,你可以根据上面学到的知识,把他们对应安放到你的工具当中,快去看看会得到什么样的图吧。
关键词((best quality ,masterpiece, highres)),Illustration, Defined ‘real’ light source,detailed light,beautiful detailed glow, 1girl,10-year-old,solo,long sleeves,railing,brown eyes,brown hair,Blue jean jacket,White T-shirt,smile,long hair,city,Turn and look back,Look at view *关键词*(low quality, worst quality:1.4),(bad-artist:0.7),(bad hand:1.4),lowres, cropped,blurred,mutated,error,deformed
设置Steps: 30, Sampler: DDIM, CFG scale: 10, Seed: 1039378680, Size: 300x400, Model hash: 89d59c3dde, Model: final-pruned, Clip skip: 2Hires upscale: 2, Hires upscaler: Latent Denoising strength: 0.7
模型你可以换成任意模型,感受一下不同模型提供的魔法效果吧。
记得把高分辨率修复勾选上!~
关于AI绘画技术储备
学好 AI绘画 不论是就业还是做副业赚钱都不错,但要学会 AI绘画 还是要有一个学习规划。最后大家分享一份全套的 AI绘画 学习资料,给那些想学习 AI绘画 的小伙伴们一点帮助!
对于0基础小白入门:
如果你是零基础小白,想快速入门AI绘画是可以考虑的。
一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以找到适合自己的学习方案
包括:stable diffusion安装包、stable diffusion0基础入门全套PDF,视频学习教程。带你从零基础系统性的学好AI绘画!
需要的可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

1.stable diffusion安装包 (全套教程文末领取哈)
随着技术的迭代,目前 Stable Diffusion 已经能够生成非常艺术化的图片了,完全有赶超人类的架势,已经有不少工作被这类服务替代,比如制作一个 logo 图片,画一张虚拟老婆照片,画质堪比相机。
最新 Stable Diffusion 除了有win多个版本,就算说底端的显卡也能玩了哦!此外还带来了Mac版本,仅支持macOS 12.3或更高版本。
2.stable diffusion视频合集
我们在学习的时候,往往书籍代码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,一步步带你入门stable diffusion,科学有趣才能更方便的学习下去。
3.stable diffusion模型下载
stable diffusion往往一开始使用时图片等无法达到理想的生成效果,这时则需要通过使用大量训练数据,调整模型的超参数(如学习率、训练轮数、模型大小等),可以使得模型更好地适应数据集,并生成更加真实、准确、高质量的图像。
4.stable diffusion提示词
提示词是构建由文本到图像模型解释和理解的单词的过程。可以把它理解为你告诉 AI 模型要画什么而需要说的语言,整个SD学习过程中都离不开这本提示词手册。
5.AIGC视频教程合集
观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。
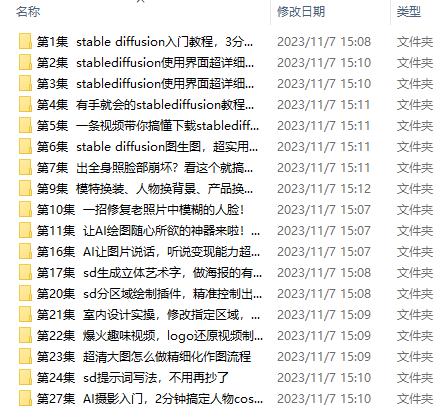
实战案例
纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
这份完整版的学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】




 3万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


