


前言
大家好!今天主要是帮大家梳理下Stable diffusion里面的各种模型,模型在Stable diffusion中占据着至关重要的地位,不仅决定了出图的风格,也决定了出图质量的好坏。

但在第一次接触SD的时候,我就被里面的模型搞到头大,不仅有多种模型后缀,模型之间也有很多种类型,如果是新手小白的话,在这一步就很容易被搞晕。而在本期文章,技术巫帮你系统梳理了SD的模型,相信不管是对于小白还是老手,都会有一定帮助!
所有的AI设计工具,安装包、模型和插件,都已经整理好了,👇获取
[优快云大礼包:《SD绘图学习资源包》免费分享

为了更好地理解模型,让我们先从模型的后缀说起。
在Stable diffusion中,有两种比较常见的模型后缀,分别是 .ckpt 和 .safetensors 。
.ckpt 的全称是 checkpoint,中文翻译就是检查点,这是 TensorFlow中用于保存模型参数的格式,通常与 .meta 文件一起使用,以便恢复训练过程。
简单理解的话,.ckpt模型就好比我们打游戏时,每通过一关时对这一关的一个“存档”,因为你在训练模型时也是如此,没办法保证能一次就训练成功,中途是有可能因为各种因素失败的,所以可能在训练到20%时就存一次档,训练到40%时又存一次档,这也是为什么它叫 checkpoint 的一个原因。
在提到.ckpt 模型时,我想顺便补充下.pt 模型,前面提到,.ckpt 是TensorFlow 用于保存模型参数的格式,而 .pt 则是 PyTorch保存模型参数的格式。TensorFlow 和 PyTorch都是比较出名的深度学习框架,只不过一个是Google发布的,另外一个是Facebook发布的。
PyTorch 保存模型的格式除了.pt 之外,还有 .pth 和.pkl。.pt 和 .pth 之间并没有本质的差别,而.pkl 只是多了一步用Python的 pickle 模块进行序列化。
讲完了 .ckpt 模型,那么就该说说 .safetensors 模型了。
之所以有 .safetensors 模型,是因为 .ckpt 为了让我们能够从之前训练的状态恢复训练,好比从50%这个点位重新开始训练,从而保存了比较多的训练信息,比如模型的权重、优化器的状态还有一些Python代码。
这种做法有两个问题,一是可能包含恶意代码,因此不建议从未知或不信任的来源下载并加载.ckpt 模型文件;二是模型的体积较大,一般真人版的单个模型的大小在7GB左右,动漫版的在2-5GB之间。
而 .safetensors 模型则是 huggingface 推出的新的模型存储格式,专门为Stable Diffusion模型设计。这种格式的文件只保存模型的权重,而不包含优化器状态或其他信息,这也就意味着它通常用于模型的最终版本,当我们只关心模型的性能,而不需要了解训练过程中的详细信息时,这种格式便是一个很好的选择。
由于 .safetensors 只保存模型的权重,没有代码,所以会更安全;另外由于保存的信息更少,所以它的体积也比 .ckpt 小,加载也更快,所以目前是比较推荐使用 .safetensors 的模型文件。
总的来说,如果你想在某个SD模型上进行微调,那还是得用 .ckpt 模型;但如果你只关心出图结果,那么使用 .safetensors 模型会更好!
二、从模型分类讲起
在Stable diffusion中,模型主要分为五大类,分别是Stable diffusion模型、VAE模型、Lora模型、Embedding模型以及Hypernetwork模型。
2.1 Stable diffusion大模型
这类模型俗称“底模”,对应下面这个位置。

这类模型代表了Stable diffusion的一个知识库,比如说我们训练大模型用的全是二次元的图片,那么它最终生成的图片效果也会趋于二次元;而如果训练的时候用的是真人图片,则最终出图效果则趋于真人。
由于这类模型包含的素材非常多,训练的时间也非常长,所以体积也比较大,一般在2GB以上,后缀的话就是上面提到的 .ckpt 和 .safetensors
2.2 VAE模型
VAE全称Variational autoenconder,中文叫变分自编码器,这种模型可以简单理解为起到一个滤镜的效果。在生成图片的过程中,主要影响的是图片的颜色效果。
一般来讲,在生成图片时,如果没有外挂VAE模型,生成的图片整体颜色会比较暗淡;而外挂了VAE模型的图片整体颜色会比较明亮。

注:左边是没有使用VAE生成的图片,右边是使用VAE生成的图片
不过需要注意的是,有一些大模型在训练的时候就已经嵌入了VAE的效果,所以即使没有使用VAE效果,出图的效果也不会那么暗淡。
另外,有时候使用VAE反倒会出现一个不好的效果,比如在最后一刻变成一张蓝色废图,这时候就需要把外挂VAE改成自动(Automatic)即可

注:像这种即为蓝色废图
2.3 Lora模型
Lora模型想必大家都经常看到了,LoRA的英文全称为Low-Rank Adaptation of Large Language Models,直译为“大语言模型的低阶适应”。这是一项由微软研究人员提出的大语言模型微调技术,简单来说,它的作用是让这些庞大的模型变得更加灵活和高效,能够在特定任务上进行优化(比如对样式进行一些修改),而不需要从头开始训练整个模型。
比如像下面这个Lora模型,就是在大模型的基础上增加一些森林水母发光的效果(就是我们不必为了增加这个效果,重新训练我们的大模型,因为训练大模型花费时间很长,通过Lora就可以提高效率)

需要注意的是,Lora模型并不能单独使用,它必须与前面的大模型一起使用!
另外,由于Lora训练的图片较少,比如上面的Lora就是用100+图片训练的,所以它的体积一般不会很大,一般在几十到几百MB之间,这样大大节省了磁盘的占用量。
最后,有些Lora模型启用是需要触发词的(也就是在提示词那里加上这个触发词),比如上面的Lora触发词就是 jellyfishforest

2.4 Embedding模型
Embedding模型也称为textual inversion,即文本反转。在Stable Diffusion中,Embedding模型使用了嵌入技术以将一系列输入提示词打包成一个向量,从而提高图片生成的稳定性和准确性。
简单来说,如果我们要通过SD生成火影里面的鸣人形象,我们需要好几个提示词来进行描述,比如什么外形,穿什么颜色的衣服,而Embedding就是将这一系列提示词打包成为一个新的提示词,假设叫鸣人。
这样后续我们只要引入这个 Embedding模型,然后输入鸣人提示词,就会生成我们想要的鸣人形象,提高了写提示词的效率!
由于Embedding模型只是将提示词整合了,所以它的体积非常小,一般在几十到几百KB之间。
举个例子,比如像这个 Embedding 模型,它描绘了一位叫Caroline Dare的美女

当我们输入触发词时,就会生成类似的美女

虽然生成的图片不是一模一样,因为这跟你使用的底模有关,但是比较明显的特征是一致的,比如白头发
2.5 Hypernetwork模型
Hypernetwork可以翻译为“超网络”,它是一种基于神经网络的模型,可以快速生成其他神经网络的参数,常应用于Novel AI的Stable Diffusion模型中。
Hypernetwork可以用来对模型进行微调,比如在Stable Diffusion这样的图像生成模型中,通过插入一个小型的超网络来修改输出风格,而不改变原始模型的核心结构
这个模型的作用其实和Lora模型功能有点重叠,所以在实际使用中,我个人用得比较少。
三、模型的剪枝
大家在下载模型的时候,可能还会看到两个版本,一个版本带 pruned,另外一个版本是带 pruned-emaonly,比如下面这个[1]

这是因为大模型在训练的时候会保存两组不同类型的权重:第一组取的是最后一次的权重,也就是只带 pruned 的模型
💡
在深度学习模型训练的过程中,模型的参数(或称为“权重”)会在每一次迭代(或训练步)中根据损失函数(loss function)对数据的拟合情况进行调整。当训练结束时,模型所拥有的权重就是经过所有训练样本反复教导后的最终状态。这部分权重代表了模型在训练数据上学习到的知识,没有经过额外的平滑处理,直接反映了最后一次更新的结果
而第二组则是最近几次迭代的权重进行加权平均,加权平均即EMA(Exponential Moving Average),使用加权平均主要是减少短期波动的影响,这样得到的模型泛化性更好,也更稳定,也就是带 pruned-emaonly 的模型
由于带 pruned-emaonly 的模型体积更小,所以占用的显存(VRAM)也更少,适合用于直接出图;带 pruned 的模型体积更大,占用的显存也更多,更适合对其进行微调,如下图:

四、常用模型介绍
Stable diffusion的模型除了上述的分类之外,从用途上看,还分为官方模型、二次元模型(动漫)、真实系模型和2.5D模型四大类。
4.1 官方模型
官方模型有 1.X 和 2.X 两个大版本,目前在 1.X 中官方发布的有四个版本,分别是v1-1、v1-2、v1-3、v1-4

官方地址:https://huggingface.co/CompVis/stable-diffusion
但是 1.X 其实还有一个 v1-5 的版本,这个版本不是 CompVis 发布的,而是Runwayml发布的,而Runway就是那个文生视频比较出名的公司,据说这个版本在文本到图像生成任务上表现尤为出色,能够生成更符合用户需求的图像(不过我没试过)。
地址:Stable Diffusion v1-5 - a Hugging Face Space by runwayml[2]
2.X 目前一共有两个版本,分别是2-0和2-1,但变成了stabilityai 发布了
https://huggingface.co/stabilityai/stable-diffusion-2
https://huggingface.co/stabilityai/stable-diffusion-2-1
4.2 二次元模型
二次元模型比较出名的当属Anything系列(万象熔炉),像秋叶整合包默认就带了anything-v5-PrtRE 模型。
Anything系列型号目前有四个基本版本V1,V2.1,V3和V5,Prt是V5的特殊装饰版本,是比较推荐的版本。
Anything系列除了生成二次元外,其实对于肖像、风景、动物等也具有较强的适应性和泛用性,是一个比较通用的模型

4.3 真实系模型
真实系比较出名的模型有Realistic Vision等,这是C站上放出的一些图片,可以看到确实非常逼真了
Realistic Vision 模型:

4.4 2.5D模型
2.5D是半3D的意思,简单来说,2D是平面图形,如图片等没有厚度和轮廓的图形。而3D是具有厚度、可以从各个角度观看的立体图形,例如通过3D打印出来的实物模型。2.5D位于2D和3D之间,它加入了部分3D元素但不完全是3D
比较出名的2.5D模型有GuoFeng3等,这是它的一些效果图

这里分享给大家一份Adobe大神整理的《AIGC全家桶学习笔记》,相信大家会对AIGC有着更深入、更系统的理解。
有需要的朋友,可以点击下方免费领取!
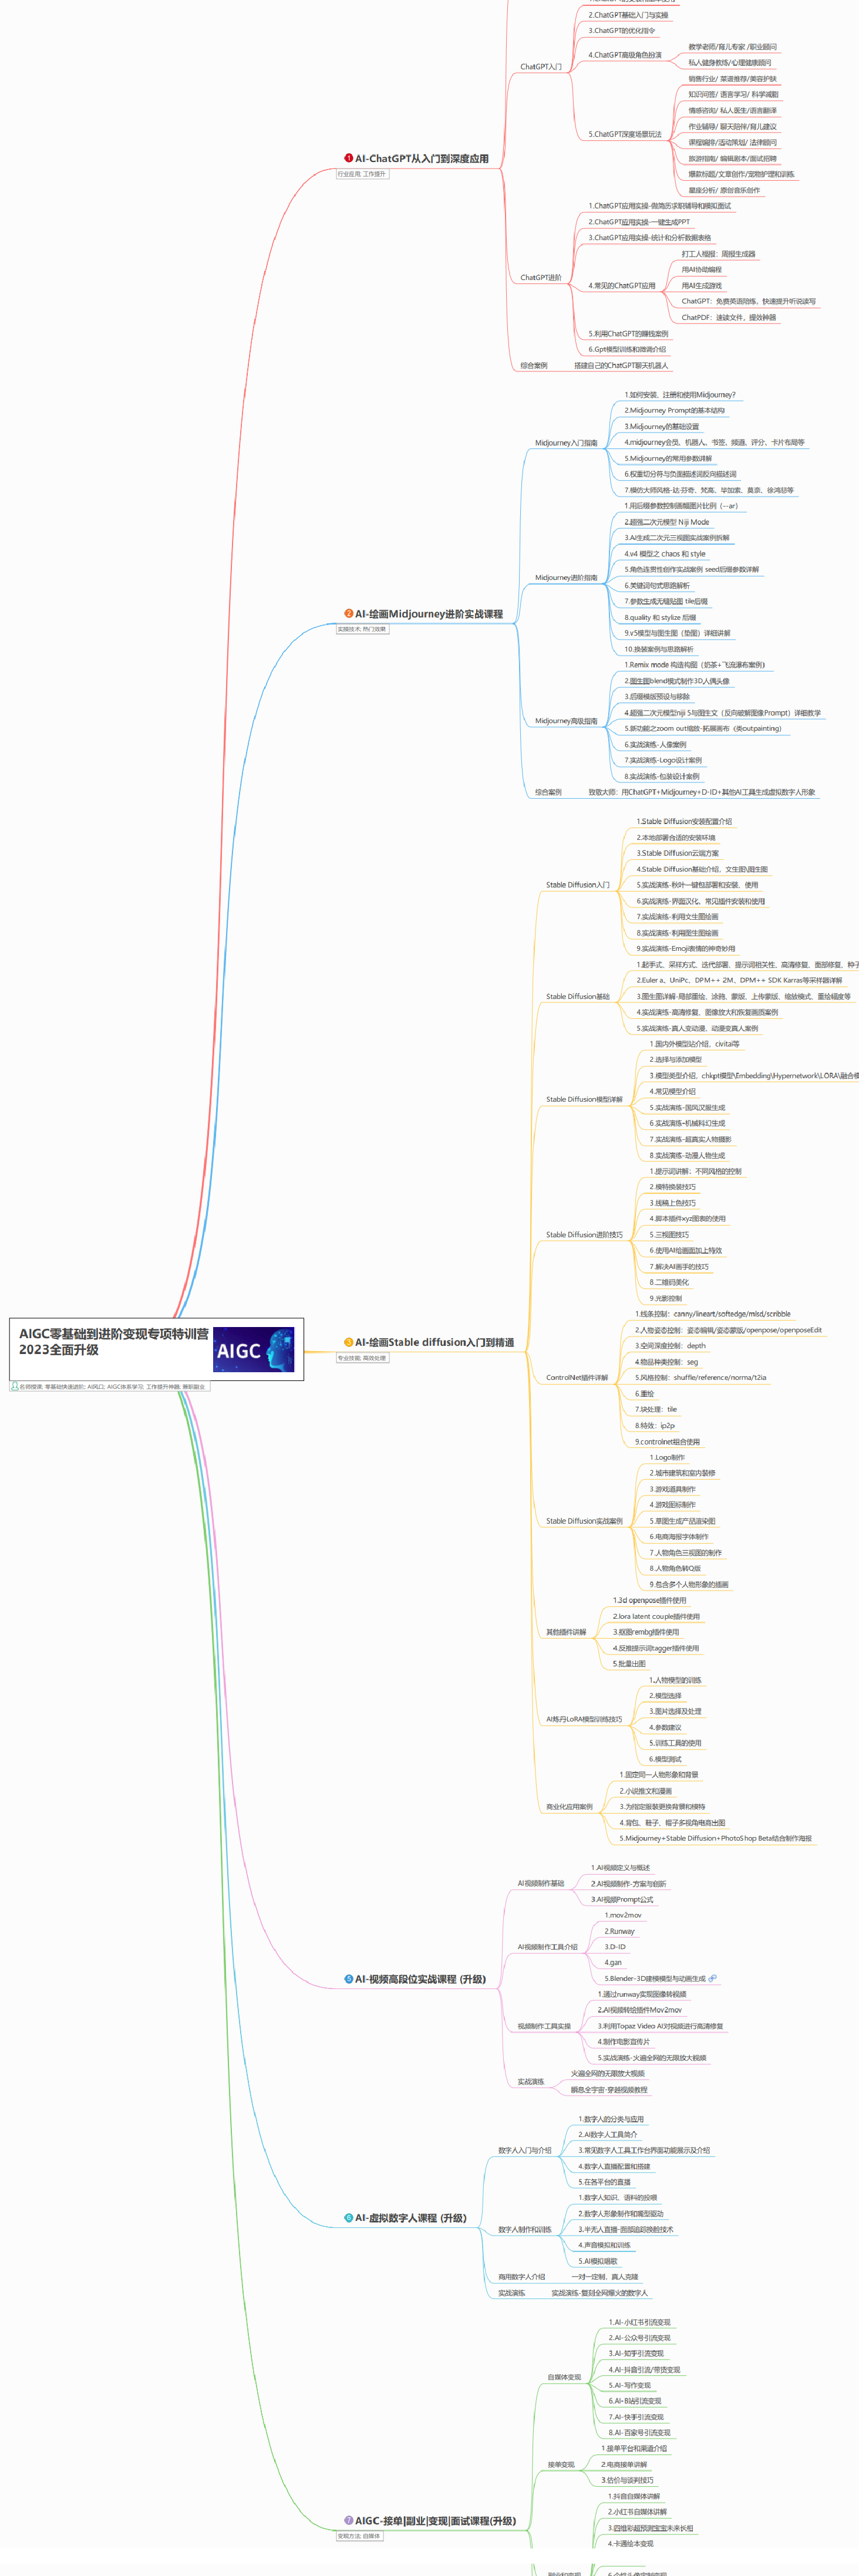
AIGC所有方向的学习路线思维导图
这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。如果下面这个学习路线能帮助大家将AI利用到自身工作上去,那么我的使命也就完成了:
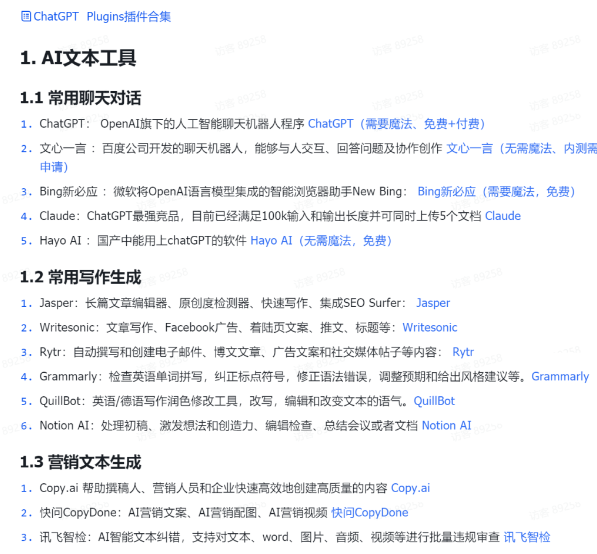
AIGC工具库
AIGC工具库是一个利用人工智能技术来生成应用程序的代码和内容的工具集合,通过使用AIGC工具库,能更加快速,准确的辅助我们学习AIGC
有需要的朋友,可以点击下方卡片免费领取!
[优快云大礼包:《SD绘图学习资源包》免费分享

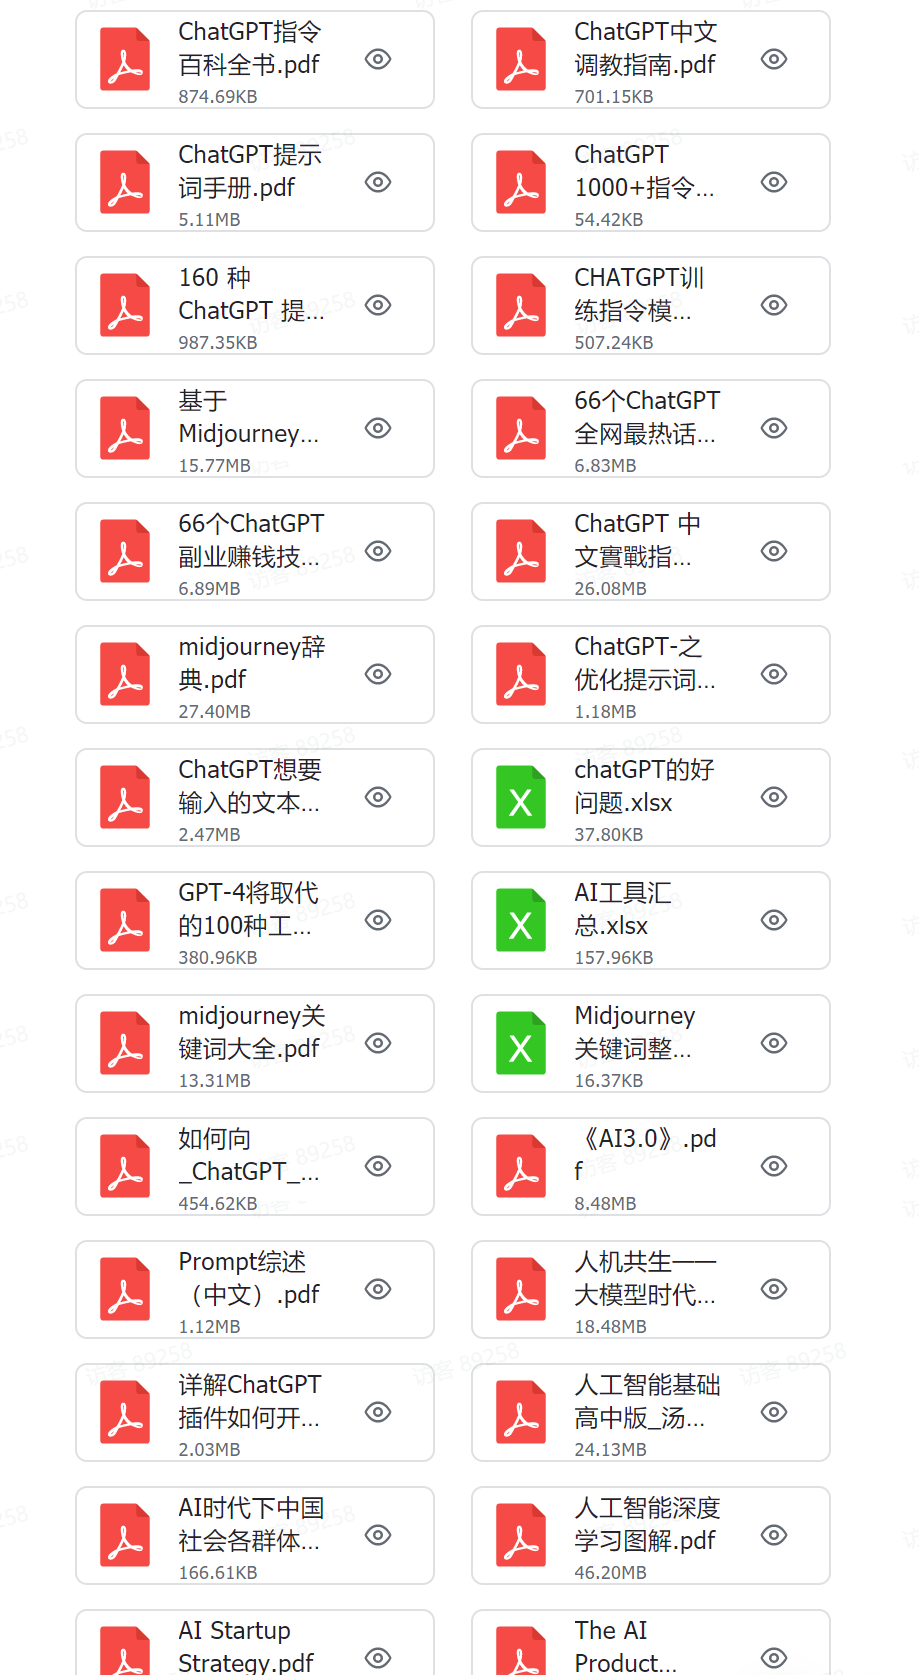
精品AIGC学习书籍手册
书籍阅读永不过时,阅读AIGC经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验,结合自身案例融会贯通。
AI绘画视频合集
我们在学习的时候,往往书籍源码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,科学有趣才能更方便的学习下去。



 2198


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


