AI绘画;(Stable Diffusion进阶篇:模型训练)

Stable Diffusion XL之使用Stable Diffusion XL训练自己的AI绘画模型 其中config_file.toml文件中的配置文件包含了sdxl_arguments,model_arguments,dataset_arguments,training_arguments,logging_arguments,sample_prompt_arguments,saving_arguments,optimizer_arguments以及additional_network_arguments九个个维度的参数信息。但是切记不能在多尺度增强的时候将图片的主体特征裁剪掉(比如人脸,建筑等)。 阅读详情

前言

在上一篇笔记中学习了解了一部分关于Stable Diffusion的运行原理,今天就来接着学习下Stable Diffusion关于微调训练方面的知识点。

今天没多少废话,因为我下午要去玩PTCG!让我们冲冲冲

整理和输出教程属实不易,觉得这篇教程对你有所帮助的话,可以点击👇二维码领取资料😘
在这里插入图片描述

数据集

上一篇笔记里提到过AI是如何“吸收”我们给它的知识,其中便是通过记录图像的像素色块分布然后存储这一特征。

现如今Stable Diffusion作为最炙手可热的AI绘画工具,它的训练规模肯定是极为庞大的。

在最开始的时候,官方的V1.1版本说是用了世界上最大规模的多模态图文数据集LAION-2B来进行训练,其中的B代表着Billion(十亿)。

这个数据集有着约23.2亿对图片和对应文本描述的庞大数据集:
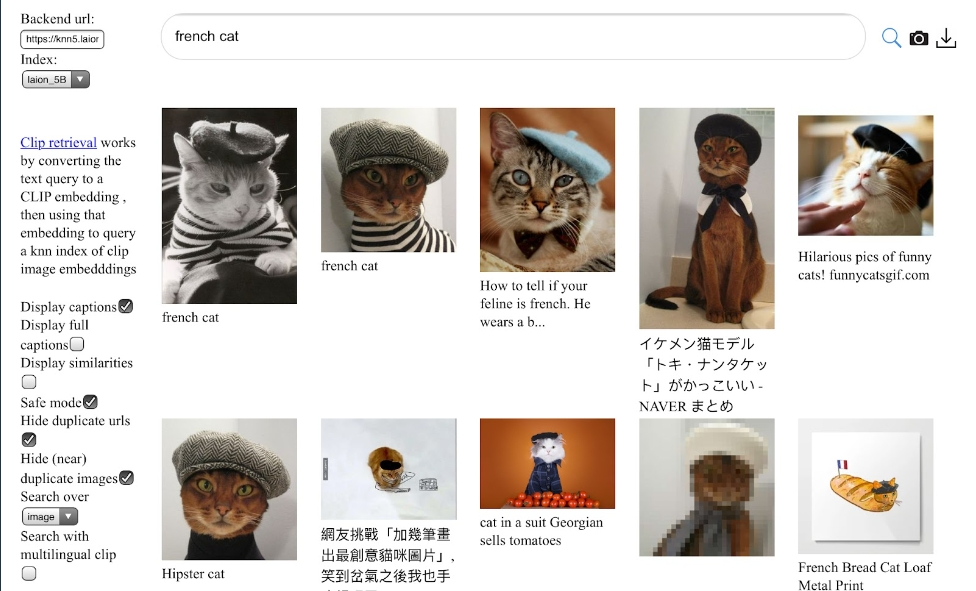
最新的LAION-5B约有58.5亿

Stable Diffusion官方在这个基础上训练了超过40万步,每个版本追加了更高清的图片进行优化,而SD1.5版本就是建立在LAION-5B数据集基础上。

这样庞大的数据集训练成本当然是很高的
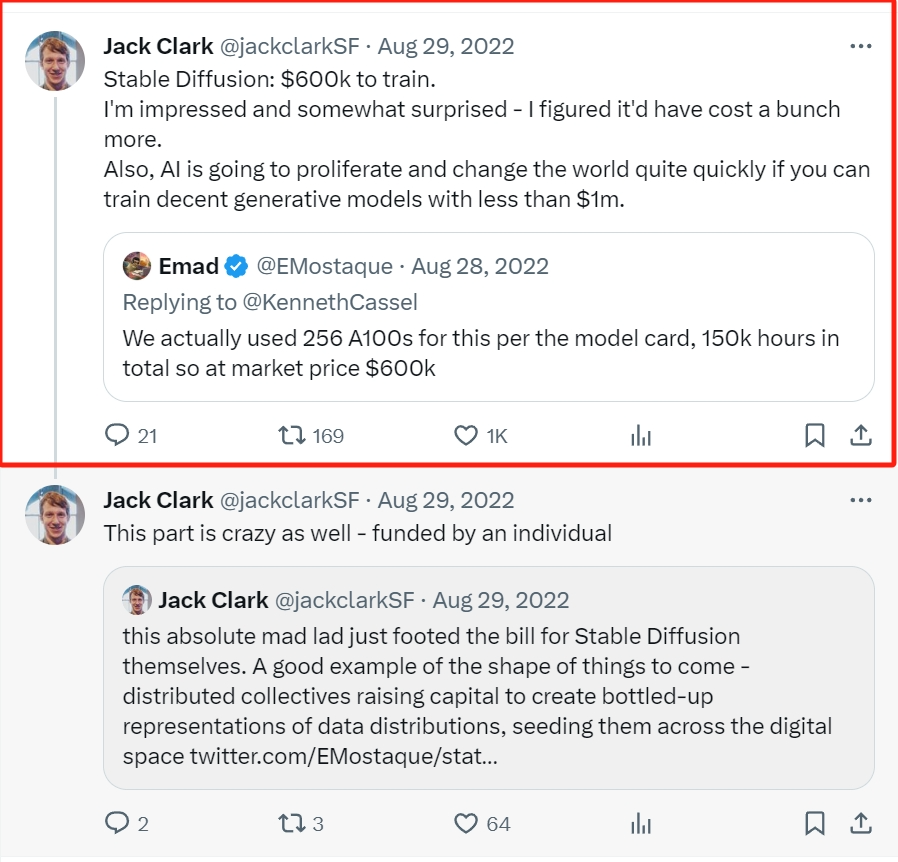
Stable Diffusion团队共使用了256块英伟达A100 GPU,训练了15万个小时共计成本约60万美金,而其竞争对手Dalle2的训练开销约在其7-8倍左右。

现在许多人手机上都有的GPT4训练成本已然超过了1亿美金,回过头看感觉Stable Diffusion还挺有性价比的。

当然看到这里也不要紧张,我们自己训练的模型并不需要这么大规模和这么多钱。
目前AI绘画领域所讨论的所有模型训练都是建立在这些官方已经花了很多钱和时间训练出来的开源模型(预训练模型)基础上。

所以现在绝大多数个人用户上传的模型都是微调模型,也就是那些在已经预训练好的大型模型基础上使用特定的数据集进行进一步训练,这样可以让模型适应特定任务或领域。

在以往官方已经训练好了不同版本的模型,而这些被模型训练者们挑选来训练的模型被称为“基底模型”。当然不只是官方的模型,还可以选择别人微调后的模型再进行一次训练。
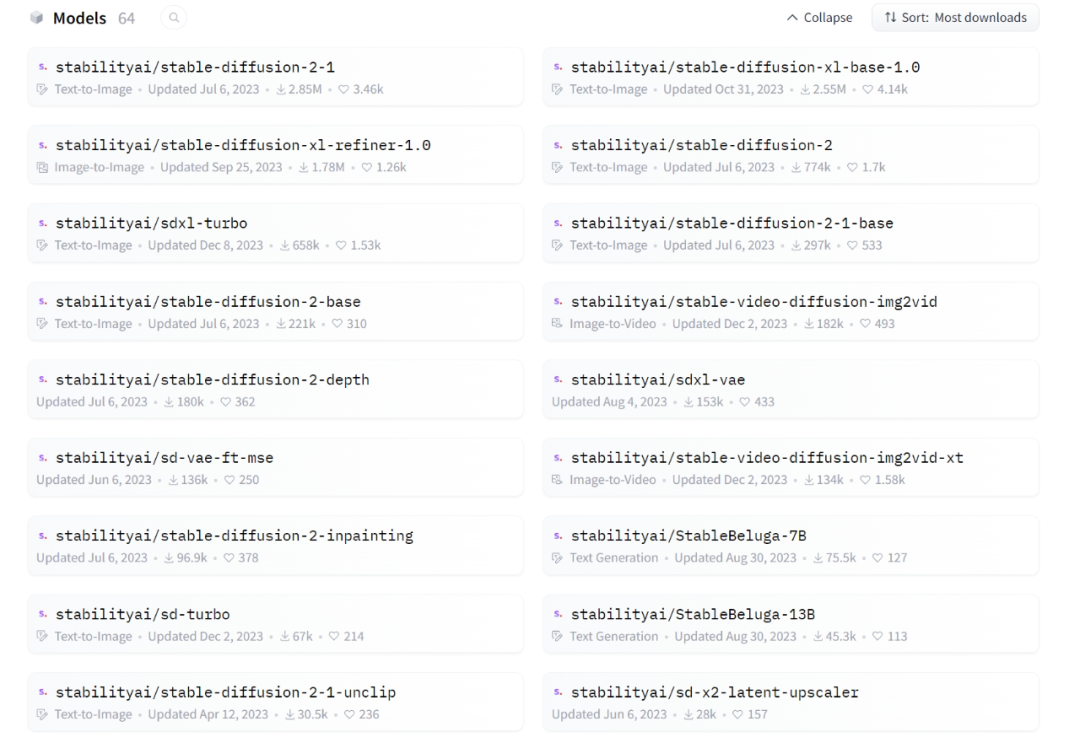
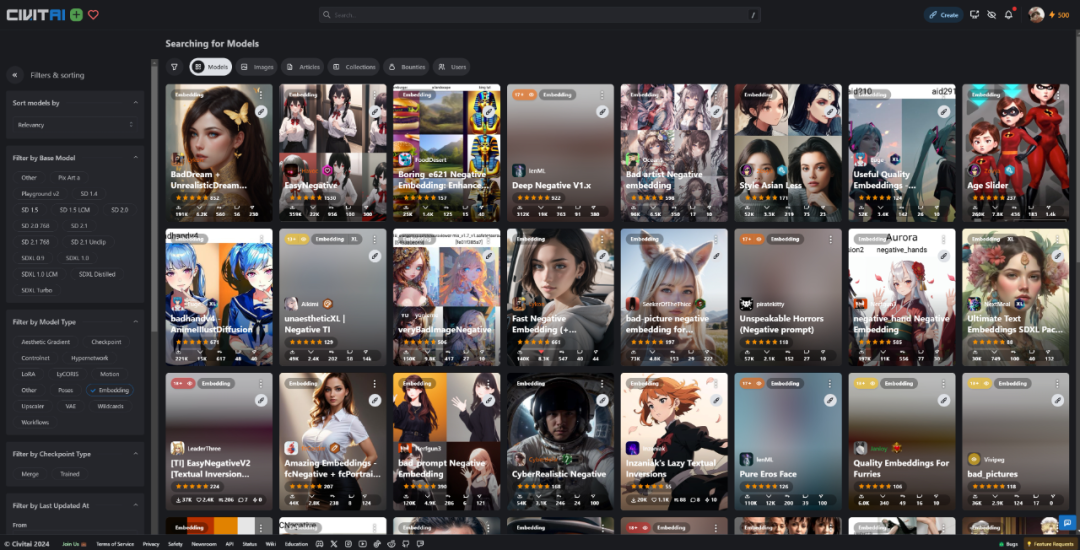
目前在各类模型网站上有着各种对模型的微调方式,而且这方式都是一个个开发者自行摸索出来的。

**主流模型微调手段
**

在早期的时候有着各类模型微调手段例如审美梯度Aesthetic Gradient、由NovelAI开发者提供的超网络Hypernetwork等。
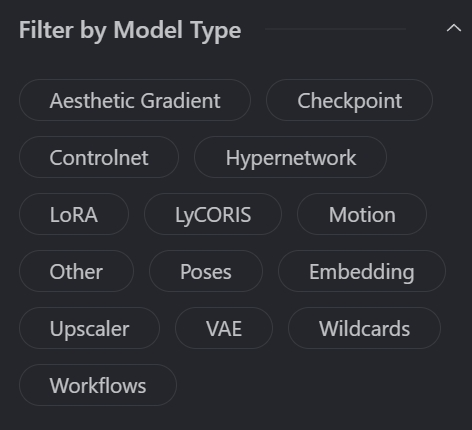
就目前的模型市场上看,还能发挥比较大作用的主流微调训练手法一共有三种:Dreambooth、LoRA(Low-Rank Adaptation)低秩(zhi)适应模型、Textual Inversion文本反演。

这三个微调手法分别对应着我们已经很熟悉的CheckPoint大模型、Lora模型和Embeddings词嵌入模型

Dreambooth(CheckPoint)是最早诞生且对配置要求最高的手段(显存>12GB),它是直接对包括文本编码器到噪声预测器的一整个过程进行微调,但调出来的模型理论上能容纳很多新东西,像是各种风格化的大模型。

LoRa是目前公认性价比最高的微调方式,通过在噪声预测期的神经网络中嵌入一些额外的低秩适应层从而实现高质量微调。配置要求也是最低的(显存>8GB),毕竟生成的模型只需要几十到几百MB,目前用来生成里植入一些人物角色和特定物体。

Textual Inversion(Embeddings)是比较轻量的微调手段(显存>10GB),是通过一些文本(Token)向量层面的微小改动起到微调效果。现多用于一些简单的概念植入或者提高生成图片的质量。
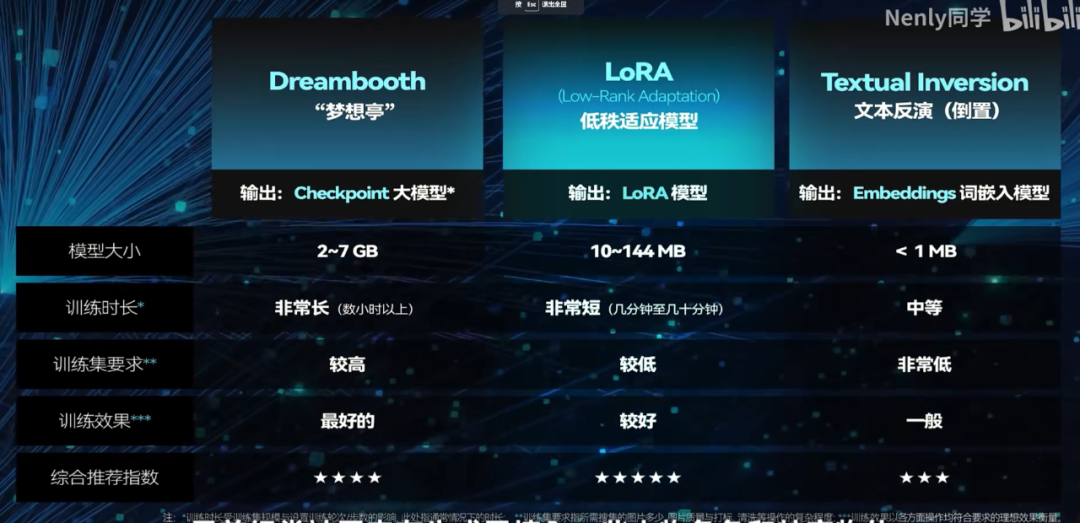
当然显卡配置越高越舒服,最好是16GB以上的配置。如果没有也没关系,可以用线上部署的方式来训练,直接上4090巴巴适适。

不过还有另一种方法:模型之间的融合,现如今所常用的模型大多数都是多个模型融合的结果。
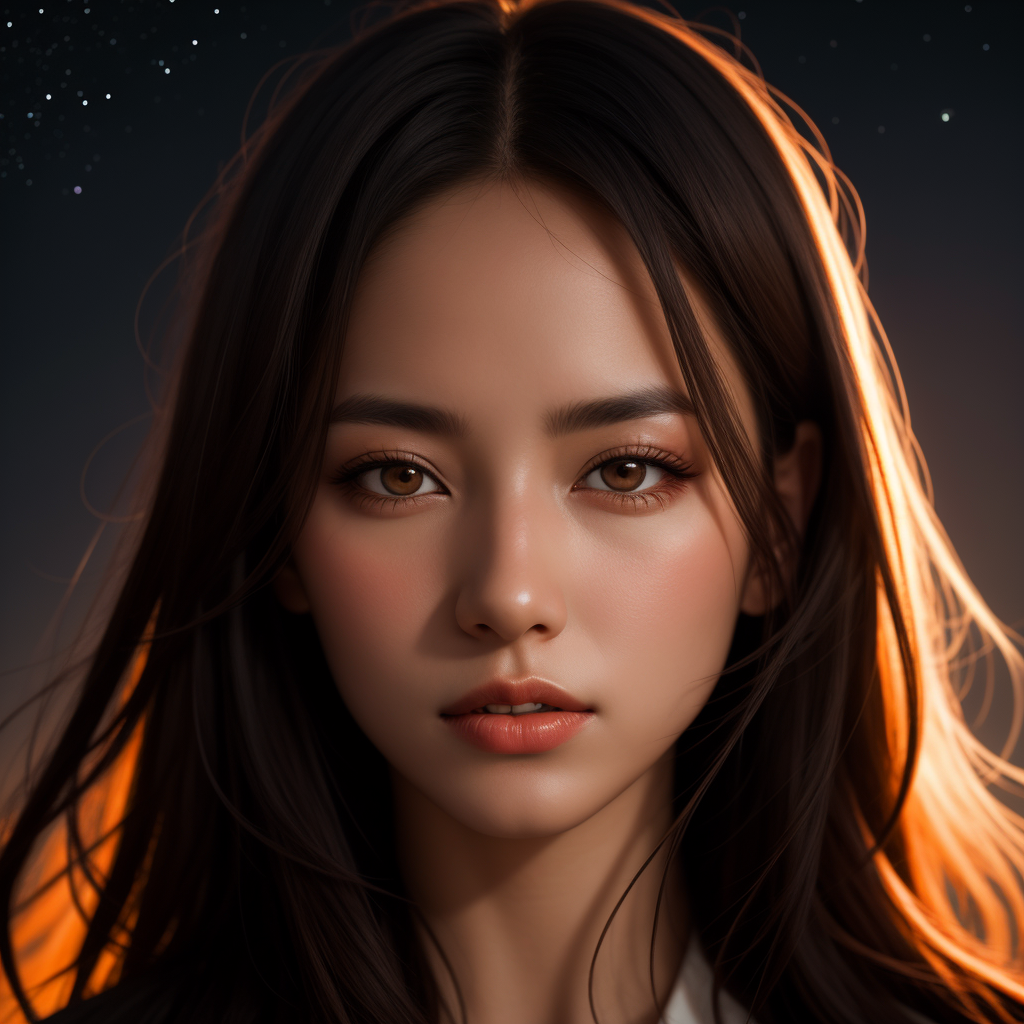

1girl, beautiful face, ((white eyes)), sexy pose, Red moon in the background, stars, space, (lightroom:1.13), soft light, (natural skin texture:1.2), (hyperrealism:1.2), sharp focus, focused,[[realistic]]

Negative prompt: (low quality:1.3), (worst quality:1.3),(monochrome:0.8),(deformed:1.3),(malformed hands:1.4),(poorly drawn hands:1.4),(mutated fingers:1.4),(bad anatomy:1.3),(extra limbs:1.35),(poorly drawn face:1.4),(watermark:1.3),(patreon logo),FastNegativeV2

  • Steps: 30

  • Sampler: Euler a

  • CFG scale: 7

  • Seed: 3943490072

  • Size: 512x512

  • Model hash: e3020b4e49

  • Model: realisian_v50

  • Denoising strength: 0.7

  • Clip skip: 2

  • ENSD: 31337

  • Hires upscale: 2

  • Hires upscaler: R-ESRGAN 4x+

  • Version: v1.6.0-2-g4afaaf8a0

关于AI绘画技术储备

学好 AI绘画 不论是就业还是做副业赚钱都不错,但要学会 AI绘画 还是要有一个学习规划。最后大家分享一份全套的 AI绘画 学习资料,给那些想学习 AI绘画 的小伙伴们一点帮助!

对于0基础小白入门:

如果你是零基础小白,想快速入门AI绘画是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以找到适合自己的学习方案

包括:stable diffusion安装包、stable diffusion0基础入门全套PDF,视频学习教程。带你从零基础系统性的学好AI绘画!

零基础AI绘画学习资源介绍

👉stable diffusion新手0基础入门PDF👈

(全套教程文末领取哈)
在这里插入图片描述

👉AI绘画必备工具👈

在这里插入图片描述

温馨提示:篇幅有限,已打包文件夹,获取方式在:文末

👉AI绘画基础+速成+进阶使用教程👈

观看零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

在这里插入图片描述

温馨提示:篇幅有限,已打包文件夹,获取方式在:文末

👉12000+AI关键词大合集👈

在这里插入图片描述

这份完整版的AI绘画全套学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

AI绘画Stable Diffusion实战:从模型训练到Prompt工程全解析 通过本文的实战案例和代码示例,希望能够帮助开发者更好地理解和掌握Stable Diffusion模型训练和Prompt工程的技巧。在实际开发中,开发者需要根据项目需求和数据集特点选择合适的训练方法和参数设置,并精心设计Prompt以引导模型生成符合期望的图像。无论是艺术创作还是视觉设计领域,Stable Diffusion都将为开发者提供强大的支持和创新的可能性。 阅读详情

相关推荐

数据集-(图像-文本):LAION【史上最大规模多模态图文数据集,包含58.5亿个图像-文本对】

之前的研究中,为了限制生成模型不生成种族主义图片,尝试在训练集中删除了与暴力相关的物体、人和面部的图像,然而,这显然限制了模型的通用能力—比如人脸生成。紧接着发布的ALIGN[3]、GLIDE[12]等证实了这一点,但是这些大型数据集都没有开源,因此这一领域的研究,只集中在少数几个机构中,2021年公布的LAION-400M[1]是当时最大的公开图文数据集,本次发布的LAION-5B[2]是LAION-400M的14倍,足够规模的公开数据使得该领域的研究更多元化,能够让更多的研究者参与到这一领域的研究中。

u013250861的博客 5673

AI绘画:Lora模型训练完整流程!

关于AI绘画(基于Stable Diffusion Webui),我之前已经写过三篇文章,分别是。整体来说还是比简单的,搞个别人的模型,搞个提示词就出图了。今天来一个有些难度的,自己训练一个LoRA微调模型。

托尼不是塔克 2万+

stable diffusion模型训练时数据量

laion2B-en数据集,是laion5B的一个子集,更具体的说它是laion-5B中的英文数据集,laion-5B是从网页数据common crawel中筛选出来的图像文本对,包含5.85B的图像文本对,其中文本为英文的数据量为2.32B,这就是laion-2B-en数据集。在laion-2B-en数据集上评分为5以上训练的,先用256x256,再用512x512,用了32台8卡A100 40G,bs=32x8x2x2=2048。在laion-2B-en数据集上评分为4.5以上训练的,

liguandong 3773

Stable Diffusion Lora模型训练详细教程

stable diffusion lora模型训练

程序员深度学习 5万+

Laion5B数据集下载,laion2B-en数据集下载,百度云盘,阿里云盘

存在此文件》看大小》不大就断点续传。不存在此文件》断点续传。

q742971636的博客 2623

Stable Diffusion模型训练实战:打造专属AI绘画模型

你是否遇到过这样的困扰?用通用Stable Diffusion模型生成的图像总是“千篇一律”——赛博朋克风像模板复制,二次元角色总带网红脸。想让AI画出“奶奶织的毛衣质感”“童年老房子的黄昏”?这就需要训练专属模型。本文覆盖从原理理解到实战落地的全流程,帮你掌握Stable Diffusion的核心训练方法(含LoRA轻量级训练),目标读者无需GPU集群,用消费级显卡(如RTX 3090)即可完成。本文先通过“擦除-恢复”游戏讲清扩散模型原理,再用“学新风格”类比解释训练逻辑;

AIGC应用创新大全的博客 1437

【粉丝福利社】AI绘画:Stable Diffusion ComfyUI的艺术

2022年8月,Stable Diffusion开源发布,经过两年的多次迭代升级,涌现出了如SD1.5、SD2.1、SDXL、SD3等经典版本,目前已进入较为成熟的阶段。2024年8月,Flux横空出世,让AI绘画翻开了新的篇章。考虑到模型生态、插件支持及画质表现,本书主要基于SDXL模型进行撰写。快手的Kolors模型(采用了SDXL模型架构)已经开源,支持中文提示词,能够生成优质的中国元素图像。

愚公智库 14万+

AI 绘画 stable diffusion webui 常见模型汇总及简介

主要是记录索引一下常见的 AI 绘画作画模型,方便自己用。主要收集 stable diffusion webui 用大模型(ckpt与safetensors)包括了常见的模型比如的Waifu Diffusion、anything、f222、basil mix、urpm 、chillout mix等模型。Lora(人物卡模型)和hypernetworks(embedding和hypernetwork)暂时不打算广泛搜集,因为这个实在有点多了,未来只打算列出非常热门的。

weixin_41259045的博客 2万+

【AI绘画】9个Stable Diffusion模型网站分享

今天给大家分享一些可以下载Stable Diffusion模型的网站。

libaiup的博客 1万+

【IIC通信】Chap.1(I2C)IIC通信原理、IIC读写时序详解

IIC通信以两根连线SDA、SCL实现了完善的全双工同步数据传送, 可以方便地构成多机系统和外围器件扩展系统。

Jie_MSD的博客 2万+

Codex辅助小说创作:零成本AI写作指南与实战技巧

自然语言处理技术通过深度学习模型理解语义上下文,其核心原理是基于大规模文本训练的语言模型预测能力。在创意写作领域,这项技术的价值在于突破传统写作工具的功能局限,实现从内容生成到风格模仿的智能化辅助。特别是提示词工程的应用,让创作者能够精准控制AI输出的内容和风格。在实际应用场景中,AI写作工具显著降低了小说创作门槛,适用于网络小说、奇幻科幻等多种文学类型。本文以OpenAI Codex为例,详细解析如何利用AI技术完成从故事大纲设计、章节生成到平台发布的全流程创作,其中提示词优化和内容质量把控是提升生成效果

weixin_32678995的博客 568

Stable Diffusion绘画 | 来训练属于自己的模型:秋叶训练器使用

Stable Diffusion绘画 | 来训练属于自己的模型:秋叶训练器使用

weixin_55154866的博客 1837

CANoe.Diva实战:基于CDD的UDS诊断自动化测试全流程解析

本文详细解析了使用CANoe.Diva进行基于CDD的UDS诊断自动化测试的全流程,包括环境搭建、CDD文件配置、测试范围设置、用例生成与验证、CANoe集成测试及报告分析。通过实战经验分享,帮助工程师快速掌握诊断自动化测试技巧,提升测试效率与质量。

weixin_29258297的博客 219

【stable diffusion模型】Stable Diffusion进阶篇:模型训练

《Stable Diffusion模型训练实战:文本反演与Embeddings微调指南》 摘要: 本文介绍了Stable Diffusion模型训练的基础实践,重点讲解文本反演(Embeddings)这种轻量级微调方法。作者通过三步实操演示训练过程:1)准备10-20张训练图片;2)使用WebUI的预处理功能进行512×512裁剪和自动标注(BLIP/Deepbooru);3)处理常见报错问题。文章指出Embeddings文件仅需几KB空间,却能有效提取图像特征,适用于特定形象塑造和负面词优化。虽然存在1.

z19981的博客 1848

【数字图像处理第四版课后习题答案】第2章 数字图像基础(含英文原版)

如图 P2.3 所示,视网膜图像中与点相对应的直径 x 是由类似的三角形得到的。即得出 x = 0.085d。根据第 2.1 节中的讨论,并结合一些自由解释,我们可以将眼窝视为一个方形传感器阵列,拥有大约 337,000 个元素,这相当于一个大约 580×580 个元素的阵列。假设元素间距相等,则在 1.5 毫米长的直线上有 580 个元素和 579 个空间,共计 1,159 个。换句话说,如果一个点的直径 d<1.3×10⁻⁶ m,或者 d<15.3×10 m,眼睛就无法检测到这个点。

weixin_56463218的博客 1万+

FPGA波束形成:从算法到硬件的艺术之旅

本文深入探讨了FPGA在波束形成技术中的应用,从算法原理到Verilog硬件实现的全过程。文章详细分析了FPGA并行处理、低延迟和可重构特性如何优化波束形成系统性能,并提供了Verilog关键模块代码示例和资源优化策略,为工程师实现高效FPGA波束形成解决方案提供实用指导。

tea88的博客 1047

AI绘画教程:如何用Stable Diffusion训练出自己专属的人像模型?

在Stable Diffusion,有好几种模型训练方式,前面已经介绍了效果最佳的dream booth,另外还有Textual Inversion (Embedding)、 Hypernetwork和Lora几种方式。今天来介绍下Textual Inversion (Embedding)的模型。相对于dream booth动辄几个G的体积,Textual Inversion的体积则非常小。

m0_74942241的博客 1435

3、灵巧手的设计与构造

本文详细探讨了灵巧手的设计与构造,包括多指结构、关节和连杆设计、传感器集成以及分层控制架构等内容。同时,通过工业装配、医疗手术辅助和日常生活辅助等实际应用案例,展示了灵巧手的灵活性和适应性,并分析了当前设计面临的挑战及未来发展方向。

brandy的博客 496

AI绘画软件Stable Diffusion的Lora模型详解与使用教程

在[AI绘画]领域,StableDiffusion作为一种强大的文本到图像的生成模型,已经吸引了众多艺术家和爱好者的关注。而Lora(Low-RankAdaptation)模型作为StableDiffusion的一个重要扩展,进一步提升了模型的微调效率和生成质量。本文将详细介绍Lora模型的基本概念、工作原理以及如何在StableDiffusion中使用Lora模型,为希望提升AI绘画技能的读者提供一份详尽的指南。

Android 开发架构 1464

沁恒CH32V30X学习笔记02--GPIO的使用教程及2次封装驱动

刚复位后,GPIO 口运行在初始状态,这时大多数 IO 口都是运行在状态所有的 GPIO 口都可以被配置外部中断输入通道,但一个外部中断输入通道最多只能映射到一个GPIO 引脚上,且外部中断通道的序号必须和 GPIO 端口的位号一致,,两方都是一对一的关系。复用功能。

Car12 707

Raspberry Pi 4 ARM Trusted Firmware 技术解析

摘要: 本文详细介绍了在树莓派4(Raspberry Pi 4)上移植ARM可信固件(TF-A)的实现方案与安全考量。该移植专注于BL31功能,作为非安全世界(如Linux内核)的启动桥梁,支持加载EL2级别程序。文章分析了启动流程、内存映射设计,并对比了RPi3与RPi4的关键差异,指出当前版本缺乏硬件级安全内存保护的局限性。此外,提供了构建指南、配置说明及设备树自动修补的实现细节,强调通过config.txt简单配置即可启动64位内核。该方案充分利用树莓派原有GPU固件流程,兼顾兼容性与简易性。

Linux内核架构师 932
上一篇: AI副业革命:大学生如何用AI月入六位数?
下一篇: 2024已经过半,推荐几个AI副业的机会!
壹只小小码农
博客等级 码龄5年 8104粉丝 1333原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值