你有没有在MySQL的order by上栽过跟头

深入解析ORDER BY注入:原理、实战与防御方案 SQL注入是Web安全领域的核心威胁之一,其本质是攻击者通过构造恶意输入,篡改应用程序与数据库交互的查询逻辑。在众多注入类型中,ORDER BY注入因其独特的利用方式和隐蔽性,常被开发者忽视。其技术原理在于,应用程序未对用户控制的排序字段或方向进行有效过滤,导致攻击者能在ORDER BY子句中注入额外的SQL表达式,进而通过条件判断(如CASE WHEN)或时间延迟函数(如SLEEP)进行数据探测。这种漏洞的价值在于,它能绕过针对WHERE子句的传统防御(如参数化查询),成为渗透测试中信息收集的关键入口。其 阅读详情

排序这个词,我的第一感觉是几乎所有App都有排序的地方,淘宝商品有按照购买时间的排序、B站的评论有按照热度排序的...,当然我们今天说的并不是大数据下该如何优雅的排序,如何提升排序性能的问题,我们说一说MySQL中的排序。

对于MySQL,一说到排序,你第一时间想到的是什么?关键字order by?order by的字段最好有索引?叶子结点已经是顺序的?还是说尽量不要在MySQL内部排序?

事情的起因

现在假设有一张用户的朋友表:

CREATE TABLE `user` (
  `id` int(10) AUTO_INCREMENT,
  `user_id` int(10),
  `friend_addr` varchar(1000),
  `friend_name` varchar(100),  
  PRIMARY KEY (`id`),
  KEY `user_id` (`user_id`)
) ENGINE=InnoDB;

表中目前有两个点需要关注下:

  1. 用户的 user_id ,朋友的姓名 friend_name 、朋友的地址 friend_addr

  2. user_id 是有 索引 的

有一天,有个初级开发工程师小猿,收到了来自初级产品经理小汪的需求:

小汪 :小猿同志,现在需要在后台加个功能,这个功能要支持根据用户 id 能查到他所有的朋友姓名和地址,并且要求朋友的姓名是按照字典排序的。

小猿

:好的,这个功能简单,我马上就上线。

于是小猿书写了这样的sql:

select friend_name,friend_addr from user where user_id=? order by name

在电光石火的瞬间,小猿趾高气昂的上线了,这一切都很顺利,直到有一天有个运营同学导致了这样的查询:

select friend_name,friend_addr from user where user_id=10086 order by name

然而,这个查询竟然比平时慢很多,数据库报了慢查询,小猿此时慌的一b:这是怎么回事?user_id 明明有索引啊,而且机智地我还只用了 select friend_name,friend_addr,并没有用 select *呀。小猿此时不停地安慰自己,要淡定要淡定,然后突然想到有个explain命令,用explain来查看下那条sql的执行计划吧,当小猿用了explain之后,发现extra字段里面有个看起来很危险的字眼: using filesort 。

“这个查询竟然用到了传说中的文件排序,但是如果一个人朋友不是很多,就算了用了文件排序,应该也很快吧”,除非这个user_id=10086的朋友很多,后来小猿去查了下,这个用户的朋友竟然有10w多个~。

陷入了沉思的小猿心想:这个锅看来是背定了,10w数据是有点大了,还有这个 using filesort 到底是怎么个排序原理?

解剖文件排序

有人可能说上面的问题是10w数据太大了,就算不排序也慢,这个其实是有道理的,10w数据一次性查出来,无论是MySQL内存缓冲区的占用,还是网络带宽的消耗都是非常大的,那如果我加了limit 1000呢?网络带宽的问题肯定是解决了,因为数据包整体变小了,但是 using filesort 的问题其实还是没有解决,看到这里你可能会有疑问,using filesort 难道是在文件中排序的?在文件中到底是怎么排序的?或者我这样问:如果给你来设计排序你会怎么处理?带着这些疑问和思考我们来看看 using filesort 会涉及到哪些技术难点以及是如何解决的?

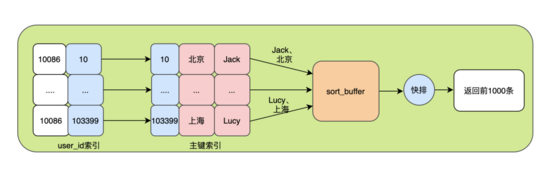
  1. 首先我们的 user_id 是有索引的,所以会先在 user_id 索引树上检索我们的目标数据,即 user_id=10086 的数据,但是我们要查询的是 friend_name 和 friend_addr 字段,很不幸,光靠 user_id 索引是找不到这两个字段值的

  2. 于是需要回表,通过 user_id 对应的主键去主键索引树上去查找,ok,我们找到了第一条 user_id=10086 的 friend_name 和 friend_addr 字段

  3. 这时该怎么办?直接返回回去肯定不对,因为我需要对 friend_name 排序,如何排?数据都还没找全,那么就得把查到的数据先放在一个地方,这个地方就是 sort_buffer ,看到名字我想你应该猜出来,没错,sort_buffer 就是用于这种情况下排序用的缓冲区,这里需要注意的是每个线程都会有一个单独的 sort_buffer,这么做的目的主要是为了避免多个线程对同一块内存进行操作带来锁竞争的问题。

  4. 当第一条数据的 friend_name 和 friend_addr 已经放入 sort_buffer 中,这当然没完,会一直重复同步的步骤,直至把所有 user_id=10086 的 friend_name 和 friend_addr 都放入到 sort_buffer 中才结束

  5. sort_buffer 中的数据已经放入完毕,接下来就该排序了,这里 MySQL 会对 friend_name 进行快排,通过快排后,sort_buffer 中 friend_name 就是有序的了

  6. 最后返回 sort_buffer 中的前1000条,结束。

一切看起来很丝滑,但是 sort_buffer 占用的是内存空间,这就尴尬了,内存本身就不是无限大的,它肯定是有上限的,当然 sort_buffer 也不能太小,太小的话,意义不大。在 InnoDB 存储引擎中,这个值是默认是256K。

mysql> show variables  like 'sort_buffer_size';
+------------------+--------+
| Variable_name    | Value  |
+------------------+--------+
| sort_buffer_size | 262144 |
+------------------+--------+

也就是说,如果要放进 sort_buffer 中的数据是大于256K的话,那么采用在 sort_buffer 中快排的方式肯定是行不通的,这时候,你可能会问:MySQL难道不能根据数据大小自动扩充吗?额,MySQL是多线程模型,如果每个线程都扩充,那么分给其他功能buffer就小了(比如change buffer等),就会影响其他功能的质量。

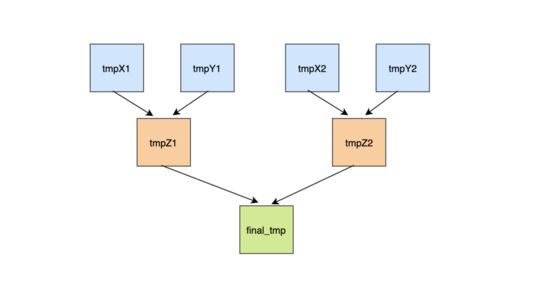
这时就得换种方式来排序了,没错,此时就是真正的文件排序了,也就是磁盘的临时文件,MySQL会采用归并排序的思想,把要排序的数据分成若干份,每一份数据在内存中排序后会放入临时文件中,最终对这些已经排序好的临时文件的数据再做一次合并排序就ok了,典型的分而治之原理,它的具体步骤如下:

  1. 先将要排序的数据分割,分割成每块数据都可以放到 sort_buffer 中

  2. 对每块数据在 sort_buffer 中进行排序,排序好后,写入某个临时文件中

  3. 当所有的数据都写入临时文件后,这时对于每个临时文件而言,内部都是有序的,但是它们并不是一个整体,整体还不是有序的,所以接下来就得合并数据了

  4. 假设现在存在 tmpX 和 tmpY 两个临时文件,这时会从 tmpX 读取一部分数据进入内存,然后从 tmpY 中读取一部分数据进入内存,这里你可能会好奇为什么是一部分而不是整个或者单个?因为首先磁盘是缓慢的,所以尽量每次多读点数据进入内存,但是不能读太多,因为还有 buffer 空间的限制。

  5. 对于 tmpX 假设读进来了的是 tmpX[0-5] ,对于 tmpY 假设读进来了的是 tmpY[0-5],于是只需要这样比较:如果 tmpX[0] < tmpY[0],那么 tmpX[0] 肯定是最小的,然后 tmpX[1] 和 tmpY[0] 比较,如果 tmpX[1] > tmpY[0],那么 tmpY[0] 肯定是第二小的...,就这样两两比较最终就可以把 tmpX 和 tmpY 合并成一个有序的文件tmpZ,多个这样的tmpZ再次合并...,最终就可以把所有的数据合并成一个有序的大文件。
文件排序很慢,还有其他办法吗

通过上面的排序流程我们知道,如果要排序的数据很大,超过 sort_buffer 的大小,那么就需要文件排序,文件排序涉及到分批排序与合并,很耗时,造成这个问题的根本原因是 sort_buffer 不够用 ,不知道你发现没有我们的 friend_name 需要排序,但是却把 friend_addr 也塞进了 sort_buffer 中,这样 单行数据的大小就等于 friend_name 的长度 + friend_addr 的长度 ,能否让 sort_buffer 中只存 friend_name 字段,这样的话,整体的利用空间就大了,不一定用得到到临时文件。没错,这就是接下来要说的另一种排序优化 rowid排序 。

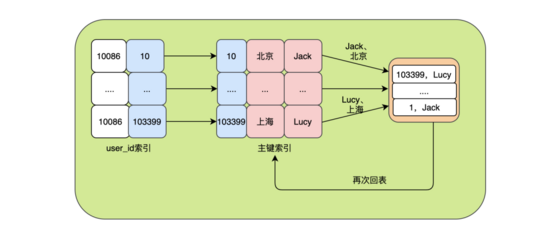
rowid 排序的思想就是把不需要的数据不要放到 sort_buffer 中,让 sort_buffer 中只保留必要的数据,那么你认为什么是必要的数据呢?只放 friend_name?这肯定不行,排序完了之后,friend_addr 怎么办?因此还要把主键id放进去,这样排完之后,通过 id 再回次表,拿到 friend_addr 即可,因此它的大致流程如下:

  1. 根据 user_id 索引,查到目标数据,然后回表,只把 id 和 friend_name 放进 sort_buffer 中

  2. 重复1步骤,直至全部的目标数据都在 sort_buffer 中

  3. 对 sort_buffer 中的数据按照 friend_name 字段进行排序

  4. 排序后根据 id 再次回表查到 friend_addr 返回,直至返回1000条数据,结束。
这里面其实有几点需要注意的:

  1. 这种方式需要两次回表的

  2. sort_buffer 虽然小了,但是如果数据量本身还是很大,应该还是要临时文件排序的

那么问题来了,两种方式,MySQL 该如何选择?得根据某个条件来判断走哪种方式吧,这个条件就是进 sort_buffer 单行的长度,如果长度太大(friend_name + friend_addr的长度),就会采用 rowid 这种方式,否则第一种,长度的标准是根据 max_length_for_sort_data 来的,这个值默认是1024字节:

mysql> show variables like 'max_length_for_sort_data';
+--------------------------+-------+
| Variable_name          | Value |
+--------------------------+-------+
| max_length_for_sort_data | 1024  |
+--------------------------+-------+

不想回表,不想再次排序

其实不管是上面哪种方法,他们都需要 回表 + 排序 ,回表是因为二级索引上没有目标字段,排序是因为数据不是有序的,那如果二级索引上有目标字段并且已经是排序好的了,那不就两全其美了嘛。

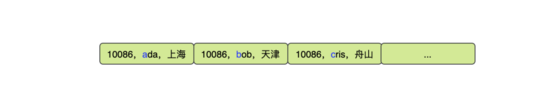
没错,就是联合索引,我们只需要建立一个 (user_id,friend_name,friend_addr)的联合索引即可,这样我就可以通过这个索引拿到目标数据,并且friend_name已经是排序好的,同时还有friend_addr字段,一招搞定,不需要回表,不需要再次排序。因此对于上述的sql,它的大致流程如下:

  1. 通过联合索引找到user_id=10086的数据,然后读取对应的 friend_name 和 friend_addr 字段直接返回,因为 friend_name 已经是排序好的了,不需要额外处理

  2. 重复第一步骤,顺着叶子节点接着向后找,直至找到第一个不是10086的数据,结束。
联合索引虽然可以解决这种问题,但是在实际应用中切不可盲目建立,要根据实际的业务逻辑来判断是否需要建立,如果不是经常有类似的查询,可以不用建立,因为联合索引会占用更多的存储空间和维护开销。

总结

  1. 对于 order by 没有用到索引的时候,这时 explain 中 Extra 字段大概是会出现 using filesort 字眼

  2. 出现 using filesort 的时候也不用太慌张,如果本身数据量不大,比如也就几十条数据,那么在 sort buffer 中使用快排也是很快的

  3. 如果数据量很大,超过了 sort buffer 的大小,那么是要进行临时文件排序的,也就是归并排序,这部分是由 MySQL 优化器决定的

  4. 如果查询的字段很多,想要尽量避免使用临时文件排序,可以尝试设置下 max_length_for_sort_data 字段的大小,让其小于所有查询字段长度的总和,这样放入或许可以避免,但是会多一次回表操作

  5. 实际业务中,我们也可以给经常要查询的字段组合建立个联合索引,这样既不用回表也不需要单独排序,但是联合索引会占用更多的存储和开销

  6. 大量数据查询的时候,尽量分批次,提前 explain 来观察 sql 的执行计划是个不错的选择。

从CVE-2021-35042看Django QuerySet.order_by()的SQL注入风险与实战利用 本文深入分析了CVE-2021-35042漏洞,揭示了Django框架中QuerySet.order_by()方法的SQL注入风险。通过详细的原理解析和实战复现,展示了攻击者如何利用该漏洞进行报错注入,获取数据库敏感信息。同时提供了官方修复方案、临时缓解措施和安全编码建议,帮助开发者有效防范此类安全威胁。 阅读详情

相关推荐

从MySQL迁移到Kingbase8:深入解析GROUP BY语法差异与sql_mode参数实战

本文深入解析了从MySQL迁移至Kingbase8数据库时,由GROUP BY语法差异引发的典型KSQLException报错问题。文章对比了MySQL宽松模式与Kingbase8严格遵循SQL标准的行为差异,并重点阐述了通过调整sql_mode参数(尤其是ONLY_FULL_GROUP_BY选项)以及规范SQL写法(如使用聚合函数或修改GROUP BY子句)等实战解决方案,帮助开发者顺利完成迁移并提升代码质量。

weixin_29267307的博客 364

你真的了解MySQL的order by吗

排序这个词,我的第一感觉是几乎所有App都有排序的地方,淘宝商品有按照购买时间的排序、B站的评论有按照热度排序的...,当然我们今天说的并不是大数据下该如何优雅的排序,如何提升排序性能的问题,我们说一说MySQL中的排序。 对于MySQL,一说到排序,你第一时间想到的是什么?关键字order by?order by的字段最好有索引?叶子结点已经是顺序的?还是说尽量不要在MySQL内部排序? 事情的起因 现在假设有一张用户的朋友表: CREATETABLE`user`( `id`int(...

假装懂编程的博客 5434

SQL GROUP BY 详解:从分类汇总到多维度聚合实战

在数据库查询与数据分析中,聚合操作是核心概念之一,它允许我们对数据集进行汇总统计,从而提炼出有价值的信息。其基本原理是通过将数据行按照指定字段分组,然后对每个组内的数据应用聚合函数(如COUNT、SUM、AVG)进行计算,最终将多行数据压缩为一行汇总结果。这项技术的核心价值在于改变了观察数据的维度,能够高效地回答诸如“每个类别的总数是多少”、“不同维度的平均值如何”等业务问题,广泛应用于销售统计、用户行为分析、日志汇总等数据汇总场景。本文将以SQL中的GROUP BY子句为具体切入点,通过丰富的实例,深入剖

weixin_30410119的博客 490

看一遍就理解:order by详解

日常开发中,我们经常会使用到order by,亲爱的小伙伴,你是否知道order by 的工作原理呢?order by的优化思路是怎样的呢?使用order by有哪些注意的问题呢?本文将跟大家一起来学习,攻克order by~

weixin_45017098的博客 2192

SQL八大核心命令执行顺序与协作逻辑详解

SQL不是语法列表,而是一套严格遵循执行时序的数据处理协议。理解SELECT、WHERE、GROUP BY、HAVING、ORDER BY、LIMIT、INSERT、UPDATE这八条命令的底层执行流程(如WHERE在GROUP BY前、HAVING过滤聚合结果、ORDER BY必须位于LIMIT之前),是写出正确、高效、可维护SQL的基础。掌握它们之间的能力边界与协作规则,能避免90%的常见错误——如WHERE中误用聚合函数、HAVING与WHERE混淆、LIMIT位置错误导致分页失真等。这些知识直接支撑

dglf54292的博客 1052

ROW_NUMBER()实战指南:分组排名、TopN与窗口函数避坑

ROW_NUMBER()是SQL中实现行级排序与定位的核心窗口函数,其本质是在不改变原始行数的前提下,为每行动态生成唯一序号。它基于OVER()子句构建‘局部计算窗口’,通过PARTITION BY划分逻辑分组,配合ORDER BY定义严格全序,从而支撑分组TopN、连续行为识别、去重留新等高阶分析。相比GROUP BY的聚合坍缩和LIMIT的粗暴截断,ROW_NUMBER()保留完整字段粒度,具备强组合性与可复现性。实际应用中需重点关注排序唯一性、NULL处理、索引优化及跨数据库兼容性,尤其在MySQL与

weixin_30394981的博客 366

MYSQL order by 索引 为什么还全表扫描+文件排序?

有一张表: CREATE TABLE `t1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `a` int(11) DEFAULT NULL, `b` int(11) DEFAULT NULL, `c` varchar(20) DEFAULT NULL, PRIMARY KEY (`id`), KEY `ic` (`c`(19)) USING BTREE ) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSE

一个技术菜鸟的博客 2510

LAG()函数实战避坑指南:从原理到生产级SQL优化

LAG()是SQL窗口函数中最基础也最易误用的核心工具,本质是在有序序列中实现‘向前/向后取值’的确定性操作。其执行依赖ORDER BY排序与PARTITION BY逻辑分片两大机制,底层通过扫描+缓存+回填完成O(1)取值,性能90%由索引和数据治理决定。技术价值在于支撑同比、环比、趋势识别等关键分析场景,广泛应用于零售销量预警、用户行为路径、金融时序风控等业务系统。本文聚焦LAG()在真实ETL脚本中的高频陷阱——如NULL排序歧义、分区粒度错配、OFFSET硬编码漂移、DEFAULT语义失真等,并提供

weixin_30847939的博客 294

MySQL实战第十六讲-“order by”是怎么工作的?

在你开发应用的时候,一定会经常碰到需要根据指定的字段排序来显示结果的需求。还是以我们前面举例用过的市民表为例,假设你要查询城市是“杭州”的所有人名字,并且按照姓名排序返回前 1000 个人的姓名、年龄。 假设这个表的部分定义是这样的: CREATE TABLE `t` ( `id` int(11) NOT NULL, `city` varchar(16) NOT NULL, `name` varchar(16) NOT NULL, `age` int(11) NOT NULL, `

分享前端工程化、AI 应用、Agent 开发与大模型实践! 803

Vivado2019.1 ZYNQ7020无Uart SDK调试打印调试信息xil_printf

Vivado2019.1 ZYNQ7020无Uart SDK调试打印调试信息xil_printf

泛红尘的博客 2998

Graylog日志系统实战:高效接收与解析交换机日志

本文提供Graylog日志系统的实战部署与配置指南,重点讲解如何高效接收与解析交换机日志。通过Docker快速部署,配置Syslog输入,并指导华为、华三等主流交换机将日志发送至Graylog。文章还介绍了使用提取器解析日志字段、创建数据流进行分类,以及设置报警规则,实现从被动排查到主动预警的运维转变,帮助网络工程师构建集中、智能的日志管理系统。

weixin_29284885的博客 541

12、Oracle:order by 排序和限制条件

第一部分: 本文来自:http://www.cnblogs.com/yzqm666/p/5854527.html Oracle的排序和限制条 1、Order by 子句的使用 select column.... from .... order by ...       1) Order by子句在整个     select语句中的位置:     始终位于

xushaozhang的专栏 6897

【OpenSearch】从零到一:手把手搭建OpenSearch与Dashboard可视化平台

本文提供了一份详细的OpenSearch与Dashboard可视化平台从零搭建指南。内容涵盖环境准备、系统调优、核心服务安装配置、Dashboard部署与汉化,以及生产环境安全加固建议,帮助用户快速构建一个功能完整的搜索与分析平台。

devops8pract的博客 617

springbean面试题,你有没有在MySQL的order by上栽过跟头,非科班生金九银十求职经历

2021年的金三银四一眨眼就到了,对于很多人来说是跳槽的好机会,大厂面试远没有我们想的那么困难,摆好心态,做好准备,你也可以的。另外,面试中遇到不会的问题不妨尝试讲讲自己的思路,因为有些问题不是考察我们的编程能力,而是逻辑思维表达能力;最后平时要进行自我分析与评价,做好职业规划,不断摸索,提高自己的编程能力和抽象思维能力。BAT面试经验实战系列:Spring全家桶+Redis等其他相关的电子书:源码+调优面试真题:一个人可以走的很快,但一群人才能走的更远。

2401_84103100的博客 388

Light Tools 8.4 在 win10系统上的安装方法(64位)

** 总的来说安装LT需要以下步骤(折腾了三天终于装好): 安装LT软件–禁用签名–加载含数字签名的第三方inf–添加注册表/安装驱动/添加密钥–成功破解 一、下载对应的LightTools 8.4版本软件,如下图为解压后的文件: 并选择 进行默认安装。 二、禁用数字签名。这里我用了两种方法,一种不行就换另一种,最终成功禁用。 方法1: 1、输入“cmd”并以管理员身份运行; 2、输入或复制 bcdedit.exe /set nointegritychecks on (此命令若没成功,再试bcded

weixin_45560953的博客 1万+

【2025最新版】Open3D 区域生长分割(python详细过程版)

点云区域生长分割算法的python详细过程版实现。博客长期更新,本文最新更新时间为:2025年3月23日。

点云侠的博客 9529

在MySQL的order by上栽过跟头的别躲啦

排序这个词,我的第一感觉是几乎所有App都有排序的地方,淘宝商品有按照购买时间的排序、B站的评论有按照热度排序的...,当然我们今天说的并不是大数据下该如何优雅的排序,如何提升排序性能的问题,我们说一说MySQL中的排序。 对于MySQL,一说到排序,你第一时间想到的是什么?关键字order by?order by的字段最好有索引?叶子结点已经是顺序的?还是说尽量不要在MySQL内部排序? 事情的起因 现在假设有一张用户的朋友表: CREATE TABLE `user` ( `id` int(

qq_64513388的博客 132

【突变检验合集】含Pettitt突变检验等

突变检验方法合集

WW、forever的博客 3535

mysql加了索引但是不起作用_【MySQL】明明加了索引,为何不生效?

加了索引却不生效可能会有以下几种原因。 1. 索引列是表示式的一部分,或是函数的一部分如下SQL:SELECT book_id FROM BOOK WHERE book_id +1 = 5;或者:SELECT book_id FROM BOOK WHERE TO_DAYS(CURRENT_DATE) - TO_DAYS(gmt_create) <= 10上述两个 SQL 虽然在列 book_...

weixin_35266799的博客 2167

Android 13.0 开机启动优化之PMS扫描apk耗时相关功能优化

在android13.0的系统rom定制化开发中,在系统中开发产品时,会根据客户要求内置第三方app,这时如果内置app过多,或者安装的app过多,在系统开机的过程中 在pms扫描安装app的时候,就会比较耗时,这时候就需要优化下pms扫描安装app这块的功能代码,用多线程来实现pms扫描安装app,来加快开机时间,接下来 来实现这个功能

安卓兼职framework和app工程师的博客 1335

【Unity URP渲染管线下Shader的自定义物体半透明和投影半透明效果_半透明案例分享】

Unity Shader Graph URP渲染管线下的自定义半透明效果_半透明案例分享

暴走约伯的博客 3295
上一篇: MySQL innodb是如何存数据的?
下一篇: ElasticSearch 索引设计指南
JavaShark
博客等级 码龄4年 184粉丝 438原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值