


📝 摘要
Rust 以其“零成本抽象”和与 C/C++ 相媲美的性能而著称。然而,仅仅使用 Rust 并不总能自动获得最佳性能。本文将深入探讨 Rust 的性能分析工具、常见的性能陷阱、内存布局优化以及高级并发模式,通过实战案例和最佳实践,帮助你编写出真正极致性能的 Rust 代码。
一、性能分析工具链
1.1 基准测试(Benchmarking)
1. cargo bench (Criterion.rs)
# Cargo.toml
[dev-dependencies]
criterion = { version = "0.5", features = ["html_reports"] }

[[bench]]
name = "my_benchmark"
harness = false
// benches/my_benchmark.rs
use criterion::{black_box, criterion_group, criterion_main, Criterion};

fn fibonacci(n: u64) -> u64 {
    match n {
        0 => 0,
        1 => 1,
        _ => fibonacci(n - 1) + fibonacci(n - 2),
    }
}

// 慢速实现
fn fib_slow(n: u64) -> u64 {
    fibonacci(n)
}

// 快速实现(迭代)
fn fib_fast(n: u64) -> u64 {
    let mut a = 0;
    let mut b = 1;
    for _ in 0..n {
        let temp = a;
        a = b;
        b += temp;
    }
    a
}

fn benchmark(c: &mut Criterion) {
    let mut group = c.benchmark_group("Fibonacci");

    group.bench_function("Recursive (n=20)", |b| {
        b.iter(|| fib_slow(black_box(20)))
    });

    group.bench_function("Iterative (n=20)", |b| {
        b.iter(|| fib_fast(black_box(20)))
    });

    group.finish();
}

criterion_group!(benches, benchmark);
criterion_main!(benches);
运行与分析:
cargo bench
# ...
# Iterative (n=20)      time: [11.332 ns 11.365 ns 11.401 ns]

# 生成 HTML 报告
# open target/criterion/Fibonacci/report/erion.rs HTML report showing a graph comparing fib\_slow and fib\_fast performance]

> 图表说明:Criterion 生成的 HTML 报告直观地显示了 `fib_fast` (迭代) 相比 `fib_slow` (递归) 的巨大性能优势。

#### 1.2 性能剖析(Profiling)

**1. `perf` (Linux)**

```bash
# 1. 安装调试符号
# (Cargo.toml)
# [profile.release]
# debug = true

# 2. 编译
cargo build --release

# 3. 运行 perf
perf record -g ./target/release/my_app

# 4. 生成报告
perf report
2. flamegraph
cargo install flamegraph
cargo flamegraph -- ./target/release/my_app
[Image of a Flamegraph (火焰图)]
火焰图说明:火焰图的可视化结果。X 轴代表 CPU 时间,Y 轴代表调用栈。平顶(Plateaus)的函数是性能瓶颈,应优先优化。
1.3 `cargoasm`
查看生成的汇编代码:
cargo install cargo-asm
cargo asm --rust --lib my_crate::my_function
二、常见的性能陷阱与优化
2.1 字符串操作
陷阱:过度分配(Over-allocation)和不必要的 clone()
// ❌ 低效:每次循环都重新分配
fn slow_string_concat(words: &[&str]) -> String {
    let mut result = String::new();
    for word in words {
        result += word; // 内部调用 push_str
        result += " ";
    }
    result
}

// ✓ 高效:预分配容量
fn fast_string_concat(words: &[&str]) -> String {
    let total_len: usize = words.iter().map(|s| s.len() + 1).sum();
    let mut result = String::with_capacity(total_len);

    for word in words {
        result.push_str(word);
        result.push(' ');
    }
    result
}

// ✓ 更优:使用 join
fn idiomatic_string_concat(words: &[&str]) -> String {
    words.join(" ")
}
2.2 循环与迭代器
陷阱:使用索引访问 Vec
// ❌ 较慢:每次索引都会进行边界检查
fn sum_index(vec: &Vec<i32>) -> i32 {
    let mut sum = 0;
    for i in 0..vec.len() {
        sum += vec[i]; // 边界检查
    }
    sum
}

// ✓ 高效:迭代器无边界检查
fn sum_iter(vec: &Vec<i32>) -> i32 {
    vec.iter().sum()
}

// 编译器优化:
// 在 --release 模式下,LLVM 优化器通常能消除 `sum_index` 的边界检查,
// 但依赖迭代器是更稳妥和惯用的方式。
2.3 错误处理
**陷阱:在循环中创建复杂的错误对象
use thiserror::Error;

#[derive(Error, Debug)]
enum MyError {
    #[error("值 {0} 无效")]
    InvalidValue(i32),
}

// ❌ 较慢:在循环内部格式化字符串
fn process_slow(data: &[i32]) -> Result<(), MyError> {
    for &val in data {
        if val < 0 {
            return Err(MyError::InvalidValue(val)); // 每次都格式化
        }
    }
    Ok(())
}

// ✓ 优化:延迟错误创建
#[derive(Debug)]
struct InvalidValueError(i32);

fn process_fast(data: &[i32]) -> Result<(), InvalidValueError> {
    for &val in data {
        if val < 0 {
            return Err(InvalidValueError(val)); // 仅返回轻量级结构体
        }
    }
    Ok(())
}
2.4 克隆(Cloning)
陷阱:在循环中不必要地克隆(clone())
// ❌ 慢:每次迭代都克隆 String
fn process_strings_slow(strings: &Vec<String>) {
    for s in strings {
        let s_clone = s.clone();
        // ...
    }
}

// ✓ 快:使用引用
fn process_strings_fast(strings: &Vec<String>) {
    for s in strings {
        // ... (使用 &s)
    }
}

// ✓ 技巧:使用 Cow (写时复制)
use std::borrow::Cow;

fn process_cow(s: &str) -> Cow<str> {
    if s.contains(' ') {
        Cow::Owned(s.replace(' ', "_")) // 发生分配
    } else {
        Cow::Borrowed(s) // 零分配
    }
}
三、内存布局优化
3.1 数据结构的选择
| 场景 | 推荐 | 不推荐 | 原因 |
|---|---|---|---|
| 连续序列 | Vec<T> | LinkedList | CPU 缓存友好 |
| 键值查找 | HashMap | `Vec<(K, V` | O(1) vs O(n) |
| 静态键值 | phf | HashMap | 完美哈希,无分配 |
| 字符串 | String | &str (如需修改) | 拥有所有权 |
| 小字符串 | SmolStr, smartstring | String | 避免堆分配 |
// ❌ 缓存不友好 (LinkedList)
// [ptr] -> [data, ptr] -> [data, ptr]

// ✓ 缓存友好 (Vec)
// [data, data, data, data, data]
3.2 结构体字段重排
// ❌ 未优化 (16 字节)
struct BadLayout {
    a: u8,   // 1 字节
    // 3 字节填充 (padding)
    b: u32,  // 4 字节
    c: u16,  // 2 字节
    // 2 字节填充
    d:d: u32,  // 4 字节
}
// 总大小:1 + 3 + 4 + 2 + 2 + 4 =6 字节

// ✓ 优化 (12 字节)
struct GoodLayout {
    b: u32,  // 4 字节
    d: u32,  // 4 字节
    c: u16,  // 2 字节
    a: u8,   // 1 字节
    // 1 字节填充
}
// 总大小:4 + 4 + 2 + 1 + 1 = 12 字节
技巧:通常按对齐方式从大到小排列字段。
3. 零拷贝(Zero-Copy)
// ❌ 拷贝:反序列化时创建 String
use serde::Deserialize;

#[derive(Deserialize)]
struct ConfigOwned {
    api_key: String,
    endpoint: String,
}

// ✓ 零拷贝:借用原始数据
#[derive(Deserialize)]
struct ConfigBorrowed<'a> {
    #[serde(borrow)]
    api_key: &'a str,
    #[serde(borrow)]
    endpoint: &'a str,
}

fn main() {
    let data = r#"{"api_key": "12345", "endpoint": "https://api.example.com"}"#;

    // ConfigBorrowed 避免了为字符串分配新内存
    let config: ConfigBorrowed = serde_json::from_str(data).unwrap();
}
}
四、高级并发与并行
4.1 std::thread vs Rayon
// 场景 Vec 中的每个元素执行密集计算
fn heavy_computation(n: &mut i32) {
    *n = (*n as u64).pow(3) as i32;
}

// 1. 单线程
fn single_thread(data: &mut Vec<i32>) {
    data.iter_mut().for_each(heavy_computation);
}

// 2. Rayon (数据并行)
use rayon::prelude::*;

fn rayon_parallel(data: &mut Vec<i32>) {
    data.par_iter_mut().for_each(heavy_computation);
}

// 3. 手动线程池 (Tokio)
async fn tokio_parallel(data: &mut Vec<i32>) {
    let mut handles = Vec::new();
    for chunk in data.chunks_mut(1000) {
        handles.push(tokio::task::spawn_blocking(move || {
            chunk.iter_mut().for_each(heavy_computation);
        }));
    }
    for handle in handles {
        handle.await.unwrap();
    }
}
选择指南:
- Rayon:CPU 密集型任务(如数据处理、科学计算)的首选。
- **Tokio:I/O 密集型任务(如 Web 服务器、数据库访问)的首选。
spawn_blocking:在 Tokio 运行时中执行 CPU 密集型任务。
4.2 锁的性能
陷阱:过度使用 Arc<Mutex<T>>
use std::sync::{Arc, Mutex, RwLock};

// ❌ 慢:即使是读取也需要独占锁
fn read_mutex(data: &Arc<Mutex<Vec<i32>>>) {
    let _data = data.lock().unwrap();
    // 独占访问,其他读写均被阻塞
}

// ✓ 快:允许多个读取者
fn read_rwlock(data: &Arc<RwLock<Vec<i32>>>) {
    let _data = data.read().unwrap();
    // 共享访问,其他读取者可以进入
}

// ✓ 更快:使用无锁数据结构 (e.g., crossbeam, flume)
use crossbeam_channel::unbounded;

fn channel_communication() {
    let (s, r) = unbounded();

    std::thread::spawn(move || {
        s.send("Hello").unwrap();
    });

    r.recv().unwrap();
}
五、编译时优化
5.1 Cargo 配置(Profile)
# Cargo.toml

[profile.release]
opt-level = 3       # 优化级别 (0-3, s, z)
lto = "fat"         # 链接时优化 (Link-Time Optimization)
codegen-units = 1   # 减少并行编译单元,增加优化机会 (编译更慢)
panic = "abort"     # 遇到 panic 直接终止 (二进制更小)
strip = true        # 去除调试符号 (二进制更小)
LTO (Link-Time Optimization):
LTO 允许编译器在链接阶段跨多个 crate 进行优化。
- `lo = “fat”`:完全 LTO,优化最好,编译最慢。
lto = "thin":增量 LTO,平衡编译速度和性能。
5.2 CPU 特定指令(SIMD)
// 启用 AVX2 指令集
#[cfg(target_arch = "x86_64")]
#[target_feature(enable = "avx2")]
unsafe fn sum_avx2(aa: &[f32], b: &[f32], c: &mut [f32]) {
    use std::arch::x86_4::*;

    for i in (0..a.len()).step_by(8) {
        let va = _mm256_loadu_ps(&a[i]);
        let vb = _mm256_loadu_ps(&b[i]);
        let vc = _mm256_add_ps(va, vb);
        _mm256_storeu_ps(&mut c[i], vc);
    }
}

// ✓ 更安全:使用 auto-vectorization 或 packed_simd
// 编译器通常会自动向量化简单的循环
fn sum_auto_vectorized(a: &[f32], b: &[f32]) -> Vec<f32> {
    a.iter().zip(b.iter()).map(|(x, y)| x + y).collect()
}
六、性能优化清单
6.1 检查列表
- [ ] 分析先行:不要猜测猜测!使用
criterion和flamegraph定位瓶颈。 - [ ]
release模式:始终在cargo run --release或cargo build --release` 下测试性能。 - [ ] 避免克隆:检查循环中的
.clone(),优先使用引用。 - [ ] 预分配:使用
String::with_capacity和 `Vec::withcapacity`。 - [ ] 迭代器:优先使用迭代器(
iter(),map(), `filter())而非索引。 - [ ] 数据结构:使用
HashMap而非Vec进行查找;使用Vec而非 `LinkedList 进行迭代。 - [ ] 字符串:使用
join()或push_str(),而非+或 `format` 拼接。 - [ ] 并发:对 CPU 密集型任务使用
rayon。 - [ ]锁:对“读多写少”场景使用
RwLock替代Mutex。 - [ ] 零拷贝在反序列化时使用
&'a str和Cow。
七、总结与讨论
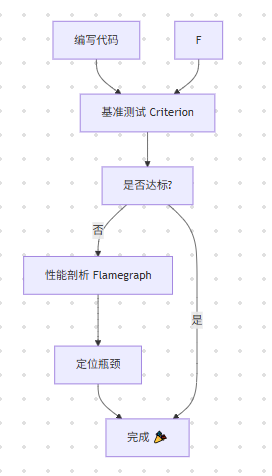
Rust 提供了编写极致性能代码所需的所有工具,但性能优化是一个“测量-分析-优化”的循环过程。
✅ 零成本抽象:泛型、Trait、迭代器编译后无运行时开销。
✅ 精细控制:内存布局、unsafe、FFI 提供了底层控制力。
✅ 强大工具:criterion、flamegraph、miri 提供了完整的分析链。
流程:
讨论问题:
- 在你的 Rust 项目中,最大的性能瓶颈通常出现在哪里?
rayon和tokio在你的项目中是如何共存的?- 你是否曾通过优化内存布局(如字段重排)获得显著的性能提升?
欢迎分享你的优化经验!💬
参考链接
- Rust Performance Book:[https://nnethercote.github.io/perf-book/](https://nnethercote.ttps://criterion.rs](https://criterion.rs)
3 Rayon (数据并行):https://docs.rs/rayon/ - Cargo Profiles:[https://dochttps://doc.rust-lang.org/cargo/reference/profiles.html
 7万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


