爬虫万能模板之XPath_没有爬不到的数据只有想不到的网站_一蓑烟雨任平生

python爬虫之xpath详解(附加实战代码) xpath解析 最常用切最便捷高效的一种方式 xpath解析原理: 实例化一个etree的对象,且需要将被解析的页面源码数据加载到该对象中 调用etree对象中的xpath方法结合xpath表达式实现标签的定位和内容的捕获 环境安装 pip install lxml 如何实例化一个etree对象 导包:from lxml import etree 将本地的HTML文档中的数据加载到该对象中: etree.parse(filePath,etree.HTMLParser()) 解析本地本件第二 阅读详情

前言

先上代码,带引包就24行代码,简单易懂,适合小白


一、上模板代码

import requests
from lxml import etree
import time

if __name__ == '__main__':
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.183 Safari/537.36'
    }
    url = 'https://www.baidu.com'
    # while 1:
    r = requests.get(url=url,headers=headers).text
    e = etree.HTML(r)
    div_list = e.xpath('//*[@id="articleMeList-blog"]/div[2]/div')
    href_list = []
    for div in div_list:
        href = div.xpath('./h4/a/@href')[0]
        href_list.append(href)
    while 1:
        for i in range(len(href_list)):
            visit = href_list[i]
            page = requests.get(url=visit,headers=headers).text

            tree = etree.HTML(page)
            count = tree.xpath('//span[@class="read-count"]/text()')[0]
            print(count)
        time.sleep(5)

二、讲解

1.找到需要的网址

然后用request.get访问,然后获取值

url = 'https://www.baidu.com'
    # while 1:
    r = requests.get(url=url,headers=headers).text

啥都别问,盘它就对了

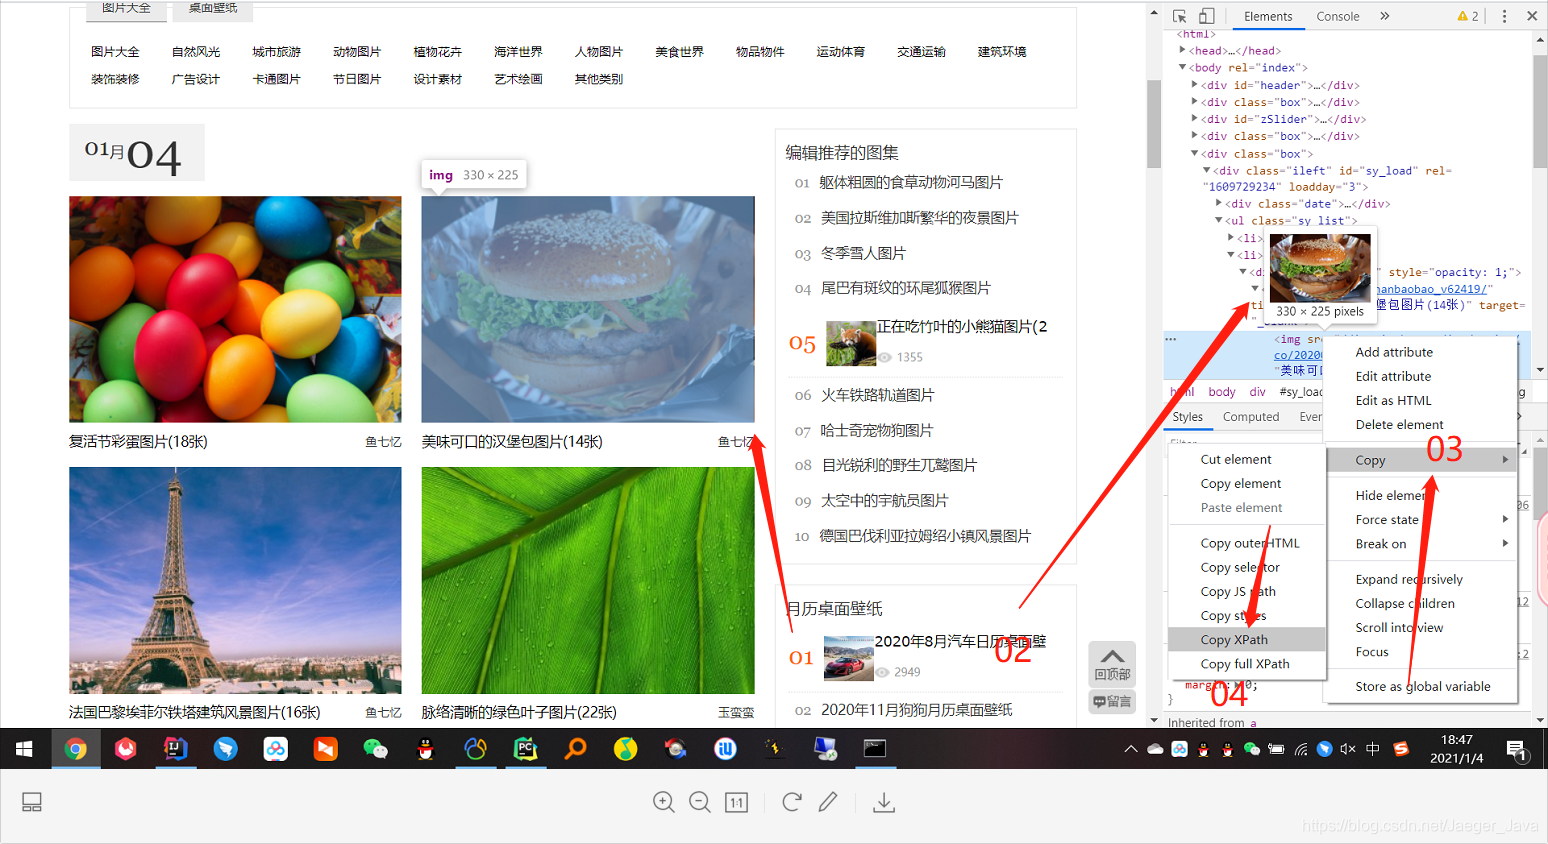
2.找到Xpath的值

怎么找?

F12→鼠标右键→获取Xpath
在这里插入图片描述
看不懂?那就别往下看了

3.替换Xpath

 div_list = e.xpath('//*[@id="articleMeList-blog"]/div[2]/div')

4.组装

href_list = []
    for div in div_list:
        href = div.xpath('./h4/a/@href')[0]
        href_list.append(href)

5.运行


总结

说白了,利用XPath爬数据跟bs4的find_all差不多,都是先定位到地方,找到集合,然后一行一行怼就完了
在这里插入图片描述

jsp中div遍历list集合 今天拿到一个新的需求实现,页面右边有两个tab,其中一个为今日报警,点击该tab连接一个页面,页面显示今日报警的最新两条记录。     之前的查询都是分页返回ListData,然后查询数据显示在表格,然后在xml中配置URL,即action中该查询方法所打的标签。         我还天真的以为jsp中也可以承接一个action返回的URL,不过一直显示不出来数据,后来发现自己 阅读详情

相关推荐

python爬虫学习(十五)xpath模板下载

# -*- coding: utf-8 -*- import requests from lxml import etree import os if __name__ == '__main__': headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KH...

haimian_baba的博客 349

charles抓包工具使用:自动循环重复发送请求、修改重发请求

无意之中发现一个测试神器,有几个点对测试人员大有帮助,尤其是对于构造大量或者特定测试数据的情况,能够节约很多时间,常用的几点记录一下,以备后续使用。 一、重发请求,请求内容不变发多次 二、对请求内容修改并重发 三、修改返回的请求内容 设置断点,然后在页面上刷新,在返回接口中修改后再执行 ...

测试人的成长日志 7904

XPath的22个示例

其它网站转的,方便大家学习          

python 爬虫 可以反复运行的一段代码 创作者利器

#!/usr/bin/env python # -*- coding: utf-8 -*- # @Time : 2020/12/2 10:16 # @Author : huni # @File : csdn阅读量.py # @Software: PyCharm import requests from lxml import etree import time if __name__ == '__main__': headers = { 'User-Agent':

乎你的博客 30万+

xpath表达式基本格式

xpath表达式的基本格式,应用实例等等

AutoSAR RTE调度机制揭秘:从定时器事件到Runnable执行的完整流程

本文深入解析了AutoSAR RTE(运行时环境)的核心调度机制,详细阐述了从定时器事件触发到Runnable(可运行实体)执行的完整流程。通过剖析Rte_Start()函数、OS任务与警报的交互,以及事件驱动循环,揭示了RTE如何作为幕后指挥家,高效、可靠地协调软件组件间的周期性任务执行,是打通AutoSAR应用开发的关键。

weixin_29169899的博客 226

爬虫 使用selenium和Xpath的模板---(模板篇)

【代码】爬虫 使用selenium和Xpath的模板---(模板篇)

qq_58369347的博客 273

INCA基础教程

以软件自带Demo为例记录INCA学习过程,主要内容包括测量与标定。

yunqianrui的博客 6万+

爬虫基础-xpath模块

xpath介绍: xpath 是在XML文档中搜索内容的一门语言 html是XML的一个子集 导入模块:from lxml import etree 生成xpath解析对象:xxx = etree.HTML(需要解析的对象) 获取层级关系节点:xxx.xpath("") 获取节点内的内容:在结尾加上 /text() xpath检索: 选取此节点的所有子节点:nodename 表示一个层级,从根节点开始定位:/ 表示多个层级,从任意位置开始定位:// 通配符,选择所有元素节点与元素名:* 选取当前

下一个路口,又会是怎样的结果 1301

CZT与FFT频谱分析方法对比:从任意频带重采样到高精度频谱分析

M = 85 % 输出点数f0 = 70 Hz % 起始频率DELF = 0.4 Hz % 频率步长频率分辨率提高到0.4 Hz分析带宽聚焦在[70, 103.6]Hz更清晰地分辨出78Hz和82Hz的频率分量。

2403_88098319的博客 1859

PDMS二次开发入门:手把手教你用PML2写第一个交互式窗体工具

本文详细介绍了如何使用PML2进行AVEVA PDMS二次开发,从零开始构建交互式窗体工具。通过PML2语言的面向对象特性、即时调试能力和深度系统集成优势,开发者可以高效创建自动化设计工具、批量修改属性和定制报表系统。文章包含开发环境配置、基础语法、窗体架构设计、事件处理等实战内容,帮助读者快速掌握PDMS二次开发技能。

weixin_29281941的博客 271

python爬虫定位元素_python爬虫之定位网页元素的三种方式

python爬虫之定位网页元素的三种方式2018年08月02日 13:30:02Barry__阅读数:1373标签:python更多css我的分类:pythonhtml版权声明:本文为博主原创文章,转载请注明出处 https://blog.youkuaiyun.com/rankun1/article/details/81357179python在作爬虫的过程当中,网页元素的定位是比较重要的一环,本...

weixin_27374911的博客 1993

谷歌账号国家或地区设置修改全攻略:条件、流程与避坑指南

谷歌账号的国家或地区设置与付款资料、账号历史行为及登录环境强绑定,修改时需满足特定条件。其原理在于地区作为索引键,关联内容库、货币结算和风控策略。正确切换可解决内容推荐错乱、付款失败等问题,适用于搬家、订阅区域限定服务等场景。操作前需在目标地区创建付款资料、清空余额并取消订阅,且一年仅能修改一次。本文详解从准备到验证的完整流程,并揭示官方文档未提及的实操陷阱,助你安全完成地区切换。

weixin_42521558的博客 2239

CSS div 定义的list

http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd"> http://www.w3.org/1999/xhtml"> float test 2 Demo .container{  width:500px;  height:auto;  background:yellow;    /*firefox chro

kady_love的专栏 619

OTFS从零开始11 10

未来的无线网络有望提供全球覆盖,因此需要支持在恶劣环境下的各种新兴应用,例如飞机上的移动通信(MCA)、低地球轨道(LEO)卫星通信、车对车(V2V)通信、高速铁路(HSR)通信、无人驾驶飞机(UAV)通信和水下声学通信(UAC)。在这些恶劣环境中的无线信道通常被视为对通信不友好,其特点是严重的延迟和多普勒扩散,以及有限的路径寿命等。这些不利于通信的特性使目前移动网络中广泛采用的正交频分复用(OFDM)调制的性能恶化。

qq_46009045的博客 9848

Trae IDE项目开发全流程深度技巧与最佳实践

2026年AI开发新范式:Trae AI IDE深度解析 摘要 2026年,AI已成为软件开发的核心驱动力。字节跳动推出的AI原生IDE——Trae,从根本上重塑了开发体验,将AI作为第一公民而非附加功能。Trae通过深度集成大型语言模型和创新交互模式,解决了现代开发中的重复劳动、信息过载等核心痛点。 报告全面剖析了Trae的核心功能: 智能代码生成:支持上下文感知续写、自然语言驱动生成和多模态输入转换 对话式AI助手:提供侧边栏和行内对话模式,支持代码解释、Bug修复、重构建议等 Builder/SOLO

公众号:AI前沿侦探 159

DIV标签中列表的获取方法

    昨天把JavaEye的头条获取过来,思路是这样的:通过id获取div的源代码通过正则表达式获取列表,以实现配置的通用性,只需改变正则表达式就可以获取不同的数据通过正则表达式的分组获取头条的标题、title、链接    javaEye头条的源代码如下:    焦点新闻 更多Dropbox 用户达到2百万:优秀的免费文 ... 超酷的JavaScript

hdhhb的专栏 2251

Codex 100个真实案例 - 用AI做在线考试系统(自动组卷+防作弊)

本案例使用 Codex 从零搭建一个功能完整的在线考试系统。涵盖题库管理(单选/多选/判断/填空)、智能随机组卷、考试倒计时、自动判分、成绩统计分析、以及多维度防作弊机制(切屏检测、禁止复制粘贴、IP限制等)。前端使用 Vue 3 + Element Plus 构建考试界面,后端使用 Node.js + Express + MySQL 提供 API 服务。全程用自然语言驱动 Codex 完成开发,最终交付一个可直接部署的在线考试平台。

yueyeguzhuo的专栏 77

循环div加后台获取的list集合数据整合

var baseRequestUrl = 'http://localhost:8888'; $(function () { $.ajax({ type: "post", url: baseRequestUrl + "/admin/receptionInfo/websitePositionList", ...

weixin_42707543的博客 1437

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

python如何重复执行代码

在编程中,有时候需要重复执行某个特定的代码段,这就需要使用循环结构。Python提供了多种循环结构,可以满足不同的需求。本文将从多个角度分析Python如何重复执行代码。

2201_75362610的博客 1万+

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

XPATH使用

1. XPath概览 XPath 的选择功能十分强大,它提供了非常简洁明了的路径选择表达式,另外它还提供了超过 100 个内建函数用于字符串、数值、时间的匹配以及节点、序列的处理等等,几乎所有我们想要定位的节点都可以用XPath来选择。 XPath 于 1999 年 11 月 16 日 成为 W3C 标准,它被设计为供 XSLT、XPointer 以及其他 XML 解析软件使用,更多...

diandinai8712的博客 805

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

五分钟学会使用XPath

XPath 是什么? XPath (XML Path Language) 是一门在 XML 文档中查找信息的语言,可用来在 XML 文档中对元素和属性进行遍历。 先介绍工具 Chrome插件:XPath Helper Firefox插件:XPath Checker 开源的XPath表达式编辑工具:XMLQuire 这些工具可以方便再浏览器中测试我们写的 XPath ,看看所...

Dolphin's Blog 576

xpath格式转换

from lxml import etree #定义一个字符串 HTML text = “”" first item second item third item fourth item fifth item """ print(text) #初始化一个xpath一个解析对象,返回的是lxml...

小生不才 4683

使用xpath解析站长素材_免费简历模板

关于使用什么模块写爬虫做数据解析,并没有刻板的规定,鉴于正在学习仍使用xpath 分析站长素材网的免费简历模板,需求分析不再赘述,且看编码过程 #!/usr/bin/env python # encoding: utf-8 """ @file: 解析站长素材_免费简历模板.py @time: 2020/2/29 14:30 """ import requests from lxml impor...

视觉软件 726

用xpath获取html源码

from lxml import html import requests url = 'http://navi.cnki.net/knavi/JournalDetail/GetArticleList?year=2018&issue=04&pykm=DZXU&pageIdx=0&pcode=CJFD' res = requests.get(url) tree = ...

繁星、晚风 2671

Python爬虫_宅男福利?妹纸勿点__一蓑烟雨任平生

咳咳直接上代码 #!/usr/bin/env python # -*- coding: utf-8 -*- # @Time : 2020/12/15 19:10 # @Author : huni # @File : 图库大全1000.py # @Software: PyCharm import requests from lxml import etree import os if __name__ == '__main__': headers = { 'User-A

Jaeger_Java的博客 1万+
上一篇: Python爬虫_宅男福利?妹纸勿点__一蓑烟雨任平生
下一篇: Python抖音去水印_一步到位_一蓑烟雨任平生
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

