从轮询到等待——PostgreSQL WAIT FOR LSN 特性深度解析

PostgreSQL在Web应用中的深度实践:Schema管理、密码安全与复制调度 Web应用的稳定性与可扩展性,高度依赖数据库层的工程化能力。PostgreSQL作为成熟的关系型数据库,不仅支持标准SQL操作,更通过可演进的Schema管理机制、内置安全模型(如pg_shadow/pg_authid)和灵活的Replication架构,为Web Applications提供从数据定义、敏感信息防护到读写流量治理的全栈支撑。其技术价值在于将数据库从‘存储后端’升维为‘业务协作者’——例如Alembic实现版本化迁移保障发布可靠性,基于角色与函数的密码验证构建纵深防御,而事务感知的主从路由则 阅读详情

本文整理于 HOW 2026 演讲内容,演讲者:周煦能,数据系统工程师,专注 PostgreSQL 内核开发、性能优化与核心子系统补丁迭代,拥有大量生产级内核优化经验。

前言

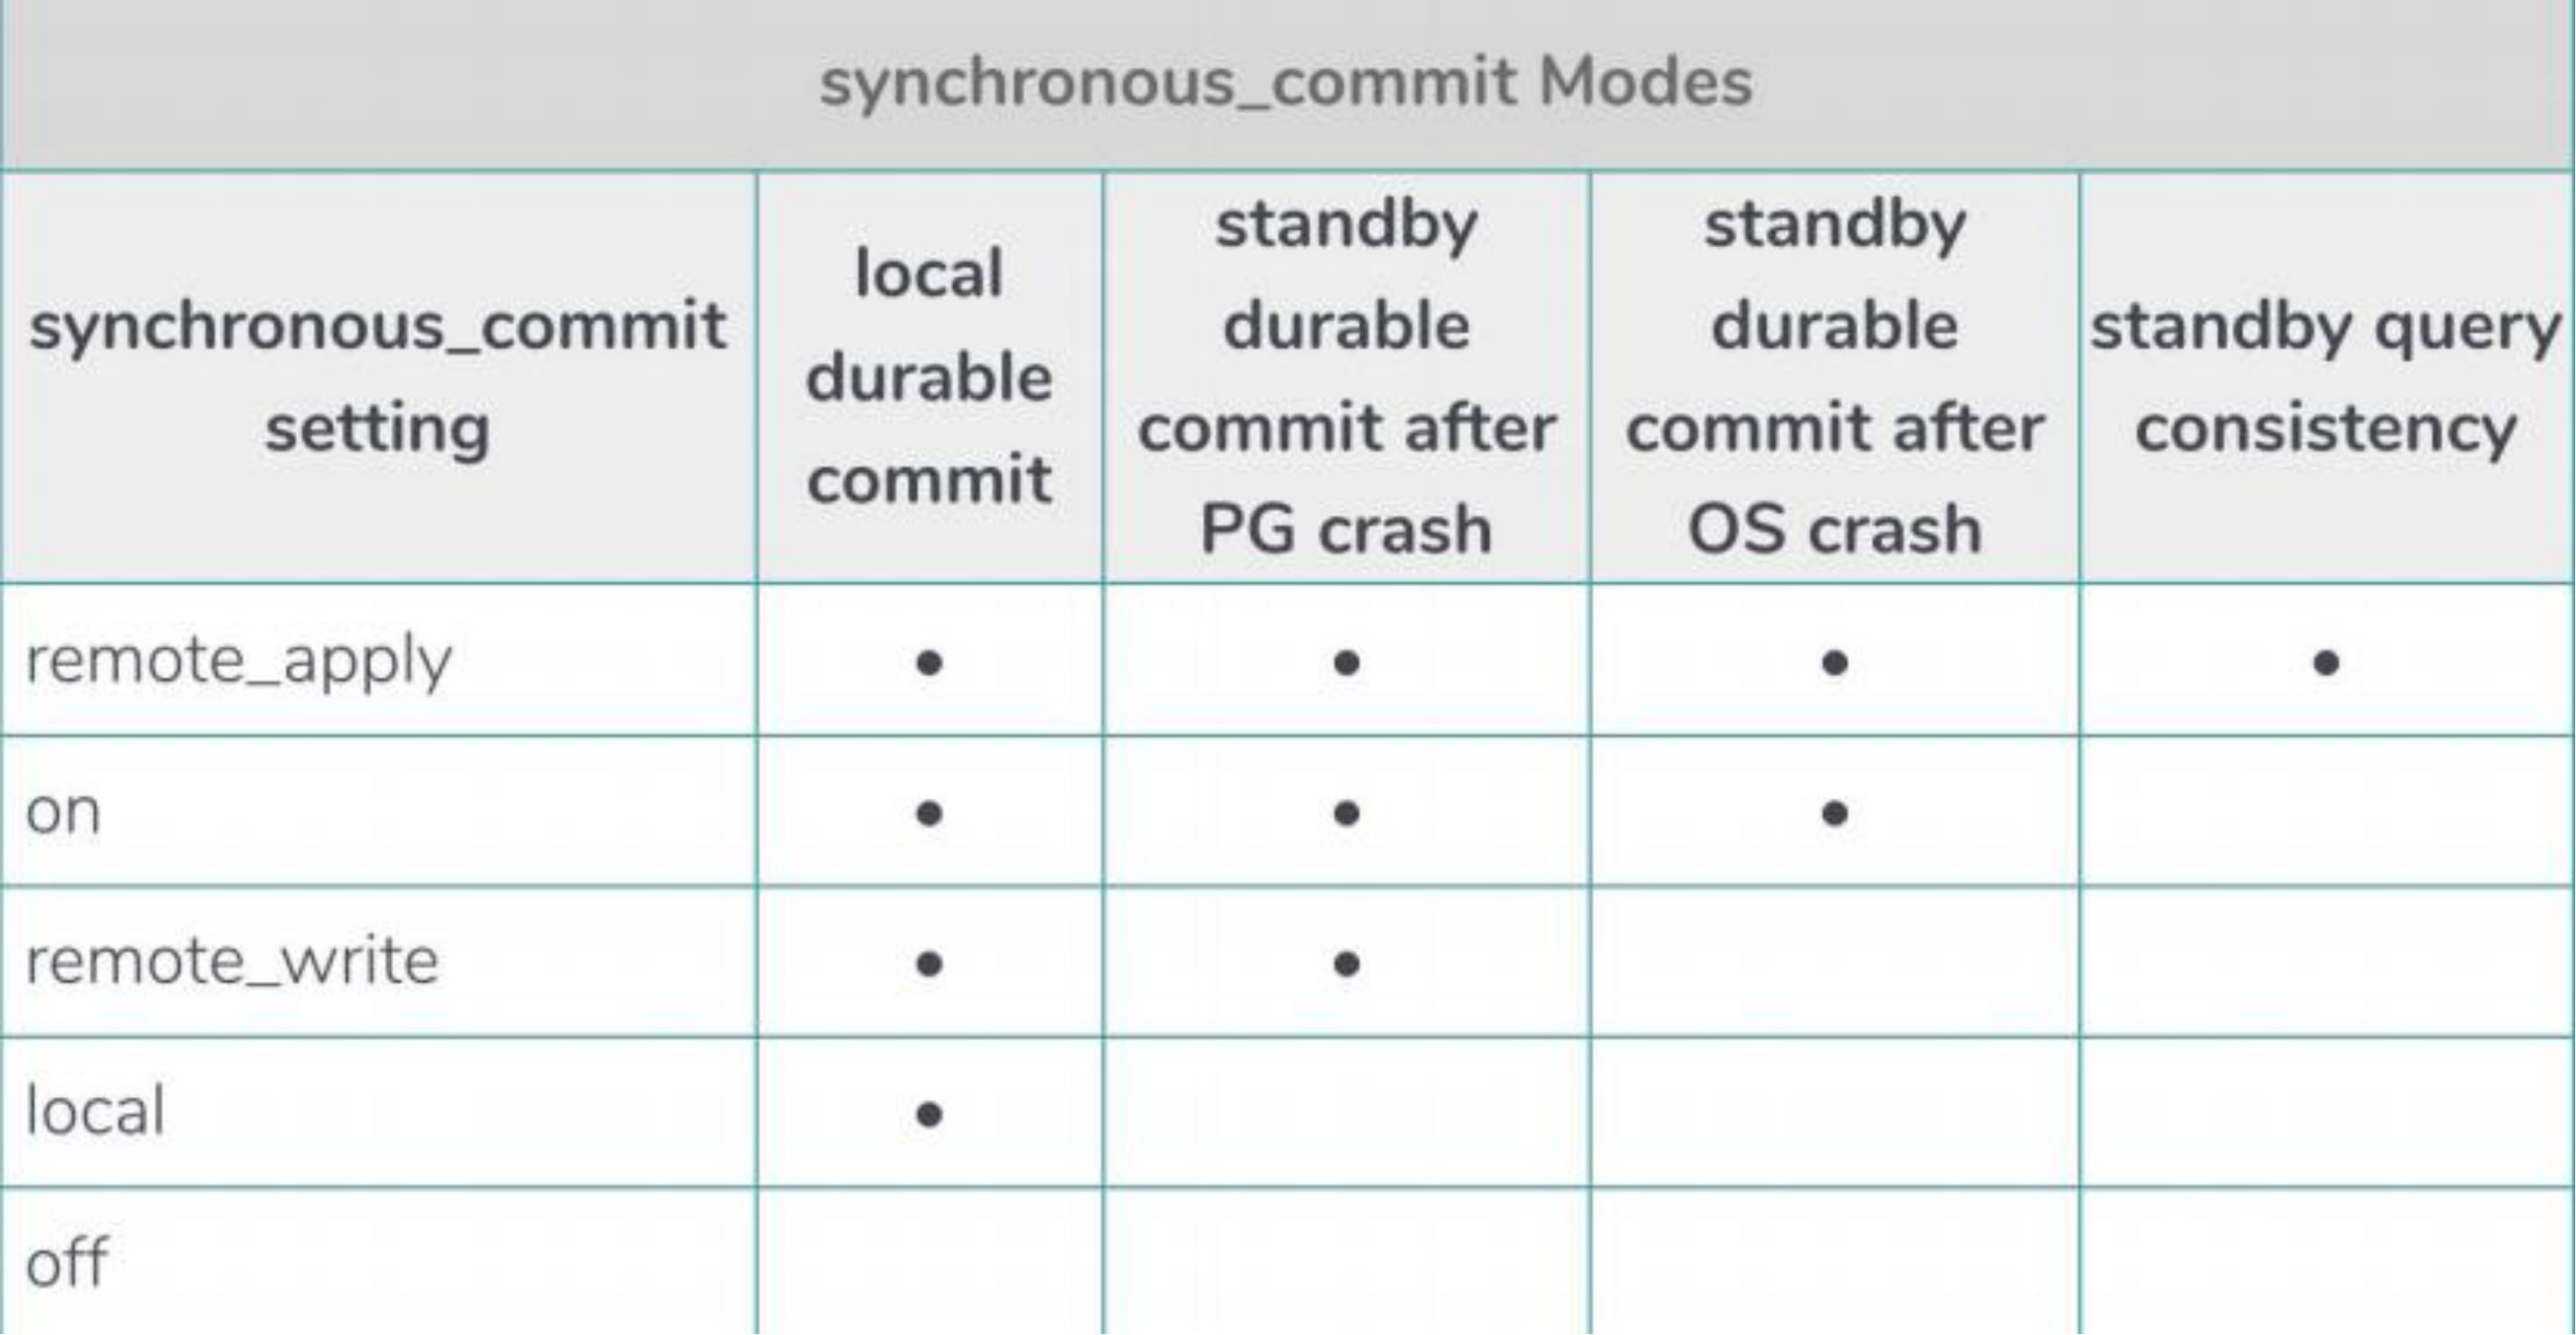
在异步复制的 PostgreSQL 集群中,读写一致性是一个长期存在的痛点。主库写入成功后,备库可能还未完成 WAL 的重放,此时在备库上查询,可能查不到刚刚写入的数据。为了解决这个问题,社区此前普遍采用的方案是轮询(Polling) :在备库上不断查询pg_last_wal_replay_lsn(),直到其追上主库的目标 LSN。

然而,轮询方案存在明显的效率问题:反复查询带来了大量的 CPU 消耗、缓存污染和上下文切换。在 PG 19 中,社区引入了一个全新的特性——WAIT FOR LSN,通过事件驱动的等待机制,彻底替代了低效的轮询。

本文基于 HOW 2026 开源生态大会暨 PostgreSQL 高峰论坛的主题分享,系统解析 WAIT FOR LSN 特性的设计背景、实现原理与接口设计。

一、异步场景下的读写一致性挑战

1.1 同步复制 vs 异步复制

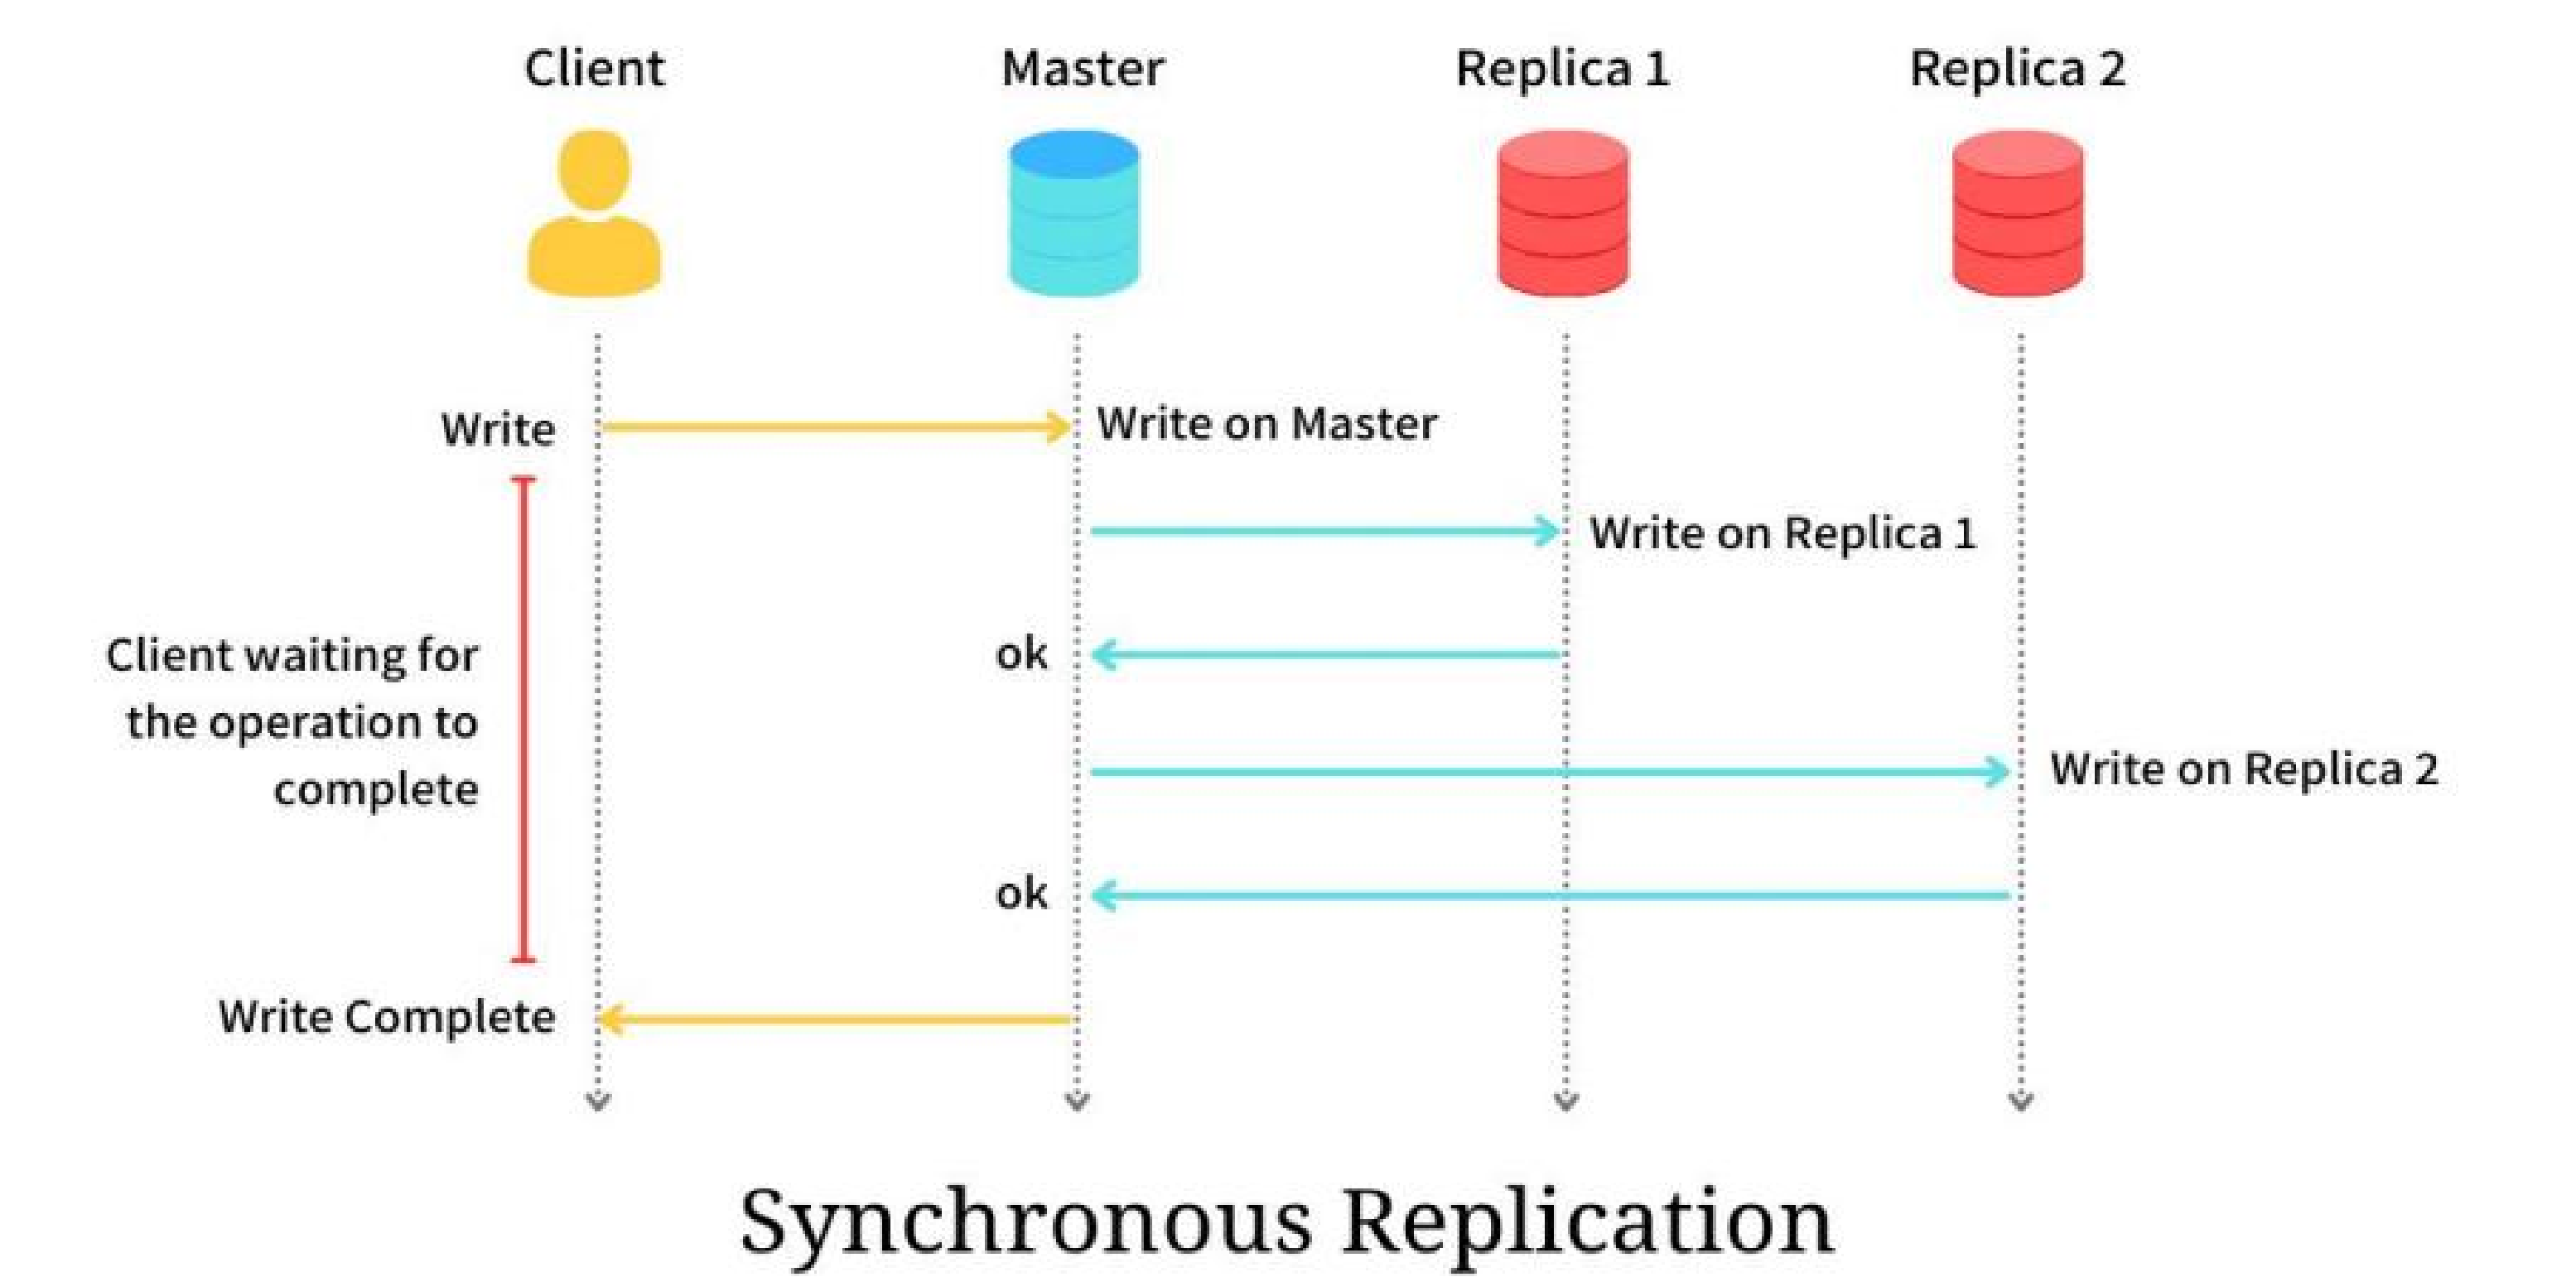
在同步复制模式下,客户端发起写请求后,主库在本地完成写入,并将变更同步复制到所有同步备库。只有在主库和所有同步备库均确认写入成功后,主库才向客户端返回成功。因此,客户端在备库上查询时,能够确保数据已同步。
1.png

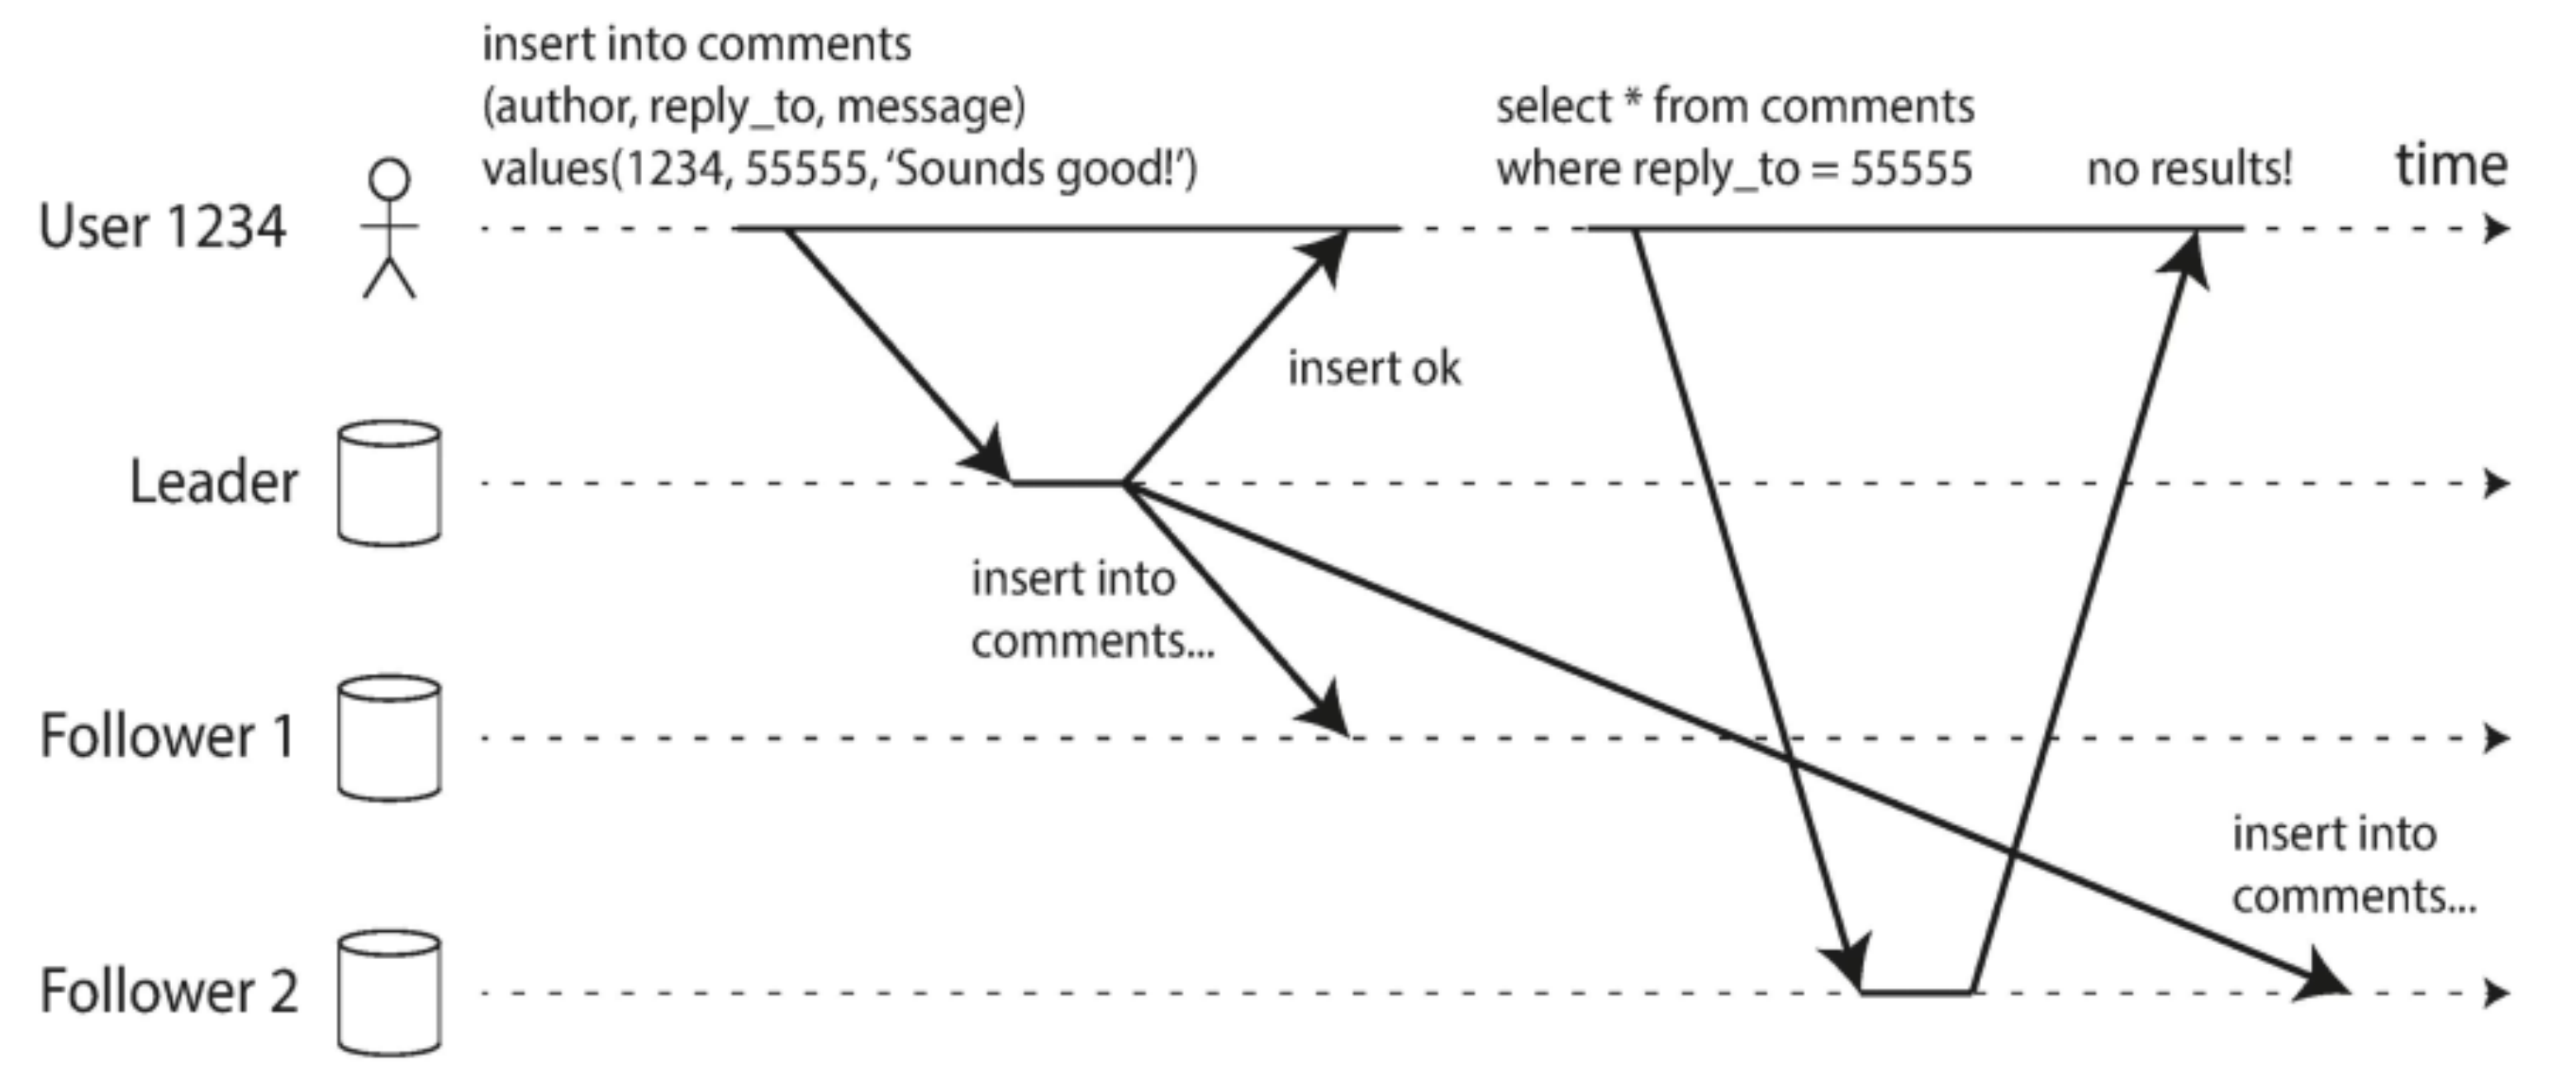
而在异步复制模式下,情况则完全不同:

  1. 客户端向主库发起写入请求
  2. 主库本地 WAL 持久化后,立即向客户端返回成功(无论备库是否已接收到 WAL)
  3. WAL 通过 walsender 异步发送给备库的 walreceiver
  4. 备库接收并重放 WAL——此过程存在延迟(replication lag)
  5. 客户端立即在备库上查询——可能查不到刚刚写入的数据

一致性问题的根本原因在于:主库提交与备库回放是解耦的。主库的提交操作与 walsender 发送 WAL、备库接收和回放 WAL 之间,没有任何同步保证。
2.png

1.2 一致性问题的典型场景

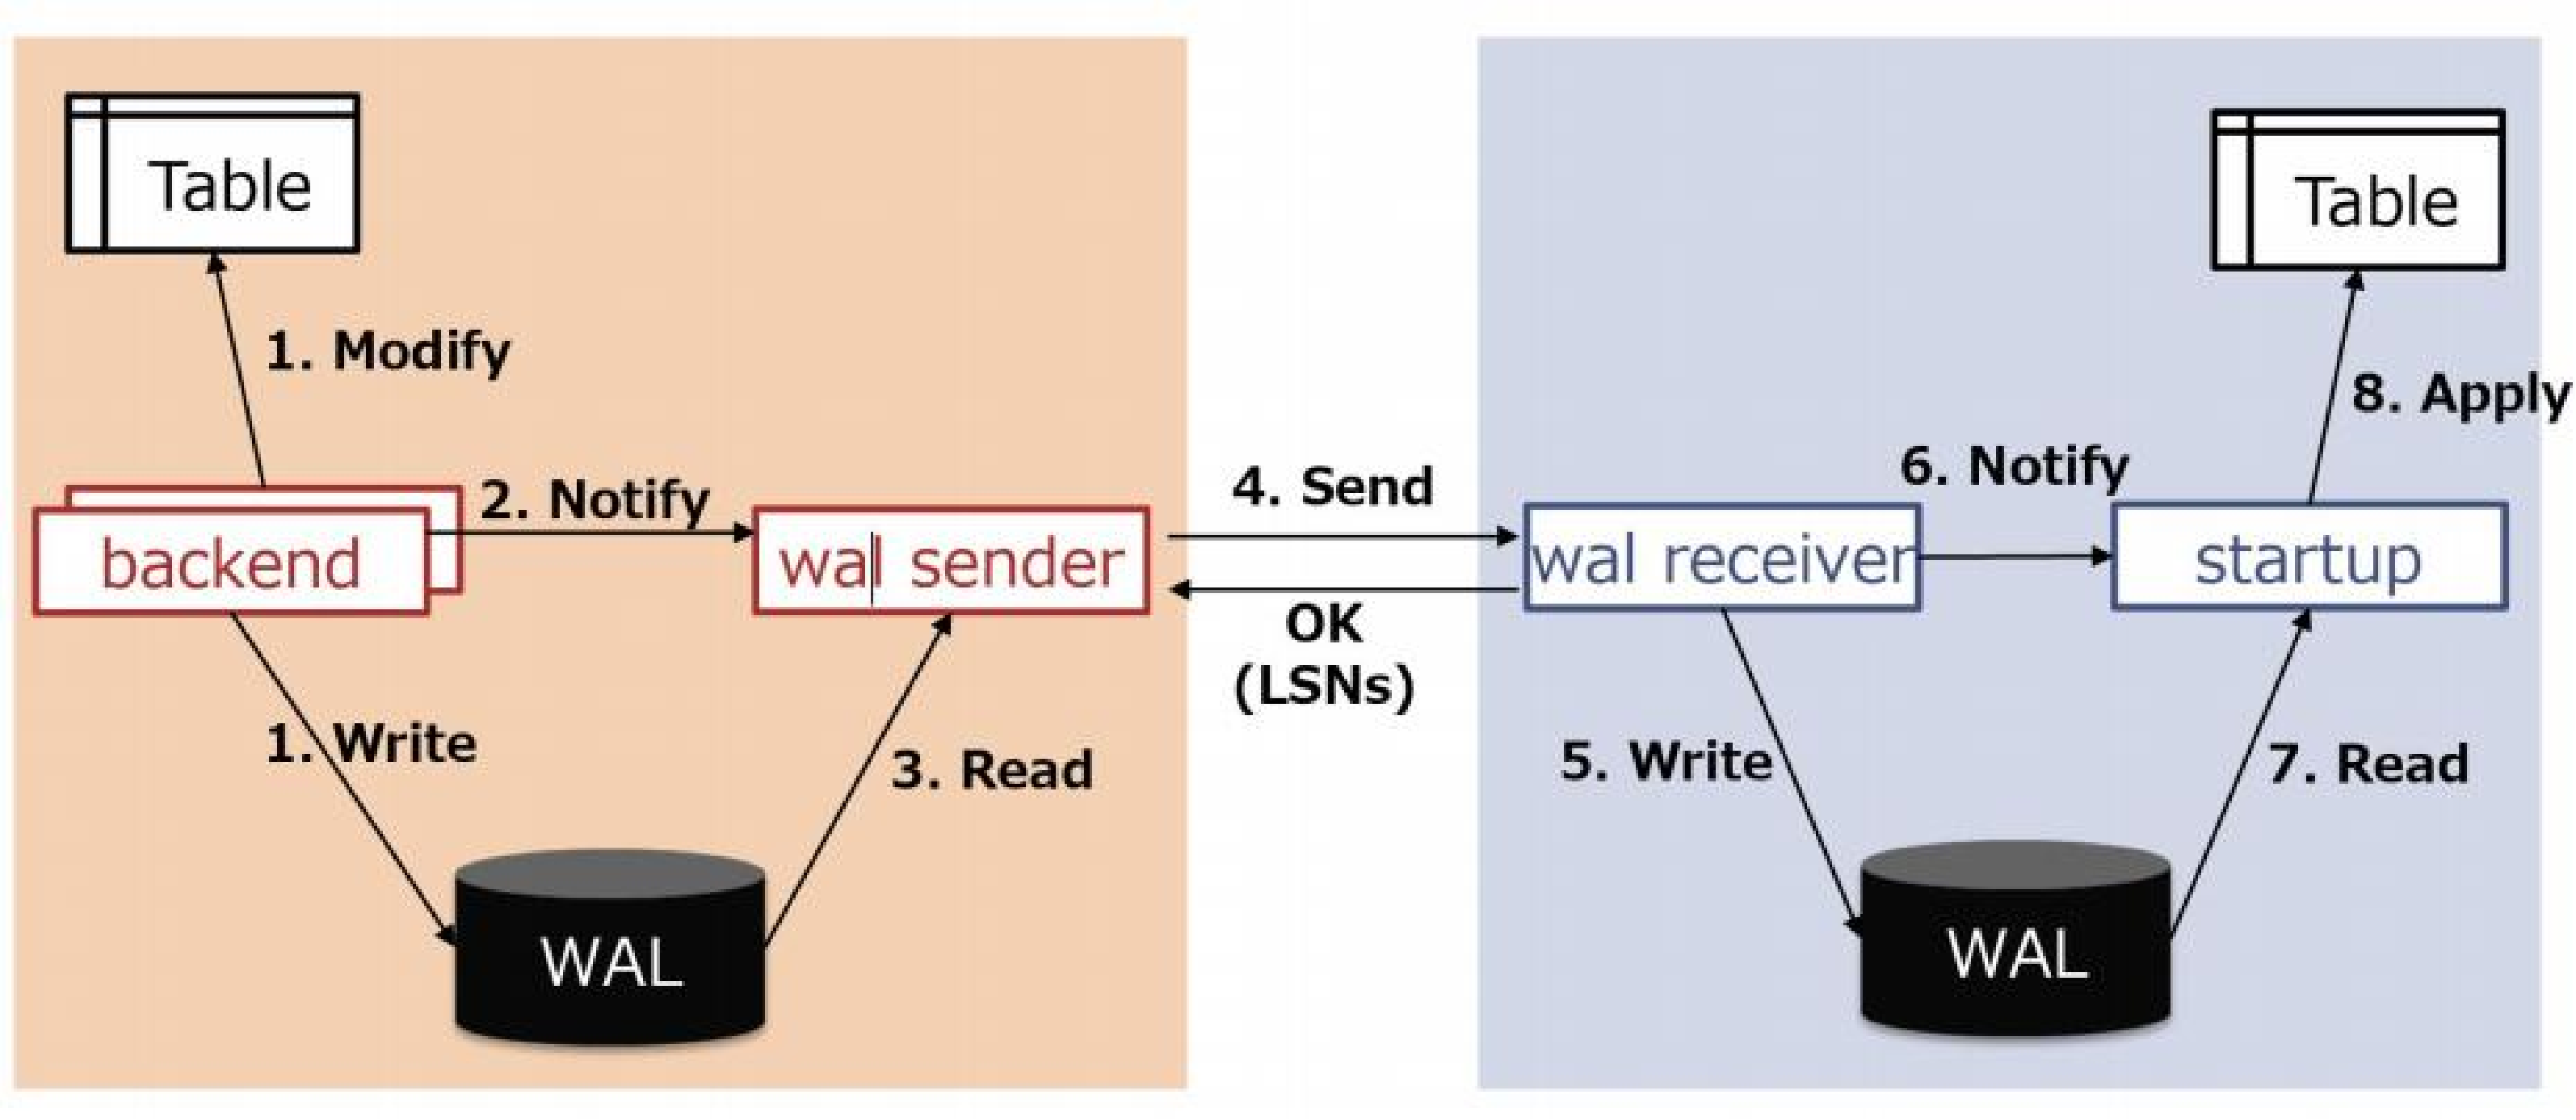
读写分离架构中,为了分摊主库的查询压力,应用程序通常会将读请求路由到备库。然而,在异步复制场景下,如果写入操作刚完成就立即查询备库,查询结果可能为空——数据尚未同步完成。

这在很多业务场景中是不可接受的。一个典型例子是“写后读”模式:用户提交表单后立即刷新页面查看结果,如果查询被路由到尚未完成同步的备库,用户将看到不一致的状态。
3.png

二、基于轮询的现有方案及其开销

2.1 轮询方案的实现逻辑

社区此前提供的轮询方案,核心逻辑如下:

-- 在主库获取当前WAL插入位置
SELECT pg_current_wal_insert_lsn(); -- 例如 0/306EE20

-- 在备库不断轮询,直到重放位置追上目标LSN
function wait_for_replay(target_lsn, timeout):
    deadline = now() + timeout
    while now() < deadline:
        replay_lsn = query("SELECT pg_last_wal_replay_lsn()")
        if replay_lsn is NULL:
            continue   -- 备库尚未就绪
        if lsn_cmp(replay_lsn, target_lsn) >= 0:
            return "success"
        sleep(200ms)
    return "timeout"

2.2 轮询方案的核心缺陷

问题说明
额外开销反复发起查询并比较 LSN,带来 SQL 执行、连接和网络开销
延迟与负载的权衡轮询间隔越短,响应越及时但系统开销越大;间隔越长,系统开销小但检测延迟越大
非事件驱动条件满足后,仍需等到下一次轮询才能观察到状态变化
应用逻辑复杂需要自行处理超时、重试、异常状态以及边界情况

2.3 轮询开销的微观分析

为了直观观察轮询的实际代价,可以构造一个实验:

  1. 在主库创建长时间运行的阻塞条件:开启一个后台事务(如BEGIN; INSERT; pg_sleep(60); COMMIT;),使该事务长时间持有资源
  2. 在备库触发被阻塞的操作:执行pg_create_logical_replication_slot(),该操作会进入等待状态
  3. 收集性能指标:通过 perf 工具采集等待进程的硬件指标

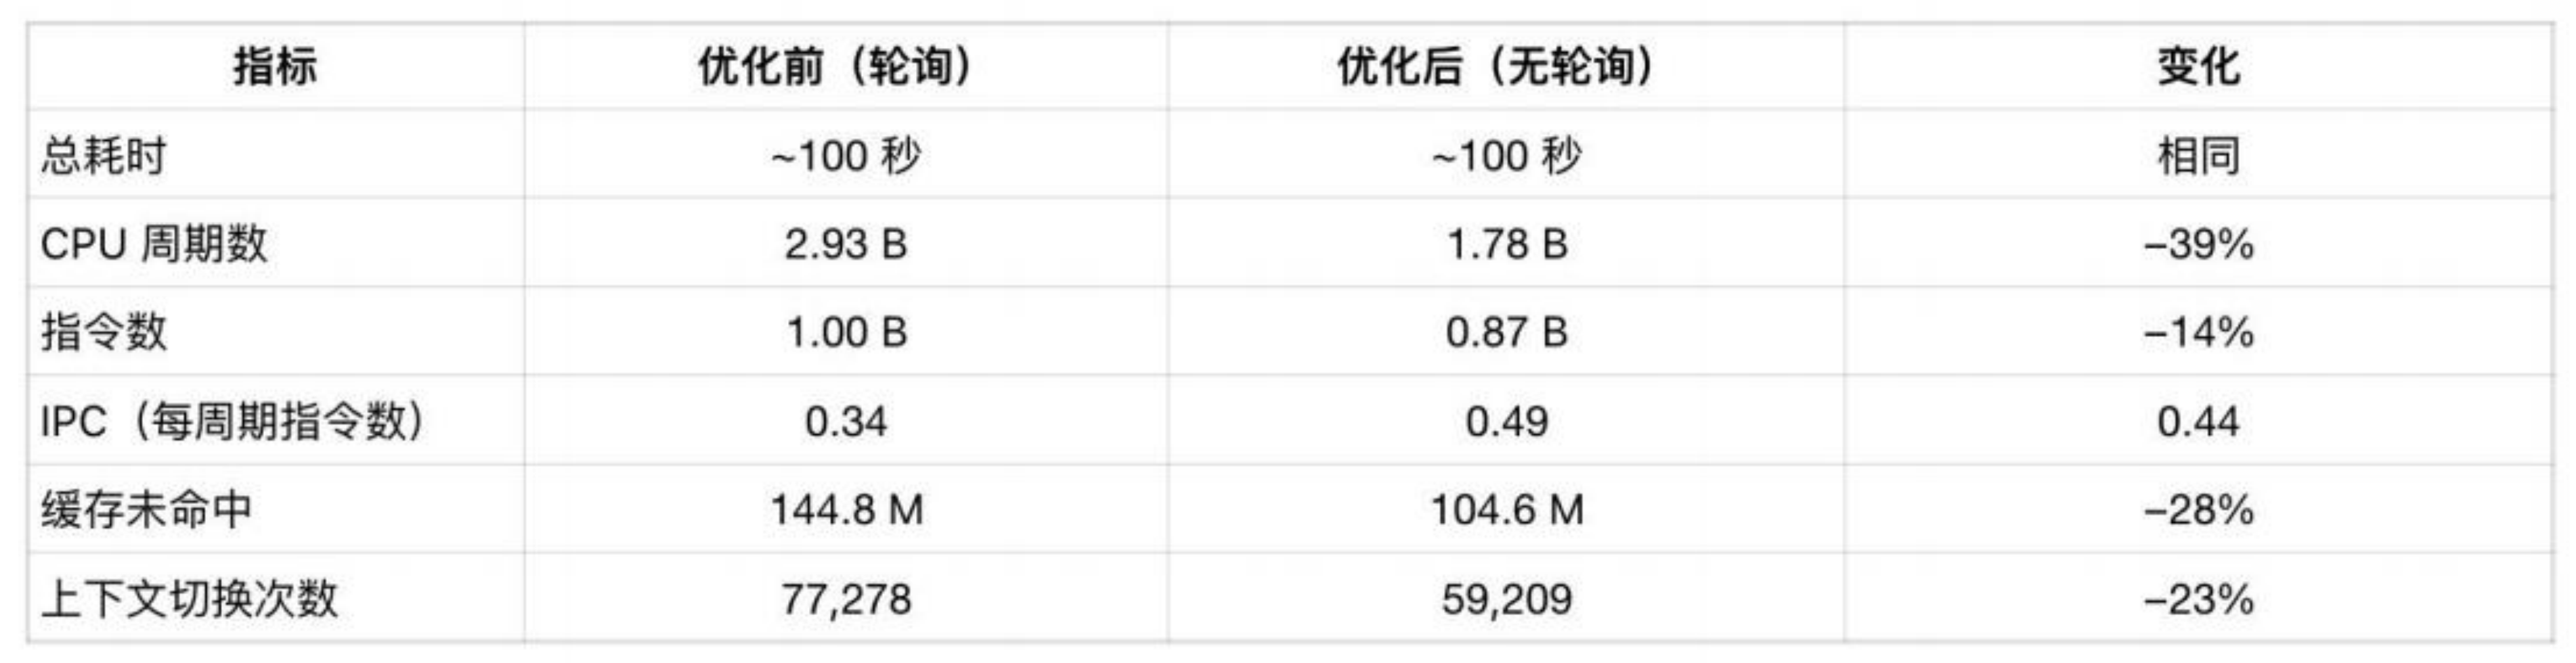
实验结果显示,在 60 秒的等待过程中:

指标数值
CPU 周期数2,930,606,156(约 29 亿)
指令数1,003,179,713(约 10 亿)
缓存未命中144,808,110(约 1.45 亿)
上下文切换77,278(约 7.7 万次)

一个仅仅在等待的后端进程,就消耗了数十亿的 CPU 周期,并发生了数万次上下文切换。

2.4 代价为何如此之高?

轮询的开销主要来自以下几个方面:

(1)上下文切换(Context Switch)

进程在休眠与唤醒之间反复切换,涉及用户态与内核态的转换,每次切换都有显著的成本:TLB(Translation Lookaside Buffer,页表缓存)刷新失效;CPU 流水线被冲刷(pipeline flush),无法并行执行;L1/L2/L3 的指令缓存和数据缓存被污染。

(2)调度器开销

Linux 的调度器使用红黑树(Red-Black Tree,一种自平衡二叉搜索树)管理可运行进程。每次将进程从红黑树取下再放回,都需要进行树的平衡操作(rebalance)。

(3)性能计数器开销

进程切换时,内核需要记录进程在 CPU 上运行的时间等统计信息,这些记账操作本身也消耗 CPU。

社区资深成员 Andres Freund 曾在邮件列表中表示:PostgreSQL 代码中应尽量避免引入长时间的轮询——因为轮询会隐藏 bug、容易出错、耗能且低效。

三、WAIT FOR LSN 基础设施

3.1 设计目标

WAIT FOR LSN 的核心设计思路是:用事件驱动的等待机制替代轮询。当条件满足时,进程被主动唤醒,而不是反复自行检查。

3.2 核心 IPC 机制

PG 内部提供了两种主要的进程间通信(IPC)原语:

(1)Latch

基于布尔标志的唤醒原语,通过SetLatch/ResetLatch/WaitLatch进行操作。进程在“有工作到来之前”进入休眠,避免轮询。

(2)条件变量(Condition Variable)

基于自旋锁保护的等待队列(由一组 PGPROC 组成),通过Signal/Broadcast唤醒等待者。本质上是给对应进程设置其 latch,从而触发唤醒。

3.3 消除“虚假唤醒”

如果采用简单的条件变量方案,每次 WAL 推进时广播唤醒所有等待进程,会导致大量不必要的唤醒——因为很多进程等待的目标 LSN 可能尚未达到。

要实现精确唤醒,需要引入按 LSN 索引的等待队列,仅唤醒那些条件已经满足的进程:

  • 为每个 backend 分配独立的 latch
  • 维护一个等待队列,记录每个进程的等待类型和目标 LSN
  • 只有当目标 LSN 达成时,才唤醒相应的进程

数据结构设计:

引入ProcessInfos结构保存当前所有等待进程的信息。使用配对堆(Pairing Heap) 按等待 LSN 排序,以便快速获取当前等待的最小 LSN。引入无锁的缓存标记(lock-free cache mark) ,记录当前所有等待类型中最小等待 LSN 的值——每次 WAL 推进时,只需比较推进的 LSN 与缓存的最小等待 LSN,如果连最小的等待 LSN 都没有达到,则无需遍历堆。
4.1.png

3.4 WAIT FOR LSN Infra 核心接口

新增的核心接口:

  • WaitLSNWakeup:用于唤醒等待 LSN 的进程
  • WaitForLSN:用于进程进入等待状态

支持的等待类型:

  • standby_replay:等待备库回放(默认)
  • standby_write:等待备库写入
  • standby_flush:等待备库持久化
  • primary_flush:等待主库持久化

3.5 效果验证

将原有轮询逻辑:

pg_usleep(1000L);  // 轮询等待

替换为事件驱动机制:

WaitForLSN(WAIT_LSN_TYPE_PRIMARY_FLUSH, loc, -1);
WaitForLSN(WAIT_LSN_TYPE_STANDBY_REPLAY, loc, -1);

在同样的 60 秒等待测试中,硬件指标显著改善:

指标轮询方案WAIT FOR LSN提升
CPU 周期数~29 亿~17.8 亿约 39%
指令数~10 亿~8.7 亿约 14%
缓存未命中~1.45 亿~1.06 亿约 27%
上下文切换~77,278~60,000约 22%

值得注意的是,每周期指令数(IPC) 有所提升,说明 CPU 利用率更高——流水线没有被缓存未命中或代码冲刷频繁阻塞。

四、WAIT FOR LSN 命令接口

4.1 为什么不能用 Function 或 Procedure?

在设计用户接口时,看似有多种选择:Function、Procedure 或 Command。最终选择Command而非更常见的 Function/Procedure,背后有深刻的技术原因。

关键约束:等待期间必须释放所有 Snapshot

如果在等待期间持有 Snapshot(快照),会持有MyProc->xmin,从而阻止备库的 WAL 回放。具体来说:

  • startup process 回放时,需要判断某些元组(tuple)或索引项对哪些进程可见
  • 如果某个 backend 持有 snapshot,startup process 可能需要等待该 backend 结束才能推进回放
  • 而该 backend 可能在等待 WAL 回放——形成死锁(Self Deadlock)

各方案的对比:

方案问题结论
FunctionExecutorRun 期间必须持有 query 快照;函数只是表达式求值,不能安全释放外层 ActiveSnapshot → 持有 xmin → 可能阻塞备机回放❌
ProcedureCALL 本身嵌在 portal/result 处理流程中,snapshot 可能由外层框架创建,不属于 procedure 本身,无法安全释放❌
Command顶层 utility command,不需要 snapshot;等待前清理 active/catalog snapshot,并验证无 registered snapshot → MyProc->xmin 为 Invalid,可安全等待 replay✅

只有 Command 能够满足安全等待的要求。

4.2 命令语法与使用示例

基本用法:

-- 主库执行写入操作
UPDATE movie SET genre = 'Dramatic' WHERE genre = 'Drama';
-- UPDATE 100

-- 获取当前WAL插入位置
SELECT pg_current_wal_insert_
();
-- pg_current_wal_insert_lsn
-- ---------------------------
-- 0/306EE20
-- (1 row)

-- 在备库执行等待
WAIT FOR LSN '0/306EE20';
-- status
-- ---------
-- success
-- (1 row)

-- 此时备库已同步,可以查到写入的数据
SELECT * FROM movie WHERE genre = 'Drama';
-- genre
-- -------
-- (0 rows)

带选项的用法:

WAIT FOR LSN '<lsn>' [WITH (MODE '<mode>')]

支持的 MODE 选项:

  • standby_replay(默认):等待备库回放完成
  • standby_write:等待备库写入完成
  • standby_flush:等待备库持久化完成
  • primary_flush:等待主库持久化完成

4.png

不同 MODE 对应不同的等待级别,用户可以根据业务一致性需求灵活选择。

结语

WAIT FOR LSN 是 PostgreSQL 19 中一个重要的特性增强。它通过以下方式从根本上解决了异步复制场景下的读写一致性问题:

  1. 事件驱动替代轮询:彻底消除了轮询带来的 CPU 周期消耗、缓存污染和上下文切换开销
  2. 精准定向唤醒:通过 LSN 索引的等待队列,只唤醒条件满足的进程,避免“虚假唤醒”
  3. 安全的接口设计:通过 Command 而非 Function/Procedure 实现,确保等待期间能够释放所有 Snapshot,避免死锁

这一特性不仅提升了异步复制场景下的系统效率,也为用户提供了一种简洁、可控的读写一致性保障手段。

PostgreSQL 9.3实战元年:JSONB、FDW与逻辑复制生产落地指南 关系型数据库正从单一存储走向混合数据中枢,其核心演进体现在对半结构化数据、跨源联邦查询与变更数据捕获(CDC)的原生支持能力上。PostgreSQL 9.3作为首个全面支撑OLTP+OLAP混合负载的稳定版本,通过JSONB二进制格式实现高性能路径索引与运算符优化,借助Foreign Data Wrapper(FDW)达成SQL级异构数据源透明关联,并以WAL日志解析为基础构建逻辑复制雏形——这三大能力共同构成了现代云原生数据架构的底层契约。技术价值不仅在于功能本身,更在于其可灰度、可审计、可运维的工程就绪 阅读详情

相关推荐

四层冗余架构:RAID、DRBD、MySQL复制与PostgreSQL高可用选型实战

高可用(High Availability)本质是分层容错设计,而非单一技术堆砌。从存储层物理冗余(RAID)到块设备同步(DRBD),再到数据库服务级复制(MySQL/MariaDB主从与GTID),最终抵达原生高可用架构(PostgreSQL流复制+Patroni),每一层解决特定故障域——RAID应对磁盘损坏,DRBD覆盖主机单点失效,MySQL半同步保障事务级RPO,Patroni实现自治化故障转移。这种分层模型兼顾数据一致性、恢复时效性与运维可控性,广泛应用于金融账务、电商订单、政务云等对连续性要

weixin_33836874的博客 440

PostgreSQL 18/19 新特性深度解读:从 IO 预取到智能运维,全面提升数据库体验

PostgreSQL 的版本升级成本相对较低,无论是通过pg_upgrade还是逻辑复制迁移,都能较为平滑地完成。PG 18 重在夯实底层 IO 性能和开发便利性,适合追求高吞吐和简化业务代码的团队;PG 19 则聚焦运维可观测性和自动化治理,为大规模、高要求的生产环境提供利器,尤其是自适应 I/O、智能回收和在线表收缩,将显著减轻 DBA 日常负担。面对 AI 应用对数据库提出的新挑战(如 JSON 存储、图关系检索、一致性读),PG 19 也给出了积极回应。

IvorySQL的博客 472

DBeaver Ultimate 25.3:企业级多源数据库治理与SQL工程化实践

数据库客户端工具已从基础连接演进为数据工程核心枢纽。理解元数据快照隔离、可插拔执行上下文等架构原理,是实现跨库协同、生产环境安全管控与高并发SQL治理的技术前提。这类能力直接支撑信创迁移、异构数据库统一运维、灰度发布审计等关键场景,尤其在OceanBase Oracle模式调试、PostgreSQL逻辑复制槽监控、ClickHouse分布式JOIN优化等新一代数据库深度适配中体现显著工程价值。DBeaver Ultimate Edition 25.3正是面向DBA、数据工程师和后端开发,提供元数据治理、SQ

anchang7456的博客 447

Patroni DCS Failsafe Mode 深入解析:在 DCS 故障时避免 PostgreSQL 主库被迫降级

本指南围绕 Patroni 官方文档 [docs/dcs_failsafe_mode.rst](https://link.gitcode.com/i/a66684e2f0366286df413dcc29f5633f) 展开,系统讲解 DCS Failsafe Mode 的诞生背景、工作原理、底层实现与完整启用流程。读完本文,你将理解 Patroni 如何在 Etcd / Consul / ZooK

gitblog_00039的博客 163

YashanDB数据库安装部署实战手册:从裸机直装到高可用集群

数据库安装部署是数据库系统稳定运行的基石,涉及操作系统适配、内核参数调优、权限模型设计及高可用架构落地等关键环节。理解其底层原理——如内存分配器(JEMalloc)与cgroup的协同机制、MVCC并发控制对锁行为的影响、WAL日志与文件系统屏障的耦合关系——才能规避‘启动成功但三天后性能断崖’等典型陷阱。技术价值在于将部署从经验驱动升级为意图驱动:明确每个配置项背后的架构权衡,例如vm.swappiness=1兼顾page cache保留与OOM防护,ext4禁用journal_checksum避免双重校

mybwu_com的专栏 395

DigitalOcean实战指南:中小团队云服务选型与高效部署

云服务本质是支撑开发者快速交付业务价值的基础设施。理解其核心原理——资源抽象、按需计费与托管运维——是技术选型的前提。DigitalOcean以精准克制的设计哲学,将复杂云能力收敛为Droplets(轻量云服务器)、Spaces(极简对象存储)和Managed Databases(免运维数据库)三大支柱,显著降低认知负荷与操作成本。它不追求功能堆砌,而是聚焦中小团队高频场景:MVP快速上线、静态资源全球分发、数据库高可用与确定性恢复。对于正面临K8s学习曲线陡峭、AWS配置繁琐或账单不可控困境的devs而言

weixin_33670786的博客 503

PostgreSQL高可用架构设计与故障转移技术实现

PostgreSQL高可用架构设计是企业级数据库部署的核心需求,通过合理的故障转移技术实现可以确保99.99%以上的业务连续性。本文深入探讨PostgreSQL高可用解决方案的技术选型、部署配置和性能优化策略,为中级技术人员提供实用的实战指南。 ## 技术架构概述 PostgreSQL高可用架构的核心在于构建冗余的数据库节点集群,通过复制机制确保数据一致性,并实现自动故障检测与切换。现代Pos

gitblog_01055的博客 756

【合规领域】【信息科学与工程学】计算机科学与自动化——第五百篇 国产化/XC解决方案 第二篇 海光CPU/DCU芯片适配02

类型:信创CV大模型异构推理适配信创硬件及国产化硬件及对应芯片架构和指令集:主机CPU:海光三号(x86-64指令集,14nm)/ 飞腾S2500(ARMv8指令集)AI加速:燧原S60推理加速卡 × 2(基于自主AI计算指令集体系的GCU-CARE加速计算单元,DSA架构)互联:GCU-LARE片间高速互连操作系统:银河麒麟高级服务器操作系统V10(Kylin v10 x86_64/AMD64 或 AArch64/ARM64)信创及国产化软件:操作系统:银河麒麟V10(燧原官方兼容适配)驱动与软件栈:En

weixin_49199313的博客 63

PostgreSQL性能监控神器pg_enterprise_views:从核心视图到实战优化

数据库性能监控是保障系统稳定运行的关键环节,其核心在于对数据库内部运行状态的实时洞察与量化分析。PostgreSQL作为主流开源数据库,提供了丰富的系统视图用于性能诊断,但原始数据往往分散且解读门槛较高。pg_enterprise_views插件通过整合与增强这些系统视图,提供了更直观、更深入的监控维度,例如直接计算索引扫描百分比和索引缓存命中率,从而将碎片化的性能指标转化为可直接指导行动的洞察。这一技术显著提升了数据库管理员和开发人员定位性能瓶颈的效率,尤其在处理慢查询、评估索引有效性、量化存储膨胀等典型

weixin_30384217的博客 352

数据库原理实践报告:从零手写存储引擎、B+树与WAL日志

数据库原理是计算机核心知识,但很多人只停留在增删改查层面。真正理解数据库需要从存储引擎、索引与事务恢复入手。以B+树为例,其高度与扇出决定磁盘IO次数,是千万级数据查询的关键;WAL日志则保障事务提交后断电不丢数据。掌握这些底层机制,不仅能应对数据库性能调优,还能在面试中脱颖而出。围绕数据库原理实践报告,从单页存储、手写B+树到WAL与锁管理器的完整路径,结合避坑经验与故障注入方法,帮助开发者从应用者进阶为内核认知者。

weixin_33841722的博客 407

从零实现关系型数据库内核:存储引擎、查询优化与事务管理的工程实践

关系型数据库是现代信息系统的核心组件,其核心原理在于高效、可靠地管理结构化数据。从架构上看,数据库系统通常包含存储引擎、查询处理器和事务管理器三大核心模块。存储引擎负责数据的物理存储与索引,其设计直接决定了数据存取的性能,常见的B+树索引结构因其出色的范围查询性能而被广泛采用。查询优化器是数据库的“大脑”,它通过分析SQL语句,基于统计信息和代价模型,将逻辑查询计划转化为高效的物理执行计划,从而避免低效的全表扫描。事务管理器则通过锁机制和预写日志等技术,确保数据的ACID特性,保障并发操作下的数据一致性。这

weixin_30824479的博客 367

Patroni 迁移与升级实战:将独立 PostgreSQL 转化为 Patroni 集群并完成大版本升级

本指南以 [docs/existing_data.rst](https://link.gitcode.com/i/8b9a7b19ac4dd668b2af18c771d2ff1a) 为骨架,系统讲解两条 Patroni 生命周期中最关键的两条运维路径:一是将一台(或多台)已有 PostgreSQL 独立实例平滑纳入 Patroni 管理,二是对已由 Patroni 管理的集群执行 PostgreS

gitblog_00074的博客 599

回声消除评价指标——ERLE, PESQ

回声消除评价指标——ERLE, PESQ ERLE(echo return loss enhancement): 对于回声消除,单讲,只有回声信号,没有近端信号,判断输出结果是否能把回声信号消除掉。其值越大,证明效果越好。 其中y(n)是输入信号,s(n)是输出信号。 PESQ(perceptual evalution of speech quality): 其值是越大越好。针对双讲(回声信号,和近端信号同时存在)。判断双讲下, 计算PESQ方法: 在python安装pypesq,安装方式如下: pip

yin_fei_0825的博客 6387

postgresql源码(一)——psql命令

postgesql的源码都已经百万级了。单单.c文件都有1000+。怎么办,硬着头皮看吧,所幸postgrsql的源码很规范,这应该会给我省不少事。给自己顶一个小目标:每天看一点源码,每天都更新做不到,每周都更新吧,每周至少一篇。希望看到我的博客的朋友们也和我一起学习,我有什么理解不对的地方,也希望大家提出意见~ 大部分人初次接触postgresql一般都是接触psql这个命令行工具吧,那么我们今天就从psql程序的源码开始看吧。 psql的源码分为两部分,一部分是psql的前台处理代码,...

driftingman的专栏 995

WINDOWS下SIP拨号的实现

在WIN10上拨打SIP电话  由于我的交换原理实验有一个是关于SIP的抓包的。而之前从未接触过SIP,所以在如何完成一次SIP拨号上遇到了不少问题,查了好多资料都没有完整的或者写的很清楚的,这里就对那些资料做一个总结,给出一个比较完善的解决方案,一来是记录此次实验的收获,而来也可能为其他有同样困惑的人解惑。  废话不多说直接开始。首先是下载一个可以拨打SIP电话的客户终端,这里我选择的是MicroSIP, 下载红圈内的文件,下载好之后直接一路安装即可,没有什么特别注意的地方。  安装好客户端之后,就需要注

weixin_43918519的博客 3808

医药行业SAP序列号管理深度解析:如何满足GMP合规要求

本文深度解析了医药行业如何利用SAP序列号管理构建满足GMP合规要求的数字化追溯体系。文章详细阐述了SAP序列号在实现从生产到患者全流程“一物一码”精准追溯中的核心作用,并探讨了其与质量管理、冷链监控等系统的关键集成配置,为医药企业应对严格监管、保障产品质量与安全提供了切实可行的技术方案。

backprop5master的博客 656

Patroni 版本发布说明深度解读:从 0.80 到 4.1.5 的高可用演进之路

**导读**:本文以当前仓库 [docs/releases.rst](https://link.gitcode.com/i/03e86930459f55a1329f7eeef8153445) 官方发布说明为骨架,系统梳理 PostgreSQL 高可用方案 Patroni 从 2016 年 0.80 版到 2026 年 4.1.5 版的核心能力演进,涵盖 DCS 故障安全模式、quorum 同步复制

gitblog_00081的博客 502

从Mule ESB到Apache Camel:手把手教你设计一个轻量级企业集成框架的‘心脏’

本文深入探讨了从Mule ESB到Apache Camel的轻量级企业集成框架设计实践,对比了两者在协议支持、消息处理能力和部署灵活性等方面的差异。通过实际代码示例和性能优化技巧,帮助开发者构建高效的核心模块,适用于现代微服务架构下的系统集成需求。

weixin_28738165的博客 375

PostgreSQL国产数据库实战:从技术本质到部署验证的完整指南

关系型数据库作为企业数据存储与管理的核心,其ACID特性、SQL标准支持及事务处理能力构成了现代应用的数据基石。开源数据库PostgreSQL凭借其成熟稳定的内核、良好的扩展性及宽松的BSD协议,成为众多数据库产品的技术源头。在国产化替代与数字化转型的背景下,基于PostgreSQL内核进行深度定制与增强的国产数据库产品,通过引入分布式架构、HTAP能力及对Oracle/MySQL的语法兼容,在金融、电信、政企等核心业务场景中展现出重要技术价值。本文聚焦于PostgreSQL及其衍生国产数据库的实战评估,通

weixin_34199405的博客 353

保姆级教程:用Fiddler+夜神模拟器搞定抖音App抓包(附SSL Pinning绕过实战)

本文提供了一套完整的移动端抓包解决方案,详细介绍了如何使用Fiddler和夜神模拟器进行抖音App抓包,并重点讲解了SSL Pinning绕过技术。通过Xposed框架和JustTrustMe模块的组合,实现高效抓包,适用于产品分析、竞品研究和安全测试等场景。

weixin_30855099的博客 424

星辰超级智能体TeleClaw桌面版深度体验:央企出品的本地AI生产力助手

中国电信星辰超级智能体TeleClaw桌面版是一款本地化AI生产力助手,主打数据安全、自主高效和深度协同。作为程序员,作者实测其核心功能包括本地数据处理、长期记忆、定时任务和代码开发辅助,特别适合敏感数据处理和日常办公自动化。相比在线AI工具,TeleClaw在数据安全、合规性和自动化能力方面优势明显,但技能生态和响应速度仍有提升空间。总体评价为务实高效的本地AI助手,尤其适合对数据安全有要求的企业用户。

研究中.... 1363

Web开发者必知的数据库实战指南:从连接池到PostgreSQL优化

数据库是Web应用的交通指挥中心,而非后端私有模块。理解连接池原理、事务边界与索引机制,是保障API响应快、系统不崩塌的技术基础。PostgreSQL凭借JSONB字段、内置全文检索、确定性连接池(如pg_bouncer)和地理空间扩展,正成为现代Web开发的新默认。它并非替代MySQL或Redis,而是以查询场景为标尺,在读写分离、冷热分层、Schema演进等真实需求中展现工程优势。本文聚焦Web特有的高并发突发性、分钟级实时容忍度与动态数据模型三大特征,解析从建表规范、ORM陷阱规避到K8s下连接管理的

agcozdwdfvds08078的博客 400

S7-1200 PN与G120变频器控制起停及调速PROFINET实现详解

S7-1200 PLC与G120变频器通过PROFINET通信可实现高效、实时的电机控制。2. 《S7-1200与G120 CU250S-2PN的PROFINET通讯指南》- 控制器:S7-1200 PLC (如1214C DC/DC/DC)- 变频器:G120 CU250S-2PN (带PROFINET接口)- 输出区(PZD1-2):控制字(16位)、速度设定值(16位)- 输入区(PZD1-2):状态字(16位)、实际速度值(16位)- P922=1:选择报文类型为"标准报文1 (PZD2/2)"

电工 1871

开源之夜倒计时!瀚高PG内核专家周煦能7月14日香港开讲,报名从速

开源数据库领域再迎重磅线下交流!将深度参与由主办的月度开发者聚会,公司资深PostgreSQL内核研发专家、将受邀发表主题演讲。本次活动定于在香港举办,现开放25个珍贵席位,诚邀数据库爱好者和开源开发者共赴这场技术盛宴。

IvorySQL的博客 177

哨兵1号后向散射系数土壤水分反演

打开之前预处理之后的VH和VV极化的后向散射系数转存的tiff文件。

所有专家都曾始于新手 3295

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

技术盛宴抢先看!HOW2026 主论坛 + 分论坛全议题前瞻

HOW 2026 PostgreSQL & IvorySQL 技术峰会议程正式发布。这一次,我们把目光从单点技术,拉回到数据库演进的全局视角,从内核机制的深度打磨,到 PostgreSQL 18 的关键跃迁;从 AI 与数据的深度融合,到云原生与行业场景的全面落地。1 场主论坛 + 12 大主题分论坛,覆盖数据库技术的关键路径与前沿方向,一次性展开 PostgreSQL 在当下与未来的完整技术版图。接下来,带你提前走进 HOW 2026,看看这场大会,究竟在讲什么。

IvorySQL的博客 462

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

上一篇: PostgreSQL 日报|修复截断 zstd 备份检测(10 月 9 日)
下一篇: PostgreSQL 日报| PostgreSQL JDBC 安全更新(10 月 10 日)
IvorySQL
博客等级 码龄5年 745粉丝 566原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值