AI 赋能数据库查询优化:Tree Transformer + 排序学习突破传统瓶颈

PolarDB+MemTensor:云原生数据库如何解决AI向量检索性能瓶颈 向量检索是支撑大模型应用、推荐系统和语义搜索的核心技术,其原理是通过将文本、图像等高维数据转换为向量表示,并计算向量间的相似度来实现语义匹配。传统基于PGVector扩展的方案在应对海量向量数据时,常面临计算瓶颈和内存IO瓶颈,导致查询延迟飙升。PolarDB结合MemTensor AI内存方案,通过将向量计算卸载到专用高性能内存池,实现了资源隔离与数量级的性能提升,为RAG应用、智能推荐等需要高效向量检索的生产场景提供了稳定可靠的云原生解决方案。 阅读详情

本文整理于 HOW 2026 演讲内容,演讲者:崔鹏,PostgreSQL ACE,计算机博士,10 年 以上数据库经验,ORACLE OCM + PostgreSQL ACE 双认证,海能达通信 DBA 总监,公众号“CP 的 PostgreSQL 厨房”主理人。

本次分享主要分四个部分:第一,智能查询优化技术背景;第二,基于排序学习的查询计划选择算法;第三,基于 Tree Transformer 的查询计划表征算法;第四,原型系统设计与实现。

一、研究背景:传统查询优化器的三大痛点

随着大数据时代的到来,数据规模呈爆炸式增长,数据库管理系统在处理复杂查询和高效数据检索方面面临前所未有的挑战。

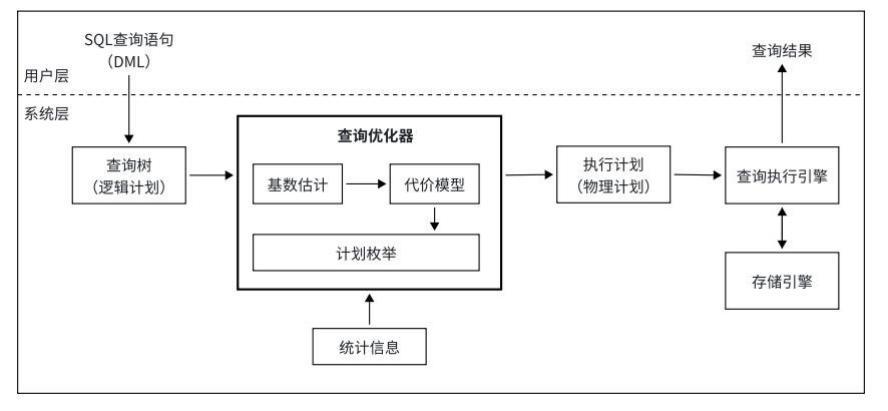
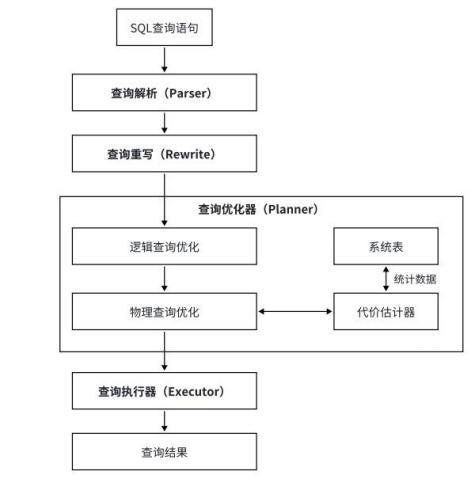
传统查询优化器的核心任务是制定出最佳的执行计划——同一个 SQL 查询可以有多种执行方式,它们产生相同的结果集,但执行效率可能天差地别。查询优化器需要对所有可能的执行计划进行评估,选出预计执行时间最短的那个。

然而,传统方法存在三个明显的局限性:
1.jpeg

第一个是基数估计问题。 基数估计方法主要分为基于摘要和基于采样两类,但都存在不足。基于摘要的方法难以捕捉数据之间的相关性;基于采样的方法性能依赖采样策略,还需要额外的存储开销。统计信息分析不准,直接导致中间结果大小估计出现偏差。

第二个是代价模型缺陷。 传统代价模型依赖预设常数,其准确性受基数估计质量影响很大。而且,查询计划代价估计与实际执行时间之间不一定呈线性关系,可能导致选择出的执行计划质量不佳。

第三个是计划枚举限制。 计划枚举策略旨在寻找最优连接顺序,但这个问题本身是 NP 难题。传统方法如动态规划、记忆化搜索和遗传算法,都受限于基数估计和代价模型的误差,面对多表连接时能力明显不足。

AI 技术的到来,为数据库查询优化带来了新的机遇。 利用机器学习改进查询优化器的研究日益活跃,在基数估计、代价模型改进和计划枚举等方面都取得了积极进展。
2.jpeg

二、现有智能优化技术的探索与局限

先简单回顾一下机器学习领域与查询优化相关的基础算法。

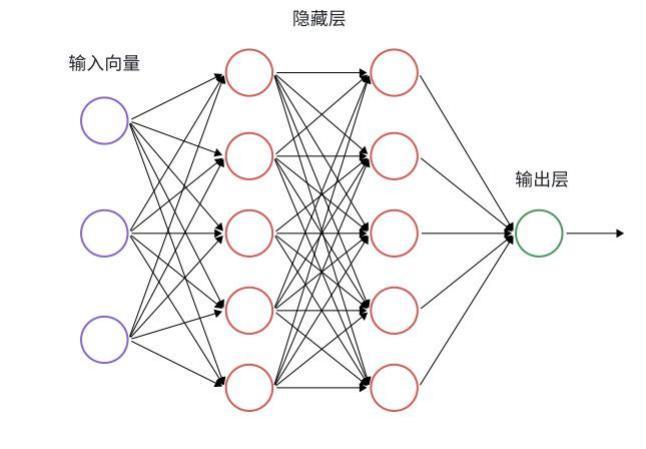
全连接神经网络(FCN) 将输入嵌入成向量矩阵,经过多个隐藏层提取特征,最终由输出层输出结果。但全连接带来的问题是参数量过大,计算性能受影响。
3.jpeg

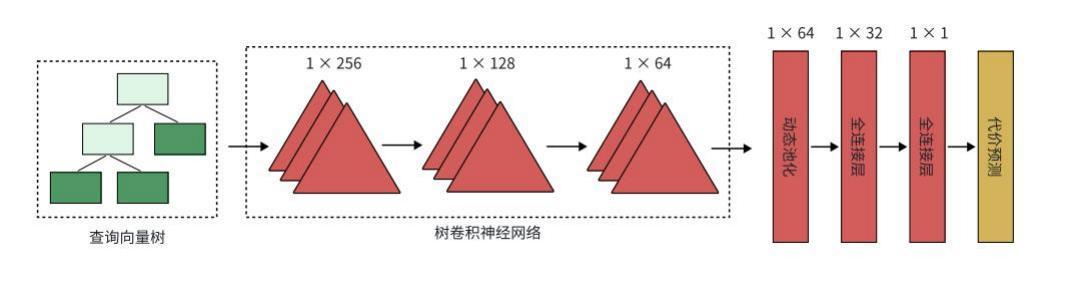
卷积神经网络(CNN) 通过卷积核(如 3×3、5×5)在原始特征矩阵上滑动做矩阵乘法,极大减少了特征提取的参数量,在图像等网格结构数据上表现优异。
4.jpeg

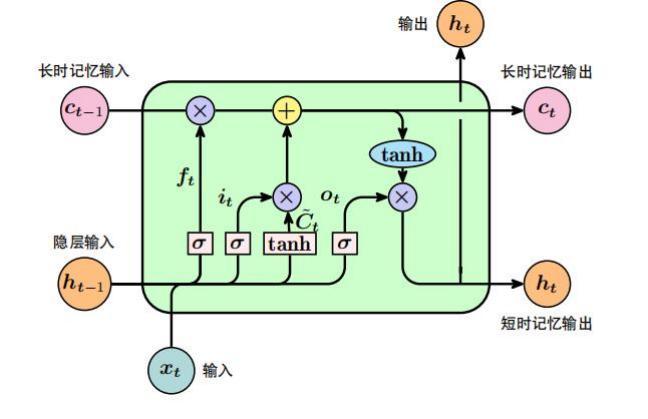
长短期记忆网络(LSTM) 专门为解决标准循环网络处理长期依赖问题而设计,通过遗忘门、输入门、输出门的门控机制,有效避免了长期依赖问题。
5.jpeg

Tree LSTM则是将 LSTM 推广到树形结构,更适合处理查询计划树这种具有层次结构的数据。

在智能优化的进展方面,研究者们做了大量探索:

  • 基数估计:分为查询驱动(有监督)和数据驱动(无监督)两类方法
  • 代价模型改进:用 Tree LSTM、Tree CNN 等模型替代或增强传统代价估计
  • 计划枚举创新:引入深度强化学习,如 ReJoin 和 RTOS
  • 端到端优化:如 Neo 和 Bao,通过价值网络和可学习搜索策略优化查询执行

但现有技术仍面临两大挑战:

第一,表征性能问题。 当前主要采用 CNN、RNN 及其衍生模型(如 Tree CNN、Tree LSTM),但在处理查询计划树形结构时存在局限性——难以捕捉长距离依赖关系。

第二,选择方法局限。 采用回归方法进行查询计划选择,需要精确预测每个查询计划的代价,这可能导致模型性能不稳定,也忽视了快速查询计划的存在。查询优化的本质是排序问题,而不是回归问题。

三、基于 Tree Transformer 的查询计划表征算法(QPR)

基于上述分析,我们提出了基于 Tree Transformer 的查询计划表征算法——QPR。

为什么选 Transformer?

Tree Transformer 以其出色的深层结构处理能力、跨层级依赖捕捉效率和优异的并行计算能力,成为查询计划表征场景下的首选模型。

我们的创新点在于:引入树注意力机制和树高度编码机制,替代传统 Transformer 中的自注意力机制和位置编码机制,使 Transformer 能够高效处理树形结构数据。
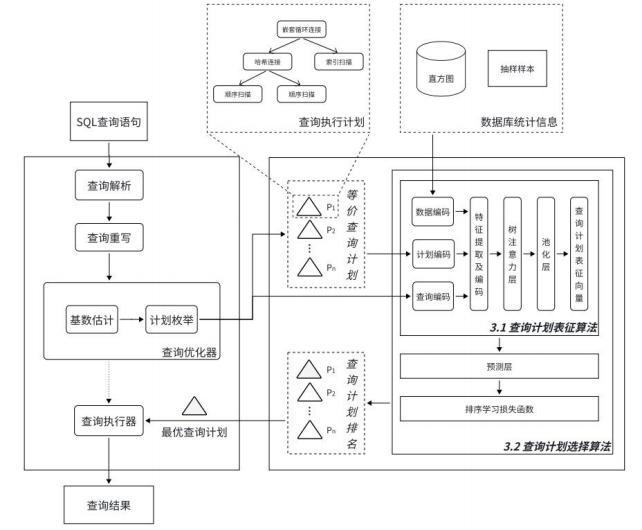
6.jpeg

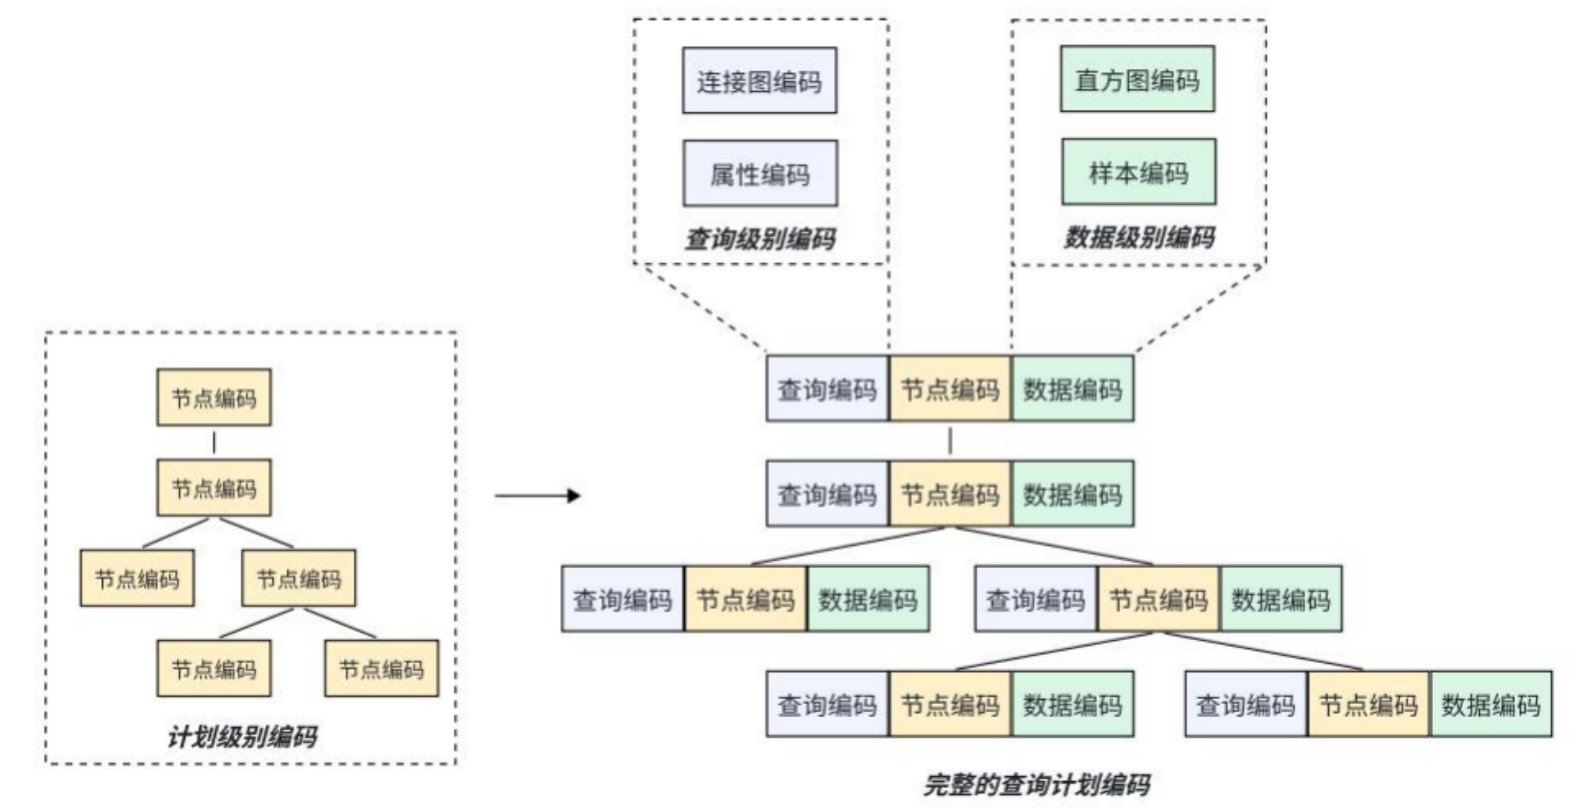
多维度的特征提取与编码

QPR 从三个维度提取特征并编码:

1. 查询级别特征

  • 连接模式:通过编码连接关系图的邻接矩阵,顶点表示数据库中的表,边表示表间的连接关系
  • 属性编码:使用 One-hot 编码处理查询中的过滤条件涉及的属性

7.png

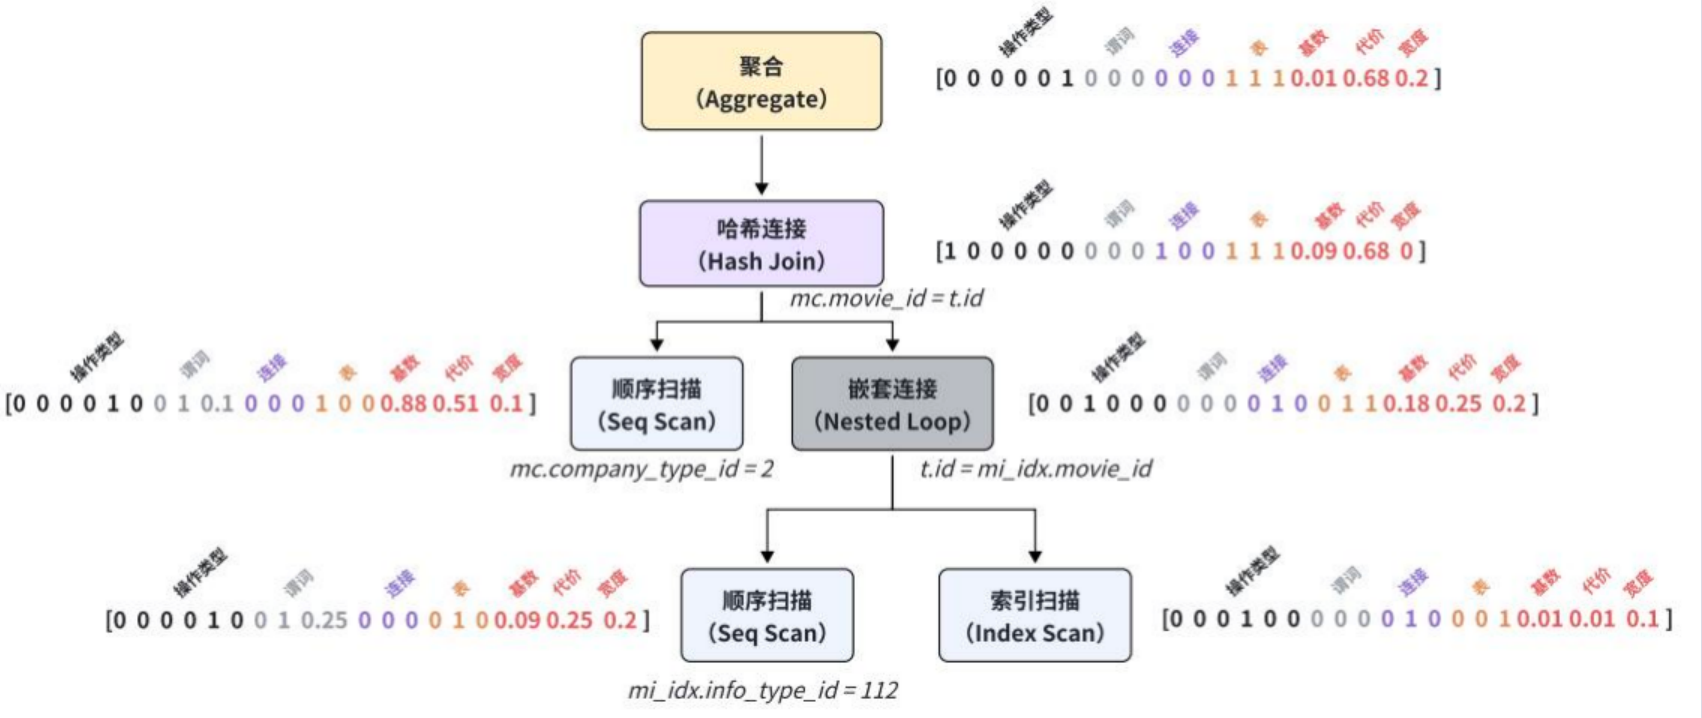
2. 计划级别特征

  • 从查询执行计划树的每个节点提取:操作类型、谓词、连接表、基数估计值、代价估计值、宽度等
  • 完整保留树形结构信息

8.png

3. 数据级别特征

  • 通过直方图和采样样本提供数据分布信息
  • 将直方图编码融入机器学习模型,提高对数据分布的理解能力

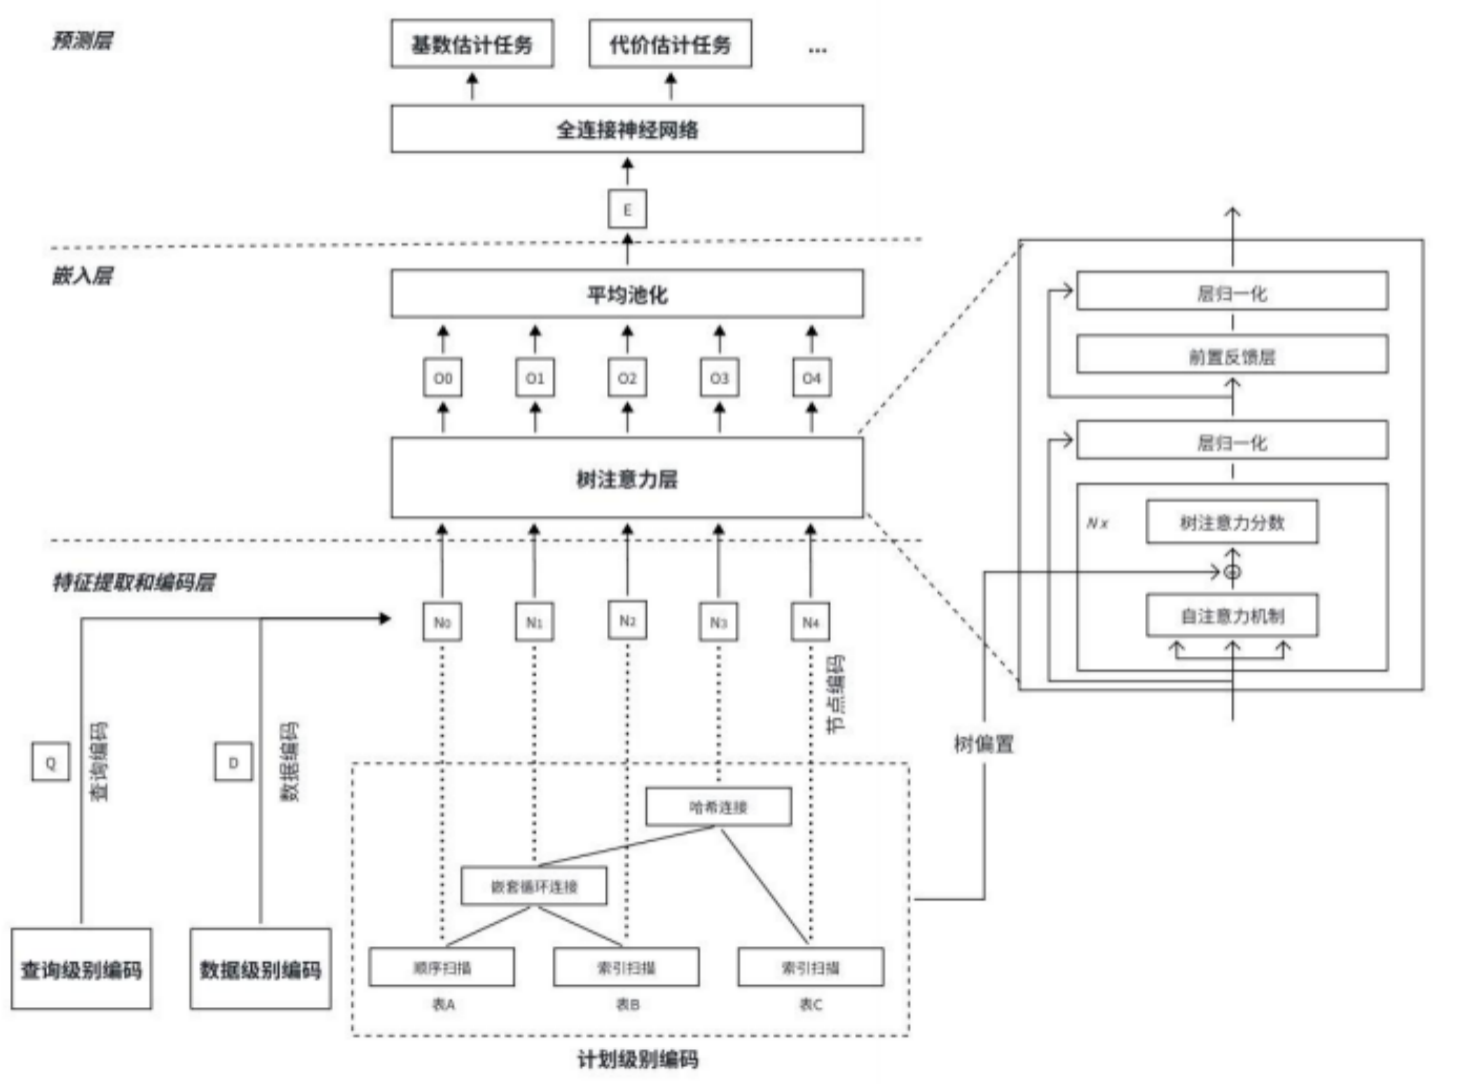
模型架构

整个模型自下而上分为:

  • 特征提取与编码层:融合查询级别、计划级别、数据级别三类编码
  • Tree Transformer 层:通过树注意力机制提取结构信息和语义依赖关系
  • 平均池化层:减少神经元,防止过拟合
  • 预测层:输出基数估计和代价估计结果

9.png

四、基于排序学习的查询计划选择算法(QPSLR)

核心理念:排序,而非回归

查询优化本质上是一个排序问题,而不是回归问题。受推荐系统中排序学习技术的启发,我们将查询优化问题建模为排序问题,目标是让模型学会区分候选查询计划的相对优劣,而非精确预测每个计划的绝对代价。

查询计划选择算法的整体流程

QPSLR 分为三个阶段:

  1. 计划枚举:设计基于基数估计的计划枚举策略,通过缩放子查询的基数估计值,引导传统优化器生成多样化且高质量的候选计划集合
  2. 查询计划表征:利用 QPR 算法提取每个候选计划的表征向量
  3. 排序学习:采用成对式(Pairwise)和列表式(Listwise)排序学习方法,学习候选计划的排序

排序学习方法

  • 成对式(Pairwise) :将完整排序转化为成对比较,通过最大化联合边际对数似然来估计模型参数
  • 列表式(Listwise) :基于负对数似然函数定义损失函数,使模型学习到的排序趋向于最优排序

通过最小化排序学习损失函数,扩大候选查询计划排名分数之间的差异,使算法能够有效区分最佳查询计划与其他候选计划,适应未知的查询场景。

五、原型系统设计与实验验证

系统架构

我们基于 PostgreSQL 设计并实现了原型系统,采用无侵入式部署架构:
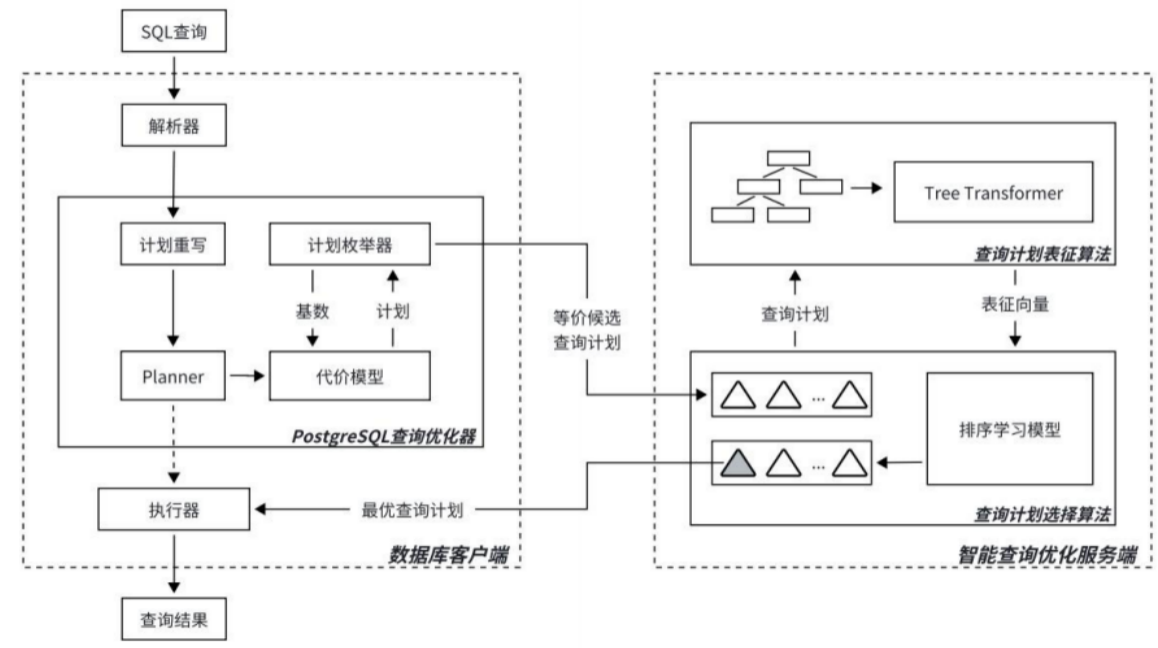
10.png

  • 数据库客户端:部署在 PostgreSQL 服务器上,负责接收 SQL 查询、生成候选查询计划
  • 智能查询优化服务端:部署在 GPU 服务器上,依托 QPR 和 QPSLR 模型进行计划评估和选择
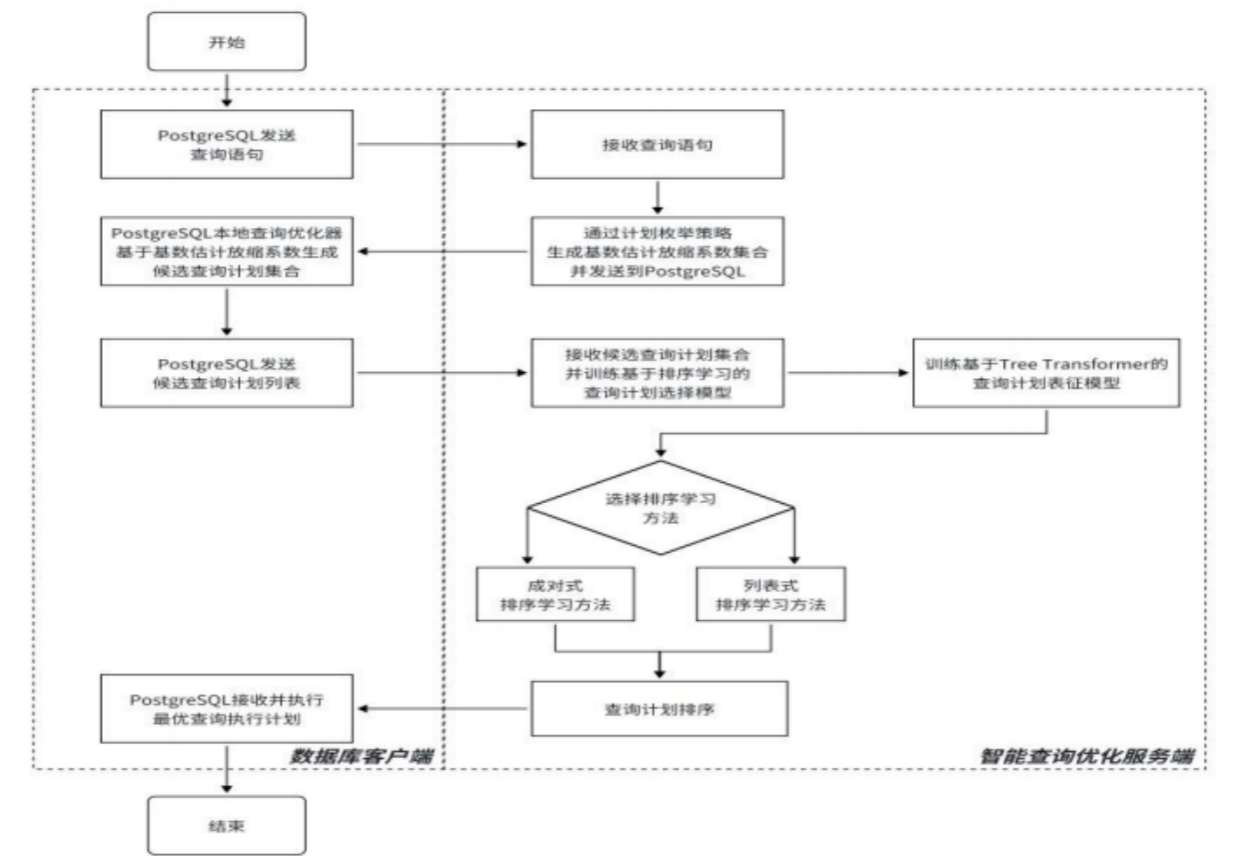
11.png

用户提交 SQL 查询后,系统询问是否启用智能查询优化算法。若启用,客户端生成候选计划发送给服务端,服务端选择最优计划返回给客户端执行。
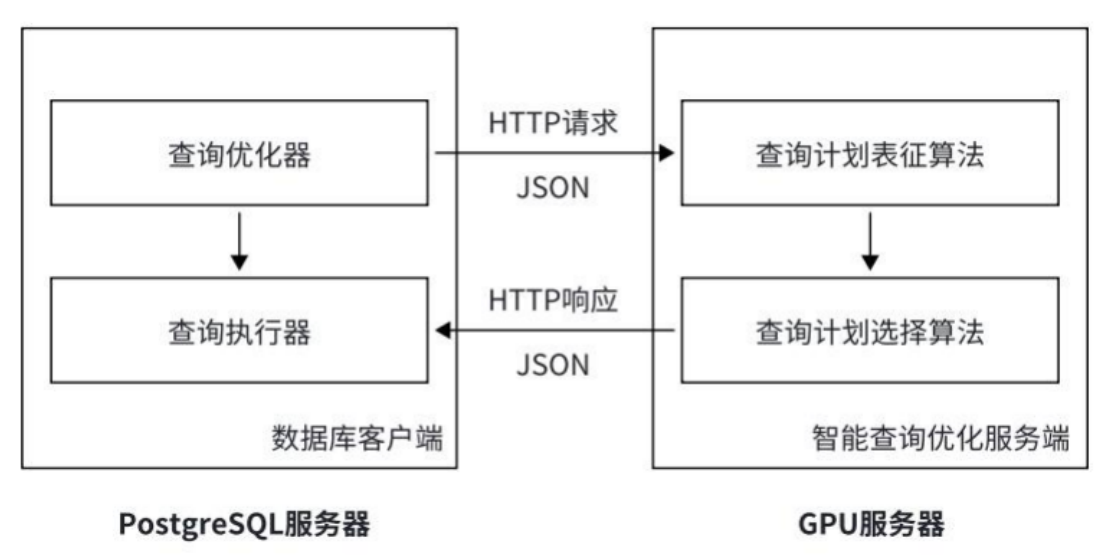
12.png

实验环境

  • 硬件:CPU、GPU、内存和硬盘
  • 软件:操作系统、PostgreSQL、Python、PyTorch
  • 数据集:
    • IMDB 数据集:6 张表、20 个属性、62,118,470 条记录,使用 JOB-light 和 Synthetic 两种查询工作负载
    • STATS 数据集:8 张表、43 个属性、1,029,842 条记录

实验结果

QPR 算法测试:在基数估计和代价估计任务上,以 Q-Error 和 Pearson 相关系数作为评估指标。QPR 在两项工作负载上的表现均优于 PostgreSQL 原生方法、MSCN、Neo(Tree CNN)和 E2E(Tree LSTM)等对比算法。模型在前 20 轮训练后即呈现明显的收敛趋势。

QPSLR 算法测试:以端到端查询执行时间为评估指标。在静态工作负载场景下,QPSLR-pairwise 和 QPSLR-listwise 模型相比于 PostgreSQL 自带优化器,在 IMDB 和 STATS 数据集上均显著减少了查询执行时间。在动态工作负载场景下,QPSLR 能更有效地适应查询变化,累计查询执行时间明显少于 PostgreSQL 原生方法。

总体效果:在真实数据集上,估计误差显著降低,查询执行效率提升了19%~49%。

六、总结与展望

本次分享提出了两个核心创新:

  1. QPR(Tree Transformer 表征) :多维度提取查询级别、计划级别和数据级别特征,通过树注意力机制高效捕捉查询计划树的结构依赖
  2. QPSLR(排序学习选择) :突破传统回归范式,将查询优化建模为排序问题,精准捕捉计划树之间的相对优劣

我们基于 PostgreSQL 实现了原型系统,实验结果验证了算法的有效性和实用性。

未来研究方向包括:

  • 整合数据库运行状态信息(如缓存数据、并发查询情况)到表征编码中
  • 探索更加先进的计划枚举策略,为选择模型提供更广泛且有效的候选计划集
  • 推进将智能优化算法从外部服务集成到数据库内核的工程化工作
预训练大模型强化学习:突破推理瓶颈,从条件概率优化到全局任务成功 在人工智能领域,强化学习(RL)是一种通过与环境交互、以最大化累积奖励为目标来学习决策策略的核心方法。其原理在于智能体通过试错探索状态-动作空间,利用价值函数评估长期收益,从而解决序列决策问题。这一技术的核心价值在于能够优化复杂任务的整体成功率,即边缘概率P(y),而不仅仅是单步输出的条件概率P(y|x)。在应用场景上,RL尤其适用于需要多步规划、长期依赖和对齐全局目标的AI任务,例如复杂对话系统、代码生成和游戏智能体。本文聚焦的预训练空间强化学习,正是将大模型强大的条件概率建模能力与RL的全局优化框架相结 阅读详情

相关推荐

RACER:无模型推测解码技术,突破大语言模型自回归生成瓶颈

在自然语言处理领域,自回归解码是序列生成任务的核心机制,它要求模型逐个生成词元,导致计算过程无法并行,成为大模型推理速度的主要瓶颈。其原理在于每一步的生成都严格依赖于前序所有输出,这种串行依赖严重制约了吞吐量。为了提升推理效率,业界提出了推测解码技术,其技术价值在于通过并行验证候选序列,用一次大模型计算换取多个有效输出,从而显著降低生成延迟。应用场景广泛覆盖了对话系统、代码补全和内容创作等需要实时或批量文本生成的领域。本文深入探讨的RACER技术,是一种创新的无模型推测解码方案,它巧妙地构建Logits树和

weixin_30907935的博客 323

Python深度学习:从入门到实战

亲爱的读者,欢迎您翻开这本书。我们即将探索的,是深度学习的宇宙——一个由数据、算法与算力构筑的奇妙世界。它既是严谨的科学,也是创造的艺术,更是一条通往未来智慧的修行之路。本书将带您从最基础的数学原理出发,亲手搭建神经网络,驾驭Transformer等前沿模型,最终将智慧转化为现实世界的价值。请放下畏惧,保持好奇。这不仅是一次知识的学习,更是一场思维的远行。来,随我一起,开启这趟非凡的旅程吧。

weixin_45747731的博客 244

GPT-5瓶颈本质:Scaling Law失效与Token经济崩溃

大语言模型的性能提升正从‘参数规模驱动’转向‘系统级约束主导’。当模型突破百亿参数量级,传统Scaling Law因数据边际收益衰减、计算物理极限和注意力复杂度爆炸而集体失效;与此同时,每个token的推理成本不再线性增长,而是受KV缓存带宽税、显存拓扑与硬件通信开销支配,形成隐性的Token经济瓶颈。这一双重约束深刻影响模型选型、推理架构与RAG设计——例如128K上下文导致延迟非线性飙升,MoE路由需负载感知,vLLM的PagedAttention成为生产刚需。本文基于一线实测数据,解析GPT-5代际跃

aodanchui1057的博客 505

AI大模型技术架构与工业级部署实战指南

Transformer架构作为现代AI大模型的核心基础,通过自注意力机制实现了对长距离依赖的高效建模。其技术原理在于并行计算输入序列中各元素间的关联权重,相比传统RNN结构显著提升了训练效率和模型表现。在工程实践中,结合混合精度训练、梯度检查点等技术可有效降低计算资源消耗,而KV Cache等推理优化手段则能大幅提升服务响应速度。当前大模型技术已在金融风控、智能客服、工业质检等领域实现规模化应用,特别是在RAG架构与多模态融合场景中展现出强大潜力。本文基于真实工业项目经验,详细解析从硬件选型到服务封装的完整

weixin_34126557的博客 298

Task-Based AI Agent性能优化五步法:缓存、状态、上下文、轻量模型与自动扩缩容

Task-Based AI Agent是一种面向具体业务任务的对话式AI系统,其性能瓶颈往往不在大语言模型本身,而在于语义理解、流程编排与基础设施三层耦合架构。本文围绕意图识别准确率、状态机跳转效率、上下文传输开销等核心指标,深入解析如何通过战略性缓存设计、轻量级状态管理、智能上下文剪枝、子任务专用轻量模型选型及实时指标驱动的自动扩缩容机制,在不更换基座模型的前提下,系统性提升任务完成率与响应时效。适用于已上线MVP、面临规模化交付压力的AI工程团队,尤其关注高并发下P99延迟控制与端到端稳定性保障。

a1311010193的博客 495

大模型已进入系统级重构阶段:AI工程师的实时决策指南

大模型(Large Language Models)正从单点能力突破转向以LLM为中枢、多模态为触角、工程化为骨架的AI基础设施重构。其核心原理在于模型能力需与数据对齐、向量检索、可观测性、本地部署等系统环节深度耦合。技术价值体现在显著降低AI落地门槛——如指令微调成本下降93%、生成合规率提升至99.2%、MLOps排障效率提升数倍。典型应用场景覆盖智能视频推荐、法律文书检索、客服对话增强等一线产线任务。本文聚焦Gemini多模态对齐、Code Llama工程适配、Langfuse可观测性实践与txtai

weixin_33924220的博客 410

【全】AI提示词工程从入门到精通教程

AI提示词工程从入门到精通教程大纲

正经教主是个热衷于正经学习分享的教主。 514

AI Agent八类模型实战分工图谱:感知、理解、规划到执行的工程化闭环

AI Agent并非单一LLM驱动,而是由感知、理解、规划、记忆、行动、验证、反思、协调八类模型协同构成的工程系统。其核心原理在于按功能角色而非技术架构划分模型职责,确保每类模型在特定任务中发挥不可替代的效率与鲁棒性优势。这种分层协作模式显著提升系统可解释性、可维护性与生产SLA保障能力,广泛应用于智能客服、工业质检、金融风控等高要求场景。本文基于17个落地项目经验,聚焦RAG流程优化、语义鸿沟对齐、多模型接口协议等关键实践问题,为构建稳定可靠的AI Agent提供可复用的模型选型框架与排障路径。

weixin_33736048的博客 396

智能代码搜索代理:用强化学习让AI理解开发者意图

代码搜索是软件开发中的基础环节,传统基于关键词匹配的方法难以理解代码语义和开发者真实意图。其原理在于仅进行文本匹配,缺乏对代码逻辑和上下文的深度理解。随着大语言模型和强化学习技术的发展,智能代码搜索代理应运而生,它通过将代码库建模为知识图谱,让AI智能体学习导航策略,实现从“找代码”到“懂意图”的跨越。这项技术的核心价值在于大幅提升研发效能,减少开发者在海量代码中筛选的时间。其应用场景包括大型项目代码导航、遗留系统理解和跨语言代码检索等。本文以CodeScout框架为例,深入探讨了如何利用强化学习训练代码搜

weixin_34007886的博客 304

人工智能训练师三级·大模型应用真题40题|Prompt→RAG→PEFT微一站搞定

思维链(Chain of Thought, CoT)是一种Prompt技术,通过引导模型输出中间推理步骤来提升复杂任务的表现。它之所以有效,是因为大模型的"直接输出"容易跳步出错,而"分步思考"可以激活模型的推理能力,让每一步推导都有依据。CoT特别适合数学推理、逻辑题、多步决策等需要逐步推导的任务,是Prompt工程中提升复杂任务准确率最有效的技术之一。

白话机器学习 65

【信息科学与工程学】【人工智能】第一篇 人工智能算法知识库01

编号格式说明示例数量分配​8位数字,前2位主类,中间2位子类,后4位序号99,999,999个。

weixin_49199313的博客 1877

大模型提示工程实战:从Chain-of-Thought到DSPy的演进与落地

提示工程是大模型时代最基础的人机协作接口,本质是通过自然语言引导模型激活预训练知识、显化推理路径并约束输出行为。其技术演进遵循‘可控性提升→可解释性增强→工程化升级’逻辑:Zero-Shot依赖模式匹配但缺乏控制;Few-Shot借助上下文学习实现任务对齐;Chain-of-Thought将黑箱推理转化为可审计步骤;Tree-of-Thoughts引入搜索空间提升复杂问题求解鲁棒性;ReAct突破文本边界支持工具调用;而DSPy则完成范式跃迁,将提示升维为可编译、可复用、可移植的程序模块。本文结合12个真实

weixin_33755649的博客 554

使用python排八字 计算八字的相合相冲五行分值等 ...

简介 八字术是一种古老的算命术。它运用阴阳、五行、干支、八卦等理论,把人的出生年月日时转化为八个字,进而推算人的富贵贫贱、祸福吉凶、穷通寿天、名利地位、家庭六亲等方面的情况 八字源自古代的中国,是一种利用天干和地支来准确记录年、月、日、时的方式,由“年干,年支”、“月干,月支”、“日干,日支”、“时干,时支”,共八个干支所组成(共八个字),年、月、日、时...

weixin_33717298的博客 5310
上一篇: PostgreSQL 日报|PG19 外键快速路径隐患已修复(8 月 23 日)
下一篇: PostgreSQL 日报|复制槽与分区索引缺陷修复推进(8 月 25 日)
IvorySQL
博客等级 码龄5年 745粉丝 566原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值