PG19 要来了!内核级 REPACK + 原生图查询,HOW2026 大咖提前剧透

PostgreSQL 19新特性:INSERT ON CONFLICT DO SELECT语法解析 数据库的冲突处理是数据同步和ETL流程中的常见挑战。PostgreSQL通过其独特的ON CONFLICT语法提供了灵活的冲突解决机制,最新版本19引入的DO SELECT子句进一步增强了这一功能。该技术允许开发者在批量插入操作中精确识别冲突记录,解决了传统方法无法获取具体冲突数据的痛点。在数据仓库加载、用户画像更新等场景中,这种原子化的冲突处理能显著提升性能,测试显示在某些情况下可减少26%的执行时间。结合CTE和RETURNING子句,新语法为复杂的数据合并操作提供了更简洁高效的实现方式,是Postgr 阅读详情

PostgreSQL 的每一次版本迭代都为开发者和企业带来令人期待的技术突破。从去年发布的 PG 18 到即将到来的 PG 19,新特性层出不穷——异步 I/O 让云上性能飞跃,内核级 REPACK 解决表膨胀痛点,图查询能力为 AI 时代铺路。但面对如此多的更新,哪些特性真正值得关注?企业什么时候该升级?如何参与到这个充满活力的开源社区?

「YOLANDA 科技见闻」独家专访 HOW 2026(开源生态大会暨 PostgreSQL 高峰论坛)三位深耕 PG 多年的技术专家,IvorySQL 专家顾问委员、PostgreSQL ACED、前阿里云数据库高级专家德哥,云和恩墨高级数据库技术顾问、IvorySQL 专家顾问委员彭冲,PostgreSQL ACE、PG 分会西安用户组主席杨向博,墨创数迹创始人汪丹(Yolanda)主持,共同为你解读 PG 18 的“真香”时刻,前瞻 PG 19 的重磅更新,并分享实用的企业升级策略与社区贡献指南。

划重点:

  1. PG 的每一次大版本发布,都是令人惊喜的。它不是简单的修修补补,而是有很多亮眼的新特性,真实解决了很多痛点问题。
  2. PG 的进化不是激进的,而是务实的。社区的严苛性保证了稳定性,插件生态验证了需求,内核化完成了收敛。这是 PG 独特的进化路径。
  3. PG 不会为了追求新特性而牺牲稳定性,也不会因为保守而拒绝变化。其丰富插件的可扩展性优势,让很多东西可以像搭积木一样实现。
  4. 从 PG 18 的异步 I/O 支持、统计信息保留,到 PG 19 的 REPACK 内核化、图查询引入,我们看到了未来数据库的更多可能性。
  5. 企业什么时候应该升级新版本?没有最好的版本,只有最合适的版本。不为升级而升级,只为解决真问题。
  6. PG 社区开放包容,社区贡献没有标准答案。从报 Bug 到写插件,从文章分享到内核提交,每一个声音都能成为 PG 进化的一部分。从小处着手,向内核生长。

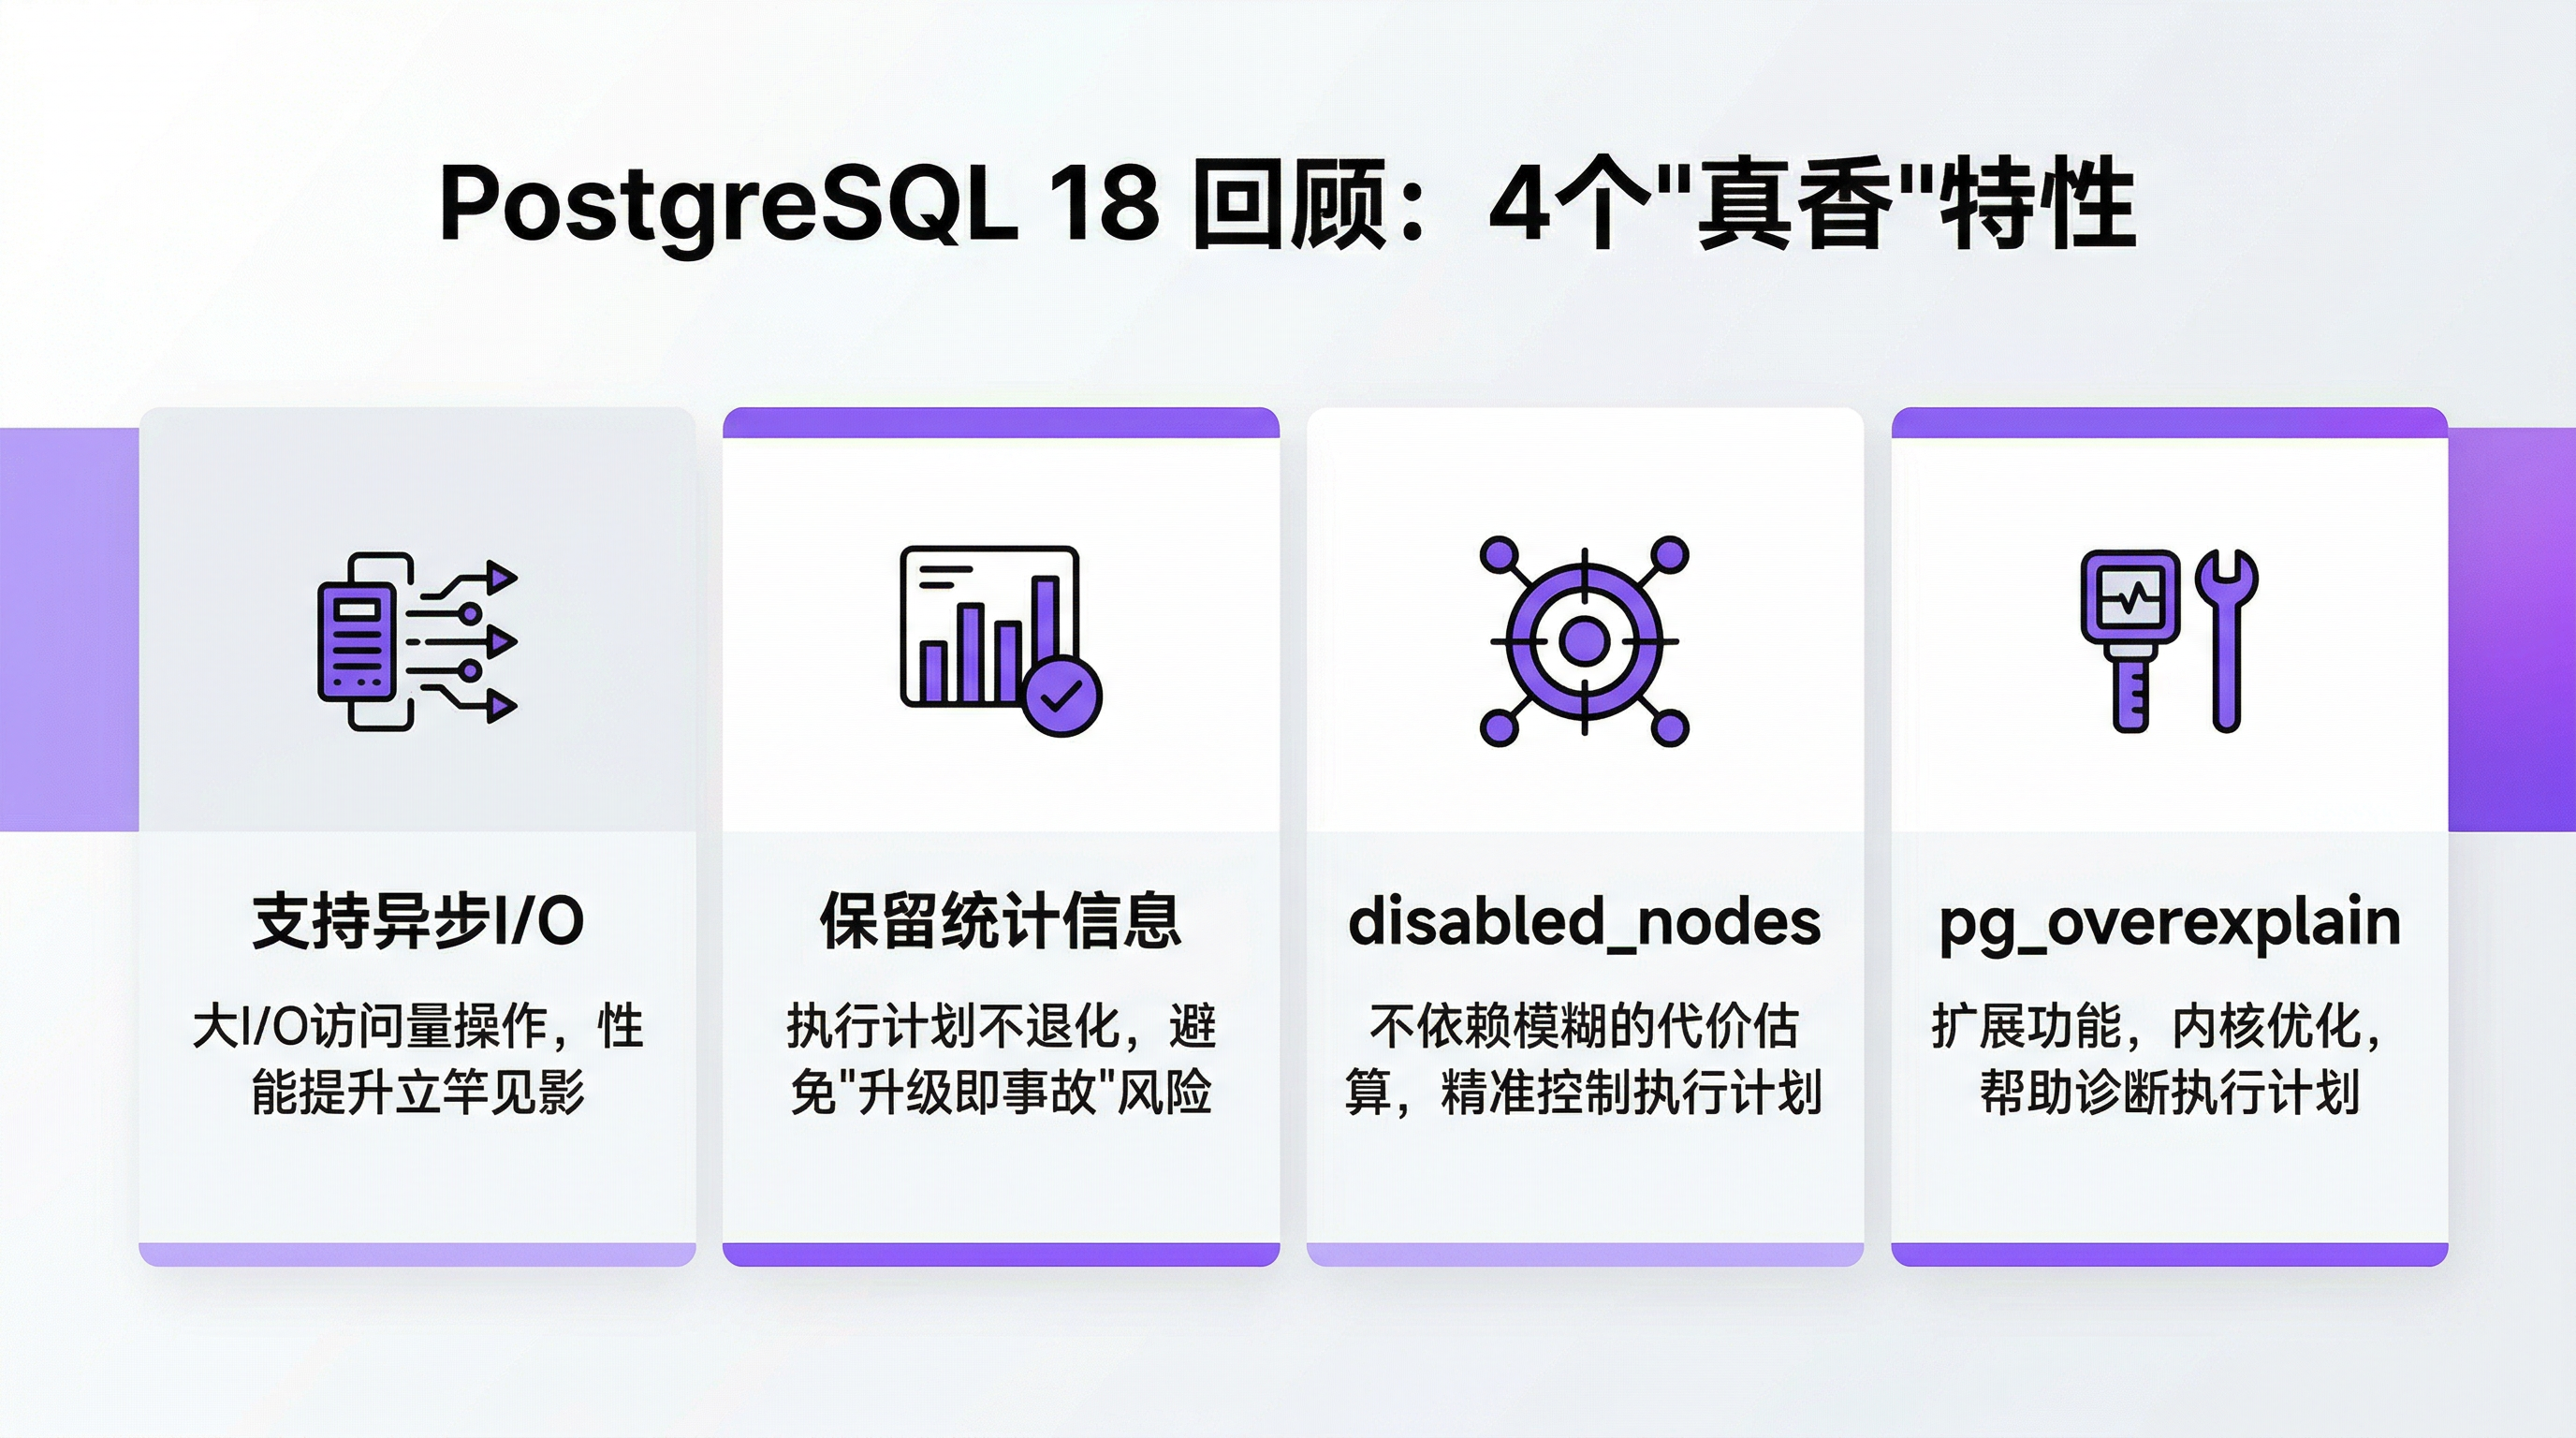
PostgreSQL 18 回顾:4 个“真香”特性

01 支持异步 I/O

让德哥觉得“真香”的第一个能力是 PG 18 支持了异步 I/O。
现在很多数据库是跑在云上的,云上数据库和线下部署完全是两回事。在本地部署中,数据库直接访问 SSD,I/O 延迟通常在微秒级别。但云上存储会用云盘,云盘底层要通过网络去访问,网络延迟相较于本地部署会高很多。像创建索引、垃圾回收、大表扫描、分析型查询等大 I/O 访问量操作,在 PG 18 之前都使用同步 I/O,数据库进程的大量时间都耗费在网络等待上。PG 18 支持异步 I/O 子系统改变了这个局面,这些大 I/O 访问操作的性能提升立竿见影。

02 保留统计信息

德哥分享的第二个特性和大版本升级有关,可能应用不多,但非常有价值,比如云厂商就会比较激进地提供大版本升级能力。一般来说,大版本升级有两种方式,一种是通过逻辑复制,复制后做切换,不过这种方式有比较严苛的适应场景,要求所有表都要有主键,同步过程中一些不可抗因素也会导致切换后数据不一致。

另外一种是通过 pg_upgrade 直接导出元数据,然后在大版本上面导入新的元数据,这种方式被诟病的地方就是统计信息导不过去,如果升级之后立马开放给用户使用,执行计划就可能不准确。特别是如果遇到业务高峰,或者有一些乱查询,由于没有统计信息往往导致执行计划不准,这种请求多起来的话,很可能带来雪崩效应。PG 18 引入了保留统计信息的能力,彻底解决了这个问题。执行计划不会因为升级而退化,避免了“升级即事故”的风险,这对于无法承受长时间维护窗口的企业级应用来说,是一个质的飞跃。

03 disabled_nodes,精准控制执行计划

向博分享了一个可能会被大家忽略掉、但站在 DBA 角度看非常有用的特性。具体来说,就是 SQL 执行计划会跑偏,这是一个让 DBA 很头疼的问题。怎么办呢?对于一些可以改 SQL 的业务来说,可以走逻辑优化的路径。但对于很多 SaaS 业务,定制化 SQL 改不了,一般就用 hint 提示的手段去做执行计划的修正。

可能会遇到这样的场景:当你指定一个表走更优的索引时,有时会发现它不但没走索引,反而走了顺序扫描。这个路径是怎么被选出来的?PG 17 及以前版本通过disable_cost给一个路径的启动代价加上一个 100 亿的常量值,以此来干预路径选择,方式“粗暴且不优雅”,当多个路径都被加上这个巨大的常量后,原本差距明显的路径可能只相差 1%,它们之间的相对差异反而变得模糊,可能导致干预失效,最终选错了路径。

PG 18 完全去掉了disable_cost这个历史包袱,把它转化成disabled_nodes,一个 int 值,默认为 0,当你禁用一个设置时,对应路径的 node 值加 1,并且这个值会层层向上传递。这样,就可以精确地比较不同路径的干预程度,而不是依赖模糊的代价估算,能更精准地控制执行计划。

04 pg_overexplain,诊断执行计划

彭冲补充了一个和执行计划相关的特性,这是 PG 18 引入的一个扩展功能,pg_overexplain,以一种更结构化、更精准的方式,输出深藏在内核数据结构中的信息,用来深度剖析优化器的内部决策过程,做一些内核相关的优化,可以帮助诊断执行计划。
1.png

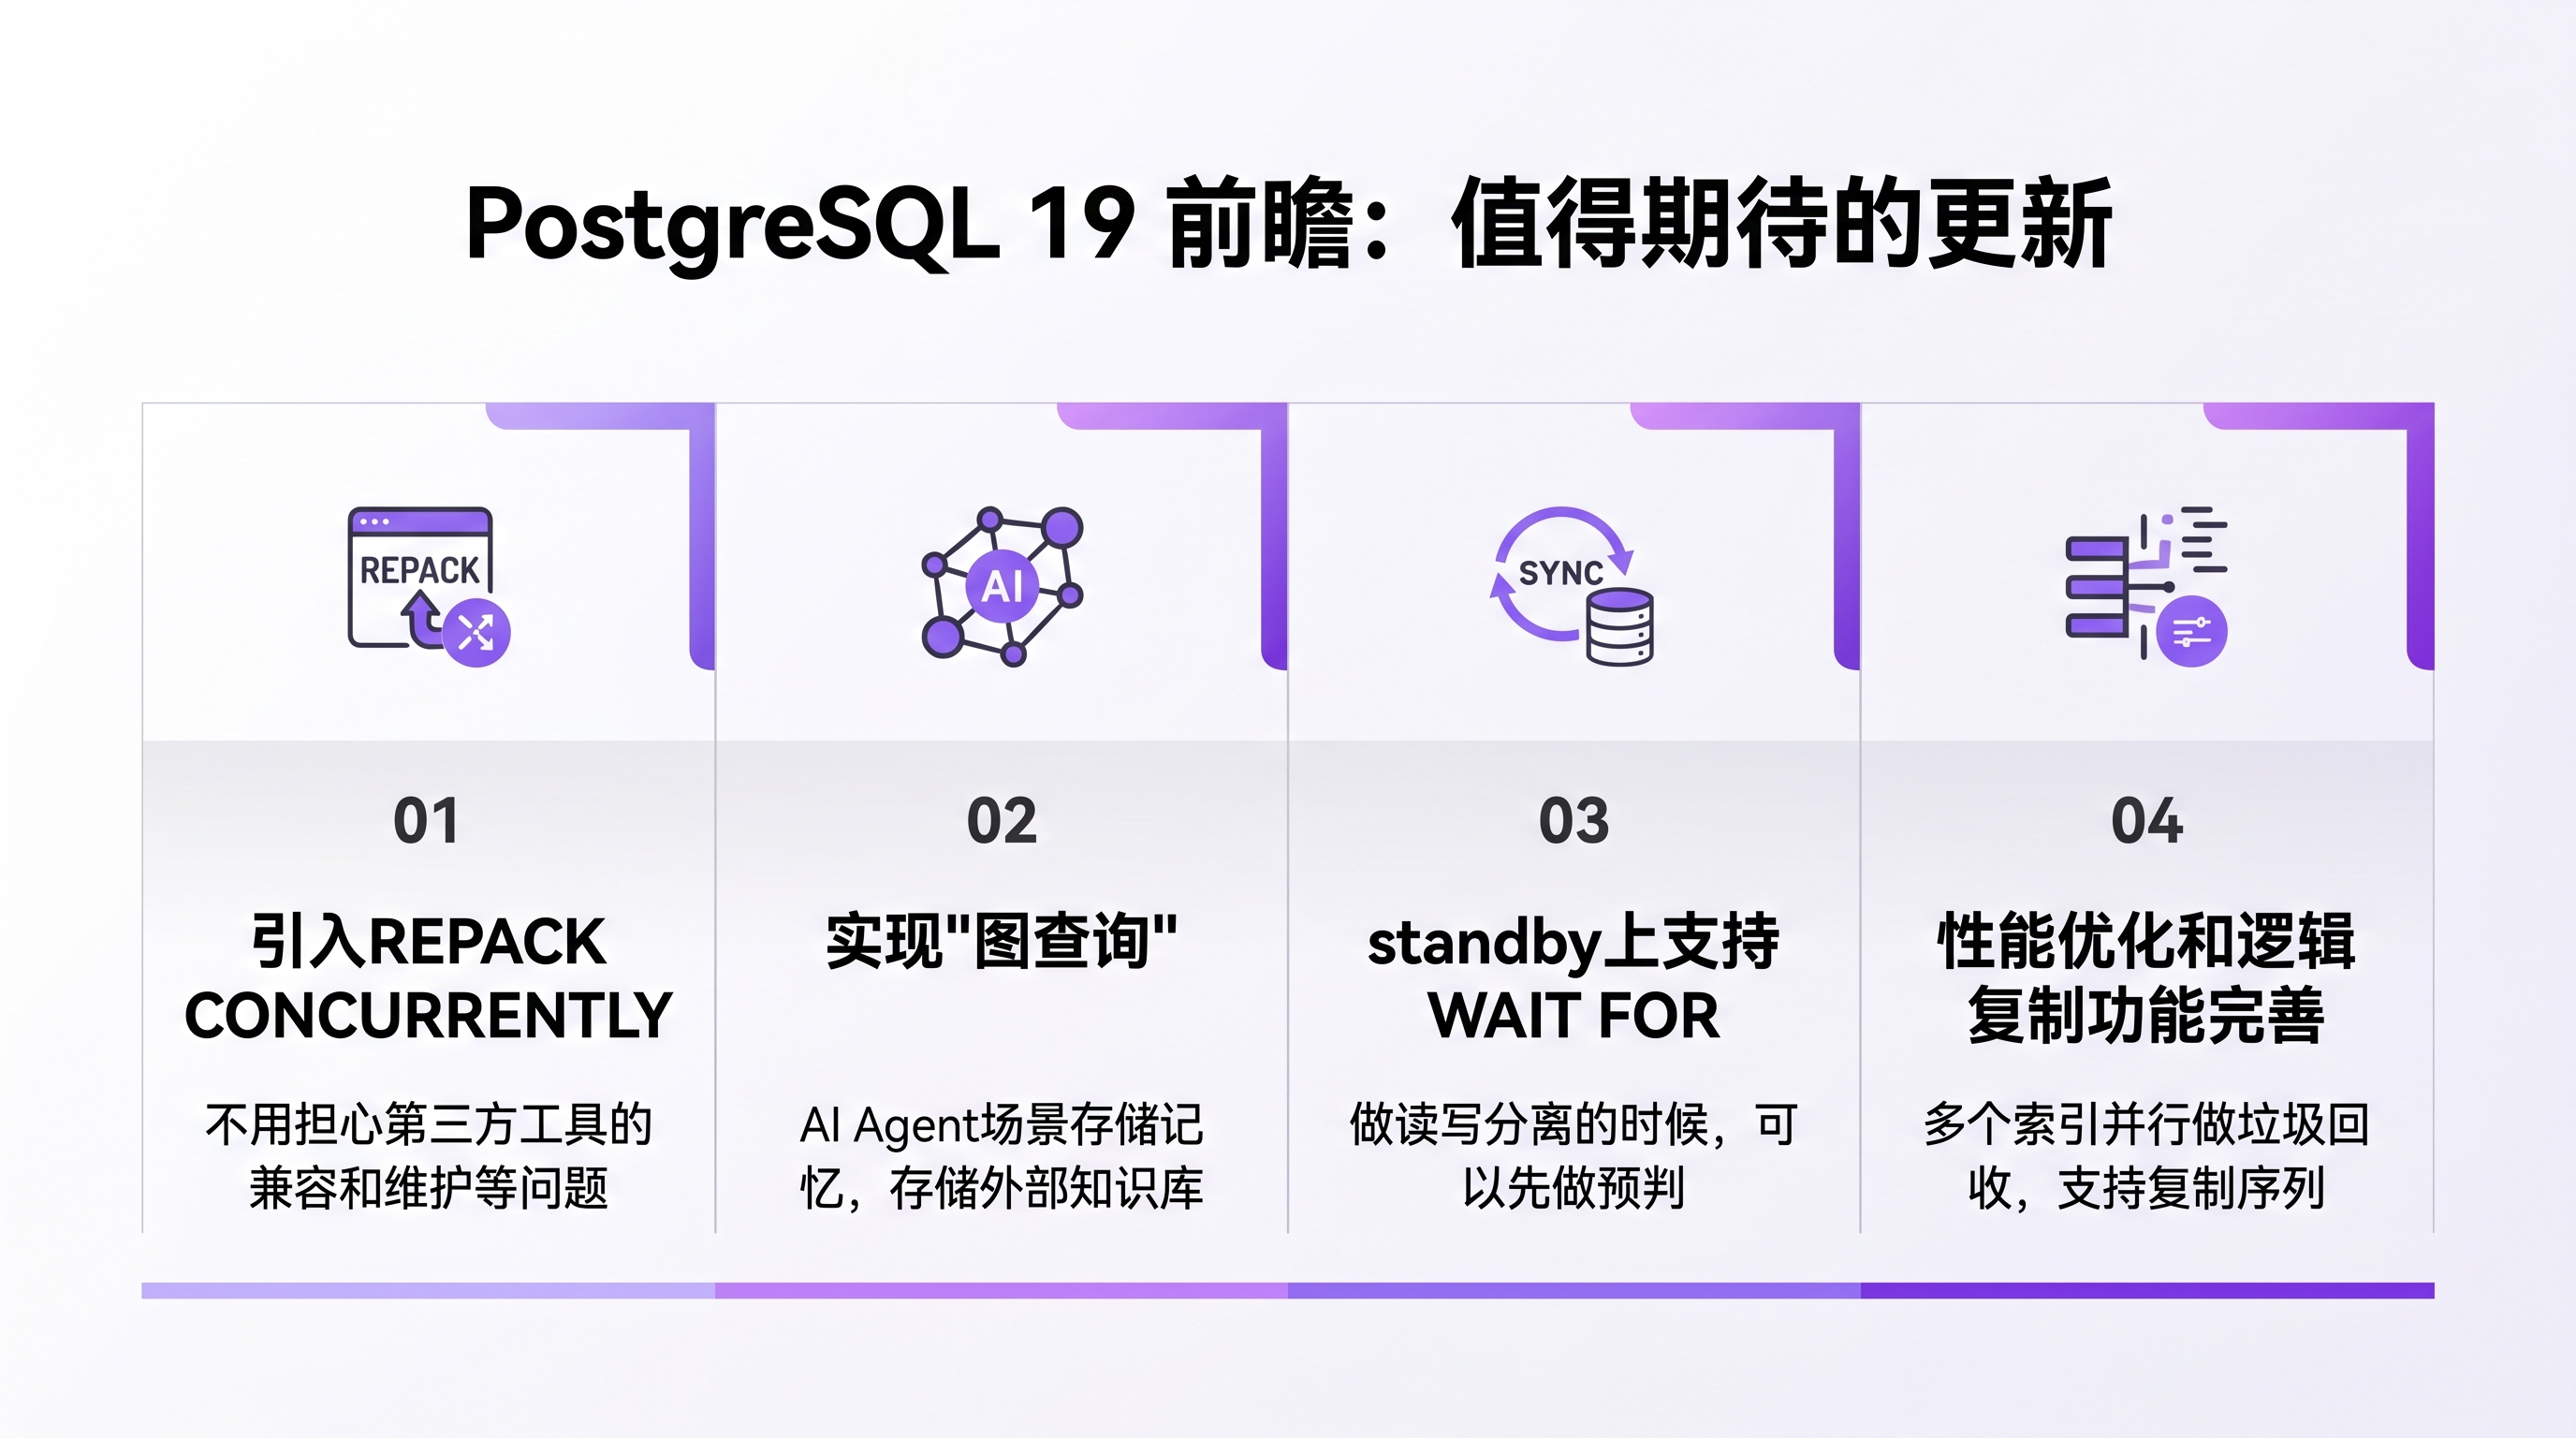
PostgreSQL 19 前瞻:值得期待的更新

对于 PG19,德哥一直在跟进它的 Git 提交记录,从 2600 多个 Commits 中筛选了好几道,最开始筛出来 100 多个,觉得都特别有价值,德哥重点分享了几个对他来说冲击比较大的新能力。

01 引入 REPACK CONCURRENTLY

使用 PG 的一个痛点就是它的事务 ID 只有 32 位,容易用完,所以必须不断地做“冻结”操作。另外就是 PG 的存储引擎,没有 Undo 回滚段,所有垃圾都放在数据文件里,和正常的数据放在一起,就要不断地做垃圾回收。一旦表膨胀了就会很麻烦,特别是在云服务里,存储都得额外算钱,那每月的账单就要滴血,压缩膨胀空间就很关键。怎么办?原来是通过第三方的pg_repack插件来解决,PG 19 把REPACK CONCURRENTLY做到内核里来了。以后我们就可以很放心地使用REPACK CONCURRENTLY了,不用担心第三方工具的兼容和维护等问题,这是一个极大的利好。

02 实现“图查询”

AI 时代,图查询是一个非常重要的特性。比如我们使用 Agent 的时候,使用越多,它堆积的记忆就越多,包括 Agent 去连接各种外部知识库,这些数据也非常复杂。以前 PG 只能提供一些向量搜索、关键词搜索、全文检索,但实际上来看,知识很多时候是树状结构的,也就是图结构。这时候,很多企业可能会选择额外再搭一套图数据库,就会导致一些数据可能是重复的,浪费企业资源。

PG 19 终于把图查询的功能引进来了,在 AI 场景存储记忆、存储外部知识库,这是一个很有必要的、很高级功能。德哥相信,将来的 AI 应用在使用数据库的时候,都可能把这块功能给用起来。

03 standby 上支持 WAIT FOR

比如读写分离场景,当业务要求只读查询和之前写入变更的事务之间必须有一个前后顺序,很多时候我们的查询不能发到只读库,因为不知道只读库回放到什么时候了,有没有把之前的修改回放过去,这种情况下,压力还是得压到主节点。

PG 19 有了 WAIT FOR,当我们做读写分离的时候,可以先做预判,判断一个只读节点是否已经同步了之前写入的事务,检查回放进度 LSN,回放到了,就把后面的请求转发给这些只读节点。这是一个很好的特性,值得我们持续关注后续应用。

04 一些“补丁”能力:VACUUM 性能优化和逻辑复制功能完善

当一个表有很多索引时,特别是大表,以前每个索引是顺序地(一个一个)做垃圾回收,PG 19 的autovacuum可以并行地对多个索引同时做垃圾回收,这能大大缩短垃圾回收的总时间。

对于逻辑复制功能,不支持复制序列(SEQUENCE),在 PG 19 里这个功能也补充上了。
2.jpeg

企业升级策略:痛点驱动升级

PG 19 要来了,不过很多用户使用比较多的版本还是 PG16、PG17,大家对于新版本用得还不多,毕竟在生产环境下需要一个小心谨慎的态度。具体什么时候应该升级?怎么用好新版本的能力?三位专家也根据具体场景给出了一些升级建议。

场景 1:云部署 + 大 I/O 操作

  • 如果你的数据库跑在云盘上,且有频繁的索引创建、垃圾回收、大表扫描
  • 建议升级 PG 18,异步 I/O 带来巨大的性能提升

场景 2:表膨胀困扰

  • 如果你的表经常膨胀,存储成本高,查询性能下降
  • 建议等待 PG 19,内核级 REPACK 更稳定,更放心

场景 3:信创 + 跨 CPU 架构

  • 如果你有信创需求,需要在 ARM 和 x86 之间做流复制或迁移
  • 建议升级 PG 17/18,提供内置的字符比较、排序比较,兼容性处理

场景 4: AI 应用(Agent) + 知识图谱

  • 如果你在构建 AI Agent,需要存储记忆、知识图谱;需要单独维护图数据库,数据同步复杂
  • 建议等待 PG 19,图查询是标配能力,原生支持图查询,统一数据平面

具体场景挑战很多,比如逻辑复制引起磁盘堆积问题、数据库拷贝难题、外部表安全问题等等,根据自身业务的痛点和 PG 版本能力做匹配,是一种可靠的判断逻辑。

另外,对于升级原则,德哥还分享了一个他的思路。对于相对传统一点的企业,如果业务迭代速度或者变化节奏不是特别快,不用太着急去升级,遇到特别大的痛点,新版本能很好解决,这时候再考虑升级。对于业务本身变化极快的企业,可以考虑更快地使用新版本带来的新特性,比如 PG 19 的图查询能力,可以给 AI Agent 相关的业务带来极大助力,帮助提升应用的竞争力,那就可以偏激进一点去使用新版本。

多元的社区贡献指南:成长于社区,贡献于社区

PG 社区对新人非常友好,包容性强,那如何更好地在社区做共享?怎样参与到 PG 下一个版本的新特性开发中?三位深耕于 PG 社区多年的专家分享了他们的经验与建议。

  1. 从报 Bug 开始:从使用者的角度,如果发现了 Bug,直接在 PG 官网按照模板提交。重要提醒:一定要写清楚信息,包括详细的环境信息(比如版本号、操作系统、硬件配置),这个问题你是怎么复现的等等。如果只是填了一段报错上去,沟通效率会比较低。
  2. 写插件:一上来就参加内核贡献,门槛还是稍微高了一点。PG 的插件生态非常广,可以从插件入手。有什么好点子,或者在使用过程中遇到了一些问题,也许写插件就能解决,那就先快速写出来,也可以利用好 AI 工具来帮助实现。比如可以写一些巡检脚本,或者写一些 Skills。等插件成熟了,社区可能会考虑将其引入内核。
  3. 写文章做分享:写文章也是贡献,比如可以从实际的案例出发,分享故障解决经验、自己的思考和心得等等。
  4. 内核贡献三步法:第一步,观察社区的沟通方式。先去邮件列表里边看大家是怎样交流沟通的,了解 Bug List,观察代码风格,把这个流程或者大家的习惯梳理清楚。第二步,从小问题入手。可以从社区现有的 Bug List 里找痛点,先去解决好一个具体的小问题。第三步,大胆提交,接受反馈。PG 社区对新手特别友好,大佬们非常包容,不过 PG 的代码审查很严苛,要有心理准备,被拒绝是正常的,每一次反馈都是学习机会。

结语:PostgreSQL 的进化哲学

从 PG 18 到 PG 19,PostgreSQL 的每一个特性都经历了反复讨论与充分验证。PG 不追求激进的创新,而是在稳定性的基石上,稳步演进至最佳实践。这种务实的进化哲学,或许正是 AI 时代我们真正需要的。PG 19 将成为一个新的起点,未来,AI 时代下数据库的更多可能性、更令人激动的篇章,值得共同期待。

SpringBoot+Vue+MySQL 高校学科竞赛平台 完整可运行版(源码+文档) 本项目基于SpringBoot+Vue+MySQL构建高校学科竞赛管理平台,覆盖学生、教师、领队教师、管理员四大角色,实现竞赛发布、报名、刷题、评分、公示等全流程闭环管理。系统架构清晰,技术主流,配套完整源码、数据库脚本、万字论文、开题报告、答辩PPT及部署文档,支持一键运行,适用于毕业设计、课程设计及院系二次开发,真正实现“开箱即用”。 阅读详情

相关推荐

使用BK3432芯片进行蓝牙开发的详细指南:编程手册与实际应用

BK3432是一款蓝牙4.2双模式芯片,支持蓝牙低功耗(BLE)和经典蓝牙(BR/EDR)模式。它集成了高性能的RF收发器、基带处理器、ARM9E内核、丰富的功能外设单元,并支持BLE应用的可编程协议和概要文件。蓝牙版本:4.2数据速率:最高支持2Mbps内核:ARM9ERF收发器:高性能、低功耗外设单元:包括UART、SPI、I2C、GPIO等功耗:超低功耗设计,适合电池供电的应用。

m0_57781768的博客 4456

PG 日报|PG19 新增分散式检查点

pgEdge AI 知识库构建器完成了一次重要架构调整,原先将所有模型的预计算嵌入存储在同一个 SQLite 文件中,每个模型对应一组列,随着模型和内容增多,文件体积持续膨胀,即便用不到的模型数据也一并占用空间。受影响的用户在周五登录系统时,发现自己被估算欠下巨额费用,引发广泛震惊。Fujii Masao 指出,在非 assert 构建中,若调用方传入错误的 buffer,可能会静默修改错误的 VM 页面,尤其是该提交扩大了调用方数量并将该函数引入 WAL redo 路径,存在一定安全隐患。

IvorySQL的博客 302

多智能体强化学习论文——SEAC(NIPS 2020)

存在的问题&研究动机&研究思路 在稀疏奖励的环境下,多智能体的exploration存在效率不足等问题。 在IAC的基础上尝试加入重要性采样,使得每次更新智能体iii的参数时,不再仅仅使用智能体iii的数据,而是使用所有智能体的数据进行智能体iii数据的更新。 对于原始的IAC算法是on-policy的,而SEAC则是off-poligy的。 创新点 在每个智能体iii的actoriactor_iactori​和criticicritic_icritici​的更新过程中,都加入了重要性

我的AI笔记 1207

PostgreSQL 19分散式检查点:多核时代下的刷脏机制重构

检查点是数据库保障ACID与崩溃恢复的核心机制,其本质是协调WAL日志、共享缓冲区脏页刷写与持久化的一致性过程。传统集中式检查点依赖全局锁、全量扫描和WAL位置阈值触发,在多核CPU、NVMe SSD和大内存环境下易引发I/O毛刺、尾延迟飙升与资源争用。PG19引入的分散式检查点并非功能增强,而是对刷脏节奏、执行主体、范围判定和状态快照四层逻辑的解耦重构,通过WAL分区、多角色写进程协同、页面生命周期感知与增量快照等关键技术,实现从‘定时爆破’到‘持续滴灌’的范式升级。该机制显著提升OLTP场景下P99延迟

weixin_32612263的博客 354

【随机过程】 3 - 随机过程的频域分析1 - 功率谱

随机过程的频域分析 文章目录随机过程的频域分析1. 什么是谱2. 确定信号的频谱2.1 周期信号的频谱2.2 非周期信号的频谱3. 随机信号的谱3.1 随机信号做傅里叶分析的困难3.2 功率谱密度的物理和数学表示形式3.2.1 功率谱密度的物理表示3.2.2 功率谱密度的数学表示3.3 功率谱密度的解读3.3.1 量纲分析3.3.2 谱3.3.3 密度3.3.4 wiener和khinchin3.4 功率谱密度的性质3.4.1 非线性3.4.2 偶函数3.5 wiener-khinchin关系的应用3.6

qq_41741344的博客 3133

Qwen-Image LoRA训练实战:从数据准备到异常修复的全流程解析

本文详细解析了Qwen-Image LoRA训练的全流程,从数据准备到参数优化再到异常修复。通过实战案例展示了如何利用LoRA技术微调Qwen-Image模型,提升中文场景下的图像生成质量,特别针对手脚生成异常等问题提供了有效解决方案。文章还分享了中文提示词优化技巧和高级训练方法,帮助开发者高效训练出高质量的LoRA模型。

lemon的博客 969

PostgreSQL 19 New Features

可以将现有的关系表暴露为属性图,并使用模式匹配语法进行遍历,从而消除了大多数工作负载对独立图数据库的需求。与嵌入在 SQL 注释中的 Oracle 或 MySQL 提示不同,建议存在于 GUC 设置中,并包含一个反馈机制,告诉你每个提示是否被采纳。每个工作者处理一个索引。对于 4 个工作者和 5 个索引,索引清理阶段完成的时间大约等于最大的单个索引所需的时间,而不是五个索引的总和。暴露了更多细节,并且按进程类型的日志记录允许你提高 autovacuum 或归档器的详细程度,而不会让日志的其他部分泛滥成灾。

mirana的专栏 896

QGIS基于快鸟(QuickBird)影像统计小麦种植面积

​01数据情况 本次选用某地4月份快鸟(QuickBird)影像为例,使用QGIS演示提取小麦播种情况,并按照200米*200米分区计算种植面积的过程。 注:本文对应的操作视频作为今天第二篇推送同时发布,习惯看视频的朋友可以点击观看。 附数据压缩包: 链接:https://pan.baidu.com/s/1JVUS8uAOR61RxC1n9Or9_w 提取码:qgis 含快鸟影像QB_subset.tif和200*200米分区矢量图层200Mgrid.shp。 ...

QGISClass的博客 1980

DeepSeek总结的PostgreSQL 19 中的 SQL/PGQ:无需图数据库的图查询

PostgreSQL 19 引入了 SQL/PGQ 标准的实现,通过 GRAPH_TABLE 功能允许用户在关系表上定义属性图并执行图查询。该功能将图模式重写为关系连接,利用现有索引和优化器,适合处理浅层固定深度的图查询(如社交网络分析),性能与传统 SQL 连接相当。但对于深层可变长度遍历(如六度分隔),由于缺乏专用图数据库的"免索引邻接"优化,PostgreSQL 仍不具优势。这一特性降低了图查询的语法门槛,使得原本复杂的关系分析(如权限审计、数据血缘追踪)更易实现,扩展了关系数据库的实用场景。

l1t的专栏 482

✨从零搭建 Ubuntu22.04 + Python3.11 + PyTorch2.5.1 GPU Docker 镜像并上传 Docker Hub

构建一个带 GPU 支持的深度学习开发镜像;使用 PyTorch 2.5.1(CUDA 12.4)环境;发布并托管 Docker 镜像至 Docker Hub;验证 GPU 环境正常运行!🎉 这将极大提升你的项目部署效率,尤其是在多人协作或跨平台部署场景中。

用大模型重构生活:猫奴程序员的AI智能日常记录 1581

Jenkins离线安装保姆级教程:从下载.war包到SVN+Maven项目一键部署(附避坑脚本)

本文详细介绍了Jenkins离线安装的全流程,包括.war包下载、SVN+Maven项目配置及自动化部署。特别针对内网环境提供解决方案,涵盖插件管理、开发工具链配置、构建触发器和SSH部署等关键步骤,帮助企业在网络隔离环境下实现高效持续集成。

weixin_30096975的博客 375

PostgreSQL 日报|PG19 路由 ON CONFLICT 插入故障(9 月 1 日)

Matthias van de Meent 提交了一组补丁,旨在通过对具有相同键定义的索引共享 rd_opfamily、rd_opcintype、rd_support、rd_supportinfo 等字段进行去重,降低 relcache 的内存占用。补丁集还包含一个由 Andres 编写、Matthias 整理的 ProxyContext 内存分配器,该分…

IvorySQL的博客 427

tsfknn 预测R语言中的时间序列

rolling参数应该设置为FALSE,这使得最后的18个观测值成为测试集,其余的作为训练集;如果我们将rolling参数设置为默认值TRUE,那么测试集就不会是一个恒定的向量。lag 滞后参数表示时间序列数据的滞后值。在这个例子中,由于我们的时间序列数据是月度的,我们将参数设置为1:12。作为药品福利计划的一部分,澳大利亚健康保险委员会记录的属于ATC代码A10的产品的每月政府支出(百万美元)。我们将使用tsfknn包,它可以用来预测R语言中的时间序列。格式:ts类别的月度时间序列。

Mrrunsen的博客 325

YaRN论文复现:用pg19数据集训练超长文本模型的完整流程

YaRN(Yet Another RoPE Extension)是一项高效扩展大语言模型上下文窗口的技术,能够让模型处理远超原始设计长度的文本序列。本文将详细介绍如何使用pg19数据集复现YaRN论文中的超长文本模型训练流程,帮助AI开发者快速掌握这一先进技术。 ## 准备工作:环境与数据集准备 ### 1. 克隆项目仓库 首先需要获取YaRN项目源码,执行以下命令克隆仓库: ```bas

gitblog_00206的博客 1332

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

PostgreSQL 19 212 项更新中的几个“承重级”改进

4 月 15 日,Bruce Momjian 发布了 PostgreSQL 19 首版 Release Notes 草案。按照统计,本次版本共包含 212 项更新。Feature Freeze 已于 4 月 8 日完成,Beta 1 预计将在下个月发布,正式版则计划于今年 9 月上线。212 项更新,数量看起来非常惊人,但对于生产环境而言,更值得关注的是:哪些更新,会真正影响 PostgreSQL 在生产环境中的运维与管理?PostgreSQL 19 版本核心定位为。

IvorySQL的博客 507

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

PG 日报|PG19 原生支持数据血缘溯源,一键厘清报表数据来源

Fujitsu 的 PostgreSQL 团队在 PostgreSQL 19 的开发周期中持续贡献代码,重点改进了逻辑复制相关功能,并在社区中获得了一定认可。该文章回顾了团队在本次版本中主导或参与开发的具体技术变更,体现了 Fujitsu 对 PostgreSQL 开源开发的长期投入与影响力。Pavlo Golub 发布了一期新的大会 Vlog,记录了在芝加哥举办的 PG DATA 2026 大会。时存在的竞争条件问题,已完成审查并提交。在处理依赖外部服务器的非超级用户订阅时可能失败的问题。

IvorySQL的博客 209

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

专家解读:PG 18“真香”特性 + PG 19 重磅更新 + 企业升级策略 + 社区贡献指南

PostgreSQL 的每一次版本迭代都为开发者和企业带来令人期待的技术突破。从去年发布的 PG 18 到即将到来的 PG 19,新特性层出不穷——异步 I/O 让云上性能飞跃,内核级 REPACK 解决表膨胀痛点,图查询能力为 AI 时代铺路。但面对如此多的更新,哪些特性真正值得关注?企业什么时候该升级?如何参与到这个充满活力的开源社区?

猫头虎技术团队:授渔优于赠鱼,兴趣引领智慧,探索之乐尤显珍贵。商务合作+:Libin9iOak ,万粉变现+:优快云WF,猫头虎承诺每年免费为100名C站创作者做账号流量诊断服务!全网搜:猫头虎技术团队,点击文章底部名片或直接私信我一切皆可谈,快找虎哥! 8989

linux学习

sudo make install:组装好的家具(编译好的库文件),原本放在你的临时工作区。坏处是,你的程序体积会变大。于是,他会根据你的计划书,结合你电脑的当前情况(比如装了什么编译器,库在哪),生成一本极度详细的《施工进度表》。很多大牌的第三方库(比如你刚装的 libevent)为了照顾不同的需求,会同时提供动态库(.so)和静态库(.a),但并不是所有库都这样。只有动态库:常见于系统的核心库(比如你系统的底层 C 库),或者一些商业闭源软件(厂商只给你一个黑盒子,不让你直接把代码打包进你的程序)。

d_mail的博客 194

ubuntu 偶发启动失败问题分析

ubuntu 系统启动偶发异常问题分析

平面到立体 193

177.Agent-LangGraph-MCP的构成说明

MCP架构通过MCP主机、客户端与服务器的协同,实现工具、资源与提示词的统一管理。MCP服务器提供Tools、Resources、Prompts能力,MCP客户端则负责发现、调用与读取,使Agent可按需获取上下文。其核心在于将工具从Agent中抽离,封装为可复用的服务,提升灵活性与可维护性,推动AI应用高效协作。

计算机王的博客 289

Docker Compose:搭建本地多服务开发环境

从一个 Java API、PostgreSQL 和 Redis 开始,配置服务名、端口、环境变量、健康检查、数据卷和依赖关系。理解 Compose 文件如何被解析、项目如何隔离,以及哪些数据不能依赖“重建容器”保留,能够把个人开发环境整理成团队可复用的启动入口。

m0_62221377的博客 477

AI全栈实战 | 3.9-01 爬虫入门:requests 加 BeautifulSoup 三分钟跑通,但 90% 的人栽在这 4 个“礼貌“问题上

⚠️:本文内容仅用于。请遵守目标站点的服务条款与相关法律法规,不得对目标服务造成负担,不得采集、传播个人隐私数据。技术是中性的,边界在你手里。爬虫的入门技术(requests 发请求 + BeautifulSoup 解析)三分钟就能学会。真正区分"会用爬虫"和"会做爬虫的人"的,是这篇我们跑通"请求→解析→存储"的最小闭环,然后重点把"合规与礼貌"这根弦给你绷上。

源码获取 | 运行部署 | 定制二开修改,如果回复不及时请耐心等待,请见谅。 436

【基于 WebSocket 的多用户网页五子棋】—— 数据管理模块

但行好事,莫问前程

qq_42996461的博客 251

OpenClaw 深度调查:把 AI 助手做成你自己的控制平面

对 openclaw/openclaw 的完整技术尽调:Gateway 架构、Agent 运行时、工具与沙箱、30 个消息通道、181 个插件、安全信任边界、工程代价与采用建议。17 章 / 10 张图,全部数字标注口径,数据截至 2026-10-31。

厚积薄发 300

IDEA 简介:从零认识 IntelliJ IDEA

IDEA 全称,是由 JetBrains 公司开发的一款主流 Java 集成开发环境(IDE)。它集代码编辑、编译、调试、测试、版本控制、构建管理等功能于一体,被大量 Java 开发者视为日常开发的首选工具。所谓 IDE(Integrated Development Environment,集成开发环境),就是把写代码所需的各类工具整合到同一个界面中。相比只用文本编辑器加命令行编译,IDE 能显著减少重复操作,让开发者把精力集中在业务逻辑上。

ztI10的博客 178

TransactionInactiveError:await 之后事务已经不活跃了

TransactionInactiveError 出现于 IndexedDB 事务已结束(非 active 状态)时调用 put、get 等操作。常见于 await 后或 setTimeout 中执行请求,因任务已完成,事务已提交或进入 finished 状态。请求必须在创建事务的同一任务中挂起,否则无效。解决方法:在 onsuccess 回调内同步发起后续操作,或提前将所有请求挂入事务。避免在异步上下文中使用事务操作,确保请求在事务活跃期内完成。

qq_40822000的博客 159
上一篇: PostgreSQL 技术日报 (4月22日)|AI 向量检索落地,PG 内核锁与日志优化更新
下一篇: PostgreSQL 技术日报 (4月23日)|时序性能暴涨,GIN 索引构建大幅提速
IvorySQL
博客等级 码龄5年 745粉丝 565原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值