


AI 正以前所未有的速度渗透进每一个角落,“数据+智能”的化学反应,数据库与 AI 的深度融合,正在重塑我们对数据库设计与应用的想象。墨创数迹创始人汪丹(Yolanda )邀请三位大会出品人,前 PostgreSQL 分会会长及中文社区主席、IvorySQL 专家顾问委员萧少聪,佰晟智算(深圳)技术有限公司联合创始人 CEO、IvorySQL 专家顾问委员白鳝,独立开源贡献者 igsty 作者、IvorySQL 专家顾问委员冯若航,围绕数据库演进、AI 时代的变量、DBA 发展路径等话题进行了一场深度对话。
核心观点
- 2023 年是 PostgreSQL AI 化的分水岭。时机 + 生态 = 弯道超车:动态扩展撬动 30 年成熟内核,直接碾平专用向量数据库赛道。
- 数据库不是海马体,而是 AI 的整体状态平面。PostgreSQL 的开放架构让多模态数据处理可以在同一个数据库内实现。
- PostgreSQL 已经是做 AI Agent 的最佳起步数据底座了。
- AI 原生数据库的终极形态,或许是 AI 自己能够扩展和定制的数据库。
- AI 不会完全取代 DBA,但会重新定义 DBA 的价值边界。操作性知识会被压缩,而品味、架构能力、判断力和学习能力的溢价会更高。
01
当 PostgreSQL 遇见 AI,数据库和 AI 正在发生化学反应
最近几年 AI 应用大爆发,我们发现关注 PostgreSQL 的人越来越多,PG 不再是一个存储数据的地方,这个诞生于 30 多年前的关系型数据库,正在成为 AI 时代最炙手可热的数据底座。这背后,是一场关于数据库如何与 AI 共生的深刻变革。
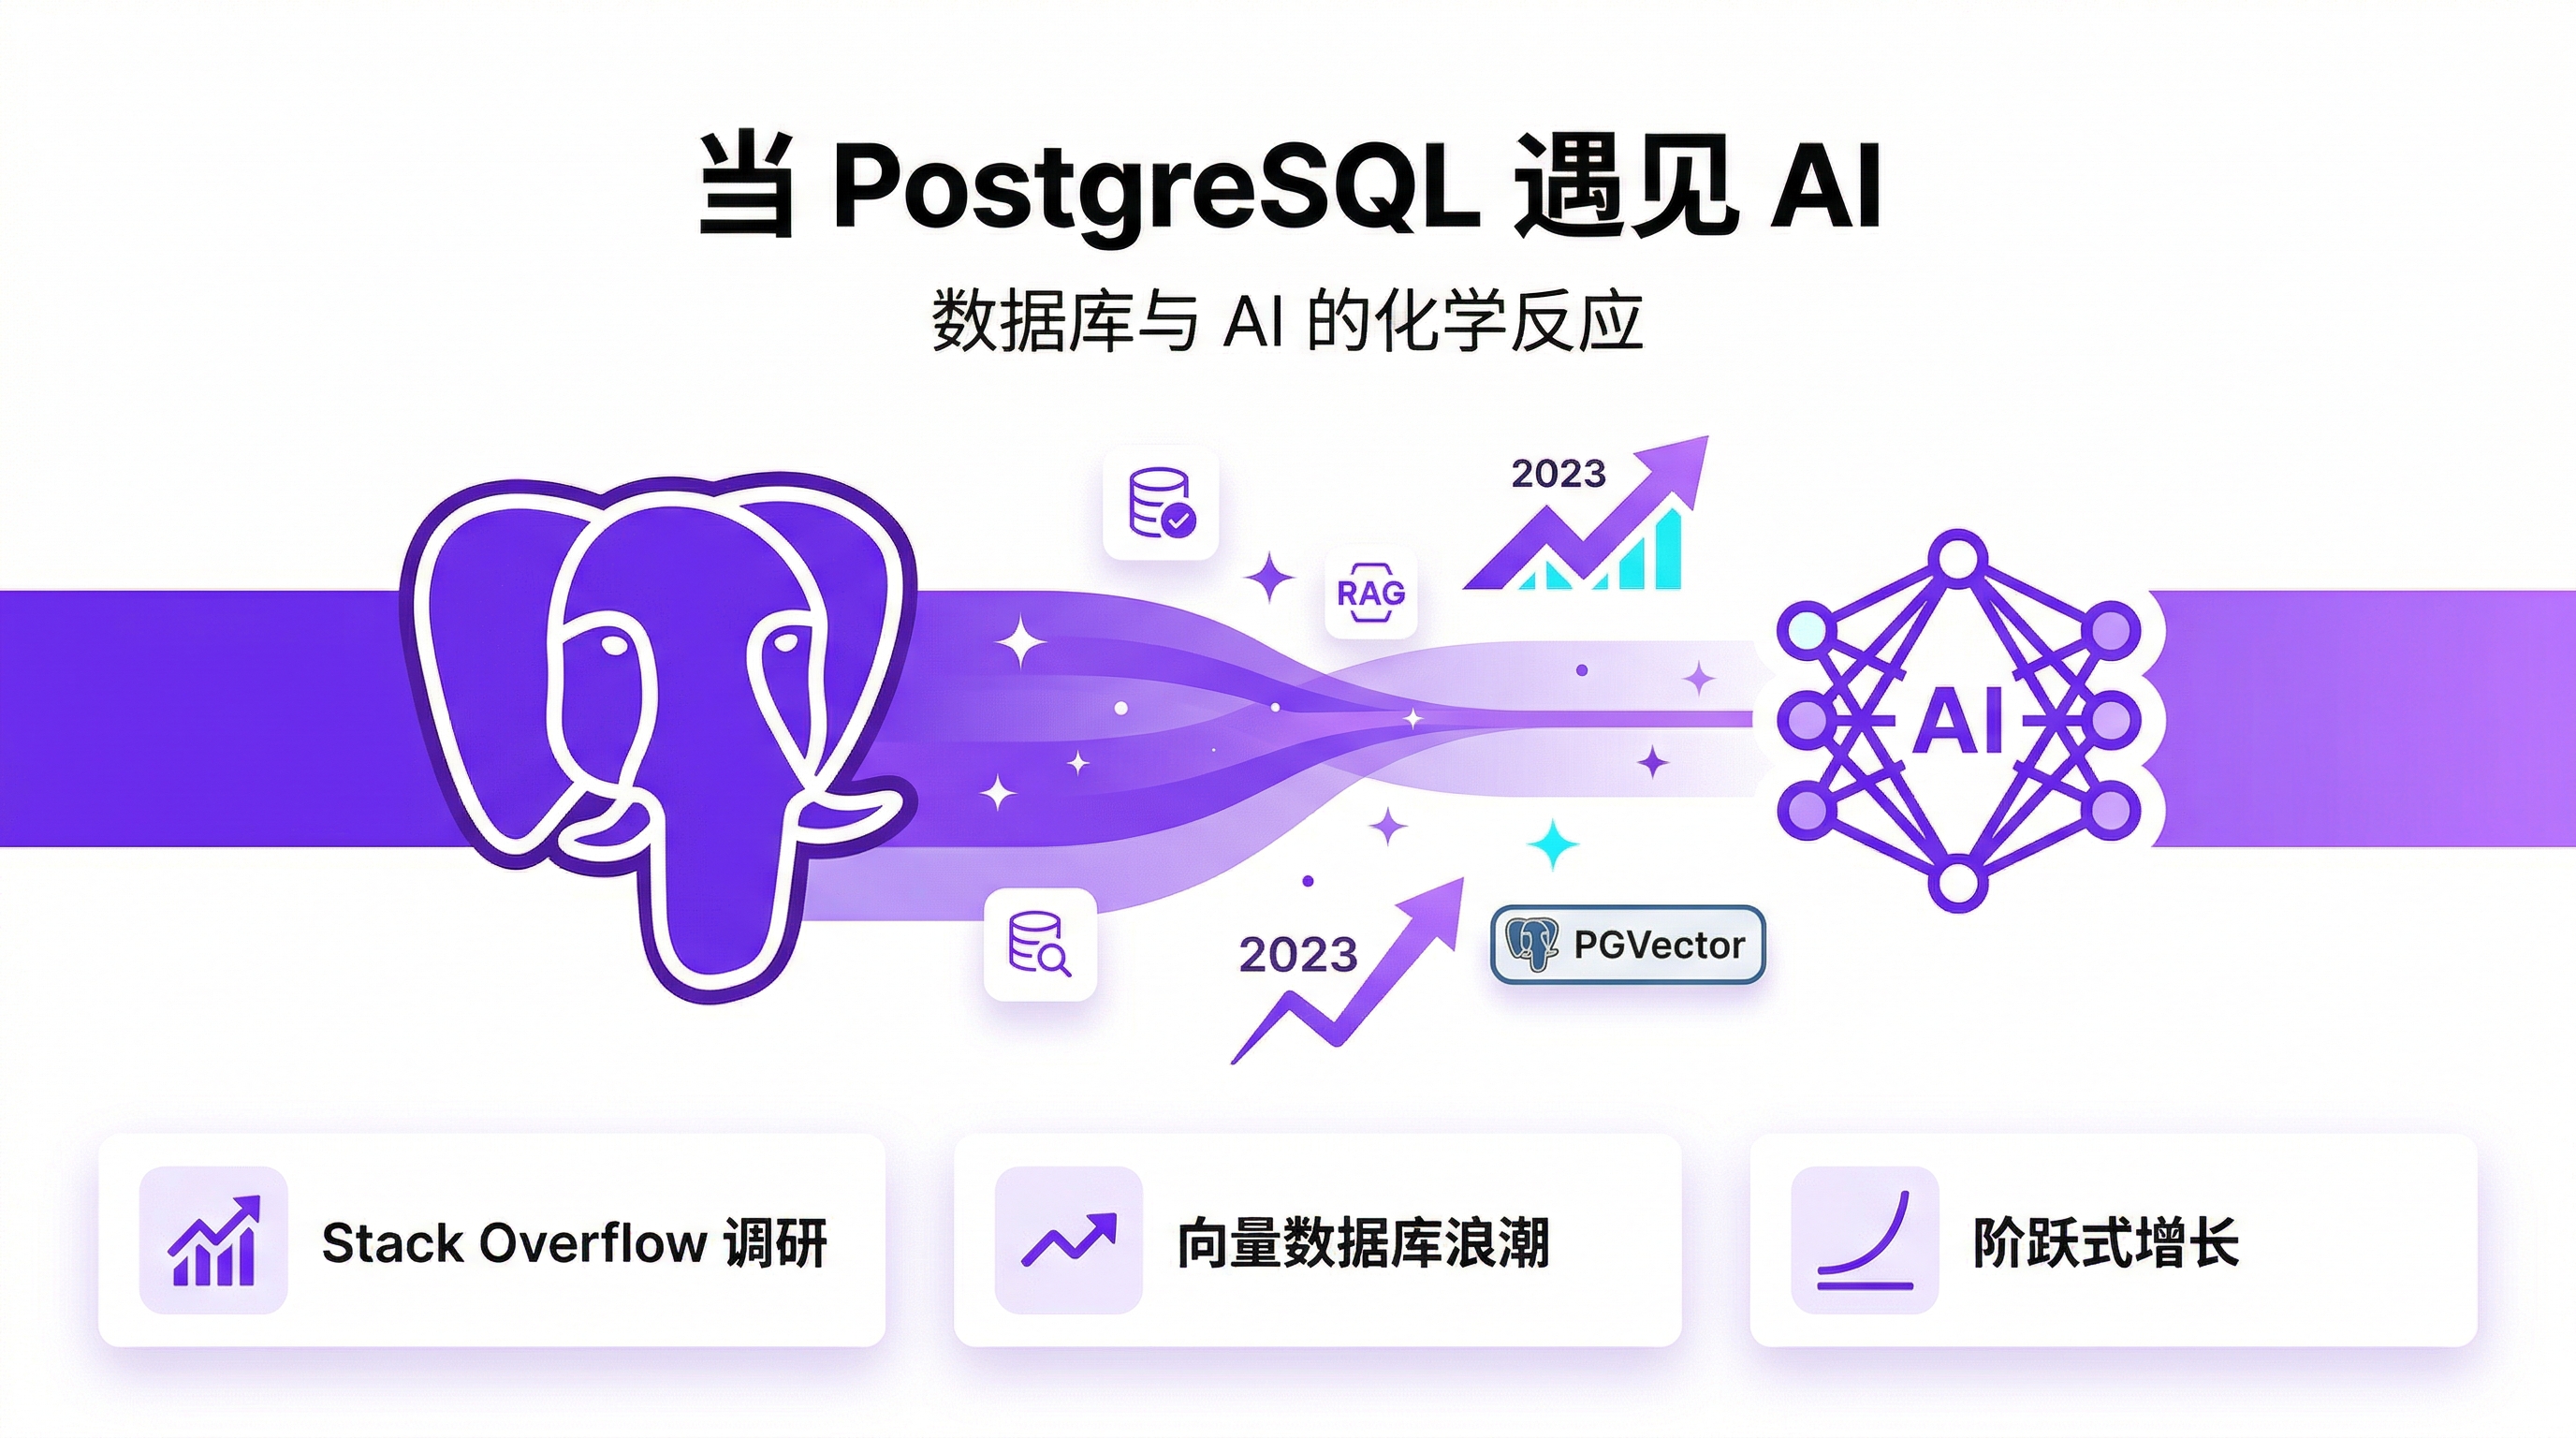
冯若航:我一直在追踪 PG 生态,关注整个数据库生态的快速演进。一个很明显的信号是 2023 年初,PG 正好赶上了 ChatGPT 发布之后的 RAG(检索增强生成)浪潮。具体来说,Neon 和 Supabase 这两个 PG 生态公司敏锐地发现:向量嵌入可以存储在数据库中进行相似性检索。这就等于范式被开发出来了,而 PG 生态里有一个 PGVector 扩展在 2021 年就已问世,正好赶上了这波浪潮。这之后,很多需要用到向量数据库的地方,就开始使用 PG 了。
Stack Overflow 有一个连续 7 年的开发者调研,我们从中去看 PG 的使用率和流行度,发现在 2023 年左右出现了一个爆炸式的阶跃增长。2023 年是一个分水岭,向量数据库这一波带飞了 PG,AI 把 PG 的增长拉到了一个新阶段。
萧少聪:我觉得未来 PG 会是一个非常重要的工具,或者说是承载 AI 数据底座的基石。其实在刚刚过去的 2025 年,我观察到这样一种情况,有些原生的 AI Agent 应用,并不一定在用 PG。我们重新去看这种情况,发现这样的应用大多跟传统业务没有直接关系,有很多新尝试。但当这个 Agent 做到一定程度以后,或者说 Agent 的使用达到一定规模后,就必须跟传统的业务进行整合,这时候 PG 又会成为一个最佳选择,因为它天生把向量和标量整合了在一起,有足够强大的体系级底座,不管在权限还是在各种功能整合上,它都可以通过一个数据底座帮助开发者解决各种问题。
我从 Agent 应用开发的角度发现,最开始阶段基本不用考虑数据库。当数据积累到一定体量,且开始出现各种各样的问题时,PG 已经是做 AI Agent 的最佳起步数据底座了。再加上它的分布式特性,丰富的扩展能力,当数据量更大的时候,也有很多解决办法。当然了,对于一些特殊应用,也需要专门的 AI 数据库或者处理方法,我相信整个世界就是开源开放的。
白鳝:黑格尔说过,任何一个伟大的历史事件都会发生两次。我想第一次就是 2023 年的 OpenAI ChatGPT,第二次就是去年的 DeepSeek。这两次历史事件发生以后,AI 浪潮就已经真正地进入到我们的生活中。其实 2023 年最开始用向量数据库的时候,我的一些项目没用 PG。但是后来我发现,很多宣称是 AI 原生数据库的,用起来并不方便,因为我不仅仅是要处理向量,我还要处理地理信息、图数据、时序数据等等,这时候就发现还是得用 PG,所有的数据都可以放在一个数据库里面,整个应用架构就简化了很多。再往后,PG 的插件架构又带来了更多、更大的可能性,我觉得这是 PG 非常独特且强大的方面。
02
数据库不是海马体,而是 AI 的状态平面
社区里有人把数据库比作 AI 的海马体,数据存储在哪里,智能就在哪里生长。比喻的目的往往不是为了准确,而是多一种理解维度。AI 时代,数据库的价值到底是怎样的?具体场景下怎么选择?
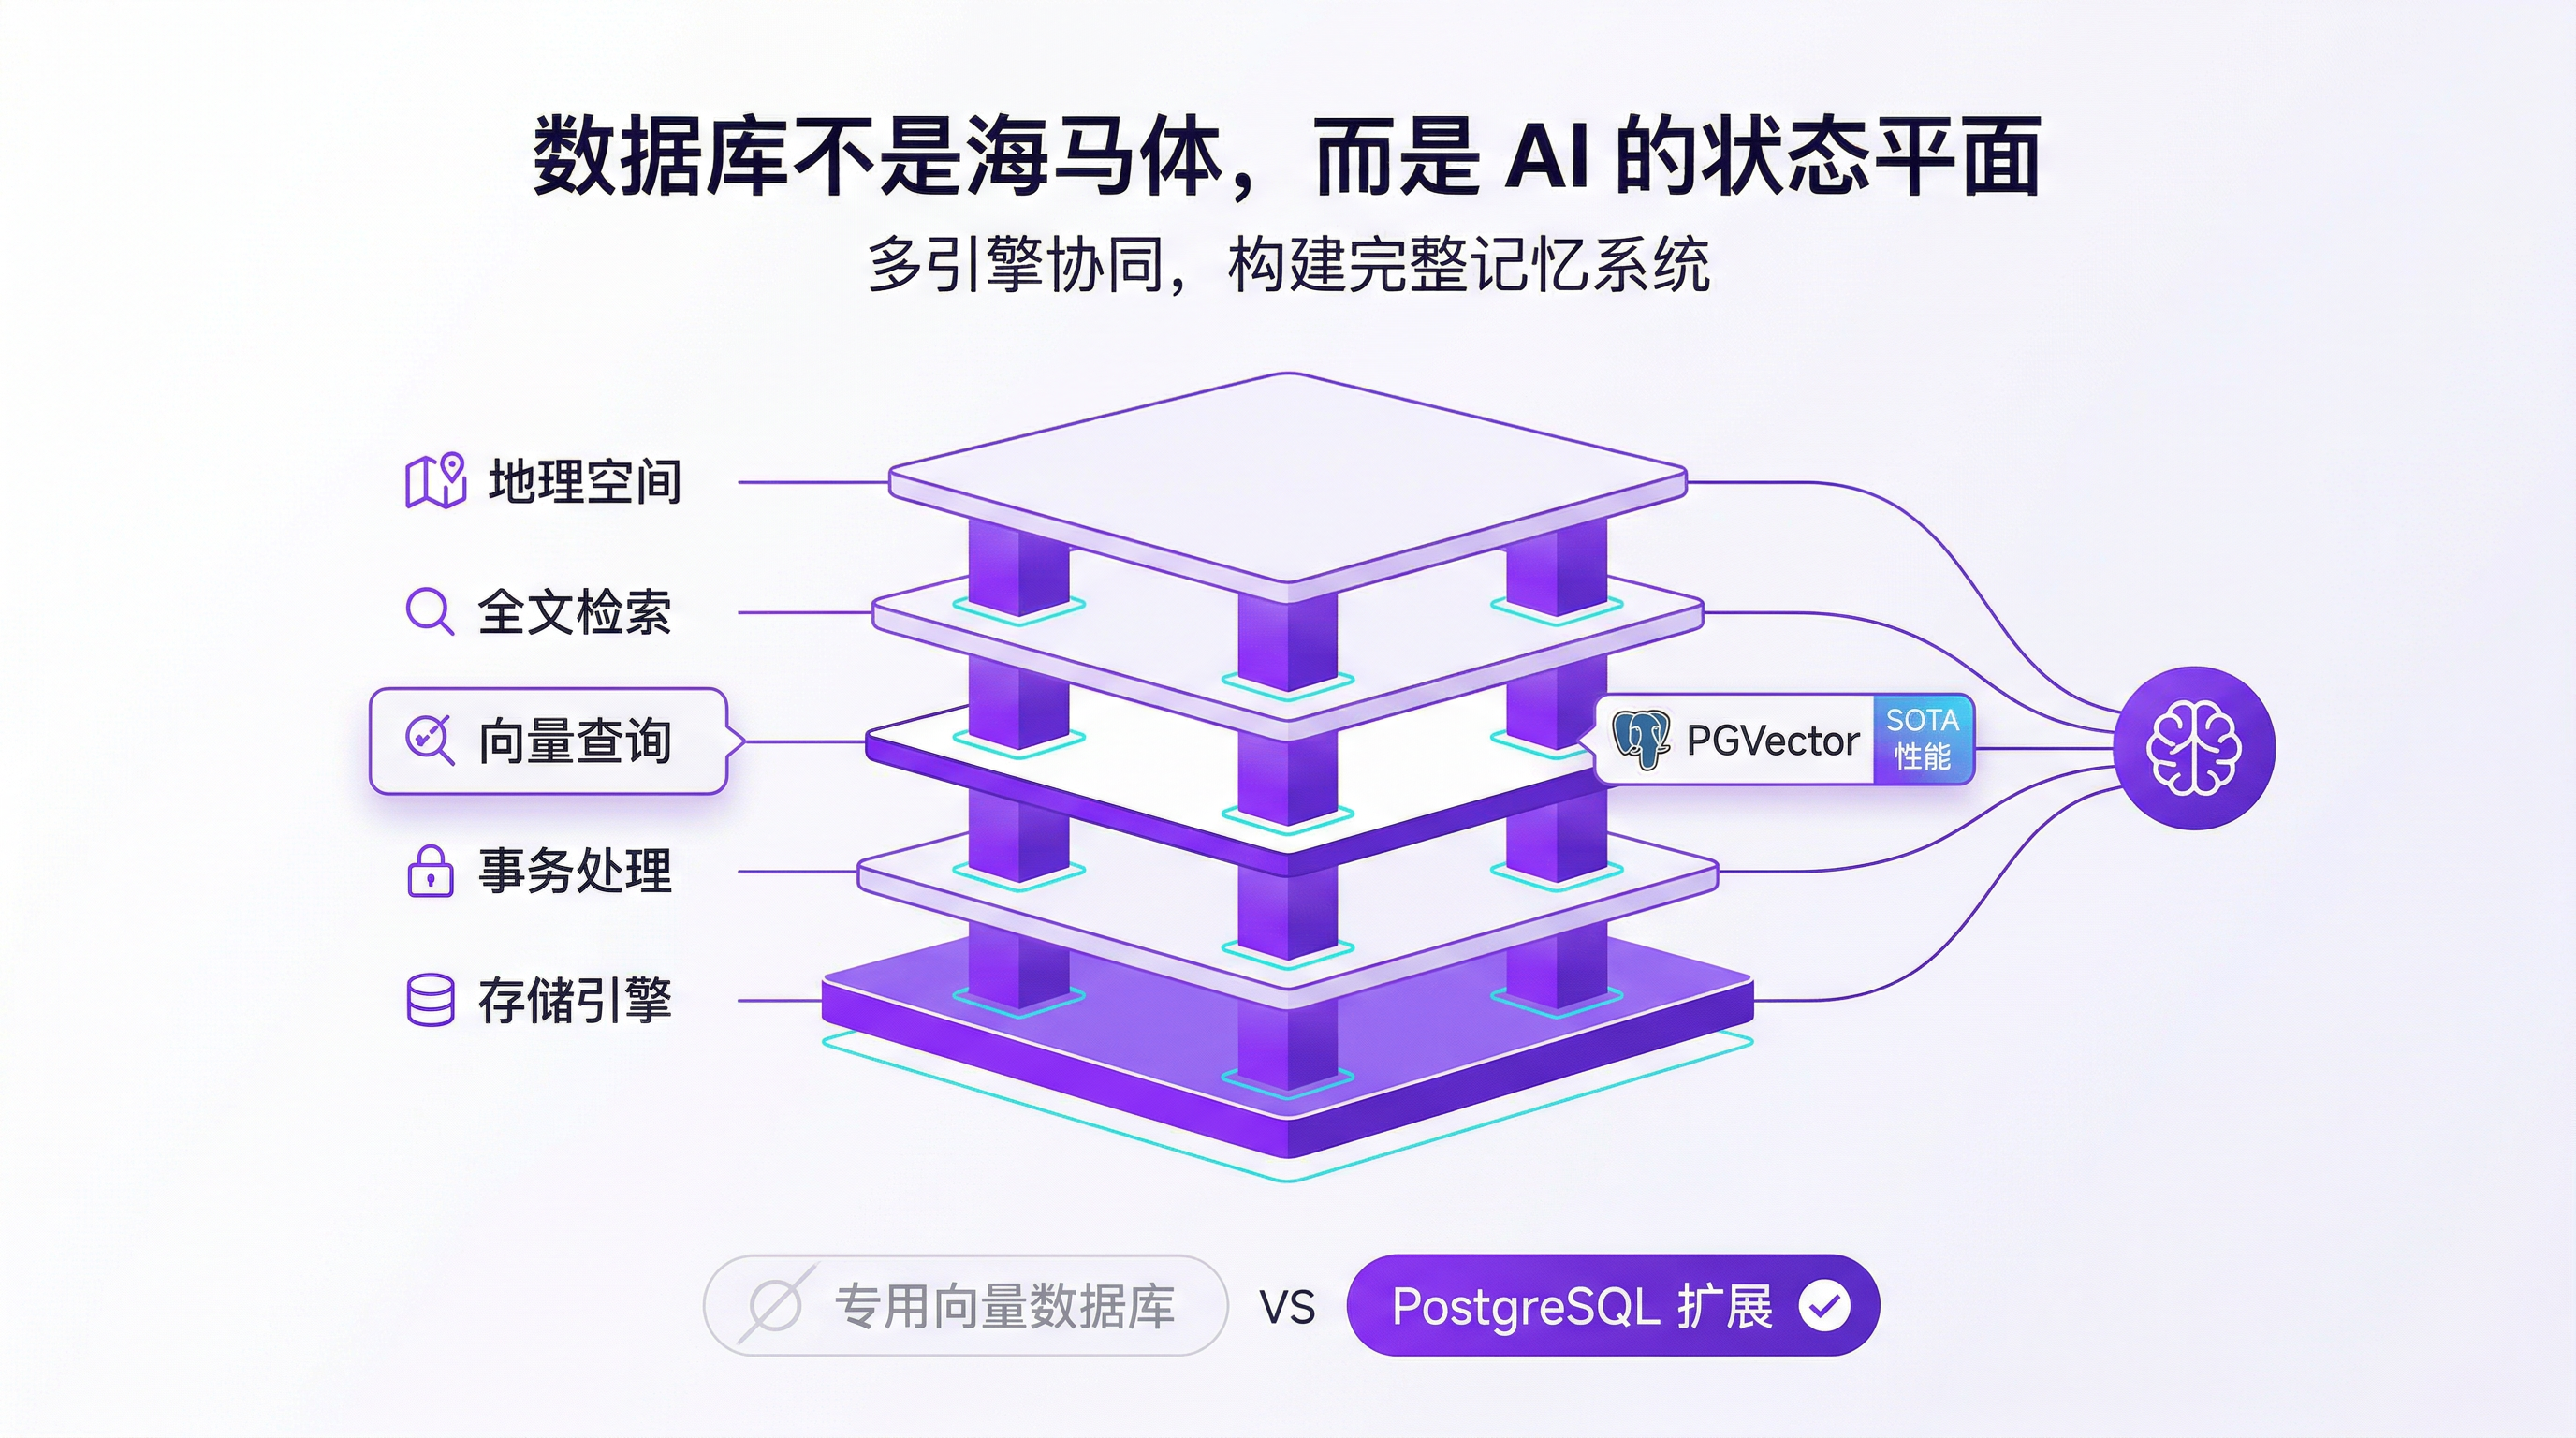
冯若航:如果用海马体这个概念的话,我会把数据库里的一个组件比喻成海马体,比如向量查询引擎,或者是全文检索引擎这样的组件。整个数据库其实就相当于大脑本身或者至少是记忆部分,一个数据库有各种各样的引擎,比如向量查询、全文检索、地理空间、存储、事务等等,他们一起来完成一个完整的工作,所以数据库更像是一个 AI 的状态平面。
顺着海马体的比喻,这里展开说说 PGVector 这样的向量组件/扩展。PGVector 最开始是 2021 年的时候,一个社区的个人爱好者自己做的一个项目,后来大厂投入了很多资源,让它成为了一个生产级别的向量组件。和这几年的很多专门的向量数据库对比,PGVector 实现了同样的 SOTA 级性能表现,它更大的亮点是易用程度。PGVector 最开始只有 2000 行代码,到现在也就是 8000~9000 行代码,用这种扩展的方式,很快就能实现完整的向量功能。从这个维度看,我认为 PGVector 是把整个专用向量数据库的赛道直接给碾平了。对于 PG 来说,这是一个弯道超车的故事,一方面,它有历经 30 年打磨的高度稳定的数据库内核;另一方面,像 PGVector 这样扩展出来的增量功能经过大厂的投入也超过了专用向量数据库。从 2023 年开始,我就已经在生产环境看到很大规模的 PGVector 部署,当下在做 AI 应用的时候,大家已经默认选择 PG 里面的 PGVector 了。
白鳝:对,PG 的开放式架构,社区活跃,整体的发展也很快。像 PGVector 这样的插件,可以让我们在开发一些简单应用的时候,不需要借助其他东西。我觉得未来的趋势就是怎么样,可能今后我们的应用都是面向 AI 的,也是用像 Claude Code 的这样的 AI 工具写的,怎么样让 AI 应用的开发成本更低,就成为一个很关键的问题,那么代码量越小,AI 应用的成本就会越低,这时候 PG 的优势是相当明显的。
萧少聪:我知道在业界对 PG 的一些特性或者能力是有一些诟病的,比如它很占内存,但实际上这些问题已经解决了。我想从另外一个角度来聊聊,就是现在很多 AI 操作直接就不去折腾 SQL 这件事了。就是通过一些提示词,或者一些更简单的调度方法,可以很轻松地做一些向量提取、获取分析等操作。这些操作,对于现在很热的 OPC(一人企业),或者小团队来说,用来开发解决具体问题的 Agent,这就已经够用了。
但再往后,我发现很多人又开始把这样的应用回归到数据库,回归到像 PG 这样的一个系统里来,当有这样需求的时候,就会发现之前写的那些短平快的应用要迁移到 SQL 变得特别辛苦,因为一开始没考虑规范化,那这个阵痛就是必经之路,一旦进入到一个规范化角度使用数据的时候,你可以对接的东西就多了。
虽然我们说未来可能是 Agent 之间在沟通,数据库非必须,但如果这个应用最终需要服务于人类,要让我们看得懂,还是必须形成一些规范化的动作,要有结构化,去支撑高可用、稳定性等动作,那么 PG 就会是一个天然的支撑体。
03
什么是真正的“AI 原生数据库”?
许多数据库标榜自己是“AI Native”,但大多只是加了向量功能。真正的 AI 原生数据库应该具备什么能力?PG 的下一步演进方向可能会是什么?
白鳝:现在很多都讲自己是 AI 原生数据库,其实我个人感觉还没看到一个真正的原生数据库。可能未来的程序都是 AI 在写,它是否需要数据库,需要什么样的数据库,这些需求还是不充分的,不是说加上一个向量功能就是原生数据库了。
我近两年一直在做 AI 应用,现在处理很多数据的时候,已经不是完全关系型的处理模式了,而是用一种逻辑数据逻辑的模式。我们在推动一个叫“数据驱动的语义化知识图谱”,其实是用语义在处理数据。在这种情况下,不是所有地方都需要 SQL,有些是语义驱动,很多中间数据就不需要了。以前我们的一个数据库里有成千上万张表,90% 都是为了处理数据而设计的表,而不是真正的业务需要的表。而在 AI 时代,有可能只有 10% 的表就可以描述所有业务。这是我现在实践的一个大概情况,未来数据库肯定会发生变化,但我还没有想清楚未来数据库到底会长成什么样子。
我想 AI 原生数据库就是真正为 AI 应用场景去构建的。我现在看到的一个路径,是在像 PG 这样优秀的底座上继续做大量改造,动态地用插件方式来来构建新能力,我相信 PG 可以越来越像一个 AI 原生数据库。
冯若航:我可以补充一下我的思考。我觉得 AI Native 数据库或者是 Agent Native 数据库,可以从下面这几个层面来看。
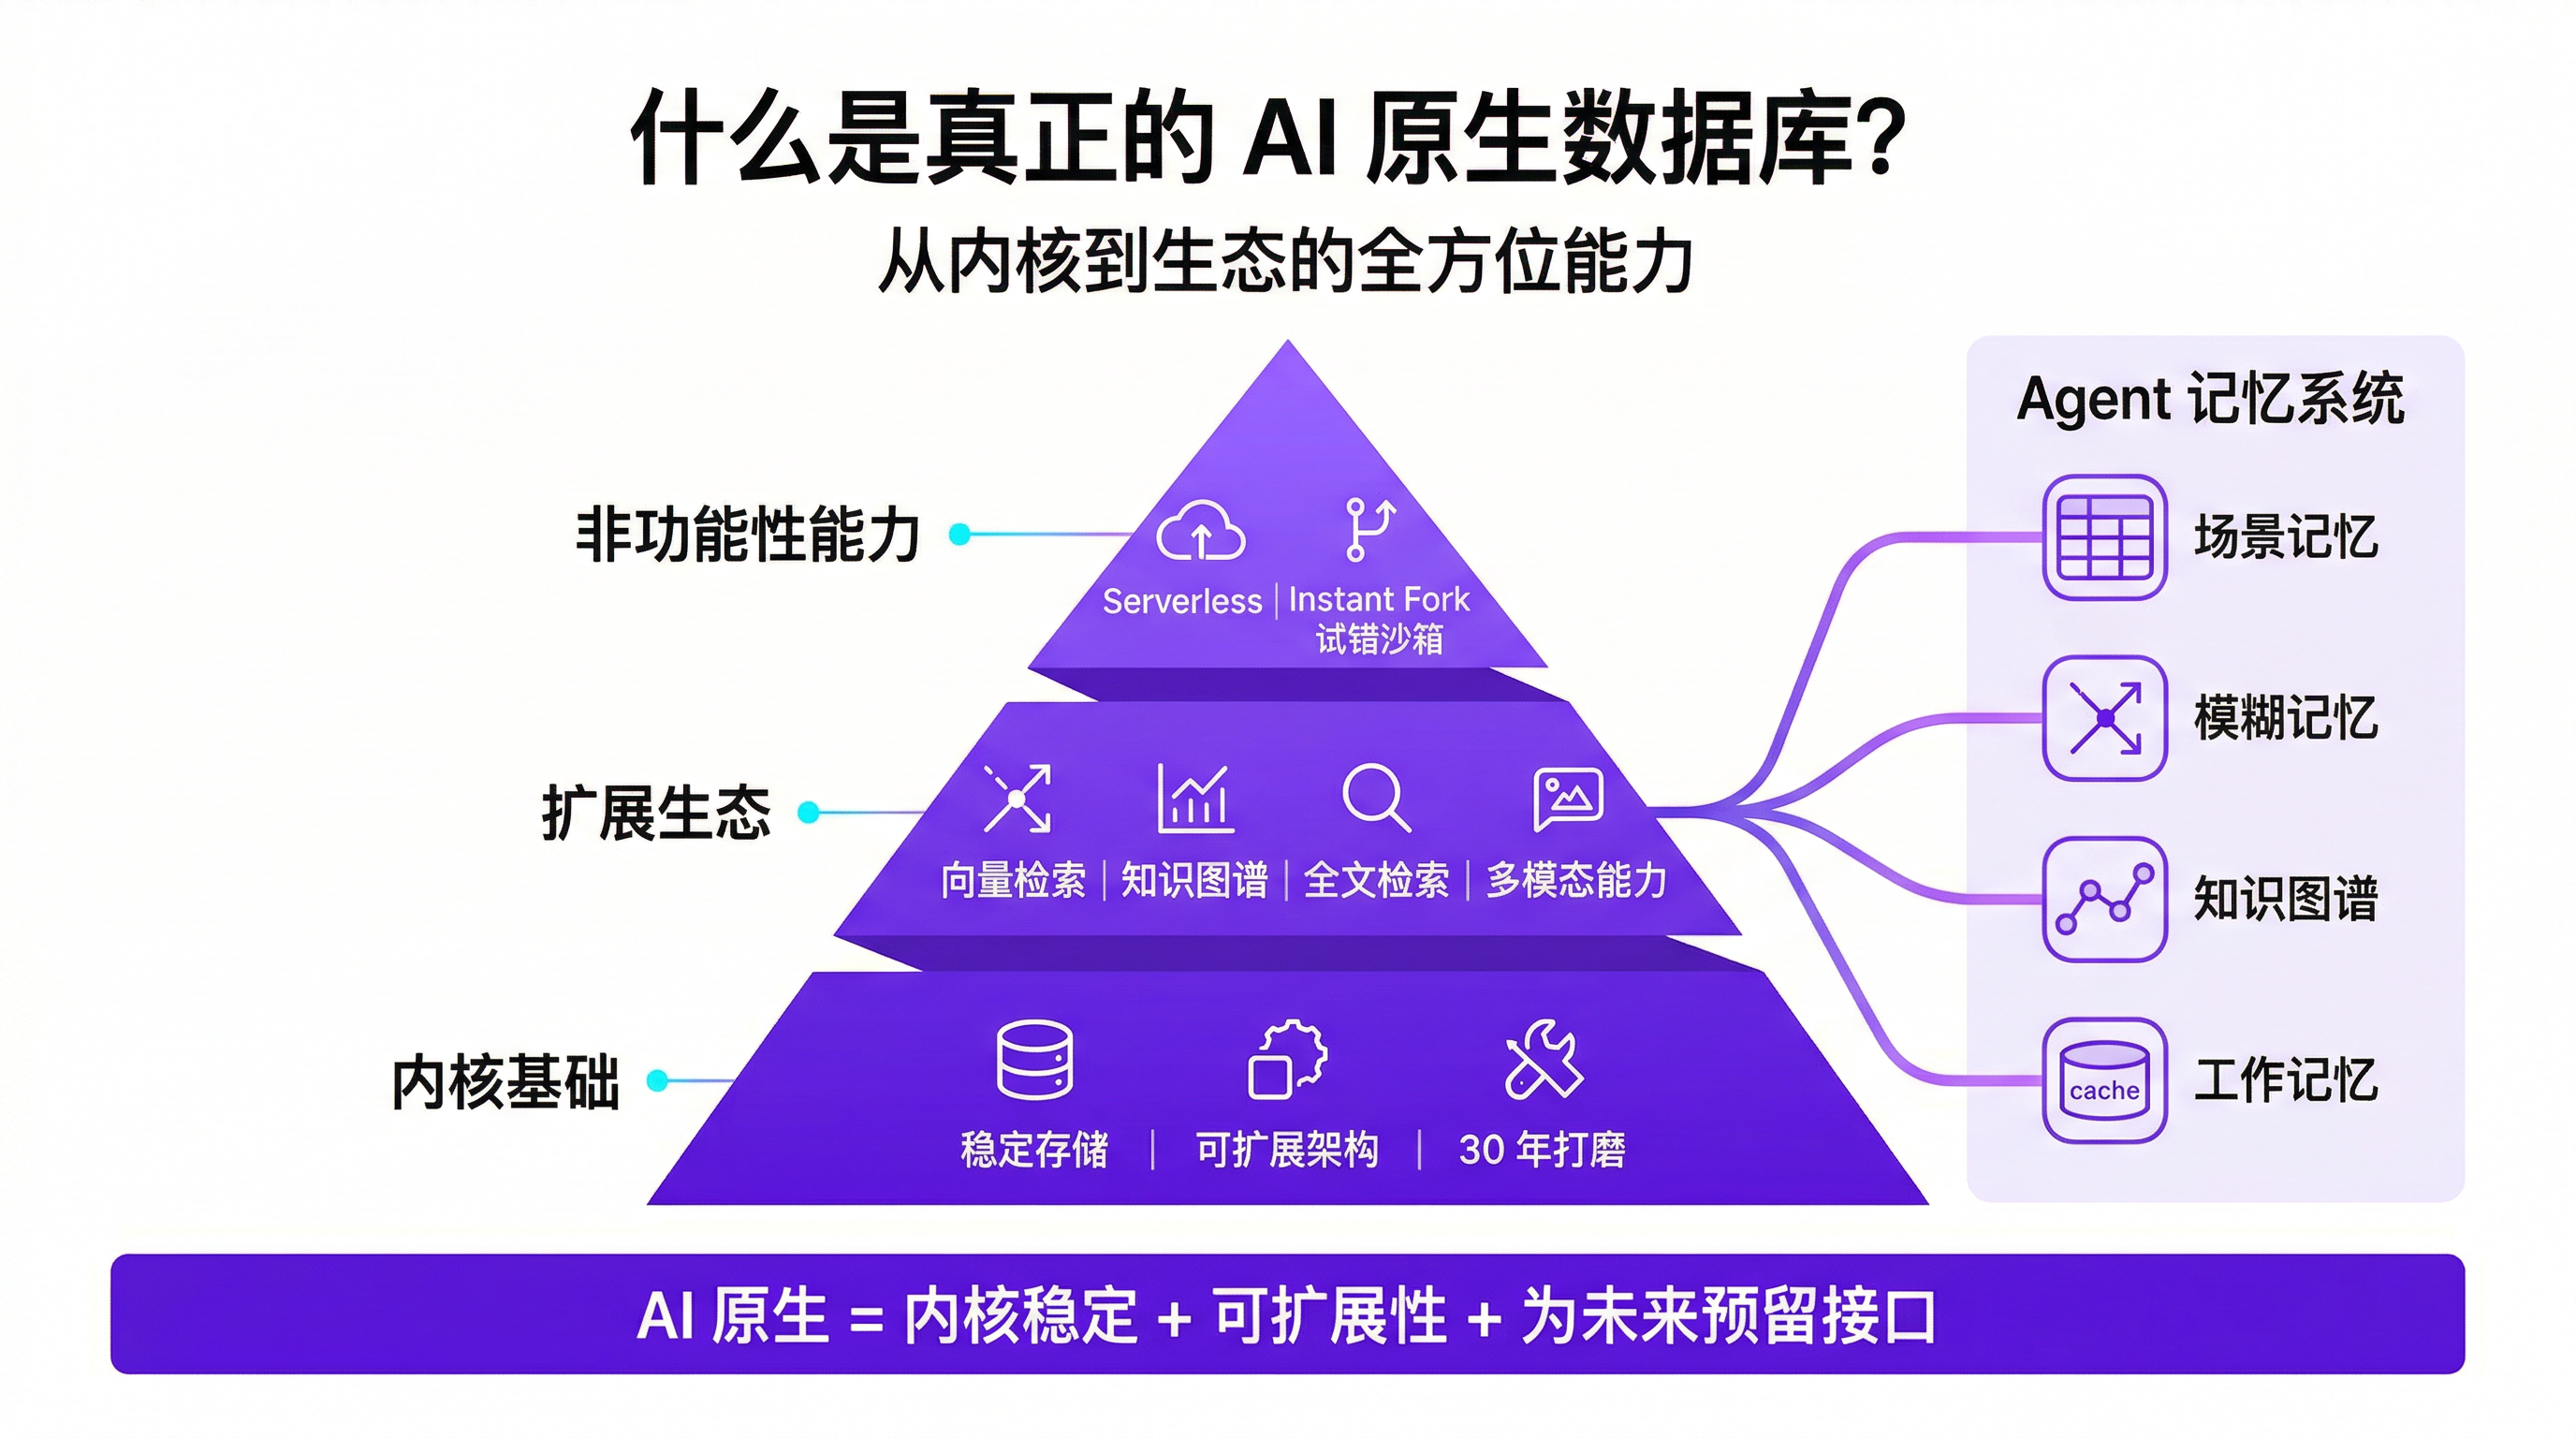
内核层面:第一,把数据库的本职工作,也就是存储数据和检索数据做好,这是基本功。第二,具备可扩展性。AI 的需求广泛,无法预估 AI 会怎么用数据库,能做好的事情就是把这些接口和钩子给预留好。它需要向量,可以加一个向量扩展;它需要图,可以加个图扩展;它需要全文检索,给它预留好全文检索的接口。在内核层面真正能称得上是 AI 原生的,就是把多模态和可扩展性给做好,在这个维度上我认为 PG 是做得最好的。
发行版扩展层面:现在 RAG 已经成为一个标配,大家都在用向量,无需多言了。那么新出现的是什么?Agent 的 Memory System(记忆系统),现在是百花齐放的阶段。已经出了各种记忆框架,你会发现很多底层用的都是 PG。都有哪些记忆呢?有场景记忆、工作记忆、长期记忆、知识性记忆、经验性记忆等等,这些记忆其实最后落到实处都是数据库表,就是传统的关系型数据;除此之外,还有模糊记忆,用向量来检索;还有一类就是知识图谱,就是图的能力,PG19 应该会有相关的更新;还有全文检索,比如把 ElasticSearch 的能力,把 BM25 全文检索的能力放到数据库里。最后你会发现在一个数据库里,你同时可以做精确 SQL 检索、做模糊向量检索、做图检索和做 BM25 全文检索这几种经典的检索范式。大体上我认为 AI 原生数据库要拥有为未来预留的可扩展性。
非功能性能力层面:我当下看到两个最值得去探索的方向,一个是 Serverless,一个是 AI 能力克隆。在 PG18 里其实有一个 Instant folk 能力,你可以在线把一个巨大的数据库原地克隆 N 份,不占额外的存储成本。对于 Agent 来说,这就等于给了它一个试错沙箱。当我需要变更功能的时候,先在克隆里面操作,验证无误之后再把它合并到生产环境里。我认为对于 Agent 来说是这是数据库应该提供的一个核心能力。
萧少聪:我补充一个小点。退回到数据库出现的那一天,它到底在解决什么问题,实际上就是在解决数据操作的一致性问题。怎么理解?从自己开发的一个应用,变成团队开发的应用,要给很多人用,也会有其他应用来读取,就需要有一个相同的方法,大家用相同的操作方式去使用这些数据,得到相同的效果,这就是一种操作上面的一致性。这时候数据库软件出现了,叫做通用基础软件。
我相信在 AI 时代也是一样。过去这样的一个通用基础软件的数据库,是给人编写程序和人类所使用的 App 去使用的,那么未来同样的需求会出现在 AI Agent 这一端,它会变成什么样子?我觉得这个还是交给后续的持续发展,跟随逐步变化再去观察。说不定因为 PG 足够开放,你把 PG 协议扔给 Agent,告诉它需要用的时候自己做扩展,它完全可以在这基础之上做出很多可能人类看不懂、但是对 Agent 沟通非常有效的东西,然后在 Agent 之间流传。我想,这就是 PG 开放生态所带来的东西,未来可能有一堆这样的扩展吧。
如果给 PG 提一个期待,我讲一个希望内核组赶紧解决的一个问题。我们在用向量和标量,现在两边都是一个比较独立的算子在运行。到底是先用向量来过滤数据,还是先用标量来过滤数据,这里头其实是一个博弈状态。后续的 PG 版本,是否有可能更快地打通两个算子,能够让操作变得更加平滑,可观测更强,可以按需调节,让开发者使用起来更加简单。
04
AI 可观测性发展趋势
AI 可观测性成为一个越来越重要的话题,现状如何?未来又有怎样的发展趋势?
白鳝:最近 Harness 特别火,也是因为在做一个 AI 应用的时候,不是像以前写代码就可以完全控制住它,AI 生成的 Agent 有自己的不确定性。
我们讲可观测性缺失,更多是大模型应用方面的问题,还不是数据库内部的。比如 PG 数据库,它的底层架构特别好,可以看到索引构建的进度,是很放心的。当然,PG 的一些指标体系还可以持续完善,但它有很好的插件机制,有很多钩子,我们需要观测的任何指标,在 PG 框架里都是可以解决的。
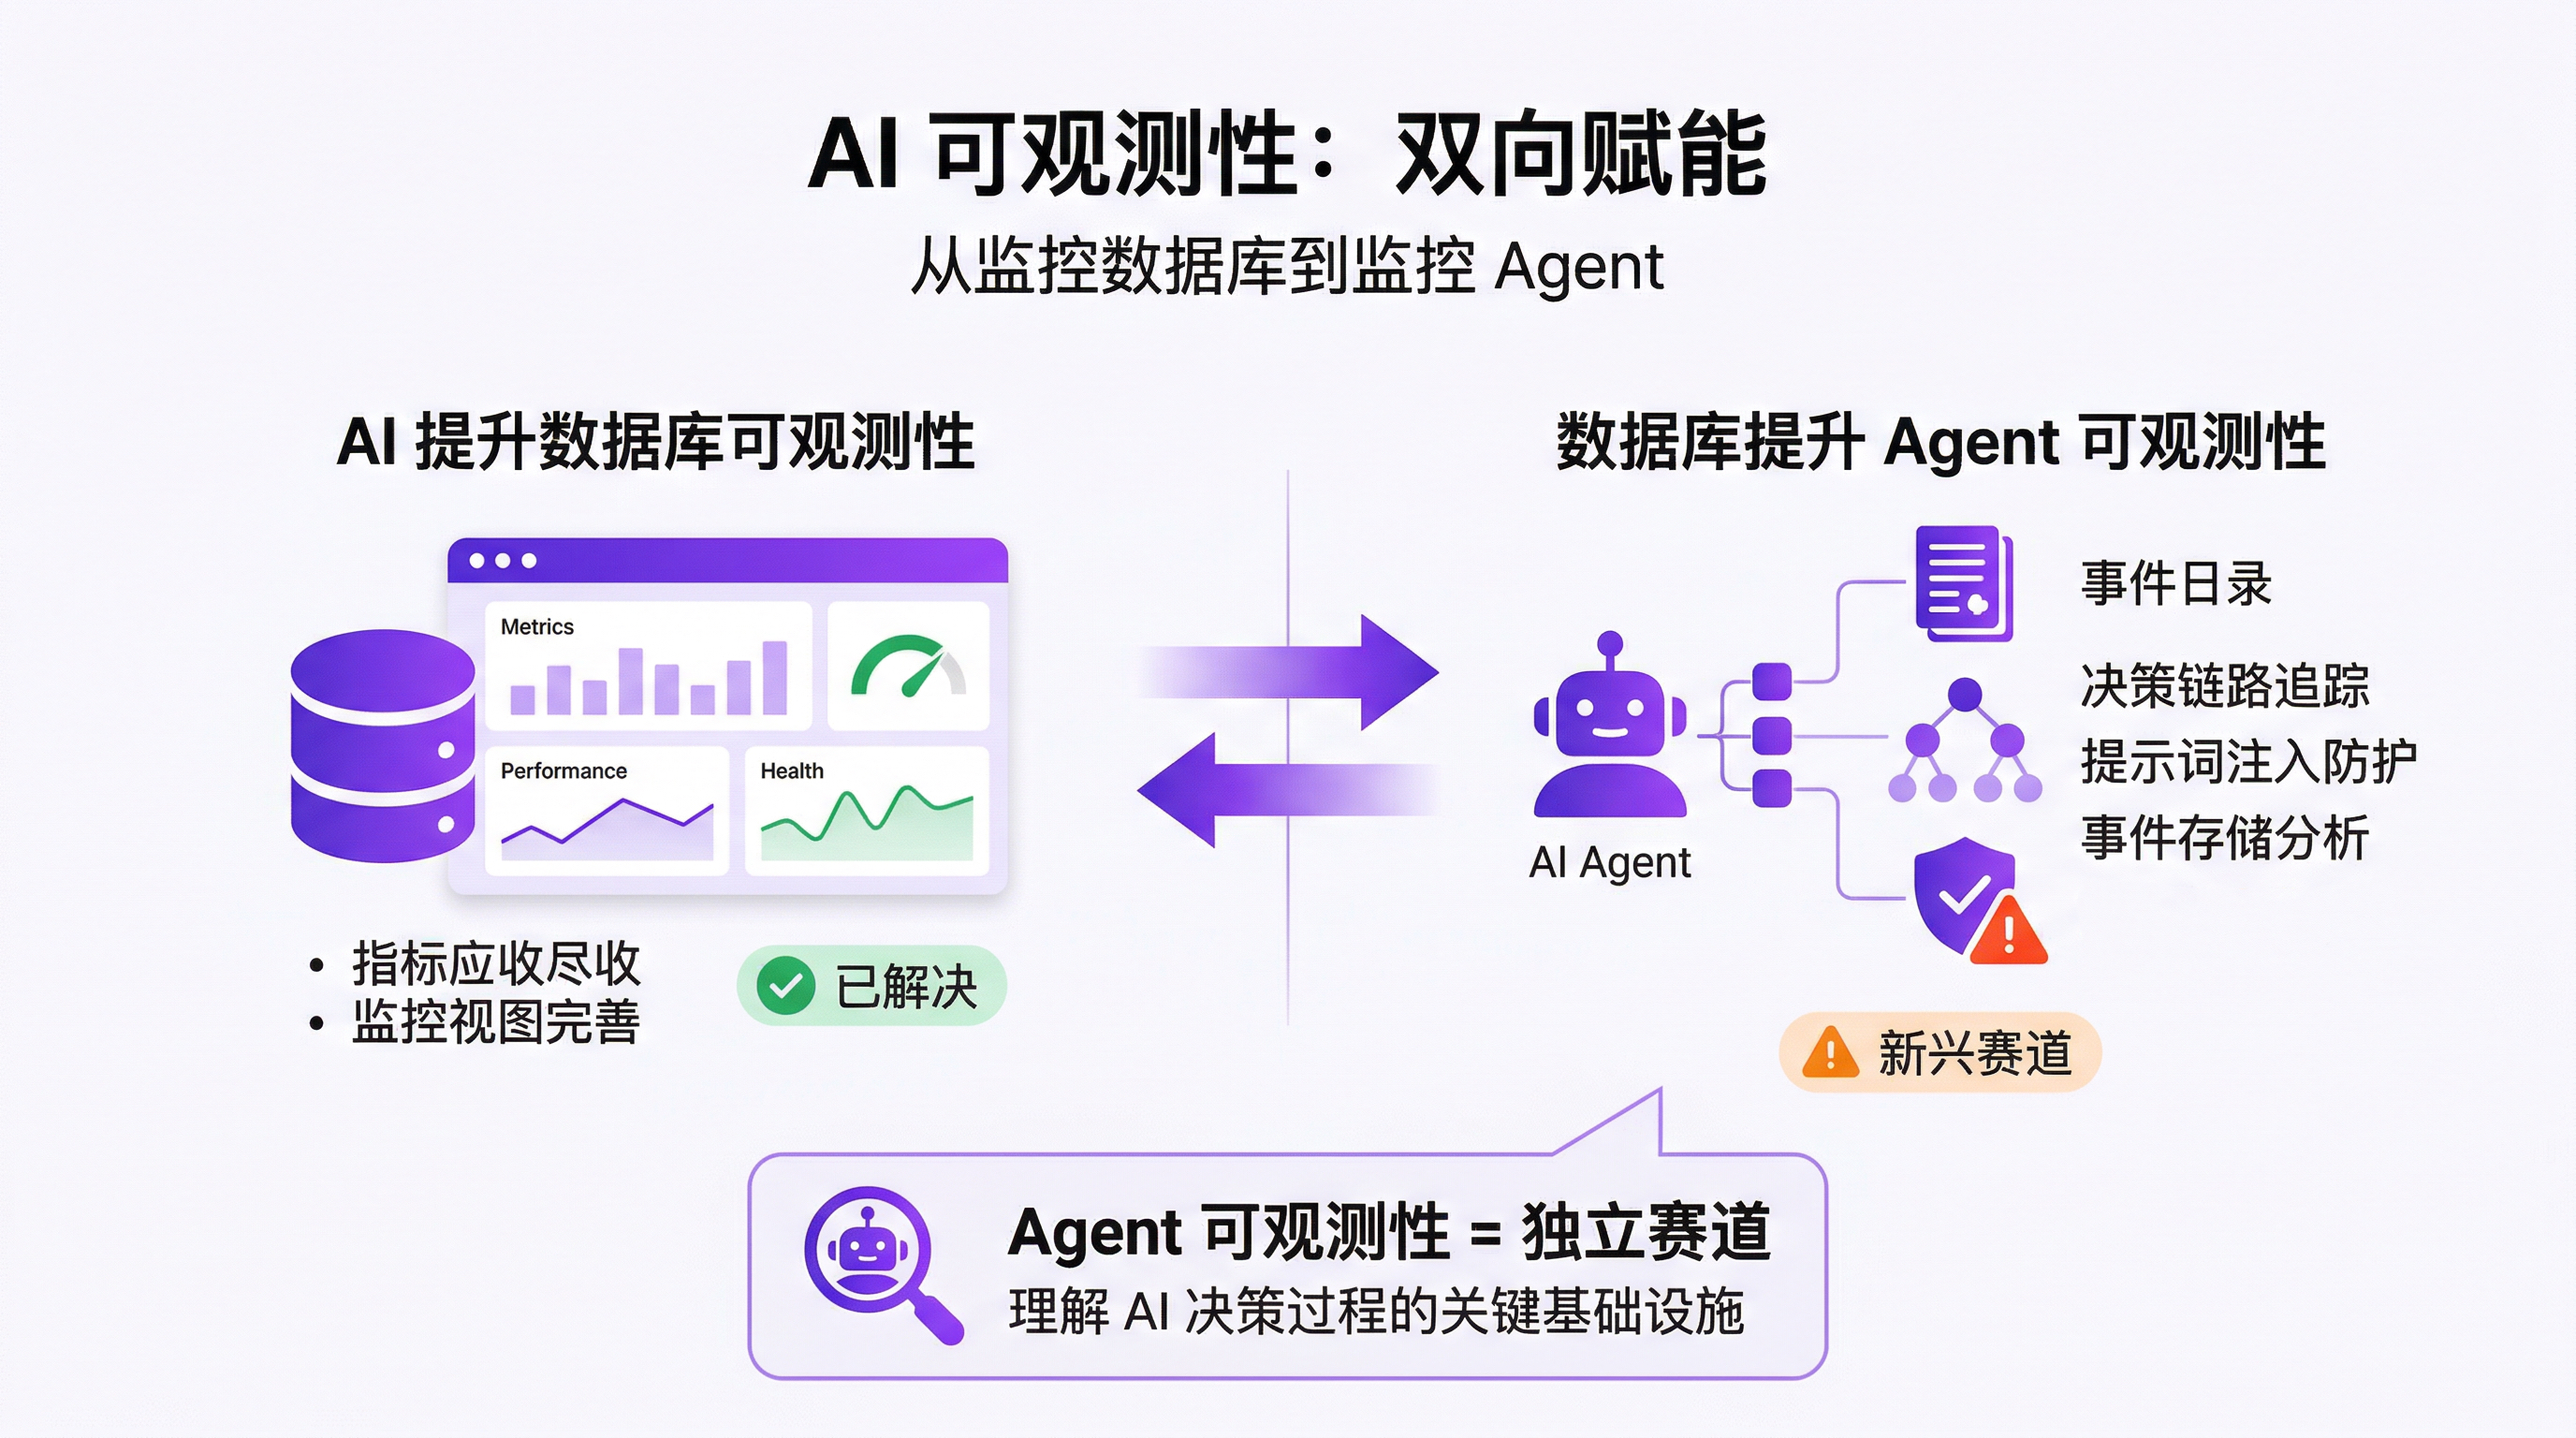
冯若航:关于可观测性,我觉得分两个问题,一个是 AI Agent 怎么帮助提升数据库的可观测性,一个是数据库怎么帮助提升 AI Agent 的可观测性。对于前一个问题,数据库的可观测性,已经不再是一个问题了,比如 PG 有很多观测视图,很多扩展能力,包括我自己做的 PG 监控系统,几年前就已经做到了 PG 里面所有的指标应收尽收。
更重要的问题是 Agent 本身的可观测性如何用数据库来解决。一个 Agent 的 Loop,它里面有很多事件,其实大家是想知道它里面到底发生了什么,它为什么是这么决策的?当前 Agent 最大的一个隐患是提示词注入,它去网上各种冲浪找东西查文献,文献里面如果有一行注入提示词,很可能就把它带偏了,它可能做出了一个不理智的决策,把你的密钥发给别人,这个问题怎么解决?我认为 Agent 可观测性将会成为一个独立赛道,就像以前的应用可观测性一样,大家需要理解 Agent 为什么做出这些决策,这些决策事件应该有个地方保存。现在看到的做法还都很粗糙,比如只是存储日志,没有把它以专业的可观测的决策树链条画出来,我认为这是数据库可以干的事情,在企业级场景里面,这件事的价值还会持续升级。
05
DBA 会被 AI 取代吗?
这是每个数据库从业者都在思考的问题。答案既残酷又充满希望。“老人”如何保持竞争力?“新人”的成长路径在哪里?
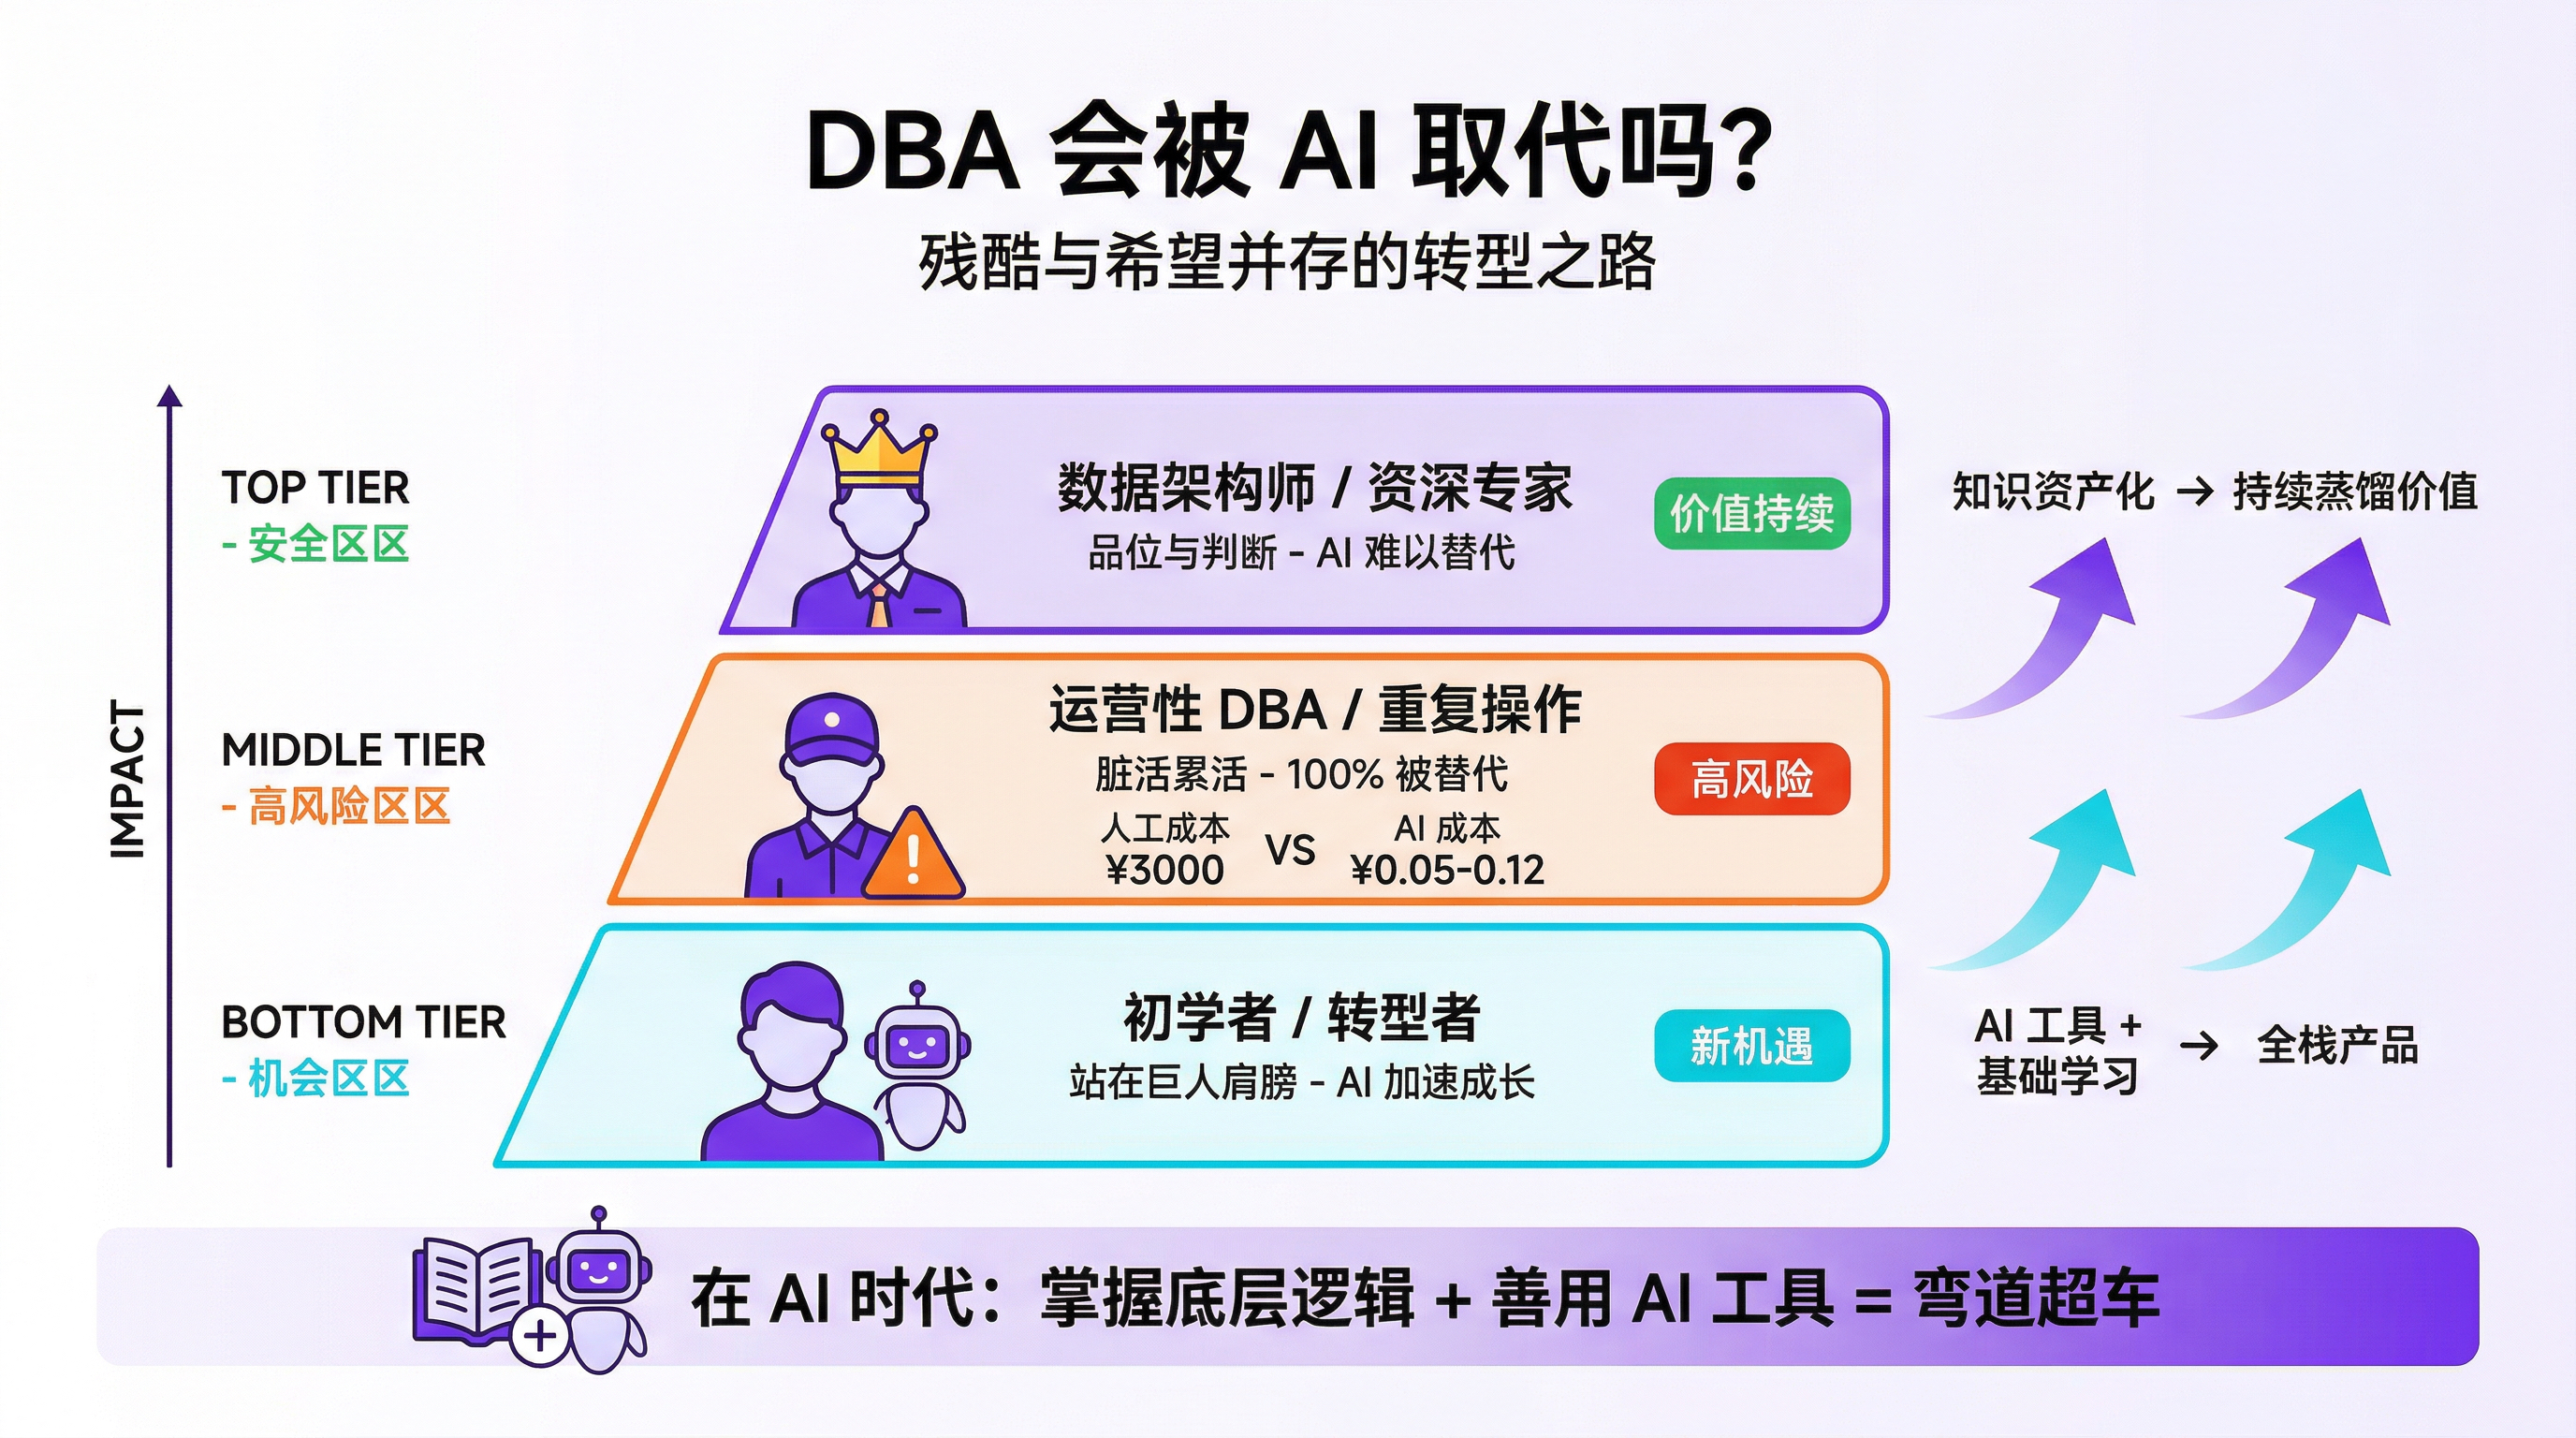
白鳝:这个话题几乎每个活动都会谈到。前天我在长沙和用户也在聊这个问题,聊了三个小时以后,大家信心都很足。现场的 DBA 都很兴奋,一点都没觉得会被淘汰,反而感受到了自己的价值,能把以往的经验喂给 AI。
前段时间我去一个公司,他们的运维团队都在写 Skills,甚至做了 KPI 要求,叫知识资产化。这是 AI 给我们带来的一个改变,当我们脑子里没有知识的时候,就只能变成 Token 陪伴大家;但是当脑子里还有知识的时候,是不会马上被蒸馏完的。我们必须往前走,需求在变,能力增长就要变。不过当下的残酷是变化太快了,是一种跨越式的发展,而不是我刚入行 DBA 的 90 年代了,那时候能装个数据库就已经是专家了。
去年耶鲁大学有一个学者说了一个观点:AGI 时代,劳动价值将被算力成本重新定价。啥意思?传统经济学中工资与技能稀缺性挂钩,但是在 AGI 时代,劳动者的收入上限取决于复制其技能所需的算力成本。举个例子,以前我们经常做 AWR 报告,需要专家才能把它分析清楚,你花三五千元请专家到现场,或者说线上给一千元的费用,基本没有专家愿意干。现在 AI 分析这样一个报告需要多少钱?我们就免费开放了一个工具,分析一份报告的实际算力成本是 5 分钱到 1 毛 2。
你看,这就是一个很现实的问题。坦白说,简单的一线工作,AI 能够做得很好,基本是完全替代。所以得让自己成为脑子里有持续可蒸馏知识的 DBA。还是那句话,我们 DBA 必须往前走,保有被持续蒸馏的价值。
萧少聪:我最近也在蒸馏自己,方法不是把我蒸馏完了,是把我每一部分的不同能力蒸馏出来,干不同的活。白老师给了大家很多鼓励,我说点冷冰冰的话。DBA 分两种,第一种是真正从数据库的基础架构思考学习过来的,打好了坚实的基础。我想这就是刚才白老师所讲的,听到 AI 这东西来了会兴奋的那波 DBA。为什么?脏活累活咱不用干了,那么多 AI 工具先用起来,解放双手,然后去解决更有意义的价值。第二种 DBA 是对数据库是做什么事情的、解决什么问题的、底层架构怎么设计的这些没有深刻理解,只会敲几个命令,今天做备份,明天做恢复,遇到备份恢复不了的情况就完全不知道怎么办,这样的 DBA 肯定没活路了,这么说可能很打击人,AI 都不需要蒸馏你,AI 已经能替代你完这些事情了。
前几天我遇到了一个非常优秀的年轻人,送了他一本书《数据库系统概论》,一本老书,我自己做了很多笔记。我觉得面对 AI 也不要慌,还是回到这些最基础的东西上:一定去学清楚数据库的底层逻辑,数据库到底在解决什么问题?怎么解决的?有一些这样的底层思考。
换个角度看,对所有人来说,AI 都提供了一个非常好的机会。从来没有一个时代,有这样一位老师,可以天天陪伴在我们左右,不懂的时候,他可以不停地教导,而且用我们所能理解的语言来讲。我现在用 AI 不是纯粹问一个问题,会先告诉 AI 我的水平在哪里,AI 就能用我们听得懂的语言和深度来帮助我们更快速成长,过去是不会有任何一个老师这么来教的。
冯若航:我觉得肖老师说的特别有道理。其实 AI 冲击最大的是中间的这一部分,最顶尖的专家受冲击是比较小的,比如数据架构师依然很有价值,品位、判断这些都是没法替代的,100% 会被替代的是运营性的操作知识;初学者或者是行外的研发与运维,受冲击也没那么大,对他们来说这是一个全新的机会。如果我要招人的话,肯定只招两类人,一类是能驱动 AI agent/DBA Agent 去干活的老司机;一类是聪明的实习生,还是一张白纸,有无限可能。
DBA 还有一个优势在哪里呢?我认为相对于前后端工程师,DBA 有一个结构性优势。在整个 IT 技术栈里,数据库是非常硬核的部分,一个对数据库有深度了解的 DBA 现在用 AI Agent 去做前后端开发是相对容易的。我们应该抓住这个优势,在这个机会窗口利用好它,VibeCoding,做 Agent,以数据库作为基石,打造全栈产品。
过去的环境是用 5~10 年专门钻研一个数据库,从小白成长为专家。但当下,在生产环境中打磨的这条路径已经被 AI Agent 锁死了,不会有这样的环境给我们来干这些事了,那年轻人入行怎么弯道超车?我的建议是站在前人的肩膀上。什么意思?比如我把自己作为 DBA 的经验蒸馏出至少 70% 做成软件,那年轻人就可以直接站在这些蒸馏出来的专家经验的基础上,最佳策略就是直接用这些软件,去培养自己的体感知识和判断力。也就是说,在 AI 的帮助下培育你自己的直觉和观感,这是我认为当下最务实的路径,专家沉淀出来的工具将会成为新人入门的一个可行路径。
结语
整合与进化的力量
三位专家的精彩分享与碰撞让我们看见 PostgreSQL 的 AI 进化脉络,它揭示了一个深刻的真理:在技术演进中,整合与进化往往比专业化更有生命力。
2026 年,我们正站在一个转折点上。PostgreSQL 不再只是“也能做 AI”的数据库,而是在重新定义什么是“AI 原生”的数据基座。它告诉我们:真正的智能不是推倒重来,而是让已有的系统学会思考。在追逐新技术的同时,不要忘记那些经过时间考验的基础设施,它们往往蕴含着更大的进化潜力。系统如此,人亦如此。在 AI 时代,新一代 DBA 也正在重新定义自己。
 662


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


