[论文阅读笔记] Boosting Adversarial Attacks with Momentum

MI-FGSM代码及注释 MI-FGSM算法的完整代码 阅读详情

Boosting Adversarial Attacks with Momentum(CVPR2018)

Source Code:
https://github.com/dongyp13/Non-Targeted-Adversarial-Attacks
https://github.com/dongyp13/Targeted-Adversarial-Attacks.

文章概述: 本文提出了一种基于动量法(Momentum)的迭代生成对抗样本的方法,这种方法可以在迭代过程中稳定更新方向并避免糟糕的局部最大值(local maxima),从而产生更可转移(transferable)的对抗性示例,并且不仅对"白盒"模型攻击有效,对"黑盒"模型攻击也同样有效。

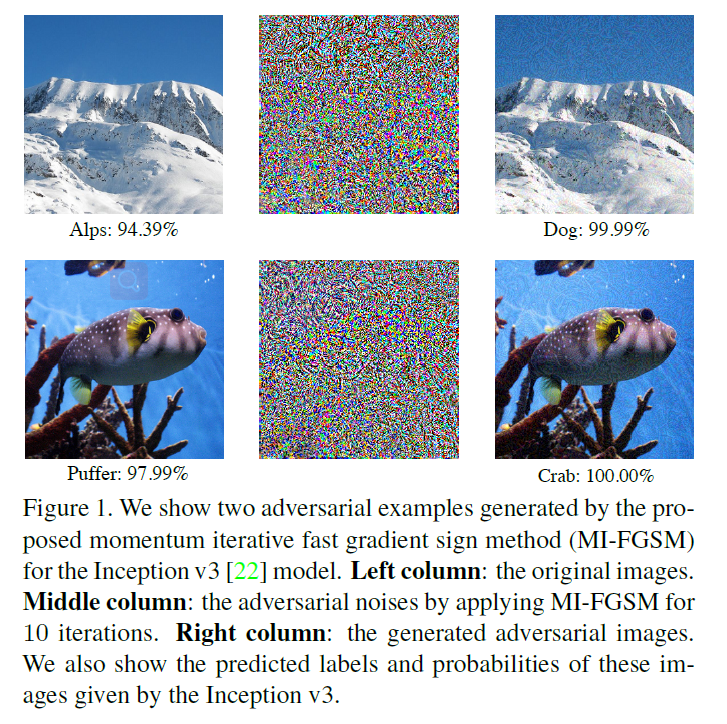
本文方法生成的对抗样本初览:

可以看出,对抗样本在一定程度上是增加了奇奇怪怪的纹路,对于常人而言,只会觉得是的"这张图不够清晰",并且会主动过滤掉,而只对总体图像进行分析,所以对常人而言,是不会误判的。而对于CNN,其实对于每一个卷积核,其实在某种程度上是一种"算子",提取的是图像中的纹理特征,对于卷积核而言,可能更加关注的是纹理特征,而无法把握总体特征,因此会误判。

我的猜想:会不会有一种可能,是因为卷积核的性质才导致了网络的不稳定性?大一点的卷积核是否在一定程度上因为关注的区域变大而忽略细小纹理从而变得更加robust?
文中猜想(或结论、现有研究的优缺点)的整理:

  1. 可转移性(transferable)现象是由于不同的机器学习模型在一个数据点周围学习相似的决策边界,使得为一个模型设计的对抗性示例对其他模型也有效。
  2. optimization-based和iterative方法产生的对抗样本在可转移性上表现比较差,因此对黑盒模型的攻击比较低效;one-step gradient方法能产生更可转移的对抗性例子,但是它们通常对白盒模型的成功率较低,使得它对黑盒攻击无效。
  3. 已经有研究表明,对于白盒模型而言,iterative方法比one-step方法有更高的成功率,但是这是以更差的可以转移性作为代价的。
  4. optimization-based方法的缺点是无法保证对抗样本的 “保真性”,即可能增加的扰动足以让人眼明显感觉到(其优化的目标函数如下)。
    arg ⁡ min ⁡ x ∗ λ ⋅ ∣ ∣ x ∗ − x ∣ ∣ p − J ( x ∗ , y ) \mathop{\arg\min}\limits_{x^*} \lambda \cdot||x^* - x||_p - J(x^*, y) x∗argmin​λ⋅∣∣x∗−x∣∣p​−J(x∗,y)
    本文的方法:
    case 1:MI-FGSM
    [无聊的补充知识]: MI即为Momentum iterative的缩写
    作者的思路来源: 借鉴物理学上的动量思想,在优化时越过local maxima,增大到达global maxima的机会。其实不太理解的是,对于这种迭代的更新步骤,local maxima和global maxima到底意味着什么? 为什么减小陷入local maxima的几率就能让攻击效果更好(主要是这里并未出现所谓的目标函数)
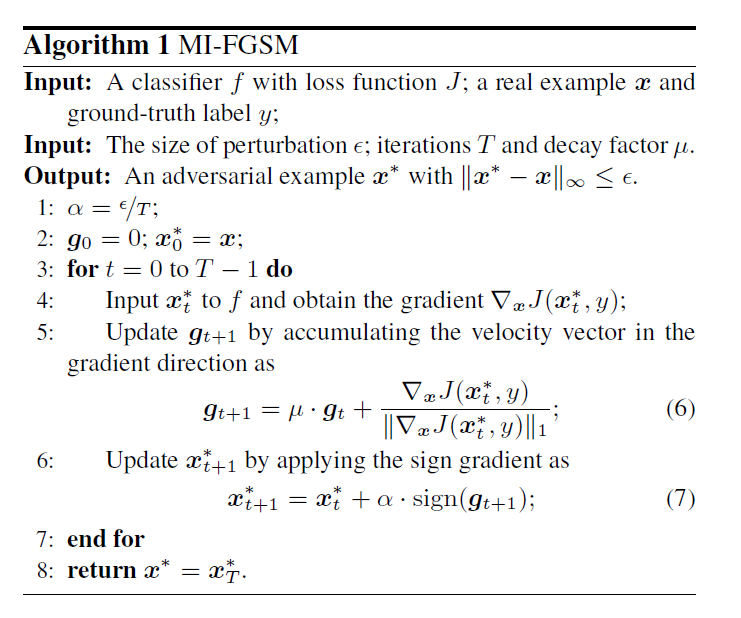
    与iterative FGSM的对比: 其主要的不同点在于iterative FGSM方法中,sign函数中的内容为
    ▽ X J ( X , y ) \triangledown_X J(X, y) ▽X​J(X,y)
    而本文sign函数中的内容,则为下图中的公式(6)。这种动量的思想,其实包含了一种指数衰减平均的思想,其好处在于,能够使目标函数优化方向振幅减小,更易朝着global maxima目标前进,此外还不容易陷入local maxima。

    此外,通过L1范数的约束,能够使各个方向的偏导数归一化,因为作者注意到,每次迭代时,这个损失函数的梯度变化量级非常大。
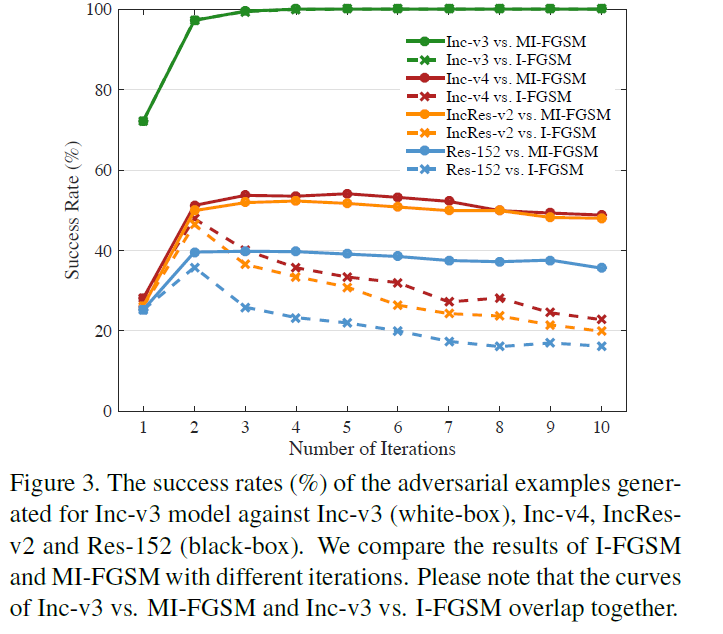
`I-FGSM`和`MI-FGSM`的比较:随着迭代的次数增加,`I-FGSM`容易在`Inc-v3`过拟合,从而对于其他未接触过的模型攻击效果变差,即transferable不好。而`MI-FGSM`则可以有效地对**白盒**模型的进行攻击却依然能保持一定的可迁移性。

case 2: ensemble
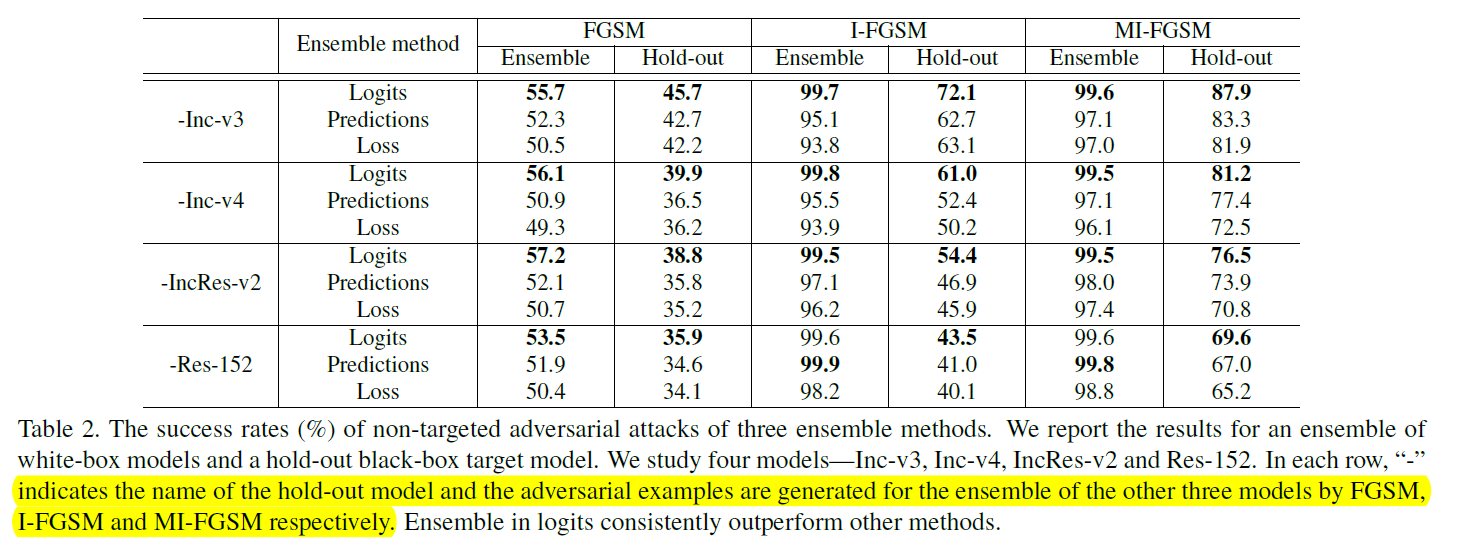
作者尝试了三种集成的策略,分别是
l ( x ) = ∑ k = 1 K w k l k ( x ) l(x) = \sum_{k=1}^{K} w_k l_k(x) l(x)=k=1∑K​wk​lk​(x)
p ( x ) = ∑ k = 1 K w k p k ( x ) p(x) = \sum_{k=1}^{K} w_k p_k(x) p(x)=k=1∑K​wk​pk​(x)
J ( x ) = ∑ k = 1 K w k J k ( x ) J(x) = \sum_{k=1}^{K} w_k J_k(x) J(x)=k=1∑K​wk​Jk​(x)
其中 w k w_k wk​是第k个模型对应的权重

   l k ( x ) l_k(x) lk​(x)表示的是,第k个模型输入softmax的logits
   p k ( x ) p_k(x) pk​(x)表示的是,第k个模型softmax输出的prediciton
   J k ( x ) J_k(x) Jk​(x)表示的是,第k个模型计算得到的loss
不同策略的攻击效果如下。其中hand-out表示的是不参与训练对抗样本的黑盒模型。从下图中可以获得以下结论:

  1. 采用logits集成的策略在总体攻击效果上比其他两者更加有效。
  2. 本文提出的MI-FGSM对白盒和黑盒模型都具有更好的攻击效果,即可迁移性(transferable)更好(因为其对黑盒模型的攻击效果远好于I-FGSM方法)。
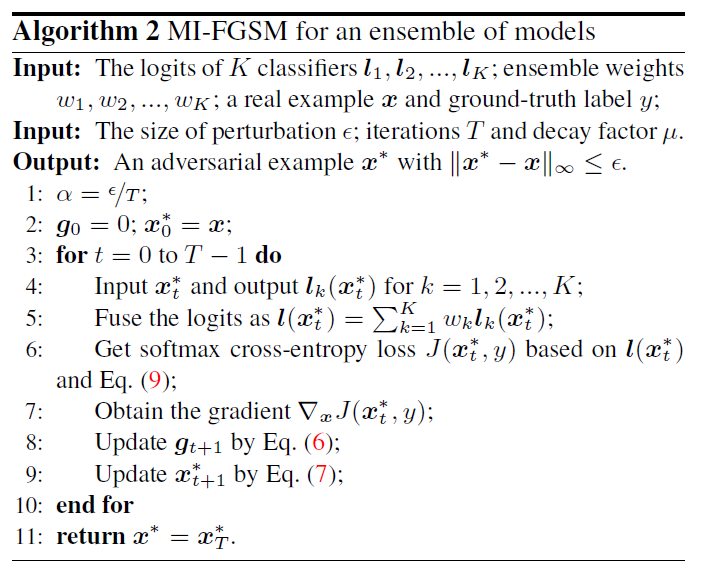
基于`ensemble`的`MI-FGSM`的算法如下。其中公式(9)为 $$ J(x, y) = -1_y \cdot log(softmax(l(x)) $$ 其中`-1_y`是`y`的one-hot编码

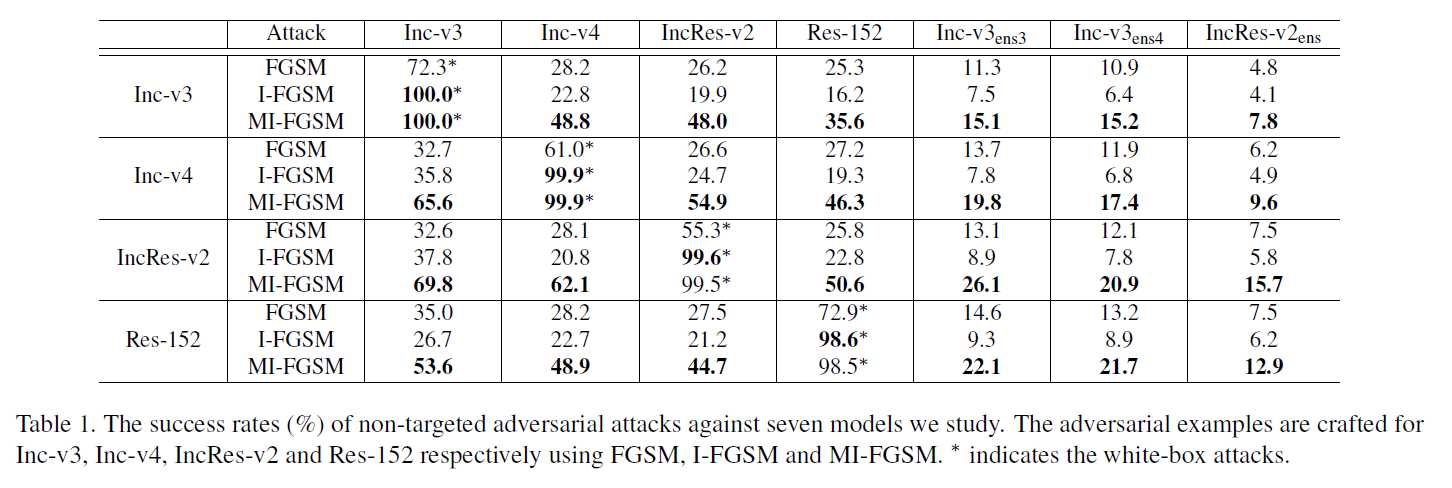
且相比于不采用ensemble策略的MI-FGSM而言,可迁移性也更强!下图为不采用ensemble策略的MI-FGSM效果。

由于这些笔记是之前整理的,所以可能会参考其他博文的见解,如果引用了您的文章的内容请告知我,我将把引用出处加上~
如果觉得我有地方讲的不好的或者有错误的欢迎给我留言,谢谢大家阅读(
点个赞我可是会很开心的哦)~

[paper]Boosting Adversarial Attacks with Momentum 本文提出一个基于动量(Momentum)的迭代算法,该方法通过梯度以迭代的方式对输入进行扰动以最大化损失函数,并且该方法还会在迭代过程中沿损失函数的梯度方向累加速度矢量,目的是稳定更新方向并避免糟糕的局部最大值。从而产生更好的可迁移(transferable)的对抗样本,解决了对抗样本生成算法对于黑盒模型的低成功率问题。 文中提到: 对抗样本迁移性的现象是由于不同的机器学习模型在数据点周围学习到... 阅读详情

相关推荐

Android 12 HAL开发避坑实录:手把手教你用AIDL在Native层实现一个可开机自启动的Service

本文详细介绍了在Android 12 HAL开发中,如何通过AIDL在Native层实现一个可开机自启动的Service。从环境准备、AIDL接口定义、服务实现到VINTF集成与SELinux策略配置,提供了完整的实战指南,帮助开发者避开常见陷阱,提升开发效率。

weixin_28314575的博客 321

Boosting Adversarial Attacks with Momentum

本文为论文阅读笔记,仅用作学习记录,Paper原文链接 注:本文提到的可转移性也可以说是可移植性 背景介绍   这篇文章是清华大学与英特尔中国实验室在2018年联合发布的一篇CVPR,主要提出了使用动量来增强对抗样本的攻击性,也就是在生成对抗样本的迭代过程中加入动量从而使得对抗样本具有较强的攻击性。除此之外这篇文章提出的方法获得了2017年NIPS比赛中无目标攻击组与有目标攻击组中的第一名。 对抗样本目前存在的问题   在文中,作者指出对于对抗样本攻击,目前大部分存在的对抗样本攻击的方法对于黑盒模型而言.

B站搜索 馆主君晓 欢迎关注~ 2350

华为使用MicroG安装并使用Google服务教程

鉴于众多华为手机用户因无法使用Google服务而感到不便,我经过多次摸索和测试,总结了一份简单易懂的教程,希望能够帮助到大家。无论是需要使用Google Play商店下载应用,还是需要使用Google服务进行工作和学习,本文将详细介绍如何在华为手机上安装并使用Google服务。二、前置条件软件要求:Aurora Store(替代Google Play商店)、MicroG Companion、MicroG Server(替代Google框架)

weixin_41926602的博客 3万+

【全文翻译】Boosting Adversarial Attacks with Momentum

深度神经网络容易受到对抗性样本的攻击,由于潜在的严重后果,这对这些算法带来了安全问题。在部署深度学习模型之前,对抗性策略可以作为一个重要的替代工具来评估深度学习模型的可行性。然而,现有的大多数对抗性攻击只能愚弄一个成功率较低的黑盒模型。为了解决这个问题,我们提出了一大类基于动量的迭代算法来增强对抗性攻击。通过在迭代过程中引入动量项,我们的方法可以在迭代过程中稳定更新方向,避免局部极值,从而产生更多可转移的对抗性例子。为了进一步提高黑箱攻击的成功率,我们将动量迭代算法应用到一个模型集合中,并

weixin_43682519的博客 1770

Dify DSL文件分享 Dify讨论群 大模型token资源等(持续收集更新)

基于LLMOps平台-Dify的一站式学习平台。包含不限于:Dify案例、DSL文件分享、模型接入、Dify交流讨论等各类资源分享。

同名公众号:dify实验室 3713

论文那些事——Boosting Adversarial Attacks with Momentum

第五篇Boosting Adversarial Attacks with Momentum(用动量增强对抗性攻击) 1、摘要(文章主要解决什么问题) 提出一种广泛的基于动量的迭代算法来增强对抗性攻击,该方法可以在迭代过程中稳定更新方向并避免局部极大值,解决了对抗样本生成算法对于黑盒模型的低成功率问题。 文中提及到: 对抗样本的移植性是由于不同的模型在数据点周围学习到相似的决策边界这一特性导致的,使得同一对抗样本可以攻击不同模型。 以往的FGSM、I-FGSM得到的对抗样本移植性较差,对黑盒模型的攻

shuweishuwei的博客 684

半导体测试(一)

探针台是一种用于在晶圆上进行配合探针卡进行电路量测的设备,在测试过程中,探针工作站会将探针与晶圆上的每个die进行接触,以进行电性测量。在这个过程中,每个die都被测试以确保它能基本满足器件的特征或设计规格书(Specification),通常包括电压、电流、时序和功能的验证。晶圆是一个圆形的硅片,在这个半导体的基础之上,建立了许多独立的单个的电路;在所有的die都被探测(Probed)之后,晶圆被切割成独立的dice,这就是常说的die saw,所有被标示为失效的die都被报废,。

m0_37606066的博客 8423

Boosting Adversarial Attacks with Momentum-总结与拓展(范数)

对MIM算法的一些总结,把认为重要的东西贴出,并且有代码实现效果,与范数知识的拓展

qq_43367558的博客 1166

python 中心线提取_二值分析 | OpenCV + skimage如何提取中心线

点击上方蓝字关注我们微信公众号:OpenCV学堂关注获取更多计算机视觉与深度学习知识问题前几天有个人问了我一个问题,问题是这样的,他有如下的一张二值图像:怎么得到白色Blob中心线,他希望的效果如下:显然OpenCV中常见的轮廓分析无法获得上面的中心红色线段,本质上这个问题是如何提取二值对象的骨架,提取骨架的方法在OpenCV的扩展模块中,另外skimage包也支持图像的骨架提取。这里就...

weixin_42204453的博客 4290

Python爬虫实战:全自动采集银行理财产品收益率数据

本文通过Playwright动态爬虫技术,成功实现了对银行理财产品收益率数据的实时采集,并通过 Pandas 数据清洗、SQLite 存储、调度自动化等模块,构建了一个可扩展的银行理财数据抓取系统。理财非儿戏,数据做决策。掌握银行收益信息是我们迈向理性投资的第一步。希望这套工具对你有所帮助!

2201_76125261的博客 1152

CVPR2018 | MI-FGSM | 利用动量增强对抗性攻击

这篇文章 “Boosting Adversarial Attacks with Momentum” 主要介绍了一种基于动量迭代梯度的方法来增强对抗性攻击,提出了动量迭代快速梯度符号法(MI-FGSM),并通过实验验证了其有效性。

四口鲸鱼爱吃盐的博客 3688

【人工智能】 WebDev Arena:实时AI Web开发竞赛的技术探索与价值

《AI编程竞赛推动Web开发技术创新》摘要:WebDev Arena作为聚焦Web开发领域的实时AI编程竞赛,通过标准化竞技环境检验AI模型在代码生成、问题解决等方面的能力。竞赛覆盖前端、后端等全流程开发环节,采用实时评分机制,推动AI对复杂Web需求的理解和多元技术栈适配。该赛事不仅促进AI编程技术创新,更为Web开发行业与AI技术融合搭建桥梁,有望提升开发效率、降低技术门槛。未来将拓展Web3.0等前沿技术主题,持续推动行业智能化发展。(150字)

奶爸的编程之路,也就一周冷个三天 254

51c深度学习~合集7

我自己的原文哦~ https://blog.51cto.com/whaosoft/12464014通过对不同下游任务的task vectors进行简单的计算,组合得到的新参数(构成一个线性子空间),可以扩展出更多的使用场景。看到了一篇很有意思的paper,文章对预训练和finetune之后的模型参数之差(task vector = 两个weight按位相减)做了分析,发现了一些奇妙的用法:通过对不同下游任务的task vectors进行简单的计算,组合得到的新参数(构成一个线性子空间),可以扩展出更多的使

whaosoft~aiotの开发板商城 1614

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Boosting Adversarial Attacks with Momentum (翻译,侵删)

Boosting Adversarial Attacks with Momentum 用动量增强对抗攻击 摘要 深度神经网络对于对抗样本是脆弱的,对这些孙发提出了安全的担忧,因为潜在的严重的威胁。对抗样本作为一个重要的代理来评估深度学习模型的鲁棒性,在他们应用之前。然而,大多数存在对抗攻击只能欺骗一个黑盒模型以一个极低的成功率。为了解决这个问题,我们提出了一个更加广的类别,基于动量的迭代算法来增强对抗攻击。通过将动量项集成到攻击的迭代过程中。我们的方法可以稳定更新的方向,导致更具有迁移性的样本。为了进一步改

bash_winner的博客 976

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

论文解读《Boosting Adversarial Attacks with Momentum》

摘要 我们提出了一种广泛的基于动量的迭代算法来增强对抗攻击。通过将动量项集成到迭代过程中,我们的方法可以在迭代过程中稳定更新方向并避免糟糕的局部最大值 1.FGSM 我们先来了解一下迭代的FGSM算法,它通过以下公式来产生扰动x∗x_*x∗​ x∗=x+ϵ∗sign(∇xJ(x∗,y)),(1) x_*=x+{\epsilon}*sign({\nabla}_xJ(x_*,y)),(1) x∗​=x...

qq_18824345的博客 2482

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

Boosting Adversarial Attacks with Momentum论文解读

摘要 深层神经网络容易受到对抗样本的攻击,由于潜在的严重后果,这对这些算法造成了安全问题。对抗性攻击是在部署深度学习模型之前评估其鲁棒性的重要替代手段。然而,大多数现有的对抗性攻击只能愚弄成功率较低的黑盒模型。为了解决这个问题,我们提出了一大类基于动量的迭代算法来增强对抗性攻击。通过将动量项集成到攻击的迭代过程中,我们的方法可以稳定更新方向,并在迭代过程中避开较差的局部极大值,从而产生更多可转移的对抗性示例。为了进一步提高黑盒攻击的成功率,我们将动量迭代算法应用到一组模型中,并表明具有强大防御能力的对抗训练

kking_edc的博客 2339

【迁移攻击笔记】动量逻辑集成!MI-FGSM!Boosting Adversarial Attacks with Momentum

1.更新策略选择 ①optimization-based和多步方法IGSM:成功率高;转移性低。(可能“过拟合”or陷入局部最优) ②单步方法FGSM: 成功率低;转移性高。 所以用: MI-FGSM: 2.集成方式选择 MI-FGSM还不够,得利用集成网络来进一步提高成功率。利用的方式有3种待测试: ①输入softmax的logits ②softmax输出的prediciton ③计算得到的...

weixin_43916250的博客 5573

动量迭代快速梯度符号方法(Momentum Iterative FGSM,MI-FGSM)原理及实现

而动量机制通过累积多次迭代的梯度信息,可以更全面地利用这些梯度信息,从而在更大范围内找到模型的弱点,增强对抗攻击的效果。而动量机制通过累积多个梯度信息,可以帮助模型摆脱局部最优解的困扰,更容易找到全局最优解或更好的局部最优解,从而生成更强的对抗样本。MI-FGSM 将动量引入到 FGSM 中,通过在每一步迭代中累积梯度的动量,生成更强的对抗样本。动量的作用是利用之前的梯度信息来增强当前更新的方向,从而提高对抗样本生成的效率。) 是之前( t )次迭代的累积梯度,即第 ( t ) 步的动量梯度。

2840216705@qq.com欢迎学习交流 3634

清华朱军团队包揽三项冠军 | NIPS 2017对抗样本攻防竞赛总结(附学习资料)

来源:AI科技评论作者:高云河本文共8989字,建议阅读10分钟。本次比赛总结由谷歌大脑、清华大学以及其它参与研究人员们联合撰写,为你介绍NIPS 2017 对抗样本攻防...

数据派THU 3708

对抗攻击(Adversarial Attack)

对抗攻击

ji_meng的博客 1万+

对抗攻击之SMI-FGSM:北航提出用"空间动量"提高对抗迁移性

关注公众号,发现CV技术之美▊引言当前很多对抗攻击方法在白盒条件下都能达到非常高的攻击成功率,但在该条件下生成的对抗样本可迁移性较差。基于动量的攻击MI-FGSM 是提高对抗样本可迁移性的一种非常有效方法,它将动量项集成到迭代过程中,可以通过为每个像素添加梯度的时间相关性来稳定梯度的更新方向。在该论文中作者认为对抗扰动中只有这种时序动量是不够的,还需要引入图像中空间域的...

我爱计算机视觉 1484

【科普】人工智能秒变人工智障:如何误导神经网络指鹿为马

本文用人话介绍了人工智能与信息安全的交叉前沿研究领域:深度学习攻防对抗。包括用对抗样本修改图片误导神经网络指鹿为马、针对不同深度学习模型的逃逸攻击、白盒攻击与黑盒攻击、NIPS 2017神经网络对抗攻防赛清华三连冠团队算法模型解读,以及未来人工智能面临的信息安全挑战。部分内容来自于2018CNCC中国计算机大会—人工智能与信息安全分会场报告。 作者:张子豪(同济大学在读研究生) 微信公众号:子豪...

同济子豪兄 2764

#每天一篇论文 256/365 Multi-adversarial Faster-RCNN for Unrestricted Object Detection

多对抗快速rcnn用于无限制目标检测 摘要 传统的目标检测方法本质上是假设训练和测试数据是从一个有限制的目标域中采集的,并且代价昂贵。为了减轻域依赖性和繁琐的标记问题,提出了利用足够的标签从辅助源域训练的领域知识来检测非受限环境中的对象。具体来说,我们提出了一个多对抗的快速rcnn(maf)框架,用于无限制目标检测。它本质上解决了特征表示中用于域自适应的域差异最小化问题。本文的优点有三:1)针对图...

流浪机器人的博客 1637

神仙打架看不懂?用人话解读NIPS神经网络攻防赛清华三连冠团队模型算法

本文用高中生能听懂的人话介绍了2017NIPS神经网络攻防竞赛清华大学三项冠军团队的算法模型,详细介绍了基本算法FGSM、对抗样本的生成、攻防模型训练、NIPS比赛规则、清华参赛队的模型可迁移性优化策略、降噪优化算法。 作者:张子豪(同济大学在读研究生) 发布于2018-10-29 在阅读下文之前,请先用三分钟阅读本文作者的另一篇科普文:【科普】人工智能秒变人工智障:误导神经网络指鹿为马。这篇...

同济子豪兄 1677

[论文阅读笔记]SEMANTIC ADVERSARIAL ATTACKS: PARAMETRIC TRANSFORMATIONS THAT FOOL DEEP CLASSIFIERS(ICCV)

SEMANTIC ADVERSARIAL ATTACKS: PARAMETRIC TRANSFORMATIONS THAT FOOL DEEP CLASSIFIERS(2019 ICCV) 文章简介: 本文的出发点不同于以前的方法(例如修改某几个像素点或者在原图上添加扰动),本文的对抗样本是通过修改输入图像中某些特殊的特征(例如戴上眼镜),从而产生语义自然的图片的同时,还能愚弄分类器。 类型:w...

Invokar的博客 1566
上一篇: [论文阅读笔记]Adversarial Transformation Networks: Learning to Generate Adversarial Examples
下一篇: [论文阅读笔记]The Limitations of Deep Learning in Adversarial Settings
大鲨鱼冲鸭
博客等级 码龄9年 249粉丝 185原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值