


快速体验
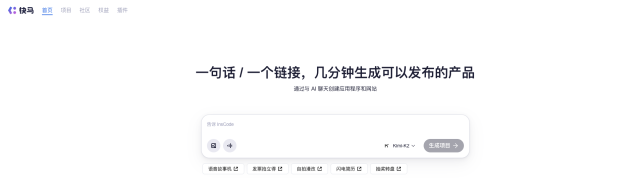
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框内输入如下内容:
在OpenSpeedy平台上,生成一个基于协同过滤的电商推荐系统。要求系统能够根据用户历史行为数据(如浏览、购买记录)生成个性化推荐列表。使用DeepSeek模型生成Python代码,并集成Flask框架提供API接口。代码应包含数据预处理、模型训练和评估模块。 - 点击'项目生成'按钮,等待项目生成完整后预览效果
最近在做一个电商项目,需要实现个性化推荐功能。传统的推荐系统开发流程复杂,从数据清洗到模型部署往往需要花费大量时间。这次尝试用OpenSpeedy平台快速搭建,整个过程比预想的顺利很多,分享一下我的实战经验。
1. 项目规划与数据准备
首先明确需求:根据用户的浏览记录和购买历史,给每个用户推荐可能感兴趣的商品。需要准备两类数据:
- 用户行为数据(user_id, item_id, 行为类型, 时间戳)
- 商品特征数据(item_id, 类别, 价格区间等)
实际项目中这些数据通常来自数据库或日志系统。我在测试时使用了公开的电商数据集,格式整理为CSV文件。
2. 模型选择与代码生成
在OpenSpeedy平台选择"生成代码"功能,输入需求描述后,系统推荐了基于用户的协同过滤算法。这个算法原理很直观:找到相似用户喜欢的内容进行推荐。
平台生成的代码包含完整流程:
- 数据加载与预处理
- 构建用户-商品交互矩阵
- 计算用户相似度(采用余弦相似度)
- 生成Top-N推荐列表
- 模型评估(准确率/召回率)
特别实用的是,代码已经封装好了pandas数据处理和scikit-learn的相似度计算,省去了很多底层编码工作。
3. API服务搭建
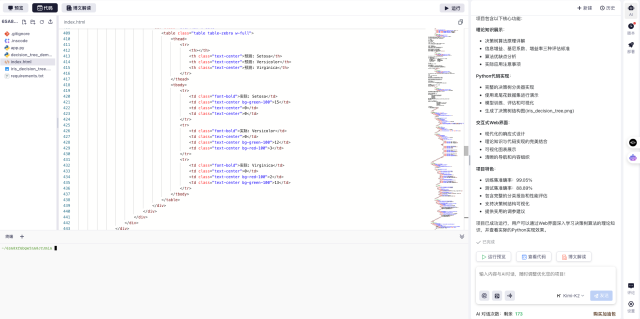
为了让推荐系统能被其他服务调用,需要提供HTTP接口。平台生成的代码已经集成了Flask框架:
- 定义了两个主要接口:
- /recommend (获取推荐列表)
- /feedback (接收用户反馈优化模型)
- 使用pickle保存和加载模型
- 添加了基础的错误处理和日志记录
4. 模型优化实践
初步模型上线后,通过AB测试发现几个可以改进的点:
- 冷启动问题:对新用户采用热门商品补充推荐
- 时效性:增加时间衰减因子,更关注近期行为
- 多样性:在相似度计算中加入商品类别维度
这些优化都在平台上通过修改代码提示词快速实现了迭代。
5. 部署与监控
最惊喜的是部署环节,在InsCode(快马)平台上一键就完成了服务上线。不需要自己配置服务器环境,系统自动生成了可访问的API地址。
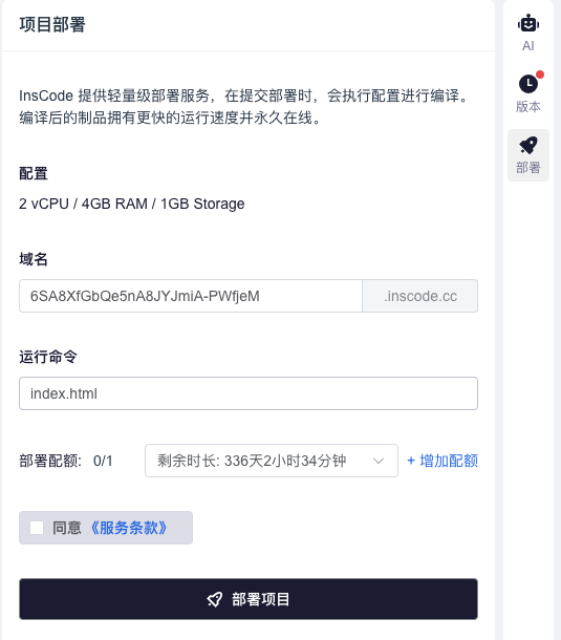
日常监控发现平台还提供了基本的请求量统计和错误日志,对初期运维帮助很大。
经验总结
通过这次实践,发现OpenSpeedy特别适合快速验证推荐算法场景:
- 省去了80%的样板代码编写
- 内置的机器学习库版本兼容性好
- 部署流程极度简化,几分钟就能看到效果
对于中小型电商项目,这种方案既能保证效果,又大幅降低了开发成本。下一步准备尝试集成更多特征,优化推荐精准度。
如果你也在做类似项目,推荐试试InsCode(快马)平台的代码生成+一键部署组合,真的能节省大量重复劳动。
快速体验
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框内输入如下内容:
在OpenSpeedy平台上,生成一个基于协同过滤的电商推荐系统。要求系统能够根据用户历史行为数据(如浏览、购买记录)生成个性化推荐列表。使用DeepSeek模型生成Python代码,并集成Flask框架提供API接口。代码应包含数据预处理、模型训练和评估模块。 - 点击'项目生成'按钮,等待项目生成完整后预览效果


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


