视觉语言模型详解

视觉语言模型可以同时从图像和文本中学习,因此可用于视觉问答、图像描述等多种任务。本文,我们将带大家一览视觉语言模型领域: 作个概述、了解其工作原理、搞清楚如何找到真命天“模”、如何对其进行推理以及如何使用最新版的 trl 轻松对其进行微调。

  • trlhttps://github.com/huggingface/trl

什么是视觉语言模型?

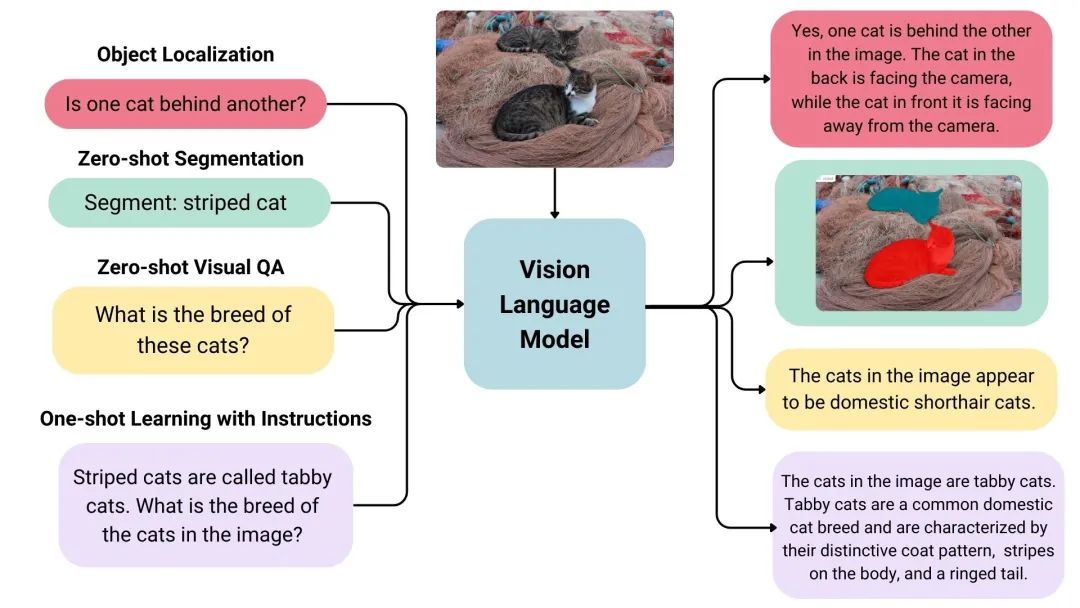
视觉语言模型是可以同时从图像和文本中学习的多模态模型,其属于生成模型,输入为图像和文本,输出为文本。大视觉语言模型具有良好的零样本能力,泛化能力良好,并且可以处理包括文档、网页等在内的多种类型的图像。其拥有广泛的应用,包括基于图像的聊天、根据指令的图像识别、视觉问答、文档理解、图像描述等。一些视觉语言模型还可以捕获图像中的空间信息,当提示要求其检测或分割特定目标时,这些模型可以输出边界框或分割掩模,有些模型还可以定位不同的目标或回答其相对或绝对位置相关的问题。现有的大视觉语言模型在训练数据、图像编码方式等方面采用的方法很多样,因而其能力差异也很大。
be5233ef744fb6883bdd476981a65fa1.jpeg

开源视觉语言模型概述

Hugging Face Hub 上有很多开放视觉语言模型,下表列出了其中一些佼佼者。

  • 其中有基础模型,也有可用于对话场景的针对聊天微调的模型。

  • 其中一些模型具有“接地 (grounding )”功能,因此能够减少模型幻觉。

  • 除非另有说明,所有模型的训练语言皆为英语。

模型可否商用模型尺寸图像分辨率其它能力
LLaVA 1.6 (Hermes 34B)✅34B672x672
deepseek-vl-7b-base✅7B384x384
DeepSeek-VL-Chat✅7B384x384聊天
moondream2✅~2B378x378
CogVLM-base✅17B490x490
CogVLM-Chat✅17B490x490接地、聊天
Fuyu-8B❌8B300x300图像中的文本检测
KOSMOS-2✅~2B224x224接地、零样本目标检测
Qwen-VL✅4B448x448零样本目标检测
Qwen-VL-Chat✅4B448x448聊天
Yi-VL-34B✅34B448x448双语 (英文、中文)

寻找合适的视觉语言模型

有多种途径可帮助你选择最适合自己的模型。

视觉竞技场 (Vision Arena) 是一个完全基于模型输出进行匿名投票的排行榜,其排名会不断刷新。在该竞技场上,用户输入图像和提示,会有两个匿名的不同的模型为其生成输出,然后用户可以基于他们的喜好选择一个输出。这种方式生成的排名完全是基于人类的喜好的。

  • 视觉竞技场 (Vision Arena)https://hf.co/spaces/WildVision/vision-arena
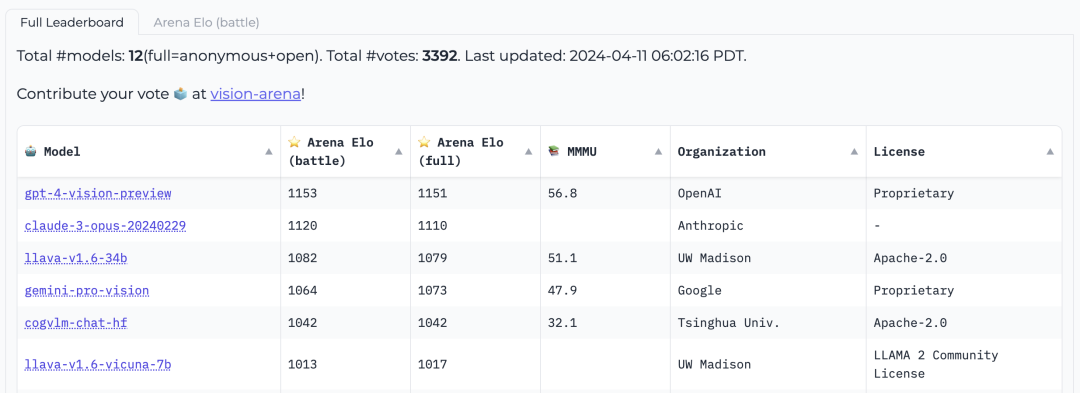
8c2050ceed0022d48c6e48499afcb478.png视觉竞技场 (Vision Arena)

开放 VLM 排行榜 提供了另一种选择,各种视觉语言模型按照所有指标的平均分进行排名。你还可以按照模型尺寸、私有或开源许可证来筛选模型,并按照自己选定的指标进行排名。

  • 开放 VLM 排行榜https://hf.co/spaces/opencompass/open_vlm_leaderboard
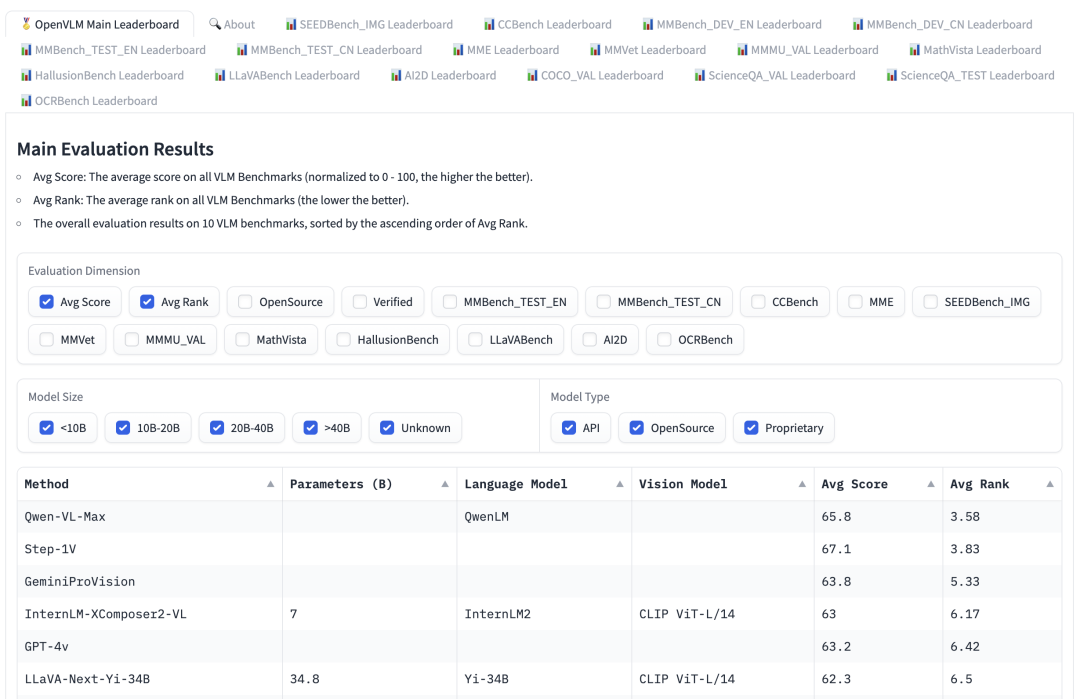
77f16a537e229abb2f53e1a72293b88d.png开放 VLM 排行榜

VLMEvalKit 是一个工具包,用于在视觉语言模型上运行基准测试,开放 VLM 排行榜就是基于该工具包的。

  • VLMEvalKithttps://github.com/open-compass/VLMEvalKit

还有一个评估套件是 LMMS-Eval,其提供了一个标准命令行界面,你可以使用 Hugging Face Hub 上托管的数据集来对选定的 Hugging Face 模型进行评估,如下所示:

  • LMMS-Evalhttps://github.com/EvolvingLMMs-Lab/lmms-eval

accelerate launch --num_processes=8 -m lmms_eval --model llava --model_args pretrained="liuhaotian/llava-v1.5-7b" --tasks mme,mmbench_en --batch_size 1 --log_samples --log_samples_suffix llava_v1.5_mme_mmbenchen --output_path ./logs/

视觉竞技场和开放 VLM 排行榜都仅限于提交给它们的模型,且需要更新才能添加新模型。如果你想查找其他模型,可以在 image-text-to-text 任务下浏览 hub 中的 模型。

  • 模型https://hf.co/models?pipeline_tag=image-text-to-text&sort=trending

在排行榜中,你会看到各种不同的用于评估视觉语言模型的基准,下面我们选择其中几个介绍一下。

MMMU

针对专家型 AGI 的海量、多学科、多模态理解与推理基准 (A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGI,MMMU) 是评估视觉语言模型的最全面的基准。它包含 11.5K 个多模态问题,这些问题需要大学水平的学科知识以及跨学科 (如艺术和工程) 推理能力。

  • 针对专家型 AGI 的海量、多学科、多模态理解与推理基准 (A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGI,MMMU)https://hf.co/datasets/MMMU/MMMU

MMBench

MMBench 由涵盖超过 20 种不同技能的 3000 道单选题组成,包括 OCR、目标定位等。论文还介绍了一种名为 CircularEval 的评估策略,其每轮都会对问题的选项进行不同的组合及洗牌,并期望模型每轮都能给出正确答案。

  • MMBenchhttps://hf.co/datasets/lmms-lab/MMBench

另外,针对不同的应用领域还有其他更有针对性的基准,如 MathVista (视觉数学推理) 、AI2D (图表理解) 、ScienceQA (科学问答) 以及 OCRBench (文档理解)。

技术细节

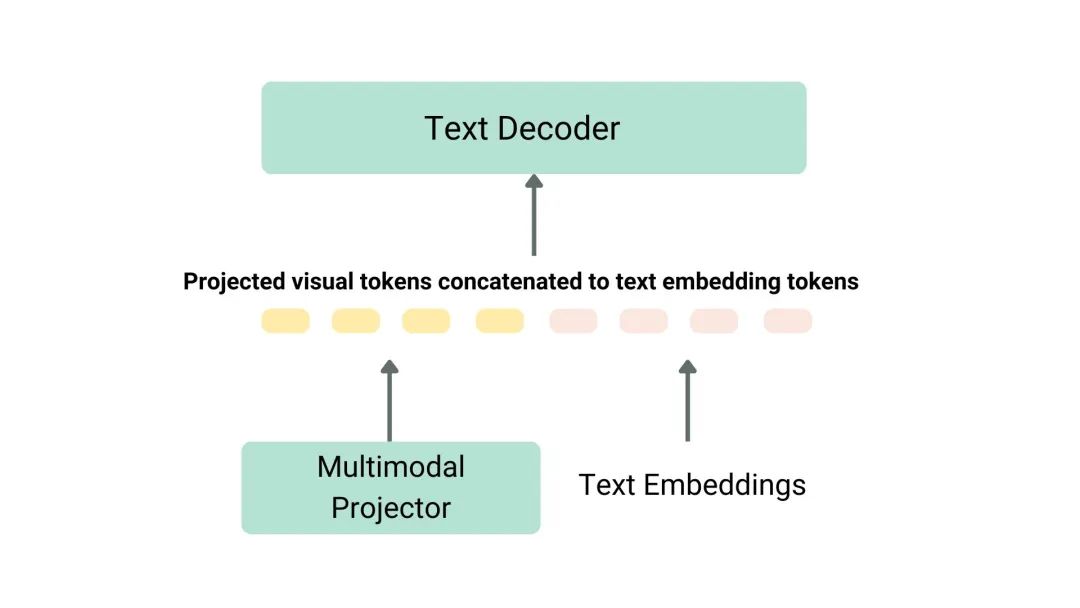
对视觉语言模型进行预训练的方法很多。主要技巧是统一图像和文本表征以将其输入给文本解码器用于文本生成。最常见且表现最好的模型通常由图像编码器、用于对齐图像和文本表征的嵌入投影子模型 (通常是一个稠密神经网络) 以及文本解码器按序堆叠而成。至于训练部分,不同的模型采用的方法也各不相同。

例如,LLaVA 由 CLIP 图像编码器、多模态投影子模型和 Vicuna 文本解码器组合而成。作者将包含图像和描述文本的数据集输入 GPT-4,让其描述文本和图像生成相关的问题。作者冻结了图像编码器和文本解码器,仅通过给模型馈送图像与问题并将模型输出与描述文本进行比较来训练多模态投影子模型,从而达到对齐图像和文本特征的目的。在对投影子模型预训练之后,作者把图像编码器继续保持在冻结状态,解冻文本解码器,然后继续对解码器和投影子模型进行训练。这种预训练加微调的方法是训练视觉语言模型最常见的做法。
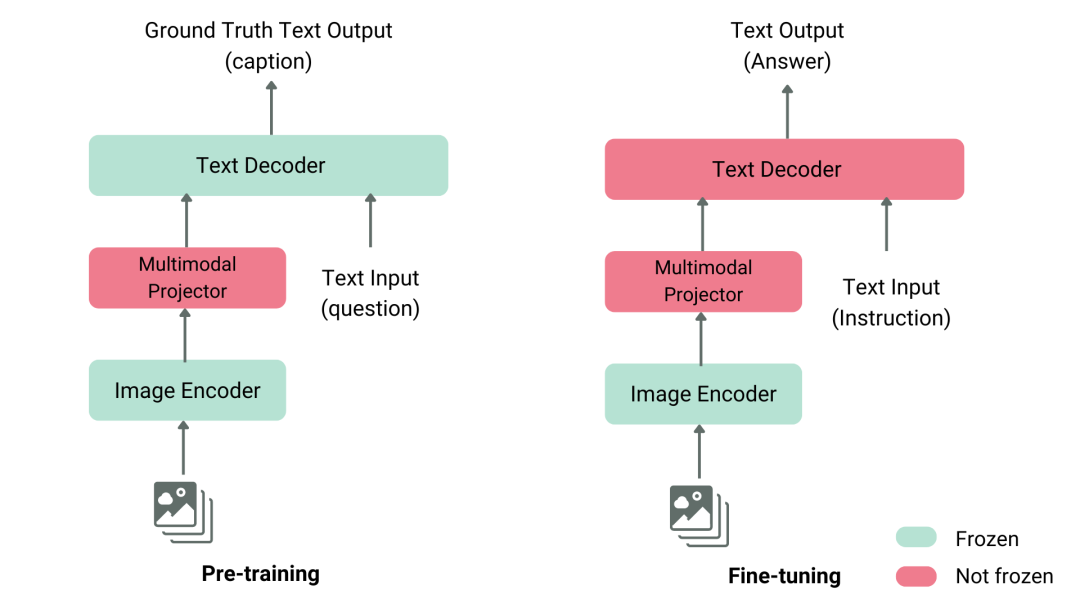
bc9eb67056cd99ad5718111ecab8df28.png
视觉语言模型典型结构

ebf3dc60db393caf85ac17c2a6555e3b.jpeg
将投影子模型输出与文本嵌入相串接

再举一个 KOSMOS-2 的例子,作者选择了端到端地对模型进行完全训练的方法,这种方法与 LLaVA 式的预训练方法相比,计算上昂贵不少。预训练完成后,作者还要用纯语言指令对模型进行微调以对齐。还有一种做法,Fuyu-8B 甚至都没有图像编码器,直接把图像块馈送到投影子模型,然后将其输出与文本序列直接串接送给自回归解码器。

大多数时候,我们不需要预训练视觉语言模型,仅需使用现有的模型进行推理,抑或是根据自己的场景对其进行微调。下面,我们介绍如何在 transformers 中使用这些模型,以及如何使用 SFTTrainer 对它们进行微调。

在 transformers 中使用视觉语言模型

你可以使用 LlavaNext 模型对 Llava 进行推理,如下所示。

首先,我们初始化模型和数据处理器。

from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained("llava-hf/llava-v1.6-mistral-7b-hf")
model = LlavaNextForConditionalGeneration.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf",
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True
)
model.to(device)

现在,将图像和文本提示传给数据处理器,然后将处理后的输入传给 generate 方法。请注意,每个模型都有自己的提示模板,请务必根据模型选用正确的模板,以避免性能下降。

from PIL import Image
import requests

url = "https://github.com/haotian-liu/LLaVA/blob/1a91fc274d7c35a9b50b3cb29c4247ae5837ce39/images/llava_v1_5_radar.jpg?raw=true"
image = Image.open(requests.get(url, stream=True).raw)
prompt = "[INST] <image>\nWhat is shown in this image? [/INST]"

inputs = processor(prompt, image, return_tensors="pt").to(device)
output = model.generate(**inputs, max_new_tokens=100)

调用 decode 对输出词元进行解码。

print(processor.decode(output[0], skip_special_tokens=True))

使用 TRL 微调视觉语言模型

我们很高兴地宣布,作为一个实验性功能,TRL 的 SFTTrainer 现已支持视觉语言模型!这里,我们给出了一个例子,以展示如何在 llava-instruct 数据集上进行 SFT,该数据集包含 260k 个图像对话对。

  • TRLhttps://github.com/huggingface/trl

  • llava-instructhttps://hf.co/datasets/HuggingFaceH4/llava-instruct-mix-vsft

llava-instruct 数据集将用户与助理之间的交互组织成消息序列的格式,且每个消息序列皆与用户问题所指的图像配对。

要用上 VLM 训练的功能,你必须使用 pip install -U trl 安装最新版本的 TRL。你可在 此处 找到完整的示例脚本。

  • 示例脚本https://github.com/huggingface/trl/blob/main/examples/scripts/vsft_llava.py

from trl.commands.cli_utils import SftScriptArguments, TrlParser

parser = TrlParser((SftScriptArguments, TrainingArguments))
args, training_args = parser.parse_args_and_config()

初始化聊天模板以进行指令微调。

LLAVA_CHAT_TEMPLATE = """A chat between a curious user and an artificial intelligence assistant. The assistant gives helpful, detailed, and polite answers to the user's questions. {% for message in messages %}{% if message['role'] == 'user' %}USER: {% else %}ASSISTANT: {% endif %}{% for item in message['content'] %}{% if item['type'] == 'text' %}{{ item['text'] }}{% elif item['type'] == 'image' %}<image>{% endif %}{% endfor %}{% if message['role'] == 'user' %} {% else %}{{eos_token}}{% endif %}{% endfor %}"""

现在,初始化模型和分词器。

from transformers import AutoTokenizer, AutoProcessor, TrainingArguments, LlavaForConditionalGeneration
import torch

model_id = "llava-hf/llava-1.5-7b-hf"
tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.chat_template = LLAVA_CHAT_TEMPLATE
processor = AutoProcessor.from_pretrained(model_id)
processor.tokenizer = tokenizer

model = LlavaForConditionalGeneration.from_pretrained(model_id, torch_dtype=torch.float16)

建一个数据整理器来组合文本和图像对。

class LLavaDataCollator:
    def __init__(self, processor):
        self.processor = processor

    def __call__(self, examples):
        texts = []
        images = []
        for example in examples:
            messages = example["messages"]
            text = self.processor.tokenizer.apply_chat_template(
                messages, tokenize=False, add_generation_prompt=False
            )
            texts.append(text)
            images.append(example["images"][0])

        batch = self.processor(texts, images, return_tensors="pt", padding=True)

        labels = batch["input_ids"].clone()
        if self.processor.tokenizer.pad_token_id is not None:
            labels[labels == self.processor.tokenizer.pad_token_id] = -100
        batch["labels"] = labels

        return batch

data_collator = LLavaDataCollator(processor)

加载数据集。

from datasets import load_dataset

raw_datasets = load_dataset("HuggingFaceH4/llava-instruct-mix-vsft")
train_dataset = raw_datasets["train"]
eval_dataset = raw_datasets["test"]

初始化 SFTTrainer ,传入模型、数据子集、PEFT 配置以及数据整理器,然后调用 train() 。要将最终 checkpoint 推送到 Hub,需调用 push_to_hub() 。

from trl import SFTTrainer

trainer = SFTTrainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    dataset_text_field="text", # need a dummy field
    tokenizer=tokenizer,
    data_collator=data_collator,
    dataset_kwargs={"skip_prepare_dataset": True},
)

trainer.train()

保存模型并推送到 Hugging Face Hub。

trainer.save_model(training_args.output_dir)
trainer.push_to_hub()

你可在 此处 找到训得的模型。你也可以通过下面的页面试玩一下我们训得的模型⬇️。

  • 模型链接https://hf.co/HuggingFaceH4/vsft-llava-1.5-7b-hf-trl
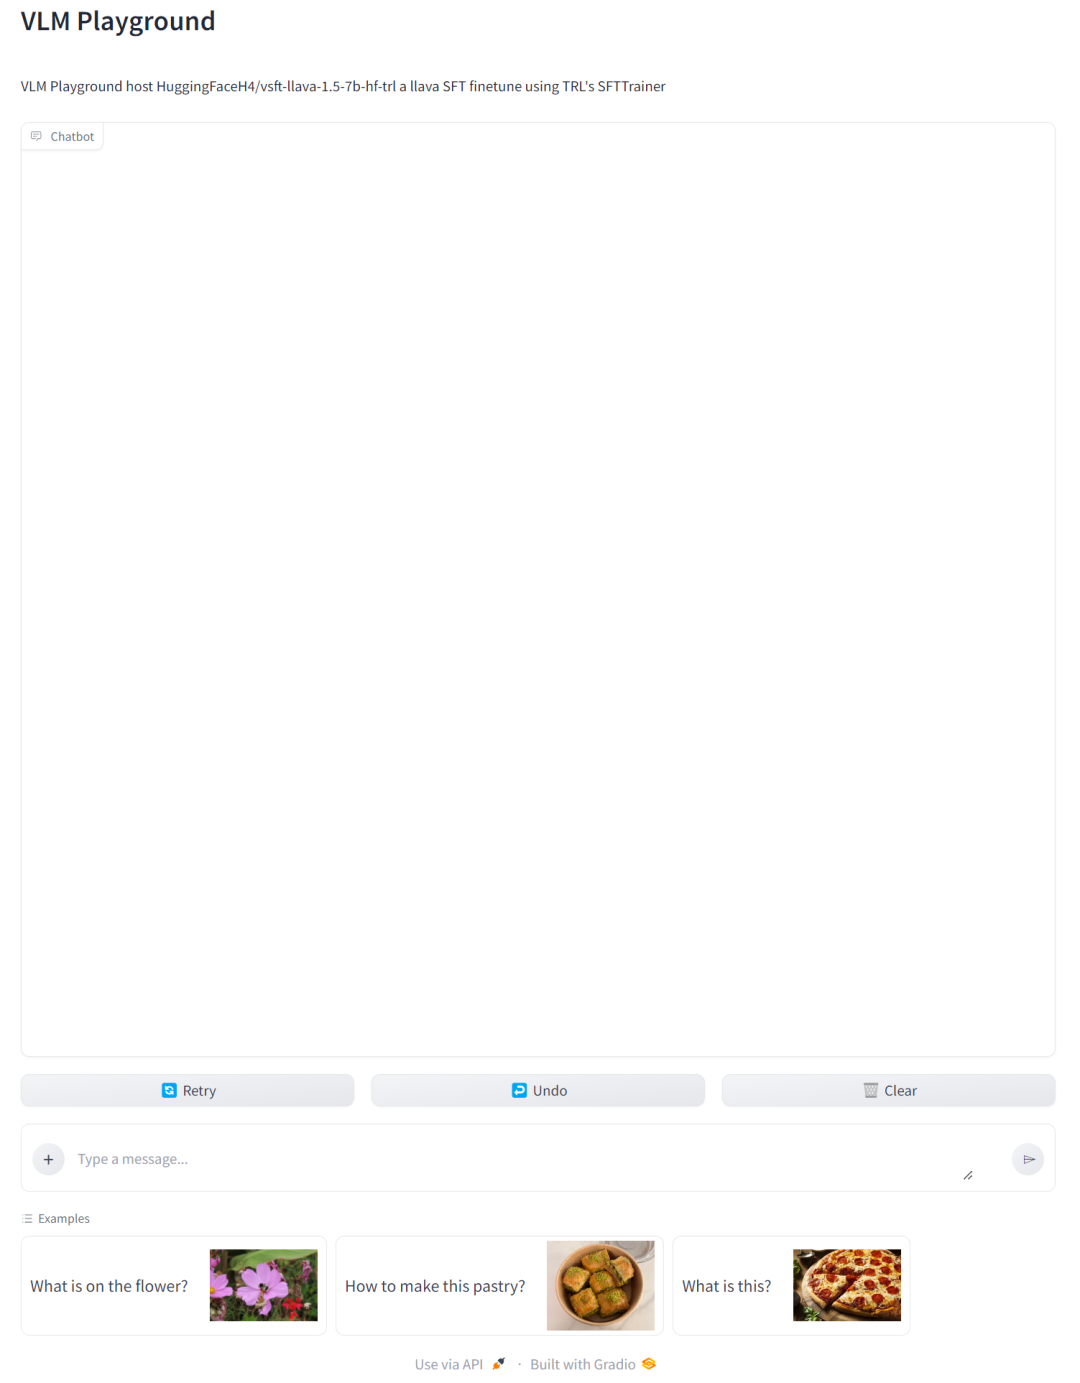
9641acf5fdda7199a258418e83dc4e79.png
https://HuggingFaceH4-vlm-playground.hf.space

致谢

我们感谢 Pedro Cuenca、Lewis Tunstall、Kashif Rasul 和 Omar Sanseviero 对本文的评论和建议。


英文原文: https://hf.co/blog/vlms
原文作者: Merve Noyan,Edward Beeching
译者: Matrix Yao (姚伟峰),英特尔深度学习工程师,工作方向为 transformer-family 模型在各模态数据上的应用及大规模模型的训练推理。

相关推荐

Transformer 中的专家混合模型 (MoE)

每个设备只加载分配给自己的那部分专家,负责对应的计算,并在最后参与结果的汇总。在专家混合 (MoE) 模型中,每个 token 会被路由到不同的专家。时,模型会从标准的张量并行 (Tensor Parallel, TP) 策略切换为专家并行 (Expert Parallel, EP) 策略,并采用专门的切分 (sharding) 方式。将全局专家索引映射为本地索引,屏蔽不属于当前设备的专家,确保每个设备只使用本地专家进行计算,并通过 all-reduce 在设备之间汇总部分计算结果。欢迎告诉我们你希望在。

Hugging Face 683

在 Hugging Face Hub 上引入 Storage Buckets

在未来的规划中,我们将支持 Buckets 与仓库之间的双向直接传输:例如将最终的 checkpoint 权重提升到模型仓库,或者在数据流水线完成后,把处理好的数据分片提交到数据集仓库。如果你来自 S3 风格的对象存储环境,Buckets 也提供了熟悉的使用模式,同时更适配 AI 产物,并能无缝过渡到 Hub 上的最终发布流程。对于一次性操作,可以使用。提供了原生的存放位置,比如 checkpoint、处理后的数据、Agent trace、日志,以及所有在最终定稿之前仍然有价值的中间产物。

Hugging Face 643

LeRobot v0.5.0 正式发布

成为目前规模最大的一次发布 —— 几乎在所有方向上都实现了扩展:支持更多机器人 (包括首个类人机器人) 、更多策略模型 (包括回归的自回归 VLA) 、更快的数据集处理、可以直接从 Hub 加载的仿真环境,以及基于。:我们将 SO-100 和 SO-101 的实现整合到一个更简洁的代码库中 (包括双臂配置) ,减少重复代码,更易维护,同时保持原有功能。从更严格的类型检查到更健壮的测试基础设施,我们正在持续加强 LeRobot 的基础架构,以支持未来更大规模的发展。这大大降低了分享自定义仿真环境的门槛。

Hugging Face 822

全球开源 AI 生态的未来:从 DeepSeek 到 AI+

资源约束并未限制中国 AI 的发展,相反,在某些方面,它们重塑了其发展轨迹。截至 2025 年中,Qwen 成为 Hugging Face 上衍生模型数量最多的基础模型,已有超过 11.3 万个模型以 Qwen 为基座构建,超过 20 万个模型仓库标注了 Qwen,远高于 Meta 的 Llama(2.7 万)或 DeepSeek(6 千)。通过在更开放的系统中打通模型、芯片与 PaddlePaddle,百度得以在算力、成本和监管等共同约束下,降低成本、吸引开发者并影响行业标准,同时保持自身的战略控制力。

Hugging Face 659

DeepSeek之后:中国开源人工智能生态的架构选择

与此同时,训练侧的信号也开始显现。相比之下,定制化和约束性更强的许可证因为不被熟知、理解成本高,增加了新的法律风险,在实际使用中显著增加了摩擦成本,从而降低了采用意愿,这也直接导致了图中所显示的整体下滑。在统一的能力框架下,根据任务的复杂度与价值,动态激活不同数量的专家,从而在不同请求与部署环境中分配计算资源。例如,在 DeepSeek-V3.2-Exp 发布时,华为昇腾与寒武纪芯片实现了“首日支持”,并非云端演示,而是与模型权重一同发布的可复现推理流水线,使开发者能够直接验证真实世界中的性能表现。

Hugging Face 1001

<span class=“js_title_inner“>DeepSeek之后:中国开源人工智能生态的架构选择</span>

与此同时,训练侧的信号也开始显现。相比之下,定制化和约束性更强的许可证因为不被熟知、理解成本高,增加了新的法律风险,在实际使用中显著增加了摩擦成本,从而降低了采用意愿,这也直接导致了图中所显示的整体下滑。在统一的能力框架下,根据任务的复杂度与价值,动态激活不同数量的专家,从而在不同请求与部署环境中分配计算资源。例如,在 DeepSeek-V3.2-Exp 发布时,华为昇腾与寒武纪芯片实现了“首日支持”,并非云端演示,而是与模型权重一同发布的可复现推理流水线,使开发者能够直接验证真实世界中的性能表现。

Hugging Face 935

推出 AnyLanguageModel:在 Apple 平台统一本地与远程大语言模型的 API

对于 Xcode 项目 (目前还不支持直接声明 trait) , 你可以创建一个内部的 Swift 包,指定所需 trait 依赖 AnyLanguageModel, 然后将这个包作为本地依赖添加到你的项目中。我们在这里做了有意识的取舍, 也许我们现在的设计将来会和 Apple 官方的实现产生冲突, 但这正是废弃警告 (deprecation warnings) 存在的意义。这个项目是一个起点: 你可以 fork 它、扩展它、替换不同的模型, 了解各个模块如何协作,并根据自己的需求进行定制。

Hugging Face 647

使用 Hugging Face 轻松构建并共享 ROCm 内核

自定义内核是高性能深度学习的基础,它让 GPU 操作能完全贴合你的工作负载需求——无论是图像处理、张量变换,还是其他计算密集型任务。然而,要为正确的架构编译这些内核、配置各种编译标志并干净地整合到 PyTorch 扩展中,往往会变成一团乱麻 (CMake/Nix、编译错误、ABI 问题等)。这保证了你的内核既高效、又可移植,还能无缝集成到 PyTorch 中。一旦构建完成,只需上传到 Hugging Face Hub,社区中的其他人就能直接使用你的自定义内核——几行代码即可完成集成,轻松共享高性能成果。

Hugging Face 1360

“DeepSeek 时刻” 一周年

DeepSeek 的 R1 模型降低了获取先进模型能力的门槛,并提供了一种清晰、可供效仿的发展范式,从而解锁了新的发展层级。来自美国机构的重要发布。表面上看似合作的行为,更准确地说,是在共同的技术、经济与监管压力下形成的对齐。这是中国的开源模型首次进入全球主流榜单,并且在随后的一年中,每当有新模型发布时,它都反复被用作重要的参考基准。与 2024 年相比,R1 发布之后,中国的人工智能格局逐步形成了一种新的态势:大型科技公司率先行动,初创公司迅速跟进,来自垂直行业的公司也越来越多地进入这一领域。

Hugging Face 874

Transformers v5 中的分词系统:更简洁、更清晰、更模块化

最糟糕的是,你无法创建一个空的分词器架构。如果你想用自己的数据训练一个 LLaMA 风格的分词器,没有简单的方法可以初始化一个“空白”的 LLaMA 分词器并填入自定义的词表和合并规则。最终得到的分词器将拥有你自定义的词表和合并规则,但在处理文本时的行为将与标准的 LLaMA 分词器完全一致:空格处理、特殊 token 规则、解码行为都相同。这些模型专属的分词器类会根据各自模型的需求,对后端进行配置,包括正确的词表、合并规则、特殊 token,以及标准化设置等,确保分词行为与模型训练时保持一致。

Hugging Face 809

<span class=“js_title_inner“>Transformers v5 中的分词系统:更简洁、更清晰、更模块化</span>

最糟糕的是,你无法创建一个空的分词器架构。如果你想用自己的数据训练一个 LLaMA 风格的分词器,没有简单的方法可以初始化一个“空白”的 LLaMA 分词器并填入自定义的词表和合并规则。最终得到的分词器将拥有你自定义的词表和合并规则,但在处理文本时的行为将与标准的 LLaMA 分词器完全一致:空格处理、特殊 token 规则、解码行为都相同。这些模型专属的分词器类会根据各自模型的需求,对后端进行配置,包括正确的词表、合并规则、特殊 token,以及标准化设置等,确保分词行为与模型训练时保持一致。

Hugging Face 915

构建开放的未来——我们与 Google Cloud 的全新合作伙伴关系

我们非常期待通过与 Google Cloud 的深入合作,让这一愿景加速实现——无论你使用的是 Vertex AI Model Garden、Google Kubernetes Engine、Cloud Run,还是 Hugging Face Inference Endpoints。通过这个 CDN Gateway,Hugging Face 的模型和数据集将直接缓存在 Google Cloud 上,大幅减少下载时间,并提升 Google Cloud 用户在模型供应链方面的稳定性和可靠性。

Hugging Face 659

使用 NVIDIA Isaac 构建医疗机器人:从仿真到部署

该流程通过约 70 个仿真演示和 10–20 个真实演示相结合,在模拟多样场景的同时,也保留真实数据的可靠性。NVIDIA Isaac for Healthcare 是一个专为 AI 医疗机器人开发者打造的框架,提供从数据采集到训练、评估再到部署的全流程工具链,适用于仿真环境与真实硬件。仿真一直是医学影像中弥补数据缺口的重要手段,但在医疗机器人领域,它过去往往速度太慢、系统割裂,或难以迁移到现实应用中。值得一提的是,超过 93% 的策略训练数据来自仿真环境,充分说明仿真技术在缩小机器人数据鸿沟方面的优势。

Hugging Face 1686

Codex 正在推动开源 AI 模型的训练与发布

你可以训练 0.5B 到 7B 参数规模的模型,将它们转换为 GGUF 格式便于本地运行,还可以通过多阶段流程结合不同方法。Trackio 会通过自动运行评估任务,帮助你监控训练和评估的得分,并选择表现最好的模型检查点 (checkpoint)。这里的重点不是“Codex 自己开源模型”,而是让 Codex 作为编码代理,参与并自动化开源模型的训练、评估与发布全流程。我们已经展示了 Codex 如何处理模型微调的完整生命周期,验证数据、选择硬件、生成训练脚本、提交任务、监控进度,以及转换输出。

Hugging Face 884

经同意的语音克隆

每次生成时,系统会随机选择一个日常话题 (如天气、美食或音乐) ,使句子内容丰富多样,也更自然好读,有助于录音清晰、自然,并具备良好的语音质量,同时包含明确的同意声明。换句话说,模型不会擅自“说出”你的声音,除非你亲口同意。也就是说,“同意”成为系统运行的前提条件,让原本抽象的伦理原则变成了具体可操作的系统规则,并形成可追溯、可审核的交互记录:AI 模型只会在明确同意之后才运行。现在很多语音克隆模型只需要一句话就能模仿说话人的声音,因此这句用于表达“同意”的句子,也可以同时作为语音克隆的输入数据。

Hugging Face 1164

流式数据集:效率提升 100 倍!

比如,在 Hugging Face 上传大型数据集时,Xet 的去重机制大幅减少了数据传输量,上传更快;流式加载一直是快速了解数据集的好方法,但在训练模型时,大多数人仍然选择将数据预先下载到本地,或使用 S3 等云存储——我们在训练。包,支持 Spark 直接读写 HF 数据集,内置对 Parquet CDC 和 Xet 的支持,大幅加快大数据处理。在机器学习中,特别是在处理 TB 级别的数据时,数据加载一直是个大难题。库还不支持,或者你希望获得更高的控制权,我们也提供了强大的自定义流式能力。

Hugging Face 978

huggingface_hub 1.0 正式版现已发布:开源机器学习基础五周年回顾

在 Hugging Face Hub 的早期阶段,研究人员和开发者常常面临一个困扰: 训练一个先进的模型不仅耗时、耗资源,而且在训练完成后,模型往往“被困”在个人电脑里,只能通过不稳定的 Google Drive 链接进行分享。不再依赖单一的推理后端,而是与多家无服务器推理平台合作,包括 Together AI、SambaNova、Replicate、Cerebras、Groq 等,用户通过一个统一的 API 即可调用多个后端,路由透明,按请求计费,真正实现了“按需调用,轻松推理”。

Hugging Face 1618

Hugging Face 论文页面功能指南

认领成功后,系统会将你标记为论文的提交者,即可向 Daily Papers 提交论文。在每篇论文的页面右侧,你都能找到相关资源链接,例如模型、数据集、Spaces 以及其他有用的集合。作者只需在相关资源(如模型或数据集)的 README.md 中添加该论文的 arXiv 链接,即可将资源与论文自动关联。论文提交不限于你自己的工作,你也可以分享任何你认为对社区有价值的研究论文。如果你的论文尚未在 Hugging Face 论文页面建立索引,只需点击 index 按钮,即可一步添加。如果你是首次分享论文。

Hugging Face 646

LeRobot v0.4.0 正式发布:全面提升开源机器人的学习能力

LeRobot v0.4.0 为开源机器人领域带来重要升级:引入可扩展的 Datasets v3.0、强大的新 VLA (视觉-语言-动作) 模型如 PI0.5 与 GR00T N1.5,以及全新的插件系统,简化硬件集成。从重构的数据集到灵活的编辑工具、新的仿真环境,以及面向硬件的全新插件系统,LeRobot 正在持续演进,以满足前沿具身智能 (Embodied AI) 不断发展的需求。模型需要在正确设备上的规范化、按批次的张量,而你的机器人硬件则需要特定格式的动作命令。更多细节可阅读我们此前的。

Hugging Face 1798

Gaia2 与 ARE:赋能社区的智能体评测

现有的评测环境通常与特定任务紧密耦合,缺乏真实世界的灵活性,也无法反映开放世界中混乱的现实:模拟页面不会加载失败,事件不会自发发生,也不存在异步混乱。在理想情况下,AI 智能体应当是可靠的助手。当接收到任务时,它们能够轻松处理指令中的歧义,构建逐步执行的计划,正确识别所需资源,按计划执行而不被干扰,并在突发事件中灵活适应,同时保持准确性,避免幻觉。当接收到任务时,它们能够轻松处理指令中的歧义,构建逐步执行的计划,正确识别所需资源,按计划执行而不被干扰,并在突发事件中灵活适应,同时保持准确性,避免幻觉。

Hugging Face 1812

ZeroGPU Spaces 加速实践:PyTorch 提前编译全解析

它高效、灵活,非常适合演示,不过需要注意的是,ZeroGPU 并不能在所有场景下完全发挥 GPU 与 CUDA 栈的全部潜能,比如生成图像或视频可能需要相当多的时间。根据模型的不同,这个过程可能需要几十秒到几分钟,对于 Spaces 中的实际 GPU 任务来说,这显然太慢了。通过提前编译,我们可以在一开始导出已编译的模型,将其保存,然后在任意进程中即时加载。否则,如果存在不兼容问题,就会报错。例如,在 Wan 系列视频生成模型中,如果你希望编译后的模型能够生成不同分辨率的内容,就会遇到这种情况。

Hugging Face 961

开源开发者须知:欧盟《人工智能法案》对通用人工智能模型的最新要求

根据 其第 3 条第 63 款 的定义,GPAI 模型是指:“人工智能模型,包括那些通过大规模自监督方式训练、具备显著通用性,并能够胜任多种不同任务的模型,无论其在市场上的投放方式如何,该类模型都能够被集成到各种下游系统或应用中。虽然《网络弹性法案》的措辞可能对《人工智能法案》的解释不具备约束力,但其中的这一表述以及其他相关措辞确实指向一种理解,即在FOSS 许可下提供的软件,并不总是、也并非本质上就应当被视为《网络弹性法案》意义下的“商业活动”,特别是在生产者未对其进行“商业化”的情况下。

Hugging Face 2119

欢迎 GPT OSS —— 来自 OpenAI 的全新开放模型家族!

在 GPT OSS 中,system 消息遵循严格格式,并包含当前日期、模型身份以及推理强度等级等信息,而 “developer” 消息则更为自由,这 (令人困惑地) 使它类似于其他模型的 “system” 消息。Hugging Face 与 Azure 合作,将最受欢迎的开源开放模型 (涵盖文本、视觉、语音与多模态任务) 直接引入 Azure AI Model Catalog,便于客户在托管在线端点中安全部署,借助 Azure 的企业级基础设施、自动扩缩与监控能力。轻松在多张 GPU 上部署。

Hugging Face 2556

Hugging Face 开源机器人 Reachy Mini 开启预定

无论是 AI 开发者、极客或黑客、科研人员、教育工作者、机器人爱好者,还是与孩子一同学习编程的家长,Reachy Mini 都能帮助你在桌面环境中高效完成 AI 应用的开发、最新算法的测试、项目的实际部署以及创新成果的共享。:通过上传、下载和分享机器人行为,实现行为复用与组合创新,随着 Reachy Mini 社区的发展,可能性将呈指数级扩展。:与 Hugging Face 社区超千万用户一起,上传、分享与下载机器人行为,共同扩展智能机器人的边界。:集成摄像头、麦克风与扬声器,支持基于 AI 的视听交互。

Hugging Face 1801

开源人工智能:数字主权的基石

像 OLMO2(一个相对较小的模型,其训练方法和数据完全透明,性能与 OpenAI 的 o1-mini 相当)或 OlympicCoder(一个更小的模型,在复杂编码任务上性能超过最新的 Claude 模型)这样的开源项目,充分体现了协同创新在构建先进人工智能模型中的潜力。这种能力的积累,不仅有助于形成符合本地价值观与监管要求的人工智能系统,更是面向未来的关键竞争力,在人工智能深度塑造经济、治理与社会结构的时代背景下,具有不可替代的长期战略意义。:确保在一国领土内生成的数据受该国法律和治理结构的约束。

Hugging Face 1277

nanoVLM: 简洁、轻量的纯 PyTorch 视觉-语言模型训练代码库

该模块将视觉主干网络产生的图像嵌入作为输入,并将它们转换为与语言模型嵌入层的文本嵌入兼容的嵌入。减少了图像标记的数量,这有助于降低计算成本并加快训练速度,特别是对于对输入长度敏感的基于 transformer 的语言解码器。下图演示了这个概念。在这篇博客中,我们介绍了什么是 VLM,探讨了支撑 nanoVLM 的架构选择,并详细解释了训练和推理工作流程。,可以帮助你构建和训练一个能够理解图像和文本,并基于此生成文本的模型。如果你尝试了它,并在它的基础上尝试构建,或者你只是有问题,我们都很乐意听到你的反馈。

Hugging Face 1473

HF Papers 直播| AI Insight Talk 强化学习专场

研究方向为多模态通用感知模型、多模态大模型后训练算法,在人工智能国际顶级会议及期刊发表论文十余篇,谷歌学术累计引用超过1900次,作为核心作者(共一二作)参与研发的多模态大模型InternVL-Chat系列模型在HuggingFace社区累计下载量突破1000万次,开源代码在Github获得stars超过8000个。已在 NeurIPS,ICLR,ACL 等国际顶级会议上发表多篇论文,谷歌学术引用量 600+,担任 NeurIPS 等顶级会议审稿人。为了更好的社区互动过,我们在本次直播加入了圆桌讨论环节。

Hugging Face 1260

SmolVLA: 让机器人更懂 “看听说做” 的轻量化解决方案

从左到右: (1) 异步的拾取 - 放置立方体计数,(2) 同步的拾取 - 放置立方体计数,(3) 在扰动下的拾取 - 放置立方体计数,(4) 在真实世界 SO101 上的乐高积木拾取 - 放置任务泛化。与学术基准不同,社区数据集自然地捕捉到了杂乱、现实的互动: 多变的光照、不完美的演示、非常规物体和异质的控制方案。在过去的几年里,Transformers 技术推动了人工智能的显著进展,从能够进行类人推理的语言模型到理解图像和文本的多模态系统。然而,在实际的机器人领域,进展则相对较慢。

Hugging Face 2427

参加 Hugging Face 组织的 Gradio & MCP 智能体主题黑客松

一场以智能体 (Agent) 和模型上下文协议 (Model Context Protocol,简称 MCP) 为核心的全球在线黑客松即将来袭!Model Context Protocol (MCP) 是一个开放协议,旨在标准化应用如何向大语言模型 (LLM) 提供上下文信息。:在 6 月 8 日 23:59 (UTC) 之前提交至对应的 Hugging Face Spaces。构建一个完整的 AI 智能体展示应用 (可使用 MCP,也可以不使用) ,让我们看到它真正能做些什么!

Hugging Face 1608

大模型评估排障指南 | 关于可复现性

它们在标准测试集 MATH-Hard 上预测的答案完全正确,但在 few-shot 简单模板测试中评估得分反而较低,很可能就是过拟合了 GSM8K 数据集 (另一个数学测试集) 的 prompt 和答案格式。,如果不看代码,你可能觉得就是上文提到的那样,直接对比预测结果和参考答案,不过: 如果查看代码会发现,在做对比之前预测结果还多做了一步归一化 (去除标点符号、统一数字格式等),这明显会改变对比得分。(没错不用惊讶,不一致时也会影响结果差异,因为不同模型对不同样本的表现是不一样的)。

Hugging Face 1157
上一篇: 使用 Gradio 的“热重载”模式快速开发 AI 应用
下一篇: 开源医疗大模型排行榜: 健康领域大模型基准测试
Hugging Face
Hugging Face Hugging Face 官方账号 Hugging Face 官方账号
博客等级 码龄4年 1862粉丝 378原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值