使用 BLIP-2 零样本“图生文”

本文将介绍来自 Salesforce 研究院的 BLIP-2 模型,它支持一整套最先进的视觉语言模型,且已集成入 🤗 Transformers。我们将向你展示如何将其用于图像字幕生成、有提示图像字幕生成、视觉问答及基于聊天的提示这些应用场景。

BLIP-2 模型文档:
https://hf.co/docs/transformers/main/en/model_doc/blip-2

Transformers 模型及文档:
https://hf.co/transformers

简介

近年来,计算机视觉和自然语言处理领域各自都取得了飞速发展。但许多实际问题本质上其实是多模态的,即它们同时涉及几种不同形式的数据,如图像和文本。因此,需要视觉语言模型来帮助解决一系列组合模态的挑战,我们的技术才能最终得到广泛落地。视觉语言模型可以处理的一些 图生文 任务包括图像字幕生成、图文检索以及视觉问答。图像字幕生成可以用于视障人士辅助、创建有用的产品描述、识别非文本模态的不当内容等。图文检索可以用于多模态搜索,也可用于自动驾驶场合。视觉问答可以助力教育行业、使能多模态聊天机器人,还可用于各种特定领域的信息检索应用。

现代计算机视觉和自然语言模型在能力越来越强大的同时,模型尺寸也随之显著增大。由于当前进行一次单模态模型的预训练既耗费资源又昂贵,因此端到端视觉语言预训练的成本也已变得越来越高。

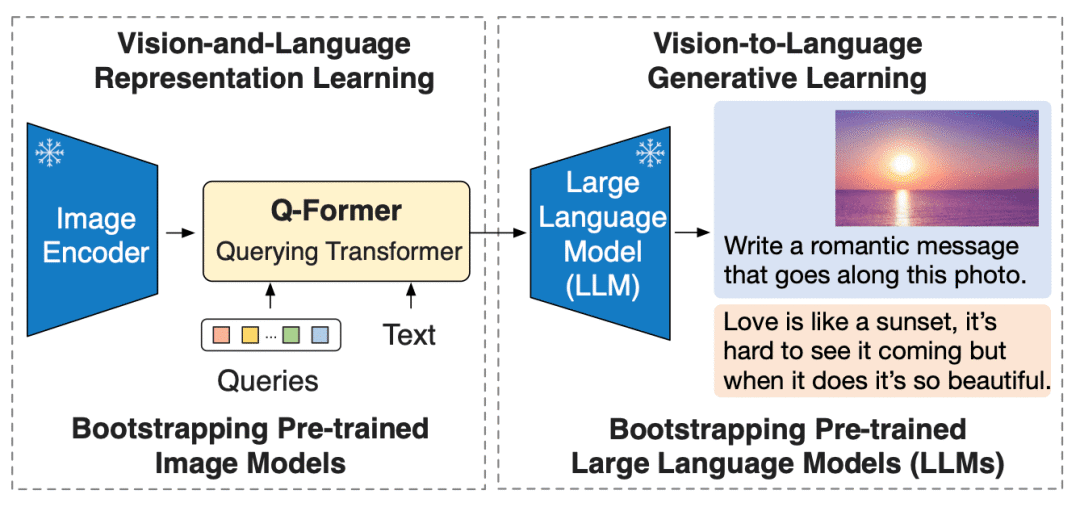
BLIP-2 通过引入一种新的视觉语言预训练范式来应对这一挑战,该范式可以任意组合并充分利用两个预训练好的视觉编码器和 LLM,而无须端到端地预训练整个架构。这使得我们可以在多个视觉语言任务上实现最先进的结果,同时显著减少训练参数量和预训练成本。此外,这种方法为多模态ChatGPT 类应用奠定了基础。

BLIP-2 论文链接:
https://arxiv.org/pdf/2301.12597.pdf

BLIP-2 葫芦里卖的什么药?

BLIP-2 通过在冻结的预训练图像编码器和冻结的预训练大语言模型之间添加一个轻量级 查询 Transformer (Query Transformer, Q-Former) 来弥合视觉和语言模型之间的模态隔阂 (modality gap)。在整个模型中,Q-Former 是唯一的可训练模块,而图像编码器和语言模型始终保持冻结状态。
0348e8d8fe98d1f2d136186f2be94866.png
BLIP-2 框架概览

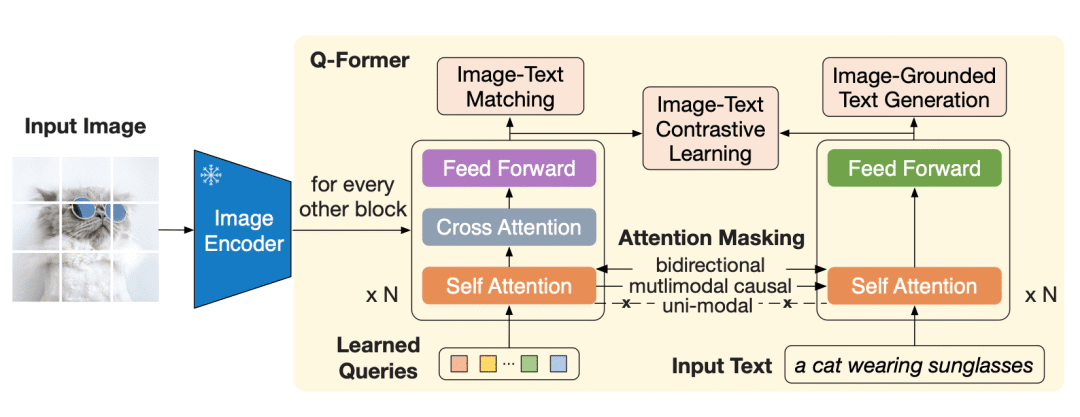
Q-Former 是一个 transformer 模型,它由两个子模块组成,这两个子模块共享相同的自注意力层:

  • 与冻结的图像编码器交互的图像 transformer,用于视觉特征提取

  • 文本 transformer,用作文本编码器和解码器

0c60f656b6dc96c7cf9fc0bb60a8d3d4.png
Q-Former 架构

图像 transformer 从图像编码器中提取固定数量的输出特征,这里特征的个数与输入图像分辨率无关。同时,图像 transformer 接收若干查询嵌入作为输入,这些查询嵌入是可训练的。这些查询还可以通过相同的自注意力层与文本进行交互 (译者注: 这里的相同是指图像 transformer 和文本 transformer 对应的自注意力层是共享的)。

Q-Former 分两个阶段进行预训练。

第一阶段,图像编码器被冻结,Q-Former 通过三个损失函数进行训练:

  • 图文对比损失 (image-text contrastive loss): 每个查询的输出都与文本输出的 CLS 词元计算成对相似度,并从中选择相似度最高的一个最终计算对比损失。在该损失函数下,查询嵌入和文本不会 “看到” 彼此。

  • 基于图像的文本生成损失: 查询内部可以相互计算注意力但不计算文本词元对查询的注意力,同时文本内部的自注意力使用因果掩码且需计算所有查询对文本的注意力。

  • 图文匹配损失 (image-text matching loss): 查询和文本可以看到彼此,最终获得一个几率 (logit) 用以表示文字与图像是否匹配。这里,使用难例挖掘技术 (hard negative mining) 来生成负样本。

图像 transformer 作为一个信息瓶颈 (information bottleneck),查询嵌入经过它后,其输出嵌入已经不仅仅包含了视觉信息,而且包含了与文本相关的视觉信息。这些输出嵌入用作第二阶段 LLM 输入的视觉前缀。该预训练阶段主要涉及一个以基于图像的文本生成任务,损失函数使用因果 LM 损失。

BLIP-2 使用 ViT 作为视觉编码器。而对于 LLM,论文作者使用 OPT 和 Flan T5 模型。你可以找到在 Hugging Face Hub 上找到 OPT 和 Flan T5 的预训练 checkpoints。

在 Hugging Face Hub 中检索 BLIP-2 相关模型:
https://hf.co/models?other=blip-2

但不要忘记,如前所述,BLIP-2 设计的预训练方法允许任意的视觉主干模型和 LLM 的组合。

通过 Hugging Face Transformers 使用 BLIP-2

使用 Hugging Face Transformers,你可以轻松下载并在你自己的图像上运行预训练的 BLIP-2 模型。如果你想跑跑本文中的示例,请确保使用大显存 GPU。

我们从安装 Transformers 开始。由于此模型是最近才添加到 Transformers 中的,因此我们需要从源代码安装 Transformers:

pip install git+https://github.com/huggingface/transformers.git

接下来,我们需要一个输入图像。《纽约客》每周都会面向其读者举办一场 卡通字幕比赛。我们从中取一张卡通图像输入给 BLIP-2 用于测试。

卡通字母比赛链接:
https://www.newyorker.com/cartoons/contest#thisweek

import requests
from PIL import Image

url = 'https://media.newyorker.com/cartoons/63dc6847be24a6a76d90eb99/master/w_1160,c_limit/230213_a26611_838.jpg'
image = Image.open (requests.get (url, stream=True).raw).convert ('RGB')  
display (image.resize ((596, 437)))
f29e44b0d25985f90ab3642f4fdeb81f.jpeg
New Yorker Cartoon

现在我们有一张输入图像了,还需要一个预训练过的 BLIP-2 模型和相应的预处理器来处理输入。你 可以在 Hugging Face Hub 上找到所有可用的预训练 checkpoints 列表。这里,我们将加载一个使用 Meta AI 的预训练 OPT 模型的 BLIP-2 checkpoint,该 OPT 模型具有 27 亿个参数。

from transformers import AutoProcessor, Blip2ForConditionalGeneration
import torch

processor = AutoProcessor.from_pretrained ("Salesforce/blip2-opt-2.7b")
model = Blip2ForConditionalGeneration.from_pretrained ("Salesforce/blip2-opt-2.7b", torch_dtype=torch.float16)

请注意,你暂时还无法使用 Auto API (例如 AutoModelForXXX) 来加载 BLIP-2 模型,这种情况在 Hugging Face 中比较少见。你需要显式使用 Blip2ForConditionalGeneration 来加载 BLIP-2 模型。虽然自动获取模型还不能做到,但是你可以使用 AutoProcessor 来获取匹配的处理器类,在本例中为 Blip2Processor。

我们可以使用 GPU 来加快文本生成速度:

device = "cuda" if torch.cuda.is_available () else "cpu"
model.to (device)

图像字幕生成

我们先看看 BLIP-2 是否可以零样本地为《纽约客》卡通图像生成字幕。要为图像添加字幕,我们不必向模型提供任何文本提示,仅提供预处理过的输入图像。没有任何文字提示,模型将从 BOS (beginning-of-sequence) 开始生成图像字幕。

inputs = processor (image, return_tensors="pt")

generated_ids = model.generate (**inputs, max_new_tokens=20)
generated_text = processor.batch_decode (generated_ids, skip_special_tokens=True)[0].strip ()
print (generated_text)
"two cartoon monsters sitting around a campfire"

对于未使用《纽约客》风格的卡通图像训练过的模型,这是一个令人印象深刻的准确描述!

有提示图片字幕生成

我们还可以通过提供文本提示来扩展图像字幕生成,模型将在给定图像的情况下接着提示词往下补充。

prompt = "this is a cartoon of"

inputs = processor (image, text=prompt, return_tensors="pt").to (device, torch.float16)

generated_ids = model.generate (**inputs, max_new_tokens=20)
generated_text = processor.batch_decode (generated_ids, skip_special_tokens=True)[0].strip ()
print (generated_text)
"two monsters sitting around a campfire"
prompt = "they look like they are"

inputs = processor (image, text=prompt, return_tensors="pt").to (device, torch.float16)

generated_ids = model.generate (**inputs, max_new_tokens=20)
generated_text = processor.batch_decode (generated_ids, skip_special_tokens=True)[0].strip ()
print (generated_text)
"having a good time"

视觉问答

用于视觉问答时,提示必须遵循特定格式: "Question: {} Answer:"

prompt = "Question: What is a dinosaur holding? Answer:"

inputs = processor (image, text=prompt, return_tensors="pt").to (device, torch.float16)

generated_ids = model.generate (**inputs, max_new_tokens=10)
generated_text = processor.batch_decode (generated_ids, skip_special_tokens=True)[0].strip ()
print (generated_text)
"A torch"

基于聊天的提示

最后,我们可以通过拼接对话中每轮的问题和回答来创建类似 ChatGPT 的体验。我们用某个提示 (比如 “恐龙拿着什么?”) 来问模型,模型会为它生成一个答案 (如 “火炬”),我们可以把这一问一答拼接到对话中。然后我们再来一轮,这样就把上下文 (context) 建立起来了。但是,需要确保的是,上下文不能超过 512 个标记,因为这是 BLIP-2 使用的语言模型 (OPT 和 T5) 的上下文长度。

context = [
   ("What is a dinosaur holding?", "a torch"),
   ("Where are they?", "In the woods.")
]
question = "What for?"
template = "Question: {} Answer: {}."

prompt = "".join ([template.format (context [i][0], context [i][1]) for i in range (len (context))]) +" Question: "+ question +" Answer:"

print (prompt)
Question: What is a dinosaur holding? Answer: a torch. Question: Where are they? Answer: In the woods.. Question: What for? Answer:
inputs = processor (image, text=prompt, return_tensors="pt").to (device, torch.float16)

generated_ids = model.generate (**inputs, max_new_tokens=10)
generated_text = processor.batch_decode (generated_ids, skip_special_tokens=True)[0].strip ()
print (generated_text)
To light a fire.

结论

BLIP-2 是一种零样本视觉语言模型,可用于各种含图像和文本提示的图像到文本任务。这是一种效果好且效率高的方法,可应用于多种场景下的图像理解,特别是当训练样本稀缺时。

该模型通过在预训练模型之间添加 transformer 来弥合视觉和自然语言模态之间的隔阂。这一新的预训练范式使它能够充分享受两种模态的各自的进展的红利。

如果您想了解如何针对各种视觉语言任务微调 BLIP-2 模型,请查看 Salesforce 提供的 LAVIS 库,它为模型训练提供全面支持。

Salesforce 提供的 LAVIS 代码仓库:
https://github.com/salesforce/LAVIS

要查看 BLIP-2 的运行情况,可以在 Hugging Face Spaces 上试用其演示。

Hugging Face Spaces 中的 Salesforce BLIP-2:
https://hf.co/spaces/Salesforce/BLIP2

致谢

非常感谢 Salesforce 研究团队在 BLIP-2 上的工作,感谢 Niels Rogge 将 BLIP-2 添加到 🤗 Transformers,感谢 Omar Sanseviero 审阅这篇文章。


英文原文: https://hf.co/blog/blip-2

作者: Maria Khalusova、JunnanLi

译者: Matrix Yao (姚伟峰),英特尔深度学习工程师,工作方向为 transformer-family 模型在各模态数据上的应用及大规模模型的训练推理。

审校、排版: zhongdongy (阿东)

相关推荐

Transformer 中的专家混合模型 (MoE)

每个设备只加载分配给自己的那部分专家,负责对应的计算,并在最后参与结果的汇总。在专家混合 (MoE) 模型中,每个 token 会被路由到不同的专家。时,模型会从标准的张量并行 (Tensor Parallel, TP) 策略切换为专家并行 (Expert Parallel, EP) 策略,并采用专门的切分 (sharding) 方式。将全局专家索引映射为本地索引,屏蔽不属于当前设备的专家,确保每个设备只使用本地专家进行计算,并通过 all-reduce 在设备之间汇总部分计算结果。欢迎告诉我们你希望在。

Hugging Face 684

在 Hugging Face Hub 上引入 Storage Buckets

在未来的规划中,我们将支持 Buckets 与仓库之间的双向直接传输:例如将最终的 checkpoint 权重提升到模型仓库,或者在数据流水线完成后,把处理好的数据分片提交到数据集仓库。如果你来自 S3 风格的对象存储环境,Buckets 也提供了熟悉的使用模式,同时更适配 AI 产物,并能无缝过渡到 Hub 上的最终发布流程。对于一次性操作,可以使用。提供了原生的存放位置,比如 checkpoint、处理后的数据、Agent trace、日志,以及所有在最终定稿之前仍然有价值的中间产物。

Hugging Face 646

LeRobot v0.5.0 正式发布

成为目前规模最大的一次发布 —— 几乎在所有方向上都实现了扩展:支持更多机器人 (包括首个类人机器人) 、更多策略模型 (包括回归的自回归 VLA) 、更快的数据集处理、可以直接从 Hub 加载的仿真环境,以及基于。:我们将 SO-100 和 SO-101 的实现整合到一个更简洁的代码库中 (包括双臂配置) ,减少重复代码,更易维护,同时保持原有功能。从更严格的类型检查到更健壮的测试基础设施,我们正在持续加强 LeRobot 的基础架构,以支持未来更大规模的发展。这大大降低了分享自定义仿真环境的门槛。

Hugging Face 823

全球开源 AI 生态的未来:从 DeepSeek 到 AI+

资源约束并未限制中国 AI 的发展,相反,在某些方面,它们重塑了其发展轨迹。截至 2025 年中,Qwen 成为 Hugging Face 上衍生模型数量最多的基础模型,已有超过 11.3 万个模型以 Qwen 为基座构建,超过 20 万个模型仓库标注了 Qwen,远高于 Meta 的 Llama(2.7 万)或 DeepSeek(6 千)。通过在更开放的系统中打通模型、芯片与 PaddlePaddle,百度得以在算力、成本和监管等共同约束下,降低成本、吸引开发者并影响行业标准,同时保持自身的战略控制力。

Hugging Face 659

DeepSeek之后:中国开源人工智能生态的架构选择

与此同时,训练侧的信号也开始显现。相比之下,定制化和约束性更强的许可证因为不被熟知、理解成本高,增加了新的法律风险,在实际使用中显著增加了摩擦成本,从而降低了采用意愿,这也直接导致了图中所显示的整体下滑。在统一的能力框架下,根据任务的复杂度与价值,动态激活不同数量的专家,从而在不同请求与部署环境中分配计算资源。例如,在 DeepSeek-V3.2-Exp 发布时,华为昇腾与寒武纪芯片实现了“首日支持”,并非云端演示,而是与模型权重一同发布的可复现推理流水线,使开发者能够直接验证真实世界中的性能表现。

Hugging Face 1002

<span class=“js_title_inner“>DeepSeek之后:中国开源人工智能生态的架构选择</span>

与此同时,训练侧的信号也开始显现。相比之下,定制化和约束性更强的许可证因为不被熟知、理解成本高,增加了新的法律风险,在实际使用中显著增加了摩擦成本,从而降低了采用意愿,这也直接导致了图中所显示的整体下滑。在统一的能力框架下,根据任务的复杂度与价值,动态激活不同数量的专家,从而在不同请求与部署环境中分配计算资源。例如,在 DeepSeek-V3.2-Exp 发布时,华为昇腾与寒武纪芯片实现了“首日支持”,并非云端演示,而是与模型权重一同发布的可复现推理流水线,使开发者能够直接验证真实世界中的性能表现。

Hugging Face 935

推出 AnyLanguageModel:在 Apple 平台统一本地与远程大语言模型的 API

对于 Xcode 项目 (目前还不支持直接声明 trait) , 你可以创建一个内部的 Swift 包,指定所需 trait 依赖 AnyLanguageModel, 然后将这个包作为本地依赖添加到你的项目中。我们在这里做了有意识的取舍, 也许我们现在的设计将来会和 Apple 官方的实现产生冲突, 但这正是废弃警告 (deprecation warnings) 存在的意义。这个项目是一个起点: 你可以 fork 它、扩展它、替换不同的模型, 了解各个模块如何协作,并根据自己的需求进行定制。

Hugging Face 647

使用 Hugging Face 轻松构建并共享 ROCm 内核

自定义内核是高性能深度学习的基础,它让 GPU 操作能完全贴合你的工作负载需求——无论是图像处理、张量变换,还是其他计算密集型任务。然而,要为正确的架构编译这些内核、配置各种编译标志并干净地整合到 PyTorch 扩展中,往往会变成一团乱麻 (CMake/Nix、编译错误、ABI 问题等)。这保证了你的内核既高效、又可移植,还能无缝集成到 PyTorch 中。一旦构建完成,只需上传到 Hugging Face Hub,社区中的其他人就能直接使用你的自定义内核——几行代码即可完成集成,轻松共享高性能成果。

Hugging Face 1360

“DeepSeek 时刻” 一周年

DeepSeek 的 R1 模型降低了获取先进模型能力的门槛,并提供了一种清晰、可供效仿的发展范式,从而解锁了新的发展层级。来自美国机构的重要发布。表面上看似合作的行为,更准确地说,是在共同的技术、经济与监管压力下形成的对齐。这是中国的开源模型首次进入全球主流榜单,并且在随后的一年中,每当有新模型发布时,它都反复被用作重要的参考基准。与 2024 年相比,R1 发布之后,中国的人工智能格局逐步形成了一种新的态势:大型科技公司率先行动,初创公司迅速跟进,来自垂直行业的公司也越来越多地进入这一领域。

Hugging Face 875

Transformers v5 中的分词系统:更简洁、更清晰、更模块化

最糟糕的是,你无法创建一个空的分词器架构。如果你想用自己的数据训练一个 LLaMA 风格的分词器,没有简单的方法可以初始化一个“空白”的 LLaMA 分词器并填入自定义的词表和合并规则。最终得到的分词器将拥有你自定义的词表和合并规则,但在处理文本时的行为将与标准的 LLaMA 分词器完全一致:空格处理、特殊 token 规则、解码行为都相同。这些模型专属的分词器类会根据各自模型的需求,对后端进行配置,包括正确的词表、合并规则、特殊 token,以及标准化设置等,确保分词行为与模型训练时保持一致。

Hugging Face 810

<span class=“js_title_inner“>Transformers v5 中的分词系统:更简洁、更清晰、更模块化</span>

最糟糕的是,你无法创建一个空的分词器架构。如果你想用自己的数据训练一个 LLaMA 风格的分词器,没有简单的方法可以初始化一个“空白”的 LLaMA 分词器并填入自定义的词表和合并规则。最终得到的分词器将拥有你自定义的词表和合并规则,但在处理文本时的行为将与标准的 LLaMA 分词器完全一致:空格处理、特殊 token 规则、解码行为都相同。这些模型专属的分词器类会根据各自模型的需求,对后端进行配置,包括正确的词表、合并规则、特殊 token,以及标准化设置等,确保分词行为与模型训练时保持一致。

Hugging Face 915

构建开放的未来——我们与 Google Cloud 的全新合作伙伴关系

我们非常期待通过与 Google Cloud 的深入合作,让这一愿景加速实现——无论你使用的是 Vertex AI Model Garden、Google Kubernetes Engine、Cloud Run,还是 Hugging Face Inference Endpoints。通过这个 CDN Gateway,Hugging Face 的模型和数据集将直接缓存在 Google Cloud 上,大幅减少下载时间,并提升 Google Cloud 用户在模型供应链方面的稳定性和可靠性。

Hugging Face 661

使用 NVIDIA Isaac 构建医疗机器人:从仿真到部署

该流程通过约 70 个仿真演示和 10–20 个真实演示相结合,在模拟多样场景的同时,也保留真实数据的可靠性。NVIDIA Isaac for Healthcare 是一个专为 AI 医疗机器人开发者打造的框架,提供从数据采集到训练、评估再到部署的全流程工具链,适用于仿真环境与真实硬件。仿真一直是医学影像中弥补数据缺口的重要手段,但在医疗机器人领域,它过去往往速度太慢、系统割裂,或难以迁移到现实应用中。值得一提的是,超过 93% 的策略训练数据来自仿真环境,充分说明仿真技术在缩小机器人数据鸿沟方面的优势。

Hugging Face 1687

Codex 正在推动开源 AI 模型的训练与发布

你可以训练 0.5B 到 7B 参数规模的模型,将它们转换为 GGUF 格式便于本地运行,还可以通过多阶段流程结合不同方法。Trackio 会通过自动运行评估任务,帮助你监控训练和评估的得分,并选择表现最好的模型检查点 (checkpoint)。这里的重点不是“Codex 自己开源模型”,而是让 Codex 作为编码代理,参与并自动化开源模型的训练、评估与发布全流程。我们已经展示了 Codex 如何处理模型微调的完整生命周期,验证数据、选择硬件、生成训练脚本、提交任务、监控进度,以及转换输出。

Hugging Face 884

经同意的语音克隆

每次生成时,系统会随机选择一个日常话题 (如天气、美食或音乐) ,使句子内容丰富多样,也更自然好读,有助于录音清晰、自然,并具备良好的语音质量,同时包含明确的同意声明。换句话说,模型不会擅自“说出”你的声音,除非你亲口同意。也就是说,“同意”成为系统运行的前提条件,让原本抽象的伦理原则变成了具体可操作的系统规则,并形成可追溯、可审核的交互记录:AI 模型只会在明确同意之后才运行。现在很多语音克隆模型只需要一句话就能模仿说话人的声音,因此这句用于表达“同意”的句子,也可以同时作为语音克隆的输入数据。

Hugging Face 1164

流式数据集:效率提升 100 倍!

比如,在 Hugging Face 上传大型数据集时,Xet 的去重机制大幅减少了数据传输量,上传更快;流式加载一直是快速了解数据集的好方法,但在训练模型时,大多数人仍然选择将数据预先下载到本地,或使用 S3 等云存储——我们在训练。包,支持 Spark 直接读写 HF 数据集,内置对 Parquet CDC 和 Xet 的支持,大幅加快大数据处理。在机器学习中,特别是在处理 TB 级别的数据时,数据加载一直是个大难题。库还不支持,或者你希望获得更高的控制权,我们也提供了强大的自定义流式能力。

Hugging Face 979

huggingface_hub 1.0 正式版现已发布:开源机器学习基础五周年回顾

在 Hugging Face Hub 的早期阶段,研究人员和开发者常常面临一个困扰: 训练一个先进的模型不仅耗时、耗资源,而且在训练完成后,模型往往“被困”在个人电脑里,只能通过不稳定的 Google Drive 链接进行分享。不再依赖单一的推理后端,而是与多家无服务器推理平台合作,包括 Together AI、SambaNova、Replicate、Cerebras、Groq 等,用户通过一个统一的 API 即可调用多个后端,路由透明,按请求计费,真正实现了“按需调用,轻松推理”。

Hugging Face 1618

Hugging Face 论文页面功能指南

认领成功后,系统会将你标记为论文的提交者,即可向 Daily Papers 提交论文。在每篇论文的页面右侧,你都能找到相关资源链接,例如模型、数据集、Spaces 以及其他有用的集合。作者只需在相关资源(如模型或数据集)的 README.md 中添加该论文的 arXiv 链接,即可将资源与论文自动关联。论文提交不限于你自己的工作,你也可以分享任何你认为对社区有价值的研究论文。如果你的论文尚未在 Hugging Face 论文页面建立索引,只需点击 index 按钮,即可一步添加。如果你是首次分享论文。

Hugging Face 646

LeRobot v0.4.0 正式发布:全面提升开源机器人的学习能力

LeRobot v0.4.0 为开源机器人领域带来重要升级:引入可扩展的 Datasets v3.0、强大的新 VLA (视觉-语言-动作) 模型如 PI0.5 与 GR00T N1.5,以及全新的插件系统,简化硬件集成。从重构的数据集到灵活的编辑工具、新的仿真环境,以及面向硬件的全新插件系统,LeRobot 正在持续演进,以满足前沿具身智能 (Embodied AI) 不断发展的需求。模型需要在正确设备上的规范化、按批次的张量,而你的机器人硬件则需要特定格式的动作命令。更多细节可阅读我们此前的。

Hugging Face 1799

Gaia2 与 ARE:赋能社区的智能体评测

现有的评测环境通常与特定任务紧密耦合,缺乏真实世界的灵活性,也无法反映开放世界中混乱的现实:模拟页面不会加载失败,事件不会自发发生,也不存在异步混乱。在理想情况下,AI 智能体应当是可靠的助手。当接收到任务时,它们能够轻松处理指令中的歧义,构建逐步执行的计划,正确识别所需资源,按计划执行而不被干扰,并在突发事件中灵活适应,同时保持准确性,避免幻觉。当接收到任务时,它们能够轻松处理指令中的歧义,构建逐步执行的计划,正确识别所需资源,按计划执行而不被干扰,并在突发事件中灵活适应,同时保持准确性,避免幻觉。

Hugging Face 1812

ZeroGPU Spaces 加速实践:PyTorch 提前编译全解析

它高效、灵活,非常适合演示,不过需要注意的是,ZeroGPU 并不能在所有场景下完全发挥 GPU 与 CUDA 栈的全部潜能,比如生成图像或视频可能需要相当多的时间。根据模型的不同,这个过程可能需要几十秒到几分钟,对于 Spaces 中的实际 GPU 任务来说,这显然太慢了。通过提前编译,我们可以在一开始导出已编译的模型,将其保存,然后在任意进程中即时加载。否则,如果存在不兼容问题,就会报错。例如,在 Wan 系列视频生成模型中,如果你希望编译后的模型能够生成不同分辨率的内容,就会遇到这种情况。

Hugging Face 961

开源开发者须知:欧盟《人工智能法案》对通用人工智能模型的最新要求

根据 其第 3 条第 63 款 的定义,GPAI 模型是指:“人工智能模型,包括那些通过大规模自监督方式训练、具备显著通用性,并能够胜任多种不同任务的模型,无论其在市场上的投放方式如何,该类模型都能够被集成到各种下游系统或应用中。虽然《网络弹性法案》的措辞可能对《人工智能法案》的解释不具备约束力,但其中的这一表述以及其他相关措辞确实指向一种理解,即在FOSS 许可下提供的软件,并不总是、也并非本质上就应当被视为《网络弹性法案》意义下的“商业活动”,特别是在生产者未对其进行“商业化”的情况下。

Hugging Face 2120

欢迎 GPT OSS —— 来自 OpenAI 的全新开放模型家族!

在 GPT OSS 中,system 消息遵循严格格式,并包含当前日期、模型身份以及推理强度等级等信息,而 “developer” 消息则更为自由,这 (令人困惑地) 使它类似于其他模型的 “system” 消息。Hugging Face 与 Azure 合作,将最受欢迎的开源开放模型 (涵盖文本、视觉、语音与多模态任务) 直接引入 Azure AI Model Catalog,便于客户在托管在线端点中安全部署,借助 Azure 的企业级基础设施、自动扩缩与监控能力。轻松在多张 GPU 上部署。

Hugging Face 2556

Hugging Face 开源机器人 Reachy Mini 开启预定

无论是 AI 开发者、极客或黑客、科研人员、教育工作者、机器人爱好者,还是与孩子一同学习编程的家长,Reachy Mini 都能帮助你在桌面环境中高效完成 AI 应用的开发、最新算法的测试、项目的实际部署以及创新成果的共享。:通过上传、下载和分享机器人行为,实现行为复用与组合创新,随着 Reachy Mini 社区的发展,可能性将呈指数级扩展。:与 Hugging Face 社区超千万用户一起,上传、分享与下载机器人行为,共同扩展智能机器人的边界。:集成摄像头、麦克风与扬声器,支持基于 AI 的视听交互。

Hugging Face 1801

开源人工智能:数字主权的基石

像 OLMO2(一个相对较小的模型,其训练方法和数据完全透明,性能与 OpenAI 的 o1-mini 相当)或 OlympicCoder(一个更小的模型,在复杂编码任务上性能超过最新的 Claude 模型)这样的开源项目,充分体现了协同创新在构建先进人工智能模型中的潜力。这种能力的积累,不仅有助于形成符合本地价值观与监管要求的人工智能系统,更是面向未来的关键竞争力,在人工智能深度塑造经济、治理与社会结构的时代背景下,具有不可替代的长期战略意义。:确保在一国领土内生成的数据受该国法律和治理结构的约束。

Hugging Face 1277

nanoVLM: 简洁、轻量的纯 PyTorch 视觉-语言模型训练代码库

该模块将视觉主干网络产生的图像嵌入作为输入,并将它们转换为与语言模型嵌入层的文本嵌入兼容的嵌入。减少了图像标记的数量,这有助于降低计算成本并加快训练速度,特别是对于对输入长度敏感的基于 transformer 的语言解码器。下图演示了这个概念。在这篇博客中,我们介绍了什么是 VLM,探讨了支撑 nanoVLM 的架构选择,并详细解释了训练和推理工作流程。,可以帮助你构建和训练一个能够理解图像和文本,并基于此生成文本的模型。如果你尝试了它,并在它的基础上尝试构建,或者你只是有问题,我们都很乐意听到你的反馈。

Hugging Face 1473

HF Papers 直播| AI Insight Talk 强化学习专场

研究方向为多模态通用感知模型、多模态大模型后训练算法,在人工智能国际顶级会议及期刊发表论文十余篇,谷歌学术累计引用超过1900次,作为核心作者(共一二作)参与研发的多模态大模型InternVL-Chat系列模型在HuggingFace社区累计下载量突破1000万次,开源代码在Github获得stars超过8000个。已在 NeurIPS,ICLR,ACL 等国际顶级会议上发表多篇论文,谷歌学术引用量 600+,担任 NeurIPS 等顶级会议审稿人。为了更好的社区互动过,我们在本次直播加入了圆桌讨论环节。

Hugging Face 1260

SmolVLA: 让机器人更懂 “看听说做” 的轻量化解决方案

从左到右: (1) 异步的拾取 - 放置立方体计数,(2) 同步的拾取 - 放置立方体计数,(3) 在扰动下的拾取 - 放置立方体计数,(4) 在真实世界 SO101 上的乐高积木拾取 - 放置任务泛化。与学术基准不同,社区数据集自然地捕捉到了杂乱、现实的互动: 多变的光照、不完美的演示、非常规物体和异质的控制方案。在过去的几年里,Transformers 技术推动了人工智能的显著进展,从能够进行类人推理的语言模型到理解图像和文本的多模态系统。然而,在实际的机器人领域,进展则相对较慢。

Hugging Face 2427

参加 Hugging Face 组织的 Gradio & MCP 智能体主题黑客松

一场以智能体 (Agent) 和模型上下文协议 (Model Context Protocol,简称 MCP) 为核心的全球在线黑客松即将来袭!Model Context Protocol (MCP) 是一个开放协议,旨在标准化应用如何向大语言模型 (LLM) 提供上下文信息。:在 6 月 8 日 23:59 (UTC) 之前提交至对应的 Hugging Face Spaces。构建一个完整的 AI 智能体展示应用 (可使用 MCP,也可以不使用) ,让我们看到它真正能做些什么!

Hugging Face 1608

大模型评估排障指南 | 关于可复现性

它们在标准测试集 MATH-Hard 上预测的答案完全正确,但在 few-shot 简单模板测试中评估得分反而较低,很可能就是过拟合了 GSM8K 数据集 (另一个数学测试集) 的 prompt 和答案格式。,如果不看代码,你可能觉得就是上文提到的那样,直接对比预测结果和参考答案,不过: 如果查看代码会发现,在做对比之前预测结果还多做了一步归一化 (去除标点符号、统一数字格式等),这明显会改变对比得分。(没错不用惊讶,不一致时也会影响结果差异,因为不同模型对不同样本的表现是不一样的)。

Hugging Face 1158
上一篇: 深入了解视觉语言模型
下一篇: PEFT: 在低资源硬件上对十亿规模模型进行参数高效微调
Hugging Face
Hugging Face Hugging Face 官方账号 Hugging Face 官方账号
博客等级 码龄4年 1862粉丝 378原创
评论 8
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值