SIGIR’23 文献阅读分享 CSA:强化学习在推荐系统中的应用

强化学习RL应用在youtube推荐系统 2019谷歌论文解读 目录1、Introduction目前主流的个性化推荐技术的问题:强化学习(RL)应用在推荐系统2、Related workRecommender Systems 推荐系统序列模型和RL推荐系统User Choice Behavior 用户选择行为建模RL with Combinatorial Action Spaces3、MDP模型 马尔可夫决策过程4、Slate-Q:候选值的分解5、用Q-val... 阅读详情
标题期刊年份关键词
Contrastive State Augmentations for Reinforcement Learning-Based Recommender SystemsSIGIR2023Recommender system, Reinforcement learning, Contrastive learning, Data augmentation, Sequential recommendation

🌟 研究背景

在数字化时代,推荐系统扮演着信息过滤的关键角色,尤其是在电商、社交网络等平台。基于强化学习(Reinforcement Learning, RL)的推荐系统因其在长期累积收益优化方面的优势而受到关注。然而,现有方法在处理未出现在离线训练数据中的新用户状态时,面临价值函数估计不准确的问题,同时,由于缺乏对比信号,难以从用户的隐式反馈中学习有效的状态表示。

📚 相关工作

2.1 顺序推荐(Sequential Recommendation)

顺序推荐方法主要依赖于马尔可夫链(Markov Chain, MC)和深度学习模型,如循环神经网络(RNN)和注意力机制(Attention Mechanism),以捕捉用户兴趣的动态变化。

2.2 强化学习(Reinforcement Learning, RL)

强化学习在推荐系统中的应用旨在通过与环境的交互来优化长期收益。然而,现有的在线RL方法需要实时探索,这在实际推荐系统中可能成本高昂且风险较大。

2.3 对比学习(Contrastive Learning)

对比学习通过最大化数据本身的正变换之间的互信息,同时提高对负样本的区分能力,从而发现不同视图之间的语义信息。

对比学习(Contrastive Learning)

对比学习是一种机器学习方法,它的核心思想是通过比较数据的不同变体(或视图)来学习数据的表示。这种方法特别关注于如何使得相似的数据点在表示空间中更接近,而让不相似的数据点更远离。通俗来说,就像我们学习新单词时,通过对比这个单词和我们已经知道的相似单词,来更好地理解和记忆它。

通俗解释: 想象一下,你在玩一个游戏,游戏中有很多动物的图片,比如猫和狗。游戏的目标是找出哪些图片是猫,哪些是狗。为了做到这一点,你会观察猫和狗之间的差异,比如猫有尖尖的耳朵和胡须,而狗没有。通过不断比较和对比这些特征,你就能学会区分猫和狗。对比学习也是这样,它通过比较数据点之间的相似性和差异性,帮助机器学习模型更好地理解和识别数据。

强化学习(Reinforcement Learning)

强化学习是一种让机器通过与环境的交互来学习如何做出决策的方法。在强化学习中,一个智能体(Agent)会尝试执行某些动作,并且根据这些动作的结果获得奖励或惩罚。智能体的目标是最大化它所获得的总奖励。这就像我们在日常生活中通过试错来学习一样,做对了事情得到表扬(奖励),做错了事情可能会受到批评(惩罚)。

通俗解释: 想象一下,你是一个小朋友,妈妈给了你一些糖果,告诉你如果吃完晚饭才能吃糖果。这里的“吃完晚饭”是一个动作,而“糖果”就是你得到的奖励。你通过尝试不同的行为(比如饭前吃糖果或者饭后吃糖果),发现只有饭后吃糖果才能得到更多的糖果(奖励)。所以,你学会了每次都要吃完饭后再吃糖果,因为这样可以得到最多的奖励。强化学习就是通过这种方式,让机器学习如何在不同情况下做出最好的决策,以获得最大的好处。

🔍 方法介绍

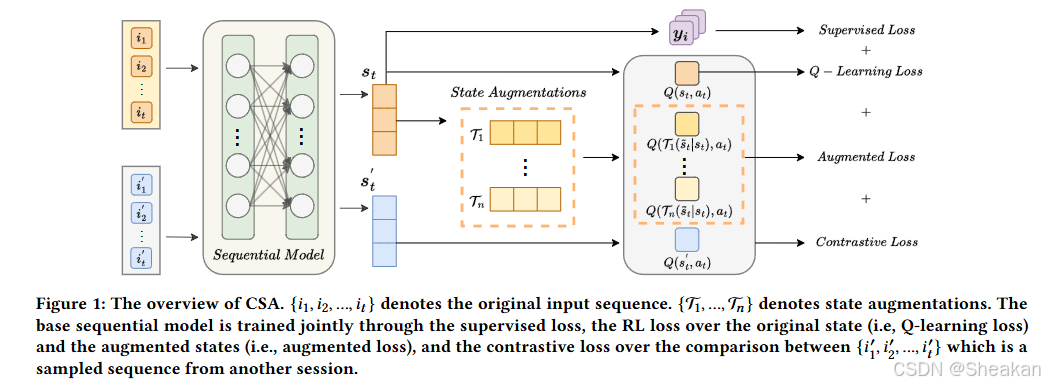
本研究提出了对比状态增强(Contrastive State Augmentations, CSA)框架,以提高基于RL的推荐系统的训练效果。CSA包含两个主要创新点:状态增强策略和对比学习损失。

1. 模型背景和目标

  • 推荐系统:帮助用户在海量信息中找到他们可能感兴趣的项目。
  • 强化学习(RL):通过与环境的交互来学习最优策略,以最大化长期收益。
  • 问题:在推荐系统中应用RL时,模型需要处理用户状态空间大和缺乏负反馈的问题。

2. 对比状态增强(CSA)

CSA模型包含两个关键部分:状态增强策略和对比学习损失。

状态增强策略

状态增强策略旨在扩大模型训练时的状态空间,使模型能够泛化到未见过的状态下。具体策略包括:

  • 高斯噪声:在原始状态上添加零均值的高斯噪声。
  • 均匀噪声:在原始状态上添加均匀分布的噪声。
  • 项目掩码:随机将序列中的某个项目替换为特殊的掩码标记。
  • 维度丢弃:随机将状态中的某个维度置零。

这些策略通过局部扰动来模拟不同的用户状态,帮助模型学习到更加鲁棒的价值函数。

对比学习损失

对比学习损失用于改善状态表示的学习。它通过以下方式工作:

  • 正样本:同一序列状态的不同增强视图被视为正样本。
  • 负样本:从其他序列中随机采样的状态被视为负样本。

对比学习损失函数旨在使得同一状态的不同增强视图在表示空间中更接近(拉近正样本),而不同序列的状态更远离(推开负样本)。

3. 模型输入和输出

  • 输入:用户-项目交互序列。
  • 输出:推荐项目的概率分布。

4. 模型训练

CSA模型的训练包括以下几个步骤:

  1. 状态映射:使用序列推荐模型将输入序列映射到隐藏状态。
  2. 状态增强:对隐藏状态应用上述四种增强策略。
  3. 对比学习:通过最小化对比学习损失来优化状态表示。
  4. RL训练:使用Q-learning算法来学习状态-动作价值函数。

🧠 实验

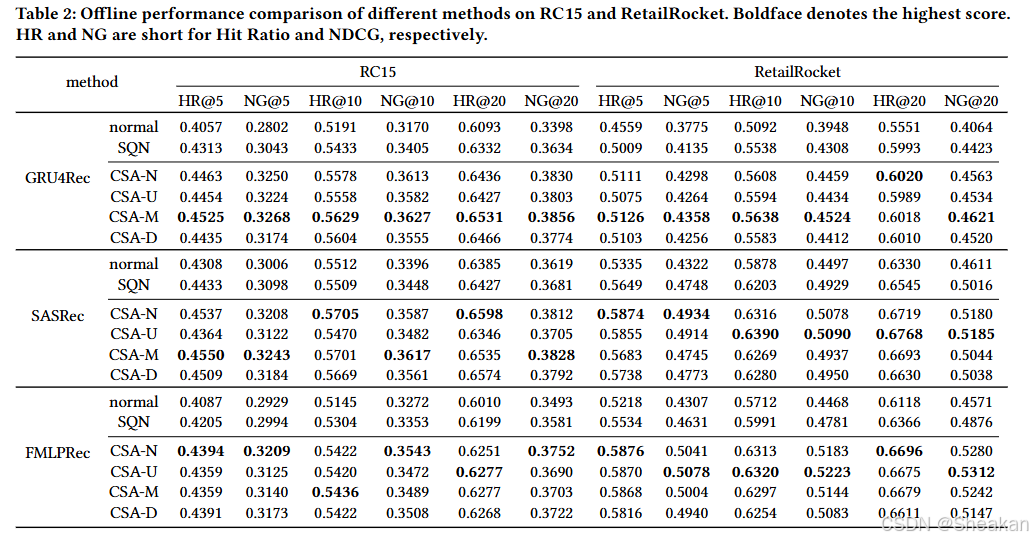
实验在两个公开数据集和一个真实电商平台数据集上进行,验证了CSA在提高推荐性能方面的有效性。结果显示,CSA能够有效提升推荐系统的准确性和鲁棒性。
🏆 创新点

  • 状态增强策略:通过局部扰动扩大状态空间,提高RL代理的泛化能力。
  • 对比学习损失:引入对比信号,改善从隐式反馈中学习的状态表示。
强化学习在推荐系统中的应用 强化学习在推荐系统中的应用 1. 背景介绍 推荐系统是当今互联网应用中不可或缺的一部分,它能够根据用户的兴趣和需求,为用户推荐个性化的内容和产品。强化学习作为一种基于试错学习的机器学习算法,近年来在推荐系统中得到了广泛的应用,显示出了强大的潜力。本文将深入探讨强化学习在推荐系统中的应用,包括核心 阅读详情

相关推荐

强化学习:在直播推荐系统中的应用

1. 背景介绍 1.1 问题由来 随着互联网直播行业的飞速发展,直播推荐系统成为了各大直播平台的核心竞争力。用户如何在海量的直播内容中找到感兴趣的频道和主播,成为了平台优化用户体验的关键问题。传统的推荐算法,如基于协同过滤和基于内容的推荐方法,难以应对直播内容的多样性和实时性。 近年来,强化学

欢迎来到我的优快云空间!这里聚焦AI大模型应用实战,分享前沿技术、实战案例与开发经验。 916

强化学习和推荐系统的结合应用

此外,推荐系统往往利用日志文件进行学习,日志文件纪录的可能是其它版本的用户行为,这个过程对应强化学习中off-policy的设定。本文的创新点之一是考虑到了推荐时商品之间的2D位置关系,Actor输出的action中同时包括了每个商品的2D位置信息。可解释性的推荐系统指的是系统在生成推荐列表的同时,针对每一个推荐商品,生成推荐的理由。具体而言,可解释性的实现是通过先建立用户和商品之间的知识图谱,再将推荐行为建模成路径搜索问题,路径经过的节点即是推荐逻辑链的组成部分。2、通过与用户的自然交互,推荐系统。...

ahahayaa的博客 2170

4G LTE 与 5G 无线网络规划对比:从 BBU/RRU 到 CU/DU/AAU 的架构演进解析

本文深度解析4G LTE与5G无线网络架构的演进差异,从BBU/RRU分立式架构到CU/DU/AAU三级重构,揭示移动通信代际跃迁的技术本质。重点对比了网络规划中的覆盖能力、容量规划、传输网络等九大维度,为通信工程师提供实用的技术对照手册,助力5G网络高效部署。

weixin_32821533的博客 288

推荐系统中的前沿技术之强化学习

来源:本文摘自《这就是推荐系统-核心技术原理与企业应用》作者:胡澜涛等强化学习是机器学习重要的范式和方法论之一,与有监督学习、无监督学习并驾齐驱。区别于其他两种学习方法,强化学习是通过智能体(Agent)与环境的交互进行学习。强化学习是最接近动物学习模式的一种学习范式。在标准的强化学习框架中,智能体作为学习系统,会结合环境当前状态信息,对环境进行行为试探,获取环境对此次行为的评价反馈和新的环境状态...

人工智能学家 660

干货——Joplin私人笔记安装部署

安全、隐私、免费、不限制的私人笔记的选择和搭建

vincentho1024的专栏 7878

Delta-Sigma调制(DSM)技术

前言 数字信号处理和通信系统的性能很大程度上受到了模拟信号到数字信号转换接口——ADC的精度和分辨率的限制。而传统的线性脉冲编码调制(PCM)ADC受到了制造工艺的限制,无法达到很高的分辨率。但基于Delta-Sigma调制技术的ADC可以在现有工艺下实现高分辨率(大于16位),同时由于结构简单,所以易于实现。低成本高性能使得Delta-Sigma调制技术得到了广泛的应用。 Delta-Sigma型ADC的结构原理图如下图所示: 它最大的优势在于仅用1位ADC进行数据转换,同时其模拟电路部分结构简单不需要

阿星的博客 2万+

强化学习在推荐系统中的应用:个性化推荐和用户行为预测

1.背景介绍 推荐系统是现代信息服务中不可或缺的一部分,它通过分析用户行为、内容特征等信息,为用户提供个性化的内容建议。随着数据量的增加和用户需求的多样化,传统的推荐算法已经无法满足现实中的复杂需求。因此,研究者们开始关注强化学习(Reinforcement Learning,RL)在推荐系统中的应用,以解决个性化推荐和用户行为预测等问题。 在这篇文章中,我们将从以下几个方面进行深入探讨: ...

AI天才研究院 3019

基于STM32+4G模块设计的智能灌溉系统

当前智能灌溉系统分为三个部分:温湿度采集部分、灌溉系统部分、OneNet云平台。 灌溉系统部分增加刷卡功能,用户可以通过IC卡刷卡将金额刷到灌溉系统设备里,灌溉系统设备里会记录金额,并且在手机可视化页面上会显示当前的设备金额。 金额会随着时间进行递减,按分钟计费,如果计费到0,就无法启动灌溉,需要重新充值金额才能继续。

4514

基于强化学习的可解释性推荐 文献三篇

A Reinforcement Learning Framework for Explainable Recommendation. IEEE 2018 现在很多推荐模型的机制是复杂且难以解释的,此时需要在对推荐结果进行事后解释,即把推荐模型与解释模型分离开,用单独的模型推荐结果作出解释。本文使用强化学习方法对推荐结果生成解释。在这个可解释框架中,被解释的推荐模型作为环境的一部分,对强化学习方法生成的句子解释进行奖励。框架中有两个智能体与环境交互,第一个智能体根据当前状态生成句子解释,第二个智能体根据第一个

白水的博客 2029

YOLOv11 | 一文带你深入理解ultralytics最新作品yolov11的创新 | 训练、推理、验证、导出 (附网络结构图)

ultralytics发布了最新的作品YOLOv11,这一次YOLOv11的变化相对于ultralytics公司的上一代作品YOLOv8变化还是很大的(YOLOv9、YOLOv10均不是ultralytics公司作品),其中改变的位置涉及到C2f变为C3K2,在SPPF后面加了一层类似于注意力机制的C2PSA,还有一个变化大家从yaml文件是看不出来的就是它的检测头内部替换了两个DWConv,在损失函数方面就没有变化了还是采用的CIoU作为边界框回归损失,下面带大家深入理解一下ultralytics最新作品

Snu77的博客 18万+

YOLO126优化:损失篇 | AAAI 2025 | 一种基于尺度的动态(SD)损失,根据目标大小动态调整尺度和位置损失的影响,提高了网络检测不同尺度目标的能力

提出了一种基于尺度的动态(SD)损失,它根据目标大小动态调整尺度和位置损失的影响,提高了网络检测不同尺度目标的能力。

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 447

强化学习在推荐系统中的应用:基于 RL 的个性化推荐模型落地

通过将推荐过程建模为马尔可夫决策过程,强化学习能有效捕捉用户兴趣的动态演化,实现长期价值最大化。落地需平衡算法复杂度与工程可行性,建议从可控场景逐步迭代。

saffadsa的博客 846

卫朋:IPD流程落地之产品开发验证阶段解读

IPD验证阶段

产品线负责人 1488

《强化学习周刊》第6期:强化学习应用之推荐系统

No.06智源社区强化学习组强化学习研究观点资源活动关于周刊强化学习作为人工智能领域研究热点之一,它在推荐系统领域中的应用的研究进展与成果也引发了众多关注。为帮助研究与工程人员了解该领域...

BAAIBeijing的博客 1646

华为OD面试手撕真题 - 最大数

华为OD面试手撕真题 最大的数 提供Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解

qq_45776114的博客 341

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

第七章 人工智能,7.1 基于深度强化学习与自适应在线学习的搜索和推荐算法研究(作者:灵培、霹雳、哲予)...

7.1 基于深度强化学习与自适应在线学习的搜索和推荐算法研究 1.搜索算法研究与实践 1.1背景 淘宝的搜索引擎涉及对上亿商品的毫秒级处理响应,而淘宝的用户不仅数量巨大,其行为特点以及对商品的偏好也具有丰富性和多样性。因此,要让搜索引擎对不同特点的用户作出针对性的排序,并以此带动搜索引导的成交提升,是一个极具挑战性的问题。传统的Learning to Rank(LTR)方法主要...

aa8102980的博客 2525

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

强化学习用于推荐系统问题(《强化学习在阿里...)

读书笔记–《强化学习在阿里的技术演进与业务创新》 强化学习和其他学习⽅法不同之处在于强化学习是智能系统从环境到⾏为映射的学习,以使奖励信号函数值最⼤。如果智能体(agent)的某个⾏为策略(action)导致环境正的奖赏(reward),那么智能体以后产⽣这个⾏为策略的趋势便会加强。强化学习是最接近于⾃然界动物学习的本质的⼀种学习范式。 主要瓶颈:对于规模⼤⼀点的问题就会出现维数爆炸,难于计算。 ...

nakaizura 9592

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

一种强化学习在新闻推荐领域的应用

今天写的博客主要参考了2018年WWW会议上的论文《DRN: A Deep Reinforcement Learning Framework for News Recommendation》,主要讲解了在新闻推荐领域如何使用深度强化学习的方法。从整个发展趋势来看,强化学习最近无论是在学术界还是工业界都越来越火了,而由于强化学习框架中包含的实体概念比较多(Agent,State,Action,Rew...

guoyuhaoaaa的博客 2216

深度学习在推荐系统上的应用

转载于携程技术团队 近些年,深度学习在语音识别、图像处理、自然语言处理等领域都取得了很大的突破与成就。相对来说,深度学习在推荐系统领域的研究与应用还处于早期阶段。   携程在深度学习与推荐系统结合的领域也进行了相关的研究与应用,并在国际人工智能顶级会议AAAI 2017上发表了相应的研究成果《A Hybrid Collaborative Filtering Model with Deep St...

weixin_30660027的博客 579

强化学习与推荐系统

强化学习简介 强化学习(Reinforcement Learning): 机器学习的一个分支:监督学习、无监督学习、强化学习 强化学习的思路和人比较类似,是在实践中学习 比如学习走路,如果摔倒了,那么我们大脑后面会给一个负面的奖励值 => 这个走路姿势不好;如果后面正常走了一步,那么大脑会给一个正面的奖励值 => 这是一个好的走路姿势 与监督学习的区别,没有监督学习已经准备好的训练数...

super_chiry的博客 4594

推荐系统——强化学习

DRN: A Deep Reinforcement Learning Framework for News Recommendation 1.新闻推荐面临三大挑战: a.新闻更新速度快 b.用户兴趣根据时间变化速度快 c.寻找相似的物品,可能会降低用户的兴趣 ...

m0_37757740的博客 2727

《推荐系统学习》之推荐系统那点事

转载自:http://www.admin10000.com/document/4995.html 推荐系统的误区   回想起来,我也算是国内接触推荐系统较早的人之一了,最近和人聊天,觉得不少人对推荐系统有所误解,以为需要多么高大上的算法才能搭建起来的,我只想说我经常说的那句话【不是这样的】,所以有了这篇文章。   第一次接触【推荐系统】是在两年前在某高校的互联网信息处理实验室的时候,那时...

Thinkgamer博客 6146

推荐系统遇上深度学习(十五)--强化学习介绍

笔者是一个痴迷于挖掘数据中的价值的学习人,希望在平日的工作学习中,挖掘数据的价值,找寻数据的秘密,笔者认为,数据的价值不仅仅只体现在企业中,个人也可以体会到数据的魅力,用技术力量探索行为密码,让大数据助跑每一个人,欢迎直筒们关注我的公众号,大家一起讨论数据中的那些有趣的事情。 我的公众号为:livandata 本文是笔者在阅读过程中遇到的比较好的一篇文章,比较全面的介绍了强化学习,先引用过...

livan1234的博客 1979

DRN——强化学习与推荐系统结合

强化学习是近年来机器学习领域非常热门的研究话题,它的研究起源于机器人领域,针对智能体在不断变化的环境 中决策和学习的过程进行建模。在智能体的学习过程中,会完成收集外部反馈,改变自身状态,再根据自身状态对下一步的行动进行决策,在行动之后持续收集反馈的循环,简称“行动-反馈-状态更新”的循环。如果把推荐系统当作一个智能体,把整个推荐系统学习更新的过程当作智能体“行动-反馈-状态更新”的循环,就能理解将强化学习的诸多理念应用于推荐系统领域并不是一件困难的事情。 2018年,由宾夕法尼亚州立大学和微软亚洲研究院的学

星辰的博客 6981
上一篇: WWW文献阅读分享:《Reinforced Negative Sampling over Knowledge Graph for Recommendation》
下一篇: www‘18文献阅读分享 DRN: A Deep Reinforcement Learning Framework for News Recommendation
Sheakan
博客等级 码龄7年 472粉丝 50原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值