GreatSQL 构建高效 HTAP 服务架构指南(主从复制)

GreatSQL vs MySQL性能测试来了,速围观~ 无论ibp(innodb_buffer_pool_size)是否充足,MySQL的性能都远不如GreatSQL。MySQL的性能平均约为GreatSQL的70%(最高84.5%,最低61.7%)。在ibp充分的情况下,随着并发数的增加,MySQL并没有表现出该有的性能提升,反倒掉头向下,可见还是不够稳定。在ibp不够的情况下,GreatSQL开启thread pool性能有所提升;当ibp充足的情况下,区别就不大了。MySQL vs GreatSQL性能数据对比各数据库版本分别为。 阅读详情

GreatSQL 构建高效 HTAP 服务架构指南(主从复制)

引言

全文约定:$为命令提示符、greatsql>为 GreatSQL 数据库提示符。在后续阅读中,依据此约定进行理解与操作

Rapid 引擎

从 GreatSQL 8.0.32-25 版本开始,新增Rapid存储引擎,该引擎使得 GreatSQL 能满足联机分析(OLAP)查询请求。

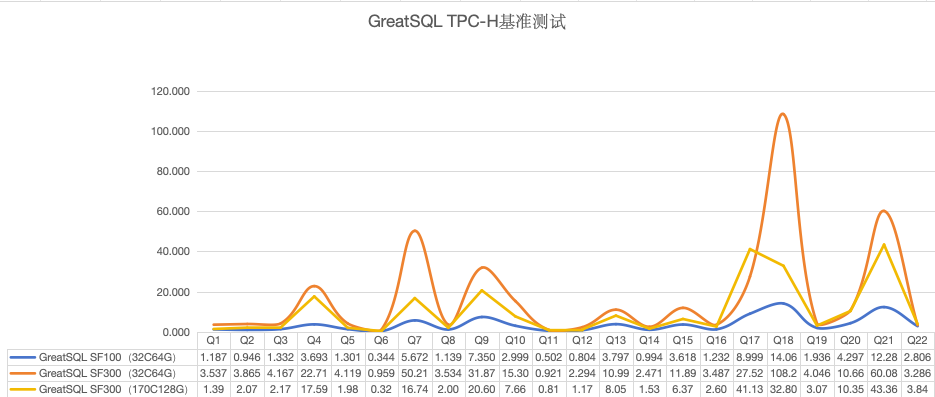
GreatSQL Rapid引擎性能表现优异,在32C64G测试机环境下,TPC-H 100G测试中22条SQL总耗时仅需不到80秒
file

Rapid 引擎更多介绍可前往查看:

有了 Rapid 引擎的加持,便可使用 GreatSQL 构建一个高效的 HTAP 服务架构,以此来提升 GreatSQL 的查询效率。

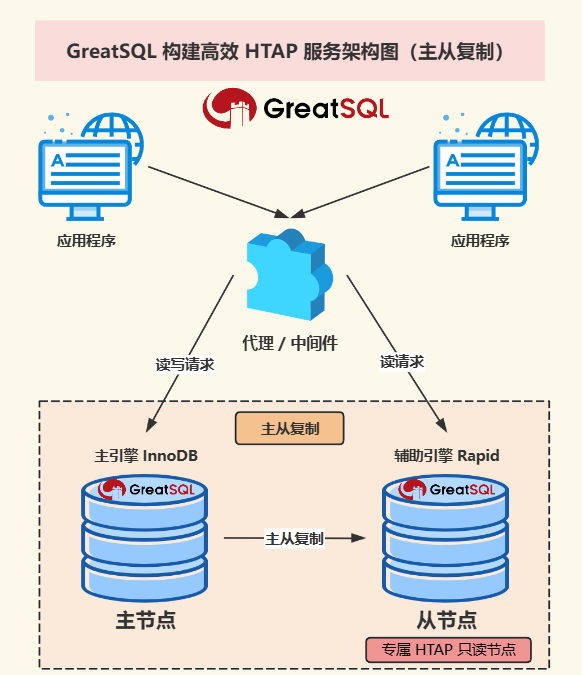
服务架构图
file

本服务架构采用的是 GreatSQL 主从复制,主节点采用默认 InnoDB 引擎,从节点使用辅助引擎 Rapid 加速查询构建专属 HTAP 只读节点。加上 MySQL Router 等之类的代理/中间件负责读写分离来完成 HTAP 服务架构。

采用此 HTAP 架构可获得以下收益

  • 高查询效率:
    • Rapid 引擎的引入使得从节点能够加速查询处理,特别适用于 OLAP(联机分析处理)场景。
  • 高负载均衡:
    • 利用代理/中间件实现读写分离,确保主节点(写操作)和从节点(读操作)负载均衡。
  • 高并发性能:
    • 主节点上采用 InnoDB 响应高并发事务请求,确保业务需求写入性能。
  • 高灵活和扩展:
    • GreatSQL 的可插拔存储引擎架构使得系统可以根据需要选择适合的存储引擎。Rapid 引擎作为辅助引擎,可以动态安装或卸载,为用户提供了极大的灵活性和可扩展性。

部署主从复制

环境准备及版本介绍

服务器配置

$ uname -a
Linux gip 3.10.0-957.el7.x86_64 #1 SMP Thu Nov 8 23:39:32 UTC 2018 x86_64 x86_64 x86_64 GNU/Linux
$ cat /etc/centos-release
CentOS Linux release 7.6.1810 (Core) 

主从库与中间件配置

IP角色版本备注
192.168.6.215:3306GreatSQL 主库GreatSQL 8.0.32-25
192.168.6.214:3306GreatSQL 从库GreatSQL 8.0.32-25专属 HTAP 只读节点
192.168.6.215:3306MySQL Router8.4.0 TLS代理/中间件。可根据需求灵活替换

安装 GreatSQL

GreatSQL 安装版本为 8.0.32-25 版本,并分别安装两个实例 GreatSQL

安装步骤详见:https://greatsql.cn/docs/8.0.32-25/4-install-guide/0-install-guide.html

部署主从复制

主节点建立账户并授权

# 建立复制账户
greatsql> ALTER USER 'slave'@'%' IDENTIFIED WITH mysql_native_password BY 'GreatSQL@2024';
Query OK, 0 rows affected (0.01 sec)
# 授权
greatsql> GRANT REPLICATION SLAVE ON *.* TO 'slave'@'%';
greatsql> FLUSH PRIVILEGES;

然后查看主节点状态,记录二进制文件名 binlog.000002 和位置 2027

greatsql> SHOW MASTER STATUS\G
*************************** 1. row ***************************
             File: binlog.000002
         Position: 2027
     Binlog_Do_DB: 
 Binlog_Ignore_DB: 
Executed_Gtid_Set: e766387a-2d3f-11ef-8435-00163e8e122e:1-8
1 row in set (0.00 sec)

从节点服务器配置,并开启从服务器复制

greatsql> CHANGE MASTER TO master_host='192.168.6.215',master_port=3306,master_user='slave',master_password='GreatSQL@2024',master_log_file='binlog.000002',master_log_pos=2027;
greatsql> START REPLICA

检查主从复制情况

greatsql> SHOW REPLICA STATUS\G
*************************** 1. row ***************************
             Replica_IO_State: Waiting for source to send event
                  Source_Host: 192.168.6.215
                  Source_User: slave
                  Source_Port: 3306
                Connect_Retry: 60
              Source_Log_File: binlog.000002
          Read_Source_Log_Pos: 2027
               Relay_Log_File: gip-relay-bin.000002
                Relay_Log_Pos: 323
        Relay_Source_Log_File: binlog.000002
           Replica_IO_Running: Yes  # 为 Yes 即表示构建成功
          Replica_SQL_Running: Yes  # 为 Yes 即表示构建成功

生成测试数据

主库写入数据

往主库生成数据

-- 创建测试数据库  
CREATE DATABASE IF NOT EXISTS htap_test_db;  
USE htap_test_db;  

-- 创建接近生产环境的表  
CREATE TABLE `orders` (
  `order_id` int NOT NULL AUTO_INCREMENT,
  `customer_id` int NOT NULL,
  `product_id` int NOT NULL,
  `order_date` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP,
  `order_status` char(10) NOT NULL DEFAULT 'pending',
  `quantity` int NOT NULL,
  `order_amount` decimal(10,2) NOT NULL,
  `shipping_address` varchar(255) NOT NULL,
  `billing_address` varchar(255) NOT NULL,
  `order_notes` varchar(255) DEFAULT NULL,
  PRIMARY KEY (`order_id`),
  KEY `idx_customer_id` (`customer_id`),
  KEY `idx_product_id` (`product_id`),
  KEY `idx_order_date` (`order_date`),
  KEY `idx_order_status` (`order_status`)
) ENGINE=InnoDB AUTO_INCREMENT=100001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci

往该表插入十万行数据

# 主库
greatsql> SELECT COUNT(*) FROM htap_test_db.orders;
+----------+
| COUNT(*) |
+----------+
|   100000 |
+----------+
1 row in set (0.01 sec)

从库此时也会复制主库的十万行数据

# 从库
greatsql> SELECT COUNT(*) FROM htap_test_db.orders;
+----------+
| COUNT(*) |
+----------+
|   100000 |
+----------+
1 row in set (0.01 sec)

如果在主库或从库进行一个复杂 SQL 查询,需要用时 4~5 秒左右

SELECT
    order_id,customer_id,product_id,order_date,order_status,
    quantity,order_amount,shipping_address,billing_address,
    order_notes,
    SUM( order_amount ) OVER ( PARTITION BY customer_id ) AS total_spent_by_customer,
    COUNT( order_id ) OVER ( PARTITION BY customer_id ) AS total_orders_by_customer,
    AVG( order_amount ) OVER ( PARTITION BY customer_id ) AS average_order_amount_per_customer 
FROM
    orders 
WHERE
    order_status IN ( 'completed', 'shipped', 'cancelled' ) 
    AND quantity > 1 
ORDER BY
    order_date DESC,
    order_amount DESC 
    LIMIT 100;

在从库运行三次结果平均值为 4.91 秒

# 第一次
100 rows in set (4.99 sec)
# 第二次
100 rows in set (4.59 sec)
# 第三次
100 rows in set (5.15 sec)

构建专属 HTAP 只读节点

以下所有操作都在 GreatSQL 从库中进行

使用 Rapid 引擎

进入 GreatSQL 从库,加载 Rapid 引擎

greatsql> INSTALL PLUGIN Rapid SONAME 'ha_rapid.so';

为 orders 表加上 Rapid 辅助引擎

greatsql> ALTER TABLE htap_test_db.orders SECONDARY_ENGINE = rapid;

将表中数据一次性全量导入到 Rapid 引擎中

greatsql> ALTER TABLE htap_test_db.orders SECONDARY_LOAD;
Query OK, 0 rows affected (1.72 sec)

检查导入情况,注意关键词 SECONDARY_ENGINE="rapid" SECONDARY_LOAD="1"

greatsql> SHOW TABLE STATUS like 'orders'\G
*************************** 1. row ***************************
           Name: orders
         Engine: InnoDB
        Version: 10
     Row_format: Dynamic
           Rows: 99381
 Avg_row_length: 142
    Data_length: 14172160
Max_data_length: 0
   Index_length: 9502720
      Data_free: 3145728
 Auto_increment: 100001
    Create_time: 2024-06-19 11:11:27
    Update_time: NULL
     Check_time: NULL
      Collation: utf8mb4_0900_ai_ci
       Checksum: NULL
 Create_options: SECONDARY_ENGINE="rapid" SECONDARY_LOAD="1"
        Comment: 
1 row in set (0.00 sec)

打开 Rapid 引擎的总控制开关,并把启用阈值调小

greatsql> SET GLOBAL use_secondary_engine = ON;
greatsql> SET GLOBAL secondary_engine_cost_threshold = 0; 

secondary_engine_cost_threshold的值可根据实际情况设置

查看该 SQL 的执行计划,注意关键词 Using secondary engine RAPID 表示使用了 Rapid 引擎

greatsql> EXPLAIN SELECT ... 省略 ... ORDER BY order_date DESC,order_amount DESC LIMIT 100;
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: orders
   partitions: NULL
         type: ALL
possible_keys: NULL
          key: NULL
      key_len: NULL
          ref: NULL
         rows: 99381
     filtered: 33.33
        Extra: Using where; Using filesort; Using secondary engine RAPID
1 row in set, 2 warnings (0.00 sec)

执行三次结果平均值为 0.12 秒,比之前提升近 41 倍!

# 第一次
100 rows in set (0.17 sec)
# 第二次
100 rows in set (0.10 sec)
# 第三次
100 rows in set (0.10 sec)

启动增量导入任务

因为在生产环境中数据是无时不刻在产生,所以需要启用增量导入,才可保证最新数据始终在 Rapid 引擎内

启动增量导入任务

greatsql> SELECT START_SECONDARY_ENGINE_INCREMENT_LOAD_TASK('htap_test_db', 'orders');
+----------------------------------------------------------------------+
| START_SECONDARY_ENGINE_INCREMENT_LOAD_TASK('htap_test_db', 'orders') |
+----------------------------------------------------------------------+
| success                                                              |
+----------------------------------------------------------------------+

查看增量导入任务状态

greatsql> SELECT * FROM information_schema.SECONDARY_ENGINE_INCREMENT_LOAD_TASK\G
*************************** 1. row ***************************
           DB_NAME: htap_test_db
        TABLE_NAME: orders
        START_TIME: 2024-06-19 14:13:53
        START_GTID: e766387a-2d3f-11ef-8435-00163e8e122e:9-100010:100012,
f4248873-2d46-11ef-90f8-00163e832e1f:1-8
COMMITTED_GTID_SET: e766387a-2d3f-11ef-8435-00163e8e122e:9-100010:100012,
f4248873-2d46-11ef-90f8-00163e832e1f:1-8
         READ_GTID: 
  READ_BINLOG_FILE: /data/GreatSQL/binlog.000003
   READ_BINLOG_POS: 1906
             DELAY: 0
            STATUS: RUNNING
          END_TIME: 
              INFO: 

在给主库插入 1 万条数据,确认主从复制和 Rapid 引擎的增量导入没有问题,产生的新数据也可以使用 Rapid 引擎加速查询。

请注意,Rapid 引擎在增量导入数据时可能存在短暂延迟。大量 Insert、Delete 数据,可能无法立即通过 Rapid 引擎查询到这些最新变动的数据。等增量任务导入完成后 Rapid 引擎才能查询到最新变动的数据。

# 从机查看数据是 110000 条和主库一致
greatsql> SELECT COUNT(*) FROM htap_test_db.orders;
+----------+
| COUNT(*) |
+----------+
|   110000 |
+----------+
1 row in set (0.01 sec)

此处启用了 Rapid 引擎所以COUNT(*)速度会很快,若没启用 Rapid 引擎则可能耗时较长

查看执行计划,从 rows 列可以看到,扫描的行数增加了,表示新数据已经增量导入到 Rapid 引擎中

greatsql> EXPLAIN SELECT ... 省略 ... ORDER BY order_date DESC,order_amount DESC LIMIT 100;
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: orders
   partitions: NULL
         type: ALL
possible_keys: NULL
          key: NULL
      key_len: NULL
          ref: NULL
         rows: 109381  # 扫描的行数也增加了
     filtered: 33.33
        Extra: Using where; Using filesort; Using secondary engine RAPID

至此,主从复制和构建 HTAP 专属只读节点完成,接下来是实现读写分离,当然一主一从的情况下是不太需要读写分离中间件的,要中间件的情况是怕 HTAP 专属服务器宕机,这时候主节点就要负责读写了。

实现读写分离

这里使用的是 MySQL Router 中间件实现的读写分离,如果有其它读写分离中间件,例如 MySQL Proxy 等也可以替换。

安装 MySQL Router

下载过程省略,可自行到 MySQL 网站上下载

这里选择的是最新的长期支持版 MySQL Router 8.4.0 版本

解压安装包,并进入 MySQL Router 的 bin 目录

$ tar -xvJf mysql-router-8.4.0-linux-glibc2.17-x86_64.tar.xz 

把 MySQL Router 配置模板拷贝出来放到 /etc/mysqlrouter 目录下,并改名为 mysqlrouter.conf

$ cp /usr/local/mysql-router-8.4.0-linux-glibc2.17-x86_64/share/doc/mysqlrouter/sample_mysqlrouter.conf /etc
$ mv /etc/sample_mysqlrouter.conf /etc/mysqlrouter.conf

修改 MySQL Router 配置文件

$ vim /etc/mysqlrouter.conf
[DEFAULT]
logging_folder = /usr/local/mysql-router-8.4.0-linux-glibc2.17-x86_64/log/mysql-router
plugin_folder = /usr/local/mysql-router-8.4.0-linux-glibc2.17-x86_64/lib/mysqlrouter/
runtime_folder = /var/run
config_folder = /etc/

[logger]
level = debug

# 主节点故障转移配置
[routing:basic_failover]
# 写节点地址
bind_address=192.168.6.215
# 写节点端口
bind_port = 7001
# 模式,读写
mode = read-write
destinations = 192.168.6.215:3306
routing_strategy=first-available
# 从节点负载均衡配置
[routing:balancing]
# 绑定的IP地址
bind_address=192.168.6.215
# 监听的端口
bind_port = 7002
# 连接超时时间
connect_timeout = 3
# 后端服务器地址
destinations = 192.168.6.214:3306,192.168.6.215:3306
# 模式:读还是写
mode = read-only
routing_strategy=first-available
[keepalive]
interval = 60

这里从节点负载均衡配置采用first-available,优先使用 HTAP 服务器。若专属 HTAP 服务器宕机,可自动切换使用主节点查询

启动 MySQL Router

$ mysqlrouter --config /etc/mysqlrouter.conf &

查看监听端口是否启用

$ netstat -ntlp |grep mysqlrouter
tcp6       0      0 ::1:7001                :::*                    LISTEN      14404/./mysqlrouter 
tcp6       0      0 ::1:7002                :::*                    LISTEN      14404/./mysqlrouter 

这里演示的是主从复制模式,所以有读写两个端口。在新版本的 MySQL Router 中,在原先的6446、6447端口上,新增一个6450端口,支持读写分离

测试只读端口是否只连接专属 HTAP 节点

$ for ((i=0;i<=3;i++));do mysql -h192.168.6.215 -uroot -p -P7002 -e"select @@server_id;";done;
+-------------+
| @@server_id |
+-------------+
|           2 |
+-------------+
+-------------+
| @@server_id |
+-------------+
|           2 |
+-------------+
+-------------+
| @@server_id |
+-------------+
|           2 |
+-------------+

自此构建高效 HTAP 服务器架构(主从复制)完成!


Enjoy GreatSQL :)

关于 GreatSQL

GreatSQL是适用于金融级应用的国内自主开源数据库,具备高性能、高可靠、高易用性、高安全等多个核心特性,可以作为MySQL或Percona Server的可选替换,用于线上生产环境,且完全免费并兼容MySQL或Percona Server。

相关链接: GreatSQL社区 Gitee GitHub Bilibili

GreatSQL社区:
image

社区有奖建议反馈: https://greatsql.cn/thread-54-1-1.html

社区博客有奖征稿详情: https://greatsql.cn/thread-100-1-1.html

(对文章有疑问或者有独到见解都可以去社区官网提出或分享哦~)

技术交流群:

微信&QQ群:

QQ群:533341697

微信群:添加GreatSQL社区助手(微信号:wanlidbc )好友,待社区助手拉您进群。

GreatSQL与MySQL性能对比测试,带您一同探索数据库的速度差异 在选择适合自己的数据库时,性能是一个至关重要的考虑因素。本文将介绍GreatSQL和MySQL两个常见的关系型数据库,并通过性能测试来比较它们之间的速度差异。除了查询性能之外,我们还可以比较GreatSQL和MySQL在插入和更新操作方面的性能差异。除了查询性能之外,我们还可以比较GreatSQL和MySQL在插入和更新操作方面的性能差异。然后,我们分别在GreatSQL和MySQL中执行了一个查询,并记录了执行时间。然后,我们分别在GreatSQL和MySQL中执行了一个查询,并记录了执行时间。 阅读详情

相关推荐

GreatSQL安装篇

操作系统:CentOS7 CPU:X86_64架构 数据库:GreatSQL-8.0.32-26-Linux-glibc2.17-x86_64.tar.xz。

BUTCHER 1123

GreatSQL是一个国内自主的开源数据库,可替代mysql

此外,GreatSQL社区还提供了MySQL Shell for GreatSQL,这是一个高级客户端和代码编辑器,支持JavaScript和Python脚本功能,以及与MySQL一起使用的API。它可以用来管理数据库,特别是对MGR的支持,可以方便地进行搭建、管理和配置。GreatSQL的架构可以分为连接层、服务层和存储引擎层。连接层负责与客户端建立连接,服务层是GreatSQL的核心,包括连接器、分析器、优化器、执行器等,而存储引擎层则负责数据的存储和提取。

地球空间 3193

GreatSQL数据库8.0快速安装部署

本文介绍了GreatSQL数据库在Linux系统上的安装配置流程。主要内容包括:1)系统兼容性检查和环境准备;2)关闭SELinux和防火墙;3)安装依赖包;4)创建安装目录并上传安装包;5)解压和安装RPM包;6)配置数据目录权限;7)初始化数据库并获取临时密码;8)修改配置文件;9)启动服务并修改密码;10)创建远程访问用户。最后还说明了如何使用Navicat客户端连接数据库。整个流程详细说明了从安装到配置的完整步骤。

m0_61389590的博客 707

技术干货 | 图文结合带你搞懂GreatSQL体系架构

所有的数据,数据库、表的定义,表的每一行的内容,索引,都是存在 文件系统上,以文件的方式存在的,并完成与存储引擎的交互。服务层是GreatSQL Server的核心,主要包含连接器、分析器、优化器、执行器等,涵盖 GreatSQL 的大多数核心服务功能,以及所有的内置函数(如日期、时间、数学和加密函数等),所有跨存储引擎的功能都在这一层实现,比如存储过程、触发器、视图等。GreatSQL数据库区别于其他数据库的一个特点就是其可插拔的表存储引擎,特别需要注意的是,存储引擎是基于表的,而不是数据库。

GreatDB的博客 437

S32K144之芯片锁死解锁——进入HardFault

S32K144之芯片锁死解锁——进入HardFault 最近遇到因为软件代码问题导致进入HardFault,从而使芯片锁死,来简述具体现象以及最终的解锁方法。 导致原因:如下图,在进行Gpio的相关配置,case后面没有break语句,导致芯片进入HardFault。 现象1:reset引脚持续为低,reset指示灯常亮。如果掉电后重新上电,通过示波器抓取reset引脚的波形,会有510us左右或者29ms左右的低电平脉冲出现,一般会出现两三次左右并且没有规矩,持续几秒的高电平之后,reset脚再次被拉低

weixin_41935674的博客 8275

注册电气工程师详细教材

注册电气工程师详细教材

qq_40844444的博客 4251

GreatSQL 构建高效 HTAP 服务架构指南(MGR)

服务器配置$ uname -a组件配置IP角色版本备注Primary 节点Secondary 节点专属 HTAP 只读节点Secondary 节点高可用备节点8.4.0 TLS代理/中间件。可根据需求灵活替换。

GreatSQL2021的博客 1306

病理图像处理个人手札(三)WSI & MIL

1.什么是WSI? WSI全称是Whole Slide Image,也就是全视野数字切片,主要应用在病理学细胞图像领域。WSI 是利用数字扫描仪对传统的病理切片进行扫描,采集具有高分辨率的数字图像,再通过计算机将得到的碎片化图像进行无缝拼接整合,制作可视化数字图像的一项技术。与传统载玻片相比,很好地解决了传统的玻璃切片易损坏、易褪色、易丢片、检索困难的问题。 一言以蔽之,WSI是对传统载玻片进行数字化。 由于是全视野,因此它将包含多尺度的切片在一个文件上面。因此WSI将使用到金字塔模型满足其支持不同分辨率的

baiweizeng的博客 1万+

GreatSQL社区2024年全年总结(免费领红包封面)

* GreatSQL社区原创内容未经授权不得随意使用,转载请联系小编并注明来源。社区2024年总结GreatSQL 社区在2024年度上持续迈进,成果斐然。一方面,开放了 GreatSQL 单机版以及三节点 MGR 集群的在线测试体验环境,让用户能够在线体验各种 GreatSQL 创新特性。另一方面,社区手册也持续更新,方便用户查阅。同时,社区积极拓展教育合作领域,成功走进郑州大学,联合开设 “G...

老叶茶馆 195

七自由度机械臂逆运动学实战:从几何简化到KDL库高效求解

本文深入探讨了七自由度机械臂逆运动学求解的实战方法。针对冗余自由度带来的挑战,文章对比了两种核心方案:一是利用任务约束进行几何简化,快速求解特定任务;二是基于DH参数法配置KDL库,实现通用高效的数值迭代求解。文中结合宇树H1机器人实例,详细阐述了从模型解析、参数提取到代码实现与验证的全流程,并提供了几何法与KDL库的适用场景对比与避坑指南。

weixin_29044713的博客 639

matlab锅炉 pid仿真,基于Matlab锅炉仿真.doc

基于Matlab锅炉仿真内蒙古科技大学MATLAB课程设计任务书2012题 目:锅炉汽包水位控制系统学生姓名:林三彪学 号:0967112127专 业:测控技术与仪器班 级:2009-1指导教师:梁 丽摘 要锅炉是化工、炼油、发电、造纸和制糖等工业生产过程中必不可少的重要动力设备。锅炉往往成了不少工厂不可缺少的一部分,因而,对锅炉设备中的自动控制系统进行分析研究是必要的...

weixin_29133981的博客 1096

PostgreSQL与国产数据库技术选型实战:从内核对比到部署测试

关系型数据库作为现代应用的数据存储核心,其技术选型直接影响系统的稳定性、扩展性与长期成本。开源数据库PostgreSQL凭借其强大的SQL标准兼容性、完善的事务支持(ACID)以及独特的扩展机制(如PostGIS),在全球企业级应用中占据重要地位。随着云原生和分布式架构的普及,数据库技术价值不仅体现在单机性能,更在于弹性伸缩、高可用运维及生态整合能力。在此背景下,国产数据库通过借鉴与创新,在云原生架构、分布式事务及企业级管控等应用场景实现了快速发展。本文聚焦于PostgreSQL内核与国产数据库(如Pola

weixin_34200628的博客 412

springcloud+nacos+gateway+oauth2小聚会

在微服务工程中,Nacos作为目前主流的注册中心和配置中心,Spring Cloud Gateway作为目前主流的网关,下面引入spring security+oauth2+jwt作为认证和授权中心,进行简单的聊聊。

ldcaws的专栏 2646

PostgreSQL开源生态与国产数据库发展:从技术基石到自主创新之路

在数据库选型和技术路线规划中,一个长期困扰国内开发者与企业决策者的问题是:那些宣称“自主可控”的国产数据库,究竟有多少是真正的技术创新,又有多少是基于成熟开源项目(尤其是 PostgreSQL)的“二次开发”?随着“去IOE”浪潮和信创政策的推进,国产数据库市场百花齐放,但繁荣背后也伴随着“套壳”的质疑。本文将深入探讨 PostgreSQL(简称 PG)这一开源数据库巨头的技术生态,分析其对国产数据库产业的深远影响,并尝试回答:在 PG 诞生三十年后,中国数据库产业究竟走到了哪一步?本文适合所有关注数据库技

weixin_30823001的博客 343

KV Cache 详解:新手也能理解的 LLM 推理加速技巧

(Autoregressive)生成的,即每次生成一个 token,然后将其作为输入继续生成下一个 token。:如果序列太长,超过了 KV Cache 的存储限制,就需要丢弃最早的 tokens(类似滑动窗口)。时,每次只会生成一个新 token,然后再把这个 token 作为输入继续生成下一个 token。,只缓存计算过的 K,VK, V,每次只计算新 token 的 K,VK, V,从而提升推理效率。:如果输入的 prompt 发生变化,之前的 KV Cache 不能复用,必须重新计算。

Harry的博客 7359

知识追踪实战:lstm+ Multi-head Attention注意力机制的学生做题成绩预测实战

知识追踪实战:lstm+ Multi-head Attention注意力机制的学生做题成绩预测实战

2222

CentOS7安装GreatSQL

GreatSQL 数据库是一款 开源免费 数据库,可在普通硬件上满足金融级应用场景,具有 高可用、高性能、高兼容、高安全 等特性,可作为 MySQL 或 Percona Server for MySQL 的理想可选替换。

落的博客 1701

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

探索卓越性能:GreatSQL - 高效数据库解决方案

探索卓越性能:GreatSQL - 高效数据库解决方案 项目简介 是一个开源的、高性能的关系型数据库管理系统,它源自 MySQL 的 Percona Server for MySQL 分支,并在此基础上进行了一系列优化和增强,旨在提供更优秀的事务处理能力、更高的并发性能以及更好的大数据处理能力。 技术分析 性能提升 GreatSQL 在 MySQL 的基础上,针对 InnoDB 存储引擎进行了深度...

gitblog_00021的博客 645

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

GreatSQL体系架构的了解

通过学习《图文结合带你搞懂GreatSQL体系架构》,能对GreatSQL的基本底层原理有所了解。一张经典的体系架构图,图1_GreatSQL5.7 版本体系架构图由此可以发现,GreatSQL5.7由以下几部分组成,连接池组件系统管理和控制工具SQL接口组件查询解析器查询优化器缓存组件可插拔存储引擎系统和日志文件GreatSQL数据库区别于其他数据库的一个特点就是其可插拔的表存储引擎,特别需要注...

bisal的专栏 409

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

MariaDB 和 GreatSQL 性能差异背后的真相

最近项目上遇到了两次 MariaDB 和 GreatSQL 的对比,GreatSQL受到客户质疑,最后经过排查抓到性能差异背后的真相。基于此做个分享。无论是问题一中的100倍性能背后还是插入hang住,其实背后都是对产品的不了解,MariaDB 10.3.39其实对应的是5.7的产品,而且其本身的默认参数调整有作弊嫌疑,默认关闭binlog ,sync_binlog设置为0,checkpoint阈值降低,提高checkpoint的频率等设置,面向测试环境数据是很好看的,但是增加了生产环境的风险和硬件成本。

GreatSQL2021的博客 1668

腾讯 GreatSQL 全链路实战:从国产化选型到 MGR 集群部署

【摘要】GreatSQL是由腾讯主导开发的开源MySQL分支数据库,基于MySQL 8.0内核深度优化,完全兼容MySQL协议与语法,特别适配国产信创环境。其核心优势包括:增强的MGR高可用架构,支持仲裁节点避免脑裂;性能较原生MySQL提升30%;提供国密加密等安全特性;完美适配鲲鹏、飞腾等国产CPU及麒麟、统信等操作系统。安装部署支持二进制包方式,配置与MySQL高度一致,同时针对MGR集群进行了优化预设。GreatSQL的零代码迁移特性使其成为金融、政务等领域替代Oracle/MySQL的理想选择,特

一火的专栏 842

图文解读MySQL/GreatSQL体系架构

*GreatSQL社区原创内容未经授权不得随意使用,转载请联系小编并注明来源。往期系列回顾图文结合系列之带你搞懂MySQL日志系列很多小伙伴使用了GreatSQL,但是对GreatSQL的底层原理还不是很了解,今天就带大家一起揭开GreatSQL体系架构的神秘面纱!首先来回顾一张经典的体系架构图:图1_GreatSQL5.7 版本体系架构图由此可以发现,GreatSQL5.7 由以下几部分组成连...

老叶茶馆 520

关于GreatSQL字符集的总结

最近的SQL优化工作中经常遇到因字符集或校验规则不一致导致索引使用不了的问题,修改表的字符集或校验规则相当于把表重构,表中数据量大时,处理起来费时费力,希望应用开发者在设计之初时注意到此问题,让后期接手运维的小伙伴少一些负担。GreatSQL的字符集和校验规则种类繁多,提供灵活性的同时,也带来使用混乱的烦恼。本文对字符集做一个总结,让读者对GreatSQL的字符集有一个全面的了解。

GreatSQL2021的博客 1142

面向金融级应用的GreatSQL正式开源

本文首发于 GreatSQL社区 微信公众号。经过几个月的紧张筹备,GreatSQL宣布正式开源。GreatSQL是源于Percona Server的分支版本,除了Percona Serv...

老叶茶馆 510

GreatSQL单机环境安装

《国产数据库之-GreatSQL》介绍了万里的GreatSQL数据库,在这篇文章中,我们尝试搭建一个单机版的环境。GreatSQL是源于Percona Server的分支版本,因此从整体安装的流程上,和MySQL基本一致。1. 下载安装文件可以从这个链接,下载对应平台的安装文件,如果是CentOS,可以选择GreatSQL-8.0.25-15-Linux-glibc2.1...

bisal的专栏 2843
上一篇: FILE+POS 方式 GreatSQL 主从复制架构给主节点磁盘扩容
下一篇: 独家揭秘丨GreatSQL 没开Binlog时多线程插入数据性能劣化之谜
GreatSQL社区
博客等级 码龄5年 1210粉丝 390原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值