如何利用 Cohere 文本嵌入技术实现语义搜索

Cohere API 之旅 阅读详情

一、什么是语义搜索

语义搜索提供基于文本段落的上下文含义的搜索功能。它解决了替代方法(关键字搜索)的局限性。

例如我们来查询:“吃饭的地方”。使用语义搜索模型就能够自动将其与“餐馆”联系起来,因为它们的含义相似。而通过关键字搜索却无法做到这一点,因为搜索结果将局限于“地点”、“去”和“吃”等关键字。

这就像是与搜索引擎进行一场对话,它不仅理解你询问的内容,还理解你为什么要询问。这正是自然语言处理、人工智能和机器学习的魅力所在。它们共同努力理解用户的查询、查询的上下文以及用户的意图。语义搜索研究单词之间的关系或单词的含义,以提供比传统关键词搜索更准确、更相关的搜索结果。

二、什么是关键词搜索

在语义搜索出现之前,最流行的搜索方式是关键词搜索。假设你有一组很多句子的列表,这些句子是搜索引擎的响应内容。当你提出一个问题(查询)时,关键词搜索会查找与查询具有最大词汇共现数的句子(响应)。例如,以下面的查询和响应为例:

查询:北京天安门在哪里?

使用关键词搜索,你可以注意到响应与查询具有以下词汇共现数: 响应:

1、天安门在北京。 (共有6个词)

2、北京有很多好吃的小吃。 (共有1个词)

3、我喜欢去北京旅游。 (共有1个词)

4、北京是中国的首都。 (共有1个词)

在这种情况下,获胜的响应是编号 1,“天安门在北京”。比较幸运,这是正确的答案。然而,并不一定每次都能答对。假如还有下面这个答案:

1、在北京天安门是一个历史悠久的建筑?

这个答案与查询有 6 个词汇共现,因此如果它在响应列表中,它将会获胜。但是这却不是正确的响应。

那么这种情况一般会如何来解决呢? 我们可以通过删除“在”、“的”、“是”等停用词来改进关键字搜索。我们还可以使用 TF-IDF 等方法来区分相关词和不相关词。然而,正如您可能想象的那样,总会有这样的情况,由于语言、同义词和其他障碍的模糊性,关键字搜索将无法找到最佳响应。语义搜索在这种场景将派上了用场。

简单的理解,语义搜索的工作原理如下:

  • 首先使用文本嵌入将单词转换为向量。

  • 然后使用相似度算法在响应结果中查找与查询对应的向量最相似的向量。

  • 最后输出与这个最相似的向量对应的响应结果。

接下来,我们将构建一个简单的语义搜索引擎。语义搜索的应用不仅仅限于构建网络搜索引擎。他们可以为内部文档或记录提供私人搜索引擎。它可用于增强 StackOverflow 的“类似问题”功能等功能。

三、如何使用文本嵌入进行搜索

Embedding 是一种为每个句子(每个文本片段,可以是一个单词或一篇完整文章)分配向量的方法,该向量是一个数字列表。本文中使用的Cohere嵌入模型返回长度为4096的向量。这是一个包含4096个数字的列表(而其他的Cohere嵌入模型,如多语言模型,则返回长度较小的向量,例如768)。嵌入的一个非常重要的特性是相似的文本片段会被分配到相似的数字列表。例如,“你好,你好吗?”和“嗨,最近怎么样?”这两个句子将被分配到类似的数字列表中,而“明天是星期五”则被分配到与前两个句子完全不同的数字列表。

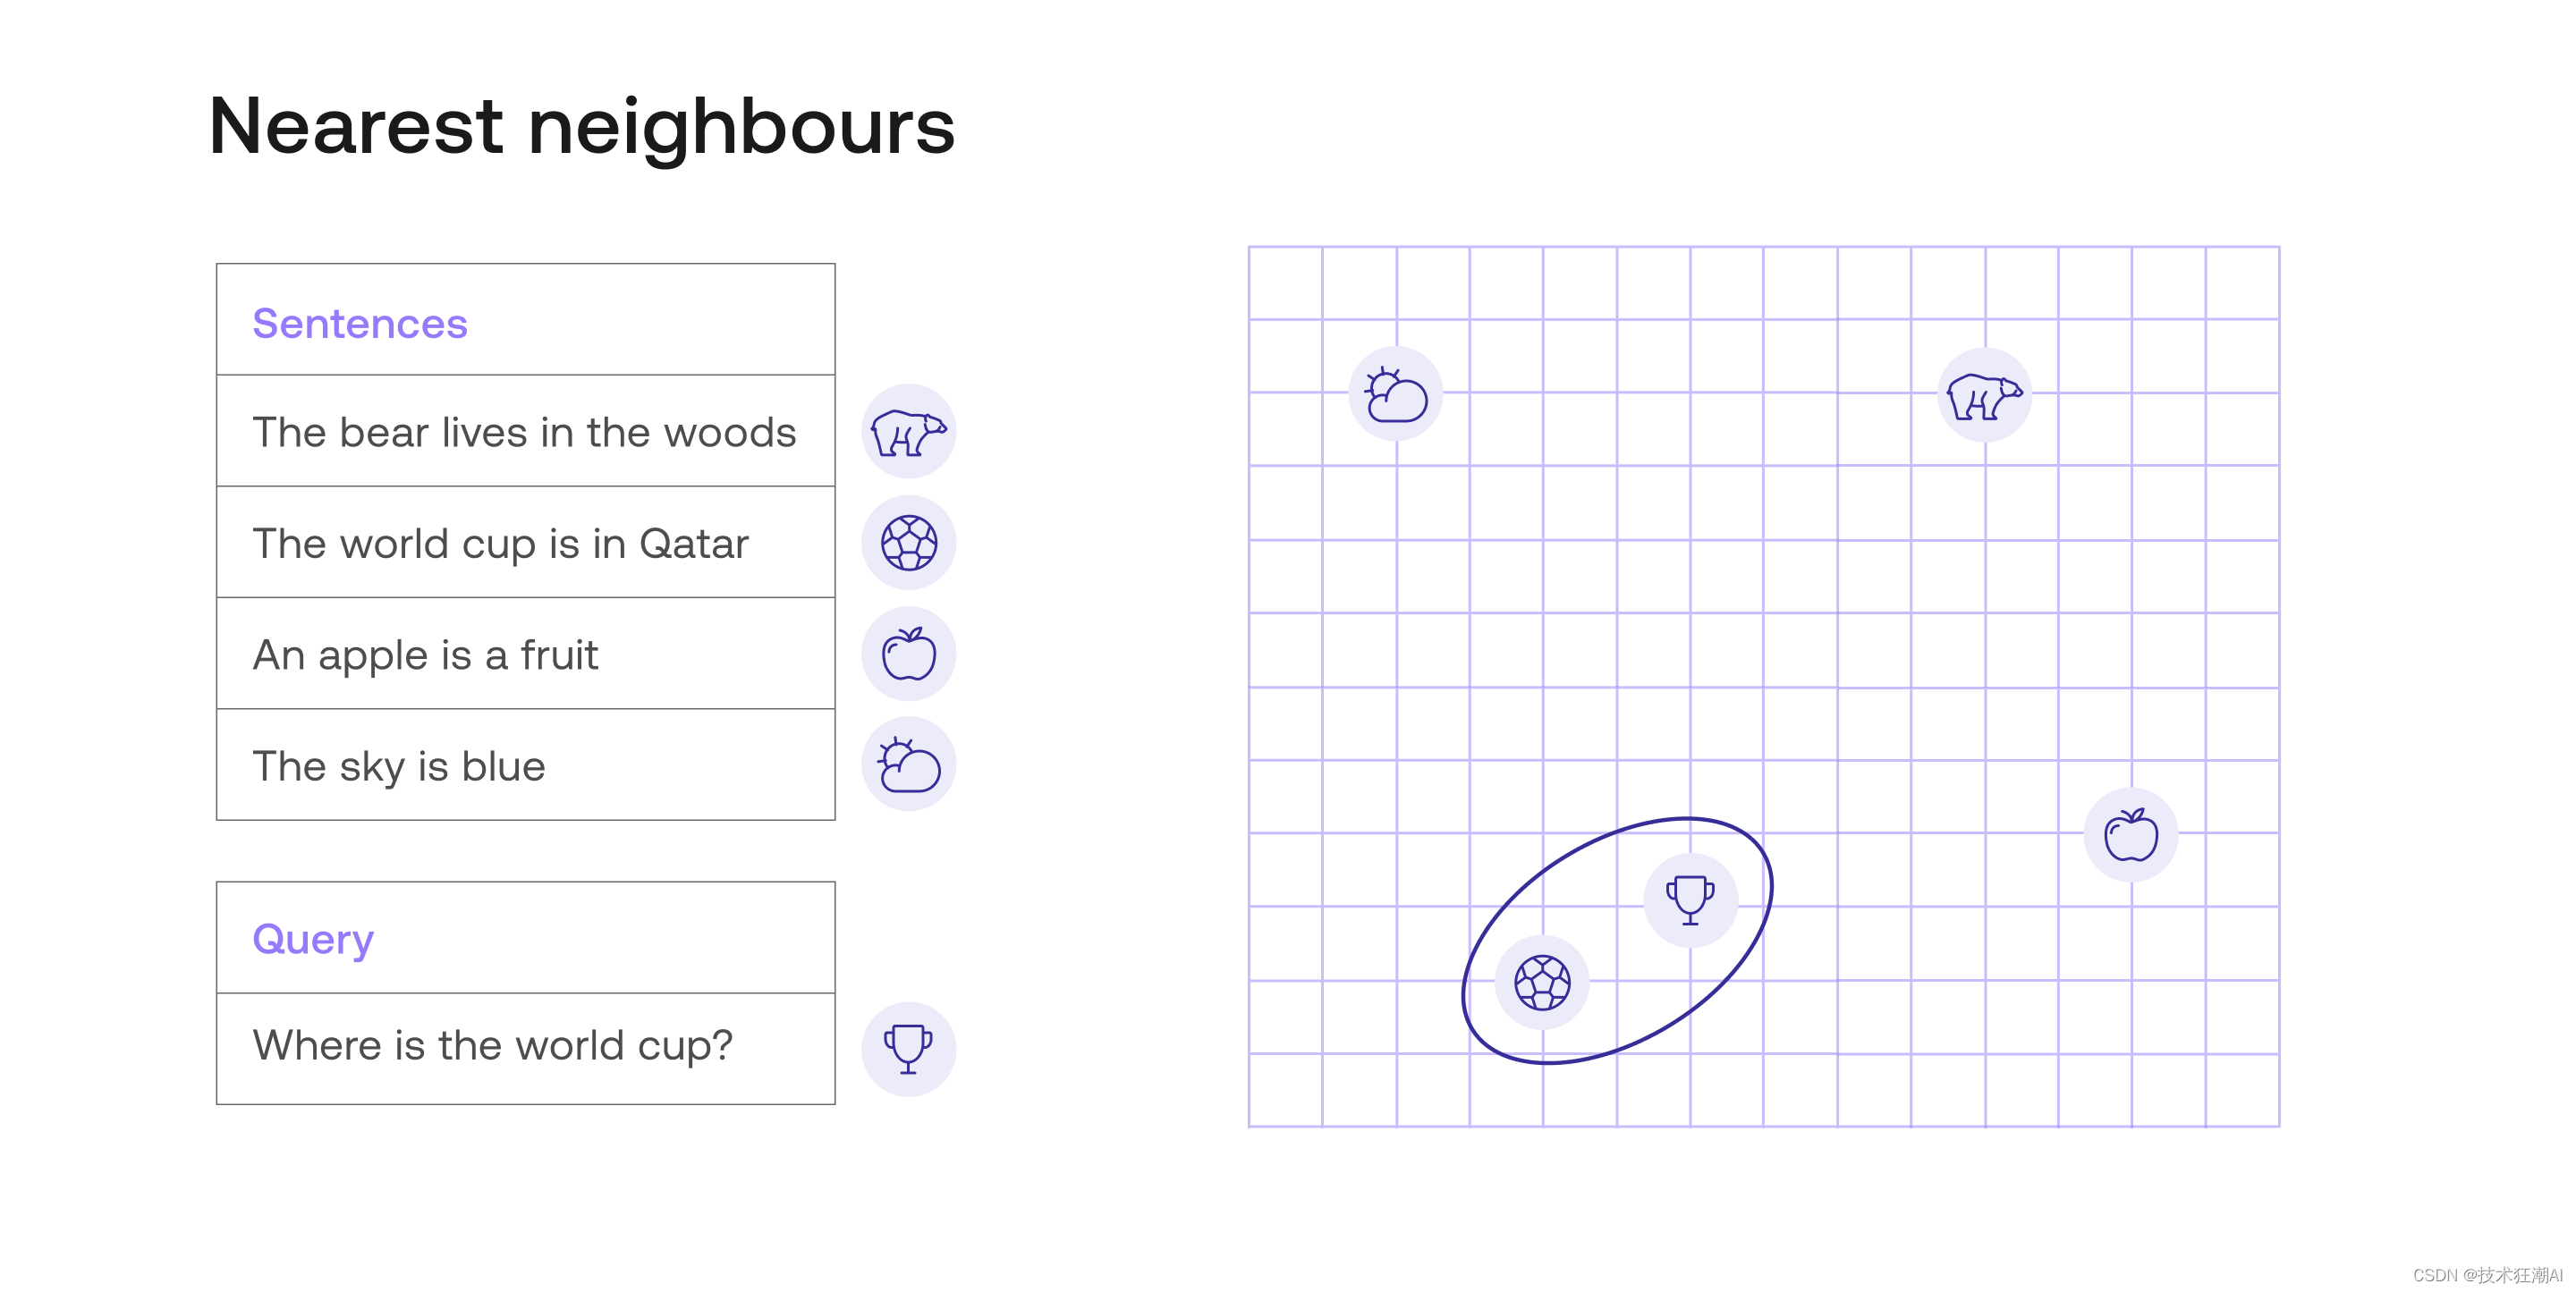
下图展示了一个嵌入示例。为了便于理解,在这个示例中每个句子都被赋予长度为2(即包含两个数字) 的向量。这些数字在右侧图表中以坐标形式绘制出来。例如,“世界杯在卡塔尔”这个句子被赋予向量(4, 2),因此它在坐标点 (4, 2) 处绘制出来。
787c6353a3884fb89f70766f4e0f7186.png?code=OTUxMjA0N2U4YzVkZGVmZmNlNzVjOTBmMjkwMDZjMjFfY25rSUFzcUZmd3JkdFMyTWxUQk9HOWJlcmhqdEM3VmRfVG9rZW46S2VTYmJLU2h5b1JXUGN4ZXM4M2NUMnN0blFmXzE2OTA4NzU5MTM6MTY5MDg3OTUxM19WNA

在此图像中,所有句子都作为平面上的点来定位。从视觉上,您可以确定查询(由奖杯表示)与响应“世界杯在卡塔尔”(由足球表示)最接近。其他查询(由云、熊和苹果表示)则远得多。因此,语义搜索将返回“世界杯在卡塔尔”,这是正确的响应。

接下来我们使用Cohere的文本嵌入来对这8个句子进行编码。这将为我们提供8个长度为4096的向量,但是我们可以使用一些降维算法将其长度降低到2。就像之前一样,这意味着我们可以使用2个坐标在平面上绘制句子。下面是情节。

2b40397a3ddc4ddd8981720a3c01cccf.png?code=M2Q2MzBmMzVmZTI2YTZiNDYwZDI1ZTRjZTY1MDM0Mjlfb0tXQVhOV2lJTGwxaDIwUGc5UnVxREM5d05CUnNxd2pfVG9rZW46TzQ1V2JUQVFkb1ZGVHh4RXNvT2NSS3lmbm5kXzE2OTA4NzU5MTM6MTY5MDg3OTUxM19WNA

请注意,每个查询都最接近其相应的响应。这意味着如果我们使用语义搜索来搜索这4个查询中每一个查询的响应,我们将得到正确的响应。

这里有个需要注意的地方。在上面的示例中,我们使用了欧几里得距离,它只是平面上的距离度量方式。然而,在比较文本片段时,并不是最理想的方法。相似性度量是最常用且能够给出最佳结果的方法。

四、使用相似性来查找最佳文档

相似性是判断两个文本片段是否相似或不同的一种方式,它使用了文本嵌入。在语义搜索中常用的两种相似性度量方法:

  • 点积相似性

  • 余弦相似性

现在,让我们将它们合并为一个概念,并假设相似性是分配给每对文档的一个数字,并具有以下特征:

  • 一段文本与自身的相似性非常高。

  • 两个非常相似的文本片段之间的相似性较高。

  • 两个不同的文本片段之间的相似性较低。

这里我们将使用余弦相似度,其额外属性是返回值介于0和1之间。一段文本与自身的相似度始终为1,并且最低值为0(当两个文本片段完全不同时)。

现在,要进行语义搜索,只需要计算查询与每对句子之间的相似度,并返回具有最高相似度的句子。下面是上述数据集中8个句子之间余弦相似度绘制出来的。

77539b1154bf4270ab6e6d20358b1974.png

 在这个图表中,右侧给出了刻度尺。请注意以下特点:

  • 对角线上都是1(因为每个句子与自身的相似度为1)。

  • 每个句子与其对应响应之间的相似度约为0.7。

  • 任何其他一对句子之间的相似度较低。

这意味着,如果你搜索例如“什么是苹果?”这个查询的答案,语义搜索模型将查看表中倒数第二行,并注意到最接近的句子是“什么是苹果?”(相似度为1)和“苹果是水果”(相似度约为0.7)。系统会从列表中排除相同的查询,因为它不想回复相同的问题。因此,获胜响应将是“苹果是水果”,这也是正确的回答。

在这里还有一个我们没有提到但非常重要的隐藏算法:最近邻算法。该算法找到数据集中某一点最近邻。在本例中,该算法找到了句子“什么是苹果?” 的最近邻,并返回了句子“苹果是水果”。

五、什么是最近邻算法

最近邻算法是一种常用的分类算法。它的基本思想是根据数据点之间的距离来确定它们的相似性。对于一个给定的数据点,最近邻算法会找出与其最接近的k个邻居,并将该数据点分配给邻居中出现最频繁的类别。

举个例子,如果我们要对一段文本进行情感分类,将其分类为积极或消极,我们可以使用最近邻算法。假设我们选择k=3,那么算法会找出与该段文本最接近的三个邻居(在某种表示下),然后观察这三个邻居中类别出现最频繁的是积极还是消极。根据这个结果,我们可以将该段文本分配给相应的类别。

需要注意的是,最近邻算法在计算速度上可能会比较慢。因为要找到一个数据点的邻居,需要计算该点与数据集中所有其他点之间的距离,并找出距离最近的几个点。这个过程可能会消耗较多的计算资源。如下图所示,为了找到与“Where is the world cup?”这句话最接近的邻居,我们必须计算 8 个距离,每个数据点一个。

总之,最近邻算法是一种简单而常用的分类算法,它通过计算数据点之间的距离来确定它们的相似性,并将数据点分配给邻居中出现最频繁的类别。尽管计算速度可能较慢,但在某些情况下仍然可以提供良好的分类结果。

07f4f63d22c84890ba71155e27f01dec.png?code=OGM0MzMyMDEzZjJmM2UyOGZlMDJiMWY1OWJiYTZiM2JfeDlMZjlKVnJRazZGNXRRZEd6TVpTVTUwcm9YU3Z3WGVfVG9rZW46T2dwM2Jha3FhbzFrdDh4aThXd2N5eTZLbjRmXzE2OTA4NzU5MTM6MTY5MDg3OTUxM19WNA

然而,在处理大量档案时,我们可以通过稍微调整算法以使其成为近似 k 最近邻来优化性能。特别是在搜索方面,有一些改进可以大大加快这个过程。以下是其中两个:

  • 倒排文件索引(IVD):包括对相似文档进行聚类,然后在最接近查询的聚类中进行搜索。

  • 分层可导航小世界(HNSW):包括从几个点开始,然后在那里进行搜索。然后在每次迭代中添加更多点,并在每个新空间中进行搜索。

六、基于 Cohere AI 实现语义搜索

6.1、下载依赖包

# 安装Cohere获取嵌入,使用Umap将嵌入降维到2维
# 使用Altair进行可视化,使用Annoy进行近似最近邻搜索
!pip install cohere umap-learn altair annoy datasets tqdm

导入必要的库

import cohere
import numpy as np
import re
import pandas as pd
from tqdm import tqdm
from datasets import load_dataset
import umap
import altair as alt
from sklearn.metrics.pairwise import cosine_similarity
from annoy import AnnoyIndex
import warnings
warnings.filterwarnings('ignore')
pd.set_option('display.max_colwidth', None)

6.2、获取 Cohere API Key

我们需要在 Cohere 的官方(https://dashboard.cohere.ai/)注册账号来获取你的 Cohere API 密钥。

# 在此处粘贴您的API密钥。请记住不要公开分享。
api_key = ''

co = cohere.Client(api_key)

6.3、获取问题分类数据集

我们这里将使用trec数据集来演示,trec数据集由问题及其类别组成。

# 获取数据集
dataset = load_dataset("trec", split="train")

# 将其导入到pandas的dataframe中,只取前1000行
df = pd.DataFrame(dataset)[:1000]

# 预览数据以确保已正确加载
df.head(10)

6.4、文档嵌入

现在我们可以使用Cohere对问题文本进行嵌入。我们将使用Cohere库的embed函数对问题进行嵌入。生成一千个这样长度的嵌入大约需要15秒钟。

# 获取嵌入
embeds = co.embed(texts=list(df['text']),
                  model="large",
                  truncate="RIGHT").embeddings

# 检查嵌入的维度
embeds = np.array(embeds)
embeds.shape

6.5、使用索引和最近邻搜索进行搜索

现在我们可以构建索引并搜索最近的邻居。我们将使用annoy库的AnnoyIndex函数,一种优化快速搜索的方式存储嵌入。在给定集合中找到距离给定点最近(或最相似)的点的优化问题被称为最近邻搜索。这种方法适用于大量的文本(其他选项包括Faiss、ScaNN和PyNNDescent)。

构建索引后,我们可以使用它来检索现有问题的最近邻,或者嵌入新问题并找到它们的最近邻。

# 创建搜索索引,传入嵌入的大小
search_index = AnnoyIndex(embeds.shape[1], 'angular')
# 将所有向量添加到搜索索引中
for i in range(len(embeds)):
    search_index.add_item(i, embeds[i])

search_index.build(10) # 10 trees
search_index.save('test.ann')

6.5.1、查找数据集中示例的邻居

如果我们只对数据集中的问题之间的距离感兴趣(没有外部查询),一种简单的方法是计算我们拥有的每对嵌入之间的相似性。

# 选择一个示例(我们将检索与之相似的其他示例)
example_id = 7

# 检索最近的邻居
similar_item_ids = search_index.get_nns_by_item(example_id,10,
                                                include_distances=True)
# 格式化并打印文本和距离
results = pd.DataFrame(data={'texts': df.iloc[similar_item_ids[0]]['text'], 
                             'distance': similar_item_ids[1]}).drop(example_id)

print(f"问题:'{df.iloc[example_id]['text']}'\n最近的邻居:")
results

问题:“什么是最古老的职业?”

最近邻:

2f54d4ad1bd74fb1ad25906ba83210f8.png?code=MzA4NWMwZDgyNmJmMDkyNzE0ODQ3ODMwYzQxM2Q0ODVfR3h0SGs2Q21neXVKbVl5N1lFQ3VoS1R1YmtRdGRXUmFfVG9rZW46U21ZNWJRSE41b2FUbmx4QTluZGNReGRtbnlnXzE2OTA4NzU5MTM6MTY5MDg3OTUxM19WNA

6.5.2、查找用户查询的邻居

我们可以使用诸如嵌入之类的技术来找到用户查询的最近邻居。通过嵌入查询,我们可以衡量它与数据集中项目的相似性,并确定最近的邻居。

query = "世界上最高的山是什么?"

# 获取查询的嵌入
query_embed = co.embed(texts=[query],
                  model="large",
                  truncate="RIGHT").embeddings

# 检索最近的邻居
similar_item_ids = search_index.get_nns_by_vector(query_embed[0],10,
                                                include_distances=True)
# 格式化结果
results = pd.DataFrame(data={'texts': df.iloc[similar_item_ids[0]]['text'], 
                             'distance': similar_item_ids[1]})

print(f"问题:'{query}'\n最近的邻居:")
results

查询:“世界上最高的山是什么?”

最近邻:

d0e56dd2233148f489dc9f2973ae9b90.png?code=MDg4ZTNkZmE5Zjc0ZmY0NTc5NDM3NDAwNmRiMThlNjdfSkFKclNMR0I0UFVrUGN2WXNMRGhaSFBDeGFaTk5hcUZfVG9rZW46UGJ6TmIzNThXb1JxVTF4aVk0Y2NvTW5abmFnXzE2OTA4NzU5MTM6MTY5MDg3OTUxM19WNA

七、总结

本文主要介绍了如何使用Cohere构建语义搜索引擎。分别从如何获取问题数据集、进行文本嵌入和搜索,以及如何对结果进行可视化等方面进行展开介绍。这为我们进一步探索语义搜索领域奠定了基础。

 

探索Cohere API:提升自然语言处理的利器 本文介绍了如何使用Cohere的API进行自然语言处理,包括安装、设置和使用提示模板。Cohere API 文档Langchain 项目。 阅读详情

相关推荐

探索Cohere API:提升自然语言处理能力的有效工具

Cohere提供了一套强大且易于使用的工具来增强NLP应用的能力。本文介绍了如何设置和调用Cohere API,以及如何结合提示模板进行应用开发。想深入了解Cohere API的更多细节,可以参考以下资源。

sjufgwgfhoia的博客 680

Cohere模型开发介绍

使用cohere进行LLM应用开发。

weixin_40090689的博客 1469

探索文本嵌入模型:使用LangChain实现语义搜索

文本嵌入模型可以将文本转化为高维向量,这些向量可以用于多种NLP任务,如分类、聚类和搜索。LangChain提供了一个统一的接口,支持多种嵌入模型,包括OpenAI、Cohere和Hugging Face。文本嵌入是实现现代NLP应用的重要工具。LangChain通过提供统一的接口,使得集成多种嵌入模型变得更加便捷。

mmlihaio的博客 838

自己实现 OpenAI 的 /v1/embeddings 接口

自己实现 OpenAI 的 /v1/embeddings 接口

engchina的专栏 3038

探索文本嵌入模型:实现文本语义搜索的利器

文本嵌入是将文本转换为数学向量的过程。转换后的向量在一定程度上保留了文本的语义信息,使我们可以在向量空间中进行相似性比较或聚类。文本嵌入模型为我们提供了一种强大的方式来在向量空间中表示文本,从而实现语义搜索等任务。了解并熟练使用这些工具可以大大提升文本处理的效率。建议进一步探索各提供者的文档以了解更多细节。

nseejrukjhad的博客 502

探索文本嵌入模型:将文本转换为向量的实用指南

文本嵌入是一种将文本转换为数值向量的技术。向量表示可以捕捉文本的语义信息,这使得进行诸如相似性搜索这样的操作变得可能。文本嵌入对于理解文本之间的相似性和关系非常有用。文本嵌入模型使得在文本处理和理解方面取得了显著进展。深入学习每个提供商的API文档,并尝试在不同的项目中应用这些技术,可以帮助您更好地掌握这些工具。

kwsyger的博客 677

大型语言模型的语义搜索(二):文本嵌入(Text Embeddings)

单词和句子嵌入是大型语言模型(LLM)的主要工作。它们是大多数语言模型的基础构件,它通过捕获了单词、语义和语言细微差别之间的许多关系,并将其转换为有关相应数字,从而将人类语言(单词)翻译为计算机能理解的语言(数字)。

weixin_42608414的博客 2824

深入探索文本嵌入模型:原理、实现与挑战

文本嵌入是指将文本表示为一组向量的技术。这些向量保留了文本的语义信息,使得可以对不同文本进行比较、检索和分析。文本嵌入模型是处理和分析文本数据的强大工具。通过使用LangChain库,我们可以便捷地访问多种嵌入提供商的服务。OpenAI API文档Cohere API文档Hugging Face模型库。

sgeahtgwh的博客 1307

Cohere 多语言嵌入模型构建金融搜索应用程序

金融分析师需要消化大量内容,如金融出版物和新闻媒体,以保持信息灵通。根据财务专业人员协会(AFP)的数据,金融分析师 75% 的时间用于收集数据或管理流程,而非增值分析。跨多种来源和文档寻找问题答案是一项耗时且乏味的工作。Cohere 嵌入模型帮助分析师快速搜索多种语言的大量文章标题,找到并排列与特定查询最相关的文章,从而节省大量时间和精力。在以下用例示例中,我们展示了如何使用 Cohere 的 Embed 模型在一个独特的管道中搜索和查询不同语言的金融新闻。

大模型 1241

[深入探索文本嵌入模型:从理论到实践]

通过本文,我们探索了如何使用LangChain库与多家文本嵌入模型提供商进行接口对接。OpenAI文档Cohere文档Hugging Face文档。

adfyvatbia的博客 774

Cohere vs OpenAI 嵌入模型深度评测:技术选型、性能对比与最佳实践

在自然语言处理(NLP)和机器学习领域,文本嵌入(Text Embedding)技术扮演着至关重要的角色。它将非结构化的文本数据转化为低维稠密的向量表示,使得计算机能够更好地理解和处理文本的语义信息。选择合适的嵌入模型,直接关系到应用性能、成本效益以及开发效率。本文将聚焦于业界领先的两大AI平台——Cohere 和 OpenAI,对其提供的嵌入模型进行全方位、深度的对比分析,助力开发者在技术选型时做出更明智的决策。

高校图书馆高级系统架构师/研究馆员,推动高校AI从概念演示到可评审、可交付、可运维:路线图与立项评审、PoC交付、评测回归与上线运维(Baseline/Eval/Ops)。 1511

Cohere

Aidan Gomez(首席执行官)、Nick Frosst 和 Ivan Zhu 于 2019 年创立了 Cohere。其中 Aidan Gomez 于 2017 年 6 月与人合著论文《Attention Is All You Need》,这个的分量大家都知道,在此不赘述。2023 年初,YouTube 前首席财务官 Martin Kon(总裁兼首席运营官)加入团队。

AI工程化、开源分享、文档翻译、代码笔记 2166

如何使用Text Embedding模型进行语义搜索:从OpenAI到Hugging Face

文本嵌入是自然语言处理中的一个关键工具,能够帮助开发者实现复杂的文本相似性和搜索功能。OpenAI官方文档Cohere官方文档Hugging Face官方文档。

adfyvatbia的博客 486

使用文本嵌入模型进行语义搜索

文本嵌入技术的核心在于将文本表示为向量,使得语义相近的文本在向量空间中距离较近。这种技术在语义搜索、文本分类、情感分析等领域有着广泛的应用。LangChain库通过统一接口简化了与各种嵌入模型(如OpenAI、Cohere、Hugging Face)的集成过程。

HGWAcsdgvs的博客 419

携程酒店数据爬取进阶:动态接口破解与反反爬策略实战

本文详细解析了携程酒店数据爬取的进阶技巧,包括动态接口参数破解、反爬虫策略对抗及企业级采集方案实现。重点介绍了eleven参数的生成逻辑、动态Cookie维护方法,以及如何应对携程的请求指纹检测和行为模式识别。通过实战案例,帮助开发者高效获取酒店价格数据,同时遵守行业规范。

eee77的博客 1078

7 series FPGAs Transceiver Wizard IP核使用和测试

学习FPGA一段时间了,前面一直没有系统的总结,这学期把在项目中用到的IP核和一些调试过程中遇到的问题总结一下发出来,坚持下去,一起进步! 今天总结一下的GTH核的使用和测试。 软件版本:Vivado 2017.4 IP核版本:7 Series FPGAs Transceivers Wizard (3.6) FPGA:xc7vx690tfft1927 实现功能: 四路光纤数据接收,由于GTX IP...

qq_39921762的博客 1万+

构建下一代语义搜索系统:深入探索 Cohere 嵌入 API 的技术实现与应用

在人工智能发展的浪潮中,文本表示学习始终是自然语言处理的核心挑战之一。从早期的词袋模型到 Word2Vec,再到 Transformer 架构带来的革命性突破,文本嵌入技术已经发生了根本性变革。Cohere 作为专注于企业级 NLP 解决方案的领先公司,其嵌入 API 不仅在 MTEB(大规模文本嵌入基准)排行榜上表现卓越,更在实用性、多语言支持和部署便利性方面提供了独特价值。

不懂先生的博客 204

利用Android系统漏洞实现后台弹窗(外弹)

关键:从 Android 8.0(API 26)开始,禁止使用 context.sendBroadcast() 发送隐式广播(即没有指定 setPackage() 或明确组件的广播)。demo核心代码展示利用Android显示系统和广播系统的漏洞实现在后台弹窗的功能,支持最新Android15,16版本。核心功能都是在so层去做,大量使用了jni反调, 如果要上架到应用市场,需要对代码做进一步混淆,加固以应对市场安全扫描。3,开启虚拟显示窗口,这是个透明像素窗口。5,可开启一个线程,调用这个外弹窗口。

2018,再出发~ 1316

将 Cohere 与 Elasticsearch 结合使用

本教程中的说明向你展示了如何使用推理 API 使用 Cohere 计算嵌入并将其存储起来,以便在 Elasticsearch 中进行高效的向量或混合搜索。本教程将使用 Python Elasticsearch 客户端执行操作。本教程使用数据集。请参阅,了解使用不同数据集的示例。

Elastic 中国社区官方博客 1695

群晖NAS断电后IP变了?3步搞定静态IP设置(附Linux挂载指南)

本文针对群晖NAS因断电重启导致IP地址变化的问题,提供了从根源到实践的完整解决方案。核心内容包括如何为NAS配置静态IP以彻底解决连接中断,并详细讲解了在Linux系统中通过NFS协议稳定挂载NAS共享文件夹的步骤与指南,确保网络存储服务持久可靠。

weixin_29271263的博客 851

Altium Designer(AD24/25)如何在PCB设计阶段做阻抗匹配

目前阻抗匹配多直接有制版厂进行,PCB设计师在设计阶段可不关注阻抗设计,在加工阶段只需标注需要控制的阻抗线,制板厂即可按照要求对阻抗线进行调整和控制。但是对于设计师来讲掌握阻抗线的设计方法也是非常必要的。本文介绍Altium Designer(AD24/25)如何在PCB设计阶段做阻抗匹配。

fydar的博客 893

**深入探索文本嵌入模型:从理论到实现**

文本嵌入是将文本转换为数值向量的过程。这使得我们可以在向量空间中比较文本的相似性,从而进行语义搜索、文本聚类等操作。LangChain库提供了一个标准接口来使用不同的嵌入模型。文本嵌入是NLP应用中的一项重要技术。通过LangChain,我们可以方便地集成多种嵌入模型。

ppoojjj的博客 522

【芯片设计- RTL 编译与仿真 1.2 -- Visualizer 常用使用命令】

打开波形后,如果想要看到所有信号的数据,可以点击下图中红框中的按钮,因为默认verdi 默认并不是显示所用信号。如果想统计某一个信号中有多少笔数据时,可以使用 Expression->Edege Count 功能。如下图所示,如果没有打开前导0的功能时,当某一笔数据位0时,只会显示1个0。如果需要将波形的数据导出到文本文件时,可以按照下面步骤进行。打开前导0功能之后,会根据数据位宽来显示对应0的个数。

CodingCos的博客 2047

超强Hands-On-Large-Language-Models Cohere:企业级API应用

还在为构建企业级AI应用而头疼?传统的大语言模型部署复杂、成本高昂、维护困难,让无数企业望而却步。Cohere API的出现彻底改变了这一局面,为企业提供了开箱即用的LLM能力,无需担心基础设施、模型训练和部署运维的复杂性。 通过本文,你将掌握: - ???? Cohere API的核心功能与企业级应用场景 - ???? 语义搜索与向量检索的实战实现 - ???? 企业级API集成的最佳实践方案 - ????...

gitblog_00324的博客 851

【DaVinci Configurator专题】-2-将CAN 2.0或CANFD Matrix的Arxml/DBC文件导入到CFG

共9页 目录 1 打开DaVinci Configurator,导入Arxml文件 2 解决导入Arxml文件后可能会出现的一些错误 3 验证CFG的配置 4 根据CFG的配置生成代码 5 结尾 <--返回「实战篇」博文-总目录--> <--返回「Autosar从入门到精通-实战篇」专栏主页--> 关键词: Open the Input Files Assistant Complete update process Update ECU configurati

「汽车电子助手」的博客 6125

01-系统技术架构师必备——软件架构设计基础与核心概念

摘要 本文系统阐述了软件架构设计的核心概念与方法论,重点涵盖以下内容:1)软件架构的四大要素(构件、连接件、约束、配置)及其边界划分;2)Garlan & Shaw五大架构风格(数据流、调用/返回、独立构件、虚拟机、仓库)的典型应用场景;3)基于电商库存系统的架构选型实战案例,展示如何根据业务需求(高并发、最终一致性)选择事件驱动架构配合Saga模式;4)介绍ABSD、DSSA等主流架构方法论及ISO/IEEE标准体系。文章融合金融与互联网领域的架构实践经验,为技术架构师提供系统性的知识框架和决策参考。

模界 | AI工程化实践者 182
上一篇: LangChain Prompt Engineering和LLMs:如何让语言模型更好地理解和生成文本
下一篇: Falcon 40B——全球排名第一的AI模型现在已免费授权
技术狂潮AI
博客等级 码龄3年 1282粉丝 137原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

技术狂潮AI

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
