Python打卡训练营学习记录Day34

数据科学在线学习的认知适配协议:从雾里开车到端到端实战 数据科学不是静态知识体系,而是一种以问题驱动、反馈迭代、模式抽象为核心的工程化思维实践。其核心原理在于将业务问题快速映射为可执行的数据操作闭环,而非前置掌握全部数学或编程理论。技术价值体现在降低认知负荷、加速肌肉记忆形成、提升真实场景调试与交付能力。典型应用场景包括转行入门、团队线上培训提效、Kaggle项目攻坚及企业级数据清洗建模。本文聚焦‘最小可行分析循环(MVAC)’‘调试即学习’‘输出倒逼输入’三大杠杆点,深度融合Pandas数据处理与Jupyter交互式分析,提供一套经37期训练营验证的认知重构方 阅读详情

知识点回归:

  1. CPU性能的查看:看架构代际、核心数、线程数
  2. GPU性能的查看:看显存、看级别、看架构代际
  3. GPU训练的方法:数据和模型移动到GPU device上
  4. 类的call方法:为什么定义前向传播时可以直接写作self.fc1(x)

    CPU性能的查看

    上述是在cpu的情况下训练,(即使安装了cuda,但是没有使用cuda),我们借这个机会简单介绍下cpu的性能差异。

  5. # pip install wmi -i https://pypi.tuna.tsinghua.edu.cn/simple
    # 这是Windows专用的库,Linux和MacOS不支持,其他系统自行询问大模型
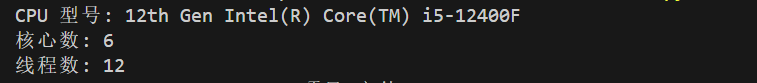
    # 我想查看一下CPU的型号和核心数
    import wmi
     
    c = wmi.WMI()
    processors = c.Win32_Processor()
     
    for processor in processors:
        print(f"CPU 型号: {processor.Name}")
        print(f"核心数: {processor.NumberOfCores}")
        print(f"线程数: {processor.NumberOfLogicalProcessors}")
 

GPU训练

要让模型在 GPU 上训练,主要是将模型和数据迁移到 GPU 设备上。

在 PyTorch 里,.to(device) 方法的作用是把张量或者模型转移到指定的计算设备(像 CPU 或者 GPU)上。

  • 对于张量(Tensor):调用 .to(device) 之后,会返回一个在新设备上的新张量。
  • 对于模型(nn.Module):调用 .to(device) 会直接对模型进行修改,让其所有参数和缓冲区都移到新设备上。

 在进行计算时,所有输入张量和模型必须处于同一个设备。要是它们不在同一设备上,就会引发运行时错误。并非所有 PyTorch 对象都有 .to(device) 方法,只有继承自 torch.nn.Module 的模型以及 torch.Tensor 对象才有此方法。

RuntimeError: Tensor for argument #1 'input' is on CPU, but expected it to be on GPU

这个常见错误就是输入张量和模型处于不同的设备。

如何衡量GPU的性能好坏呢?

以RTX 3090 Ti, RTX 3080, RTX 3070 Ti, RTX 3070, RTX 4070等为例

通过“代” 前两位数字代表“代”: 40xx (第40代), 30xx (第30代), 20xx (第20代)。“代”通常指的是其底层的架构 (Architecture)。每一代新架构的发布,通常会带来工艺制程的进步和其他改进。也就是新一代架构的目标是在能效比和绝对性能上超越前一代同型号的产品。

通过级别 后面的数字代表“级别”,

xx90: 通常是该代的消费级旗舰或次旗舰,性能最强,显存最大 (如 RTX 4090, RTX 3090)。
xx80: 高端型号,性能强劲,显存较多 (如 RTX 4080, RTX 3080)。
xx70: 中高端,甜点级,性能和价格平衡较好 (如 RTX 4070, RTX 3070)。
xx60: 主流中端,性价比较高,适合入门或预算有限 (如 RTX 4060, RTX 3060)。
xx50: 入门级,深度学习能力有限。
通过后缀 Ti 通常是同型号的增强版,性能介于原型号和更高一级型号之间 (如 RTX 4070 Ti 强于 RTX 4070,小于4080)。

通过显存容量 VRAM (最重要!!) 他是GPU 自身的独立高速内存,用于存储模型参数、激活值、输入数据批次等。单位通常是 GB(例如 8GB, 12GB, 24GB, 48GB)。如果显存不足,可能无法加载模型,或者被迫使用很小的批量大小,从而影响训练速度和效果

训练阶段:小批量梯度是对真实梯度的一个有噪声的估计。批量越小,梯度的方差越大(噪声越大)。显存小只能够使用小批量梯度。
推理阶段:有些模型本身就非常庞大(例如大型语言模型、高分辨率图像的复杂 CNN 网络)。即使你将批量大小减到 1,模型参数本身占用的显存可能就已经超出了你的 GPU 显存上限。

import torch
 
# 检查CUDA是否可用
if torch.cuda.is_available():
    print("CUDA可用!")
    # 获取可用的CUDA设备数量
    device_count = torch.cuda.device_count()
    print(f"可用的CUDA设备数量: {device_count}")
    # 获取当前使用的CUDA设备索引
    current_device = torch.cuda.current_device()
    print(f"当前使用的CUDA设备索引: {current_device}")
    # 获取当前CUDA设备的名称
    device_name = torch.cuda.get_device_name(current_device)
    print(f"当前CUDA设备的名称: {device_name}")
    # 获取CUDA版本
    cuda_version = torch.version.cuda
    print(f"CUDA版本: {cuda_version}")
    # 查看cuDNN版本(如果可用)
    print("cuDNN版本:", torch.backends.cudnn.version())
 
else:
    print("CUDA不可用。")
CUDA可用!
可用的CUDA设备数量: 1
当前使用的CUDA设备索引: 0
当前CUDA设备的名称: NVIDIA GeForce RTX 2060 SUPER
CUDA版本: 12.1
cuDNN版本: 90100

@浙大疏锦行 


VASP+Multiwfn+VMD静电势计算与可视化全流程解析 静电势是表征分子与材料表面电荷分布的关键物理量,它通过求解泊松方程,将电子密度与原子核电荷在空间中的贡献结合起来,直观揭示体系的电子富集与缺失区域。这一性质在理解化学反应活性、分子间相互作用(如氢键、卤键)以及材料表面性质方面具有重要价值。在计算材料科学与量子化学领域,基于第一性原理计算获得高精度电子结构数据后,如何将其转化为可直观分析的静电势图,是连接理论计算与物理解释的关键技术环节。本文聚焦于构建一条高效、可控的端到端工作流,详细解析如何利用VASP进行高精度电子密度计算,通过专业波函数分析软件Mult 阅读详情

相关推荐

别再为数据发愁:5分钟理解事件相机原理,并自己动手生成事件图像

本文深入浅出地解析了事件相机的工作原理,并提供了从静态图像生成事件数据的实用方法。通过Python代码示例,读者可以快速掌握如何模拟事件相机的输出,应用于机器人导航、自动驾驶等领域,解决数据获取难题。

weixin_31458015的博客 300

python打卡训练营打卡记录day34

知识点回归CPU性能的查看看架构代际核心数线程数GPU性能的查看看显存看级别看架构代际GPU训练的方法数据和模型移动到GPUdevice上类的call方法为什么定义前向传播时可以直接写作self.fc1(x)作业:复习今天的内容,在巩固下代码。思考下为什么会出现这个问题。检查CUDA是否可用。

yorushika_的博客 1449

保姆级教程:手把手教你为STM32F407和W25Q128制作Keil MDK的SPI Flash下载算法(FLM文件)

本文提供了一份详细的教程,指导开发者如何为STM32F407和W25Q128制作Keil MDK的SPI Flash下载算法(FLM文件)。从理解下载算法的核心机制到实现FlashPrg.c的核心操作,再到链接脚本与地址映射实战,手把手教你完成定制化SPI Flash下载算法的开发与优化。

weixin_28716769的博客 408

Python打卡训练营day34

【代码】Python打卡训练营day34。

weixin_70153780的博客 952

matlab 用m_map画地形水深图

clear,clc %投影 m_proj('albers equal-area','lat',[5 43],'long',[105 125],'rect','on'); %加载水深文件 [CS,CH]=m_etopo2('contourf',[-7000:500:3000],'edgecolor','none'); %绘制高分辨率陆地和海岸线 m_gshhs_h('patch',[0.1 0.9 ...

qq_44913577的博客 9513

19-5 ACC 自适应巡航控制系统需求

本专题由深圳季连AIgraphX李博及团队出品,主要讲解ACC自适应巡航控制系统的开发与仿真测试。具体说来,包括ACC标准/法规分析、系统需求、系统架构、软件需求、软件架构、算法建模、验证场景分析、仿真实验搭建等内容。 本节主要讲ACC系统需求。

AIgraphX 1090

Python训练营打卡Day34

4.类的call方法:为什么定义前向传播时可以直接写作self.fc1(x)3.GPU训练的方法:数据和模型移动到GPU device上。1.CPU性能的查看:看架构代际、核心数、线程数。2.GPU性能的查看:看显存、看级别、看架构代际。DAY 34 GPU训练及类的call方法。

m0_70431145的博客 473

解析 RABAX during SAPGUI Logon 错误及其解决方案

登录用户关联了初始启动程序,该程序由于未处理的异常导致运行时错误。在 ST22 查看错误的程序名和错误行。修复初始程序代码中的逻辑问题。重新部署修复后的代码。示例代码:防止未处理的异常TRY." 模拟逻辑处理ENDTRY.此代码通过 TRY-CATCH 块捕获潜在错误,避免程序崩溃。是 SAP 系统中常见的运行时错误,其根源可能涉及多个方面,包括用户配置、系统状态、数据库连接和自定义开发等。通过结合 ST22、SM21 等诊断工具,以及完善的代码实践和系统监控,可以有效预防和解决此类问题。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1781

Python训练营打卡DAY34

本文主要回顾了GPU训练和类的call方法的相关知识点。首先,介绍了如何查看CPU和GPU的性能,包括架构代际、核心数、线程数、显存等。接着,详细说明了GPU训练的方法,即将数据和模型移动到GPU设备上。此外,解释了在定义前向传播时可以直接使用self.fc1(x)的原因。文章还通过代码示例展示了如何检查CUDA的可用性、获取CUDA设备信息、加载数据集、归一化数据、将数据转换为PyTorch张量并移至GPU、定义和训练模型等操作。最后,通过可视化损失曲线展示了训练过程中的损失变化。

2502_91094213的博客 467

2026华为OD机试真题 9月27日 新系统 【均衡调度】

华为OD机试真题 新系统 9月27号【均衡调度】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题 【均衡调度】多语言题解。

qq_45776114的博客 1769

如何在 SAP BTP 上使用 Integration Suite 消费 S/4HANA Cloud API

SAP Integration Suite是一个集成平台即服务(iPaaS),允许开发人员顺利地将内部部署和基于云的应用程序和流程与SAP管理的工具和预构建内容进行集成。登录 SAP Business Technology Platform Cockpit,进入 integration suite:再点击 API management 进入 API Portal:或者直接从收藏夹里打开链接:https://304a49cetrial.integrationsuitetrial-apiportal.cfapp

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1699

Python打卡训练营Day34

【代码】Python打卡训练营Day34。

2401_89104459的博客 207

《Python入门到精通》函数详解

函数就是一段「封装」起来的「代码」,目的是提高代码的「模块性」和「复用性」。 2、函数的参数 2.1、变量的就近原则 2.2、传递参数 2.3、形参和实参 2.4、位置参数 2.5、缺省参数 2.6、可变类型和不可变类型 2.7、关键字参数 3、匿名函数 4、函数的返回值

wangyuxiang946的博客 1万+

【Python训练营打卡】day34 @浙大疏锦行

DAY 34 GPU训练及类的call方法知识点回归:1.CPU性能的查看:看架构代际、核心数、线程数2.GPU性能的查看:看显存、看级别、看架构代际3.GPU训练的方法:数据和模型移动到GPU device上4.类的call方法:为什么定义前向传播时可以直接写作self.fc1(x)作业复习今天的内容,在巩固下代码。思考下为什么会出现这个问题。

2301_77865880的博客 394

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Python打卡训练营day34——2025.05.23

【代码】Python打卡训练营day34——2025.05.23。

hans041113的博客 177

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Python 训练营打卡 Day 34

综上,数据传输和各种固定开销的总和,超过了 GPU 在这点计算量上通过并行处理所能节省的时间,导致了 GPU 比 CPU 慢的现象。在上述代码中,循环里的 loss.item() 操作会在每个 epoch 都进行一次从 GPU 到 CPU 的数据同步和传输,以便获取标量损失值。与day33采用的CPU训练不同,今天试着让模型在GPU上训练,引入import time比较两者在运行时间上的差异。经试验,思路一去除图片打印部分的情况下训练时间为:36.77s,思路二改变保存间隔情况下的训练时长为:44.6s。

2401_86382089的博客 732

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

python打卡训练营打卡记录day16

因为前天说了shap,这里涉及到数据形状尺寸问题,所以需要在这一节说清楚,后续的神经网络我们将要和他天天打交道。numpy数组的创建:简单创建、随机创建、遍历、运算。numpy数组的索引:一维、二维、三维。SHAP值的深入理解。

m0_74839150的博客 191

Python训练营打卡Day34-模型可视化与推理

知识点回顾:三种不同的模型可视化方法:推荐torchinfo打印summary+权重分布可视化进度条功能:手动和自动写法,让打印结果更加美观推理的写法:评估模式作业:调整模型定义时的超参数,对比下效果。一、模型结构可视化理解一个深度学习网络最重要的2点:1. 了解损失如何定义的,知道损失从何而来——把抽象的任务通过损失函数量化出来2. 了解参数总量,即知道每一层的设计才能退出---层设计决定参数总量为了了解参数总量,我们需要知道层设计,以及每一层参数的数量。

m0_60783025的博客 772

Python训练营打卡Day34(2025.5.23)

类的call方法:为什么定义前向传播时可以直接写作self.fc1(x)GPU训练的方法:数据和模型移动到GPU device上。CPU性能的查看:看架构代际、核心数、线程数。GPU性能的查看:看显存、看级别、看架构代际。

2301_80505456的博客 285

Python 训练营打卡 Day 34-GPU训练及类的call方法

在 Python 中,__call__ 方法是一个特殊的魔术方法(双下划线方法),它允许类的实例像函数一样被调用。将当前损失值(loss.item())添加到losses列表中,用于后续绘制损失曲线。call方法无参数的情况下,在实例化之后,每次调用实例时触发 __call__ 方法。这种模式在深度学习训练中很常见,既满足实时监控需求,又优化了资源使用。4. 这种设计既保证了定期记录损失值,又提供了更频繁的训练状态反馈。类名后跟(),表示创建类的实例(对象),仅在第一次创建对象时发生。

weixin_57577876的博客 449

Python打卡训练营-Day34-GPU训练及类的call方法

知识点回顾CPU性能的查看:看架构代际、核心数、线程数GPU性能的查看:看显存、看级别、看架构代际GPU训练的方法:数据和模型移动到GPU device上类的call方法:为什么定义前向传播时可以直接写作self.fc1(x)ps:在训练过程中可以在命令行输入nvida-smi查看显存占用情况作业复习今天的内容,在巩固下代码。思考下为什么会出现这个问题。

m0_68919205的博客 310

Python训练营打卡Day25(2025.5.14)

在即将进入深度学习专题学习前,我们最后差缺补漏,把一些常见且重要的知识点给他们补上,加深对代码和流程的理解。try-except-else-finally机制。debug过程中的各类报错。try-except机制。

2301_80505456的博客 174

【DAY34】GPU训练及类的call方法

内容来自@浙大疏锦行python打卡训练营知识点:CPU性能的查看:看架构代际、核心数、线程数GPU性能的查看:看显存、看级别、看架构代际GPU训练的方法:数据和模型移动到GPU device上类的call方法:为什么定义前向传播时可以直接写作self.fc1(x)ps:在训练过程中可以在命令行输入nvida-smi查看显存占用情况作业复习今天的内容,再巩固下代码。思考下为什么会出现这个问题。首先回顾下昨天的内容,我在训练开始和结束增加了time来查看运行时长。

daomingwu1的博客 987

AI全栈实战 | 3.9-01 爬虫入门:requests 加 BeautifulSoup 三分钟跑通,但 90% 的人栽在这 4 个“礼貌“问题上

⚠️:本文内容仅用于。请遵守目标站点的服务条款与相关法律法规,不得对目标服务造成负担,不得采集、传播个人隐私数据。技术是中性的,边界在你手里。爬虫的入门技术(requests 发请求 + BeautifulSoup 解析)三分钟就能学会。真正区分"会用爬虫"和"会做爬虫的人"的,是这篇我们跑通"请求→解析→存储"的最小闭环,然后重点把"合规与礼貌"这根弦给你绷上。

源码获取 | 运行部署 | 定制二开修改,如果回复不及时请耐心等待,请见谅。 421

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 237

【每天一个 Python 小案例30】Python 基础知识综合小项目:我的工具盒

作为系列收官,本篇把前 29 篇的知识点合成一个能直接用的命令行工具"我的工具盒":计算器(用 ast 解析表达式,不碰 eval)、单位换算与温度转换(一张换算表 + 特例分支)、记账与分类统计(Decimal + JSON 持久化)、以及用"字典当命令表"把菜单和业务逻辑解耦的主循环。文中对比了 eval 的安全隐患与 ast 白名单的做法,解释了 lambda 闭包在字典里的写法与晚绑定陷阱,并在最后给出整个系列的知识地图,把变量、数据结构、控制流、函数、类、异常、文件、标准库八块内容对应到具体篇目。

xinjiyaya的博客 427
上一篇: Python打卡训练营学习记录Day33
下一篇: Python打卡训练营学习记录Day35
FanfanPyt
博客等级 码龄2年 82粉丝 50原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值