Laravel chunk与chunkById避坑指南

Laravel 大数据量分块处理 chunk() 的用法 有时,我们可能会一次性查出很大的结果集(上万条记录),这样就很可能导致内存溢出。 Laravel 框架的 chunk() 方法,可以将数据分块,每次只查询指定数量的数据块,交给回调函数处理。从而在处理大量数据集合时,能够有效减少内存消耗。 User::where('status', 0)->chunk(100, function ($users) { ... 阅读详情
AI摘要

本文介绍了Laravel中chunk和chunkById在处理MySQL数据时的区别,尤其是在涉及分组和求和操作时。chunk会导致全表聚合分批取数据,而chunkById会忽略部分数据,影响统计准确性。在复杂业务场景中需谨慎选择使用方法。

一、介绍

大家在日常开发过程中,在处理mysql数据时,肯定会遇到分块、分批次处理数据。在Laravel中提供了 chunk 与 chunkById ,可以使我们专注处理数据逻辑。

二、用法
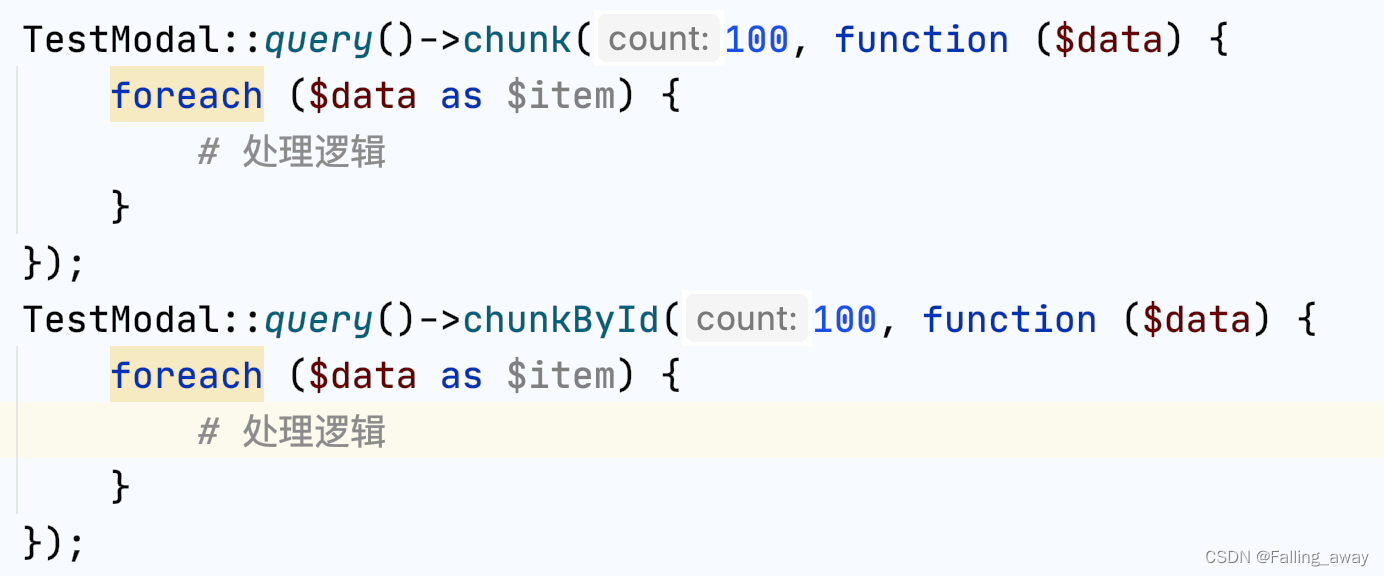
在用法上,可以看到两者没有区别。

三、区别

1、使用chunk时生成的sql

# 第一次
select * from `test` order by `id` asc limit 100 offset 0;

# 第二次
select * from `test` order by `id` asc limit 100 offset 100;

# 第三次
select * from `test` order by `id` asc limit 100 offset 200;

2、使用chunkById时生成的sql

# 第一次
select * from `test` order by `id` asc limit 100;

# 第二次
select * from `test` where `id` > 100 order by `id` asc limit 100;

# 第三次
select * from `test` where `id` > 200 order by `id` asc limit 100;

3、我们可以看到在全表处理时,两者sql虽格式不同,在处理全表数据并无特别大的区别。

四、避坑(重点来了)

相信每个公司的业务并不可能这么简单,只通过全表查询就完成业务。

当我们在程序中加入 分组(group by) 、字段求和(sum)等处理函数,就会发现 chunk 和 chunkById 两者本质上的区别。

1、使用chunk + group by + sum(字段)时生成的sql

# 第一次
select `name`, sum(`amount`) from `test` group by `name` order by `id` asc limit 100 offset 0;

# 第二次
select `name`, sum(`amount`) from `test` group by `name` order by `id` asc limit 100 offset 100;

# 第三次
select `name`, sum(`amount`) from `test` group by `name` order by `id` asc limit 100 offset 200;

2、使用chunkById + group by + sum(字段)时生成的sql

# 第一次
select `name`, sum(`amount`) from `test` group by `name` order by `id` asc limit 100;

# 第二次
select `name`, sum(`amount`) from `test` where `id` > 100 group by `name` order by `id` asc limit 100;

# 第三次
select `name`, sum(`amount`) from `test` where `id` > 200 group by `name` order by `id` asc limit 100;

3、通过生成的sql,我们可以看到一个本质上的区别。

我们会发现:

  • chunk生成的sql,是全表聚合,在聚合完成后分批取数据。
  • 而反观chunkById生成的sql,出现了where条件,这就会导致sql每次执行都会抛弃小于当前id的数据。

导致的后果:

  • 使用 chunk + group by 统计的 sum(`amount`) 是准确无误的。
  • 而使用 chunkById + group by 统计的sum(`amount`) 是错误的。

五、总结

当我们在日常开发过程中,在使用到chunk、chunkById时,如果只是简单的全表查询处理数据,两者并无无别。

当我们的业务场景比较复杂,需要用到group by、sum等函数时,切记:

使用chunk!!!

使用chunk!!!

使用chunk!!!

Laravel Eloquent 更新的6种方式与选型指南 Eloquent 更新不是简单的 SQL 封装,而是涉及模型状态机、生命周期钩子、脏数据检测和事务安全的复合操作。理解 `save()` 与 `update()` 的本质差异——前者触发事件、校验白名单、执行脏字段检测,后者直连数据库、绕过所有 ORM 层逻辑——是避免数据不一致与安全漏洞的关键。在高并发、批量处理、队列更新等典型场景中,需权衡性能(如 `where()->update()` 耗时仅1.8ms)、一致性(是否需 Observer 响应)、幂等性(`upsert()` 依赖唯一索引)与可审计性 阅读详情

相关推荐

Laravel中的chunk组块结果集处理与注意问题

前言 如果你需要处理成千上万个 Eloquent 结果,可以使用 chunk 命令。chunk 方法会获取一个“组块”的 Eloquent 模型,并将其填充到给定闭包进行处理。使用 chunk 方法能够在处理大量数据集合时能够有效减少内存消耗: Flight::chunk(200, function ($flights) { foreach ($flights as $flight) { // } }); $all_ark=Arkvolume::chunk(50000, function ($flights) { foreach ($flights as $flight) {

Laravel chunk和chunkById的坑

数据库引擎为innodb。表结构简述,只列出了本文用到的字段。字段类型注释idint(11)IDtypeint(11)类型mark_timeint(10)标注时间(时间戳)索引,也只列出需要的部分。索引名字段PRIMARYidmark_time使用 chunkById 或者 chunk 方法的时候不要添加自定义的排序,chunk和chunkById的区别就是chunk是单纯的通过偏移量来获取数据,chunkById进行了优化,不使用偏移量,使用id过滤,性能提升巨大。

Gan_1314的博客 1436

野火STM32F407(骄阳)+无刷直流驱动板+永磁同步电机控制学习记录(四)(基于HAL库)

以上内容都是参考别人资料自学的,很多地方都是凭感觉,因为理论部分不太会算,只要电机能转就行,其他性能指标都没考虑,因为不会,所以这纯属是学习记录帖。带宽在500时,电流波动小,但是响应很慢,就是堵转后不太容易恢复转动。速度环带宽设定小了,响应不够快,带宽设定大了波动比较大,电机感觉起来也震一点,而且,当带宽设到200的时候,启动直接就锁死了,应该是PI增益设定太大了。电流环带宽的试验:去掉速度环,让Iq_Set=2,Ud=0,此时电机是电流环闭环控制,用手堵转电机然后松开,看电流的波动以及响应情况。

XUEXIDEXIAOhai的博客 4553

Laravel chunk 分块 以及存在的一些坑

Laravel中chunk方法分块处理数据 Let’s imagine the situation: you have a big database table (like 10 000 rows or bigger) and you need to run an update to one column. But you cannot run just SQL query – there is...

曾沂宏的博客 7608

PlutoSDR驱动安装避坑指南:从设备管理器异常到MATLAB 2023b完美识别

本文是一份详细的PlutoSDR驱动安装与MATLAB 2023b集成排错指南。针对Windows系统下常见的设备管理器异常、驱动兼容性问题,提供了从旧驱动清理、手动指定驱动文件到USB连接稳定性排查的完整解决方案。重点阐述了如何通过离线安装硬件支持包,并利用MATLAB命令进行连接测试与射频信号验证,最终实现设备的完美识别与稳定调用。

weixin_29159441的博客 428

LLC混合滞回控制 vs 电压模/电流模:UCC25640x仿真对比与选型指南

在开关电源设计中,LLC谐振变换器的环路补偿是核心难点。传统电压模控制(VMC)和电流模控制(CMC)在LLC拓扑上存在环路增益漂移、动态响应慢等局限。混合滞回控制通过滞回比较器直接调制开关频率,并融合输出电压与谐振腔电流信息,实现了自适应环路增益和快速瞬态响应。该技术显著提升轻载效率与动态性能,适用于高密度适配器、快充及车载充电机等场景。本文基于UCC25640x系列,通过仿真对比三种控制策略,为工程选型与调试提供实践参考。

weixin_33925615的博客 334

laravel 查询数量大分配查询修改数据 chunkById

chunkById

weixin_42136237的博客 868

BeckHoff <--> ABB 机器手 Profinet 通讯

本文介绍了BeckHoff PLC与ABB机器人通过PROFINET通信的实现方案。主要内容包括:1)通信接口的详细变量定义,涵盖输入/输出信号、设备状态监控、夹爪控制等关键功能位;2)全局数据结构和变量配置说明;3)机器人任务控制程序的实现方法,包括参数校验、任务指令下发和状态监控机制;4)重点分析了任务调度功能块的代码逻辑,涉及慢速模式处理、多参数配置和执行状态判断。该方案通过结构化变量定义和模块化程序设计,实现了PLC对机器人作业的精确控制,为工业自动化系统集成提供了可靠通信范例。

工控智联驿站 1032

Laravel使用 chunkById 替代 chunk的庖丁解牛

/ 使用 created_at 作为游标列(需确保唯一或配合 ID)// ...created_at// 更安全:WHERE (created_at, id) > (?) —— 但 Laravel 不直接支持 // 此时建议用原生游标或分库分表中间件chunkById。

长风破浪会有时的博客 761

一文读懂资管系统里的“清算路径”:钱和券的“导航地图”

简单来说,清算路径就是给每一笔交易预设好的“导航路线”。钱从哪个银行账户出?通过哪家证券公司去买?用哪个股东账户去登记?买回来的股票记在谁的名下?“清算路径”就是把这一连串问题的答案提前配置好。它连接了银行托管户(钱的源头)、券商(交易的中介)和交易所(买卖的市场)。没有配好这条路,交易就无法闭环。清算路径是金融基础设施的缩影。资金如何安全地从银行流向市场;资产如何合法地归属到产品名下;交易数据如何在不同系统间流转。它是资管系统能够日复一日、准确无误地处理亿万级交易的基石。

m0_37607945的博客 236

《遥感大模型生产级实战:从数据到决策的端到端AI工程》系列第一部分:AI遥感工程师的基础设施与工具链-文章 4:传统遥感分析与机器学习基线

本章将系统性地介绍经典遥感分析工作流,从数据预处理到多维度特征工程,再到如何利用经典的机器学习模型(如随机森林、支持向量机)进行监督与非监督学习。我们将通过一个完整的“智慧农业作物分类”项目实战,展示如何利用我们之前构建的数据湖和工具链,从原始数据到最终的分析结果,构建一个性能可靠、可解释性强的基线系统。更重要的是,我们将深入剖析这种传统方法的局限性,从而为后续章节引入遥感大模型的必要性提供强有力的论证。

panshengwu的博客 705

Laravel chunk 不使用id

写于2020-01-06 PHP/LARAVEL 12 分钟 读完 (大约 1837 个字)339次访问 Laravel chunk和chunkById的坑 公司中的项目在逐渐的向Laravel框架进行迁移。在编写定时任务脚本的时候,用到了chunk和chunkById的API,记录一下踩到的坑。 一、前言 数据库引擎为innodb。 表结构简述,只列出了本文用到的字段。 字段 类型 注释 id int(11) ID type int(11) ...

qiuziqiqi的博客 785

VScode+MPLAB AI助手:Microchip MCU开发全流程实战解析

本文详细解析了如何使用VScode搭配MPLAB AI助手进行Microchip MCU开发的完整流程。从环境配置、工程创建到代码生成与调试,全面介绍了AI助手在提升开发效率、优化代码和故障排除方面的实际应用,为嵌入式开发者提供了一套高效的开发解决方案。

hh234的博客 1131

Laravel中chunk方法分块处理数据

在一些情况下,我们需要对大批量的数据进行操作,如果这个时候我们使用foreach的话,很可能会遇到操作超时的情况。在Laravel框架中我们可以很方便的使用chunk方法来解决。来看一个简单的例子:$users = User::all(); foreach ($users as $user) { $some_value = ($user->some_field > 0) ? 1 ...

weialemon 4726

【kafka】控制台默认不能发送大数据 4096 4095 4129

1.概述 因为某些原因,需要做一个测试,然后我想往topic中,发送一条消息,然后再消费它。但是消息有点大,一条消息是36K. 消费者 [root@1 kafka]# bin/kafka-console-consumer.sh --zookeeper localhost:2181 --topic xxx.devicealarm | grep 网络攻击 生产者,生产者发送了一个消息消息是一个json,json中有这个数据特征 网络攻击 [root@1 kafka]# bin/kafka-console-p

九师兄 586

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

laravel chunkById导出数据乱序问题

发现导出的数据是乱的,偶尔有些重复,偶尔有些少了,很奇怪,把数据打印出来的时候,发现模型的主表的id是乱序的。这几天在做数据导出优化,使用xlswriter作为导出组件,但是发现在 使用。所以说,主表的id是 主键,但是返回的id是乱序,导出的数据就是乱的,这里使用chunk方法是使用forpage。所以可以避免导出数据混乱的问题,这里使用。2025年7月28日17:47:29。查看了一下chunkById的代码。

Z.X的博客 333

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

如何在 Laravel 中处理大型数据集而不耗尽内存

然而,laravel 提供了一些有用的方法来帮助您以较小的块处理数据,从而节省内存并使应用程序运行得更快。通过使用这些方法,您可以确保您的 laravel 应用程序有效地处理大型数据集,即使在处理数百万条记录时也是如此。chunkbyid() 方法与 chunk() 类似,但在处理记录时更新记录时效果更好。您可以使用 chunk() 一次加载 100 个订单并以较小的批次处理它们,而不是一次将所有订单加载到内存中。假设您想要更新订单的状态,但您还需要确保订单 id 按顺序处理。允许您一条一条地处理记录。

842

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

laravel-orm

protected $dateFormat = 'U'; //为时间戳 const CREATED_AT = 'time1'; //更新列为指定列 const UPDATED_AT = 'updated_at'; protected $connection = 'mysql1'; //连接另外数据库 对应datasebase里面的配置 protected $attributes = [ //给列一个默认值 'time1' => '2021-10-19', ]; #

channel)海峡的博客 614

laravel excel分块导入_让 Laravel Scout 导入提速 64 倍

文章转发自专业的Laravel开发者社区,原始链接:https://learnku.com/laravel/t/26935下一个版本的 Laravel Scout 将会使你的模型查询速度提升64倍。 我使用null scout 驱动测试了一张包含 1,632,576条数据的表。消耗的时间从过去的29分57秒缩短到了28秒。 ^[返回原文]^你能在这里 查看提交的 pull request.这篇文...

weixin_39796652的博客 495

Coolify 项目中的 Laravel 数据库查询性能实践指南:从 N+1 到亿级数据的 Eloquent 优化全解

数据库查询是 Laravel 后端([Coolify](https://link.gitcode.com/i/1b90be00066aea2c111d680c2cf904b5) 亦不例外)最容易出现性能瓶颈的环节,其中 N+1 问题、全表 `SELECT *`、一次性加载海量数据集等反模式会随资源规模增长迅速放大为延迟与内存灾难。本指南以 [db-performance.md](https://l

gitblog_00325的博客 1012

Coolify 实战:Laravel 数据库性能优化最佳实践(从 N+1、大数据集遍历到索引设计)

> 数据库往往是自托管 PaaS 这类长时间后台作业密集的应用最容易先"卡脖子"的环节。Coolify 作为一个部署应用、数据库与 280+ 一键服务的开源 PaaS,其数据模型横跨用户、团队、项目、环境、服务器、部署队列与各类数据库实例,查询是否高效直接决定管理面板与后台 Job 的响应速度。本文以仓库内 [.claude/skills/laravel-best-practices/rules/

gitblog_00516的博客 690

【154.1】laravel 查询构造器

分块结果 如果你需要处理上千条数据库记录,你可以考虑使用 chunk 方法。该方法一次获取结果集的一小块,并将其传递给 闭包 函数进行处理。该方法在 Artisan 命令 编写数千条处理数据的时候非常有用。例如,我们可以将全部 users 表数据切割成一次处理 100 条记录的一小块: DB::table('users')->orderBy('id')->chunk(100, function ($users) { foreach ($users as $user) {

米洛口的博客 944

Coolify 仓库中的 Laravel 最佳实践技能:19 类规则体系与源码印证指南

Coolify 是一个基于 Laravel 构建的开源自托管 PaaS,其仓库中内置了一套完整的 AI 辅助开发技能文件 [.agents/skills/laravel-best-practices/SKILL.md](https://link.gitcode.com/i/6ba6e7461de4eddf3e581110a7cc8aa1),系统性地总结了 19 大类 Laravel 后端最佳实践。

gitblog_00990的博客 980

Laravel Collection 最佳实践:高阶消息、cursor/lazy 与 toQuery 的批量数据处理指南——结合 Coolify 源码实例

Eloquent Collection(集合)是 Laravel 日常开发中使用频率最高的数据类型之一,也是 N+1 查询、内存峰值、批量更新错乱等经典问题的高发地带。本文以仓库内 Laravel 最佳实践规则文档 [collections.md](https://link.gitcode.com/i/52e2d30a36dff245218b5334e9bdb408) 为核心骨架,逐条讲解其五大实

gitblog_00063的博客 649

User::chunk(200, function ($users) {处理大数据集时使用分块查询,避免一次性加载到内存

的核心价值是:将全量数据的内存加载拆分为多个小批次,每批处理完即释放,从而将内存峰值控制在合理范围。⚠️但它仍会将每一批数据加载到内存(不可避免),且存在 OFFSET 性能与数据一致性风险。🔧在自增 ID 场景下,chunkById是更安全、更高效的选择。

长风破浪会有时的博客 930

Laravel cursor内存泄漏?PDO::ATTR_EMULATE_PREPARES的隐藏陷阱与解决方案

本文深入探讨了Laravel中cursor方法导致的内存泄漏问题,揭示了PDO::ATTR_EMULATE_PREPARES参数的隐藏陷阱。通过分析原生预处理与模拟预处理的机制差异,提供了多种优化策略,包括配置调整、分块处理方案和架构层面的深度优化,帮助开发者高效处理百万级数据。

weixin_29309213的博客 402
上一篇: 统计APP下载量--发现安卓下载大文件使用多线程下载方式
Falling_away
博客等级 码龄7年 14粉丝 7原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值