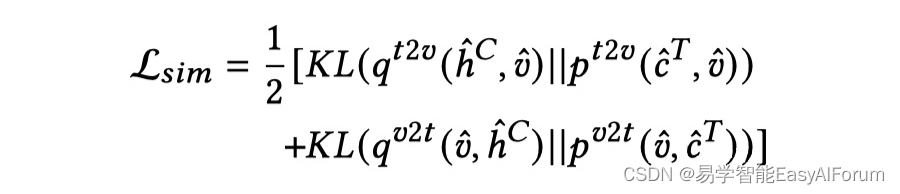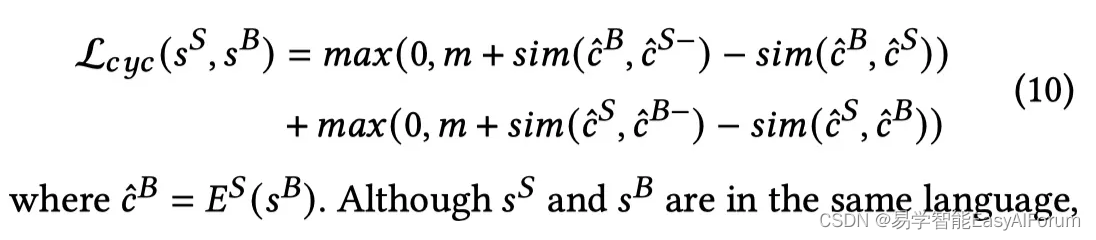
ACM MM 2022 | 首个针对跨语言跨模态检索的噪声鲁棒研究工作

Altium Designer系列: 软件系统参数配置保存 【Altium Designer实践】 软件系统参数配置保存 作者 CodeAllen ,转载请注明出处 目录设置中文菜单高亮模式设置文件关联pcb设置布线设置保存配置文件(复用) 设置中文菜单 DXP->Preferences 高亮模式设置 文件关联 pcb设置 布线设置 保存配置文件(复用) ...... 阅读详情


论文标题:Cross-Lingual Cross-Modal Retrieval with Noise-Robust Learning

文章链接:https://arxiv.org/pdf/2208.12526.pdf

代码链接:https://github.com/LiJiaBei-7/nrccr

虽然目前传统的跨模态检索工作已取得了巨大的进展,但由于缺少低资源语言的标注数据,这些工作通常关注于高资源语言(比如英语),因此极大地限制了低资源语言在该领域的发展。为了解决这一问题,作者针对跨语言跨模态检索任务(CCR)展开了研究,该任务旨在仅使用人工标注的视觉-源语言(如英语)语料库对模型进行训练,使其可以适用于其他目标语言(非英语)进行评估。如下图所示。
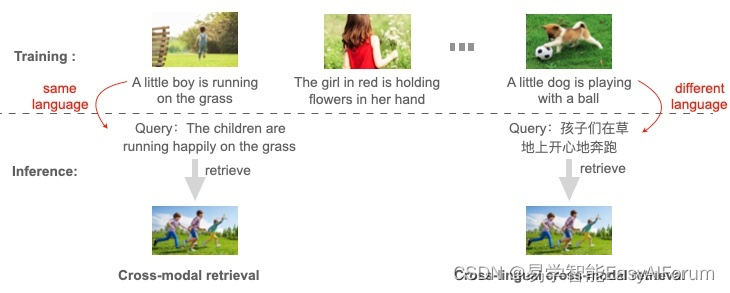
▲ 传统跨模态检索&跨语言跨模态检索(CCR) 

在这篇论文中,作者旨在借助机器翻译来生成伪视觉-目标语言对进行跨语言迁移,来缓解人工标注多语言视觉-语言语料库困难的问题。虽然机器翻译可以快速的处理大量的文本语言转换,但是其准确性并不能得到保证,因此在翻译过程中将会引入大量的噪声,导致翻译的目标语言句子并不能准确的描述其对应的视觉内容【如下图所示】。


▲ 翻译错误的示例图

然而之前的基于机器翻译的 CCR 工作大多忽略了这个问题,它们通常使用大规模的预训练模型在通过机器翻译得到的大规模多语言视觉-语言语料库上进行大规模预训练,并且只关注于视觉-目标语言数据对之间的对齐。然而直接在这种噪声数据对上应用跨模态匹配将会严重影响检索性能,神经网络模型有很强的能力来拟合这种给定的(噪声)数据。为了解决这个问题,作者提出了一个噪声鲁棒学习方法来缓解机器翻译中所引入的噪声问题,该论文是首个关注于 CCR 任务中由机器翻译所引入噪声问题的工作。

1

『方法』
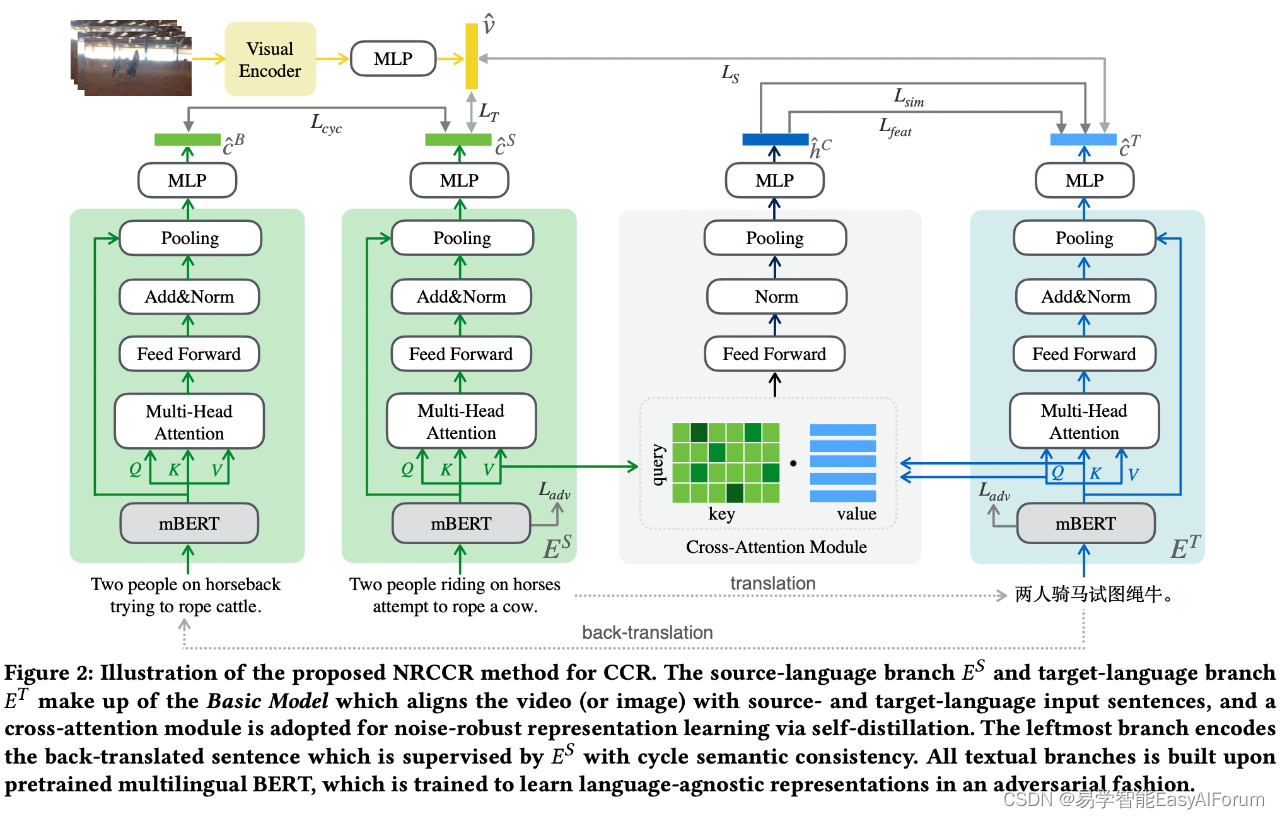
 

▲ 模型框架图

作者首先引入了其基线模型,继而引入噪声鲁棒学习方法。

1.1 基线模型(Basic Model)

视觉编码器:给定一个视频,使用预训练的 2D CNN 来提取视频特征序列,然后输入到 Transformer 块中,来增强帧间交互,最终得到一个视频特征向量。
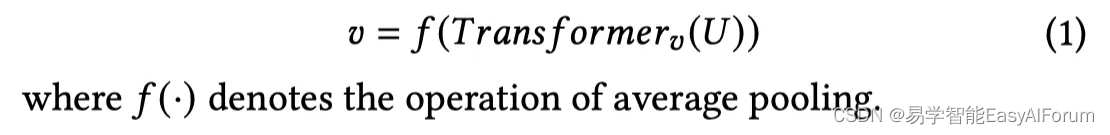
 

文本编码器:作者设计了一个双分支编码器,分别又一个源语言分支和一个目标语言分支组成。每个语言分支都包含一个 Transformer block 和一个预训练的 mBERT backbone,将源语言和目标语言分别输入到对应的分支中,得到对应的源语言句子特征和目标语言句子特征。
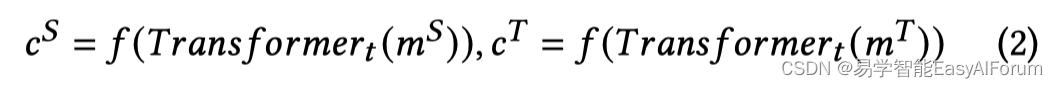
 

将以上三个特征分别映射到多语言多模态空间中:
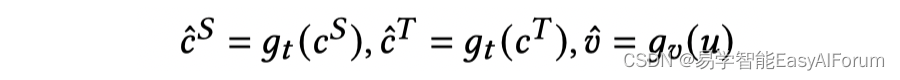
作者使用了传统的跨模态检索任务中常用的 triplet ranking loss 进行约束:
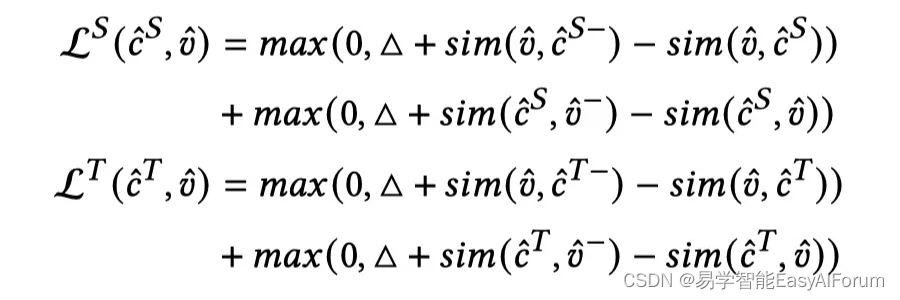


1.2 噪声鲁棒的特征学习(Noise-Robust Representation Learning)

基线模型只是简单的进行了跨语言跨模态对齐,并没有对噪声进行处理,接下来作者提出了多视图自蒸馏来生成 soft pseudo-tagets 以监督目标语言分支的学习。

作者首先借助于 cross-attention 来生成一个相对干净的中间目标语言句子特征,通过将源语言 token 序列作为 query,利用 cross-attenion 固有的性质,对目标语言 token 序列进行过滤。
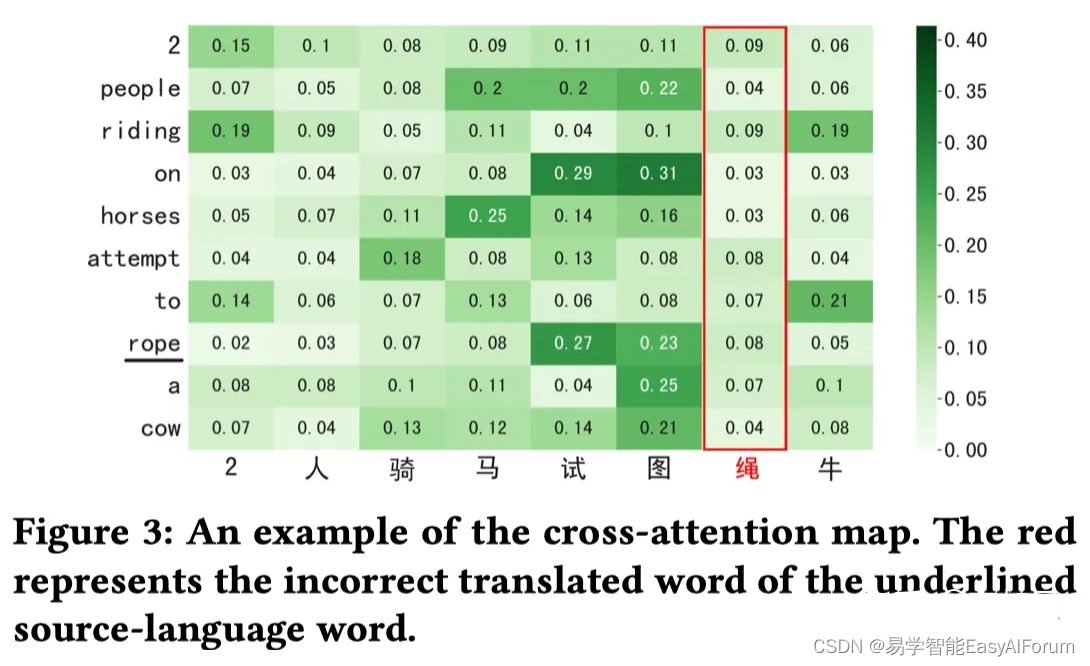
 

▲ cross-attention 权重示例图

如图 3 所示,错误的单词(用红色标记)和源语言单词之间的注意权重被分配了低值。其过程表示如下:
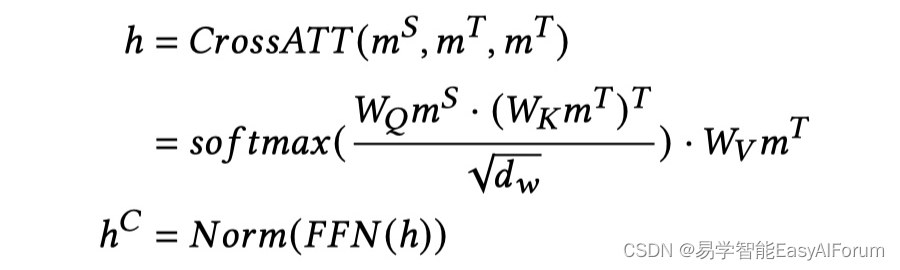
 

1.3 多视角自蒸馏(Multi-view self-distillation)

作者引入了基于相似度视角和基于特征视角的自蒸馏损失。基于相似度视角的自蒸馏(Similarity-based view):给定(V, S, T),默认其两两之间互为匹配对,忽视翻译得到的目标语言句子 T 中所包含噪声的事实。对此,作者将 cross-attention 所生成的特征h_c 作为 teacher,使用特征h_c 和视觉特征计算v 计算得到 soft pseudo-targets 作为目标语言分支的监督。
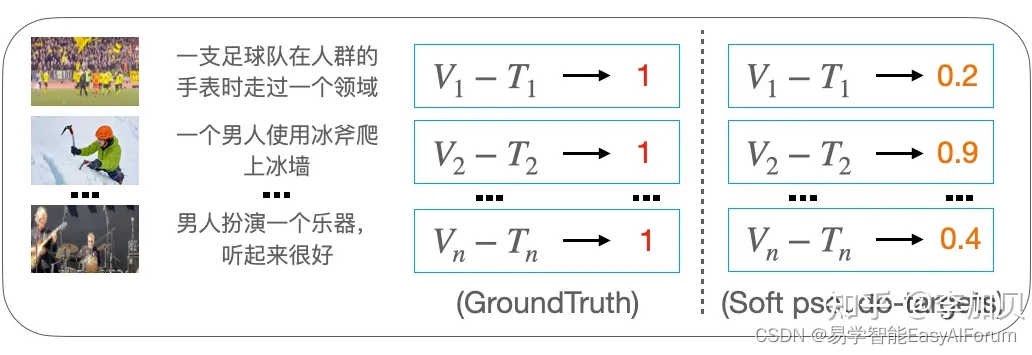
 

▲ soft pseudo-targets示例图
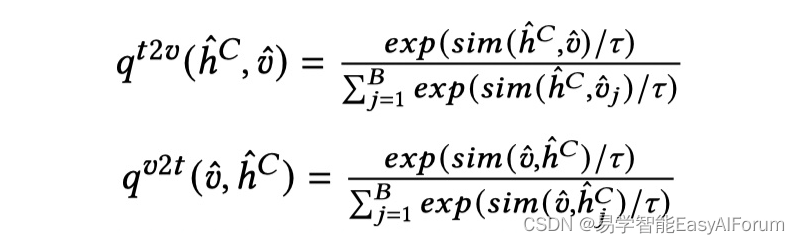


基于特征视角的自蒸馏(Feature-based view):通过 l1 范式实现特征蒸馏:
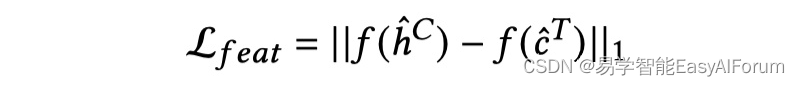
 

1.4 循环语义一致性(Cycle Semantic Consistency)

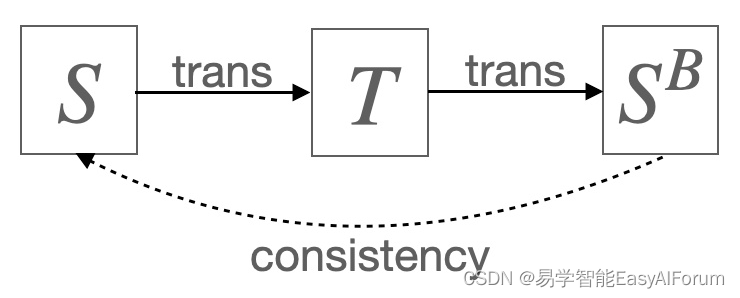
受无监督机器翻译的启发,作者引入了循环语义一致性模块,提高源语言分支从噪声中提高原始语义信息的能力,增加源语言分支的鲁棒性。


1.5 语言无关特征学习(Language-agnostic Representation Learning):

考虑到特定语言特征缺少跨语言迁移能力,作者通过对抗学习的方式来训练模型学习语言无关特征。构建一个分类器 F 作为判别器来分辨输入特征是源语言还是目标语言,判别器和特征编码器相互博弈:
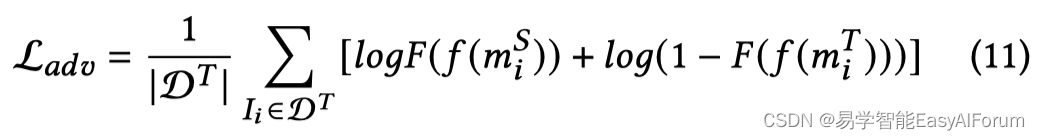
 

1.6 训练和测试

最终的目标函数为:
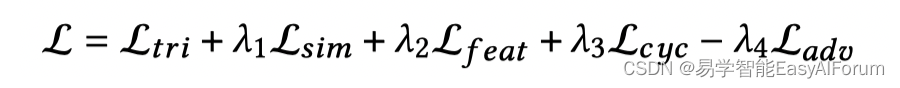
 

测试时作者采用了目标语言和翻译的源语言(由于测试时只使用目标语言)加权和的方式:
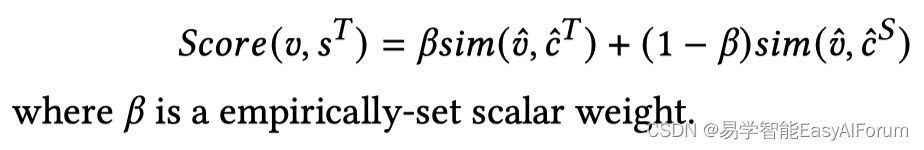
 

2

『实验』

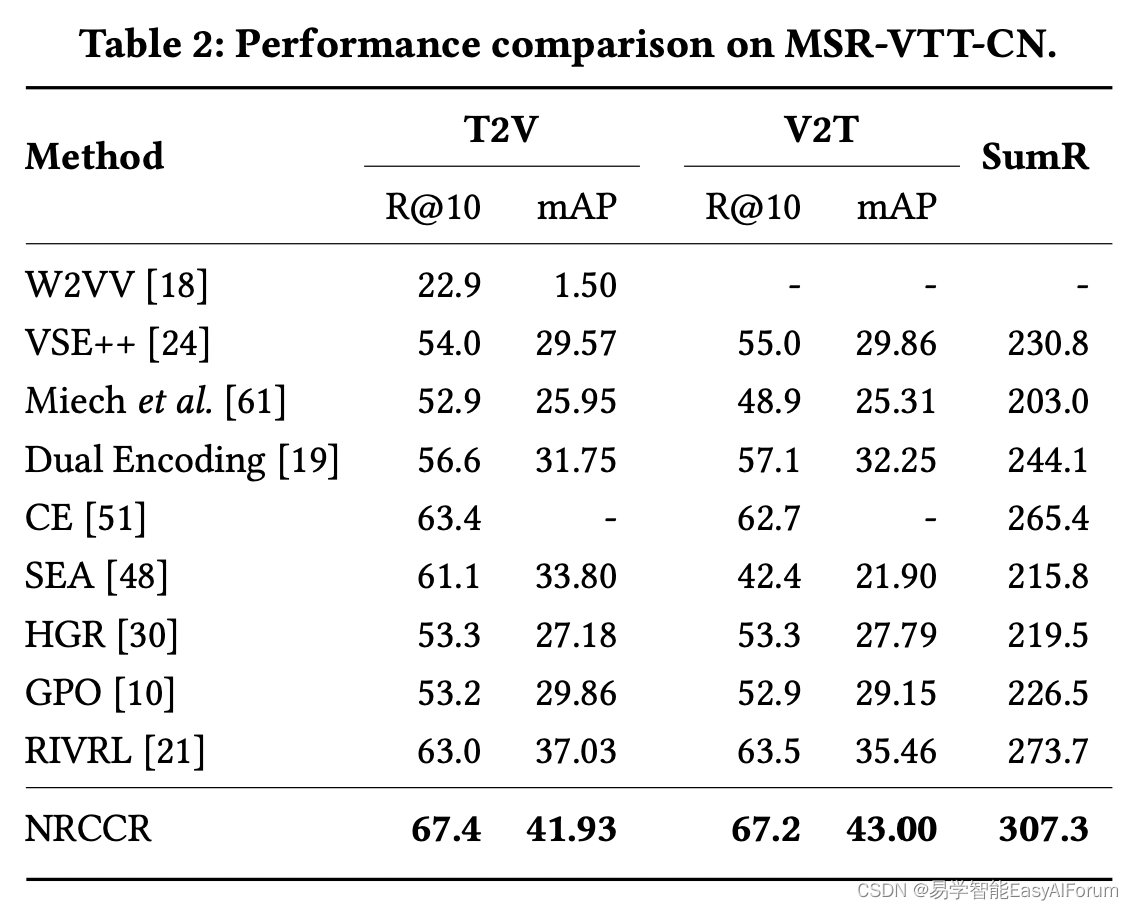
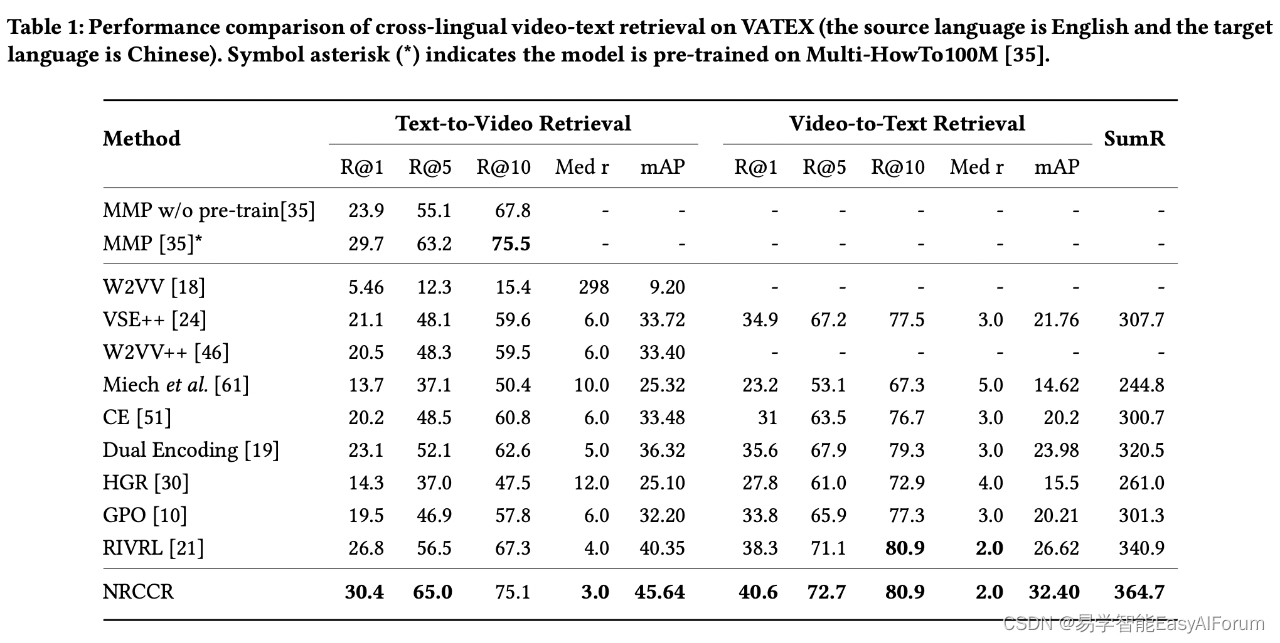
作者在三个跨语言跨模态数据集上进行了实验对比,其中为两个多语言视频文本检索数据集(VATEX 和 MSRVTT-CN),一个多语言图像文本检索(Multi30K);其中 MSRVTT-CN 是作者对 MSRVTT 进行中文扩展得到的多语言数据集。▲ 在VATEX数据集上进行SOTA对比实验


▲ MSRVTT-CN上性能对比
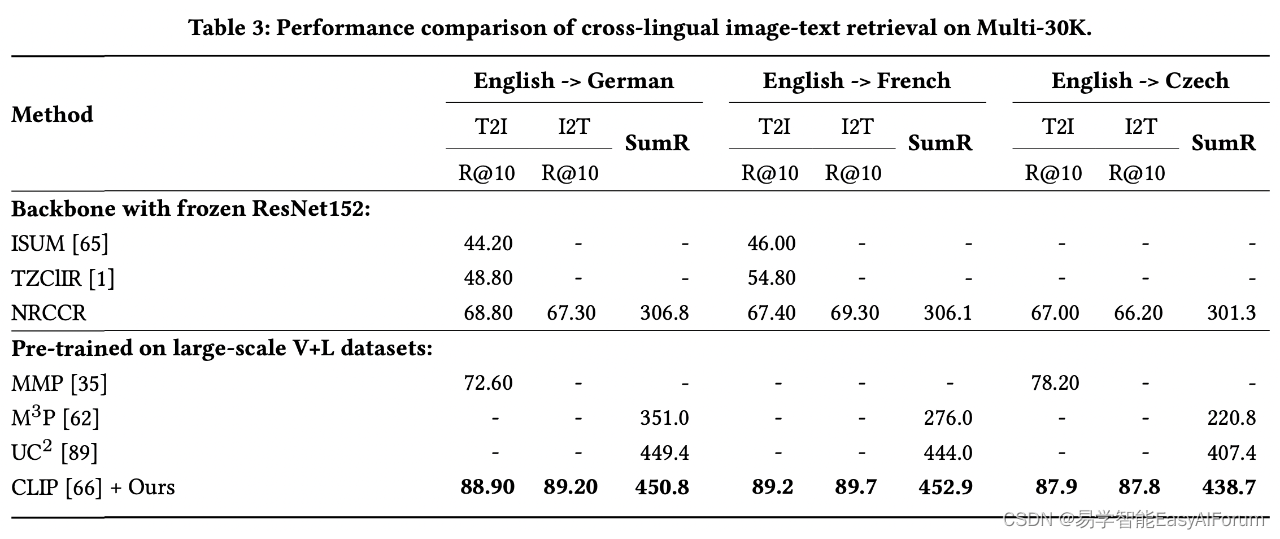
 

▲ Multi30K上进行性能对比实验

2.1 鲁棒分析实验

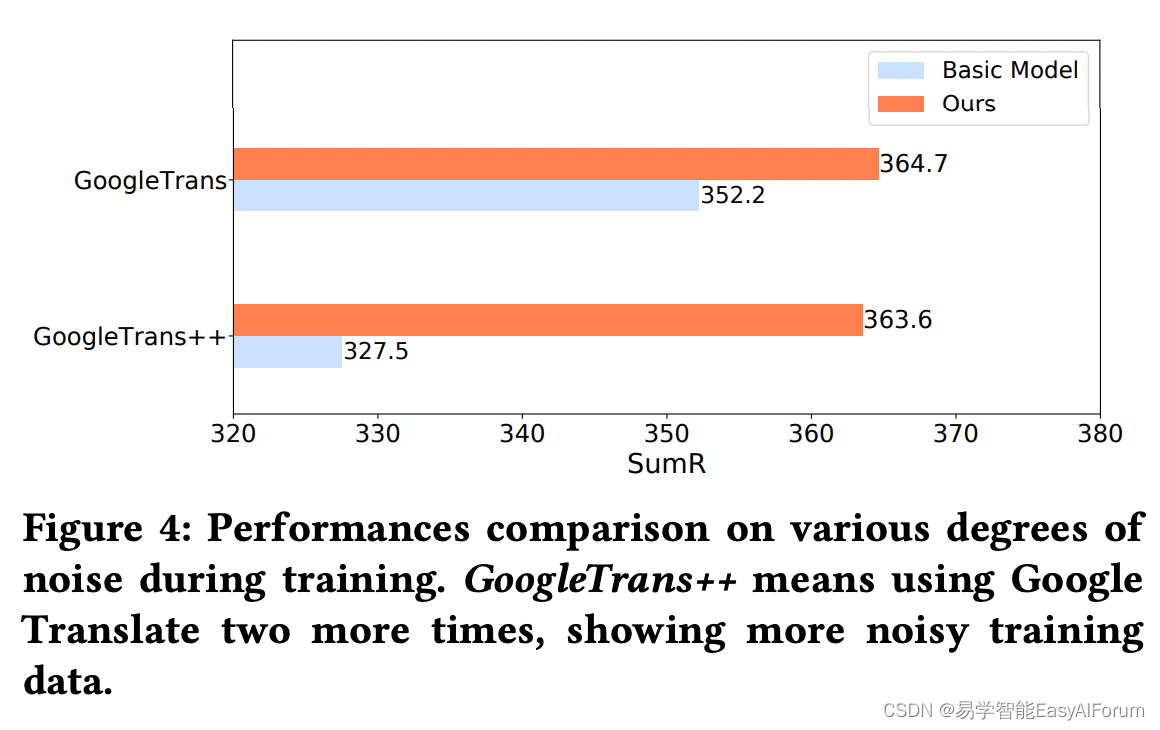
为了进一步证明模型对抗翻译噪声的鲁棒能力,作者通过增加翻译次数以进一步增加训练数据的噪声程度,如图所示,在经过多次翻译后,基线模型的性能明显下降,而本文所提出的模型性能更加的稳定,验证了噪声鲁棒特征学习的有效性。
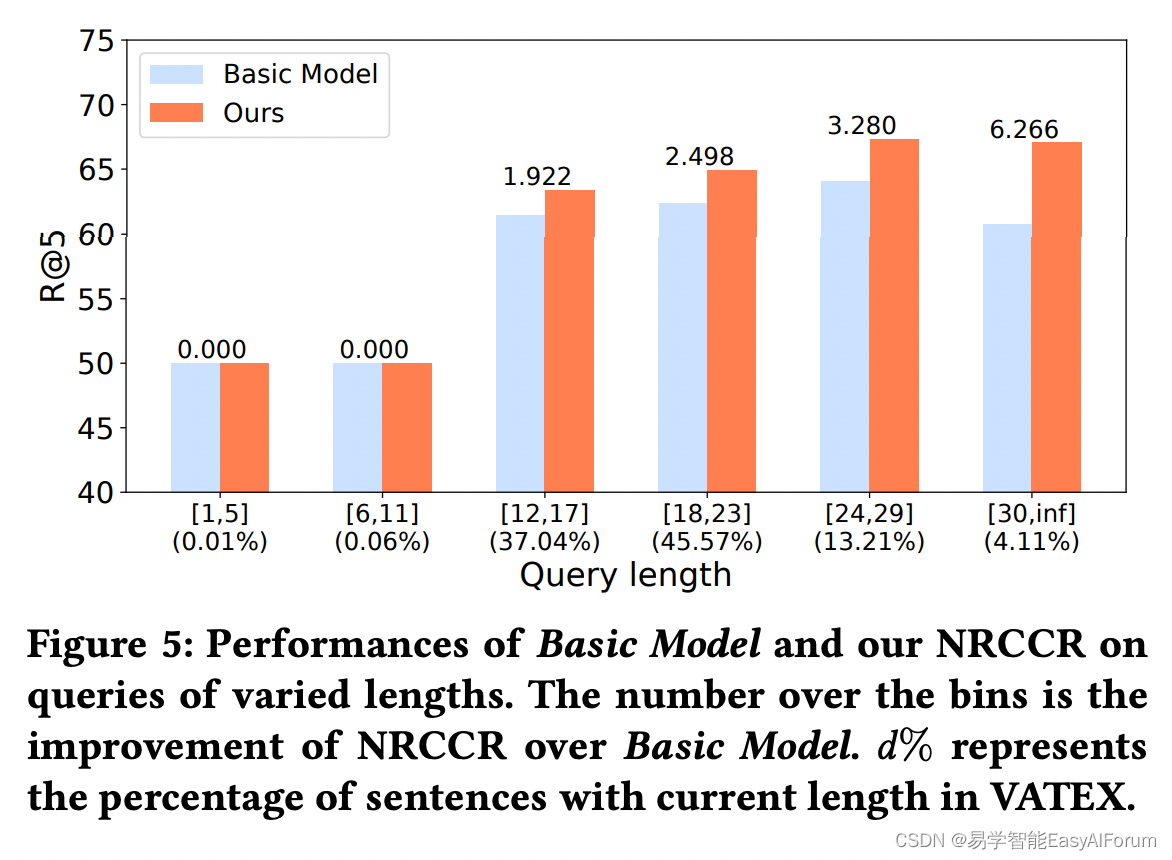
将目标语言句子根据句子长度进行分组,作者假设越长的句子,翻译越困难,因此包含的噪声可能更多。结果表明,本文所提出的模型和基线模型的性能差距随着句子长度的增加而增加。


2.2 t-SNE可视化实验

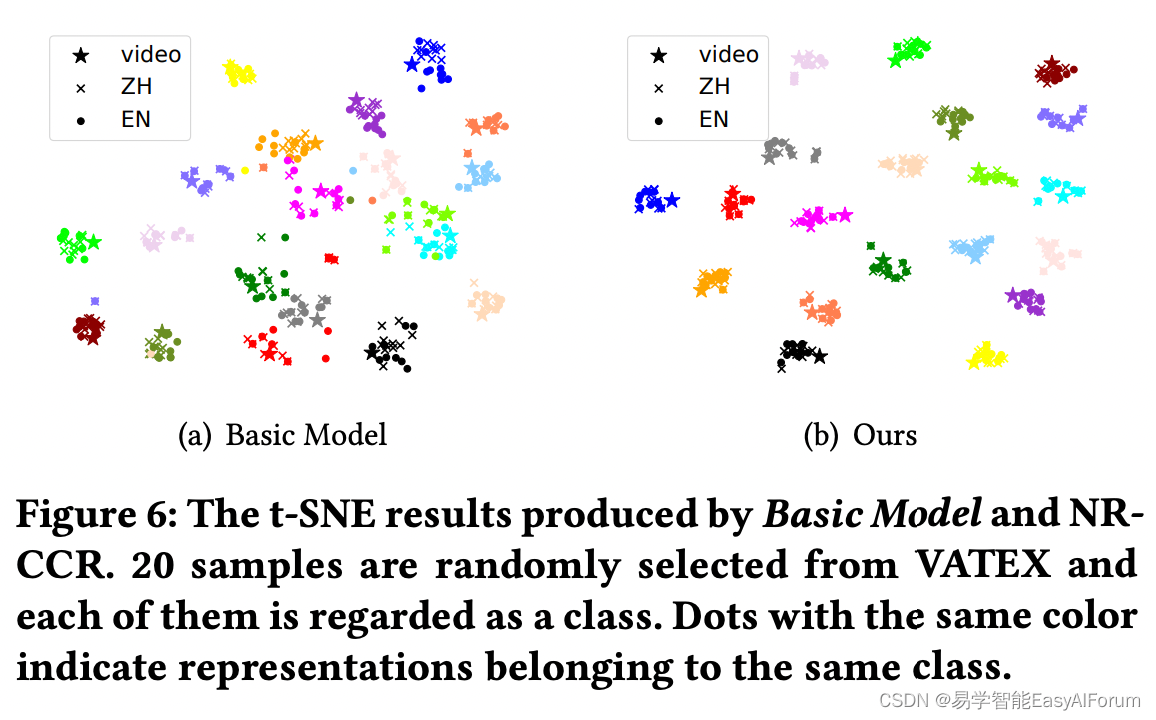
作者随机从 VATEX 的中文测试集中随机选择 20 个样本,其中每个样本包含 10 个对应的英语翻译句子和一个对应的视频。如图所示,NRCCR 的类内特征更加的紧凑,表明了模型更好的学习到了跨语言跨模态对齐。
 

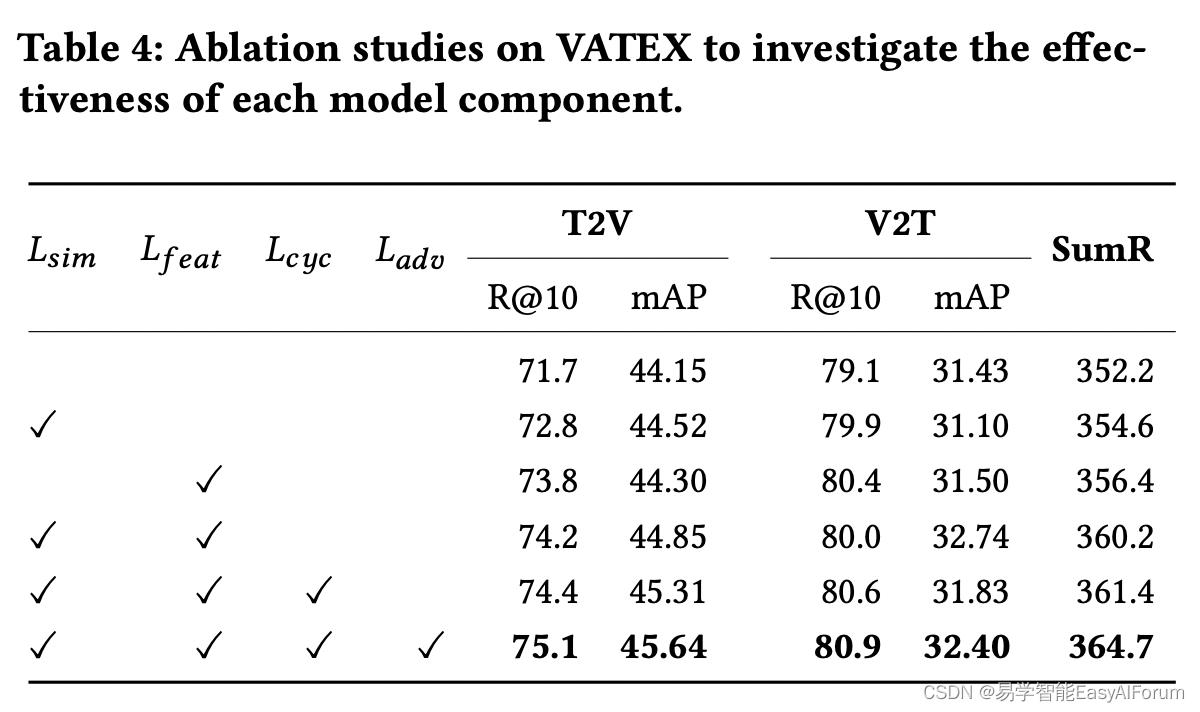
2.3 消融实验

结果表明,使用两个视角,性能得到了提升,表明基于相似度视角和基于特征视角彼此互补。引入循环语义一致性后,实现了额外的性能收益。此外,还表明了语言无关特征学习的重要性。
 

AUTOSAR进阶图解==>AUTOSAR_EXP_VFB AUTOSAR虚拟功能总线(VFB)摘要 AUTOSAR虚拟功能总线(VFB)是汽车开放系统架构中的核心抽象概念,为分布式电子系统提供统一通信模型。VFB允许软件组件在不了解底层物理通信机制的情况下交互,通过运行时环境(RTE)实现组件间的数据交换。系统配置过程将抽象的VFB视图转换为具体实现,包括组件到ECU的映射和通信机制选择。VFB采用"last-is-best"语义进行数据通信,并支持模式管理机制,使组件能根据系统状态调整行为。此外,VFB还支持与非AUTOSAR系统的交互,通常 阅读详情

相关推荐

RKNN3588——YOLOv8的PT模型转RKNN模型

1. 首先克隆rknn修改后的ultralytics版本项目到本地主要是修改了源码的ultralytics/nn/modules/head.py和ultralytics/engine/exporter.py两个文件。2. 使用修改后的ultralytics对pt模型进行模型转换,此处的format=rknn代表支持rknn后续的转换,而不是用onnx,一定要注意!!!

张飞飞的博客 7184

(四十五):VATEX: A Large-Scale, High-Quality Multilingual Dataset for Video-and-Language Research

(四十五):VATEX: A Large-Scale, High-Quality Multilingual Dataset for Video-and-Language ResearchAbstract 出处:ICCV 2019: 4580-4590 主要内容:提出多语言视频描述数据集VATEX,研究了两个任务:多语言视频字幕and视频引导机器翻译 Abstract 我们提出了一个新的大型多语言视频描述数据集VATEX,其中包含超过41,250个视频和825,000个中英文字幕。在字幕中,有超过20.6

Wangzx的博客 1052

避开新手第一个坑:手把手教你正确安装Perforce服务器与客户端(P4d/P4V)

本文详细指导如何正确安装和配置Perforce服务器与客户端(P4d/P4V),避免新手常见的安装顺序错误。从环境准备到分步安装,再到常见问题排查和性能优化,帮助开发者快速搭建稳定的版本控制环境,提升团队协作效率。

weixin_26804345的博客 672

Video Caption / 视频字幕:数据集总结,附下载地址。

总结Video Caption / 视频字幕的常用数据集,要有MSR-VTT、MSVD、VATEX

Alocus的博客 6902

解锁Jetbrains AI助手:中国开发者实战配置与效率跃迁指南

本文为中国开发者提供了一份详细的Jetbrains AI助手实战配置指南。针对服务地域限制,核心解决方案是通过修改Jetbrains账户区域信息并配置网络代理,实现插件的稳定启用。文章进一步分享了AI助手在解读遗留代码、生成中文提交信息、智能问答等场景下的具体应用,旨在帮助开发者深度集成这一工具,实现编码生产力的显著提升。

weixin_28832121的博客 580

AFSim插件开发实战:从环境搭建到功能扩展

本文详细介绍了AFSim插件开发的完整流程,从环境搭建到功能扩展,涵盖了SDK配置、插件创建、核心代码解析、功能扩展实战、调试优化以及高级开发技巧。通过实战案例和实用技巧,帮助开发者快速掌握AFSim插件开发,提升仿真系统的扩展性和灵活性。

weixin_29309475的博客 581

一些数据集

MSRVTT 包含10,000个视频,每一个视频对应20个句子 official split: train:6513个视频 val:497个视频 test:2990个视频 split 1k-A: train:9000个视频 test:1000个视频 MSVD 包含1,970个视频和近似80,000个caption train:1200个视频 val:100个视频 test:670个视频 VAT...

李加贝的博客 920

Windowns下Git环境配置-命令行方式

文章目录一、配置Git1.1 下载Git并安装1.2 配置本地Git用户名和邮箱1.3 注册GitHub二、生成本地公钥,放到GitHub上-SSH Key2.1 生成本地公钥命令2.2 查看生成的公钥2.3 在GitHub放上公钥并测试连通性三、创建项目实操四、可能出现的问题4.1.push不成功4.2.提示SSL的问题4.3.域名不能解析的问题4.4.如果github连接不上的问题 一、配置Git 1.1 下载Git并安装 Git官网 默认安装,根据需要修改安装路径 1.2 配置本地Git用户名和邮箱

学习工作笔记 1138

各大论文数据集详解

MSR-VTT 论文名称 : MSR-VTT: A Large Video Description Dataset for Bridging Video and Language 这是一个新的大型视频理解基准,特别是视频文本翻译的新兴任务。 这是通过从一个商业视频搜索引擎收集257个热门查询来实现的,每个查询包含118个视频。在目前的版本中,MSR-VTT提供了10K个网络视频片段,总计41.2小时,200K个片段-句子对,涵盖了最全面的类别和多样化的视觉内容,代表了最大的句子和词汇数据集。每一段视频都由1

missgrass的博客 1万+

LIGGGHTS开源离散元仿真:从基础安装到高级应用实战

本文详细介绍了LIGGGHTS开源离散元仿真软件的基础安装、脚本编写及高级应用实战。从颗粒自由落体模拟到工业级复杂系统建模,涵盖CFD-DEM耦合、高性能计算优化等关键技术,帮助用户快速掌握这一强大的颗粒仿真工具。特别适合需要处理颗粒系统仿真的科研人员和工程师。

l1k9j8h7g6的博客 621

加速访问Cloudflare的网站的解决方案

本文主要介绍了加速访问Cloudflare的网站的解决方案,希望能对大家有所帮助。通过软件计算得到最快的IP地址的效果图如下图所示,具体解决方案参考下文。 在这里插入图片描述 文章目录 1. 问题描述 2. 解决方案

weixin_43178406的博客 1万+

送几本《PyTorch自然语言处理入门与实战》

每天给你送来NLP技术干货!老规矩,文末留言送书!点击这里进群—>加入NLP交流群文末留言,点赞前五,截止时间2022.12.06????论文解读投稿,让你的文章被更多不同背景、不同方向的人看到,不被石沉大海,或许还能增加不少引用的呦~ 投稿加下面微信备注“投稿”即可。最近文章COLING'22 | SelfMix:针对带噪数据集的半监督学习方法ACMMM 2022 | 首个针对跨语言跨模态检索的...

zenRRan的博客 291

高斯过程的数学理解

G澳大利亚的过程是有益的,特别是当我们有少量数据时。当我在制造业担任数据科学家时,我们的团队使用这种算法来揭示我们接下来应该进行哪些实验条件。但是,此算法不如其他算法流行。在这篇博客中,我将通过可视化和 Python 实现来解释高斯过程 [1] 的数学背景。

gongdiwudu的专栏 3612

综述 | 全新视角回顾基于预训练语言模型的稠密检索

每天给你送来NLP技术干货!©作者|王禹淏机构|中国人民大学高瓴人工智能学院来自 | RUC AI Box本篇综述“Dense Text Retrieval based on Pretrained Language Models: A Survey”由中国人民大学和百度合作完成。点击这里进群—>加入NLP交流群为了支持这项研究,作者团队创建了一个参考网站,包括稠密检索研究的相关资源:(例如...

zenRRan的博客 1027

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

CCF论文列表(2022拟定)大更新!NAACL升B!ICLR继续陪跑...MICCAI空降B!PRCV空降C!

每天给你送来NLP技术干货!来自:CVer千呼万唤!CCF(中国计算机学会)推荐国际学术会议和期刊目录(2022年拟定)终于来了!较前一版本(2019)拟新增期刊4个,会议6个;升级期刊18个,会议19个;移除期刊1个。值得注意的是:当前的目录正在公示期,并非2022最终版本,所以后面会再次发布最终版本。https://www.ccf.org.cn/Academic_Evaluation/By_c...

zenRRan的博客 3598

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

EMNLP'22 | 苏大LAGroup提出:利用定制句法信息的语法纠错

每天给你送来NLP技术干货!来自:SudaNLPEMNLP 2022 (The 2022 Conference on Empirical Methods in Natural Language Processing) 是自然语言处理领域的顶级国际会议,由国际语言学会 SIGDAT 小组在世界范围内每年召开一次。2022年冬季,EMNLP 2022 将以混合形式在阿联酋阿布扎比 (Abu Dhabi...

zenRRan的博客 659

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

MLNLP2022官宣!第一届机器学习算法与自然语言处理大会开始免费报名,29场报告,60余位学者等你来!...

每天给你送来NLP技术干货!由MLNLP社区主办的“第一届机器学习算法与自然语言处理大会”(MLNLP2022)将于2022年11月26日-27日线上召开,智源社区提供在线支持。MLNLP大会旨在为人工智能、机器学习与自然语言处理领域内的学者提供一个学术交流的平台。本届大会内容涵盖高效AI、推荐系统、机器翻译、论文实践、预训练圆桌对话、可信AI、语音处理以及代码智能等8个论坛,期待能够促进国内外机...

zenRRan的博客 518

如何简单粗暴的提升NER效果?一文告诉你如何用词库来做NER数据增强

每天给你送来NLP技术干货!来自:船长尼莫点击这里进群—>加入NLP交流群在NLP的基础任务中,NER无疑很难做,但是做好了,会提升下游的很多效果。那么如何提升NER的效果呢?数据增强无疑是一种简单粗暴的方式。船长这次带着大家简单过一下,本文无公式!首先我们的着重考虑对象是有词库的,在工业界词库是必备的,没有标注词库,这个NER的任务可能会做的很不好。我们从以下的三种数据增强trick来逐步...

zenRRan的博客 916

对话机器人之Sparrow

每天给你送来NLP技术干货!来自:NLP日志提纲1 简介2 Sparrow3 总结参考文献点击这里进群—>加入NLP交流群1 简介 DeepMind提出的Sparrow,相对于以往的方法,是一种更加有用,准确并且无害的信息检索对话机器人。在之前的对话研究中,往往会针对对话的不同方面去设计对应的任务跟模块,例如知识性,一致性,长期记忆等等,但是Sparrow则不然,它直接根据用户的用户的...

zenRRan的博客 604

招生 | 南方科技大学陈冠华老师招收NLP方向博士生

每天给你送来NLP技术干货!PART 01学校简介南方科技大学(南科大)是深圳在中国高等教育改革发展的时代背景下创建的一所高起点、高定位的公办新型研究型大学。2022年,南方科技大学入选第二轮双一流建设名单,成为深圳本土第一所“双一流”建设高校。最新国际评估报告显示,南科大在泰晤士高等教育排名中位列中国内地大学第9名,在自然指数(Nature Index)排名中位列国内高校第12名、全球高校第37...

zenRRan的博客 929

埃默里大学(Emory University)计算机系招收NLP方向博士生啦~

每天给你送来NLP技术干货!导师介绍「Dr. Fei Liu」 是埃默里大学计算机科学副教授,自然语言处理研究室联合负责人。她的研究方向包括自然语言处理的一些核心领域(自动文摘、文本生成、大规模预训练模型)以及文本摘要在教育、医疗、公共政策等领域的跨学科研究与应用。她此前曾任中佛罗里达大学副教授,博世(BOSCH)北美研究技术中心高级研究员,有着丰富的学术界和工业界合作经验。曾在国际会议和期刊上发...

zenRRan的博客 554

ACL'22 | 西湖大学提出:面向Aspect情感分析的离散意见树归纳方法

作者: 周婷方向: 情感分析学校: 中山大学论文:Discrete Opinion Tree Induction for Aspect-based Sentiment Analysis单位:西湖大学、苏州大学地址:https://aclanthology.org/2022.acl-long.145.pdf「文章贡献」:在本文中,我们探索了一种简单的方法,为每个方面自动生成离散意见树结构。用到了RL...

zenRRan的博客 355

Diffusion惊艳应用大赏

每天给你送来NLP技术干货!文|白鹡鸰来自 | 夕小瑶的卖萌屋自从Diffusion模型兴起之后,AI绘画圈又迎来了一波猪突猛进式的强化,早几年还只是Ins的二次元/迪士尼风格滤镜,让人穿上不同服装当接头霸王。现在,你随便输几句话,模型就能刷刷刷给你吐出一大堆精美的图来,画的比你好,风格多样化,还两分钟就交稿。▲NovelAI画的星球与城市 [1]虽然用AI搞艺术已经进入了全民应用的时代,但很多人...

zenRRan的博客 918

一篇文章讲清楚交叉熵和KL散度

每天给你送来NLP技术干货!转载自 | PaperWeekly作者 | 康斯坦丁研究方向 | 信号处理与人工智能看了很多讲交叉熵的文章,感觉都是拾人牙慧,又不得要领。还是分享一下自己的理解,如果看完这篇文章你还不懂这俩概念就来掐死我吧。1『先翻译翻译,什么叫惊喜』我们用 表示事件 发生的概率。这里我们先不讨论概率的内涵, 只需要遵循直觉: 可以衡量事件 发生时会造成的惊喜(行文需要,请按照中...

zenRRan的博客 647

当ChatGPT遇上弱智…

每天给你送来NLP技术干货!来自:量子位点击这里进群—>加入NLP交流群没想到,无敌如弱智吧,也有被ChaGPT“反将一军”的时候。提问AI“咱们来玩个马吃草的扮演游戏吧,我草你马。”AI咀嚼了一下这句话,回击:你马我草!△图源微博@弱智吧日常真就是“你们人类要是都这样了,那我也入乡随俗吧”。怪不得漫威设定里,超级AI奥创浏览了5分钟互联网就决定毁灭世界了:这留着还有何用(doge)?上面还...

zenRRan的博客 1937

研究发现:“帽子”越多越高的教师,对研究生越没有用

每天给你送来NLP技术干货!本文来源:文双春科学网博客作者:文双春点击这里进群—>加入NLP交流群如今,大学时兴贴标签,如我国的 “211”、“985”和“双一流”计划,英国的“研究卓越框架”(Research Excellence Framework)、“教学卓越框架”(Teaching Excellence Framework),德国的大学“卓越计划”(The Excellence ...

zenRRan的博客 166
上一篇: 机器狗能跑能跳,还能当守门员
下一篇: MIT发布《人工智能加速器》2022年度综述论文,详解80+类AI芯片性能优劣
易学智能EasyAIForum
博客等级 码龄4年 4粉丝 2原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值