


目录
前言
路漫漫其修远兮,吾将上下而求索;
以下是滑窗口问题leetcode 集,大家可以先自己做做看:
- 209. 长度最小的子数组
- 3. 无重复字符的最长子串
- 1004. 最大连续1的个数 III
- 1658. 将 x 减到 0 的最小操作数
- 904. 水果成篮
- 438. 找到字符串中所有字母异位词
- 30. 串联所有单词的子串
- 76. 最小覆盖子串
题1 长度最小的子数组:
题干:
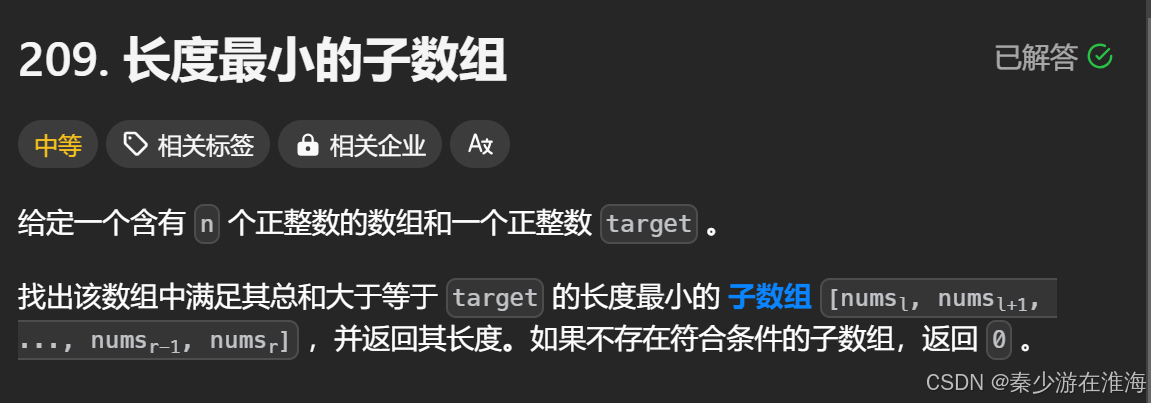
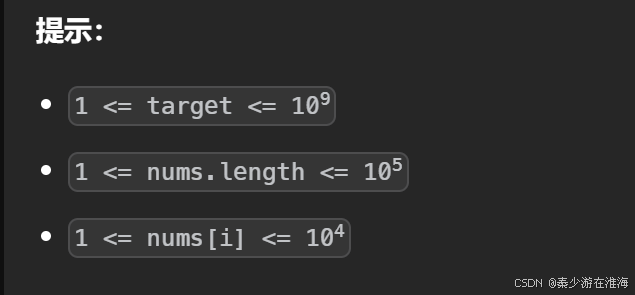
数据范围:
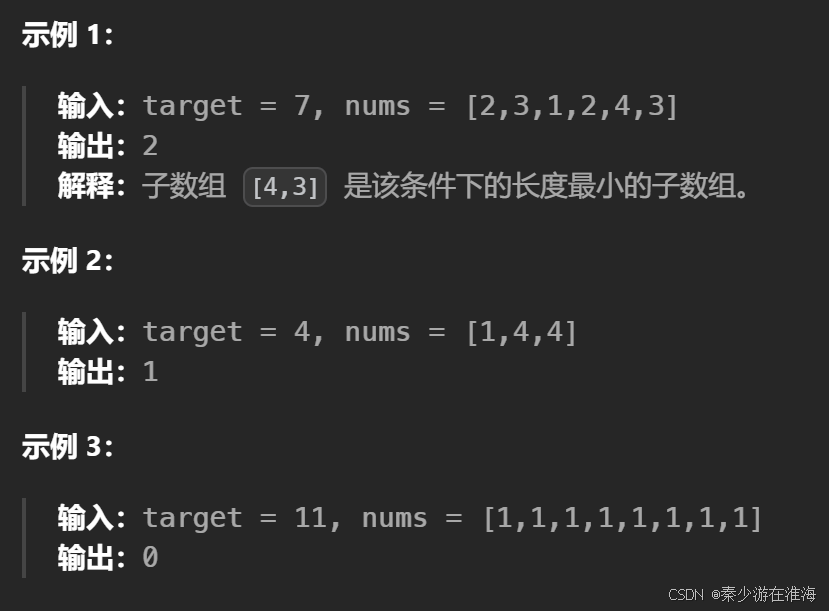
例子:
思考:
子数组:连续的数据
解法一:暴力枚举出所有子数组的情况,然后将其中的数据相加判断和是否大于target ;
这样的话,时间复杂度为O(N^3),并且本题的数据量不少,单纯地用暴力解决一定会超时;可以在暴力解法的基础上进行优化吗?无非就是在优化枚举所有子数组,计算该子数组的和这两点上进行优化;
由于数组中的数据均是正整数,正整数做加法有这样的性质:加的数越多,和就越大(利用了数据的单调性);
和前一篇“双指针题集”有相同之处,此处也可以利用数据的单调性来优化枚举所有子数组,而且还顺便可以优化计算其和:
- 假设我们两个指针(假设为left right, 这两个指针是同向走的)指向的区间中的数据为sum ,当sum 刚好大于target 的时候,可以再用一个变量记录此时子数组的长度;此时sum 已经大于target 了,那么可以让left++ ,减去前面较小的数看sum 是否还大于target ,如果还大于left 可以继续++,如果小于了就让right ++;(整体思路很像双指针)
稍微粗略的分析觉得可行之后,我们可以更加细节地分析:
优化计算子数字的和:固定左区间,再定义一个变量来一直计算,这样就不用每遇到一个区间就从头到尾依次计算,图解如下:(下图的target 为 7)
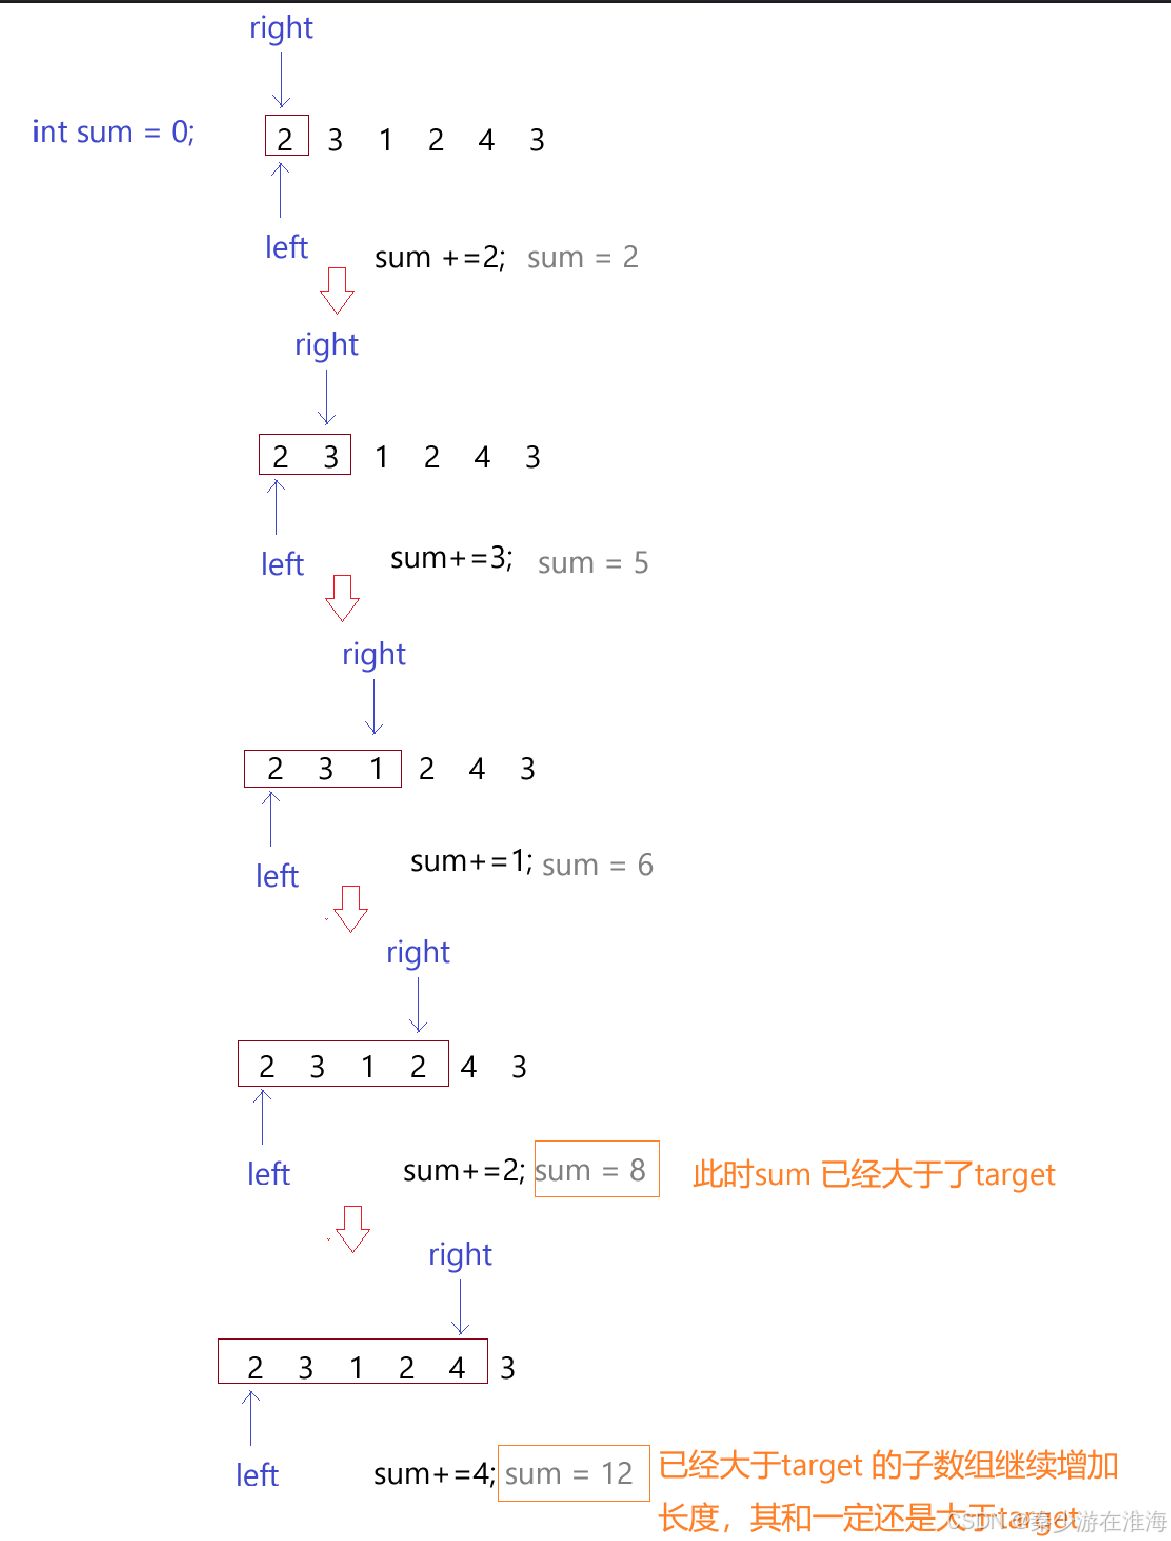
当sum 已经大于target 的时候,此时left 和 right 的区间就已经为较小子数组长度下的和,right 也没有必要继续向前走了;
优化:当sum 已经大于target 的时候,让变量记录一下该子数组的长度,然后让left ++ ,再让right 回到left 指向的位置上,如下:
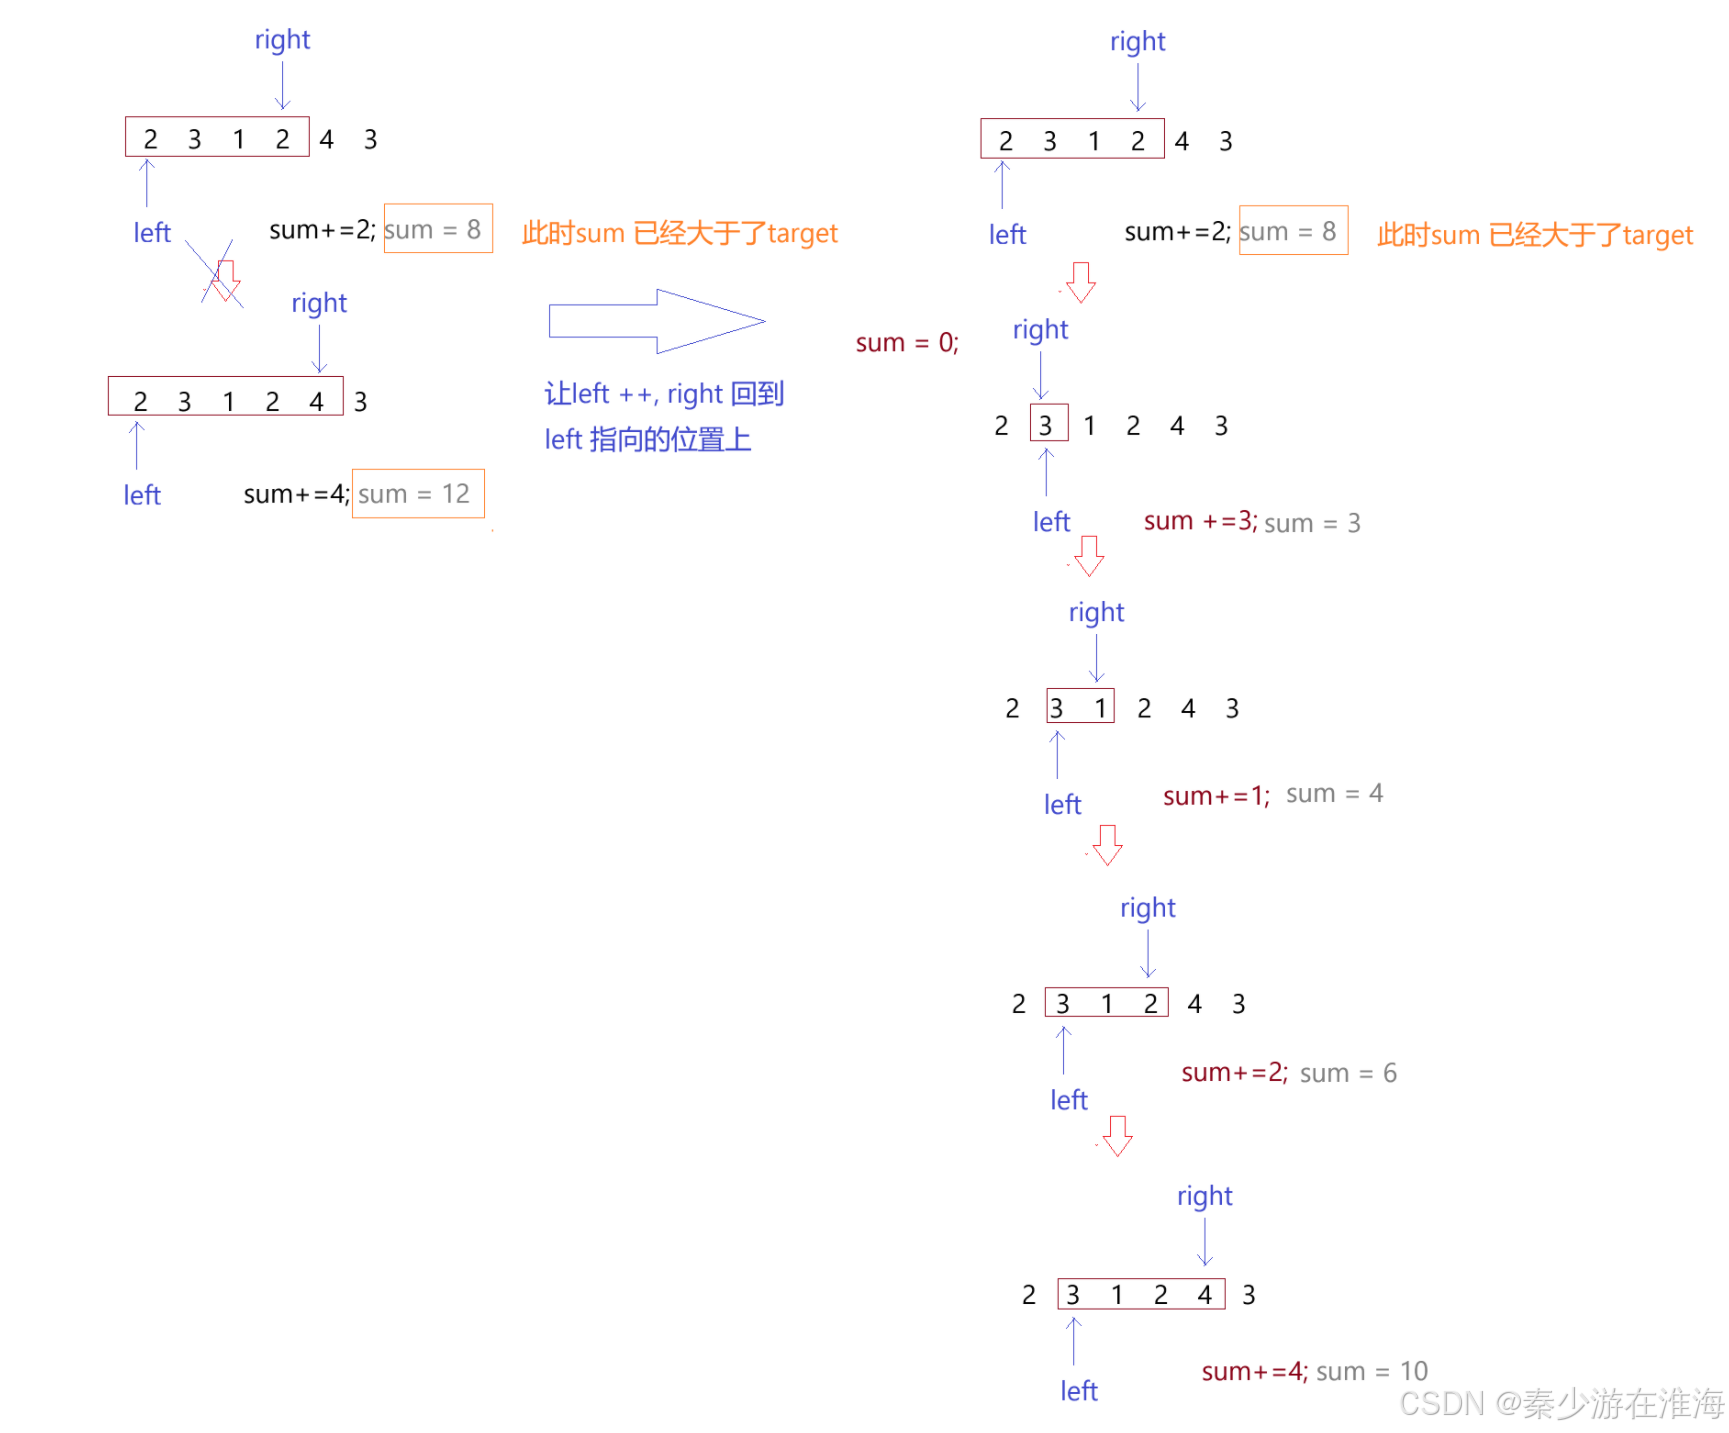
倘若当我们找到一个符合要求的区间之后让left 自增,然后再让right 指向left 指向的字符,那么就会需要将sum 置为0,然后一个一个地再遍历,计算该子数组中数据中的和;时间复杂度为O(N^2);实际上,还可以继续优化:当left 和 right 指向的区间中的数据和大于target 的时候,left ++ ,但是right 并不回到left 指向的位置处,而是让right 不动,sum 减去left 之前所指向的数据,再判断sum 和 target 的大小关系,如果sum 还是大于target ,left 继续++ ,sum 再减去left 之前所指向的数,然后再判断sum 和 target 的大小关系……如果sum小于target ,right 就++……优化二如下图:
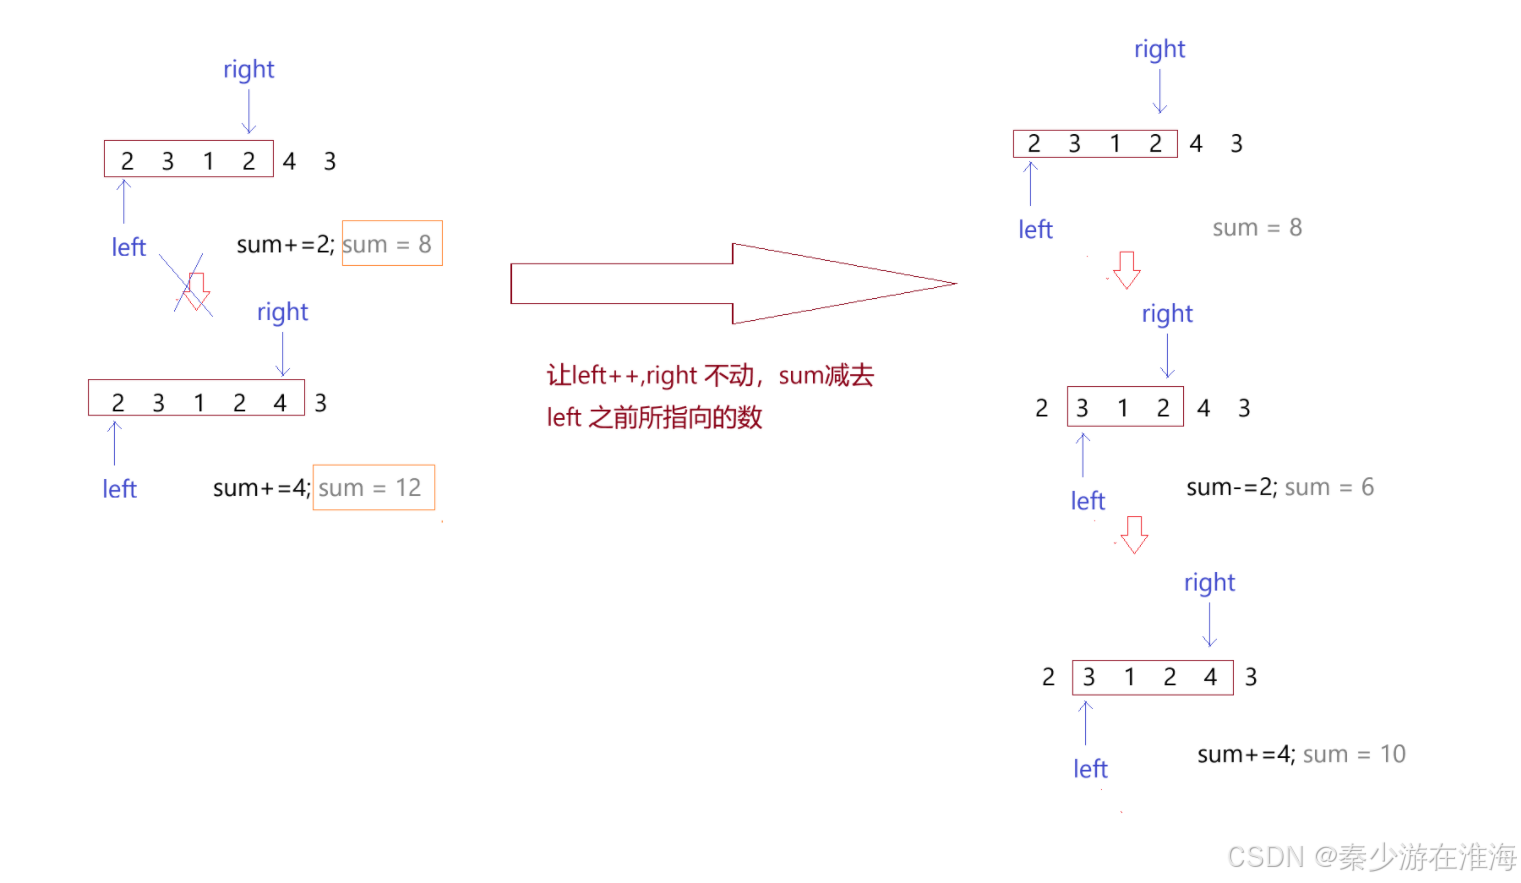
对于优化2的操作,本质上就是滑动窗口的理念,即利用单调性,并且使用同向双指针;利用滑动窗口一般是来维护一个区间;
思路总结:
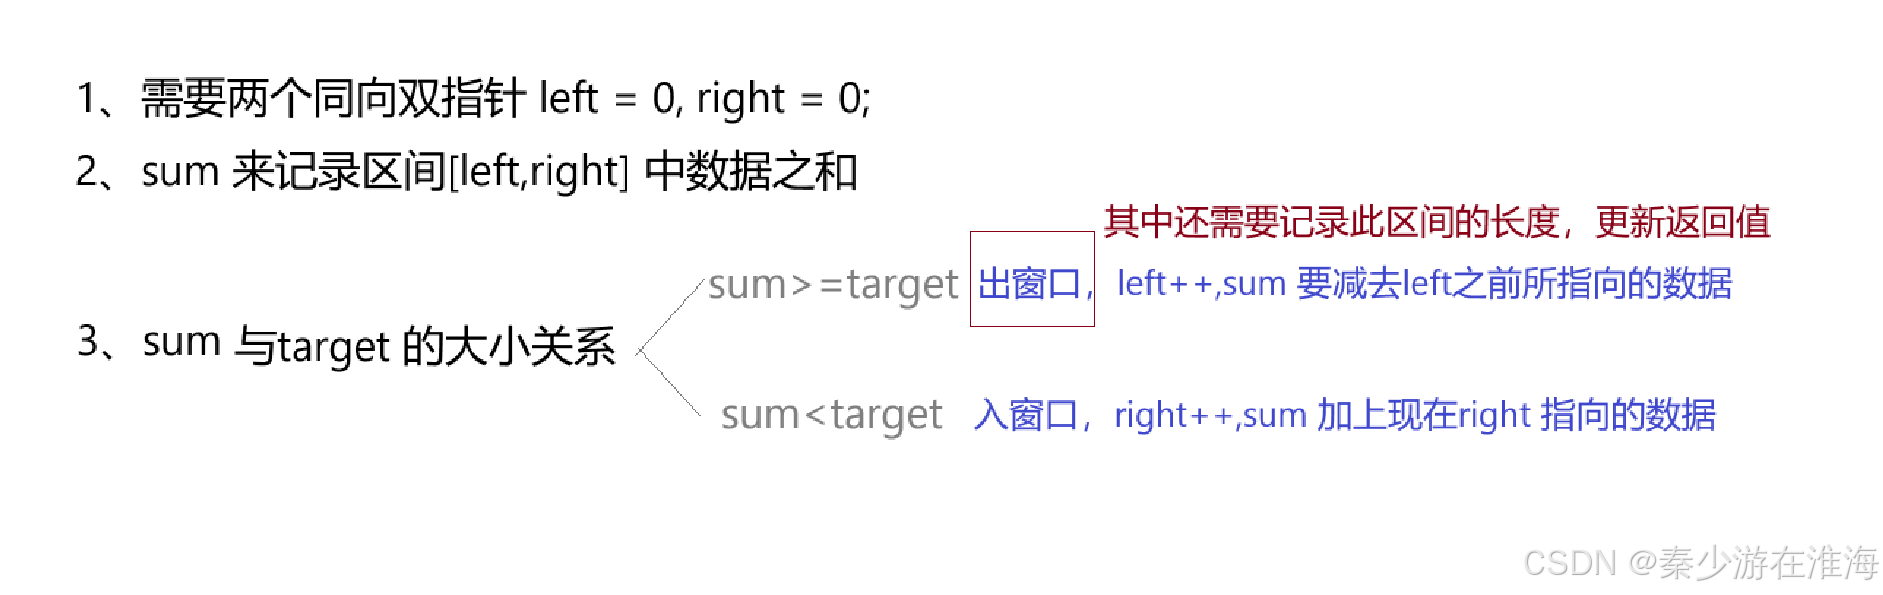
按照上面的思路写代码,我们会发现:
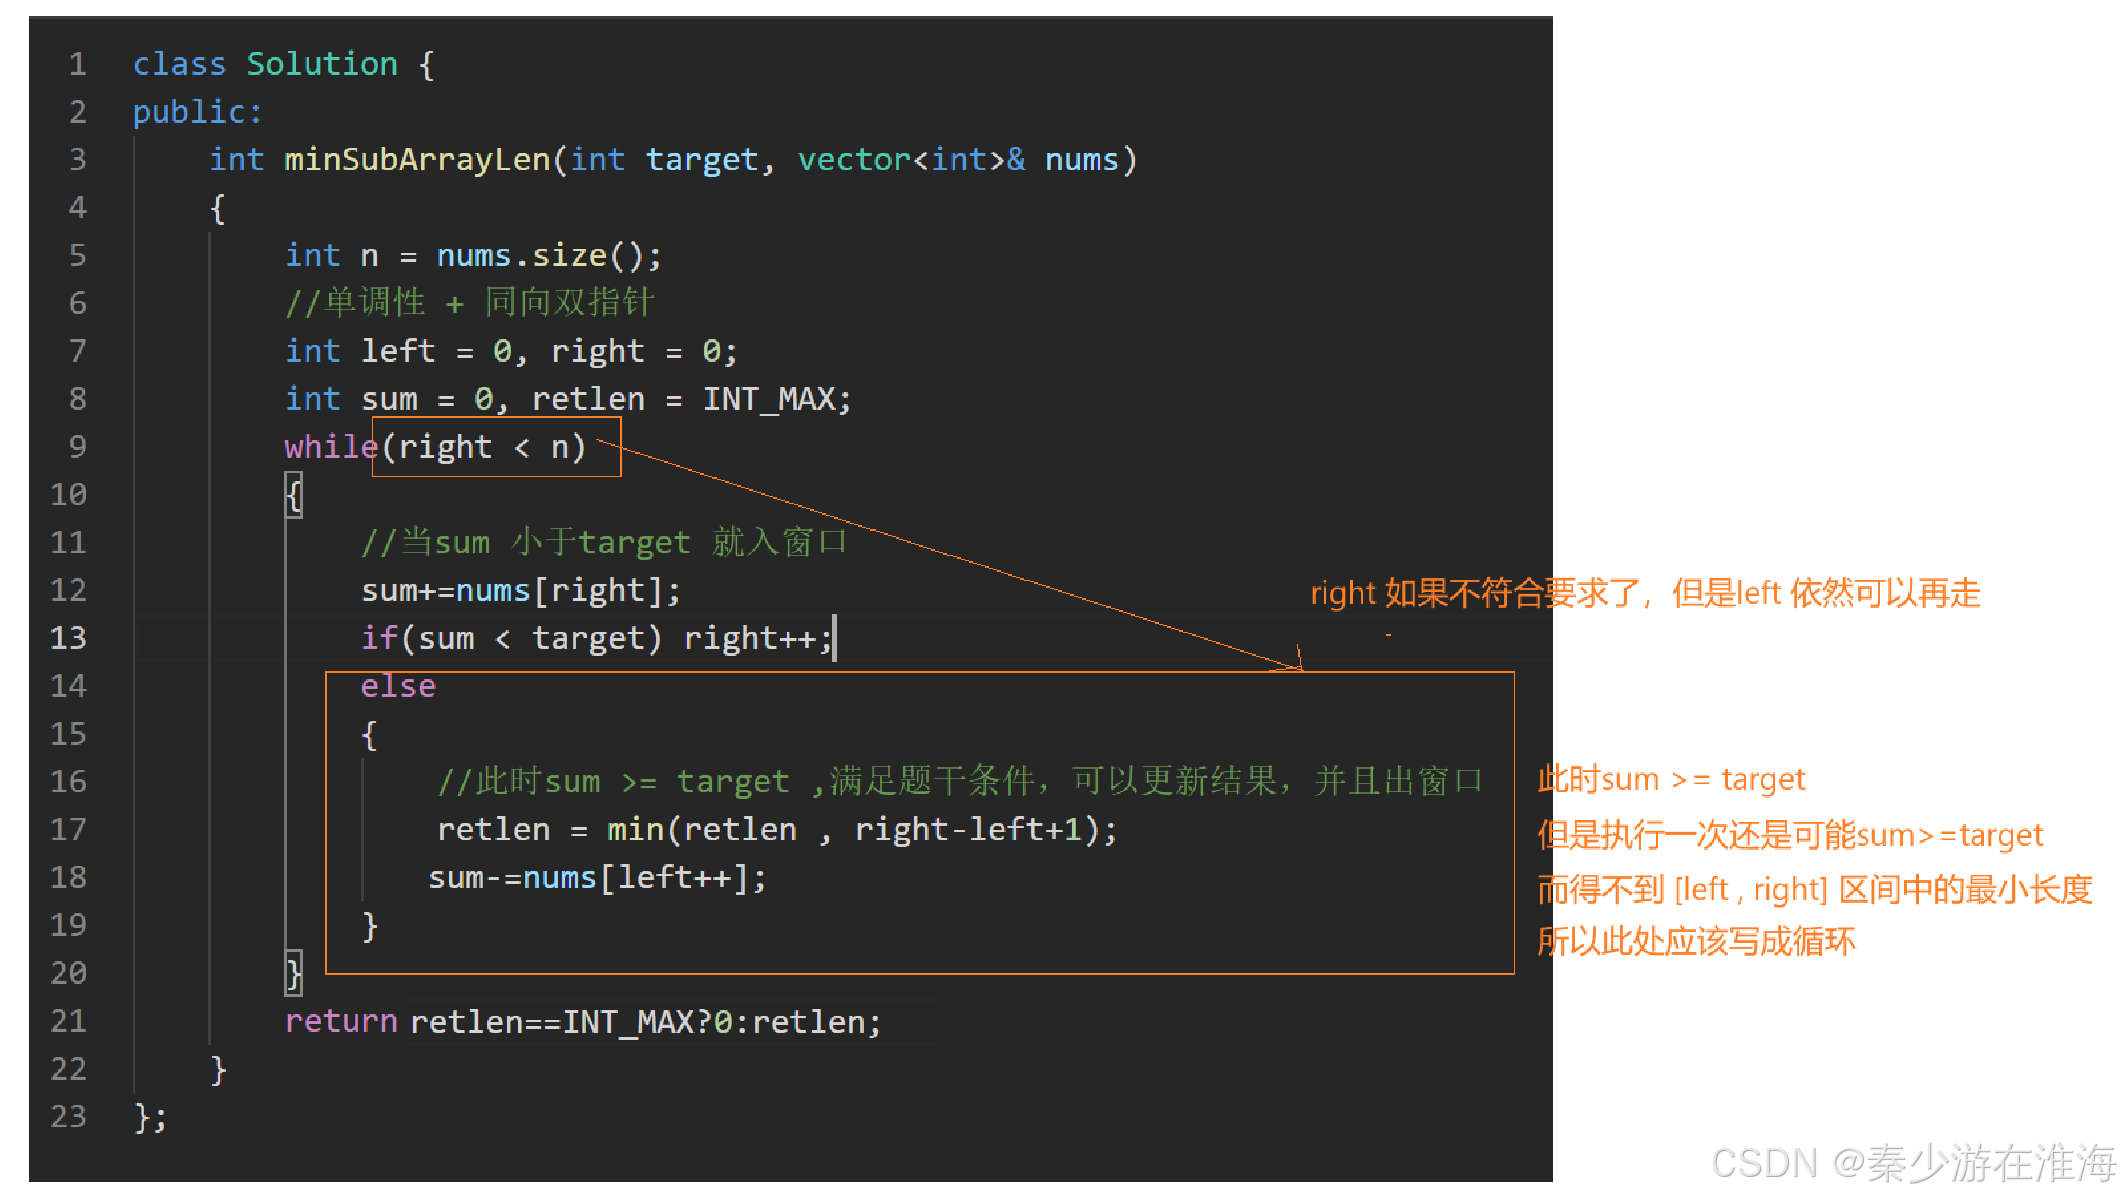
在出窗口的位置要写成循环:
参考代码1:
(while 循环版本)
    int minSubArrayLen(int target, vector<int>& nums)
    {
        int n = nums.size();
        //单调性 + 同向双指针
        int left = 0, right = 0;
        int sum = 0, retlen = INT_MAX;
        while(right < n)
        {
            //当sum 小于target 就入窗口
            sum+=nums[right];
            while(sum >= target)
            {
                //此时sum >= target ,满足题干条件,可以更新结果,并且出窗口
                retlen = min(retlen , right-left+1);
                sum-=nums[left++];
            }
            right++;
        }
        return retlen==INT_MAX?0:retlen;
    }
Q:为什么right++ 放在出窗口后面?不应该是先入窗口然后再出窗口吗?
- 最初left == right 的时候(left ==0 , right == 0),实际上是将第一个数入窗口,相当于right天然地就已经自增了;所以将right++,放在最后,每次right向后走一步就入窗口,是合理的;
基于此,我们还可以写成for 循环版本的:
参考代码2:
(for 循环版本)
    int minSubArrayLen(int target, vector<int>& nums)
    {
        int n = nums.size();
        //单调性 + 同向双指针
        int sum = 0, retlen = INT_MAX;
        for(int left = 0, right = 0;right <n;right++)
        {
            //当sum 小于target 就入窗口
            sum+=nums[right];
            //更新数据 + 出窗口
            while(sum >= target)
            {
                //此时sum >= target ,满足题干条件,可以更新结果,并且出窗口
                retlen = min(retlen , right-left+1);
                sum-=nums[left++];
            }
        }
        return retlen==INT_MAX?0:retlen;
    }
题2 无重复字符的最长子串:
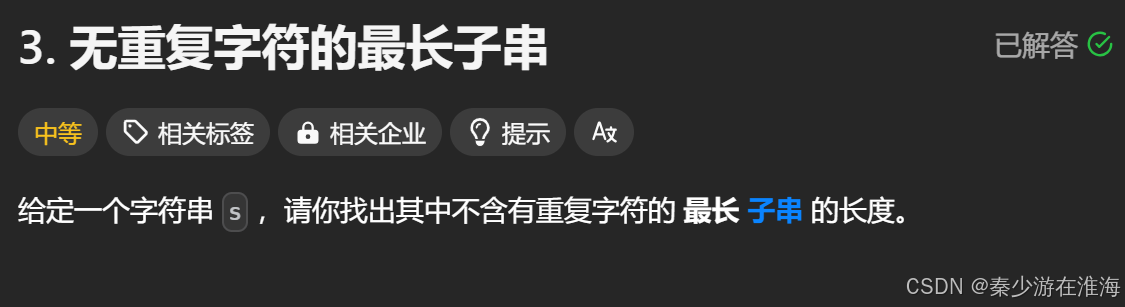
题干:
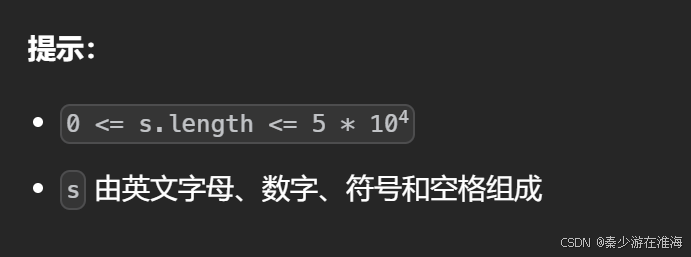
数据范围:
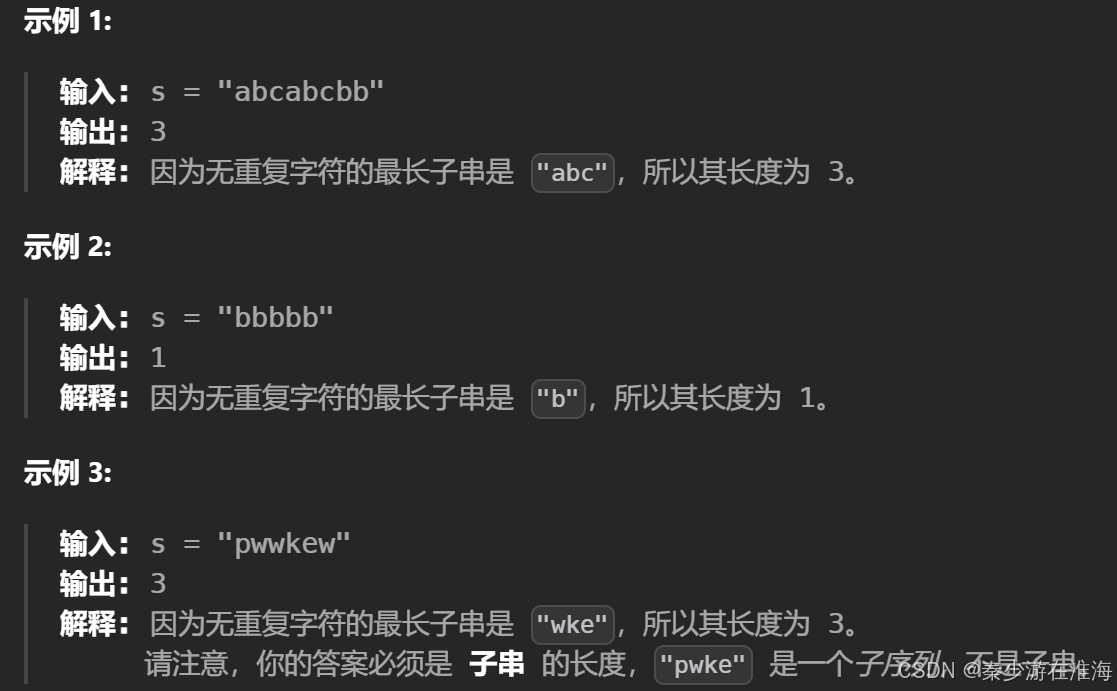
例子:
思考:
子串:连续的字符构成的串
要求:不重复的最长子串
解法一:暴力解法
列举出所有的子串的情况,再判断这每一个子串是否是不重复的子串,然后找到一个最长的就可以了;其中枚举所有子串的情况:固定每一个有可能的起始位置,然后依次向后扩展,直到扩展到不能再扩展为止;而判断这个子串是否重复:利用哈希表;
即暴力解法就是:暴力枚举 + 哈希表判断;
此处就不演示暴力解法是否能通过,我们需要做的是能否在暴力解法的基础上进行优化:这道题其实和上一道题有异曲同工之妙,只不过上一道题出窗口的条件是:当sum >= target, 而本题出窗口的条件:窗口[left,right] 之中有重复的字符,图解如下:
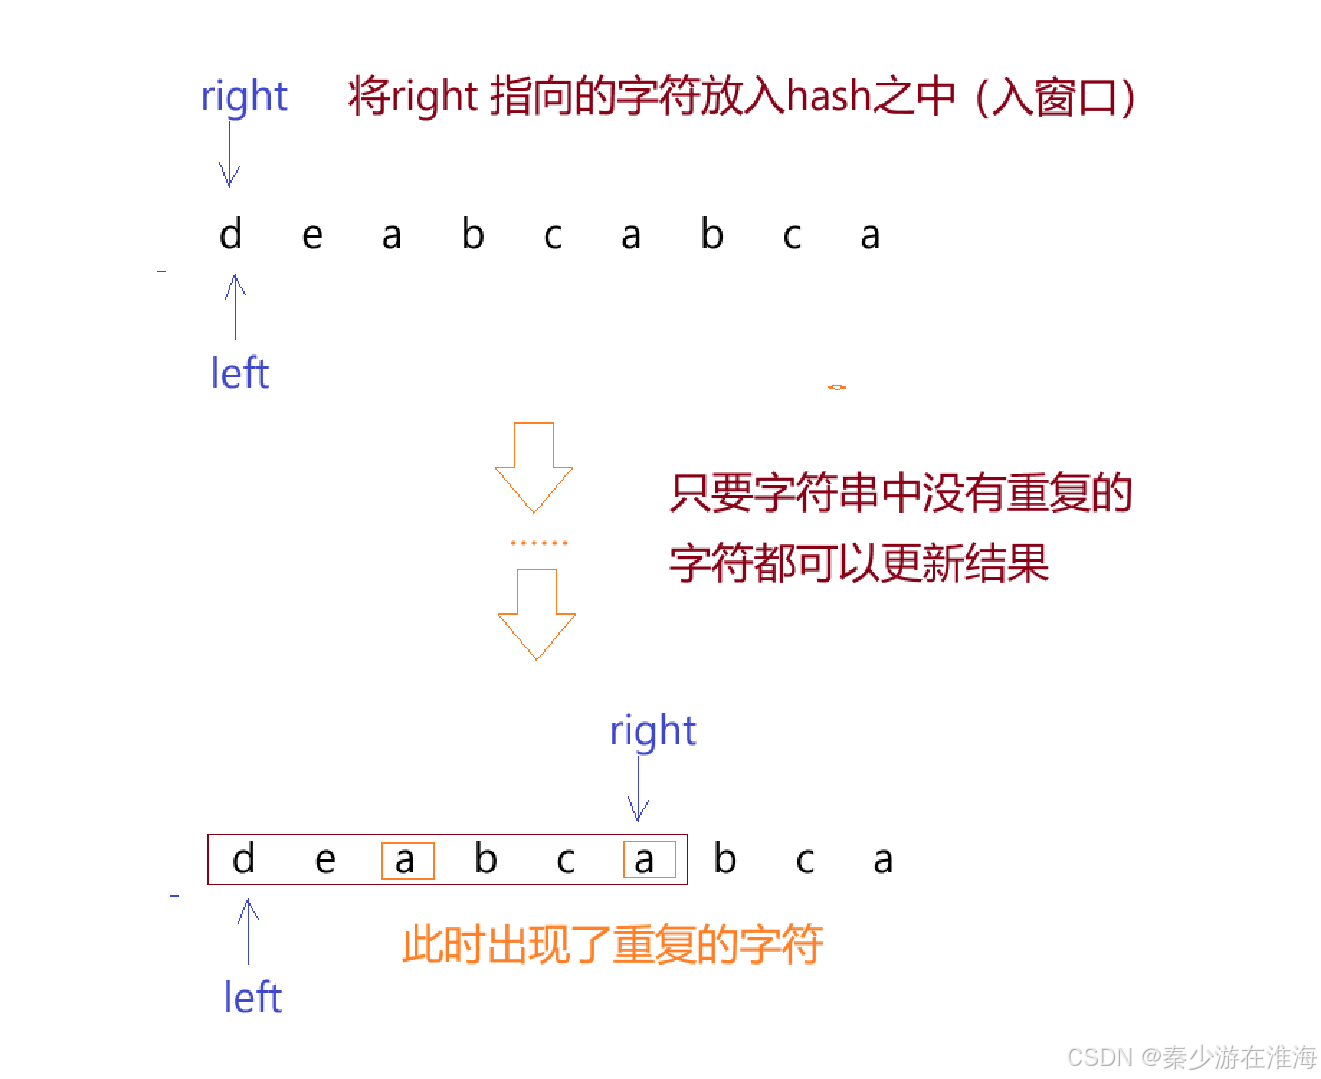
我们需要想清楚的是,当hash 之中出现了重复的字符的时候我们要怎么做?
方法一:根据暴力枚举的想法,left ++,然后right 指向left 指向的位置;
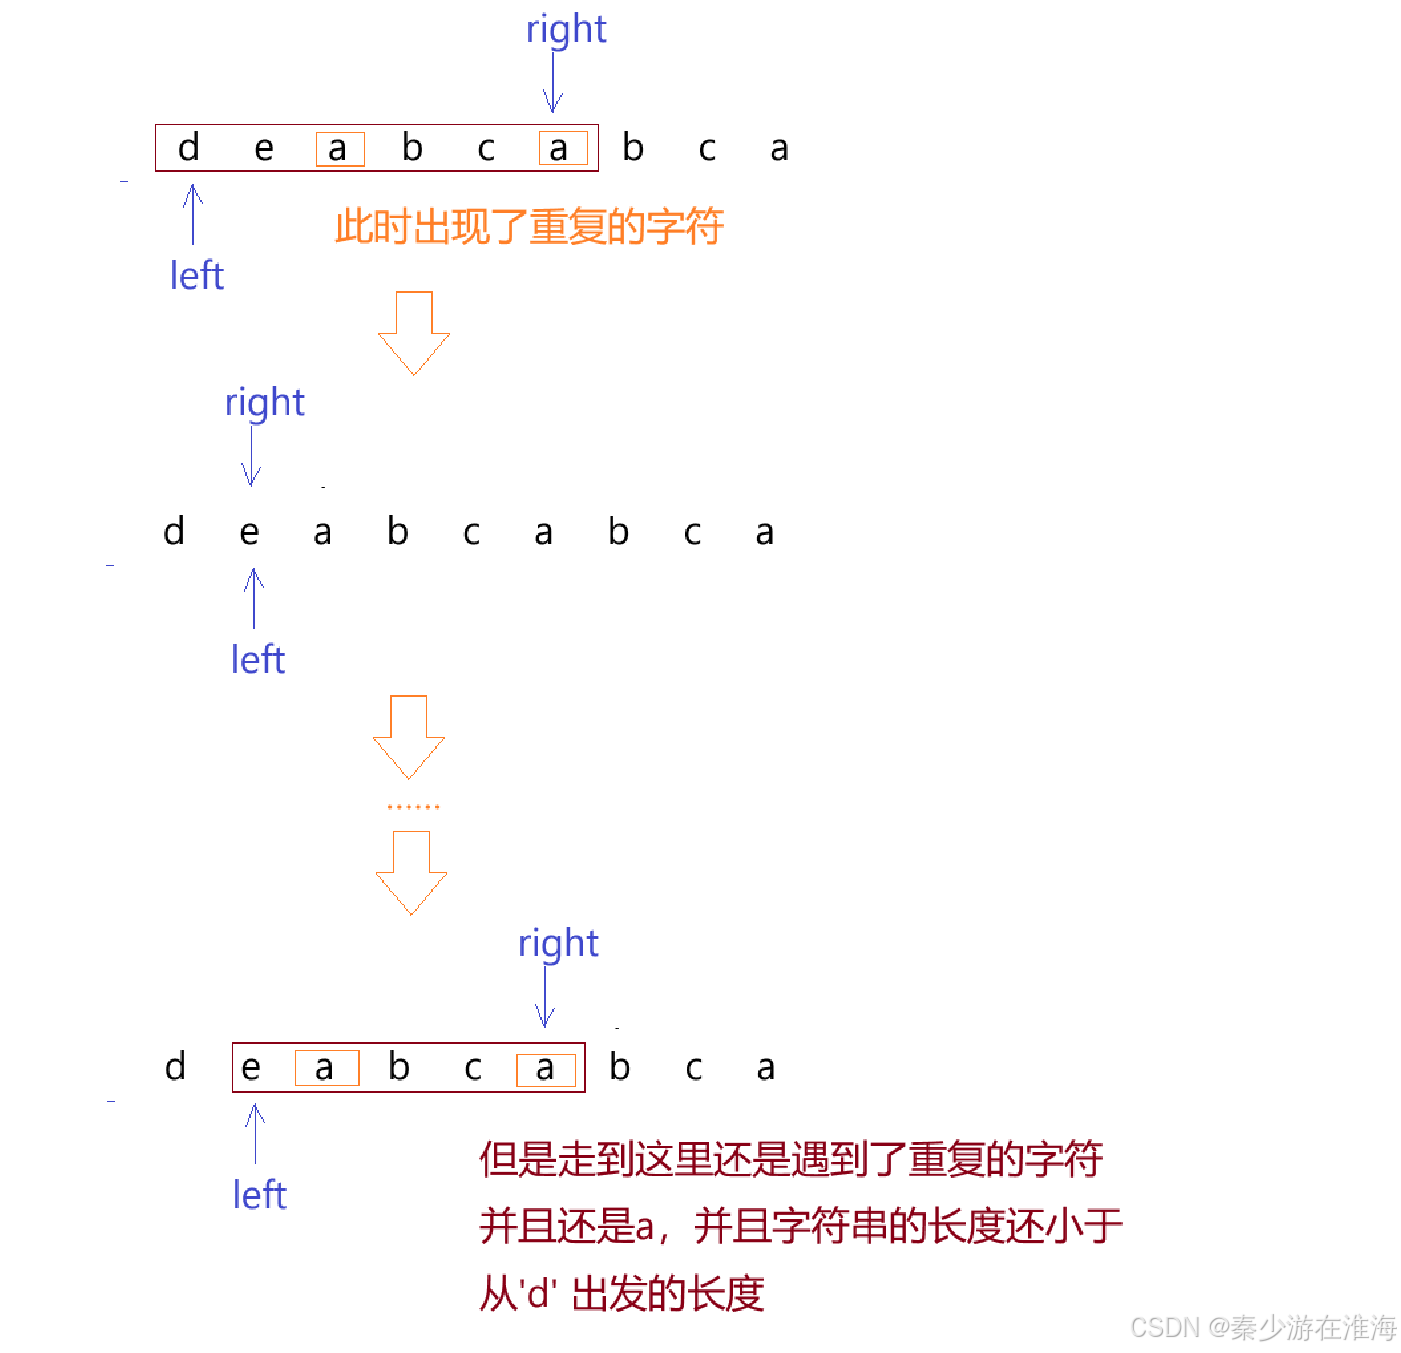
显然这种方式处理出现重复的字符的情况,不仅会有无效情况的加入,还要清空hash表重新记录,时间复杂度仍是O(N^2)
方法二:既然从方法一我们已经得知,当遇到重复的字符时,left++,right 回到left 指向的位置,还是没有解决重复字符的问题,只有越过这个重复的字符才能从根源上解决问题;
如何越过呢?
- left一直向前走,每走一步都要判断hash 之中是否还存在重复的字符,直到hash 之中没有重复的字符了,left 才停止向前走,此时出窗口结束,并且需要更新结果,图解如下:
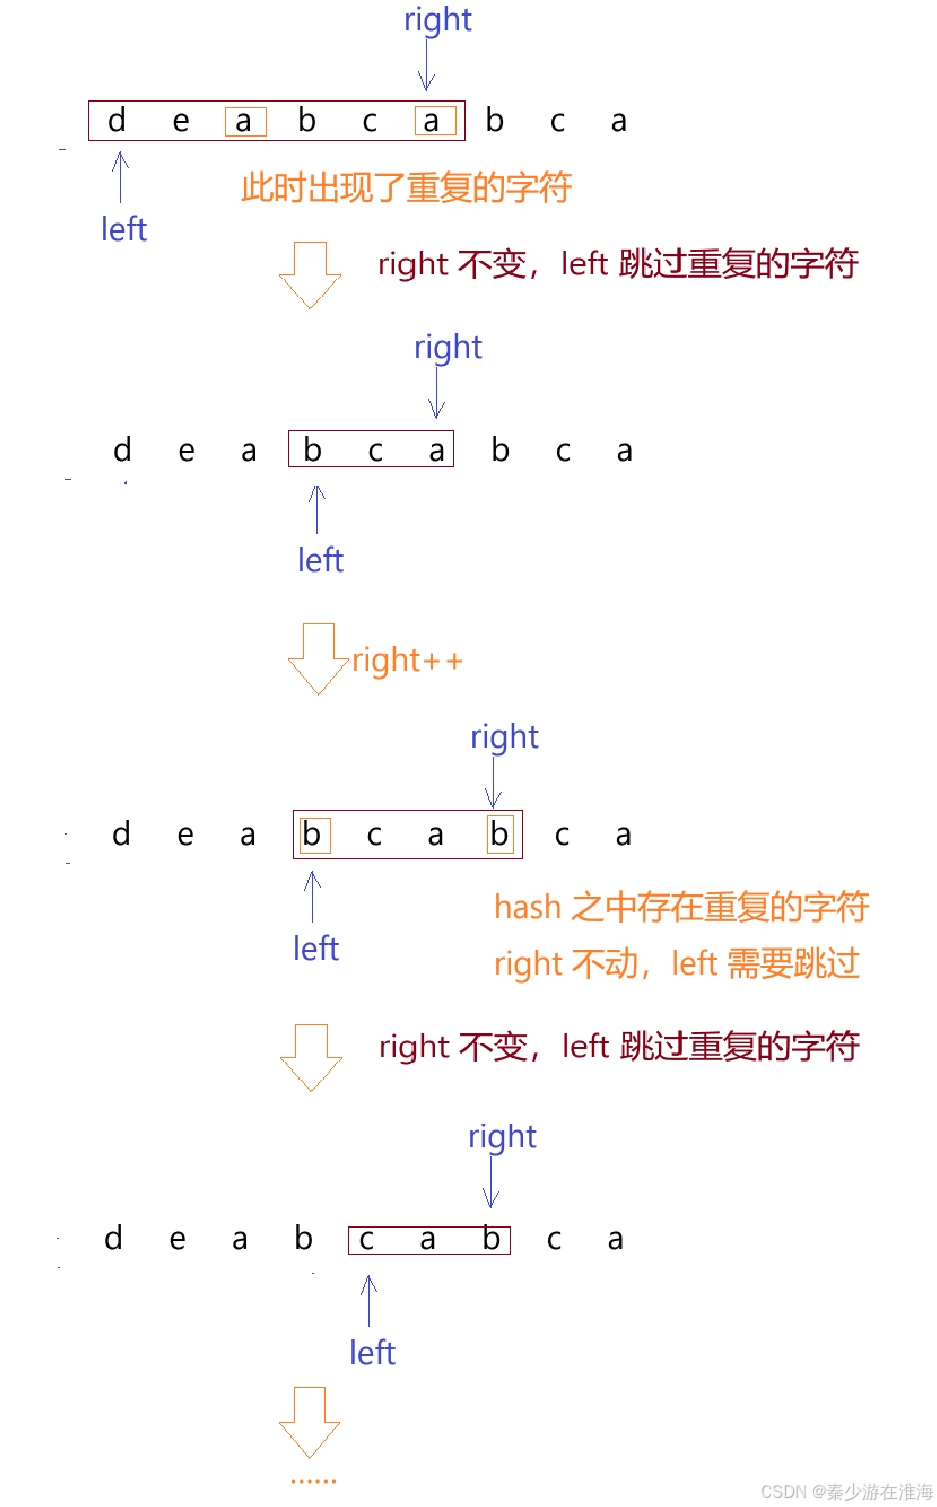
参考代码1:
    int lengthOfLongestSubstring(string s)
    {
        int n = s.size(),retlen = INT_MIN;
        //同向双指针 + hash判断窗口中是否有重复的数据
        unordered_map<char,int> hash;
        for(int left = 0 , right = 0;right < n;right++)
        {
            //入窗口
            if(hash[s[right]] == 0) hash[s[right]] = 1;
            else
            {
                hash[s[right]]++;
                //出窗口
                while(hash[s[right]]==2)
                {
                    hash[s[left++]]--;
                }
            }
            //更新结果 - 走到这里就意味着没有重复字符
            retlen = max(retlen , right-left+1);
        }
        return retlen==INT_MIN?0:retlen;
    }
由于题干说了字符串s 由英文字母、数字、符号和空格组成,所以在实现hash 的时候可以不用容器unordered_map ,可以使用128大小的整形数组,用下标来映射字符;参考代码2换成while 循环来实现,并且可以优化其代码逻辑,right 指向的字符每要入一次都要检查,那么同一个字符出现的个数最大为2,可以直接入窗口,然后再判断出窗口,走到了此处,此时窗口[left,right] 中的字符一定不会重复,所以可以更新数据,如下:
参考代码2:
    int lengthOfLongestSubstring(string s)
    {
        int n = s.size(),retlen = INT_MIN;
        //同向双指针 + hash判断窗口中是否有重复的数据
        //可以使用大小为128的字符数组来实现hash
        int hash[128] ={0};
        int left = 0 , right = 0;
        while(right < n)
        {
            //入窗口
            hash[s[right]]++;
            //判断  - 出窗口
            while(hash[s[right]]==2)
            {
                hash[s[left++]]--;
            }
            //更新结果 - 走到这里就意味着没有重复字符
            retlen = max(retlen , right-left+1);
            right++;
        }
        return retlen==INT_MIN?0:retlen;
    }
这两个参考代码的时间复杂度均为O(N);
题3 最大连续1的个数 III:
1004. 最大连续1的个数 III - 力扣(LeetCode)
题干:
数据范围:
例子:
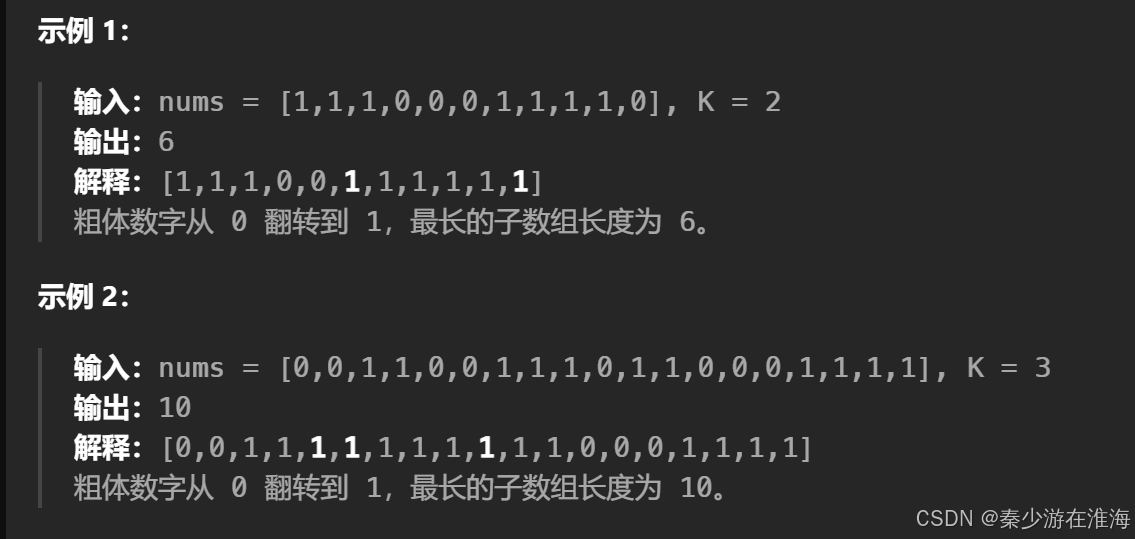
思考:
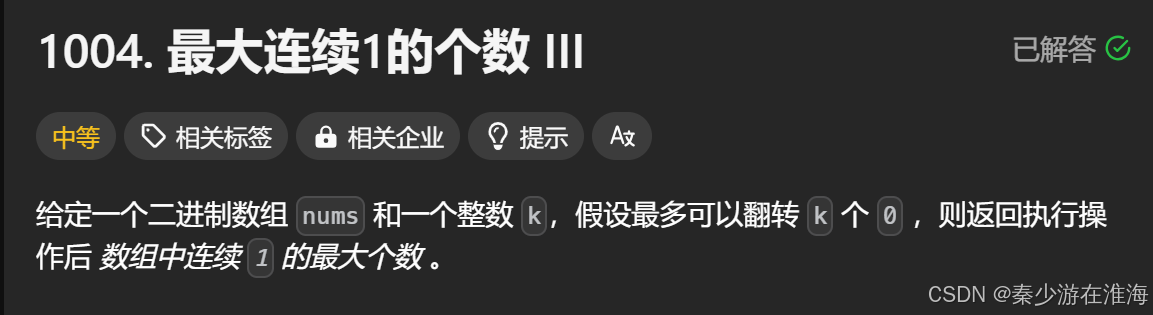
题干意思就是一个数组中只有0和1,可以将k个0变成1,求连续1的最长连续长度;
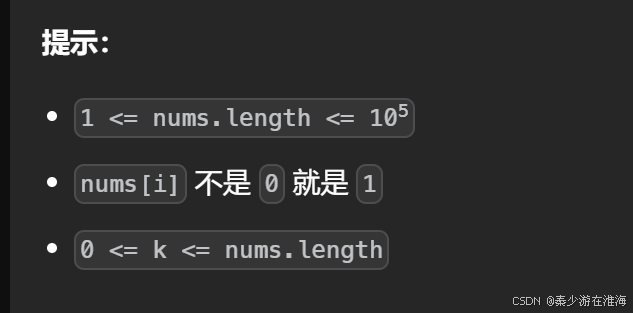
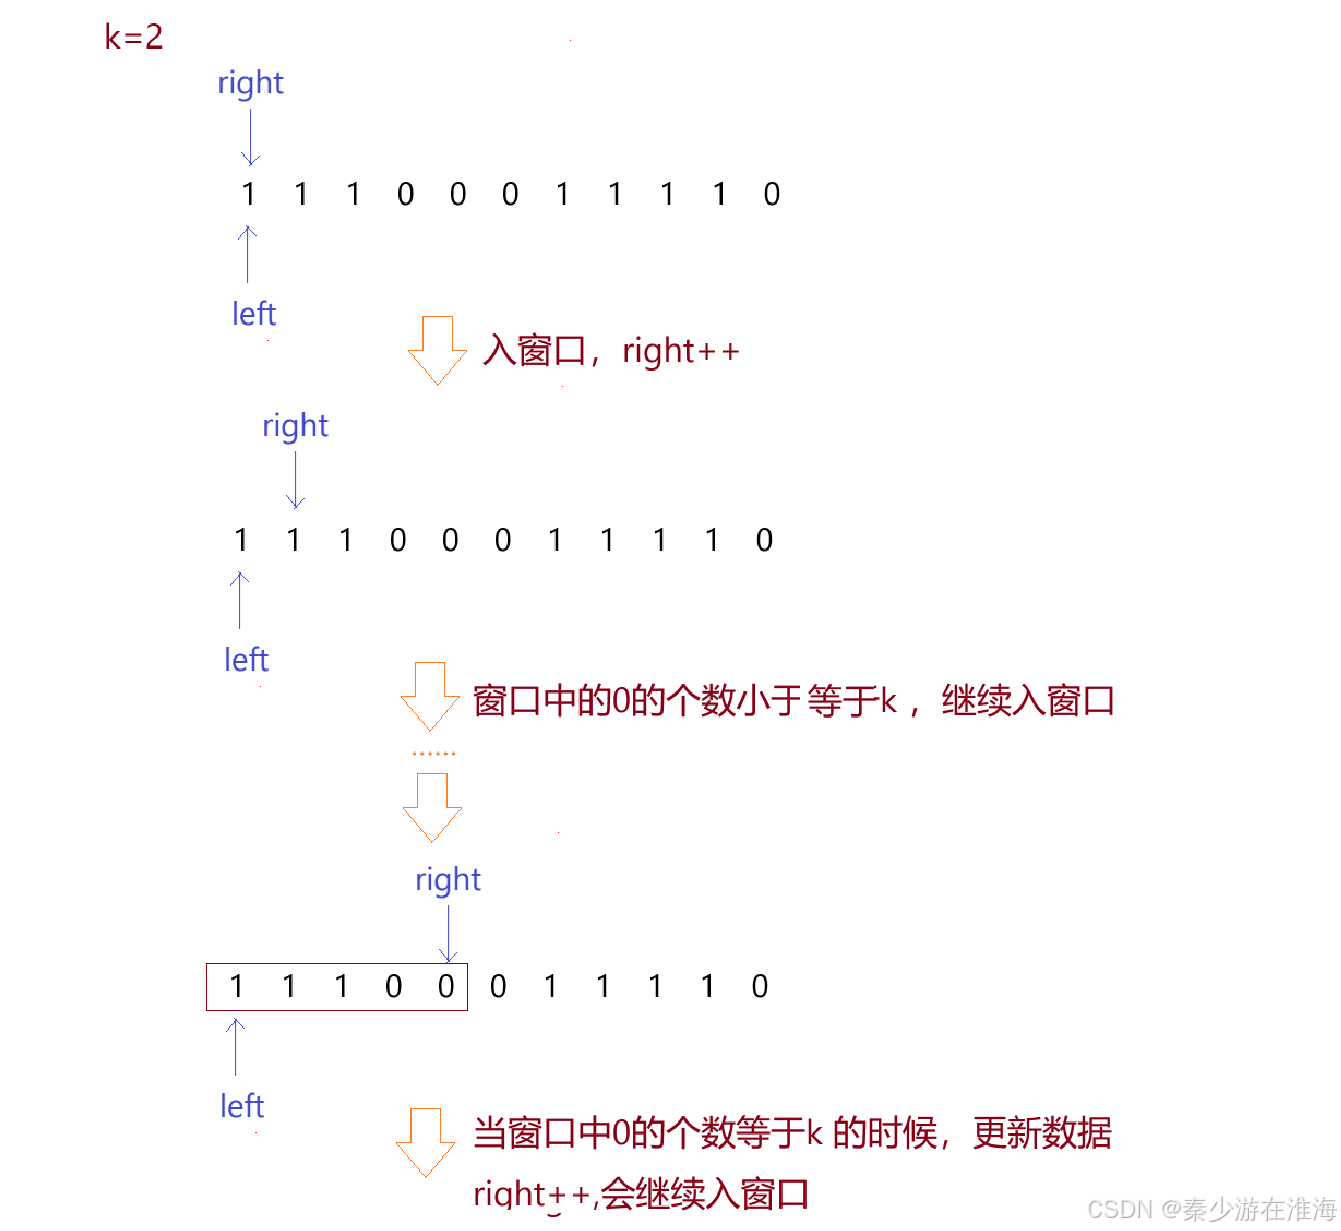
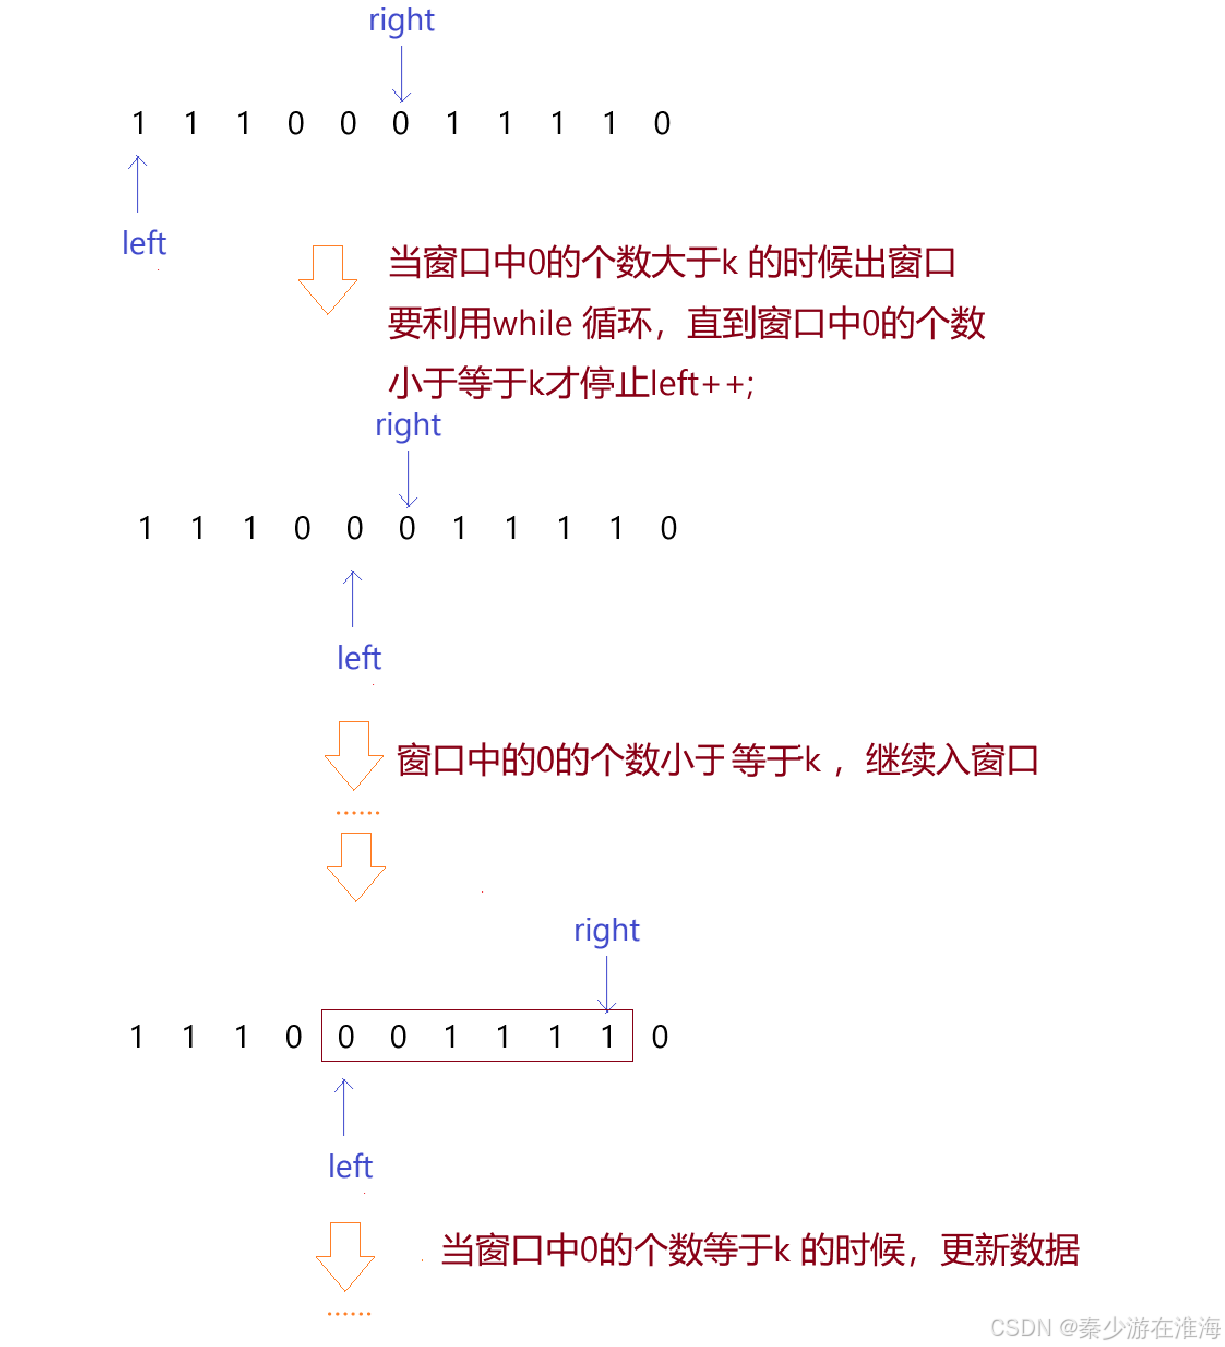
那么首先想到的肯定是暴力解法,枚举出所有的子数组,然后将子数组中k个0全部变为1,再求最长的子数组的长度;即枚举 + 判断,经过前面两道题的练习不难想到,想要高效地枚举,可以利用同向双指针来解决;而至于判断窗口中将k 个0变为1能否构成全1,可以借助于窗口的总数与数据个数的关系,例如:假设窗口中的数据有5个,k为3,那么该窗口中的数据总和的范围为[2,5] ,即[n-k,n] 一旦不在这个范围就一定不能构成连续1的子数组;那这样的话,时间复杂度依旧是O(N^2),因为没有实质性地解决枚举的消耗高的问题,需要砍掉一些可能性来降低时间复杂度;那么就得从k 入手,当窗口中的0的个数大于k个的时候,出窗口,图解如下:
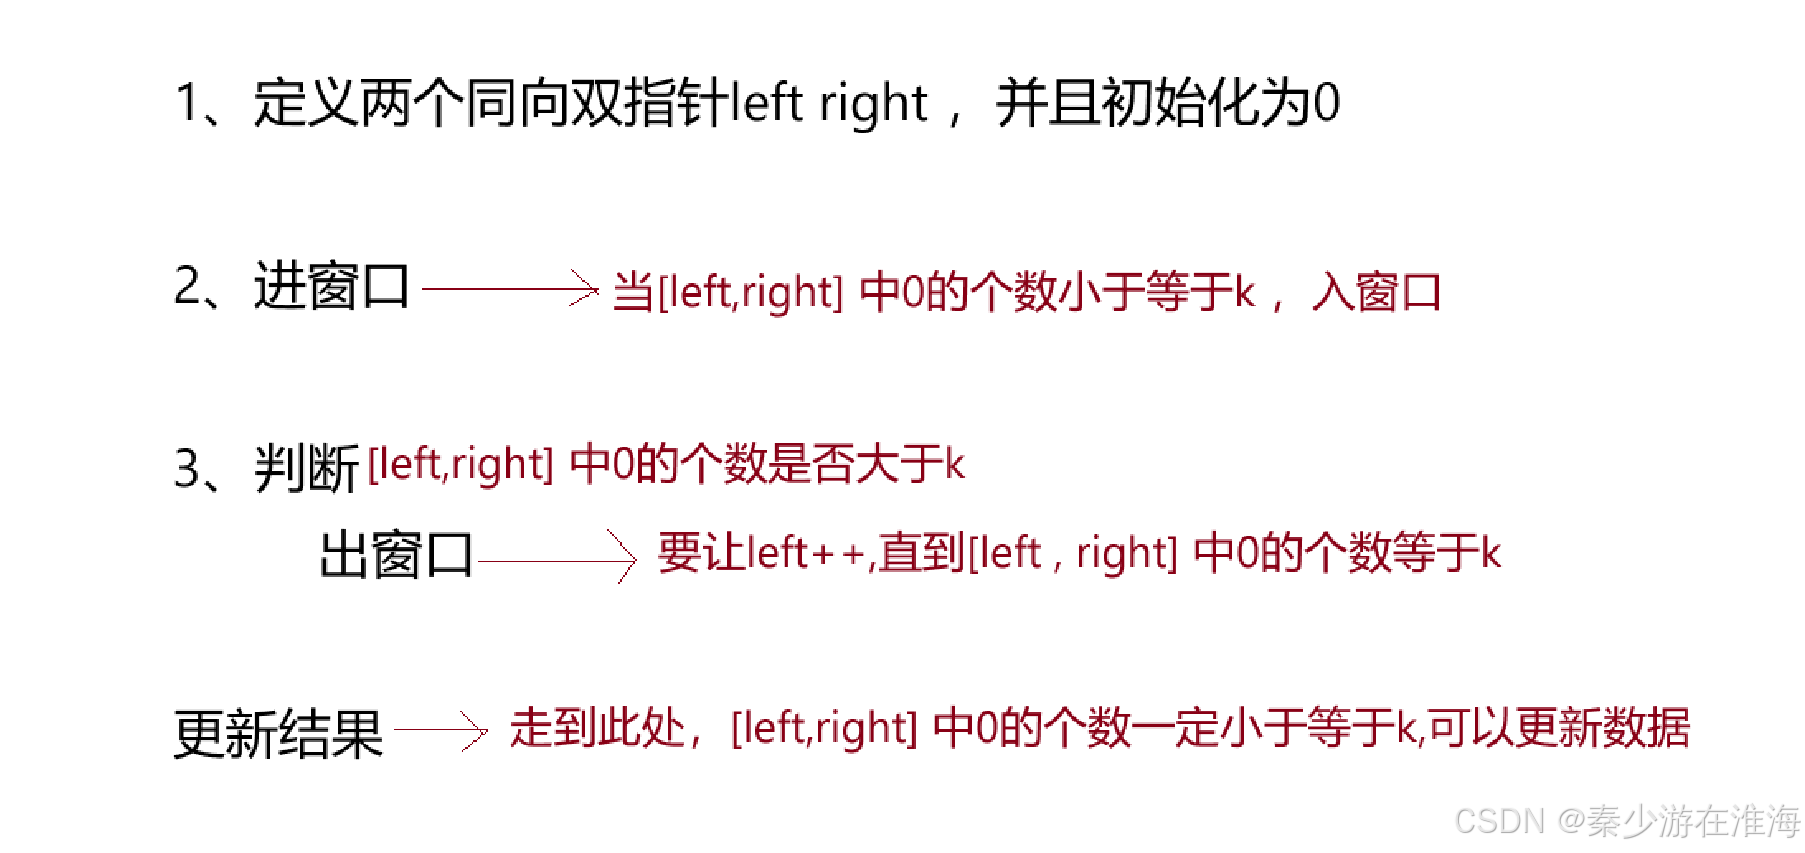
思路总结:
参考代码:
    int longestOnes(vector<int>& nums, int k)
    {
        int n = nums.size(),count = 0, retlen = INT_MIN;
        //同向双指针 + 一个变量来记录窗口中0的个数
        for(int left =0 , right = 0; right < n;right++)
        {
            //入窗口
            if(nums[right]==0) count++;
            while(count>k)
            {
                if(nums[left]==0) count--;
                left++;
            }
            //此时窗口中0的个数一定合法,可以更新数据
            retlen = max(right-left+1, retlen);
        }
        return retlen;//因为数组中至少有一个数据,所以不用判断retlen 是否会为INT_MIN
    }
可以再简洁该代码,如下:
    int longestOnes(vector<int>& nums, int k)
    {
        int n = nums.size(),retlen = INT_MIN;
        //同向双指针 + 一个变量来记录窗口中0的个数
        for(int left =0 , right = 0,count = 0; right < n;right++)
        {
            //入窗口
            if(nums[right]==0) count++;
            while(count>k)
                if(nums[left++]==0) count--;
            //此时窗口中0的个数一定合法,可以更新数据
            retlen = max(right-left+1, retlen);
        }
        return retlen;//因为数组中至少有一个数据,所以不用判断retlen 是否会为INT_MIN
    }
题4 将 x 减到 0 的最小操作数:
1658. 将 x 减到 0 的最小操作数 - 力扣(LeetCode)
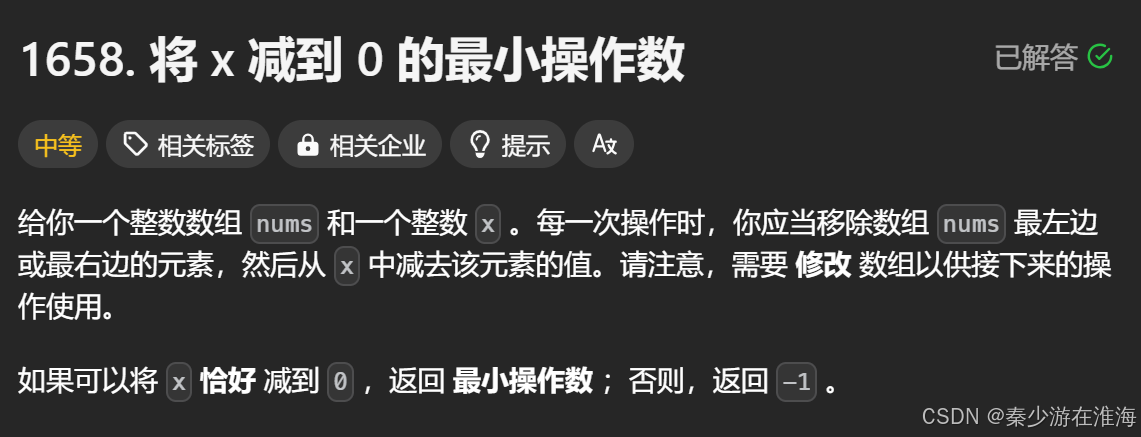
题干:
数据范围:
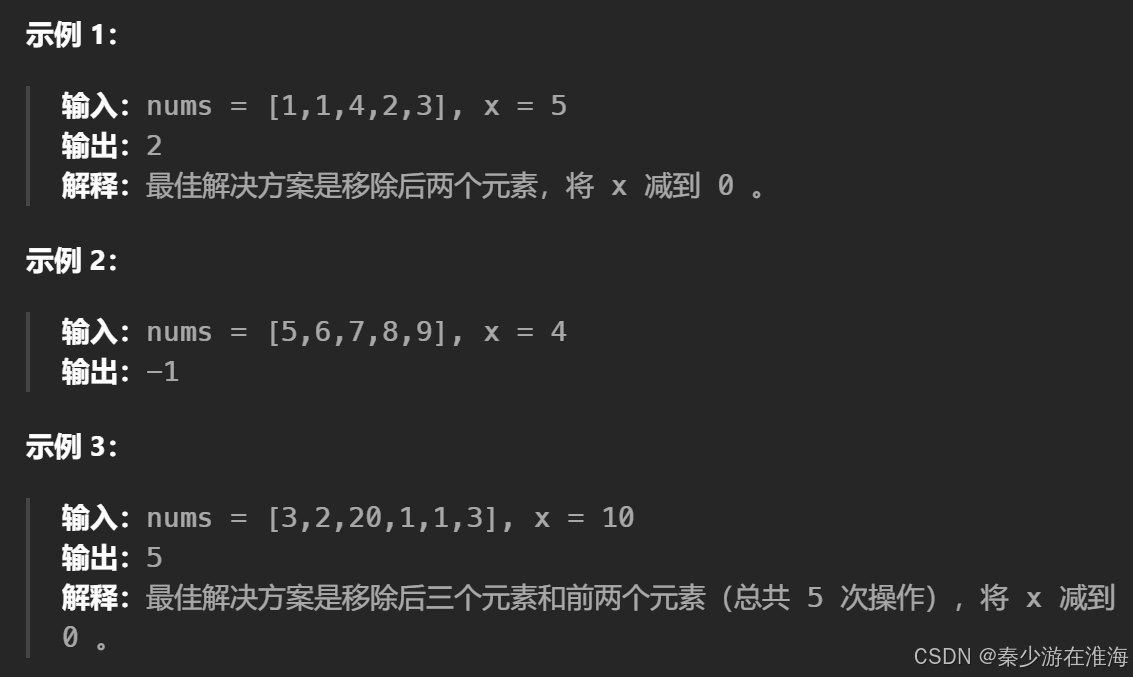
例子:
思考:
从nums 的最左边或者最右边选择一个数据,让x 减去,求让x 减为0的最少选数次数;
我们先来思考一下如何才可以让x减去一些数之后值为0?
- 显然这些数相加要为x。
那么最少的操作次数呢?
- 用最少的数相加为x;
那么每次只能选最左边或者最右边的数据该如何解决呢?
- 首先我们想到的是在左右两边均设置一个指针,一个一个地试。
但是选这个数的时候我们怎么知道这个数合不合适呢?
显然这是非常矛盾的;画图再分析一下:
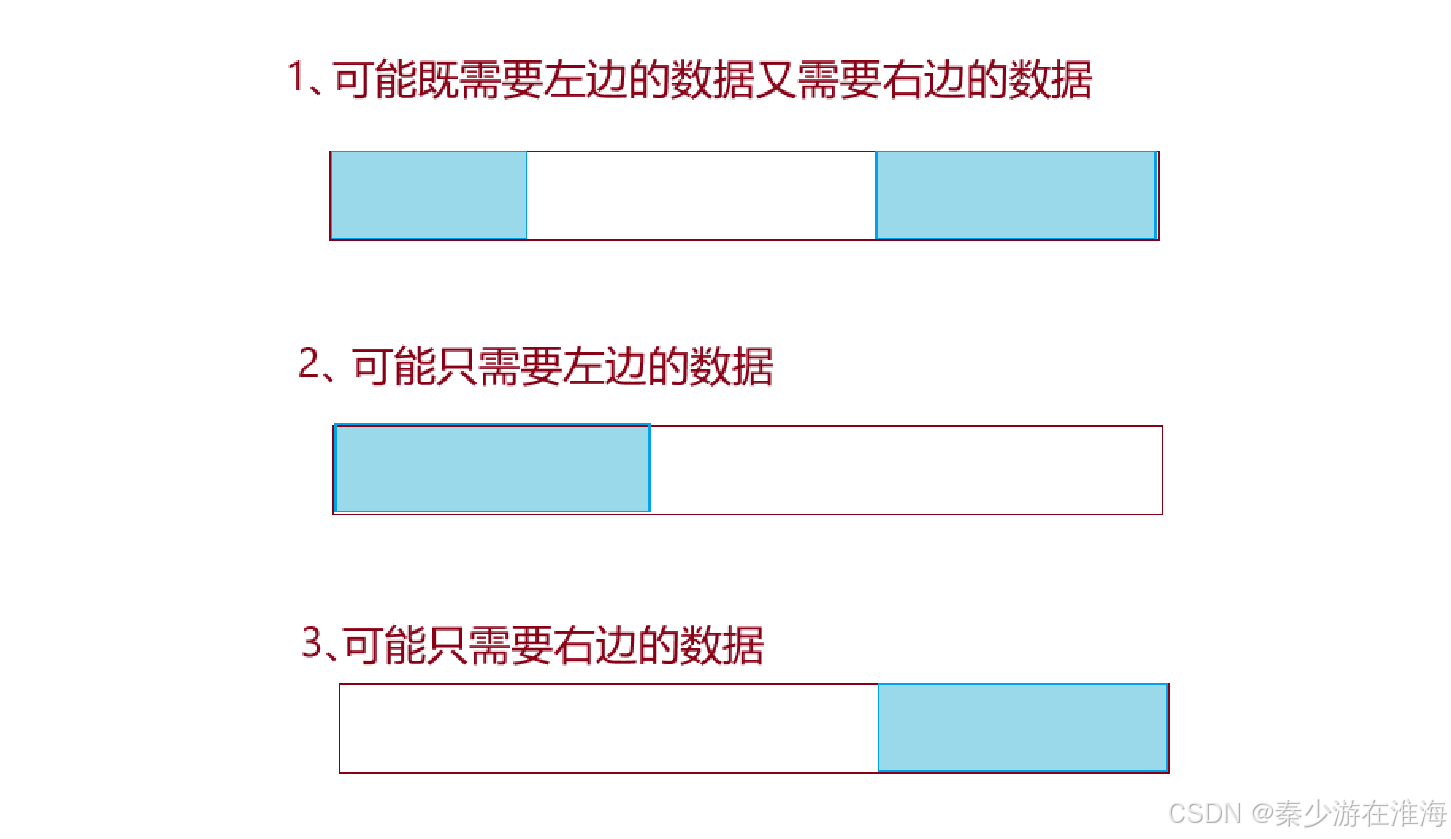
所得到的结果无非就是这三种情况中的一个,其共同点都是需要蓝色区域中的数据相加和为x ,并且求该区域中数据的最少个数,那么空白区域中数据的和为 sum-x ,则反过来就是求空白区域的最多数据个数;
而,空白区域无论在哪一个情况下均是连续的区域,我们是否可以将题干中的意思进行转换?换一个角度解决问题?
题干转换:找出nums中最长的和为(sum-x) 的子数组的长度;
解法一:暴力解法 + 计算和
枚举出所有子数组的情况,并计算其和是否等于 (sum-x) ,并且求出最长的和为 (sum-x)的 子数组的长度;
解法一一定是首先就能想到的解法,但是经过前面三道题的训练,应该可以敏感地感知,此处还可以用同向双指针进行优化,即解法二;
解法二:根据暴力解法进行优化
由题干中的信息可以知道,nums 中的数据均为正整数,所以数据就已经有了天然的单调性-> 数据的个数越多,其和越大;可以利用同向双指针来解决,假设同向双指针为left ,right ,范围[left,right] 中的数据总和为sum ,当sum > target 的时候,就要减少窗口中的数据个数来以此减小sum,即在left 窗口,出窗口可能会多次操作,故而应该用循环解决;当sum < target ,应该增加窗口中的数据个数来增大sum ,所以从right 处入窗口;当sum == target 的时候,就是我们的目标情况,此时需要更新数据;其中target 在本题中为nums 的总和减去x;
思路总结:
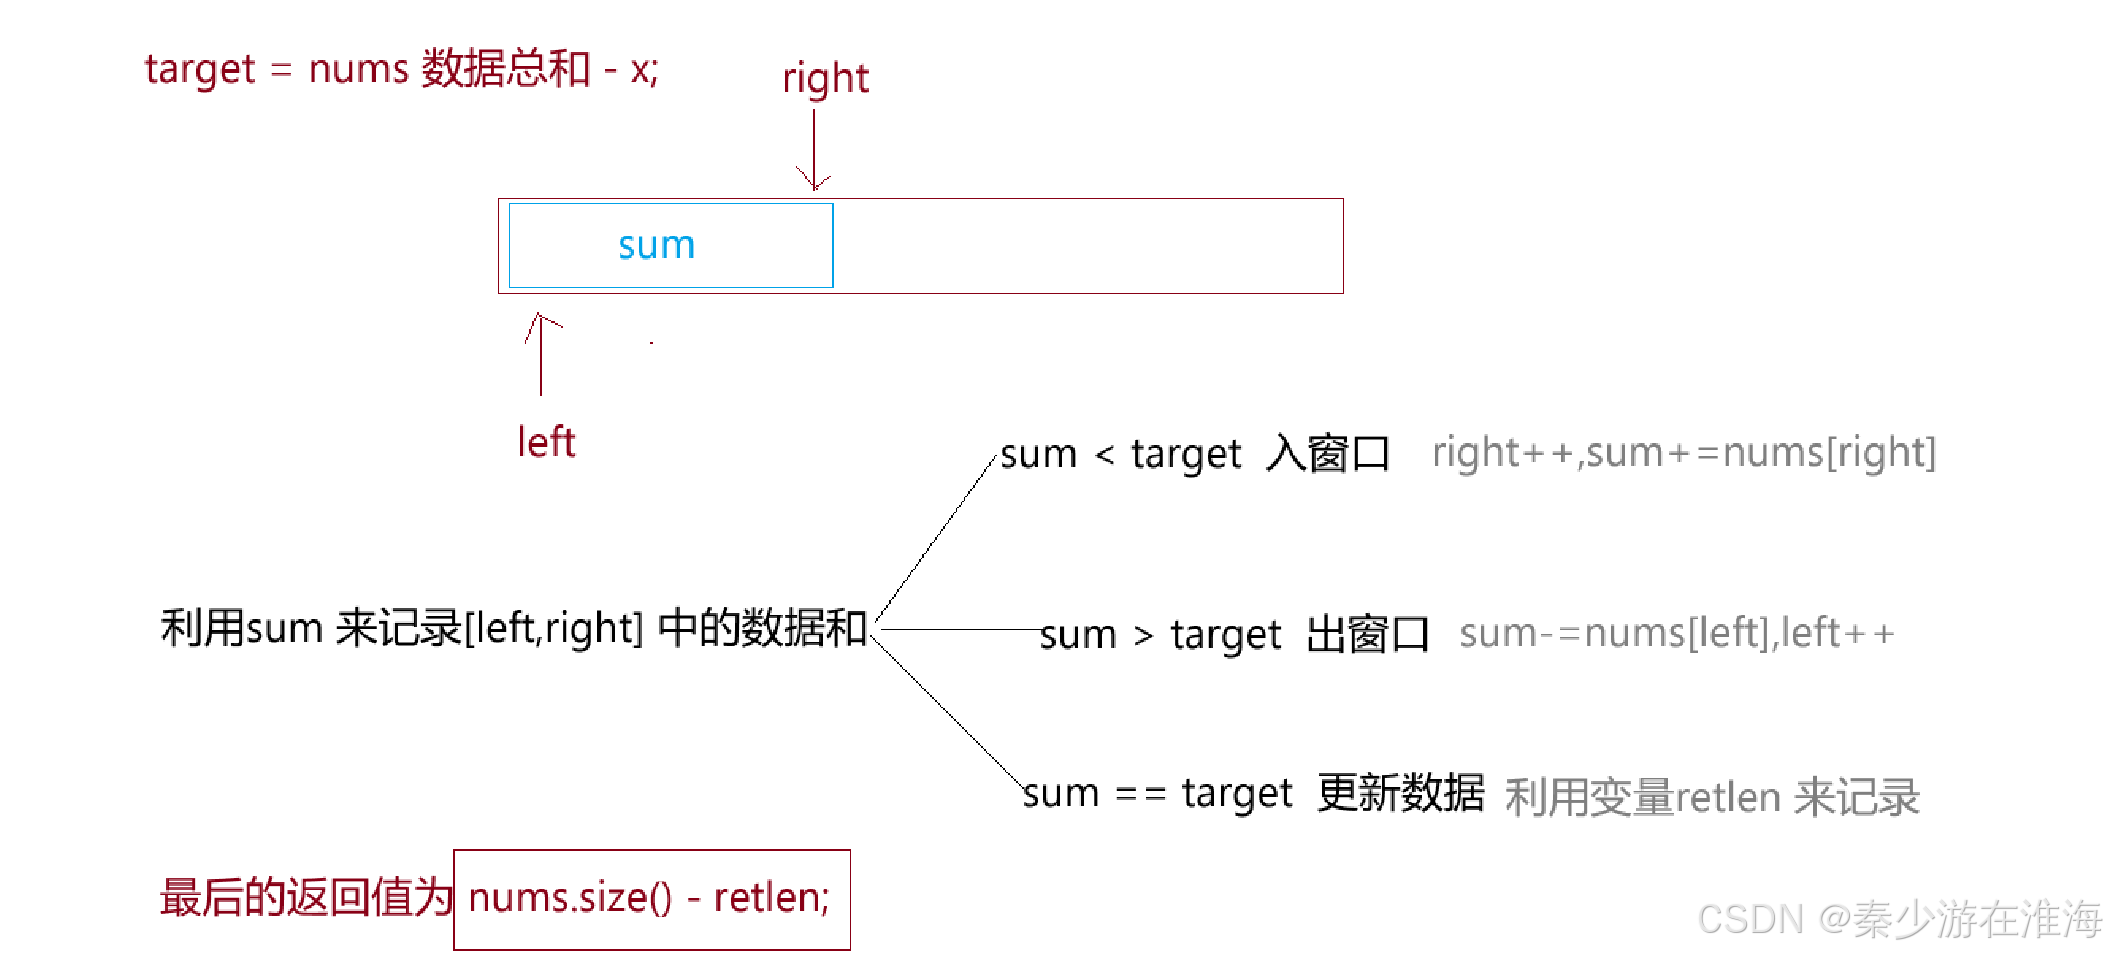
还有一个细节的地方,如果题干所要求的x 本身就大于nums 中的数据总和,那么是一定在nums 中找不到数据相加结果为x , 直接返回-1即可;
参考代码:
    int minOperations(vector<int>& nums, int x)
    {
        //转换题意:t:nums总和-x ,寻找和为t 的最多数据个数的子数组
        int sumnums = 0, n = nums.size();
        for(auto e: nums) sumnums+=e;
        int target = sumnums - x;
        //如果x大于nums中左右数据的总和是一定找到不的;
        if(target < 0) return -1;
        int left = 0, right = 0, sum = 0 , retlen = INT_MIN;//同向双指针
        while(right < n)
        {
            //入窗口
            sum += nums[right];
            //判断sum 与 target 的大小关系,决定是否要出窗口
            while(sum > target)
            {
                sum-=nums[left++];
            }
            //如果sum == target 就更新数据
            if(sum == target) retlen = max(retlen , right-left+1);
            right++;
        }
        //retlen 可能还是为INT_MIN,就说明没有找到
        if(retlen == INT_MIN) return -1;
        else return n - retlen;
    }
题5 水果成篮:
题干:
数据范围:
例子:
思考;
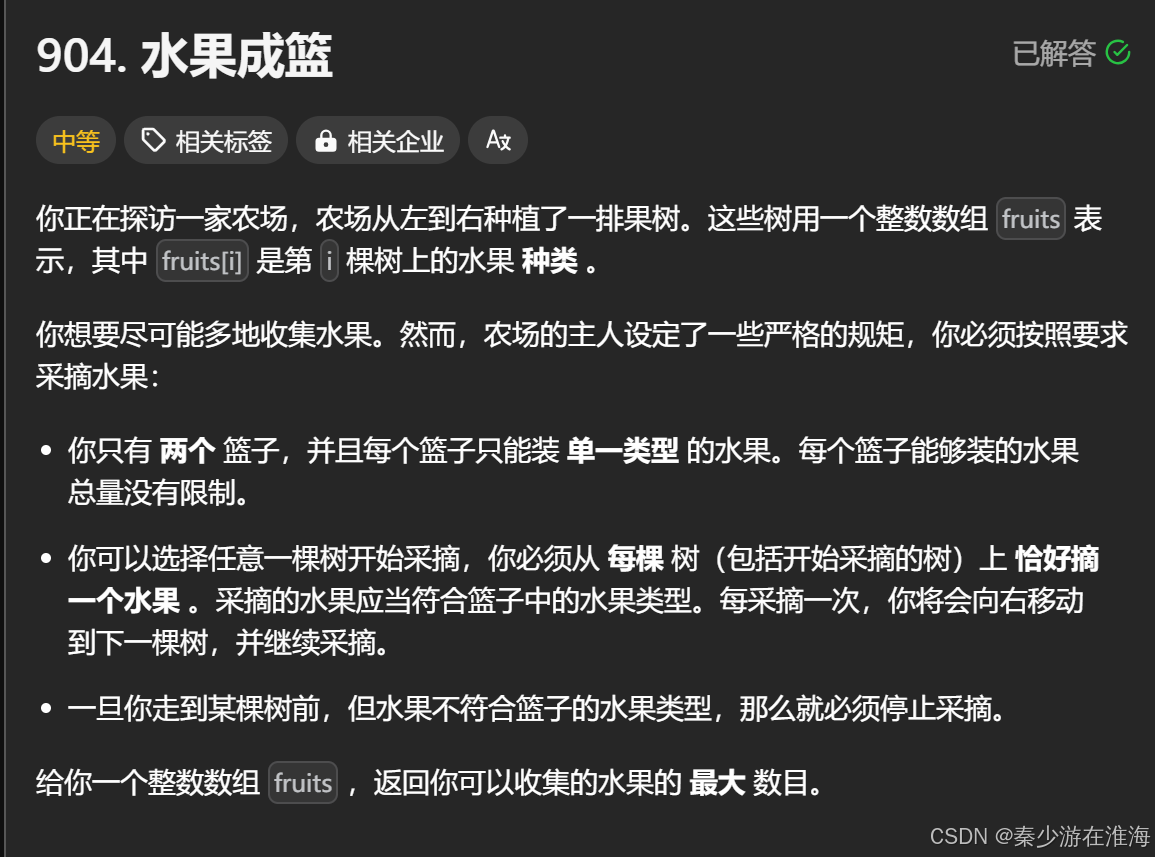
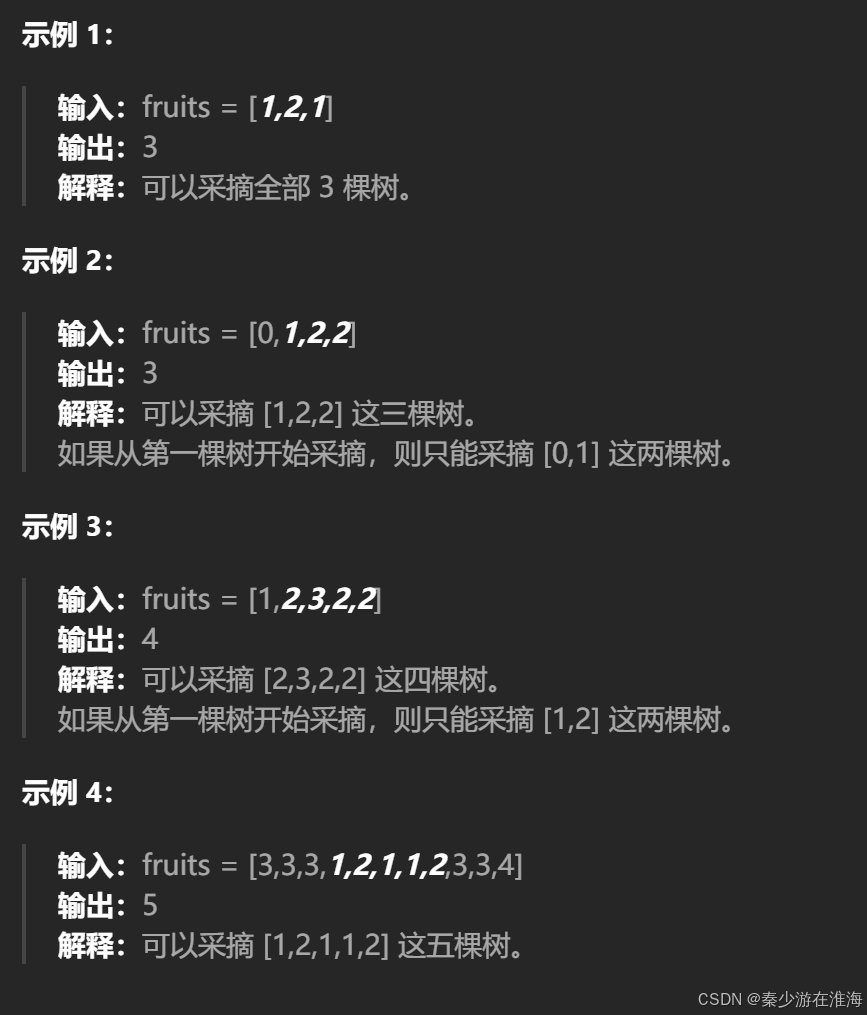
题干的意思可以提炼为:从正整数数组nums的任意一个位置开始,向右连续地选数,只能选两种数,求最多地数据个数,窗口[left,right] 中只能有两种数字;
注:此处的nums 表示题干中的数组fruits,用nums 来解释比较好理解,下文的阐述中也是用nums 代表 fruits 来阐述的;
解法一:暴力解法:
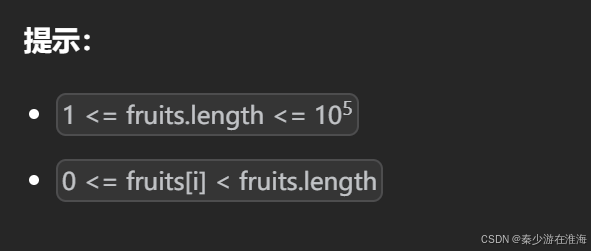
枚举出所有的子数组,判断该子数组中是否只存在两种数字,并且求满足条件的最长的子数组长度;枚举就不用多说,固定一个位置挨个枚举即可;如何判断一个区间中的数据种类?利用哈希表来解决;根据数据范围可以得知,数组nums 中最大的数值为99999,可以是开辟大小为100001的数组当作哈希表,也可以利用容器unordered_map 来解决;
看到连续的子数组的题目,我们肯定可以联想到为可以利用同向双指针来解决,从暴力解法上进行优化;
解法二:同向双指针 - 滑动窗口
需要利用变量kinds统计窗口中的数据种类,当kinds 小于等于2 的时候继续入窗口,当kinds大于2的时候出窗口,kinds 合法的时候就要更新数据;其实很像本博文中的题2 无重复字符的最长子串,只不过两个判断出窗口时的条件不同;
此处就不赘述了,思想真的一模一样;
参考代码1:
    int totalFruit(vector<int>& fruits)
    {
        int n= fruits.size();
        //hash
        unordered_map<int,int> hash;
        int left = 0, right = 0, retlen = INT_MIN, kinds = 0;
        while(right < n)
        {
            //入窗口
            hash[fruits[right]]++;
            if(hash[fruits[right]] == 1) kinds++;
            //判断是否要出窗口
            while(kinds>2)
            {
                hash[fruits[left]]--;
                if(hash[fruits[left]]==0) kinds--;
                left++;
            }
            //到了此处的kinds一定合法,更新数据
            retlen = max(retlen , right - left +1);
            right++;
        }
        //因为fruits 中至少有一个数,直接范围即可不用进行判断
        return retlen;
}实际上我们利用unordered_map容器来实现哈希表就可以不使用变量来记录窗口中的数据种类,直接使用接口函数 size() 、erase() 等来实现就可以了,如下:
参考代码2:
    int totalFruit(vector<int>& fruits)
    {
        int n= fruits.size();
        //hash
        unordered_map<int,int> hash;
        int left = 0, right = 0, retlen = INT_MIN;
        while(right < n)
        {
            //入窗口
            hash[fruits[right]]++;
            //判断是否要出窗口
            while(hash.size()>2)
            {
                hash[fruits[left]]--;
                if(hash[fruits[left]]==0) hash.erase(fruits[left]);
                left++;
            }
            //到了此处的kinds一定合法,更新数据
            retlen = max(retlen , right - left +1);
            right++;
        }
        //因为fruits 中至少有一个数,直接范围即可不用进行判断
        return retlen;
}实际上在unordered_map 中频繁地插入、删除,效率十分低下,可以这么说,参考代码2的效率没有参考代码1 的高,此处还有一种写法,就是hash 用数组来实现,用空间换时间,直接开辟大小为100001的空间,最终代码与参考代码1如出一辙,只不过是hash 实现的不同罢了;
参考代码3:
    int totalFruit(vector<int>& fruits)
    {
        int n= fruits.size();
        //hash
        int hash[100001] = {0};
        int left = 0, right = 0, retlen = INT_MIN, kinds = 0;
        while(right < n)
        {
            //入窗口
            hash[fruits[right]]++;
            if(hash[fruits[right]] == 1) kinds++;
            //判断是否要出窗口
            while(kinds>2)
            {
                hash[fruits[left]]--;
                if(hash[fruits[left]]==0) kinds--;
                left++;
            }
            //到了此处的kinds一定合法,更新数据
            retlen = max(retlen , right - left +1);
            right++;
        }
        //因为fruits 中至少有一个数,直接范围即可不用进行判断
        return retlen;
    }
题6 找到字符串中所有字母异位词:
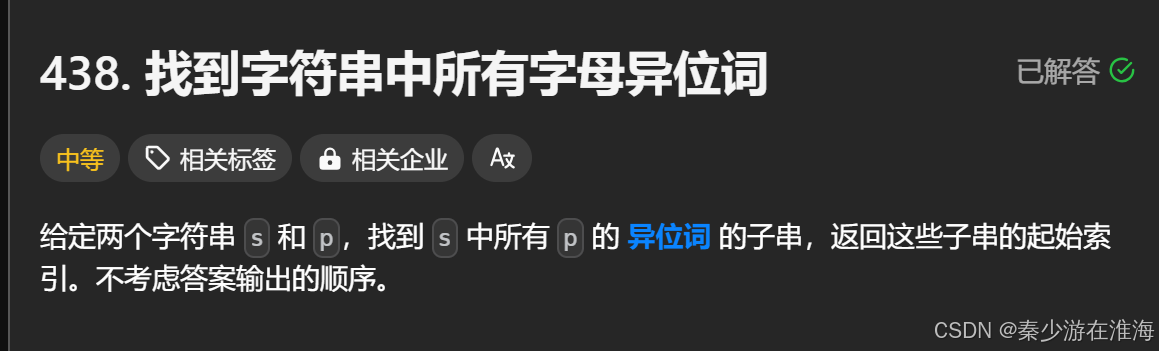
438. 找到字符串中所有字母异位词 - 力扣(LeetCode)
题干:
数据范围:
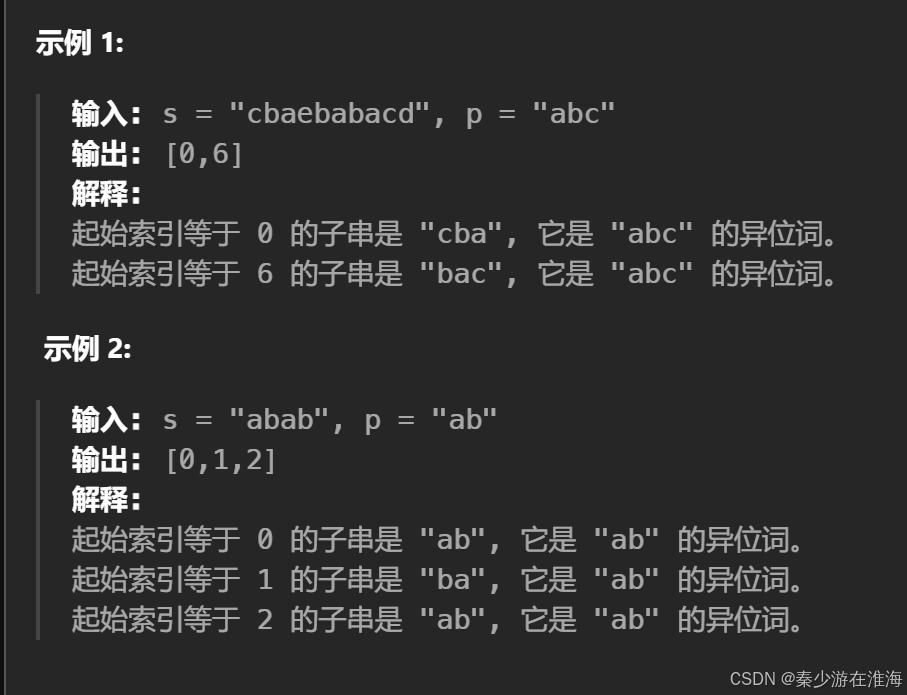
例子:
思考:
即在字符串s 中找有字符串p 中字符构成的子串,返回首字母的下标;
Q:如何判断两个字符串是否为”异位词“?
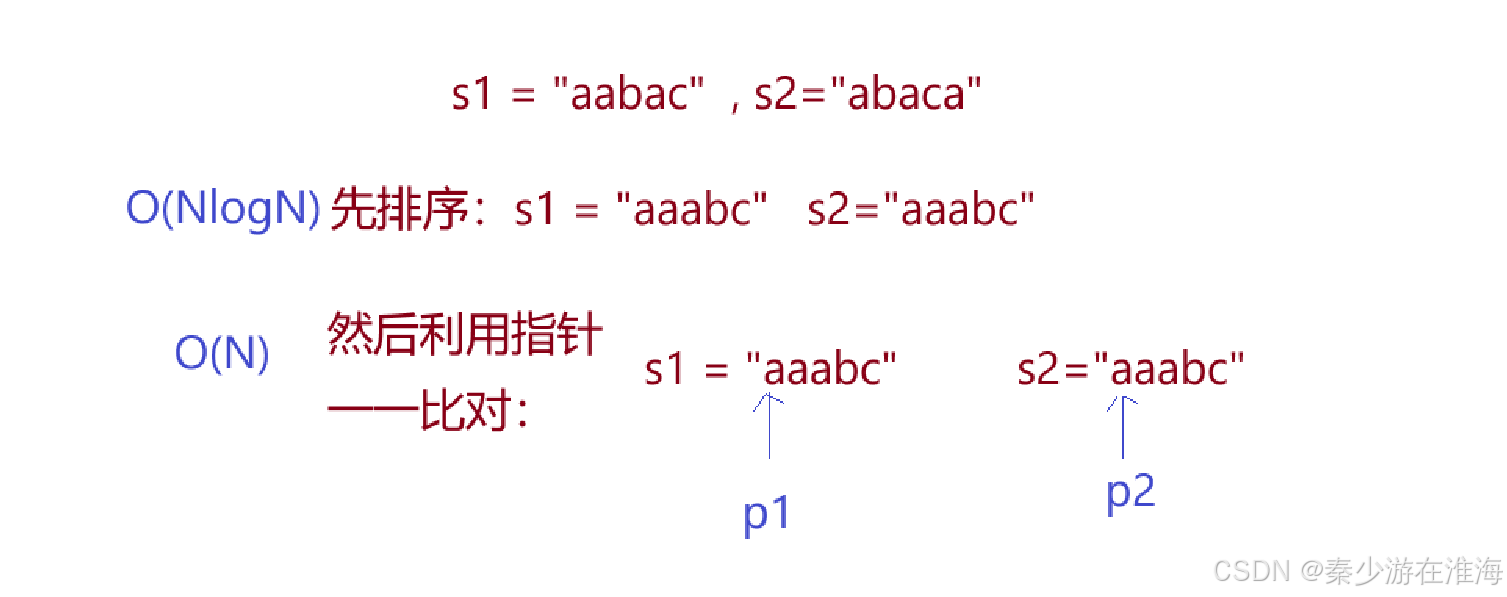
eg: s1 = "aabac" , s2="abaca"
方法一:先为这两个字符串排序,然后利用两个指针对其内容进行一一比对;时间复杂度为O(Nlogn+N),如下:
方法二:不考虑每个字符串中的字符的顺序怎么样,只是判断这两个字符串中的字符种类与个数是否相同即可,如下:
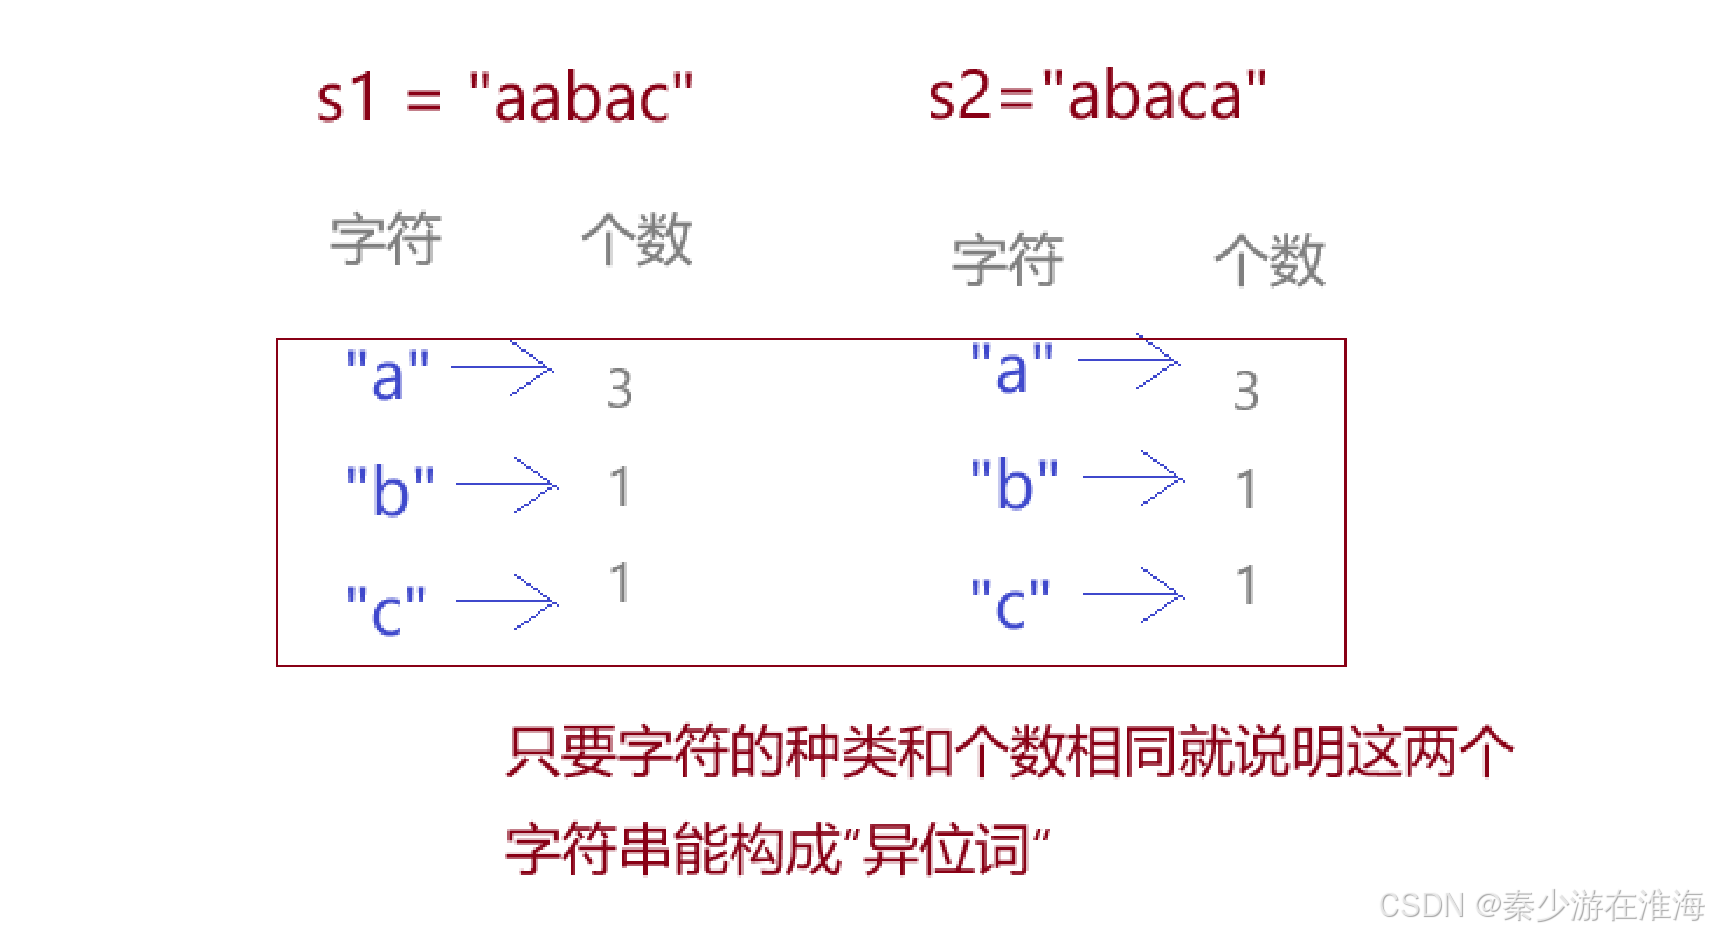
而至于如何判断,我们可以借助于哈希表来实现;
解法一:暴力解法
暴力枚举出字符串s 中所有子串的情况,然后利用hash表来判断列举出来的子串是否与字符串p构成”异位词“;
创建两个哈希表 hash1 与 hash2 , 先将字符串p 中的字符放入hash2 之中,然后再将列举出来的子串放入hash1 之中,最后再比较hash1 与 hash2是否相等即可;相等的,便可以将该子串的首字符下标放入返回的数组之中;
我们现在思考的是能否在暴力解法的基础上进行优化?首先是枚举出所有的子串,实际上有些子串根本就没有枚举的必要,例如已知这个子串中出现了非字符串p 中的字符;基于这点,如果哈希表是用容器unordered_map 实现的话,就可以使用接口函数 count() 来查找hash2 中是否有这个字符;而维护一段连续的区域,我们不难想到会使用同向双指针来解决;
解法二:同向双指针 + hash
Q:如何比较两个哈希表是否相同?
因为题干说了字符串中的字符全为小写字符,所以还可以使用大小为26 的数组来实现hash;
解决方法一:直接比较,若哈希表用数组实现的话,比较26次就可以了;
如若哈希表用unordered_map 实现的话,就需要设置一个变量来统计窗口中有效数据的个数,并且在统计的时候还需要结合hash2与hash1 字符的个数来实现;那么同样的,再增加一个变量记录窗口中有效数据的个数就可以了;
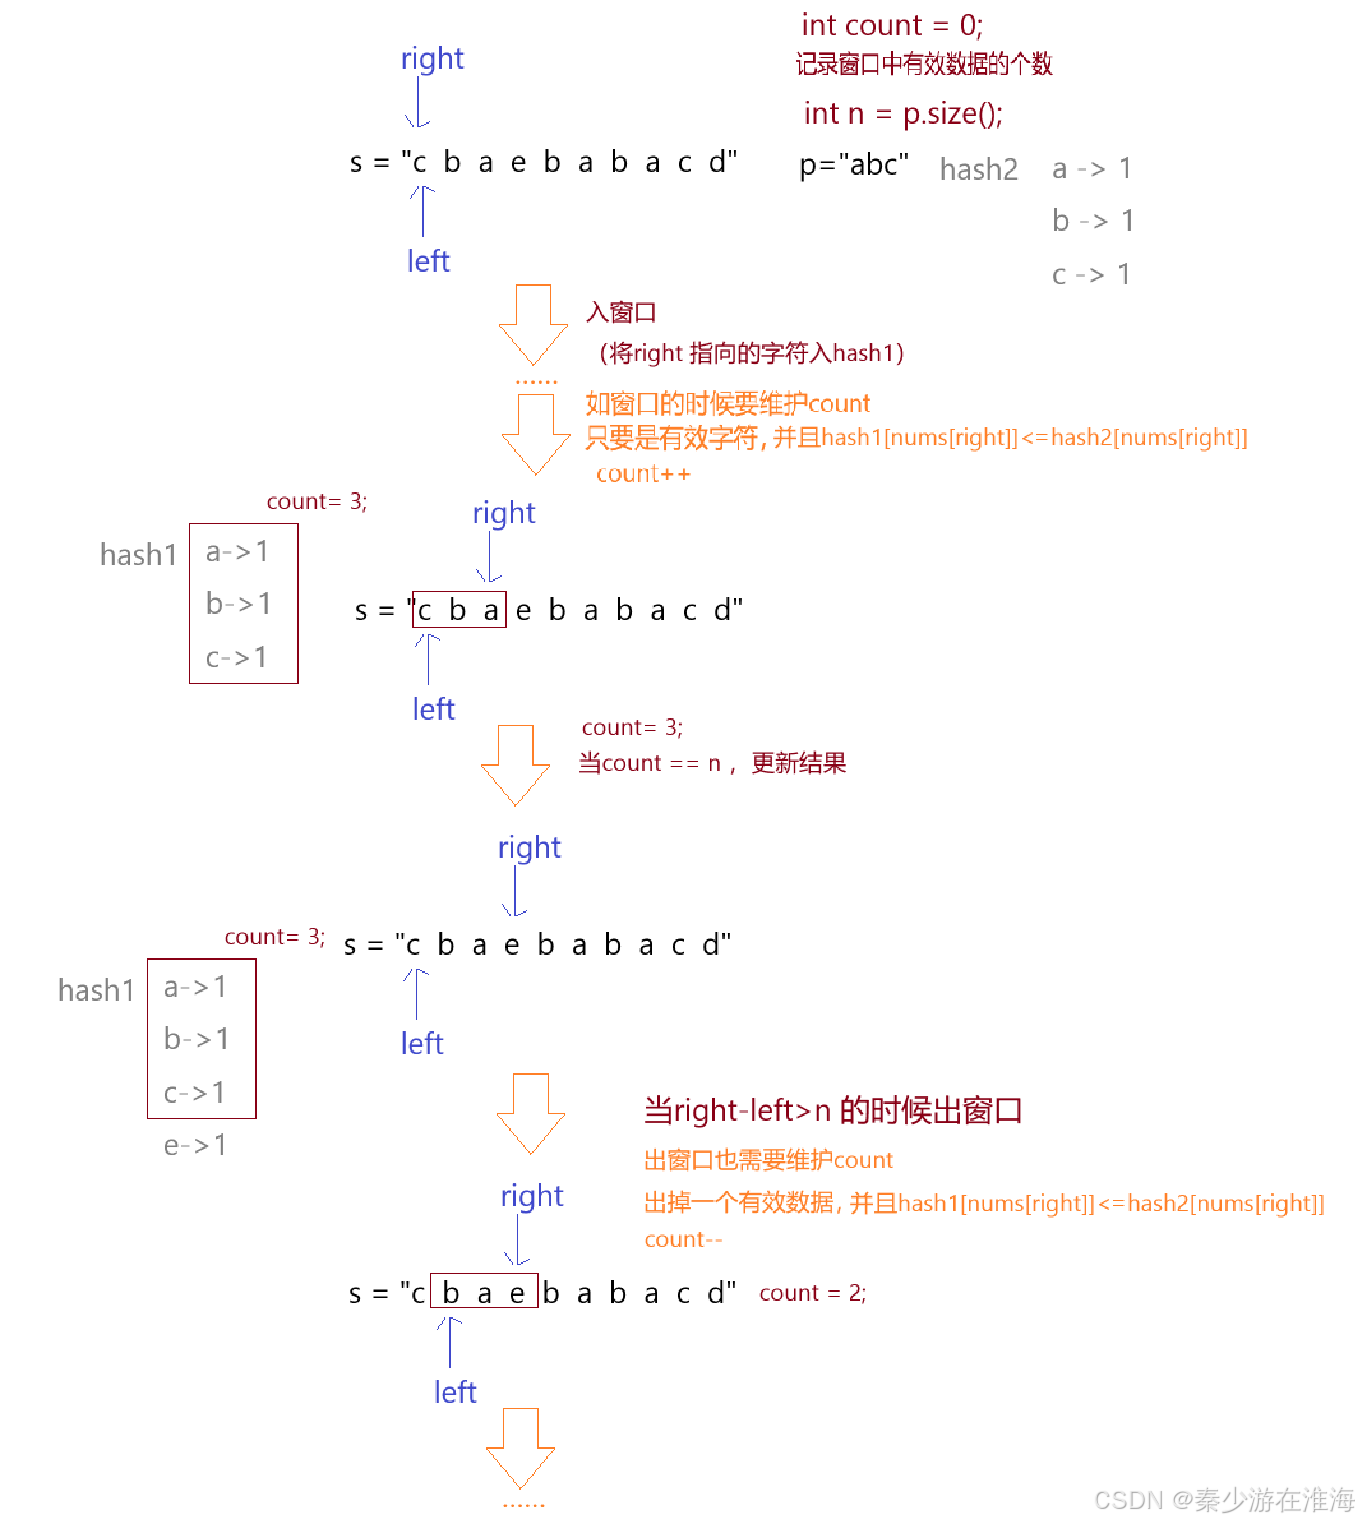
思路总结:
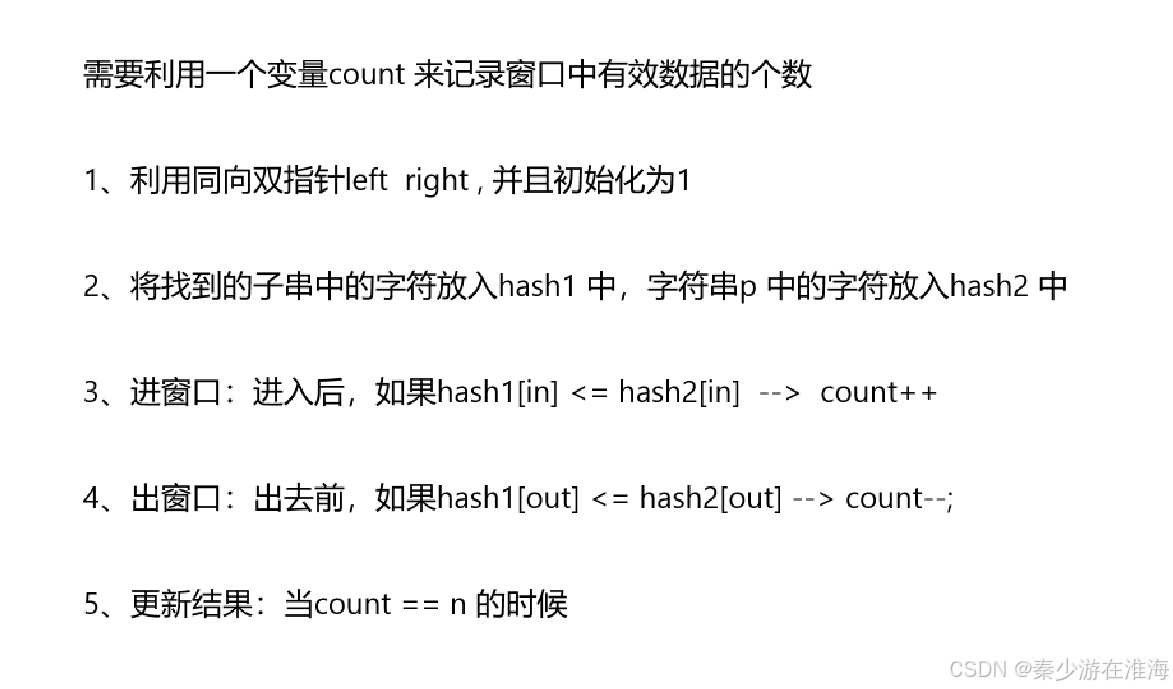
参考代码1:
    vector<int> findAnagrams(string s, string p)
    {
        int m = s.size(), n = p.size();
        unordered_map<char , int> hash1,hash2;
        //将字符串p 中的字符均放入hash表中
        for(auto e : p) hash2[e]++;
        int left = 0, right = 0, count = 0;
        vector<int> ret;
        while(right < m)
        {
            //入窗口
            char in = s[right];
            hash1[in]++;
            if(hash2.count(in) && hash1[in] <= hash2[in]) count++;
            //判断是否要出窗口
            //因为一定只会执行一次,所以可以写成if 判断语句
            if(right - left + 1 > n)
            {
                char out = s[left];
                //维护count
                if(hash2.count(out) && hash1[out] <= hash2[out]) count--;
                hash1[out]--;
                left++;
            }
            //更新结果 - 窗口中的数一定是小于等于n 的
            if(count == n) ret.push_back(left);
            right++;
        }
        return ret;
    }
如果用变量记录有效数据个数的,还可以用数组实现的hash代替unordered_map ,但是需要注意下标的映射关系,如下:
参考代码2:
    vector<int> findAnagrams(string s, string p)
    {
        int m = s.size(), n = p.size();
        int hash1[26] = {0};
        int hash2[26] = {0};
        //将字符串p 中的字符均放入hash表中
        for(auto e : p) hash2[e - 'a']++;
        int left = 0, right = 0, count = 0;
        vector<int> ret;
        while(right < m)
        {
            //入窗口
            char in = s[right];
            hash1[in - 'a']++;
            if(hash1[in - 'a'] <= hash2[in - 'a']) count++;
            //判断是否要出窗口
            //因为一定只会执行一次,所以可以写成if 判断语句
            if(right - left + 1 > n)
            {
                char out = s[left];
                //维护count
                if( hash1[out - 'a'] <= hash2[out - 'a']) count--;
                hash1[out - 'a']--;
                left++;
            }
            //更新结果 - 窗口中的数一定是小于等于n 的
            if(count == n) ret.push_back(left);
            right++;
        }
        return ret;
    }
还可以对代码进行简化,如下:
    vector<int> findAnagrams(string s, string p)
    {
        int m = s.size(), n = p.size();
        int hash1[26] = {0};
        int hash2[26] = {0};
        //将字符串p 中的字符均放入hash表中
        for(auto e : p) hash2[e - 'a']++;
        int left = 0, right = 0, count = 0;
        vector<int> ret;
        while(right < m)
        {
            //入窗口
            char in = s[right];
            if( ++ hash1[in - 'a'] <= hash2[in - 'a']) count++;
            //判断是否要出窗口
            //因为一定只会执行一次,所以可以写成if 判断语句
            if(right - left + 1 > n)
            {
                char out = s[left++];
                //维护count
                if( hash1[out - 'a']-- <= hash2[out - 'a']) count--;
            }
            //更新结果 - 窗口中的数一定是小于等于n 的
            if(count == n) ret.push_back(left);
            right++;
        }
        return ret;
    }
题 7 串联所有单词的子串:
题干:
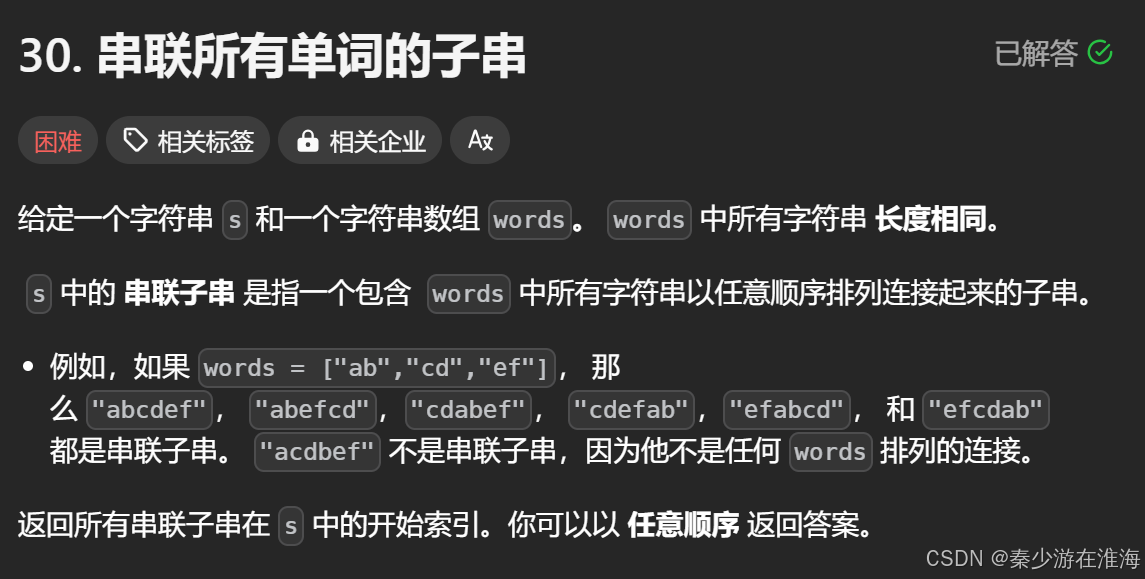
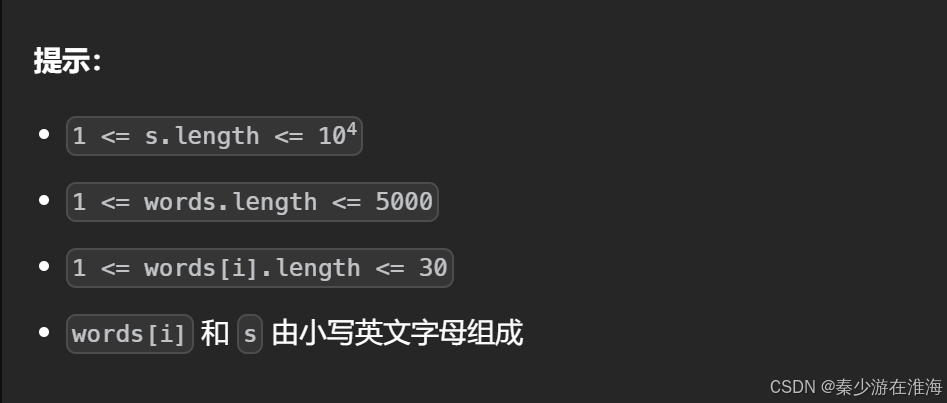
数据范围:
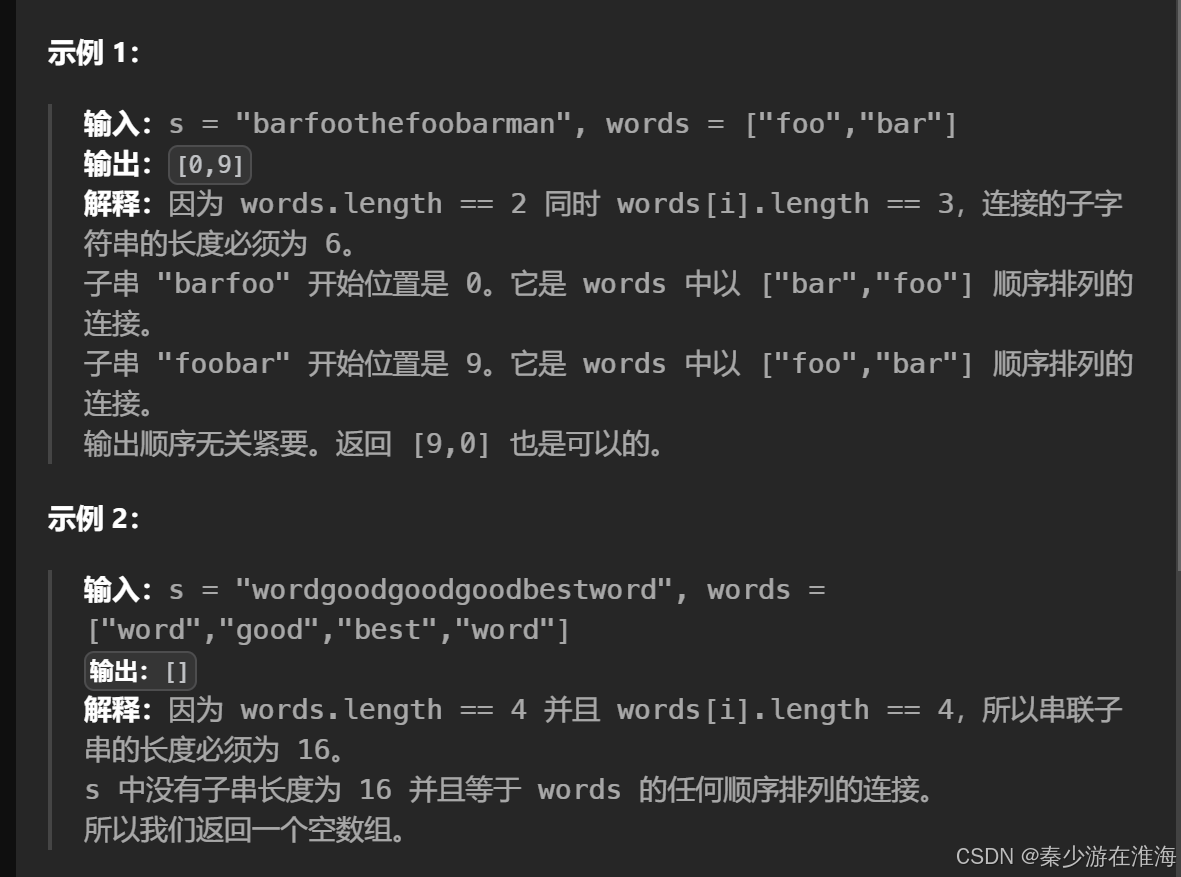
例子:
思考:
结合题干我们可以得知,s 中的字符均是words 中所有字符串以任意顺序拼接而成的;其实这道题跟上一道题很像,只不过上道题是处理字符,而本题是处理字符串;
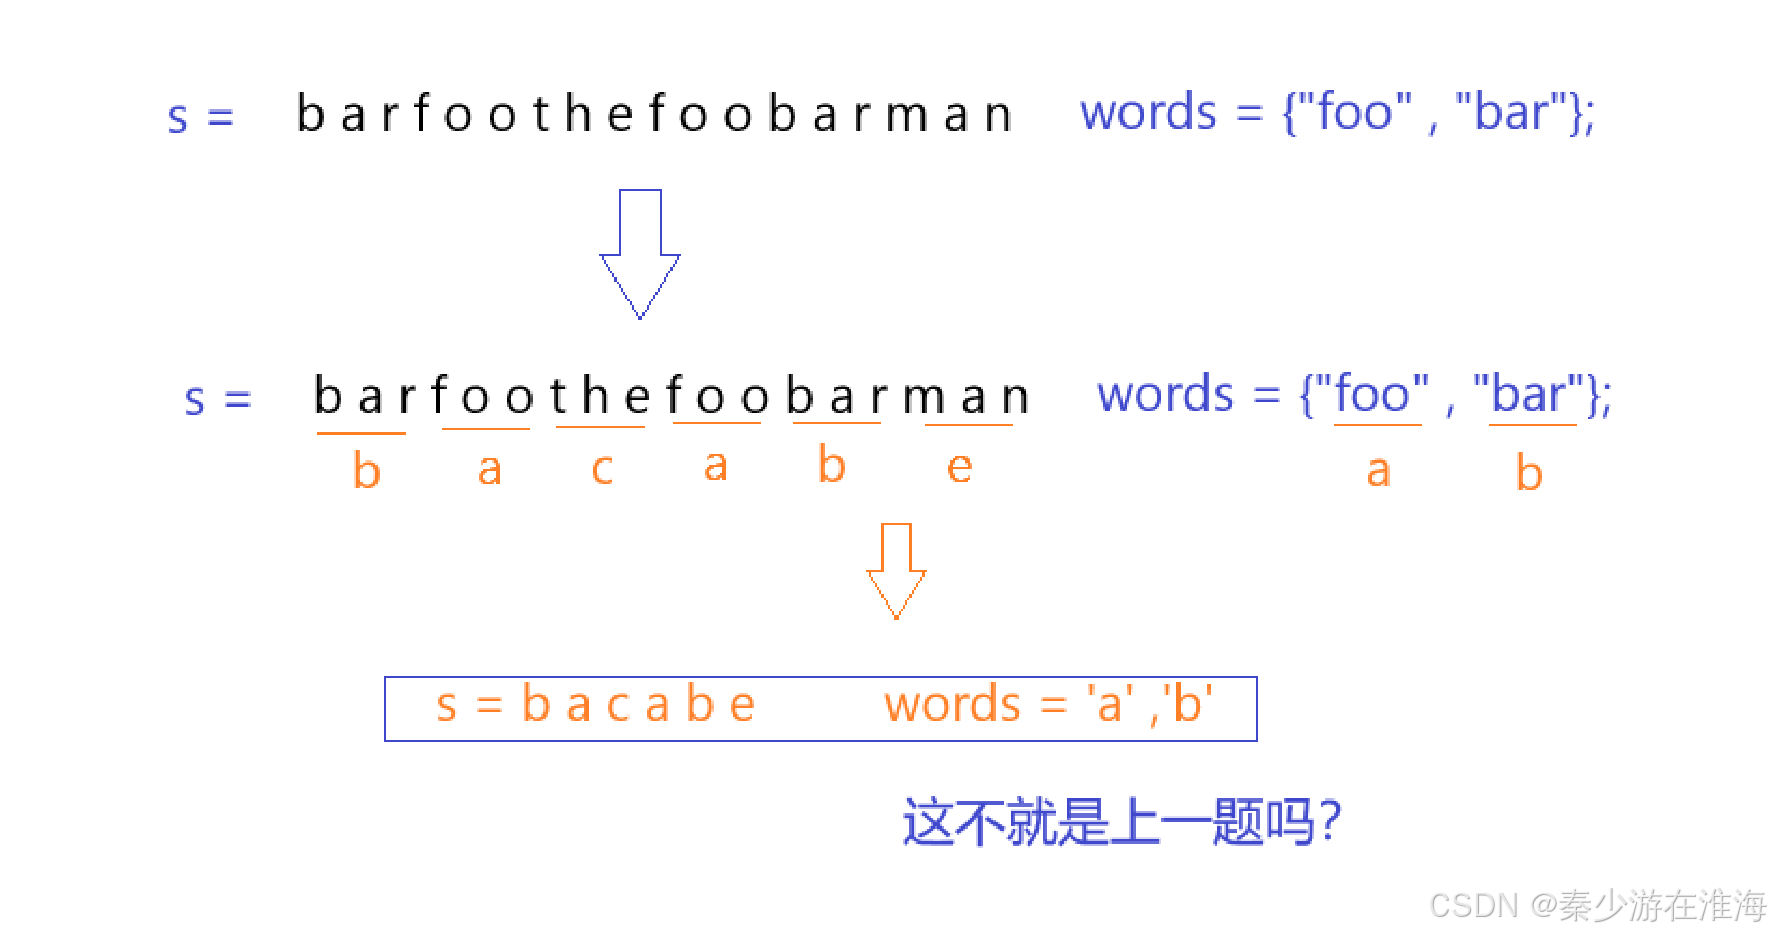
可见本题和上一题的思路大差不差,不过是在细节层面有所区别;
解法:同向双指针 + 哈希表
在上题中,因为是对字符进行操作,所以其中的哈希表可以用数组实现也可以用容器unordered_map 来实现哈希表,但是本题中是要对字符串进行处理,所以哈希表最好就不要使用数组实现,而是用容器unordered_map 来实现;
因为words 中的字符串的长度都一样,而每一次移动需要指向下一个字符串,也就是说同向双指针的移动不能是一个位置一个位置地移动,而其一次移动地距离由words 中字符串的长度决定;算法逻辑跟上一题如出一辙,此处就不再过多赘述;
还需要注意的是,s 字符串中的划分不会像我们上图那样words 中的字符串长度为多长其余的单词也为多长,此处为了不漏,需要在外层再套一个循环:从哪个位置开始向后找,由words 中字符串的长度决定;
参考代码:
    vector<int> findSubstring(string s, vector<string>& words)
    {
        int n = s.size() , m =  words.size() , len = words[0].size();
        vector<int> ret;
        unordered_map<string,int> hash1;
        for(auto&e: words) hash1[e]++;
        //执行m次
        for(int i = 0; i<len;i++)
        {
            int left = i, right = i , count  = 0;
            unordered_map<string,int> hash2;
            //滑动窗口
            while(right <= n - len)//此处是一个细节
            {
                //入窗口
                string in = s.substr(right , len);
                hash2[in]++;
                //维护count
                if(hash1.count(in) && hash2[in] <= hash1[in]) count++;
                //判断 - 出窗口
                if(right-left+1 > m*len)
                {
                    string out = s.substr(left , len);
                    //出窗口前维护count
                    if(hash1.count(out) && hash2[out] <= hash1[out]) count--;
                    hash2[out]--;
                    left+=len;
                }
                //更新数据
                if(count == m) ret.push_back(left);
                right+=len;
            }
        }
        return ret;
    }
题8 最小覆盖子串 :
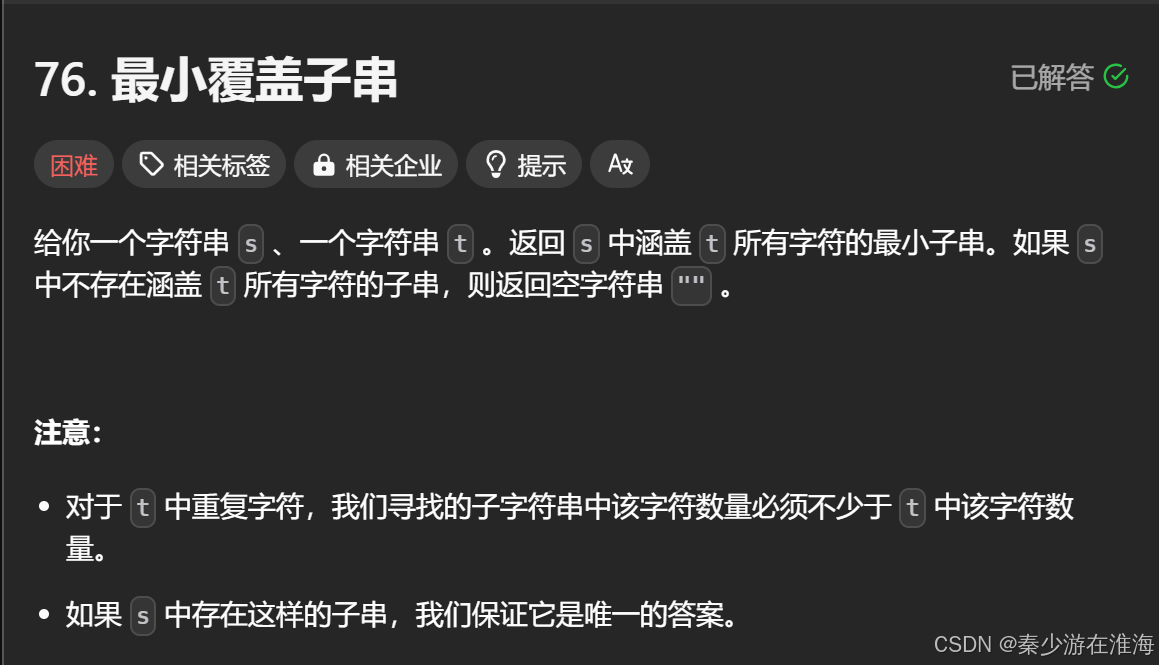
题干:
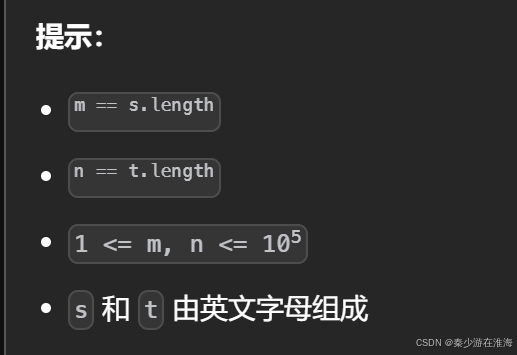
数据范围:
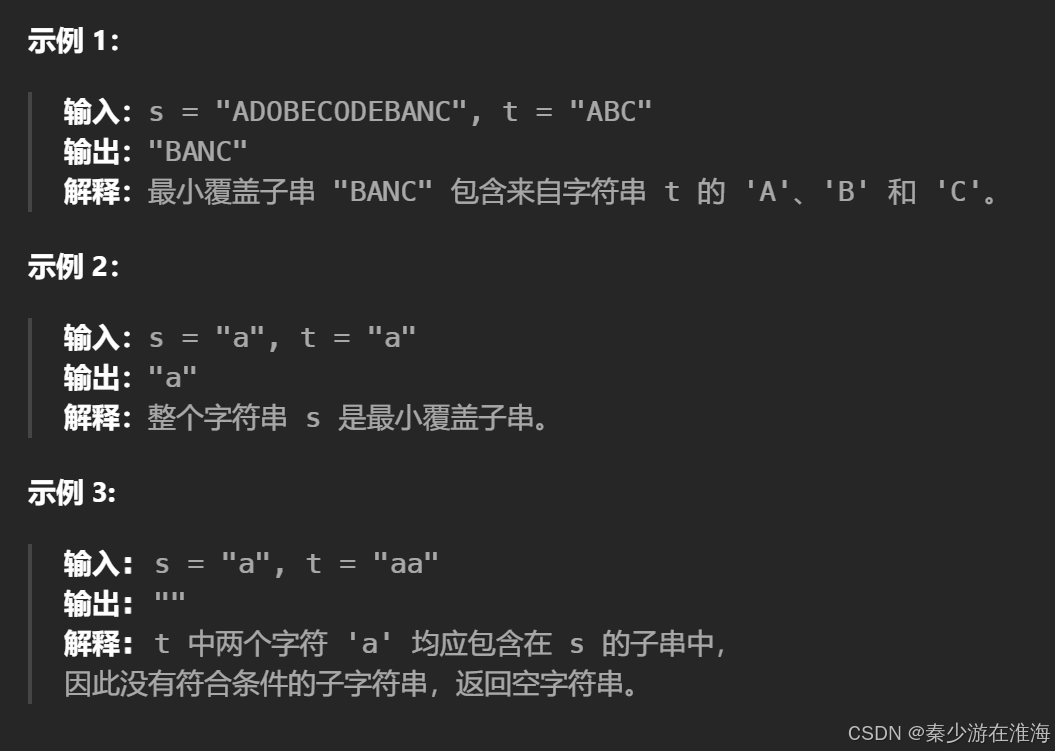
例子:
思考:
本题跟题6也很相似,只不过本题求的是当窗口中均包含了 t 中的字符的时候,窗口中的最小长度,并且返回窗口中的字符;此处可以用两个变量来记录,一个记录窗口中字符串的最小长度,一个来记录最小长度的内容或者是一个记录窗口中字符串最小长度的起始下标,一个记录窗口中字符串的最小长度;
如何才能让窗口中的字符个数最小?当然窗口的最左边和最右边都是所要求的字符(t 中的字符),那么这就是出窗口的判断,判断left 指向的是否是t 中的字符;同样地,与题6相似,需要用到hash 表来统计窗口中、t 中的字符,并且需要一个变量来维护窗口中有效字符的个数;
完整逻辑讲解:
解法一:暴力解法+哈希表
枚举出所有子串的情况,然后后找到符合题干的最短的子串返回即可;同样的,想要知道枚举出来的子串是否覆盖t 中的字符,与题6一样,需要借助于哈希表来实现;
我们需要优化暴力枚举的过程:
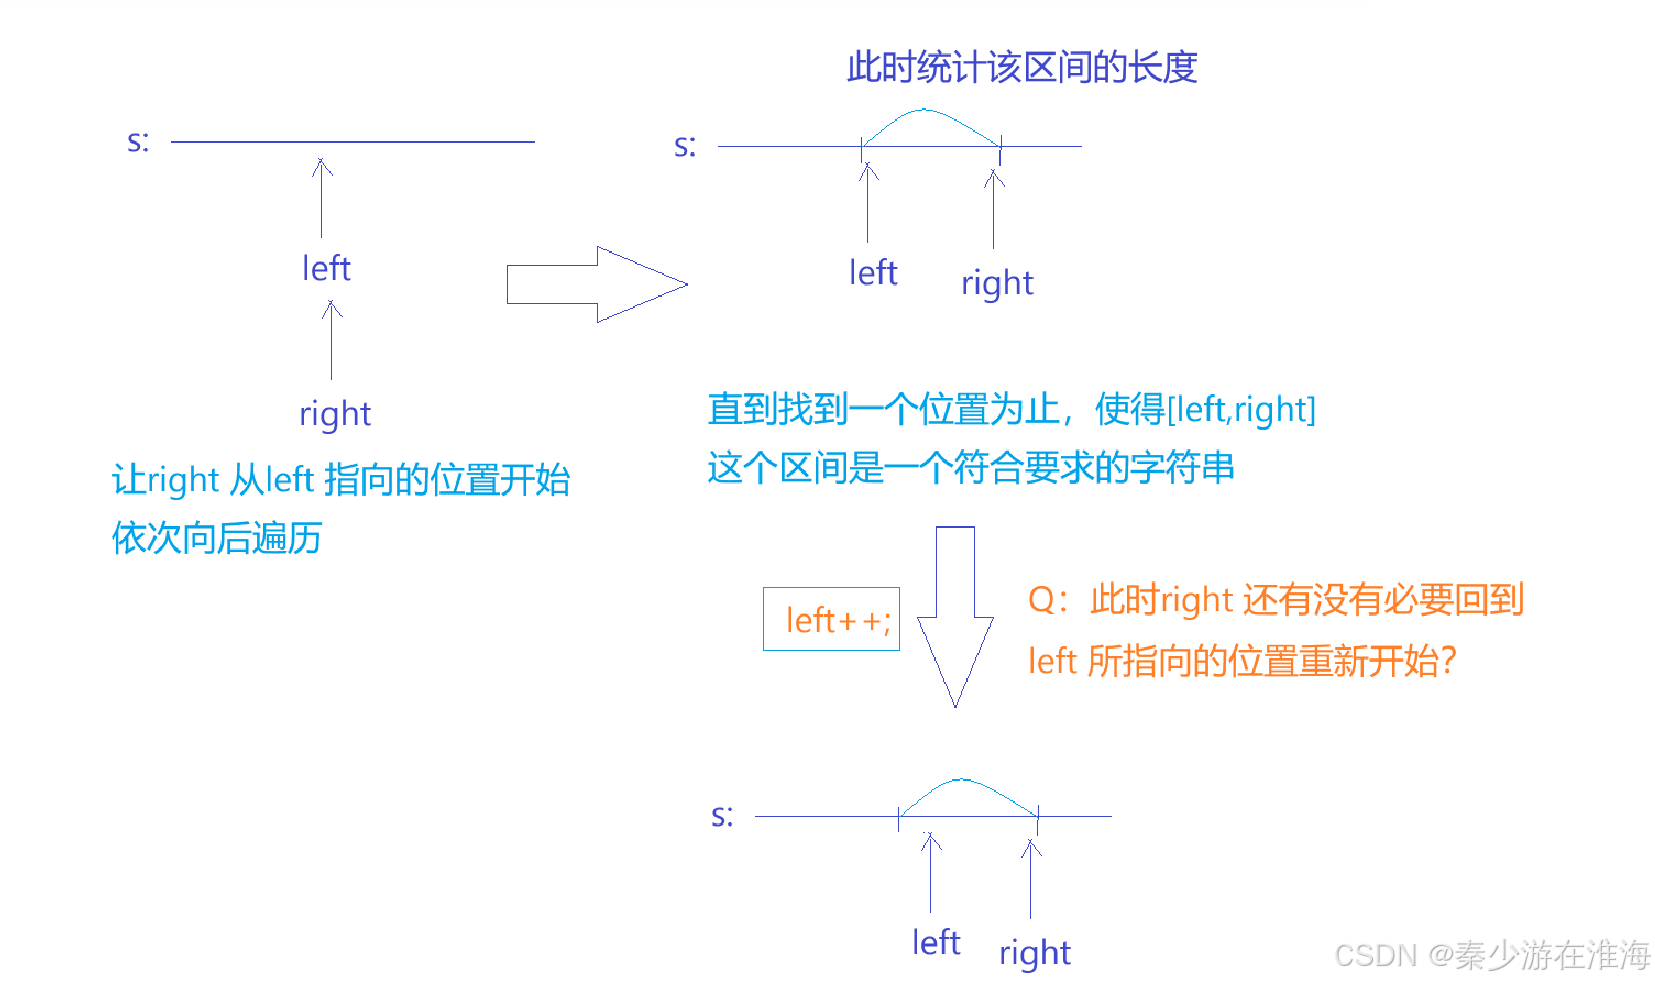
我们定义了两个指针left right , right 进行查找,当区间[left,right] 中的字符串符合题干规定的时候,就可以计算此区间的长度;然后left ++,right 回到left 指向的地方,right 继续往后找……这是暴力枚举的做法;我们需要思考的是,right 是否有必要重新回到left 指向的地方?
没必要;因为我们需要维护[left,right] 之中包含所有t 中的字符就行了;所以我们就需要讨论,left自增之后,[left,right] 中的情况,如下:
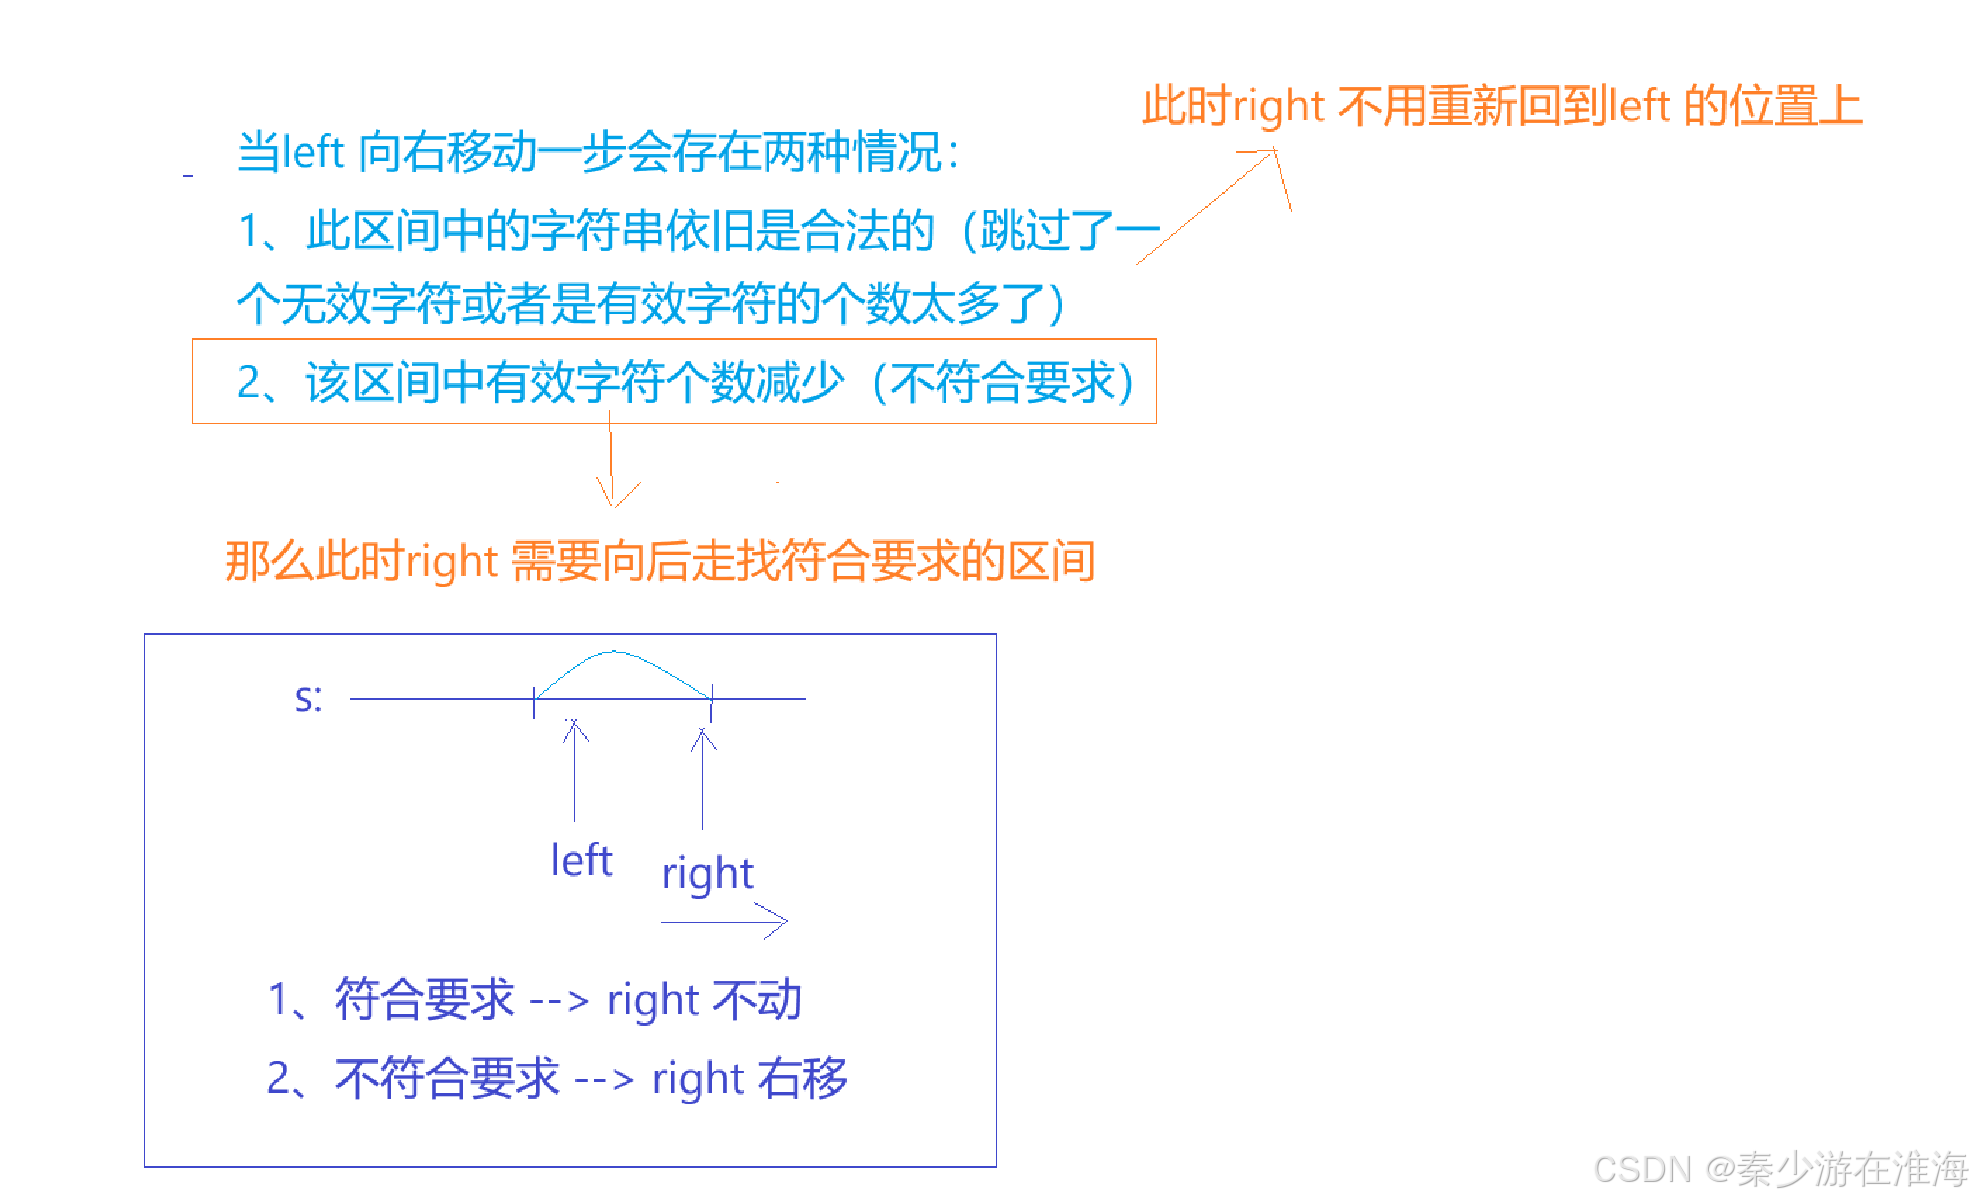
显然,此处的优化就是用滑动窗口来解决;在实现代码之前,我们需要弄清楚,入窗口、出窗口、更新数据如何操作;
解法二:同向双指针(滑动窗口) + 哈希表
因为s 与 t 中的字符全为英文字符,所以我们哈希表的实现可以是用 大小为128 的数组实现,也可以是用容器unordered_map 来实现;
首先是要将 t 中的字符全部放入hash1 之中,然后是入窗口,将right 指向的字符放入hash2 之中。按照前面几道题的做题逻辑,此时我们应该判断是否要出窗口。如何出窗口呢?当[left,right] 区间中给的字符符合要求,暴力枚举的思想是:left++,right 回到left 指向的地方;但是符合要求了不统计就直接left++?显然本题就需要先更新数据然后再判断是否要出窗口;
还需要注意的一个点是,想要判断hash2 中是否都有hsah1 中的字符与个数时,无论是用数组实现的哈希表还是利用容器unordered_map 实现的哈希表均要一个遍历比较,有点消耗效率;此处可以参考前几道题用过的策略来进行优化:利用变量来记录[left,right] 中有效数据的个数;
思路总结:
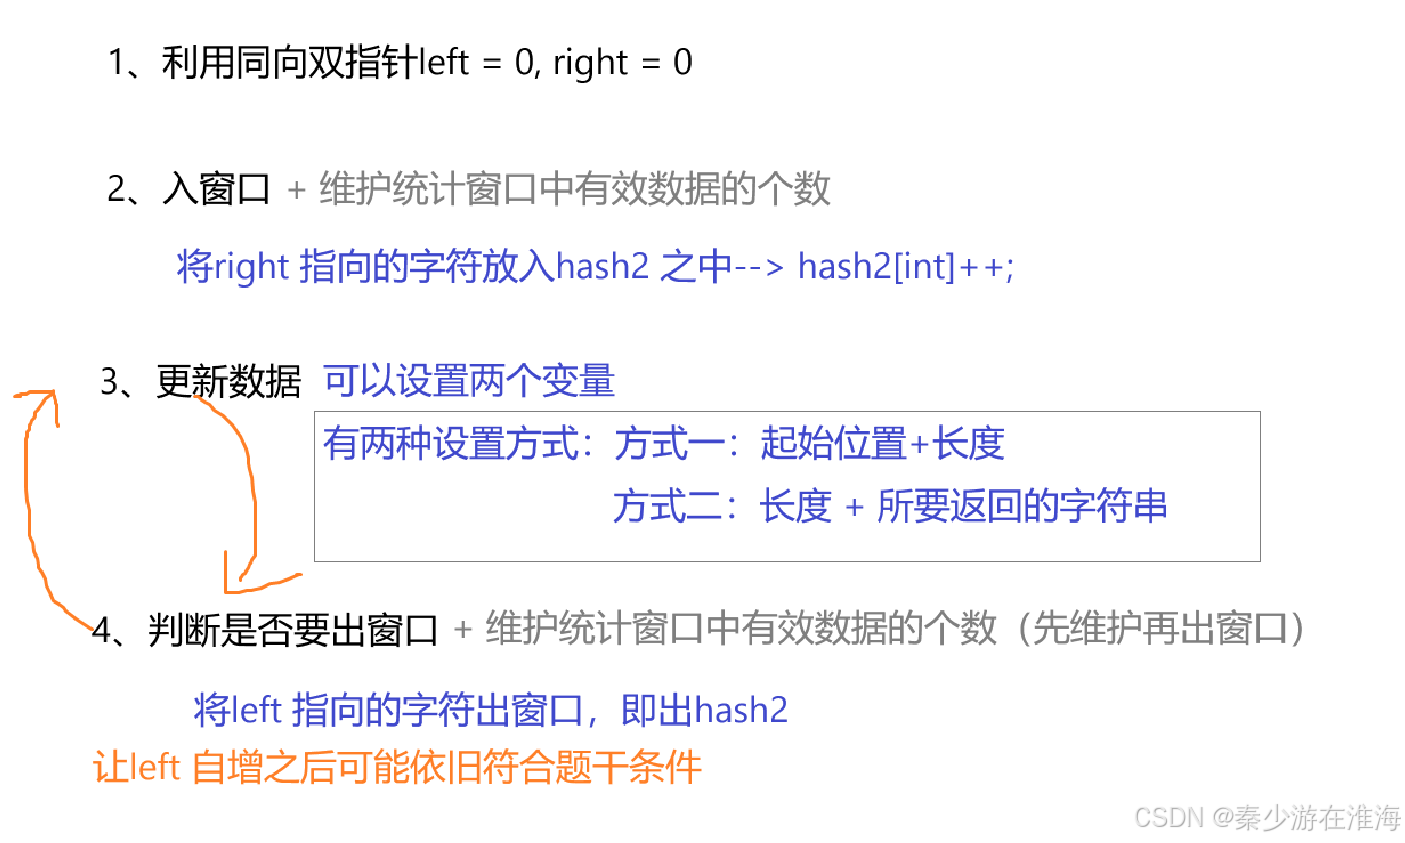
参考代码1:
此处使用unordered_map 实现的
    string minWindow(string s, string t)
    {
         int n = s.size() , m = t.size();
         unordered_map<char , int> hash1,hash2;
         for(auto ch : t) hash1[ch]++;
         int left = 0, right = 0, count = 0 , retlen = INT_MAX, begin = -1;
         while(right < n)
         {
            //入窗口
            char in = s[right];
            hash2[in]++;
            //统计窗口中有效数据的个数
            if(hash1[in] && hash2[in] <= hash1[in]) count++;
            //更新数据
            while(count == m)
            {
                int len = right - left +1;
                if(len < retlen)
                {
                    retlen = len;
                    begin = left;
                }
                char out  = s[left];
                //维护count
                if(hash1[out] && hash2[out]<=hash1[out]) count--;
                hash2[out]--;
                left++;
            }
            right++;
         }
         if(begin == -1) return "";//直接返回空字符串
         return s.substr(begin , retlen);
    }
参考代码2:
代码二的哈希表就用数组实现并且简化代码的书写:
    string minWindow(string s, string t)
    {
         int n = s.size() , m = t.size();
         int hash1[128] = {0};
         int hash2[128] = {0};
         for(auto ch : t) hash1[ch]++;
         int left = 0, right = 0, count = 0 , retlen = INT_MAX, begin = -1;
         while(right < n)
         {
            //入窗口
            char in = s[right];
            //统计窗口中有效数据的个数
            if(hash1[in] && ++hash2[in] <= hash1[in]) count++;
            //更新数据
            while(count == m)
            {
                int len = right - left +1;
                if(len < retlen)
                {
                    retlen = len;
                    begin = left;
                }
                char out  = s[left++];
                //维护count
                if(hash1[out] && hash2[out]-- <= hash1[out]) count--;
            }
            right++;
         }
         if(begin == -1) return "";//直接返回空字符串
         return s.substr(begin , retlen);
    }
总结
既然看到这里了,那就把这些题再做一遍吧~
- 209. 长度最小的子数组
- 3. 无重复字符的最长子串
- 1004. 最大连续1的个数 III
- 1658. 将 x 减到 0 的最小操作数
- 904. 水果成篮
- 438. 找到字符串中所有字母异位词
- 30. 串联所有单词的子串
- 76. 最小覆盖子串
滑动窗口,无非就是利用两个同向双指针,根据题干的要求设置入窗口的条件、出窗口的条件以及什么时候更新结果;需要注意的是,更新结果的地方是不确定的,可能是在入窗口后更新结果,也有可能是在出窗口之后才更新结果,需要根据具体的题意定夺;

 790


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


