spark从0到1 基础知识 一文全

Hive 整合 Spark 全教程 (Hive on Spark) 文章目录Hive 引擎简介环境配置 (ssh已经搭好)JDK准备Hadoop准备部署配置集群配置历史服务器配置日志的聚集启动集群LZO压缩配置Hadoop 3.x 端口号 总结MySQL准备Hive 准备Spark 准备Hive on Spark 配置Hive on Spark测试 Hive 引擎简介 Hive 引擎包括:默认 MR、tez、spark 最底层的引擎就是MR (Mapreduce)无需配置,Hive运行自带 Hive on Tez 配置:https://blog.youkuaiyun.com/we 阅读详情


学习中的测试学习代码详情代码请见本人github中的sparkcp项目
https://gi@thub.com/define@qq/spa@rkcp

1 开发前准备

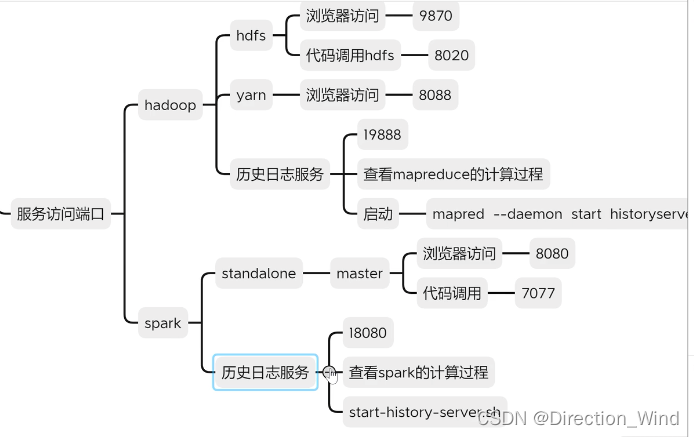
主要是本机使用,所以 安装了个python3,装了个pyspark(pip3 install pyspark),直接装了个3.4的spark,直接命名行敲pyspark,就能以spark.submit.deployMode=client模式启动一个spark,并且自动给了UI地址http://********:4040 供测试是否正常。

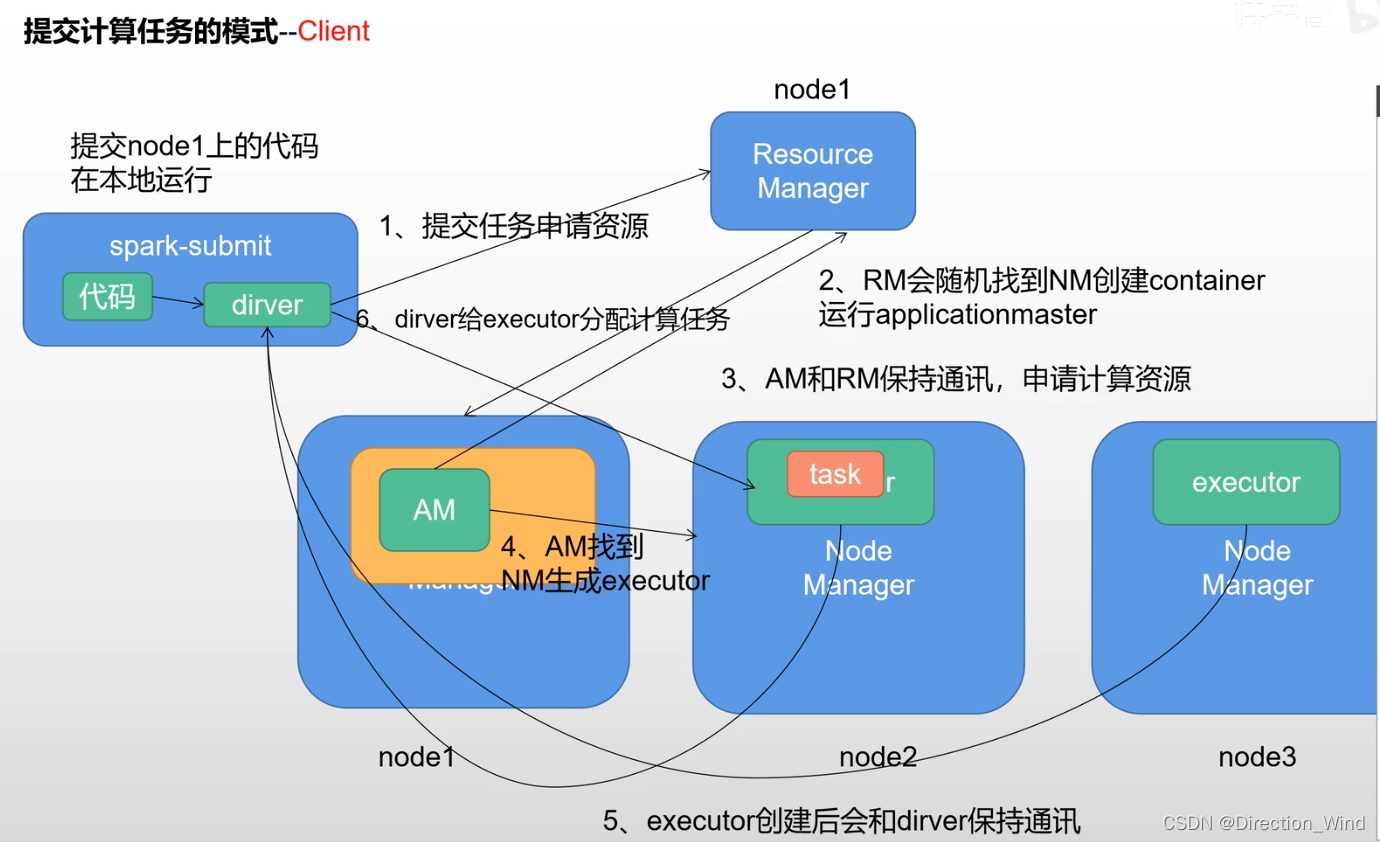
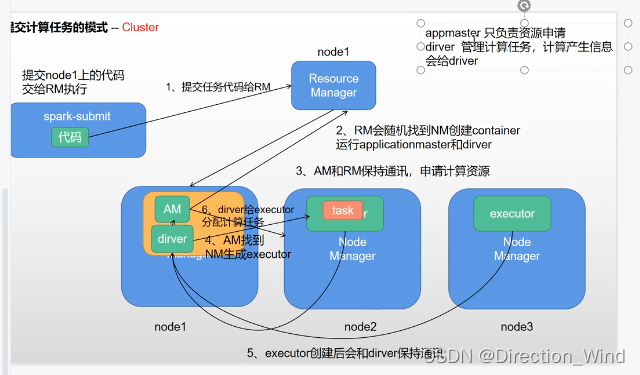
2 spark架构,任务提交流程

  • 部署方式:local / cluster(使用集群调度,分为 standalone或yarn) / 云服务(阿里maxcompute)
    local: 使用单台机器部署。
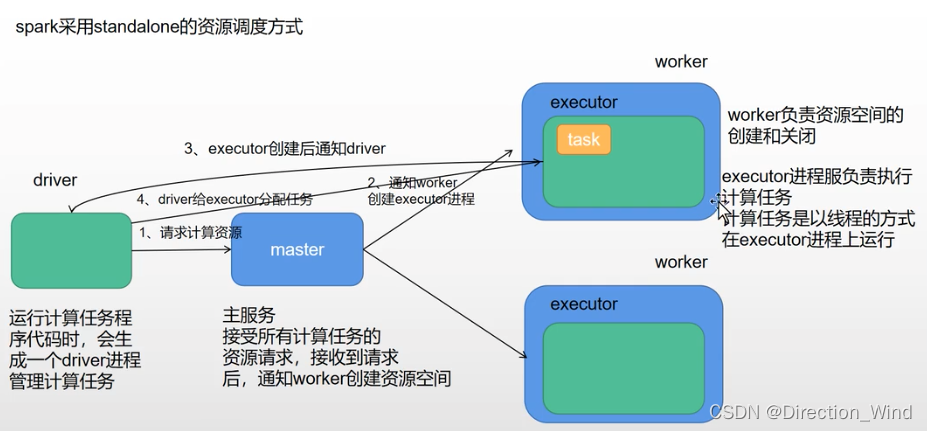
    cluster: 正常集群模式,其中standalone(包含 master 和 worker 两个服务,master只有一个单点故障,worker 可以运行在多台服务器上) ,standalone是spark自带的,yarn是hadoop的。
  • mr在调用yarn的资源时,由applicationMaster管理计算任务,所有信息都会汇报给applicationmaster。那么 spark在计算时,由driver管理计算任务,是一个计算程序进程。

spark在计算时:

  • 由driver管理计算任务,他本质是一个计算程序的进程
  • spark是以线程方式进行计算代码,线程(task )是在executor进程中进行计算,executor就是一个资源空间。

其中standalone是没有applicationMaster的,yarn模式提交会有applicationMaster.。在这里插入图片描述在这里插入图片描述
在这里插入图片描述
spark-submit --master yarn --name cluster_demo --deploy-mode client/cluster b.py
在这里插入图片描述

3 开发中涉及的python知识

Spark基础全解析 SPARK全解析 标签(空格分隔): Spark SPARK全解析 Spark是什么? Spark 源码编译 Spark本地模式安装配置及Spark Shell基本使用 Spark集群 Spark Application开发、运行及监控(IDEA) Spark 日志监控(HistoryServer)配置 Spark RDD Spark共享变量 Spark 内核 Spark 依赖 Spa... 阅读详情

相关推荐

Spark 1.0.0 横空出世 Spark on Yarn 部署(Hadoop 2.4)

就在昨天,北京时间5月30日20点多。Spark 1.0.0终于发布了:Spark 1.0.0 released 根据官网描述,Spark 1.0.0支持SQL编写:Spark SQL Programming Guide 个人觉得这个功能对Hive的市场的影响很小,但对Shark冲击很大,就像win7和winXP的关系,自相残杀嘛? 这么着急的发布1.x 版是商业行为还是货真价实的体现,让我们拭目以待吧~~~~ 本文是优快云-撸大湿原创,如要转载请注明出处,谢谢:http://blog.youkuaiyun.com

撸大湿专栏 8395

Spark 从 0 到 1 学习(2) —— Apache Spark 运行模式与原理

Spark 从 0 到 1 学习(2) —— Apache Spark 运行模式与原理 文章目录Spark 从 0 到 1 学习(2) —— Apache Spark 运行模式与原理1. Standalone 模式两种提交任务方式1.1 Standalone-client 提交任务方式1.2 Standalone-cluster 提交任务方式1.3 总结2. Yarn 模式两种提交任务方式2.1 yarn-client 提交任务方式2.2 yarn-cluster 提交任务方式3. Spark 术语解释4.

dwjf321的博客 730

Spark2.1.0安装和配置

Spark 2.1.0 安装、配置

狮锅艺 5585

Spark学习之路 (一)Spark初识

一、官网介绍 1、什么是Spark 官网地址:http://spark.apache.org/ Apache Spark™是用于大规模数据处理的统一分析引擎。 从右侧最后一条新闻看,Spark也用于AI人工智能 spark是一个实现快速通用的集群计算平台。它是由加州大学伯克利分校AMP实验室 开发的通用内存并行计算框架,用来构建大型的、低延迟的数据分析应用程序。它扩展了广泛使用的...

weixin_33737134的博客 374

基于Spark 2.0.0搭建Hive on Spark环境

如何让HIVE 2.2.0使用Spark 2.0.0计算框架。

纠了个结De聖的博客 9968

Spark1.0.0 集群配置

1.   机器: (1)master :主机名:hadoop-1         IP:202.193.74.111 (2)slave1 :主机名: hadoop-2         IP:202.193.74.112 (3)slave2 :主机名: hadoop-3         IP:202.193.74.113 已经部署好了hadoop分布式集群环境,hadoop版本为1.1.2(

muyanmoyang的专栏 601

Kyuubi1.6.0+Spark3.0.0部署

Kyuubi1.6.0是支持Spark3.0.0的最后一个版本,再往上需要更高的Spark版本,我这里就没再测试。

qq_35233282的博客 2290

Spark-2.0.1 安装 及 WordCount (详细图文)

centos 6.5 安装 spark-2.0.1-bin-hadoop-2.6.tgz

M_SIGNALs的博客 4236

Spark2.1.0之基础知识

      在阅读本文之前,读者最好已经阅读了《Spark2.1.0之初识Spark》一文,本文将对Spark的基础知识进行介绍。但在此之前,读者先跟随本人来一次简单的时光穿梭,最后还将对Java与Scala在语言上进行比较。版本变迁    经过5年多的发展,Spark目前的版本是2.3.0。Spark主要版本的发展过程如下:Spark诞生于UCBerkeley的AMP实验室(2009)。Spar...

beliefer的博客 3786

RT-Thread 5.1.0 实战:手把手教你用CubeMX和RT-Studio创建第一个工程(附常见编译错误修复)

本文详细介绍了如何使用STM32CubeMX和RT-Thread Studio 5.1.0创建第一个RT-Thread工程,包括开发环境准备、CubeMX配置、工程整合及常见编译错误修复。通过实战指南,帮助开发者快速上手RT-Thread 5.1.0,解决开发过程中的典型问题,提升嵌入式开发效率。

weixin_29165465的博客 285

深入解析UEFI PEI阶段:PeiCore的三次调用与内存管理机制

本文深入解析UEFI启动流程中的PEI阶段,重点探讨PeiCore的三次调用与内存管理机制。详细介绍了PeiCore在临时内存中的初始化、堆栈切换至永久内存的过程,以及最终交接给DXE阶段的关键步骤,为开发者提供调试技巧与实战案例,助力解决UEFI启动问题。

weixin_28452161的博客 649

spark1.0和2.0的区别_Spark2.1.0——Spark初体验

学习一个工具的最好途径,就是使用它。这就好比《极品飞车》玩得好的同学,未必真的会开车,要学习车的驾驶技能,就必须用手触摸方向盘、用脚感受刹车与油门的力道。在IT领域,在深入了解一个系统的原理、实现细节之前,应当先准备好它的运行环境或者源码阅读环境。如果能在实际环境下安装和运行Spark,显然能够提升读者对于Spark的一些感受,对系统能有个大体的印象,有经验的工程师甚至能够猜出一些Spark在实现...

weixin_39893728的博客 360

【RViz2】导入urdf模型时报错:Could not load resource xxx,Unable to open file xxx,Error retrieving file xxx

初学ROS2,想要在RViz2中显示urdf模型。其中.urdf文件引用了外部的meshes文件夹。

qq_43557907的博客 9487

Spark2.1.0之初体验

       在《Spark2.1.0之运行环境准备》一文中,已经介绍了如何准备好基本的Spark运行环境,现在是时候实践一下,以便于在使用过程中提升读者对于Spark最直接的感触!本文通过Spark的基本使用,让读者对Spark能有初步的认识,便于引导读者逐步深入学习。运行spark-shell    在《Spark2.1.0之运行环境准备》一文曾经简单运行了spark-shell,并用下图进行...

beliefer的博客 5595

VH6501干扰仪的使用

触发模式方法备注External Trigger(外部触发)使用VH6501的I/O口作为触发源Frame Trigger(报文触发)设定被干扰报文的触发位置,并发送干扰位序列/报文software Trigger(软件触发)配置好干扰序列后直接发送Error Frame Trigger(错误帧触发)基于错误帧标识位为触发条件触发干扰Direction Trigger(发送方向触发)根据TX/RX发送/接收方作为触发条件Inverted Trigger(反向触发)

帮助100万人颠覆负面潜意识,实现人生蜕变,培养1万名潜意识开发导师 9048

EDA开源仿真工具verilator入门4:访问函数介绍

访问函数(Visitor Function)是verilator算法实现的主要工作方式之一,本节将介绍一下访问函数。

fangfanglovezhou的博客 1075

spark1.0和2.0的区别_Spark 2.1.0新特性

Spark 2.1.0是2.x分支中的第二个重要的发布版本(第一个是2.0.x),在该版本中,structured streaming有重大改进,增加了event mark watermark机制和对kafka 0.10.0的支持等特性,为其用于生产环境又迈进一步。除此之外,Spark其他重大改进集中在易用性、稳定性和改进等方面,解决了1200多个ticket(包括新功能、bug fix以及性能改...

weixin_39576018的博客 599

9篇5章2节:NHIS 数据库的常规数据下载

文章概述了 NHIS-Teen、NHPI NHIS 等补充性调查以及 2024 年 NHIS 数据资源的具体内容,包括问卷材料、技术文档和数据模块,为研究者高效、规范地使用 NHIS 数据提供参考框架。

MD Code 1439

Spark 1.0.0版本发布

前言 今天Spark终于跨出了里程碑的一步,1.0.0版本的发布标志着Spark已经进入1.0时代。1.0.0版本不仅加入了很多新特性,并且提供了更好的API支持。Spark SQL作为一个新的组件加入,支持在Spark上存储和操作结构化的数据。已有的标准库比如ML、Streaming和GraphX也得到了很大程度上的增强,对Spark和Python的接口也变得更稳定。以下是几个主要的改进点

doggggggggggggggggggggggggggggggggggggie的专栏 3872

数字IC/FPGA 秋招知识点不全面整理

数字IC/FPGA 秋招知识点不全面整理

w0shishabi的博客 7866

【3D无序抓取】--终极技术详解

3D无序抓取技术详解:从感知到执行的全流程技术方案 本文系统梳理了3D无序抓取(Bin Picking)的核心技术栈,涵盖3D感知、抓取规划和机器人执行三大环节。在3D感知层,详细介绍了点云采集与预处理方法(PCL/Open3D)、物体分割(PointNet++)和位姿估计(PVN3D/DenseFusion)等关键技术。抓取规划部分重点解析了抓取生成(GraspNet)、质量评估(Dex-Net)和动态避障(MoveIt!)算法。机器人执行环节则涉及路径规划、力控技术和末端执行器选型。同时提供了完整的工具

weixin_45590420的博客 596

Spark入门基础知识

Spark得到了众多大数据公司的支持,这些公司包括Hortonworks、IBM、Intel、Cloudera、MapR、Pivotal、百度、阿里、腾讯、京东、携程、优酷土豆。为了实现这样的要求,同时获得最大灵活性,Spark支持在各种集群管理器(Cluster Manager)上运行,包括Hadoop YARN、Apache Mesos,以及Spark自带的一个简易调度器,叫作。--是否启动一个线程检查每个任务正使用的物理内存量,如果任务超出分配值,则直接将其杀掉,默认是true -->

m0_52050252的博客 1942

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

Spark2.1.0之剖析spark-shell

        通过在spark-shell中执行word count的过程,让读者了解到可以使用spark-shell提交Spark作业。现在读者应该很想知道spark-shell究竟做了什么呢?脚本分析        在Spark安装目录的bin文件夹下可以找到spark-shell,其中有代码清单1-1所示的一段脚本。代码清单1-1       spark-shell脚本function m...

beliefer的博客 4563

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

创建Spark 2.1.0 Docker镜像

目前使用最多的Apache Spark容器镜像是sequenceiq/spark,在Docker Hub上有330K的下载量。sequenceiq的更新速度不是很给力,目前最新的版本是sequenceiq/spark:1.6.0,本文说明了如何基于sequenceiq的Dockerfile构建Spark 2.1.0容器镜像,并记录了构建的整个过程。

躬行谷 9964

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Spark 2.4.0 集成Hive 1.2.1

Spark 2.4.0 集成Hive 1.2.1 更多资源 github: https://github.com/opensourceteams/spark-scala-maven-2.4.0 apache-hive-1.2.1-bin 安装: https://github.com/open...

chongqueluo2709的博客 1266

Spark2.1.0之运行环境准备

       学习一个工具的最好途径,就是使用它。这就好比《极品飞车》玩得好的同学,未必真的会开车,要学习车的驾驶技能,就必须用手触摸方向盘、用脚感受刹车与油门的力道。在IT领域,在深入了解一个系统的原理、实现细节之前,应当先准备好它的运行环境或者源码阅读环境。如果能在实际环境下安装和运行Spark,显然能够提升读者对于Spark的一些感受,对系统能有个大体的印象,有经验的工程师甚至能够猜出一些S...

beliefer的博客 2250
上一篇: Iceberg 基础知识与基础使用
下一篇: hologres基础知识一文全
Direction_Wind
博客等级 码龄8年 6438粉丝 102原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Direction_Wind

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值