为什么 HashMap 默认加载因子非得是0.75?

CCF编程培训师资认证(PTA)标准(教学能力T) 随着计算机科学的不断发展,计算机相关技术应用到社会各个行业,越来越多的青少年参加到了计算机程序设计的学习中,这对编程培训教师提出了更高的专业要求和职业要求。CCF开展编程培训师资认证项目(Programming Trainer Accreditation,PTA),旨在建立一个规范的、科学的、权威且有公信力的三方认证。认证考试分编程专业能力(P)和教学能力(T)两部分。本标准根据《CCF编程培训师资认证条例》第十条制定,旨在明确教学能力(T)的测试标准。 阅读详情

点击“开发者技术前线”,选择“星标????”

在看|星标|留言,  真爱
来源:blog.youkuaiyun.com/NYfor2017/article/details/105454097

文前调侃:黄金比例是0.618

前言

有很多东西之前在学的时候没怎么注意,笔者也是在重温HashMap的时候发现有很多可以去细究的问题,最终是会回归于数学的,如HashMap的加载因子为什么是0.75?

本文主要对以下内容进行介绍:

  • 为什么HashMap需要加载因子?

  • 解决冲突有什么方法?

  • 为什么加载因子一定是0.75?而不是0.8,0.6?

(若文章有不正之处,或难以理解的地方,请多多谅解,欢迎指正)

为什么HashMap需要加载因子?

HashMap的底层是哈希表,是存储键值对的结构类型,它需要通过一定的计算才可以确定数据在哈希表中的存储位置:

staticfinalint hash(Object key) {        int h;        return(key == null) ? 0: (h = key.hashCode()) ^ (h >>> 16);    }//AbstractMappublicint hashCode() {        int h = 0;        Iterator<Entry<K,V>> i = entrySet().iterator();        while(i.hasNext())            h += i.next().hashCode();        return h;    }

一般的数据结构,不是查询快就是插入快,HashMap就是一个插入慢、查询快的数据结构。但这种数据结构容易产生两种问题:① 如果空间利用率高,那么经过的哈希算法计算存储位置的时候,会发现很多存储位置已经有数据了(哈希冲突);② 如果为了避免发生哈希冲突,增大数组容量,就会导致空间利用率不高。

而加载因子就是表示Hash表中元素的填满程度。

加载因子 = 填入表中的元素个数 / 散列表的长度

加载因子越大,填满的元素越多,空间利用率越高,但发生冲突的机会变大了;

加载因子越小,填满的元素越少,冲突发生的机会减小,但空间浪费了更多了,而且还会提高扩容rehash操作的次数。

冲突的机会越大,说明需要查找的数据还需要通过另一个途径查找,这样查找的成本就越高。因此,必须在“冲突的机会”与“空间利用率”之间,寻找一种平衡与折衷。

所以我们也能知道,影响查找效率的因素主要有这几种:

  • 散列函数是否可以将哈希表中的数据均匀地散列?

  • 怎么处理冲突?

  • 哈希表的加载因子怎么选择?

本文主要对后两个问题进行介绍。

解决冲突有什么方法?

1. 开放定址法
Hi= (H(key) + di) MOD m,其中i=1,2,...,k(k<=m-1)

H(key)为哈希函数,m为哈希表表长,di为增量序列,i为已发生冲突的次数。其中,开放定址法根据步长不同可以分为3种:

1.1 线性探查法(Linear Probing):di = 1,2,3,…,m-1

简单地说,就是以当前冲突位置为起点,步长为1循环查找,直到找到一个空的位置,如果循环完了都占不到位置,就说明容器已经满了。举个栗子,就像你在饭点去街上吃饭,挨家去看是否有位置一样。

1.2 平方探测法(Quadratic Probing):di = ±12, ±22,±32,…,±k2(k≤m/2)

相对于线性探查法,这就相当于的步长为di = i2来循环查找,直到找到空的位置。以上面那个例子来看,现在你不是挨家去看有没有位置了,而是拿手机算去第i2家店,然后去问这家店有没有位置。

1.3 伪随机探测法:di = 伪随机数序列

这个就是取随机数来作为步长。还是用上面的例子,这次就是完全按心情去选一家店问有没有位置了。

但开放定址法有这些缺点:

  • 这种方法建立起来的哈希表,当冲突多的时候数据容易堆集在一起,这时候对查找不友好;

  • 删除结点的时候不能简单将结点的空间置空,否则将截断在它填入散列表之后的同义词结点查找路径。因此如果要删除结点,只能在被删结点上添加删除标记,而不能真正删除结点;

  • 如果哈希表的空间已经满了,还需要建立一个溢出表,来存入多出来的元素。

2. 再哈希法
Hi= RHi(key), 其中i=1,2,...,k

RHi()函数是不同于H()的哈希函数,用于同义词发生地址冲突时,计算出另一个哈希函数地址,直到不发生冲突位置。这种方法不容易产生堆集,但是会增加计算时间。

所以再哈希法的缺点是:

  • 增加了计算时间。

3. 建立一个公共溢出区

假设哈希函数的值域为[0, m-1],设向量HashTable[0,…,m-1]为基本表,每个分量存放一个记录,另外还设置了向量OverTable[0,…,v]为溢出表。基本表中存储的是关键字的记录,一旦发生冲突,不管他们哈希函数得到的哈希地址是什么,都填入溢出表。

但这个方法的缺点在于:

  • 查找冲突数据的时候,需要遍历溢出表才能得到数据。

4. 链地址法(拉链法)

将冲突位置的元素构造成链表。在添加数据的时候,如果哈希地址与哈希表上的元素冲突,就放在这个位置的链表上。

拉链法的优点:

  • 处理冲突的方式简单,且无堆集现象,非同义词绝不会发生冲突,因此平均查找长度较短;

  • 由于拉链法中各链表上的结点空间是动态申请的,所以它更适合造表前无法确定表长的情况;

  • 删除结点操作易于实现,只要简单地删除链表上的相应的结点即可。

拉链法的缺点:

需要额外的存储空间。

从HashMap的底层结构中我们可以看到,HashMap采用是数组+链表/红黑树的组合来作为底层结构,也就是开放地址法+链地址法的方式来实现HashMap。
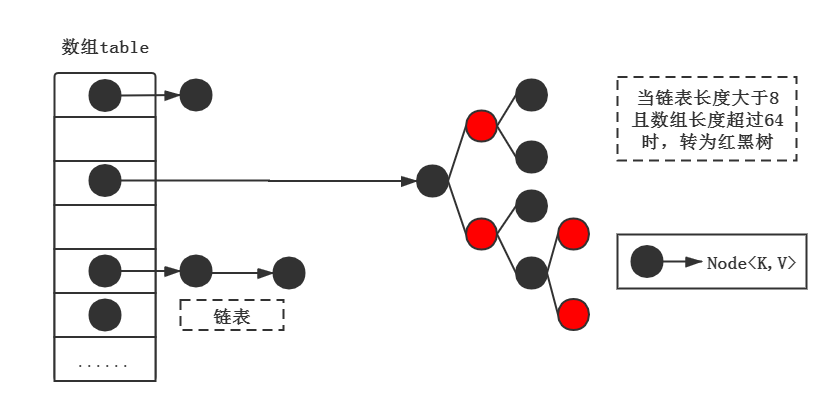
至于为什么在JDK1.8的时候要运用到红黑树,下篇文章会介绍。

为什么HashMap加载因子一定是0.75?而不是0.8,0.6?

从上文我们知道,HashMap的底层其实也是哈希表(散列表),而解决冲突的方式是链地址法。HashMap的初始容量大小默认是16,为了减少冲突发生的概率,当HashMap的数组长度到达一个临界值的时候,就会触发扩容,把所有元素rehash之后再放在扩容后的容器中,这是一个相当耗时的操作。

而这个临界值就是由加载因子和当前容器的容量大小来确定的:

临界值 = DEFAULT_INITIAL_CAPACITY * DEFAULT_LOAD_FACTOR

即默认情况下是16x0.75=12时,就会触发扩容操作。

那么为什么选择了0.75作为HashMap的加载因子呢?笔者不才,通过看源码解释和大佬的文章,才知道这个跟一个统计学里很重要的原理——泊松分布有关。

泊松分布是统计学和概率学常见的离散概率分布,适用于描述单位时间内随机事件发生的次数的概率分布。有兴趣的读者可以看看维基百科或者阮一峰老师的这篇文章:[泊松分布和指数分布:10分钟教程][10]
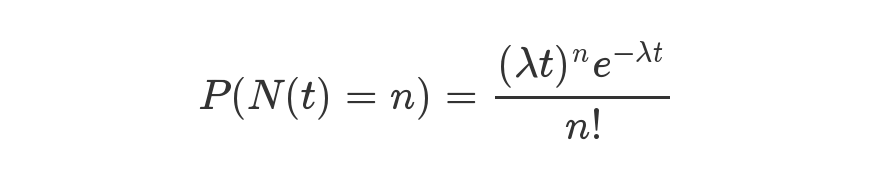
等号的左边,P 表示概率,N表示某种函数关系,t 表示时间,n 表示数量。等号的右边,λ 表示事件的频率。

在HashMap的源码中有这么一段注释:

/* Ideally, under random hashCodes, the frequency of     * nodes in bins follows a Poisson distribution     * (http://en.wikipedia.org/wiki/Poisson_distribution) with a     * parameter of about 0.5 on average for the default resizing     * threshold of 0.75, although with a large variance because of     * resizing granularity. Ignoring variance, the expected     * occurrences of list size k are (exp(-0.5) * pow(0.5, k) /     * factorial(k)). The first values are:     *     * 0:    0.60653066     * 1:    0.30326533     * 2:    0.07581633     * 3:    0.01263606     * 4:    0.00157952     * 5:    0.00015795     * 6:    0.00001316     * 7:    0.00000094     * 8:    0.00000006     * more: less than 1 in ten million

笔者拙译:在理想情况下,使用随机哈希码,在扩容阈值(加载因子)为0.75的情况下,节点出现在频率在Hash桶(表)中遵循参数平均为0.5的泊松分布。忽略方差,即X = λt,P(λt = k),其中λt = 0.5的情况,按公式:
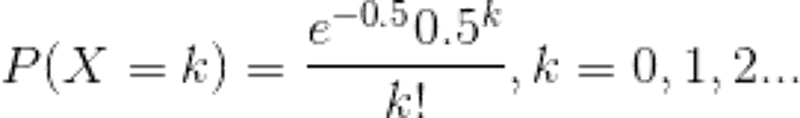
计算结果如上述的列表所示,当一个bin中的链表长度达到8个元素的时候,概率为0.00000006,几乎是一个不可能事件。

所以我们可以知道,其实常数0.5是作为参数代入泊松分布来计算的,而加载因子0.75是作为一个条件,当HashMap长度为length/size ≥ 0.75时就扩容,在这个条件下,冲突后的拉链长度和概率结果为:

0:    0.60653066
1:    0.30326533
2:    0.07581633
3:    0.01263606
4:    0.00157952
5:    0.00015795
6:    0.00001316
7:    0.00000094
8:    0.00000006

那么为什么不可以是0.8或者0.6呢?

HashMap中除了哈希算法之外,有两个参数影响了性能:初始容量和加载因子。初始容量是哈希表在创建时的容量,加载因子是哈希表在其容量自动扩容之前可以达到多满的一种度量。

在维基百科来描述加载因子:

对于开放定址法,加载因子是特别重要因素,应严格限制在0.7-0.8以下。超过0.8,查表时的CPU缓存不命中(cache missing)按照指数曲线上升。因此,一些采用开放定址法的hash库,如Java的系统库限制了加载因子为0.75,超过此值将resize散列表。

在设置初始容量时应该考虑到映射中所需的条目数及其加载因子,以便最大限度地减少扩容rehash操作次数,所以,一般在使用HashMap时建议根据预估值设置初始容量,以便减少扩容操作。

选择0、75作为默认的加载因子,完全是时间和空间成本上寻求的一种折衷选择。

结语

曾经有一堆高数、线性代数、离散数学摆在我面前,但是我没有珍惜。等到碰到各种数学问题的时候,才后悔莫及。学计算机的时候最痛苦的事,莫过于此。如果老天可以再给我一个,再来一次的机会的话。我会跟当时的我,说三个字——“学数学!”
数学真的太重要。离开大学之后,该怎么学数学啊,有什么好的建议吗?

如果本文对你有帮助,请给一个赞吧,这会是我最大的动力~


福利:

在这里,我为大家准备了一份2020年最新最全的面试题及答案,这套电子书涵盖了诸多后端,客户端,前端技术栈的面试题和答案,相信可以帮助大家在最短的时间内复习的大多数面试题,从而拿到自己心仪的offer。


END

历史推荐面试官问:说说悲观锁、乐观锁、分布式锁?都在什么场景下使用?有什么技巧?面试官问我:用了HTTPS就安全了吗?用了HTTPS会被抓包吗?我竟然回答不上来...美团面试题:String s = new String("111")会创建几个对象?
面试官:POST 比 GET 安全吗?你理解就是错的
点个在看吧
【Bug已解决】codex: tool call timeout / Function execution exceeds limit — CodeX CLI 工具调用超时解决方案 CodeX CLI 工具调用超时(Bash/文件/MCP)的解决方案,含增加超时、拆分命令、后台运行、避免交互卡住与限制读取。 阅读详情

相关推荐

暴力破解pdf文档密码

相信小伙伴们都遇到这种情况;你收到了一些标题很吸引人的pdf文档 或者是重要数据泄露 学习资料总结,再或者是某机构的押题密卷,打开pdf却提示你要输入密码 因为不知道密码 只能弃罢。我就遇到过这种情况 网友发来了标题为某天一的押题密卷 ,我也想看看这个卷子的题怎么样,因为被设置了密码 我尝试用6到10位的纯数字组合来暴力破解这个pdf,结果三 四个小时都没找到正确的密码。有些网友为破解这个密码 请某宝某多来破解 也都没有破解成功。

shelter1234567的博客 1万+

HashMap中的加载因子

面试题可能考的HashMap中的加载因子

qq_38661277的博客 1215

XianYuAutoDeliveryX:基于闲鱼API与大模型的智能自动发货系统实践

本文详细介绍了如何利用XianYuAutoDeliveryX系统,结合闲鱼API与大语言模型,构建一个智能自动发货解决方案。该系统能实现买家付款后秒级自动发货,并通过对接ChatGPT等大模型智能回复买家咨询,有效解放卖家时间,提升虚拟商品店铺的运营效率和客户体验。

bush的博客 1015

总结:理解 HashMap 加载因子

HashMap梳理

w2009211777的专栏 2422

导数在工程与AI中的12个实战应用解析

导数作为数学中的基本概念,本质是描述变化率的工具,其核心价值在于将非线性问题局部线性化处理。从原理上看,通过极限过程捕捉函数瞬时变化特性,使工程师能精确控制系统动态行为,帮助科学家量化自然规律变化速率。在技术实现层面,现代符号计算(如Mathematica)、数值计算(如MATLAB)和自动微分(如PyTorch)工具链的发展,大幅提升了导数计算的效率与精度。典型应用场景涵盖机械控制(如ABS防抱死系统)、金融工程(如期权希腊值计算)、医疗影像(如Canny边缘检测)等领域。特别在机器学习中,反向传播算法依

weixin_35509395的博客 316

动态刷新曲线_【GhPython应用】利用反射刷新Image sampler组件

【版权声明】| 作者:月之眼|案例图片来源:Sergiu Radu Pop的facebook| 如有侵权,请联系大水牛平台|如果觉得文章不错,欢迎分享效果展示利用python刷新Image sampler组件,主要的思路就是X输入端:输入要切换的图片路径,我的案例中输入了9张图片。然后通过100毫秒切换一张图片显示,来达到动态显示效果。代码分析run输入端类型:bool (I...

weixin_42393829的博客 531

Java 集合的加载因子

HashSet()的一个构造方法,看注释说其中0.75代表的是默认的加载因子 public HashSet(Collection<? extends E> c) { map = new HashMap<>(Math.max((int) (c.size()/.75f) + 1, 16)); addAll(c); } 加载因子是表示H...

weixin_30656145的博客 668

2025美赛C题奥运奖牌榜模型(附代码+全保姆教程)Models for Olympic Medal Tables

伟大教练”效应的测量方法定义奖牌变化率:−−​如果变化率显著为正,且超出历史平均增长率,则认为存在“伟大教练”效应。使用统计方法(如t检验)验证教练到来是否带来显著性差异。

博客 6371

HashMap 加载因子

HashMap 加载因子

chentianqin的博客 627

软考嵌入式 第五讲 嵌入式Linux系统技术

5.1 inittab配置文件 Linux实时操作系统开机引导时首先启动内核,由内核检查和初始化硬件设备,载入设备的驱动程序模块,安装root文件系统,然后内核将启动一个名为init的进程,它是系统运行的第一个进程,进程号为1。在init运行完成并启动其他必要的后续进程后,系统开始运行,引导过程结束。 在任何时候,可以在文件inittab中添加新的记录项。重新检查inittab文件时,可以通过命令:init q/ Q使init进程立即重新读取并处理文件inittab。 5.1.1 inittab文件记录

Leon的博客 526

滑模观测器与锁相环结合应用:让电机“无感”也能精准旋转的奥秘

本文介绍了永磁同步电机无传感器控制中的滑模观测器(SMO)结合锁相环(PLL)技术。SMO通过创建虚拟电机模型,利用电流误差产生控制信号来估计反电动势;PLL则从反电动势中解码转子位置和速度信息。该组合方案兼具SMO的鲁棒性和PLL的高精度,计算量小且硬件要求低。文章详细阐述了原理、数学模型、参数整定方法及实际实现技巧,包括离散化处理、符号函数替代等优化手段,并分析了低速性能限制、抖振问题等常见挑战及解决方案。最后指出该技术未来将与人工智能、多观测器融合等方向结合发展。

汽车软件开发 193

关于HashMap的加载因子相关理解

HashMap在JDK1.7是以数组加链表的形式组成,JDK1.8后新增了红黑树结构,当链表大于8并且容量大于64时,链表结构会转成红黑树结构。 JDK1.8 之所以会加入红黑树是因为当链表过长是会严重影响HashMap的性能,而红黑树具有快速增删改查的特点。 关于加载因子 加载因子也叫作扩容因子,用来判断什么时候进行扩容,假设加载因子为0.75,HashMap的初始容量为16,当HashMap中有16 * 0.75 = 12个容量时,HashMap就会进行扩容。 如果加载因子越大,扩容发生的频率就会比较低

qq_37461678的博客 551

基于STM32设计的老人防摔倒报警设备(OneNet)_65

本文设计了一种基于STM32单片机的智能老人防摔倒报警设备。该系统结合MPU6050陀螺仪传感器实时监测老人的姿态变化,检测摔倒事件;通过SIM800C通信模块发送短信通知紧急联系人,并将GPS定位信息上传至云端平台,确保家属能够及时了解老人的准确位置。

1万+

【转载】HashMap默认加载因子为什么选择0.75?

HashMap默认加载因子为什么选择0.75?

weixin_41432808的博客 1219

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

HashMap默认加载因子为什么选择0.75?(阿里)

Hashtable 初始容量是11 ,扩容 方式为2N+1; HashMap 初始容量是16,扩容方式为2N;   阿里的人突然问我为啥扩容因子是0.75,回来总结了一下; 提高空间利用率和 减少查询成本的折中,主要是泊松分布,0.75的话碰撞最小, HashMap有两个参数影响其性能:初始容量和加载因子。容量是哈希表中桶的数量,初始容量只是哈希表在创建时的容量。加载因子是哈希表在...

2539

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

为什么java Hashmap 中的加载因子是默认为0.75

前几天在一个群里看到有人讨论hashmap中的加载因子为什么是默认0.75。 HashMap源码中的加载因子 static final float DEFAULT_LOAD_FACTOR = 0.75f; 当时想到的是应该是“哈希冲突”和“空间利用率”矛盾的一个折衷。 跟数据结构要么查询快要么插入快一个道理,hashmap就是一个插入慢、查询快的数据结构。 加载因子是表示Hs...

没有伞的孩子必须努力奔跑!—小林 1113

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

深入理解HashMap加载因子:为什么默认值是0.75?

在Java中,HashMap是一个广泛应用的数据结构,用于存储键值对。HashMap的性能与其内部实现密切相关,其中一个关键参数就是加载因子(load factor)。而常见的默认加载因子值是0.75。在本文中,我们将深入探讨加载因子的作用,为什么选择0.75作为默认值,并通过例子来说明其影响。

qq_28068311的博客 1944

HashMap默认加载因子为什么选择0.75?

HashMap默认加载因子为什么选择0.75?(阿里) Hashtable 初始容量是11 ,扩容 方式为2N+1; HashMap 初始容量是16,扩容方式为2N;   阿里的人突然问我为啥扩容因子是0.75,回来总结了一下;提高空间利用率和 减少查询成本的折中,主要是泊松分布,0.75的话碰撞最小, HashMap有两个参数影响其性能:初始容量和加载因子。容量是哈希表中桶的数量...

weixin_42667198的博客 245

Java中HashMap默认的加载因子为什么是0.75

加载因子的作用: Hashmap的底层使用的是hash表进行数据的存储,随着表中的元素不断增加,当哈希表中的条目数超出了加载因子与当前容量的乘积时,则要对该哈希表进行扩容、rehash操作(即重建内部数据结构)。即加载因子是哈希表在其容量自动扩容之前可以达到多满的一种度量,其大小决定了HashMap的数据密度。 加载因子为什么是为什么是0.75? 首先明白什么是hash冲突: 假设哈希表的地址集为[0,n),冲突是指由关键字得到的哈希地址为j(0<=j<=n-1)的位置上已经有记录。在关键字得到

qq_45800640的博客 975

面试细节:为什么 HashMap 默认加载因子非得是0.75?

你知道的越多,不知道的就越多,业余的像一棵小草!你来,我们一起精进!你不来,我和你的竞争对手一起精进!编辑:业余草来源:blog.csdn.net/NYfor2017/article/d...

xmt1139057136的专栏 353

hashmap扩容因子_面试细节:为什么 HashMap 默认加载因子非得是0.75?

你知道的越多,不知道的就越多,业余的像一棵小草!你来,我们一起精进!你不来,我和你的竞争对手一起精进!编辑:业余草来源:blog.csdn.net/NYfor2017/article/details/105454097推荐:https://www.xttblog.com/?p=5026前言有很多东西之前在学的时候没怎么注意,笔者也是在重温HashMap的时候发现有很多可以去细究的问题,最...

weixin_26804345的博客 701
上一篇: 程序员必备的 11 大Intellij插件
下一篇: Rust 能开发App了,谷歌宣布安卓加入对 Rust 的支持!
DevolperFront
博客等级 码龄8年 464粉丝 81原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值