深度卷积对抗神经网络 基础 第三部分 (WGAN-GP)

深度探索:机器学习中的WGAN-GP算法原理及其应用 Wasserstein GAN with Gradient Penalty(WGAN-GP)凭借其在解决GAN训练不稳定性和提高生成质量方面的突出贡献,已成为生成对抗网络领域的关键算法之一。尽管存在计算复杂度较高、K-Lipschitz约束实现难度大等挑战,但随着硬件加速技术的发展和算法优化研究的深入,这些难点有望得到进一步解决。未来,WGAN-GP有望在更多领域(如强化学习、物理模拟、生物信息学等)发挥重要作用,推动生成对抗网络技术的持续进步与广泛应用。 阅读详情

深度卷积对抗神经网络 基础 第三部分 (WGAN-GP)

Wasserstein GAN with Gradient Penalty (WGAN-GP)

我们在训练对抗神经网络的时候总是出现各种各样的问题。比如说模式奔溃 (mode collapse)和 梯度消失(vanishing gradient)的问题。

比如说,模式奔溃,指的是生成器的学习效率远高于辨别器的时候,那么学习一段时间过后,辨别器便无法再继续提供有用的损失信息,以至于生成器无法得到参考而塌陷到一个局部最小点中去。而梯度消失指的是当损失趋于无限大或者无限小时,损失函数的值变化基本可以视为忽略,那么梯度就会消失,进而停止学习或者学习效率基本为零。

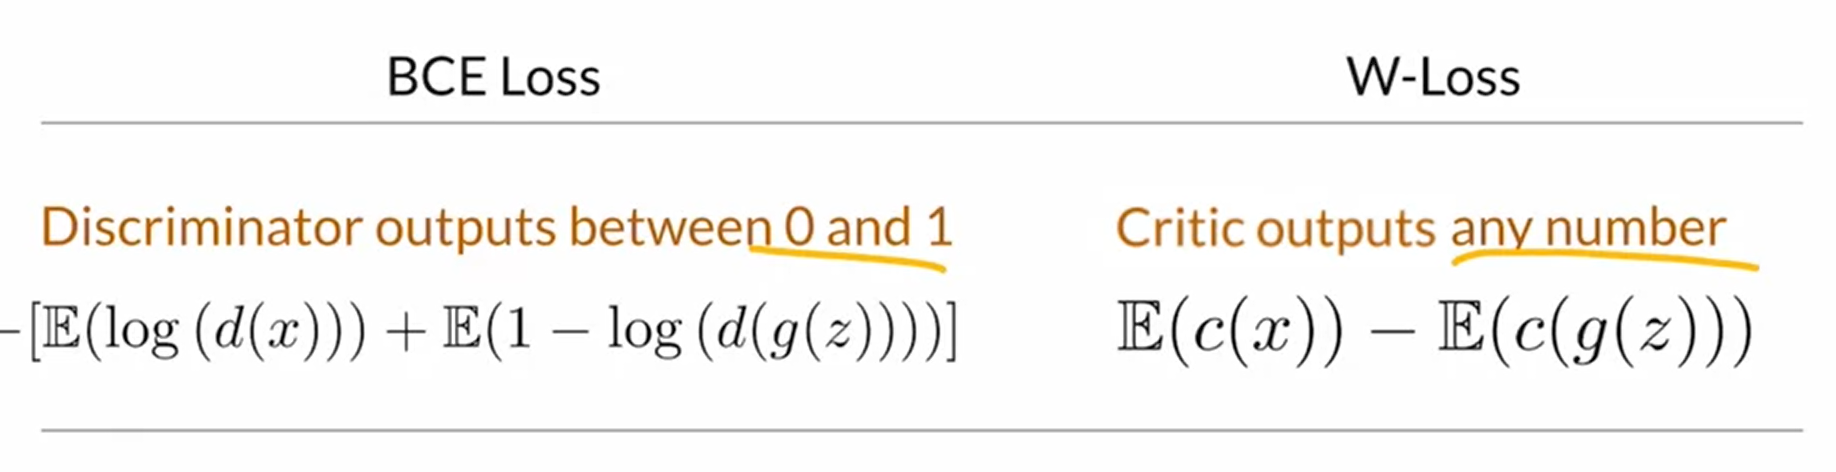
正如GANs模型中,我们经常使用BCE损失函数 (BCE loss problem)来作为模型的损失函数,但是其会存在一定的模式奔溃和梯度消失的问题。 为了解决这个问题,WGAN使用 EMD (Earth mover’s distance) 距离,通过类比定义两个曲线之间距离的方式来定义其损失的函数。

EMD 用于分析两张图片的距离,其实是计算两个分布数据之间的距离,也就是所谓的推土机距离。当其应用于比较生成图像和真图像的距离时,其不会直接想BCEloss那样直接使用判别器的判别结果,而是根据计算生成图像和真图像的分布距离来作为反馈,这样就可以直接避免上述的两个问题。一来模式不会立刻崩溃,而是生成一组图片才会有一个评分结果,并且比较的不是单一图像的差距,而是生成图像和真图像的分布差距。其次,这个距离可以通过对critic函数限制来达到避免梯度消失的问题。

  • Function of amount and distance
  • Doesn’t have a flat regions when the distributions are very different
  • approximating EMD solves mode collapse and vanishing gradient from BCE LOSS

Wasserstein loss: with c(x) critic
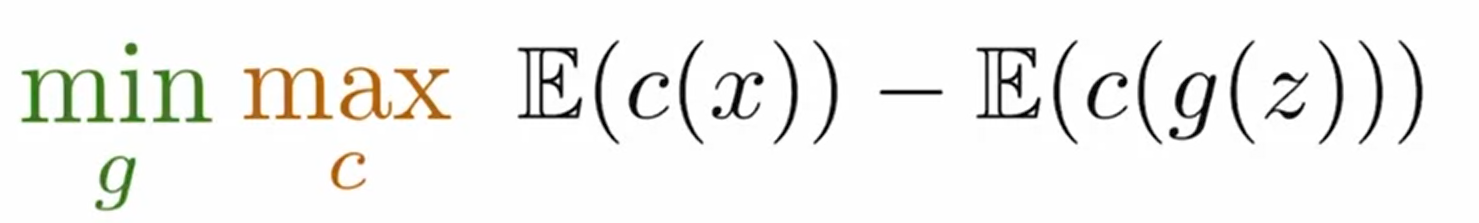
Screenshot 2023-01-12 183853

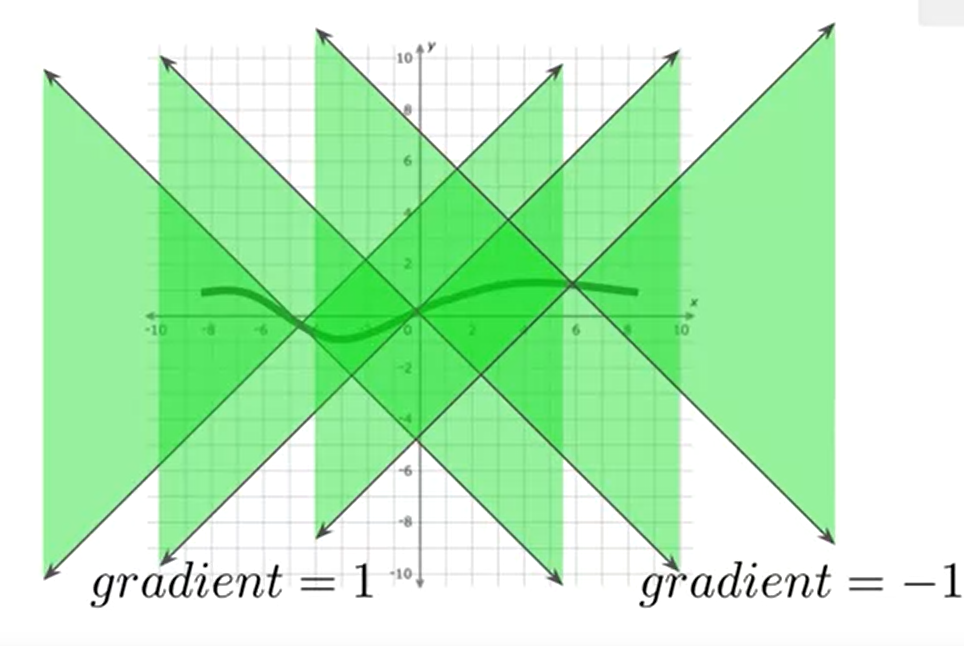
这个函数需要满足 1-Lipschitz 连续条件。This function needs to be 1-Lipschitz Continuous to validate W-loss

其主要是满足训练时的稳定性条件,其斜率的绝对值被正负一所限制。 which will maintain some stability during training
Screenshot 2023-01-12 184223

Screenshot 2023-01-12 183536

相对于BCE损失函数,W损失函数如何可以变得更加稳定?enforce this condition (feature space)

这个模型通过加入一个修正项的方式来矫正其满足1-lipschitz条件。

那么如何权衡? How much to weigh this regularization term against the main loss function 如何权衡main loss和penalty使得其满足1-L 连续条件

方法一: 梯度惩罚 Gradient penalty

这个方法很简单,当梯度大于一时,我们通过修正项进行修正,使得学习稳定一些。而如何检测梯度的值也非常重要,如果每次计算损失都检测,那么一定是不值当的。因此我们对特征空间中的点进行插值的方式类进行计算。x^\hat{x}x^便是插值点,我们只要计算插值点的梯度值来代替这一区域的梯度。

  • 通过在W-loss中加入一个gradient penalty,当其值大于一时,其gradient过于大,那么我们就控制其小于1.
  • 但是又无法对所有feature space中的点都进行插值,因此我们需要将真假照片进行插值处理来计算gradient。
  • gradient penalty 用来计算真假的gradient的理想值,我们想要这个值在与正负一的距离**<=1**。
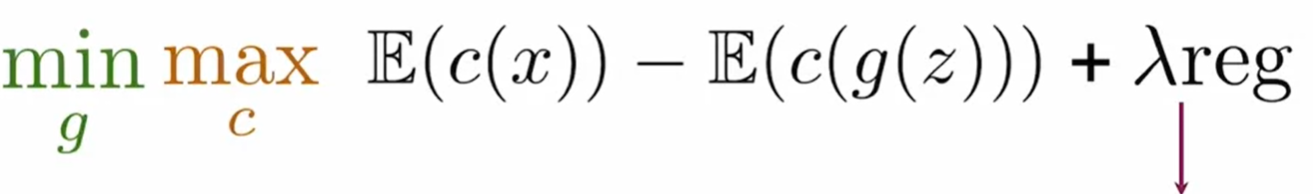
Screenshot 2023-01-12 190733

插值interpolation x^\hat{x}x^的表示式为:
x^=ϵx+(1−ϵ)g(z) \hat{x} = \epsilon x + (1- \epsilon)g(z) x^=ϵx+(1−ϵ)g(z)
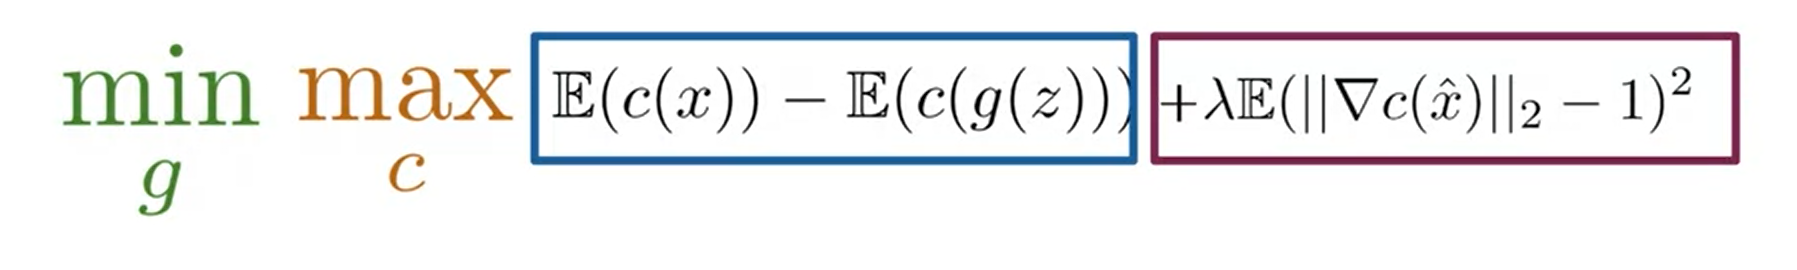
Screenshot 2023-01-12 190115

C 表示critisizer, G代表 generator,上述表达式中 第一项 E(c(x))E(c(x))E(c(x)) 指的是C识别真图片的期望,因此,越高越好。第二项 E(c(g(x)))E(c(g(x)))E(c(g(x)))指的是C识别假图片的期望,因此越低越高,这样 第一项减去第二项便是越高越好,因此总体来说,对于C来说,整体项越大越好,C的有效率越高。而在当C取到最有效的鉴别器后,这时,寻找最高效的生成器便是最重要的。那么反过来,第一项无法改变,而第二项则是越大越好,越大意味着C把假图片识别成了真图片,因此整体便是越小越好。这也是为什么会有 min max之说。

  • fake 分数越高, critic loss越高,因为fake图片的分数代表着其将假图片识别成1的分数高
  • real 分数越高,critic loss越低,因为其识别错误会是0,而识别正确是1,而critic要识别越正确越好,所以越高越好
  • gradient penalty越高,critic loss越低,因为其越高,其在中间点的gradient距离1越远,也就意味着其loss越大,因为其gradient和理想1有差别。

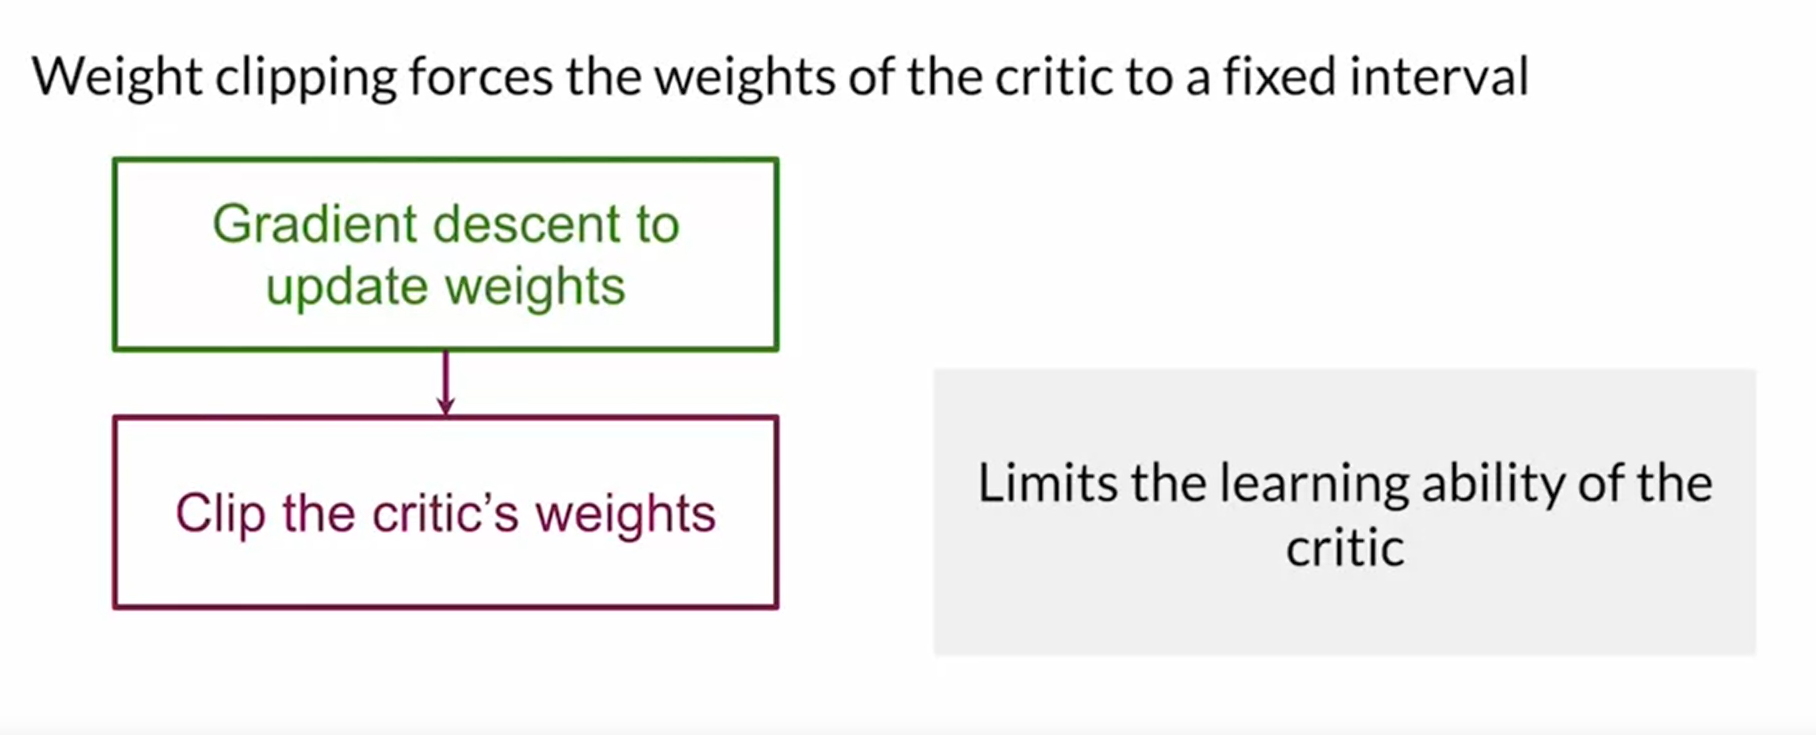
方法二: Weight clipping

通过给gradient加入一个上限和下限来使其满足1-L连续条件,问题是这种方法降低了学习能力和速率,不建议采用
Screenshot 2023-01-12 190041

Wasserstein Slim GAIN with Gradient Penalty(WSGAIN-GP)介绍及代码实现——基于生成对抗网络的缺失数据填补 WSGAIN-GP全称Wasserstein Slim GAIN with Gradient Penalty,其目的在于减少影响普通GAN以及影响WGAN的主要警告,即因权重剪裁而产生的不良行为。WSGAIN-GP的架构与WSGAIN-CP几乎相同。WSGAIN-CP的架构可以参考文章:Wasserstein Slim GAIN with Clipping Penalty(WSGAIN-CP)介绍及代码实现——基于生成对抗网络的缺失数据填补。WSGAIN-GP的生成器与WSGAIN-CP的生成器完全相同。. 阅读详情

相关推荐

GAN:WGAN-GP-带有梯度惩罚的WGAN

WGAN-GP中移除了判别器中的BN操作: 因为WGAN-gp的惩罚项计算中,惩罚的是单个数据的gradient norm,如果使用 batchNorm,就会扰乱这种惩罚,让这种特别的惩罚失效。所以只有设置的不大不小,比如c=0.01(wgan作者推荐的数值),下图中的紫色线,梯度保持相对合理,才能让生成器获得不错的回传梯度。公式在下面, 里面表达的是它在WGAN的loss上加了一个惩罚项,如果判别器的 gradient 的 norm,离 1 越远,那么 loss 的惩罚力度越高。作者发现移除后效果很好。

微风❤水墨 4661

【深度学习·命运-44】WGAN-GP

是一种强大的生成对抗网络变体,通过引入梯度惩罚项来代替传统的权重裁剪,使得训练过程更加稳定,生成效果更加优秀。WGAN-GP 在许多生成任务中取得了优异的性能,特别是在高质量图像生成领域。随着生成对抗网络的不断发展,WGAN-GP 已成为最常用的 GAN 变体之一,并广泛应用于计算机视觉、生成建模等领域。

m0_69378371的博客 1294

11、深度卷积生成对抗网络(DCGAN)及Wasserstein GAN带梯度惩罚(WGAN - GP)解析

本文详细解析了深度卷积生成对抗网络(DCGAN)和Wasserstein GAN带梯度惩罚(WGAN-GP)的工作原理与训练方法。重点探讨了GAN训练中的常见问题,如判别器过强、生成器模式崩溃、损失函数无信息性等,并介绍了WGAN-GP如何通过Wasserstein损失和梯度惩罚提高模型稳定性与生成质量。同时提供了训练流程、与传统GAN的对比分析以及实际应用中的注意事项,为理解和应用GAN模型提供了全面指导。

sony5的博客 102

WGAN-GP解读分析

WGAN-GP(Wasserstein GAN with gradient penalty)相比GAN(Generative Adversarial Network)有以下几个优点:更好的损失函数:WGAN-GP使用了Wasserstein距离来度量生成器和判别器之间的距离,相比于GAN中使用的交叉熵损失函数,Wasserstein距离更加稳定,可以避免GAN中出现的训练不稳定和模式崩溃等问题。

weixin_46238823的博客 1万+

生成对抗网络GAN原理与代码实例讲解

《生成对抗网络GAN原理与代码实例讲解》 关键词:生成对抗网络,GAN,深度学习,图像生成,训练技巧,应用实例 摘要: 生成对抗网络(Generative Adversarial Netwo

AI天才研究院 1143

PyTorch-GAN:深度学习生成对抗网络实战教程

在深度学习和人工智能领域,生成对抗网络(GANs)已成为推动创新的强大工具,尤其是在图像和数据生成方面。PyTorch-GAN项目是将这种强大技术具体化的一个集合,它以PyTorch深度学习框架为支撑,提供了实现和实验各种GAN模型的平台。本项目不仅包含经典GAN模型的实现,例如DCGAN、CGAN和WGAN-GP,还提供了便于用户交互和模型训练的示例。通过本章,我们将对PyTorch-GAN项目有一个概览,涵盖项目的目标、功能和实现的广度,为后续深入探讨各章节打下基础。

weixin_28931449的博客 1210

【Pytorch神经网络实战案例】15 WGAN-gp模型生成Fashon-MNST模拟数据

1 WGAN-gp模型生成模拟数据案例说明 使用WGAN-gp模型模拟Fashion-MNIST数据的生成,会使用到WGAN-gp模型、深度卷积GAN(DeepConvolutional GAN,DCGAN)模型、实例归一化技术。 1.1 DCGAN中的全卷积 WGAN-gp模型侧重于GAN模型的训练部分,而DCGAN是指使用卷积神经网络的GAN,它侧重于GAN模型的结构部分,重点介绍在DCGAN中使用全卷积进行重构的技术。 1.1.1 DCGAN的原理与实现 DCGAN的原理和...

小李的研究生学习日记 1万+

CISP-PTE八套真题详解(侵删)_cisp-pte 考题与答案,万字长文轻松彻底入门Flutter

接下来就是代码审计了isset()函数用于检测变量是否已设置并且非 NULL代码中base64解码出来是一个base64的一句话木马根据代码,需要我们提交一个Hello参数,参数的值为多少都行,然后我们可以通过提交z0参数的base64值进行执行命令先用phpinfo();试一下:发现执行成功那么直接写个查看key文件的系统命令(记得最后要加分号)在源代码中找到key。

2401_83947398的博客 4680

生成式对抗网络(GANs)及变体

GAN的起源及发展至今的一些变体,简单介绍思想及实现。

ssshyeong的博客 6338

告别配置迷茫:手把手教你用Vivado 2023.1配置Xilinx FPGA的DDR4 MIG IP核(含AXI接口详解)

本文详细介绍了如何在Vivado 2023.1中配置Xilinx FPGA的DDR4 MIG IP核,包括AXI接口的深度解析与优化。通过实战案例和调试技巧,帮助工程师快速掌握DDR4内存与FPGA的协同工作,提升系统性能。特别适合需要高性能计算和实时信号处理的开发者。

weixin_29231725的博客 441

GD32F103RCT6/GD32F303RCT6(6.2)USART串口实战:从寄存器配置到DMA高效传输

本文详细介绍了GD32F103RCT6和GD32F303RCT6的USART串口通信实战,从寄存器配置到DMA高效传输的全过程。通过具体的代码示例和优化建议,帮助开发者快速掌握串口通信的关键技术,提升嵌入式开发效率。特别强调了DMA在高速数据传输中的优势和应用技巧。

weixin_33725239的博客 309

PyTorch计算机视觉(8)——WGAN及其变体WGAN-GP

本节介绍了 WGAN 及其改进版 WGAN-GP 的原理与实现,重点解决传统 GAN 的模式坍塌和训练不稳定问题。WGAN 通过引入 Wasserstein 距离作为损失函数,并采用权重裁剪满足 1-Lipschitz 连续性,但生成质量仍有限。WGAN-GP 进一步用梯度惩罚替代权重裁剪,通过计算插值样本的梯度范数约束判别器,显著提升训练稳定性。

盼小辉丶的博客 3587

Linux PE vs WinPE:为何麒麟系统修复需要专属工具?

本文探讨了Linux PE与WinPE在修复国产麒麟系统时的关键差异,强调了专属工具的必要性。通过分析文件系统兼容性、引导修复、硬件适配和安全合规等方面,揭示了通用PE工具的局限性,并提供了构建专属修复工具链的实用方案,确保系统维护的高效与安全。

weixin_29290863的博客 1066

对抗神经网络(GAN)

对抗神经网络其实时两个网络的组合,可以理解为一个网络生成模拟数据,另一个网络判断生成的数据是真实的还是模拟的。生成模拟数据的网络要不断优化自己让判别的网络判断不出来,判别的网络也要优化自己让自己判断得更加准确。 一、GAN的理论知识 GAN有generator和discriminator两部分构成 generator:主要是从训练数据中产生相同分布的samples,对于输入x,类别标签y,在生成式模型中估计器联合概率分布。 discriminator:判断输入是真实数据还是generator生成的数据,即

新手的博客 1万+

【第一篇】Xshell连接服务器部署前后端项目(连接服务器)

利用Xshell连接服务器部署前后端项目

blog 1074

【调优】OpenClaw从零开始高阶调优之skill篇

本文详细解析了OpenClaw技能系统的核心机制。首先介绍了技能的分层加载逻辑,按照优先级从高到低依次为:工作区专属技能、全局共享技能、出厂自带技能和自定义路径技能。通过流程图展示了从扫描到注册的完整加载流程,并解释了同名技能覆盖规则。随后深入剖析了SKILL.md文件结构,包含YAML元数据定义技能属性和Markdown正文说明使用方法,以公众号写作技能为例展示了具体配置。文章还提供了技能优先级切换的实用技巧,帮助用户灵活管理不同版本的技能。

海兰 240

基于生成对抗网络(GAN)生成动漫头像

图为 WGAN-GP 训练1000 epoch的过程 引言 生成对抗网络(GAN)是深度学习领域的一项重大创新,其独特之处在于通过生成器和判别器之间的对抗训练,实现了对数据的无监督学习。这种创新性的训练方式使得 GAN 在图像生成、图像修复、超分辨率等领域取得了显著的成效,为人工智能带来了新的突破。 GAN 的重要性在于其突破了传统生成模型的限制,通过引入对抗训练的思想,使得生成器能够学习到更加真实的样本分布。这不仅提高了生成器的生成质量,还为解决许多实际问题提供了新的思路和方法。 同时,GAN 的应用

王不二的AI之路 3208

上位机1000条/秒数据不丢不卡:SQLite持久化队列最优方案实战

在上位机每秒1000条、1MB数据的场景下,SQLite做持久化队列是最优解可靠性拉满,ACID事务+WAL模式保证绝对不丢数据;性能完全够用,优化后每秒几千条没问题;轻量无依赖,只有一个.db文件;C#/.NET原生支持,代码简单易维护。只要按照上面的优化点和代码实现,完全能满足工业现场的需求,不用再担心数据丢失、存储卡采集的问题。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 485

《深度学习之Tensorflow》-12对抗神经网络GAN

文章目录1.DCGAN-基于深度卷积的GAN2.InfoGAN3.AC-GAN4.AEGAN:基于自编码的GAN5.WGAN:基于推土机距离的GAN6.WGAN-GP:带梯度惩罚项的WGAN7.LSGAN:最小乘二GAN8.GAN-cls:具有匹配感知的判别器9.SRGAN:适用超分辨率重建的GAN9.1 ESPCN:基于卷积神经网络的图像超分辨率方法9.2 SRGAN 1.DCGAN-基于深度卷...

三岁的博客 1210

【机器学习-09】特征工程

特征工程是机器学习模型构建的初步工作,但它的重要性却贯穿整个模型生命周期。在进行特征工程时,我们需要充分利用数据科学的知识和技巧,结合具体的应用场景和业务需求,来制定出最合适的特征提取和转换策略。只有这样,我们才能为机器学习模型提供最有价值的输入,从而使其发挥出最大的潜力。总之,特征工程是机器学习中的一项关键任务,它需要我们用心去探索、去实践、去创新。只有不断地优化和完善特征工程的过程,我们才能构建出更加准确、更加可靠的机器学习模型,为实际应用带来更大的价值。

qq_38614074的博客 2万+

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

PixelRNN—VAE—GAN/cGAN/WGAN

根据图像生成像素

红叶谷 wsp_1138886114的博客 3540

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

【 深度学习 】生成对抗网络 GAN

转置卷积是一种上采样操作(考点),用于将小尺寸的特征图扩展为大尺寸的特征图。

PANSS__的博客 1175

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

使用PyTorch构建生成对抗网络从基础实现到关键技巧详解

在PyTorch中,我们首先需要定义生成器和判别器的网络结构。一个基础的全连接生成器可以由多个线性层和激活函数(如ReLU)构成,最终使用Tanh激活函数将输出值压缩到[-1, 1]的区间,以匹配归一化后的训练图像。判别器同样由线性层组成,但在最后一层使用Sigmoid激活函数,输出一个介于0到1之间的标量,表示输入图像为真实数据的概率。通过本文的阐述,我们使用PyTorch实现了从基础GAN到融入关键技巧的改进模型。

qw940423的博客 886

GAN及其改进算法总结

GAN及其改进算法总结GAN及其各种改进算法GAN概述原理优点和不足 未来主要的方向被定在了GAN相关的一个子方向,在这里从源头总结一下GAN以及相关的一些改进算法,帮自己理清一下思路,和大家共同学习。

Avery123123的博客 1万+

生成对抗网络(GAN)

生成对抗网络(Generative Adversarial Networks)由Ian Goodfellow等人于2014年提出,通过对抗训练机制开创了生成模型的新范式。其核心思想是构建两个神经网络——生成器(Generator)和判别器(Discriminator)——在博弈中共同进化:其中:G:生成器,将随机噪声z映射到数据空间D:判别器,评估输入来自真实数据还是生成样本p_data:真实数据分布p_z:噪声先验分布(通常为标准正态分布)

m0_54570435的博客 2074

生成对抗网络(GAN)原理与实战:从DCGAN到图像生成应用

生成对抗网络(GAN)是一种基于博弈论的深度学习模型,通过生成器与判别器的对抗训练实现数据生成。其核心原理在于构建一个动态的零和博弈系统,生成器学习生成逼真数据,判别器则不断提升鉴别能力,两者在对抗中共同进化。这种对抗训练机制为图像合成、数据增强等任务提供了强大的技术基础,尤其在计算机视觉领域展现出巨大价值。从基础的DCGAN架构到进阶的StyleGAN,GAN在图像生成质量与控制能力上不断突破。在实际应用中,GAN已广泛用于图像修复、风格迁移、游戏内容生成等场景,例如通过PyTorch框架构建的DCGAN

weixin_33816300的博客 373
上一篇: 非常好用,绝对未来黑马的 Python 开源测试框架 PySimpleTest
下一篇: 深度卷积对抗神经网络 基础 第四部分 可控制的GANs(Controllable GANs)
Volavion
博客等级 码龄9年 3788粉丝 36原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Volavion

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值