LSTM

双向长短期记忆网络(Bi-LSTM) 在开始之前,首先区分下均命名为RNN,新手很容易混淆的两大神经网络:循环神经网络(Recurrent Neural Network,RNN)和递归神经网络(Recurssion Neural Network,RNN)。 递归神经网络(RNN)是空间上的展开,处理的是树状结构的信息,模型结构如下: 循环神经网络(RNN)是时间上的展开,擅长处理以时间序列数据作为输入的预测问题, 其原因在于 RNN 的网络结构可以处理时间序列数据之间的相关性。模型结构如图所示,包括输入层 x、隐藏层 h、输出层 o,在隐藏层 阅读详情

循环神经网络(RNN)点击打开链接

人们的每次思考并不都是从零开始的。比如说你在阅读这篇文章时,你基于对前面的文字的理解来理解你目前阅读到的文字,而不是每读到一个文字时,都抛弃掉前面的思考,从头开始。你的记忆是有持久性的。

传统的神经网络并不能如此,这似乎是一个主要的缺点。例如,假设你在看一场电影,你想对电影里的每一个场景进行分类。传统的神经网络不能够基于前面的已分类场景来推断接下来的场景分类。

循环神经网络(Recurrent Neural Networks)解决了这个问题。这种神经网络带有环,可以将信息持久化。
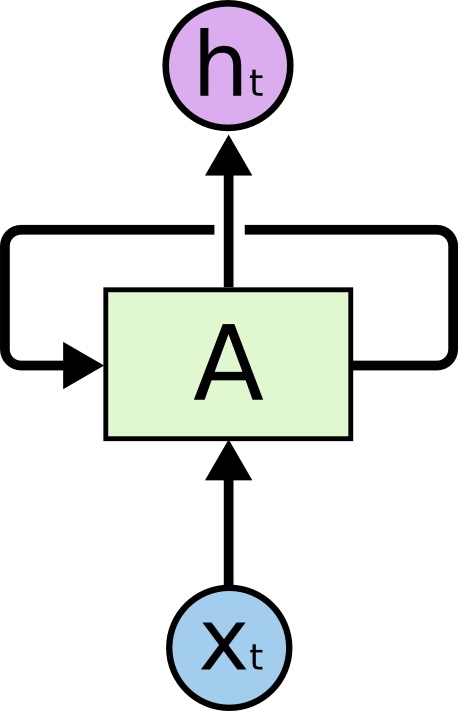
Recurrent Neural Networks have loops.

在上图所示的神经网络 A A中,输入为 Xt Xt,输出为 ht ht。 A A上的环允许将每一步产生的信息传递到下一步中。环的加入使得RNN变得神秘。不过,如果你多思考一下的话,其实RNN跟普通的神经网络也没有那么不同。一个RNN可以看作是同一个网络的多份副本,每一份都将信息传递到下一个副本。如果我们将环展开的话:
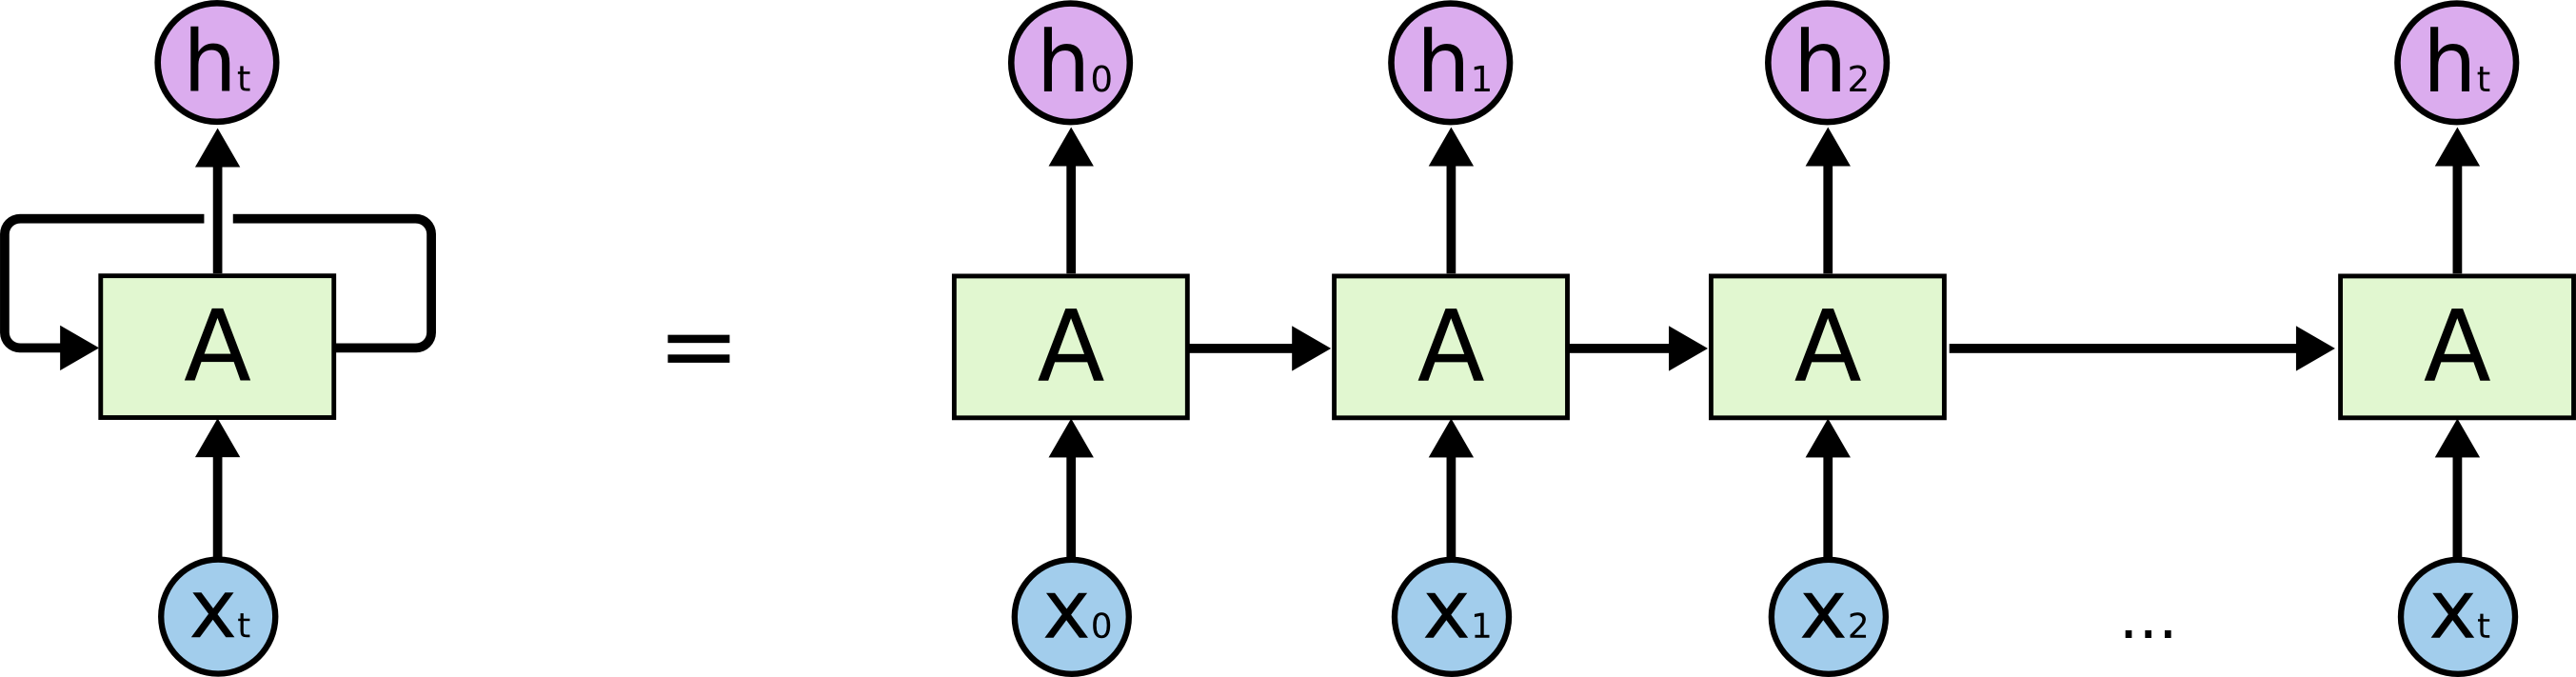
An unrolled recurrent neural network.

这种链式结构展示了RNN与序列和列表的密切关系。RNN的这种结构能够非常自然地使用这类数据。而且事实的确如此。在过去的几年里,RNN在一系列的任务中都取得了令人惊叹的成就,比如语音识别,语言建模,翻译,图片标题等等。关于RNN在各个领域所取得的令人惊叹的成就,参见这篇文章。

LSTM是这一系列成功中的必要组成部分。LSTM(Long Short Term Memory)是一种特殊的循环神经网络,在许多任务中,LSTM表现得比标准的RNN要出色得多。几乎所有基于RNN的令人赞叹的结果都是LSTM取得的。本文接下来将着重介绍LSTM。

长期依赖(Long Term Dependencies)的问题

RNN的一个核心思想是将以前的信息连接到当前的任务中来,例如,通过前面的视频帧来帮助理解当前帧。如果RNN真的能够这样做的话,那么它们将会极其有用。但是事实真是如此吗?未必。

有时候,我们只需要看最近的信息,就可以完成当前的任务。比如,考虑一个语言模型,通过前面的单词来预测接下来的单词。如果我们想预测句子“the clouds are in the sky”中的最后一个单词,我们不需要更多的上下文信息——很明显下一个单词应该是sky。在这种情况下,当前位置与相关信息所在位置之间的距离相对较小,RNN可以被训练来使用这样的信息。
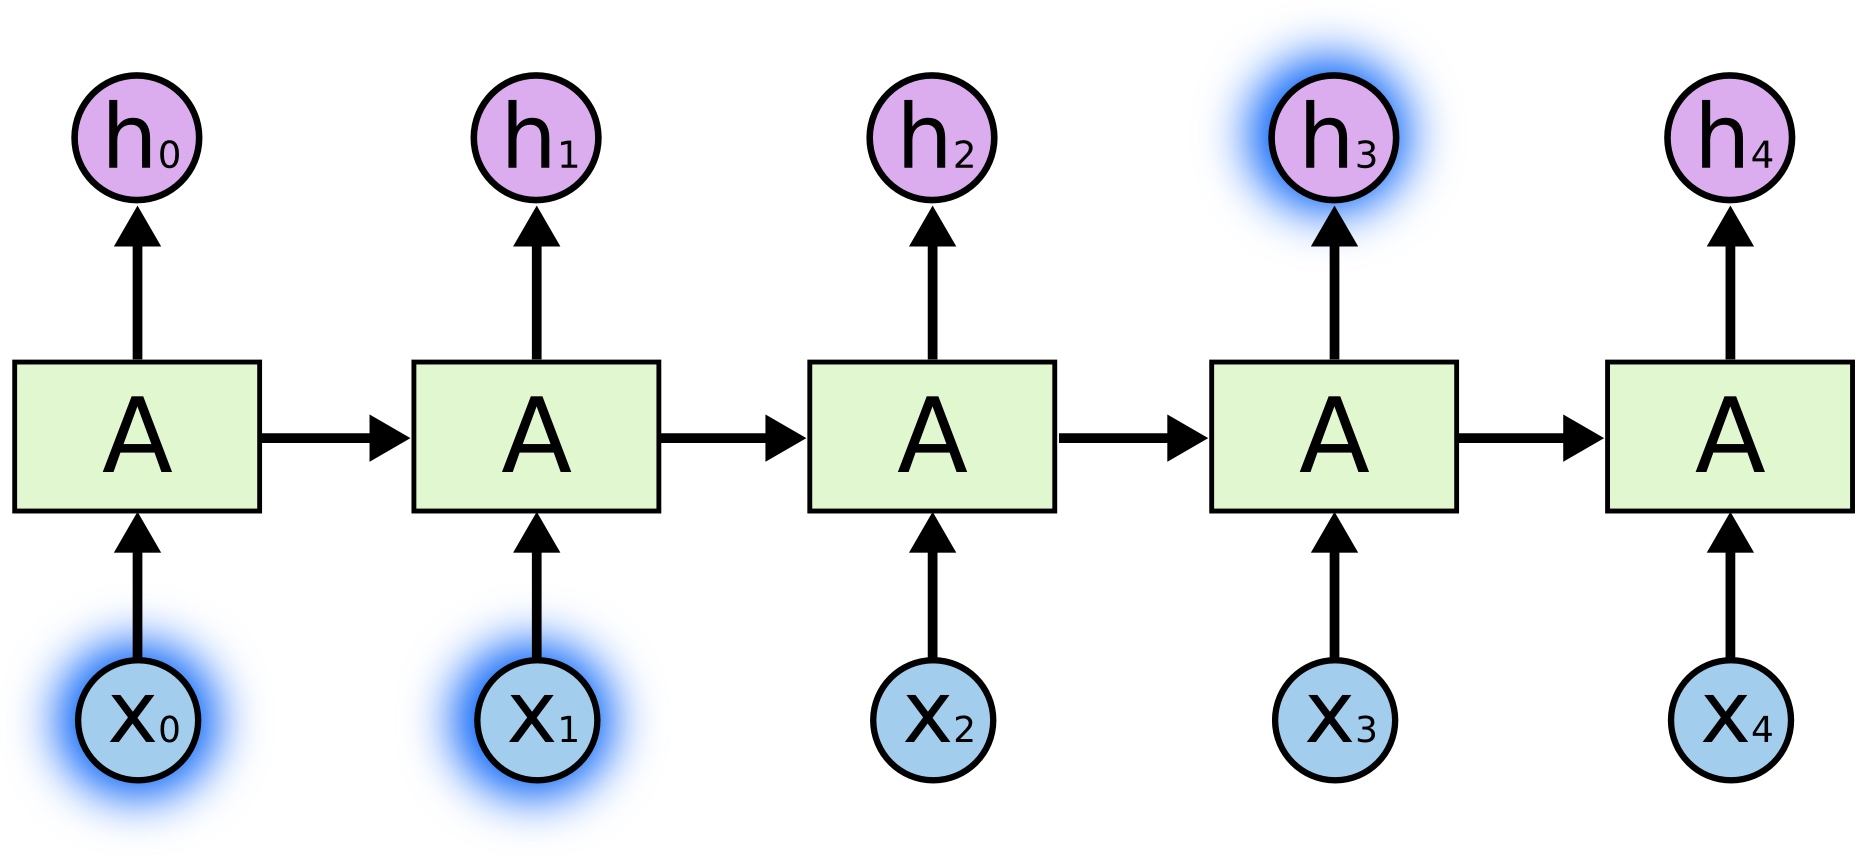
然而,有时候我们需要更多的上下文信息。比如,我们想预测句子“I grew up in France… I speak fluent French”中的最后一个单词。最近的信息告诉我们,最后一个单词可能是某种语言的名字,然而如果我们想确定到底是哪种语言的话,我们需要France这个更远的上下文信息。实际上,相关信息和需要该信息的位置之间的距离可能非常的远。

不幸的是,随着距离的增大,RNN对于如何将这样的信息连接起来无能为力。
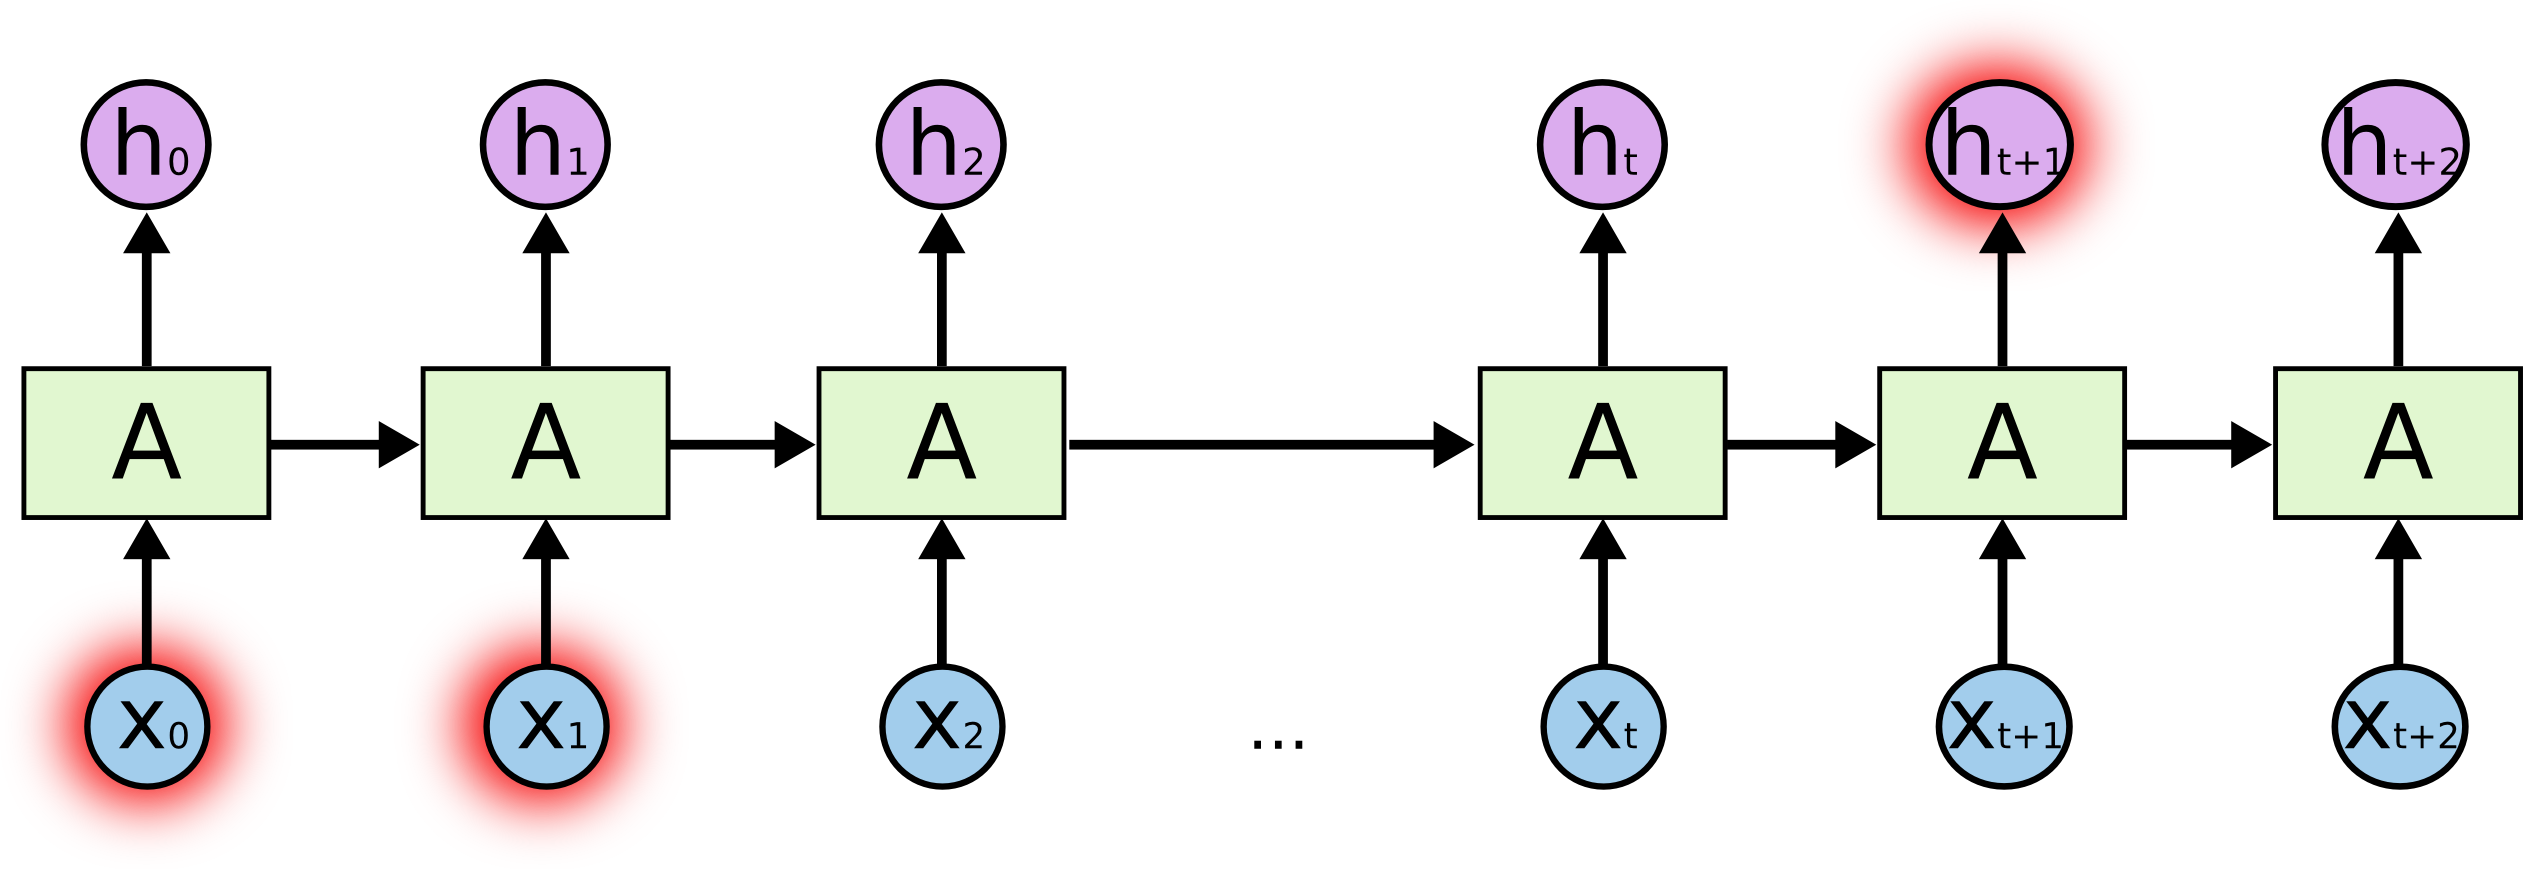
理论上说,RNN是有能力来处理这种长期依赖(Long Term Dependencies)的。人们可以通过精心调参来构建模型处理一个这种玩具问题(Toy Problem)。不过,在实际问题中,RNN并没有能力来学习这些。Hochreiter (1991) German更深入地讲了这个问题,Bengio, et al. (1994)发现了RNN的一些非常基础的问题。

幸运的是,LSTM并没有上述问题!

LSTM网络

LSTM,全称为长短期记忆网络(Long Short Term Memory networks),是一种特殊的RNN,能够学习到长期依赖关系。LSTM由Hochreiter & Schmidhuber (1997)提出,许多研究者进行了一系列的工作对其改进并使之发扬光大。LSTM在许多问题上效果非常好,现在被广泛使用。

LSTM在设计上明确地避免了长期依赖的问题。记住长期信息是小菜一碟!所有的循环神经网络都有着重复的神经网络模块形成链的形式。在普通的RNN中,重复模块结构非常简单,例如只有一个tanh层。
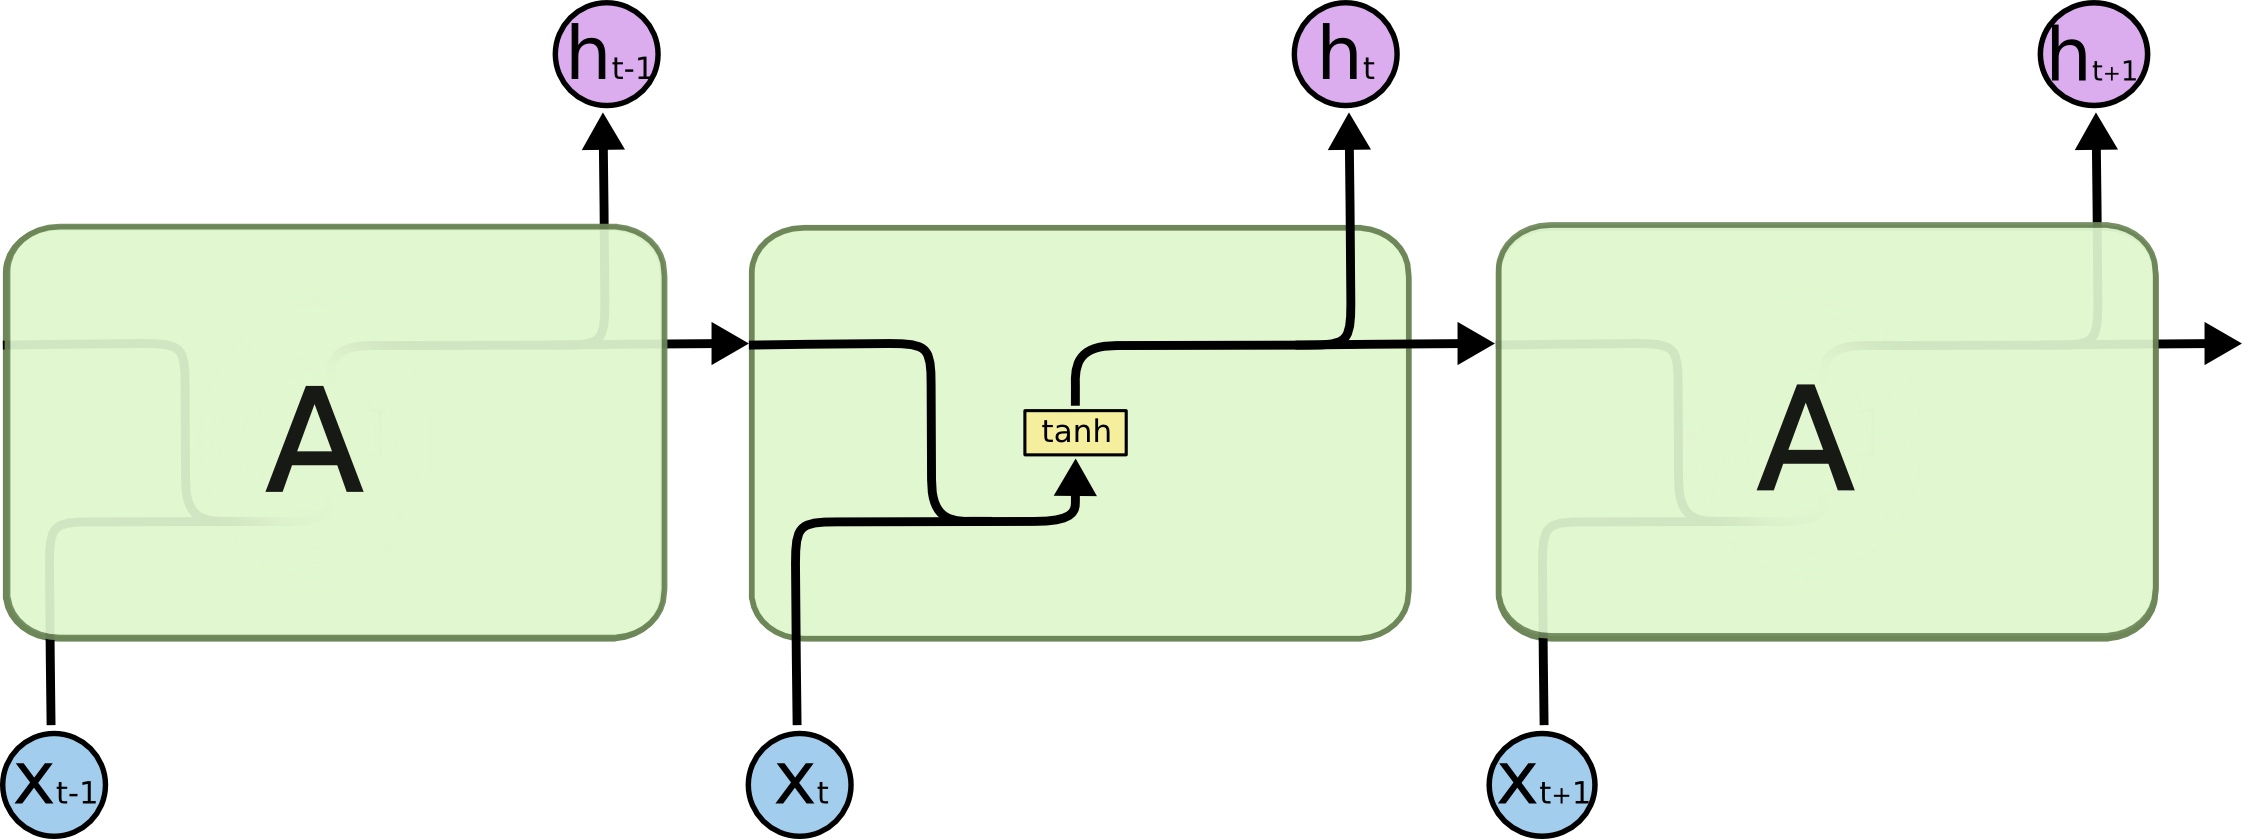
The repeating module in a standard RNN contains a single layer.

LSTM也有这种链状结构,不过其重复模块的结构不同。LSTM的重复模块中有4个神经网络层,并且他们之间的交互非常特别。
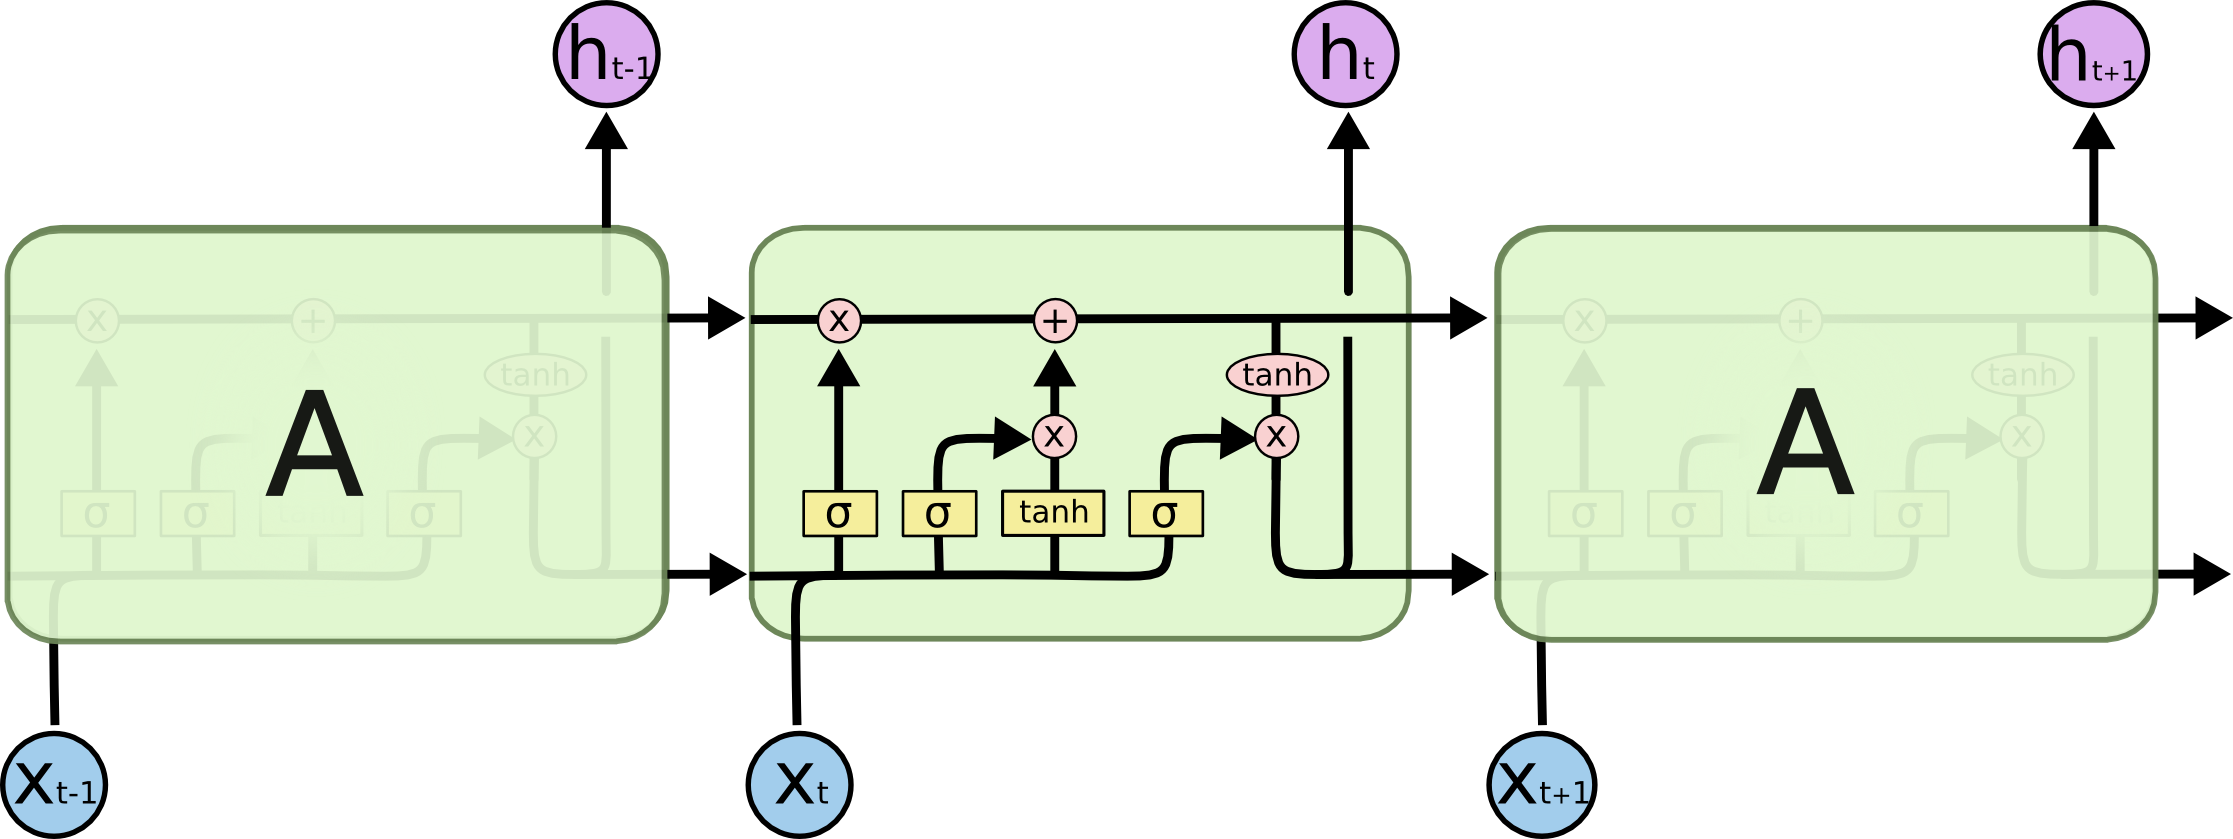
The repeating module in an LSTM contains four interacting layers.

现在暂且不必关心细节,稍候我们会一步一步地对LSTM的各个部分进行介绍。开始之前,我们先介绍一下将用到的标记。
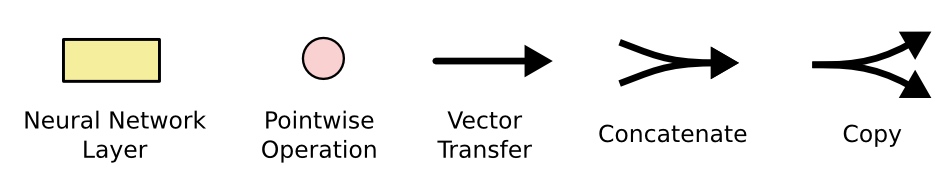
在上图中,每条线表示向量的传递,从一个结点的输出传递到另外结点的输入。粉红圆表示向量的元素级操作,比如相加或者相乘。黄色方框表示神经网络的层。线合并表示向量的连接,线分叉表示向量复制。

LSTM核心思想

LSTM的关键是元胞状态(Cell State),下图中横穿整个元胞顶部的水平线。

元胞状态有点像是传送带,它直接穿过整个链,同时只有一些较小的线性交互。上面承载的信息可以很容易地流过而不改变。
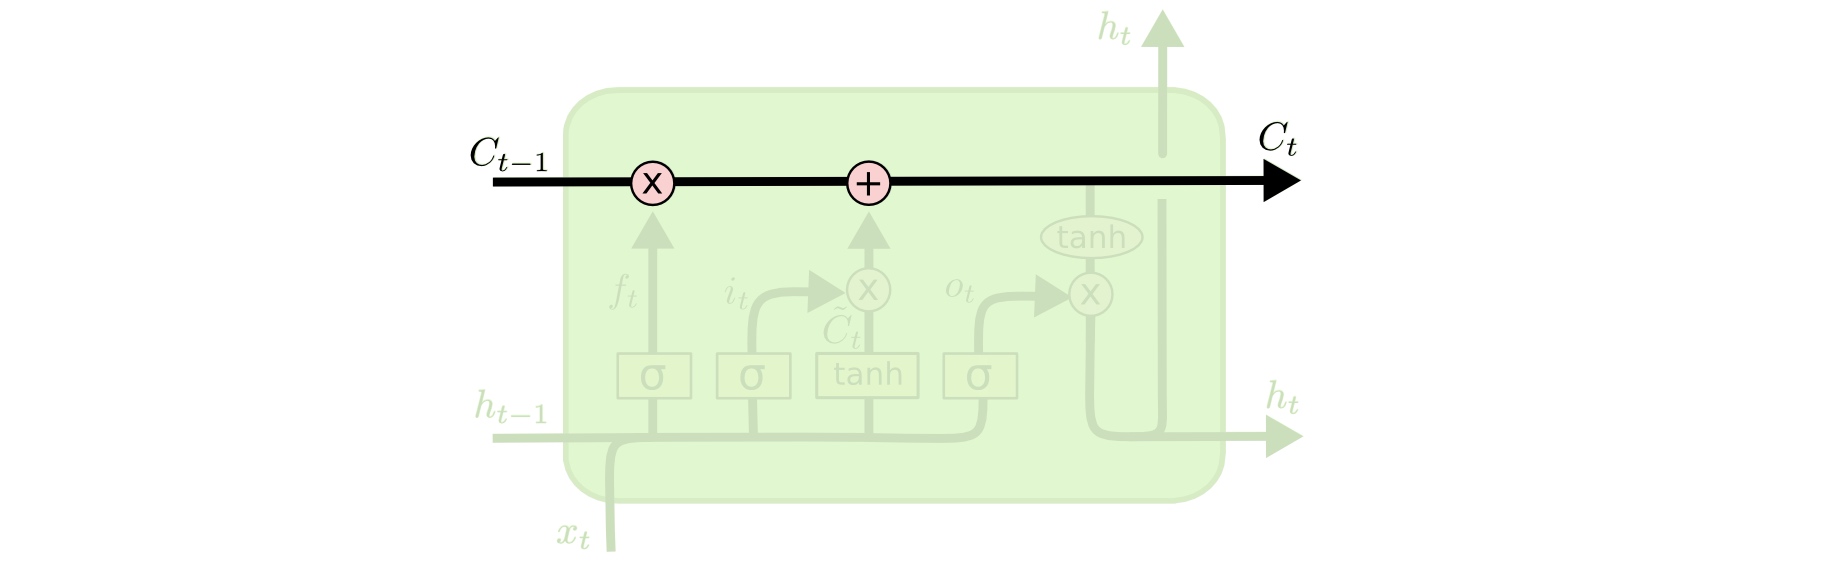
LSTM有能力对元胞状态添加或者删除信息,这种能力通过一种叫门的结构来控制。

门是一种选择性让信息通过的方法。它们由一个Sigmoid神经网络层和一个元素级相乘操作组成。
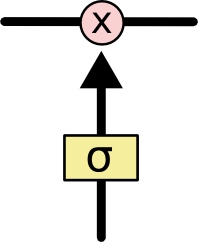
Sigmoid层输出0~1之间的值,每个值表示对应的部分信息是否应该通过。0值表示不允许信息通过,1值表示让所有信息通过。一个LSTM有3个这种门,来保护和控制元胞状态。

LSTM分步详解

LSTM的第一步是决定我们将要从元胞状态中扔掉哪些信息。该决定由一个叫做“遗忘门(Forget Gate)”的Sigmoid层控制。遗忘门观察 ht−1 ht−1和 xt xt,对于元胞状态 Ct−1 Ct−1中的每一个元素,输出一个0~1之间的数。1表示“完全保留该信息”,0表示“完全丢弃该信息”。

回到之前的预测下一个单词的例子。在这样的一个问题中,元胞状态可能包含当前主语的性别信息,以用来选择正确的物主代词。当我们遇到一个新的主语时,我们就需要把旧的性别信息遗忘掉。
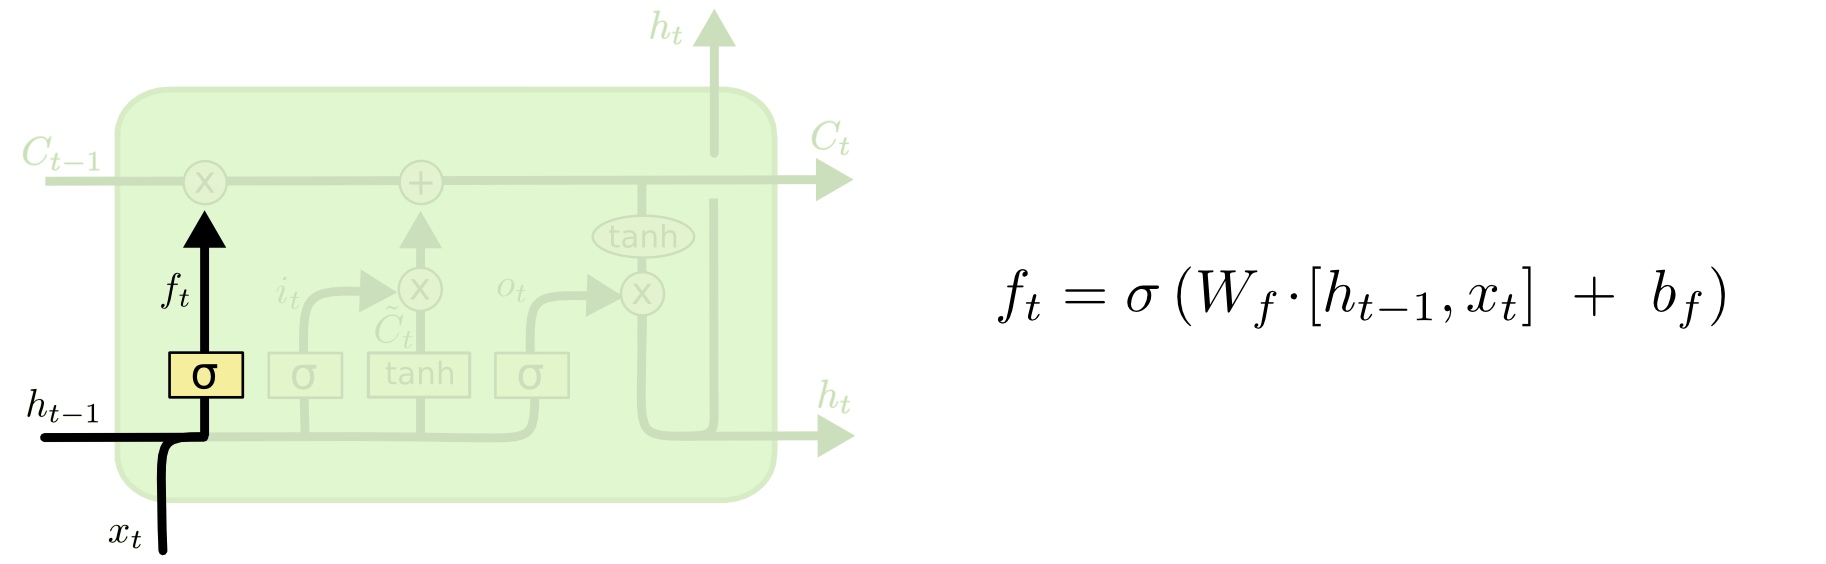
下一步是决定我们将会把哪些新信息存储到元胞状态中。这步分为两部分。首先,有一个叫做“输入门(Input Gate)”的Sigmoid层决定我们要更新哪些信息。接下来,一个tanh层创造了一个新的候选值, Ct~ Ct~,该值可能被加入到元胞状态中。在下一步中,我们将会把这两个值组合起来用于更新元胞状态。

在语言模型的例子中,我们可能想要把新主语的性别加到元胞状态中,来取代我们已经遗忘的旧值。
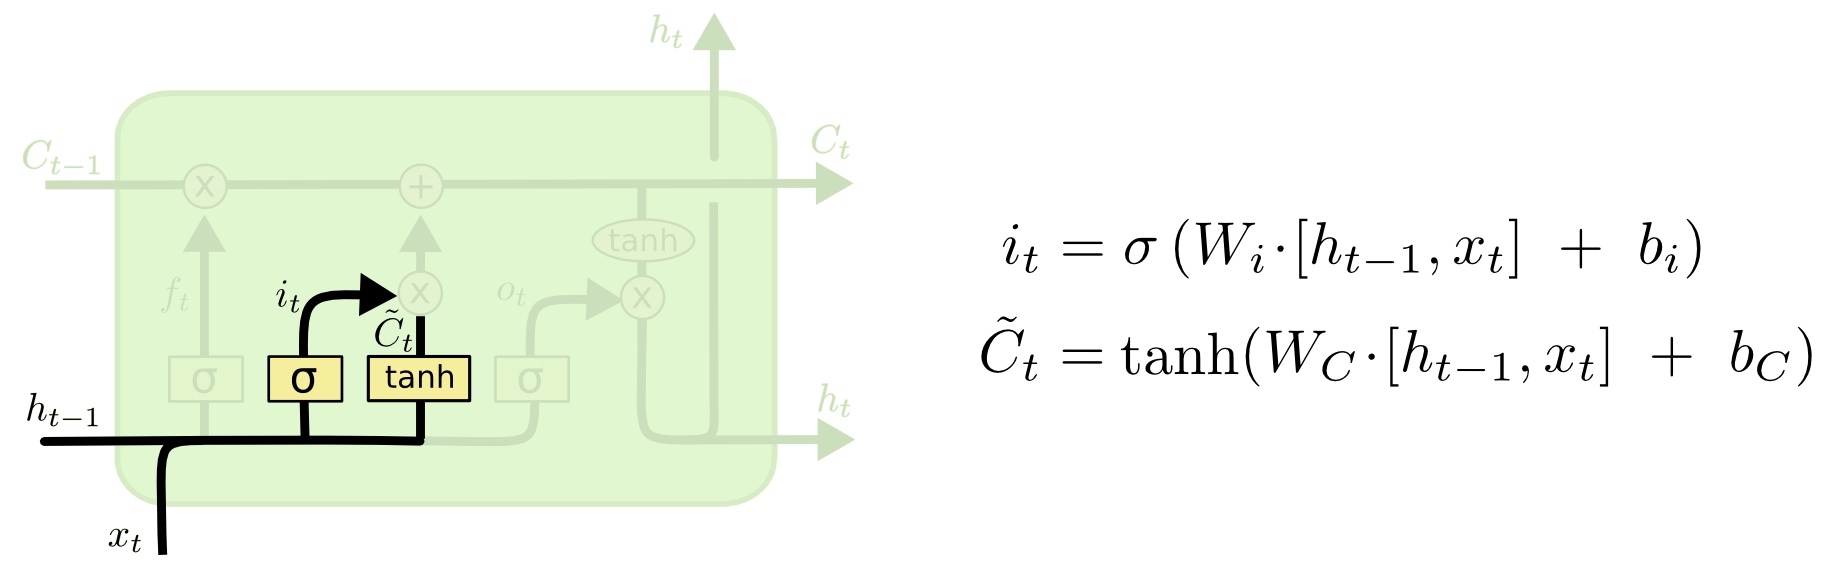
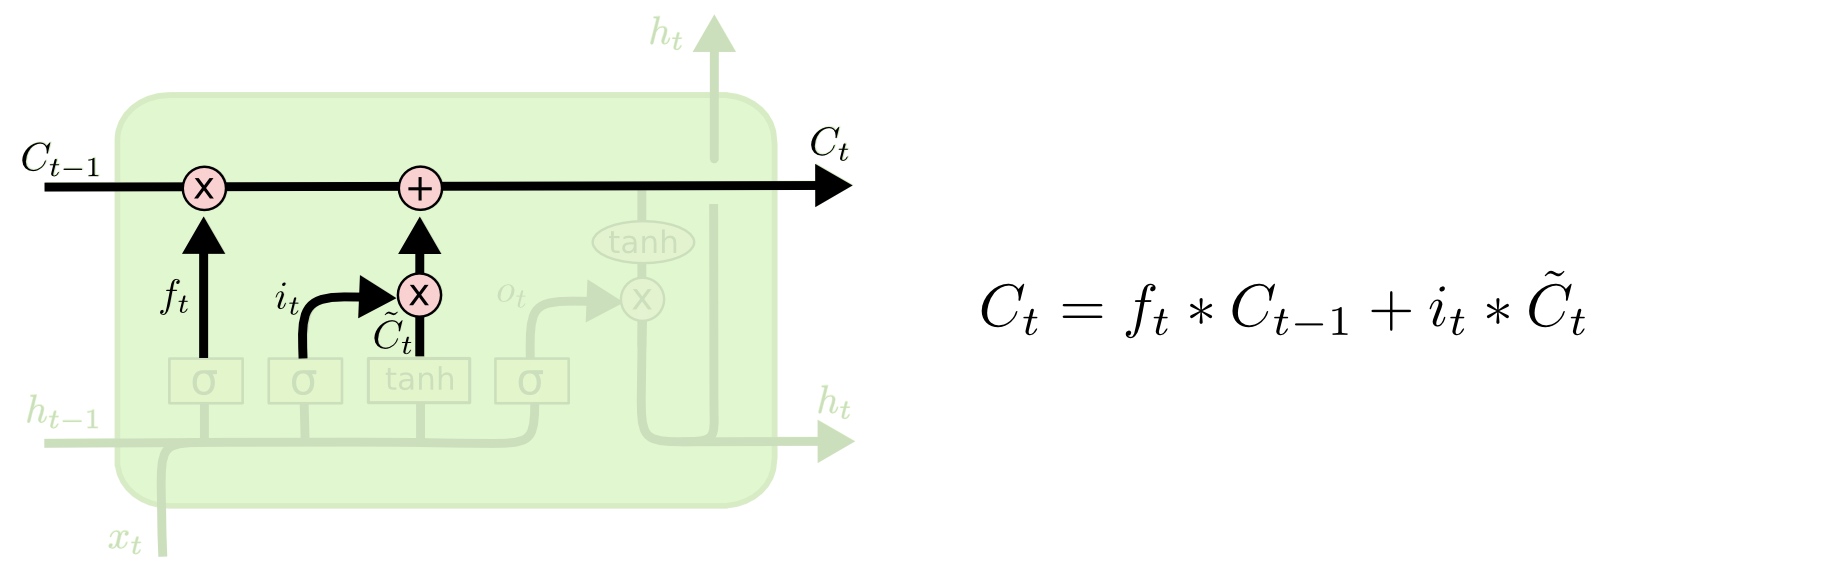
现在我们该更新旧元胞状态 Ct−1 Ct−1到新状态 Ct Ct了。上面的步骤中已经决定了该怎么做,这一步我们只需要实际执行即可。

我们把旧状态 Ct−1 Ct−1乘以 ft ft,忘掉我们已经决定忘记的内容。然后我们再加上 it∗Ct~ it∗Ct~,这个值由新的候选值( Ct~ Ct~)乘以候选值的每一个状态我们决定更新的程度( it it)构成。

还是语言模型的例子,在这一步,我们按照之前的决定,扔掉了旧的主语的性别信息,并且添加了新的信息。
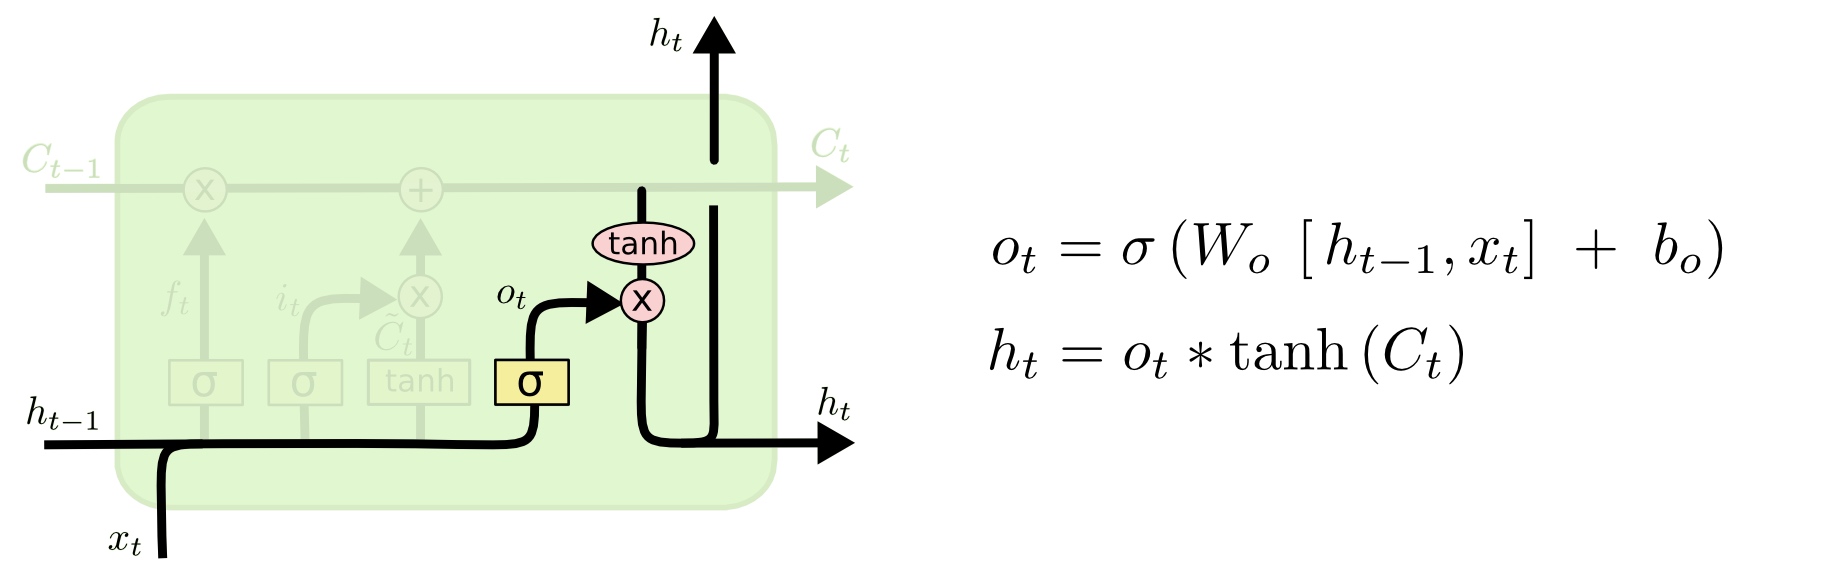
最后,我们需要决定最终的输出。输出将会基于目前的元胞状态,并且会加入一些过滤。首先我们建立一个Sigmoid层的输出门(Output Gate),来决定我们将输出元胞的哪些部分。然后我们将元胞状态通过tanh之后(使得输出值在-1到1之间),与输出门相乘,这样我们只会输出我们想输出的部分。

对于语言模型的例子,由于刚刚只输出了一个主语,因此下一步可能需要输出与动词相关的信息。举例来说,可能需要输出主语是单数还是复数,以便于我们接下来选择动词时能够选择正确的形式。
LSTM的变种

本文前面所介绍的LSTM是最普通的LSTM,但并非所有的LSTM模型都与前面相同。事实上,似乎每一篇paper中所用到的LSTM都是稍微不一样的版本。不同之处很微小,不过其中一些值得介绍。

一个流行的LSTM变种,由Gers & Schmidhuber (2000)提出,加入了“窥视孔连接(peephole connection)”。也就是说我们让各种门可以观察到元胞状态。
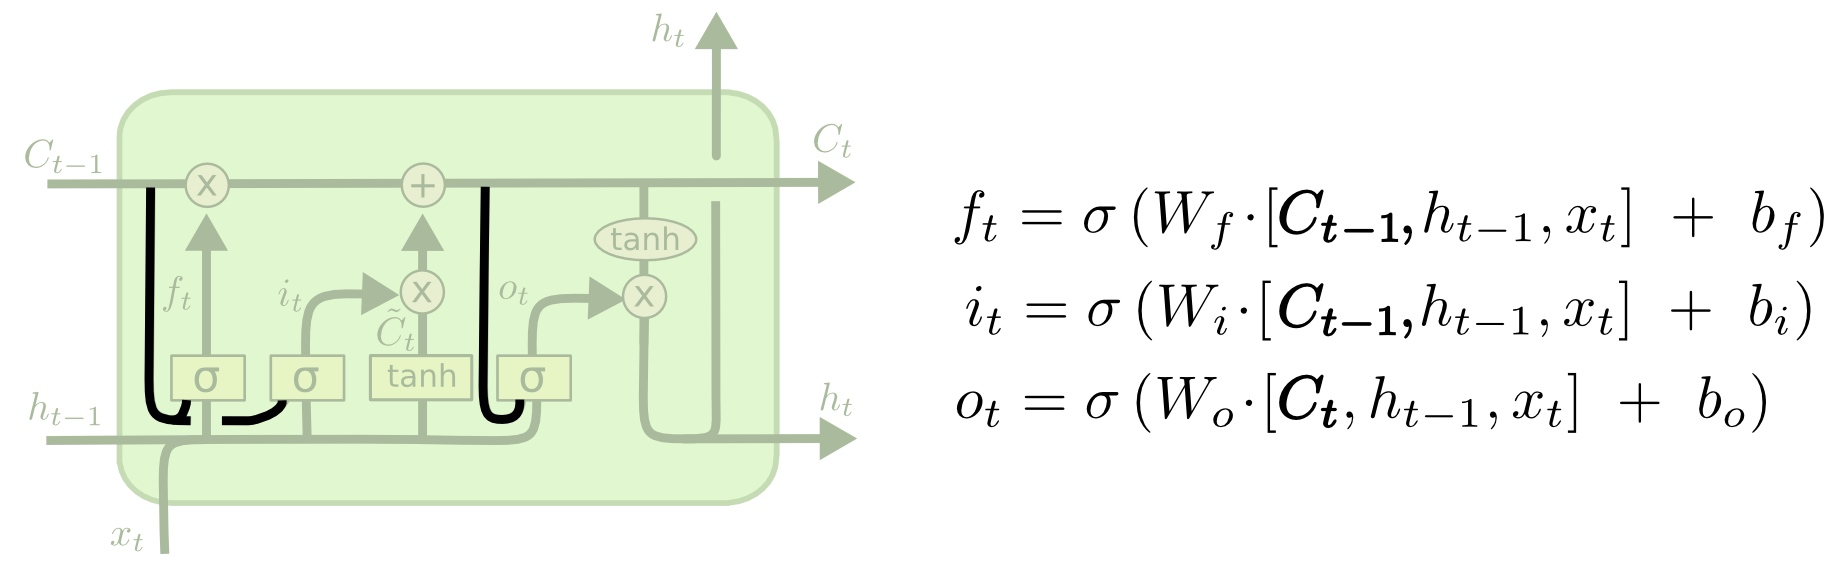
上图中,对于所有的门都加入了“窥视孔”,不过也有一些paper中只加一部分。

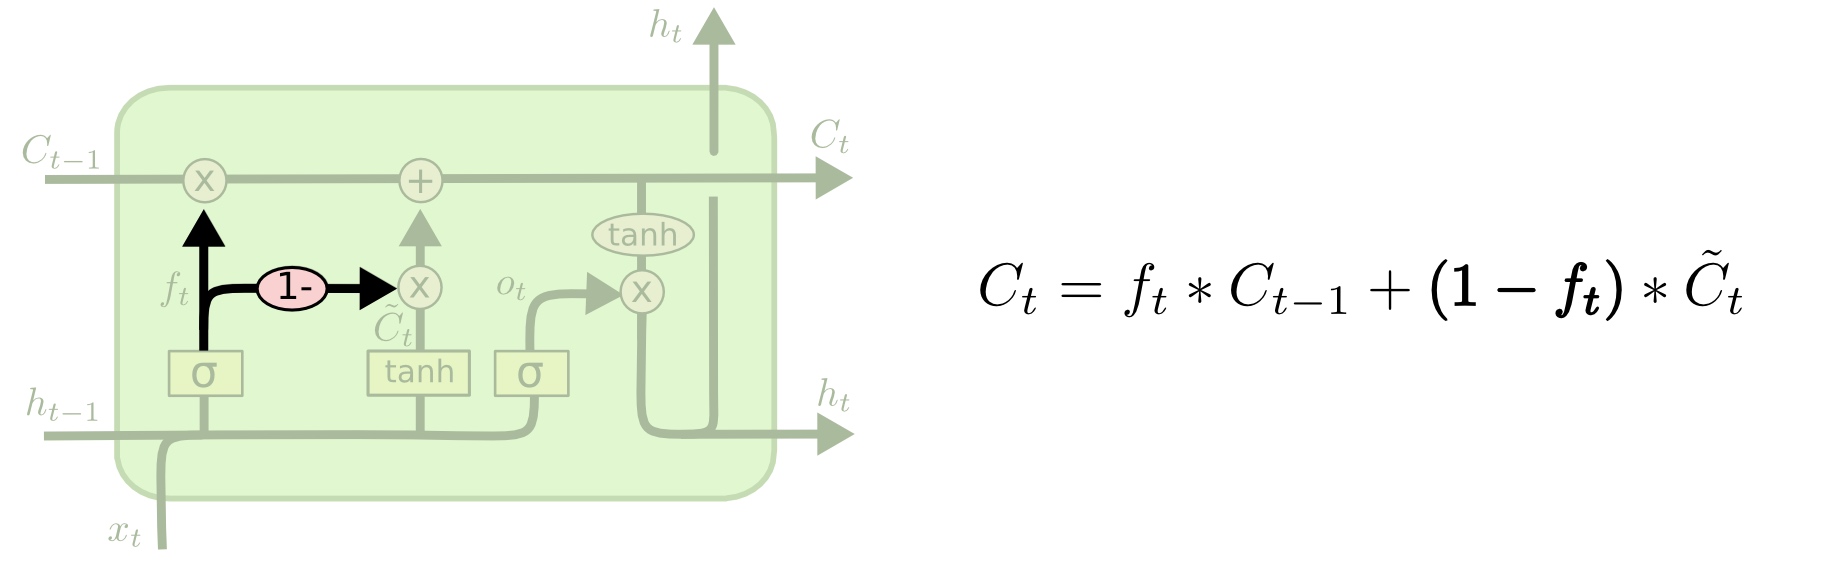
另一种变种是使用对偶的遗忘门和输入门。我们不再是单独地决定需要遗忘什么信息,需要加入什么新信息;而是一起做决定:我们只会在需要在某处放入新信息时忘记该处的旧值;我们只会在已经忘记旧值的位置放入新值。
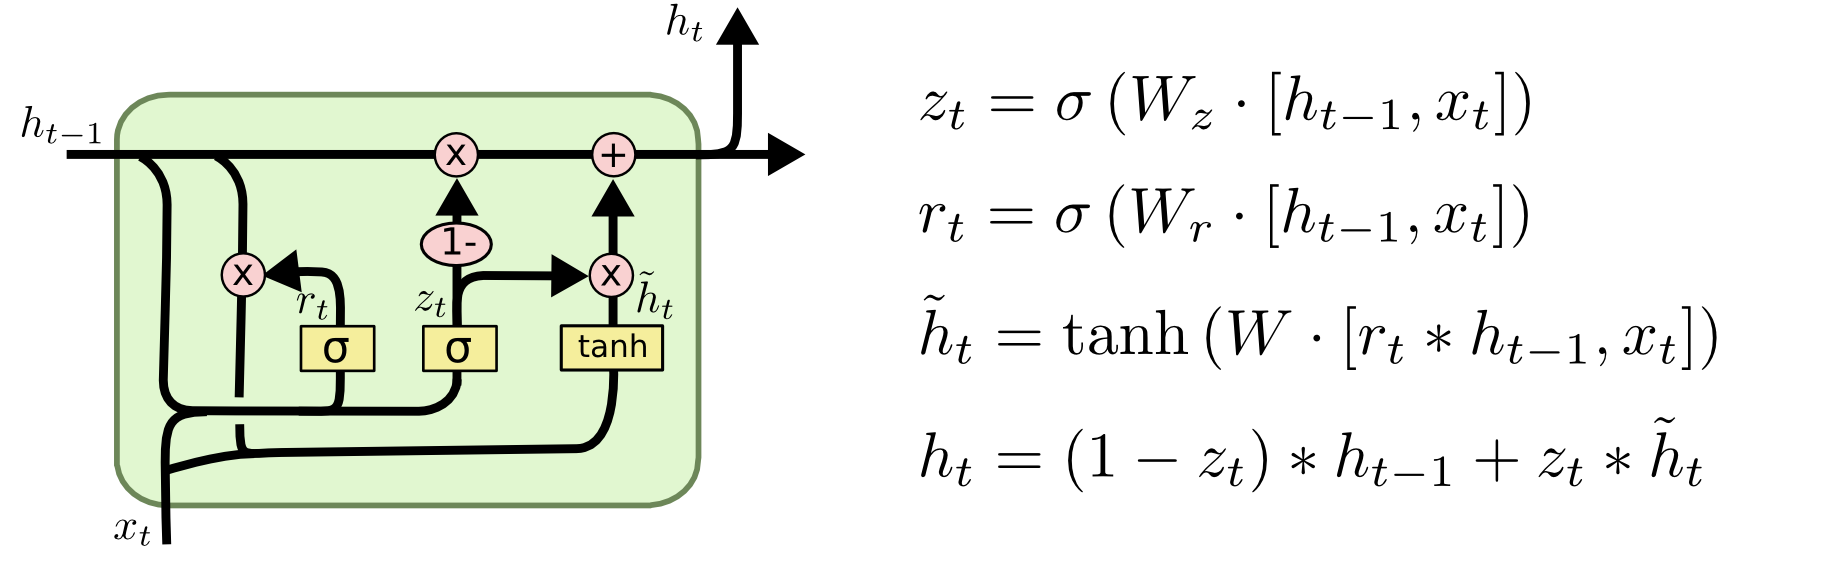
另一个变化更大一些的LSTM变种叫做Gated Recurrent Unit,或者GRU,由Cho, et al. (2014)提出。GRU将遗忘门和输入门合并成为单一的“更新门(Update Gate)”。GRU同时也将元胞状态(Cell State)和隐状态(Hidden State)合并,同时引入其他的一些变化。该模型比标准的LSTM模型更加简化,同时现在也变得越来越流行。
另外还有很多其他的模型,比如Yao, et al. (2015)提出的Depth Gated RNNs。同时,还有很多完全不同的解决长期依赖问题的方法,比如Koutnik, et al. (2014)提出的Clockwork RNNs。

不同的模型中哪个最好?这其中的不同真的有关系吗?Greff, et al. (2015)对流行的变种做了一个比较,发现它们基本相同。Jozefowicz, et al. (2015)测试了一万多种RNN结构,发现其中的一些在特定的任务上效果比LSTM要好。

结论

前文中,我提到了人们使用RNN所取得的出色的成就。本质上,几乎所有的成就都是由LSTM取得的。对于大部分的任务,LSTM表现得非常好。

由于LSTM写在纸上是一堆公式,因此看起来很吓人。希望本文的分步讲解能让读者更容易接受和理解。

LSTM使得我们在使用RNN能完成的任务上迈进了一大步。很自然,我们会思考,还会有下一个一大步吗?研究工作者们的共同观点是:“是的!还有一个下一步,那就是注意力(Attention)!”注意力机制的思想是,在每一步中,都让RNN从一个更大的信息集合中去选择信息。举个例子,假如你使用RNN来生成一幅图片的说明文字,RNN可能在输出每一个单词时,都会去观察图片的一部分。事实上,Xu, et al.(2015)做的正是这个工作!如果你想探索注意力机制的话,这会是一个很有趣的起始点。现在已经有很多使用注意力的令人兴奋的成果,而且似乎更多的成果马上将会出来……

注意力并不是RNN研究中唯一让人兴奋的主题。举例说,由Kalchbrenner, et al. (2015)提出的Grid LSTM似乎极有前途。在生成式模型中使用RNN的工作——比如Gregor, et al. (2015)、Chung, et al. (2015)以及Bayer & Osendorfer (2015)——看起来也非常有意思。最近的几年对于RNN来说是一段非常令人激动的时间,接下来的几年也必将更加使人振奋!

【机器学习】LSTM(长短期记忆网络)详解 长短期记忆网络(Long Short-Term Memory, LSTM)是一种特殊的循环神经网络(RNN)架构,旨在解决传统RNN在处理长序列时容易出现的梯度消失/爆炸问题。LSTM通过精心设计的门控机制,能够更好地捕捉长期依赖关系,在自然语言处理、语音识别、时间序列预测等领域取得了卓越的成绩。本文将详细介绍LSTM的工作原理、前向传播过程以及在实际任务中的应用。 阅读详情

相关推荐

简单介绍长短期记忆网络 - LSTM

简单说明了循环神经网络RNN的一些不足,对长短期记忆网络-LSTM的一个简单介绍

qq_43226867的博客 7244

理解 LSTM 网络

循环神经网络(RNN) 人们的每次思考并不都是从零开始的。比如你在阅读这篇文章时,你基于对前面的文字的理解来理解你目前阅读到的文字,而不是每读到一个文字时,都抛弃掉前面的思考,从头开始。你的记忆是有持久性的。 传统的神经网络并不能如此,这似乎是一个主要的缺点。例如,假设你在看一场电影,你想对电影里的每一个场景进行分类。传统的神经网络不能够基于前面的已分类场景来推断接下来的场景分类。

战斗蜗牛的专栏 2210

长短时记忆网络LSTM

长序列依赖问题:在传统的循环神经网络(RNN)中,随着序列长度的增加,梯度在反向传播过程中可能会变得非常小(梯度消失)或非常大(梯度爆炸),导致模型难以学习到长距离的依赖关系。请注意,这只是一个简化的例子,实际的股票市场预测会更加复杂,并需要考虑更多的因素。以下是使用Python和Keras库构建一个简单的LSTM模型的例子,这个模型将用于文本分类任务,即根据输入的文本将文本分类到不同的类别中。在创作诗歌、故事或新闻文章时,LSTM可以根据给定的文本序列生成新的文本内容,模仿特定作者的风格或创造新的内容。

qq_45738095的博客 2159

理解LSTM网络

理解LSTM神经网络

weixin_44966641的博客 2356

深度学习十大算法之长短时记忆网络(LSTM)

长短时记忆网络(LSTM)是一种特殊类型的循环神经网络(RNN),主要用于处理和预测序列数据的任务。LSTM由Hochreiter和Schmidhuber于1997年提出,其设计的初衷是为了解决传统RNN在处理长序列数据时面临的梯度消失或爆炸问题。LSTM网络通过特殊的结构设计,能够在长期间隔内有效地保持信息,因此在处理具有长距离依赖的序列数据时表现出色。

第欧根尼的酒桶的博客 5510

时间序列预测(十)——长短期记忆网络(LSTM)

长短期记忆网络(LSTM, Long Short-Term Memory)是一种专门设计用来解决时间序列数据的循环神经网络(RNN)。LSTM的主要优势是能够,适用于处理长期记忆(长期依赖)的问题,同时在训练过程中避免了传统RNN常见的问题。在时间序列预测中,LSTM网络非常适合处理具有长期相关性的输入数据,例如气温变化、股票价格、驾驶员行为数据等。LSTM可以通过记忆单元和门控机制来决定哪些信息需要“记住”,哪些需要“遗忘”。

qq_47885795的博客 6130

【个人整理】长短是记忆网络LSTM的原理以及缺点

前言:普通的循环神经网络RNN是很难训练的,这导致了它在实际应用中,很难处理长距离的依赖。在本文中,我们将介绍一种改进之后的循环神经网络:长短时记忆网络(Long Short Term Memory Network, LSTM),它成功的解决了原始循环神经网络的缺陷,成为当前最流行的RNN,在语音识别、图片描述、自然语言处理等许多领域中成功应用。本文将大致介绍一下LSTM的工作原理,然后介...

MIss-Y的博客 3万+

用deepseek学大模型08-长短时记忆网络 (LSTM)

deepseek.com 从入门到精通长短时记忆网络(LSTM),着重介绍的目标函数,损失函数,梯度下降 标量和矩阵形式的数学推导,pytorch真实能跑的代码案例以及模型,数据, 模型应用场景和优缺点,及如何改进解决及改进方法数据推导。

wyg_031113的专栏 1918

通俗理解LSTM

介绍LSTM主要组成及公式解析

tinstone的博客 1万+

长短时记忆网络(LSTM)基础

往期回顾 在上一篇文章中,我们介绍了循环神经网络以及它的训练算法。我们也介绍了循环神经网络很难训练的原因,这导致了它在实际应用中,很难处理长距离的依赖。在本文中,我们将介绍一种改进之后的循环神经网络:长短时记忆网络(Long Short Term Memory Network, LSTM),它成功的解决了原始循环神经网络的缺陷,成为当前最流行的RNN,在语音识别、图片描述、自然语言处理等许多

Duckie的博客 5459

六、长短时记忆网络语言模型(LSTM)

用 tanh 函数层将当前时刻向量中的有效信息提取出来压缩映射到区间 (-1, 1) 中创造了一个当前单元状态的候选 C'(t),然后使用图中 tanh 函数层左侧的 sigmoid 函数来控制这些记忆要放“多少”进入单元状态(为每个分量做出评级 (0, 1),评级越高的会有越多的记忆进入单元状态)遗忘门 forget gate:LSTM会先根据新的输入和上一时刻的输出决定遗忘掉之前的哪些记忆——输入和上一步的输出会整合为一个单独的向量,然后通过sigmoid神经层,最后点对点的乘在单元状态上。

contributed_l的博客 2191

长短时记忆网络(LSTM)(超详细 |附训练代码)

那么,从这个时刻开始再往之前走,得到的梯度(几乎为零)就不会对最终的梯度值有任何贡献,这就相当于无论t-3时刻之前的网络状态h是什么,在训练中都不会对权重数组W的更新产生影响,也就是网络事实上已经忽略了t-3时刻之前的状态。由于遗忘门的控制,它可以保存很久很久之前的信息,由于输入门的控制,它又可以避免当前无关紧要的内容进入记忆。LSTM的前向计算都这么复杂,那么,可想而知,它的训练算法一定是非常非常复杂的。从上面的代码我们可以看到,门的计算都是相同的算法,而门和的计算仅仅是激活函数不同。

qq_73462282的博客 14万+

四、长短期记忆网络(LSTM)数据驱动模型

长短期记忆网络(LSTM)数据驱动模型 5.1 基本原理 长短时记忆网络(Long Short Term Memory Network, LSTM),是一种改进之后的循环神经网络,可以解决RNN无法处理长距离的依赖的问题。在原始的 RNN 模型中,隐藏层只有一个状态,即h,RNN对于短期的输入非常敏感。如果此时再增加一个状态c,让它来保存长期的状态,那么则称之为称为单元状态(cell state)。 按照时间维度展开:在 t 时刻,LSTM 的输入有三个:分别是当前时刻网络的输入值 X_t、上一时刻

记录自己的成长 4182

【机器学习】长短时记忆网络(LSTM)

文章目录1. 基本概念2. 长短时记忆网络的前向计算2.1 门2.2 遗忘门 1. 基本概念 长短时记忆网络(Long Short Term Memory Network, LSTM),它成功的解决了原始循环神经网络的缺陷,成为当前最流行的RNN,在语音识别、图片描述、自然语言处理等许多领域中成功应用。 原始RNN无法处理长距离依赖,原始RNN的隐藏层只有一个状态,即h,它对于短期的输入非常敏感。 长短时记忆网络在RNN的基础上再增加一个状态c,让它来保存长期的状态。 新增加的状态c,称为单元状态(cel

weixin_42301220的博客 8456

镜像电流源与比例电流源:原理、应用与性能优化

本文深入解析了镜像电流源与比例电流源的工作原理、核心应用与性能优化方法。镜像电流源利用匹配晶体管实现电流复制,是集成电路的基础;比例电流源通过发射极电阻实现电流缩放,应用更灵活。文章重点探讨了其作为有源负载提升放大器增益的关键应用,并分析了静态误差、输出阻抗和最小工作电压三大性能指标,最后介绍了威尔逊电流镜等进阶优化技术及实战设计要点。

dd012的博客 567

Class AB OPA STB仿真相位异常:从corner case到碰撞电离的排查与规避

本文深入分析了Class AB运算放大器(OPA)在STB稳定性仿真中,特定工艺角(corner case)下出现相位从0°开始的异常现象。排查发现,其根本原因在于高Vds引发的碰撞电离效应,通过衬底和电源网络引入了隐藏的正反馈通路。文章对比了修改衬底连接与优化电路降低Vds两种解决方案,并基于工程实践推荐了代价更小、兼容性更好的电路优化方案,成功规避了问题并完成流片验证。

grape的博客 636

解密长短时记忆网络(LSTM):从理论到PyTorch实战演示

本文深入探讨了长短时记忆网络(LSTM)的核心概念、结构与数学原理,对LSTM与GRU的差异进行了对比,并通过逻辑分析阐述了LSTM的工作原理。文章还详细演示了如何使用PyTorch构建和训练LSTM模型,并突出了LSTM在实际应用中的优势。

TechLead 6302

ffmpeg 4.4 cenc-aes-ctr 加解密 MP4 工程性质分析

ffmpeg 4.4 cenc-aes-ctr 加解密 MP4 工程性质分析

Dream_Dynasty的博客 3047

长短时记忆网络(Long Short Term Memory,LSTM)详解

长短时记忆网络(LSTM)基本原理与基于Pytorch的实现方法。

weixin_60737527的博客 1万+

Opencv计算相机响应函数(Camera Response Function)与Radiance

本文主要用于记录自己在学习CRF过程中遇到的一些问题。 CRF模型 I=f(V(t⋅L))I=f(V( t\cdot L))I=f(V(t⋅L)) 其中III为相机灰度值Intensity,LLL为环境中irradiance,ttt为曝光时间,VVV为相机镜头参数,fff为相机响应函数CRF。 有些论文中认为相机镜头参数是线性的不考虑,但有些考虑了衰减即靠近图像边缘亮度会暗一些,但没有看到二者同时计算的,如果同时计算两个非线性的函数,我觉得可能会有不确定性,在这里还请教一下了解的朋友。 控制

larrydong的博客 6001

AI驱动的客户终身价值分析:深入理解公司的收入质量

客户终身价值(Customer Lifetime Value, CLV)是衡量客户在整个生命周期内能为企业带来多少利润的重要指标。传统的CLV计算方法往往过于简化,无法准确反映复杂的客户行为和收入模式。本文旨在介绍如何利用人工智能技术,特别是机器学习方法,构建更精确的CLV预测模型,从而帮助企业深入理解其收入质量。CLV的基本概念和商业意义传统CLV计算方法的局限性基于机器学习的CLV预测方法特征工程和模型选择策略实际应用案例和Python实现首先介绍CLV的基本概念和商业背景。

AI云原生与云计算技术学院 477

利用LSTM(长短期记忆网络)来处理脑电数据

目录LSTM 原理介绍LSTM的核心思想一步一步理解LSTM代码案例 本分享为脑机学习者Rose整理发表于公众号:脑机接口社区(微信号:Brain_Computer).QQ交流群:903290195 Rose小哥今天介绍一下用LSTM来处理脑电数据。 LSTM 原理介绍 LSTMs(Long Short Term Memory networks,长短期记忆网络)简称LSTMs,很多地方用LSTM...

脑机接口社区 7547

2023年全国青少年信息素养大赛C++编程初中组决赛真题+答案解析

2023年全国青少年信息素养大赛C++编程初中组决赛真题+答案解析

伶俐角少儿编程 820
上一篇: 协方差矩阵
下一篇: openmp与openmpi区别
Ddreaming
博客等级 码龄10年 122粉丝 30原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值