


§1 SkyWalking 是什么
面向微服务与云原生的可观测平台:追踪、指标、日志、剖析一体
在几十到几百个微服务构成的系统里,排障通常会撞上同一组问题:如何把一次请求的调用链串起来并快速定位;如何看清服务之间的依赖;如何做接口级性能分析;如何还原业务流程的处理顺序。缺少统一的链路与拓扑视图时,团队往往只能在日志、指标与猜测之间来回切换。更糟的是,高峰期「平均延迟看起来还行」,真正拖垮 SLA 的往往是某个下游实例上的长尾 Span——没有 Trace,这类问题几乎只能靠运气。
Apache SkyWalking 是面向分布式系统的应用性能监视与可观测性分析平台,专为微服务、云原生以及容器化(Docker、Kubernetes 等)场景设计。它不仅做分布式追踪,还把服务网格遥测、度量聚合、日志关联与可视化放在同一套后端与 UI 中。项目起源于 2015 年的开源实践,2017 年进入 Apache 孵化器,之后成为 ASF 顶级项目;截至 2026 年,后端稳定版以 10.4.0 为代表(含 GenAI 可观测、Grafana Tempo 兼容等演进),Java Agent 独立发版(如 9.7.x 线),可与 OAP 10.x 搭配使用。官网文档把「Showcase 一键体验」与「Quick Start 起后端」并列为入门路径:前者适合先看端到端效果,后者适合把 OAP/UI/存储真正跑在自己环境里。
和「只展示调用链」的轻量工具相比,SkyWalking 更接近一套可观测平台:同一份探针数据可以喂给拓扑、RED 类服务指标、告警与 Profiling。2024–2026 这条版本线上,存储侧明显向 BanyanDB 倾斜(10.2 起默认路径不再依赖 H2),UI 侧以 Horizon 为主,并继续兼容 Zipkin / OTLP 等外部格式接入——这意味着存量 SkyWalking Agent 与新 OTel 管道可以并存,而不是二选一推倒重来。
1.1 调用链选型怎么比
工程选型时,常见对照大致如下(表述侧重能力边界,具体数字以各自官方文档与压测为准):
| 方案 | 特点(中性概括) | 常见适用感 |
|---|---|---|
| Zipkin | 轻量调用链分析;与 Spring Cloud Sleuth / Brave 生态结合多 | 先要「看得见链路」、部署尽量简单 |
| OpenTelemetry | 厂商中立的遥测标准;OTLP 统一 traces / metrics / logs,后端可替换 | 埋点一次、多后端并存,降低锁定 |
| DataBuff | 开源 APM:原生 OTLP + 兼容 SkyWalking Agent;拓扑 / 服务 / Trace / AI 问数同栈 | 保留既有 Agent,增强分析与值班面 |
| Pinpoint | 字节码注入、插件丰富、UI 能力强、接入侧无业务代码侵入 | 强调细粒度探针与控制台体验 |
| SkyWalking | 字节码注入 + 多语言 Agent + Mesh/eBPF;UI 与告警、拓扑一体 | 社区庞大,文档丰富 |
| CAT 等 | 偏编码/配置接入,覆盖链路、监控、日志与告警等一整套 | 团队已有对应接入习惯与运维体系 |
关于探针开销:社区与厂商早期对比文章常引用「全采样、高并发下 SkyWalking 对吞吐量影响相对更小」一类结论。需要强调的是:采样率、插件集合、JDK 版本与业务路径不同,结论会漂移;生产环境应以自己业务路径的压测为准,把采样(如每 3 秒采样次数)、忽略后缀端点等参数纳入对照。把「别人的压测表」直接写进容量规划,是链路治理里最常见的误判来源之一。
选型时还可以多问两个工程问题:团队是否已有 Spring Cloud Sleuth / OTel 埋点资产;是否强依赖 Mesh 或 eBPF 零代码覆盖。前者决定你要不要并行维护两套上下文传播;后者决定 SkyWalking 是否继续作为主栈,而 DataBuff 更适合以「双写增强分析」的方式进入,而不是立刻替换探针。
1.2 主要功能
-
多种监控手段:语言探针、Service Mesh 接收器等,覆盖应用与基础设施侧信号。
-
多语言自动探针:Java、.NET、Node.js、Go、Python、PHP、Rust 等独立 Agent 仓库持续演进。
-
轻量高效:不必先上重型大数据平台即可完成聚合与查询(存储可按规模升级)。
-
模块化:UI、存储、集群管理均可替换或水平扩展。
-
告警:基于规则与度量表达式触发通知。
-
可视化:拓扑、服务仪表板、Trace 瀑布图、日志与 Profiling 同控制台。
1.3 整体架构
逻辑上仍可按四段理解:
[ Probe 探针 / Receiver ]
        │  gRPC / OTLP / Zipkin / Prometheus …
        ▼
[ OAP 可观测分析平台 ]  →  聚合 · 流式分析 · 告警
        ▼
[ Storage ]  →  BanyanDB / Elasticsearch / 其他存储插件
        ▼
[ UI ]  →  Horizon UI(v10/v11 代)· 拓扑 · Trace · 指标 · 日志
-
Agent:基于字节码增强(Java 侧常见 ByteBuddy),以
-javaagent加载,启动时拦截目标方法采集数据。 -
SDK:业务显式调用 SDK,有代码侵入,适合特殊框架。
-
Service Mesh / eBPF:从代理或内核侧收集,适合网格与基础设施深度观测。
后端以 OAP(Observability Analysis Platform) 为核心:接收探针数据,做度量与调用链分析,写入存储,再对外提供查询。历史上还有 OAL 等分析语言;10.x 文档体系更强调 MQE、存储选型(生产常用 BanyanDB / Elasticsearch)与 Marketplace 开箱能力。UI 从早期 RocketBot 演进到 Horizon UI,Demo 站点亦为 Horizon 界面。
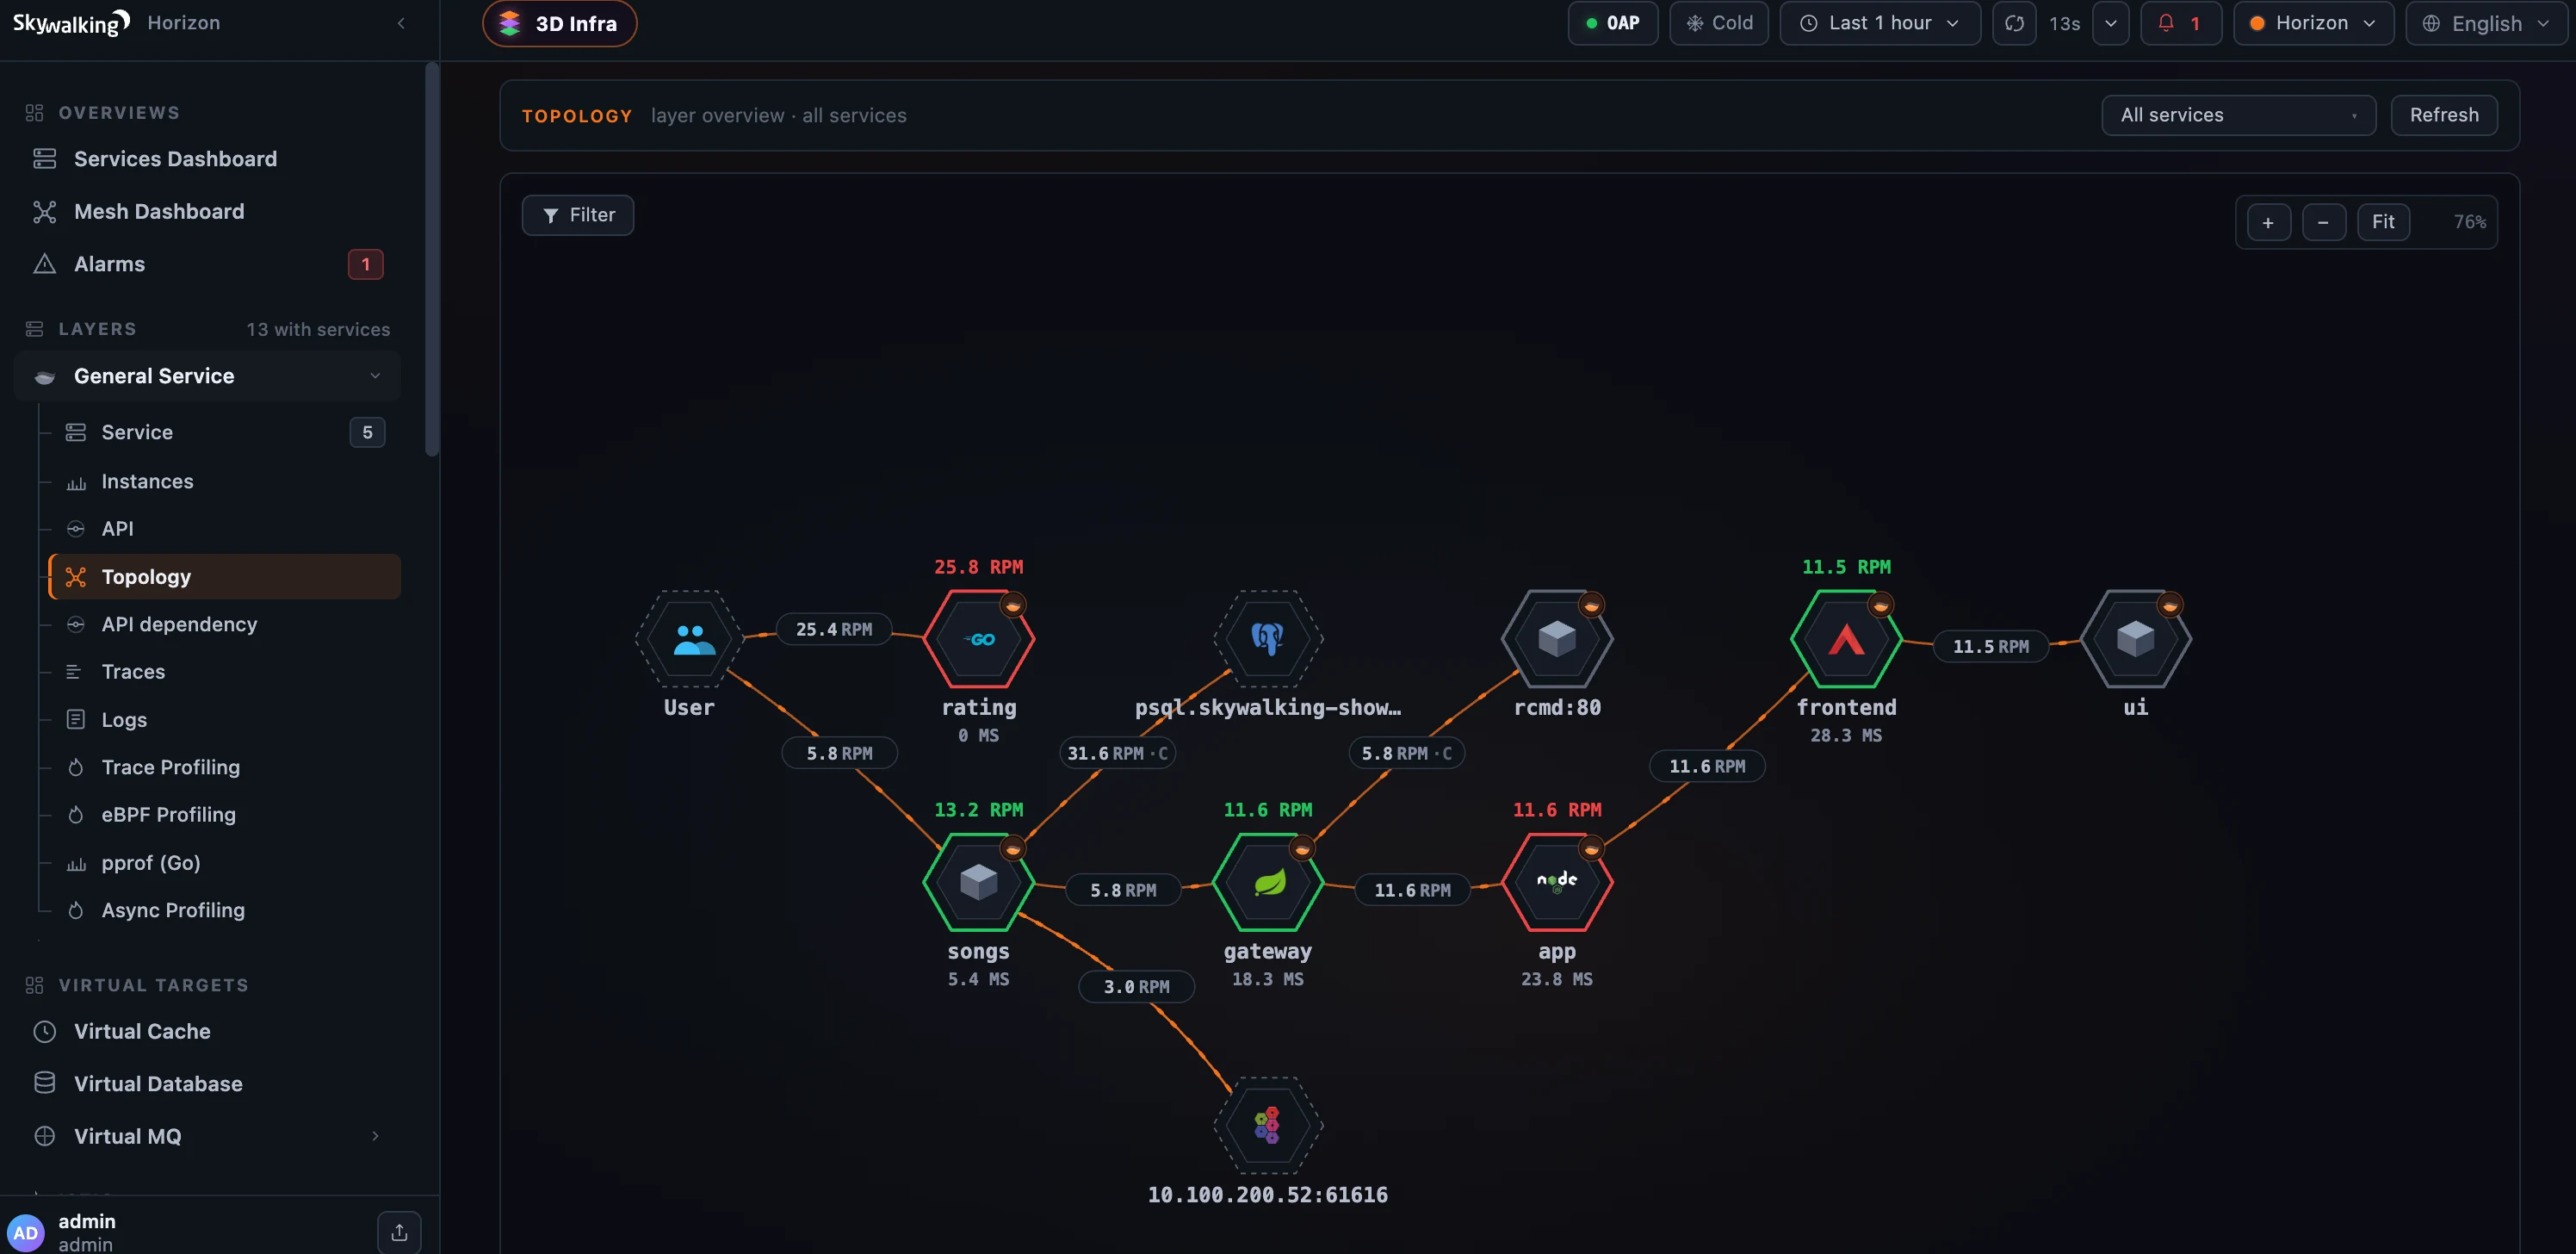
图 1-1 · 拓扑按调用深度排布服务节点,边可携带 RPM 等度量;适合一眼看清上下游依赖。
1.4 三个核心概念
-
Service(服务):一组提供相同行为的工作负载;Agent 侧通过
agent.service_name命名。 -
Service Instance(服务实例):该组工作负载中的每一个实例,通常对应一个操作系统进程。
-
Endpoint(端点):服务接收请求的路径,如 HTTP URI 或 gRPC 的类名 + 方法签名。
理解这三者,才能在 UI 里从「服务列表 → 实例 → 端点 → Trace」逐级下钻,而不是只盯着一条瀑布图猜根因。
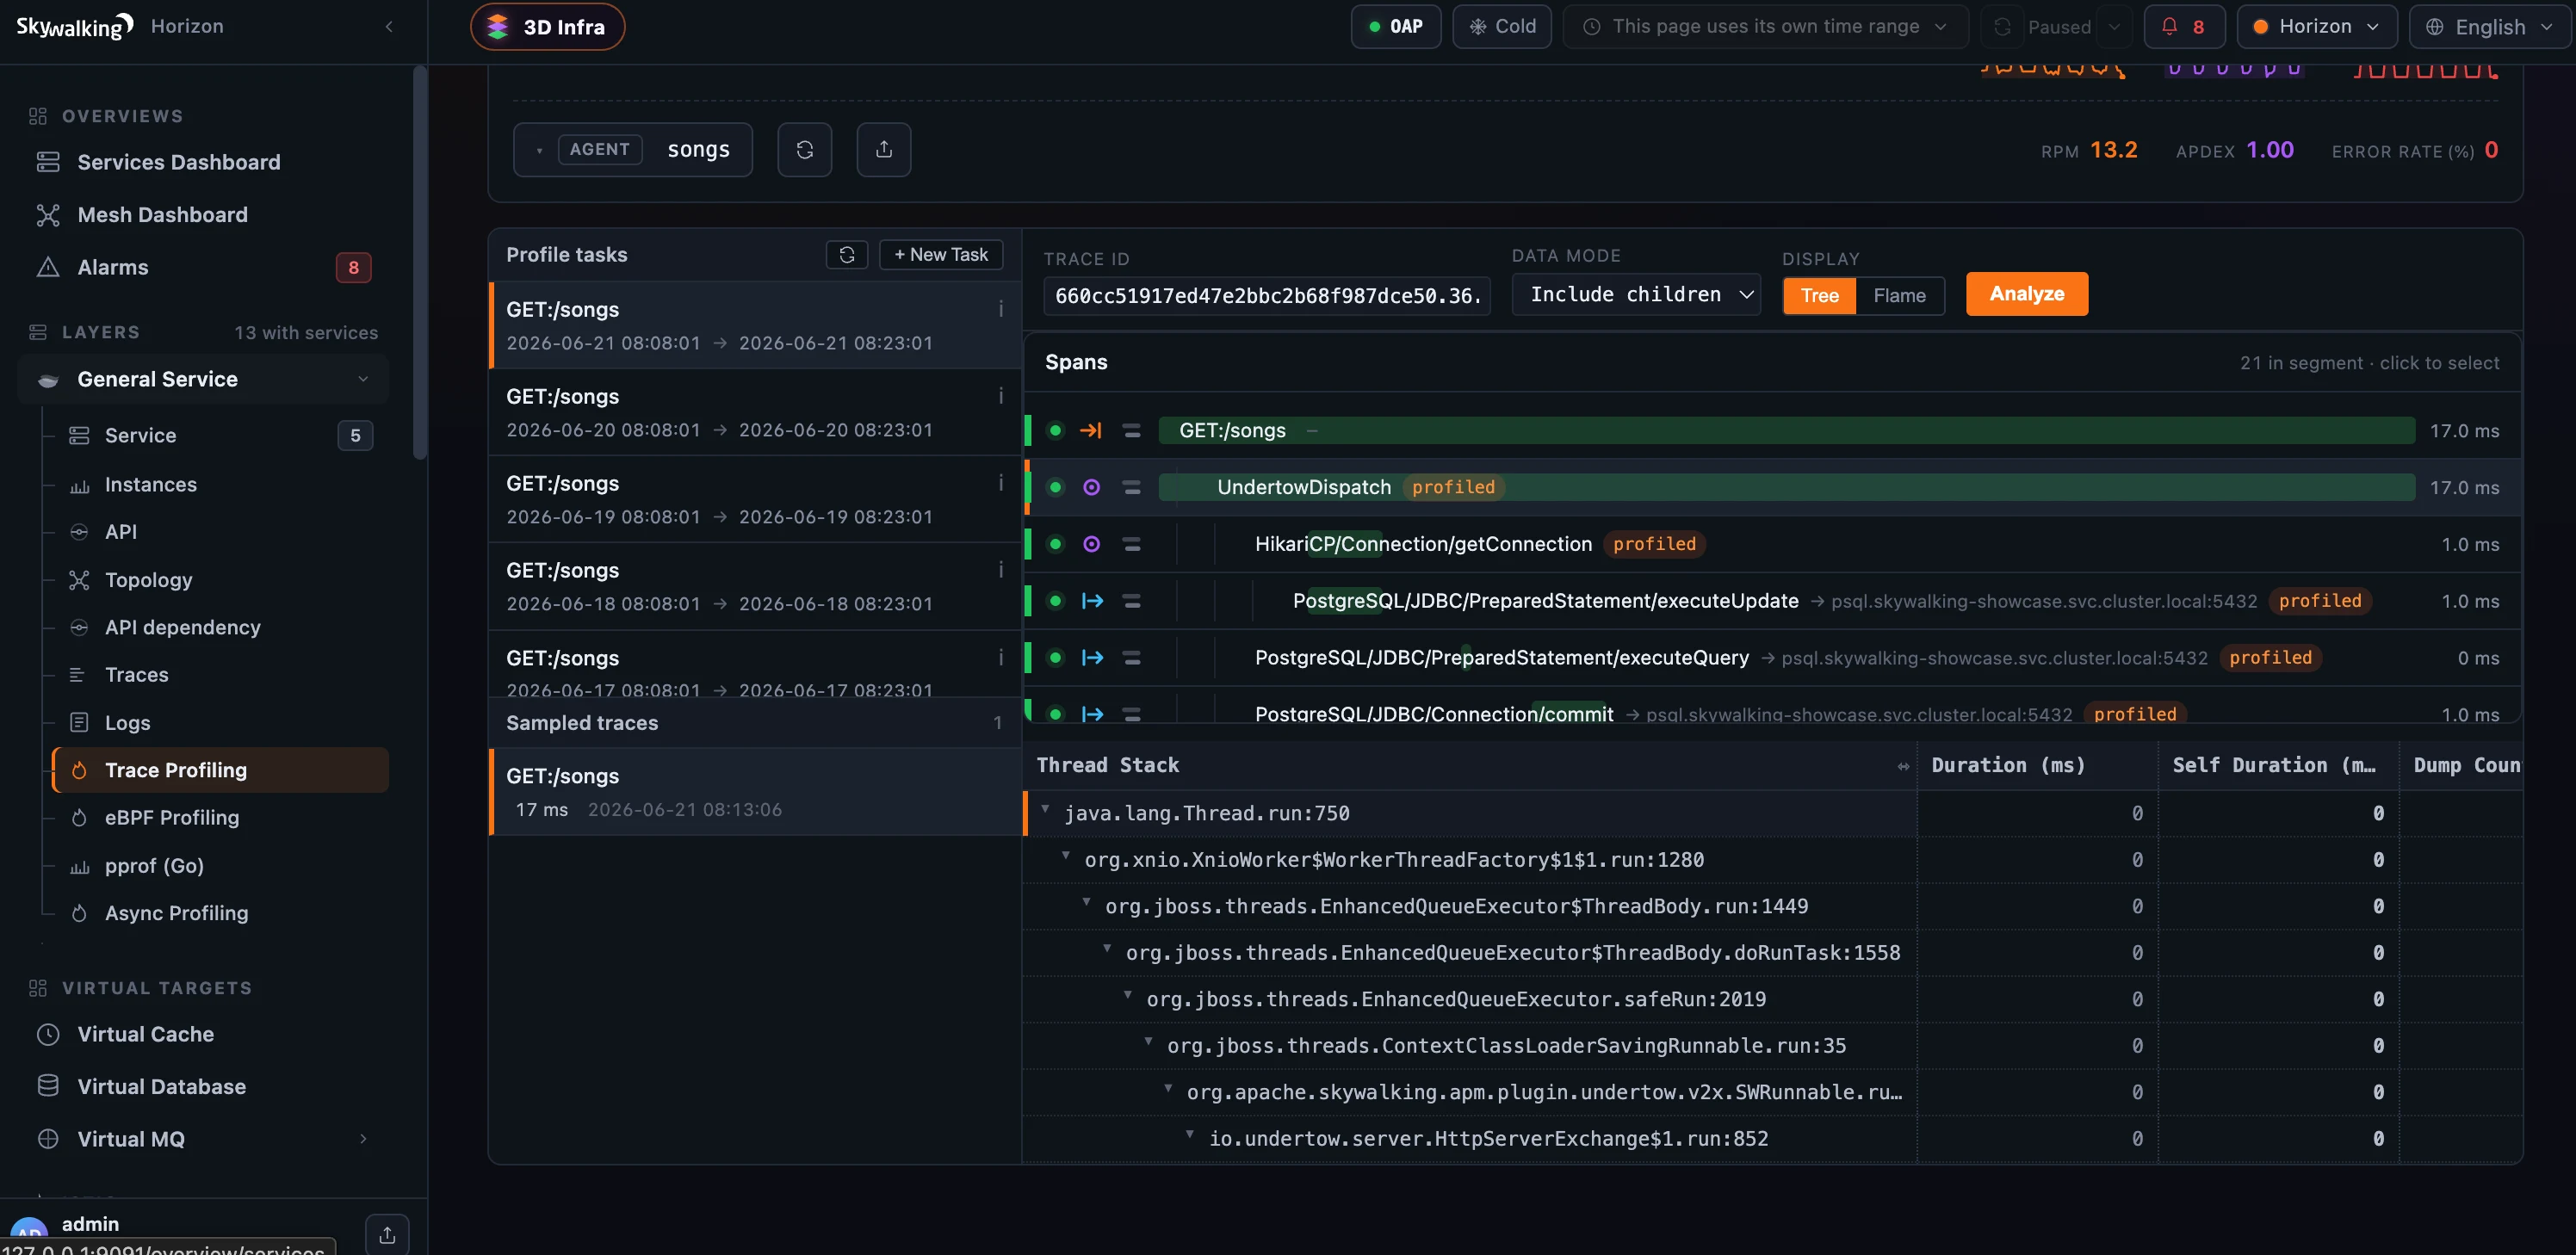
图 1-2 · 侧栏按 Layer 组织观测面,服务与实例下钻是日常排障的主路径。
§2 SkyWalking 快速开始
对齐官方文档:一键起后端、挂 Java Agent、看 Trace,并覆盖告警、持久化与集群要点
2.1 后端快速拉起
官方文档页提供 Docker 一键脚本,启动时选择存储后端(如 Elasticsearch 或 BanyanDB),并拉起 OAP + UI。第一次建议在干净的 Docker 环境执行,避免本机已占用 11800/8080 导致「脚本成功但 UI 打不开」。若端口冲突,按 compose 文件调整映射后再启动,而不是先改 Agent 地址绕开问题。
Linux / macOS / WSL:
bash <(curl -sSL https://skywalking.apache.org/quickstart-docker.sh)
Windows PowerShell:
Invoke-Expression ([System.Text.Encoding]::UTF8.GetString(
  (Invoke-WebRequest -Uri https://skywalking.apache.org/quickstart-docker.ps1 -UseBasicParsing).Content))
典型端口(与官方 Docker 说明一致):
-
Agent gRPC 上报:11800
-
OAP HTTP / 查询:12800
-
UI:8080
二进制包亦可从 Downloads 获取 10.4.0 发行物,解压后按文档启动 OAP 与 UI;生产切勿长期依赖内存型默认存储,应尽早落到 BanyanDB / ES 等持久化方案。体验结束后可用 compose 项目名销毁环境,避免残留容器占磁盘。Showcase(music 示例应用)适合演示拓扑与 Profiling,和 Quick Start 后端是两条线:前者看效果,后者练部署。
2.2 Java Agent 接入(jar / IDE)
下载与 OAP 匹配的 Java Agent 发行包(独立版本线,例如 9.7.x),解压后核心是 skywalking-agent.jar 与 config/agent.config。-javaagent 必须放在 -jar 之前。
export SW_AGENT_NAME=springboot-demo
export SW_AGENT_COLLECTOR_BACKEND_SERVICES=127.0.0.1:11800

java -javaagent:/path/to/skywalking-agent.jar \
  -Dskywalking.agent.service_name=${SW_AGENT_NAME} \
  -Dskywalking.collector.backend_service=${SW_AGENT_COLLECTOR_BACKEND_SERVICES} \
  -jar springboot-demo.jar
agent.config 中对应项常见写法:
agent.service_name=${SW_AGENT_NAME:Your_ApplicationName}
collector.backend_service=${SW_AGENT_COLLECTOR_BACKEND_SERVICES:127.0.0.1:11800}
系统属性可用 skywalking. 前缀覆盖配置文件;环境变量与 -D 的优先级以当前 Agent 版本文档为准。IDEA 本地调试:打开 Run/Debug Configurations → 选中应用 → 在 VM options 填入 -javaagent:... 与 collector 地址,Apply 后启动即可,不必改业务代码。若使用 Spring Boot 的「分层 jar」或自定义 ClassLoader,确认 Agent 与业务使用同一 JDK 大版本,并在启动日志中搜索 SkyWalking agent begin 一类字样,确认探针真正挂上。
采样与噪声控制建议在联调阶段就定基线:开发环境可用全采样快速看到数据;预发/生产再把 agent.sample_n_per_3_secs、忽略静态资源后缀等参数调到可接受开销。跨线程、跨消息队列场景还要确认插件是否覆盖你的框架版本——官方插件列表随 Agent 版本更新,缺失插件时 Span 会「断链」,看起来像「下游没被追踪」,其实是上下文没传过去。
2.3 跨服务与自定义追踪
多服务场景下,只要各进程挂上同一套兼容 Agent、指向同一 OAP(或同一 proxy),跨进程上下文会通过协议头(默认 sw8)传播,UI 中即可看到跨服务 Trace。建议先用两个最小 Spring Boot 服务(A 调 B)验证:两边 service_name 不同、collector 相同,然后在 Trace 瀑布图确认 A→B 的父子关系。
对未覆盖的框架,可用官方插件扩展或 Toolkit API 手工埋点;同时注意 agent.span_limit_per_segment 等上限,避免异常路径 Span 爆炸拖垮 OAP。自定义埋点只包「业务关键步骤」,不要把每个 getter 都打成 Span——否则 UI 好看了,存储与查询先崩。
2.4 告警、日志与持久化
-
告警:在 OAP 侧配置规则(YAML / 控制台,视版本而定),对接 Webhook、邮件等渠道;规则与指标表达式需与自身 MQE/度量模型对齐。联调时先做一条「故意调高阈值」的规则,确认通道通,再改回生产阈值。
-
日志:Agent 可将日志与 Trace 上下文关联上报;也可由其他接收器写入 OAP,再在 UI 按 TraceId 联查。日志量大时务必做采集端过滤,避免把 Debug 洪峰灌进存储。
-
持久化:Quick Start 仅用于体验;生产选择 BanyanDB 或 Elasticsearch,并规划 TTL、分片与磁盘容量。升级大版本前阅读 Breaking Changes(例如存储默认项变更),先在预发完整回放查询与告警。
2.5 集群要点
OAP 常以集群部署:多实例共享同一存储,UI 指向多个 OAP 查询地址。Kubernetes 可用官方 Helm Chart;注意 Agent 侧 collector.backend_service 指向 Service / Ingress 的稳定入口,而不是某个瞬时 Pod IP。滚动升级时先扩容再缩容,并观察 gRPC 连接与延迟。
集群排障高频项:时间是否 NTP 对齐(跨机 Trace 时间线错乱)、存储是否只被一半 OAP 写到、UI 是否仍指向旧 OAP 列表。能在控制台看到服务却查不到新 Trace 时,优先核对「写入集群」与「查询集群」是否一致,而不是先怀疑 Agent。
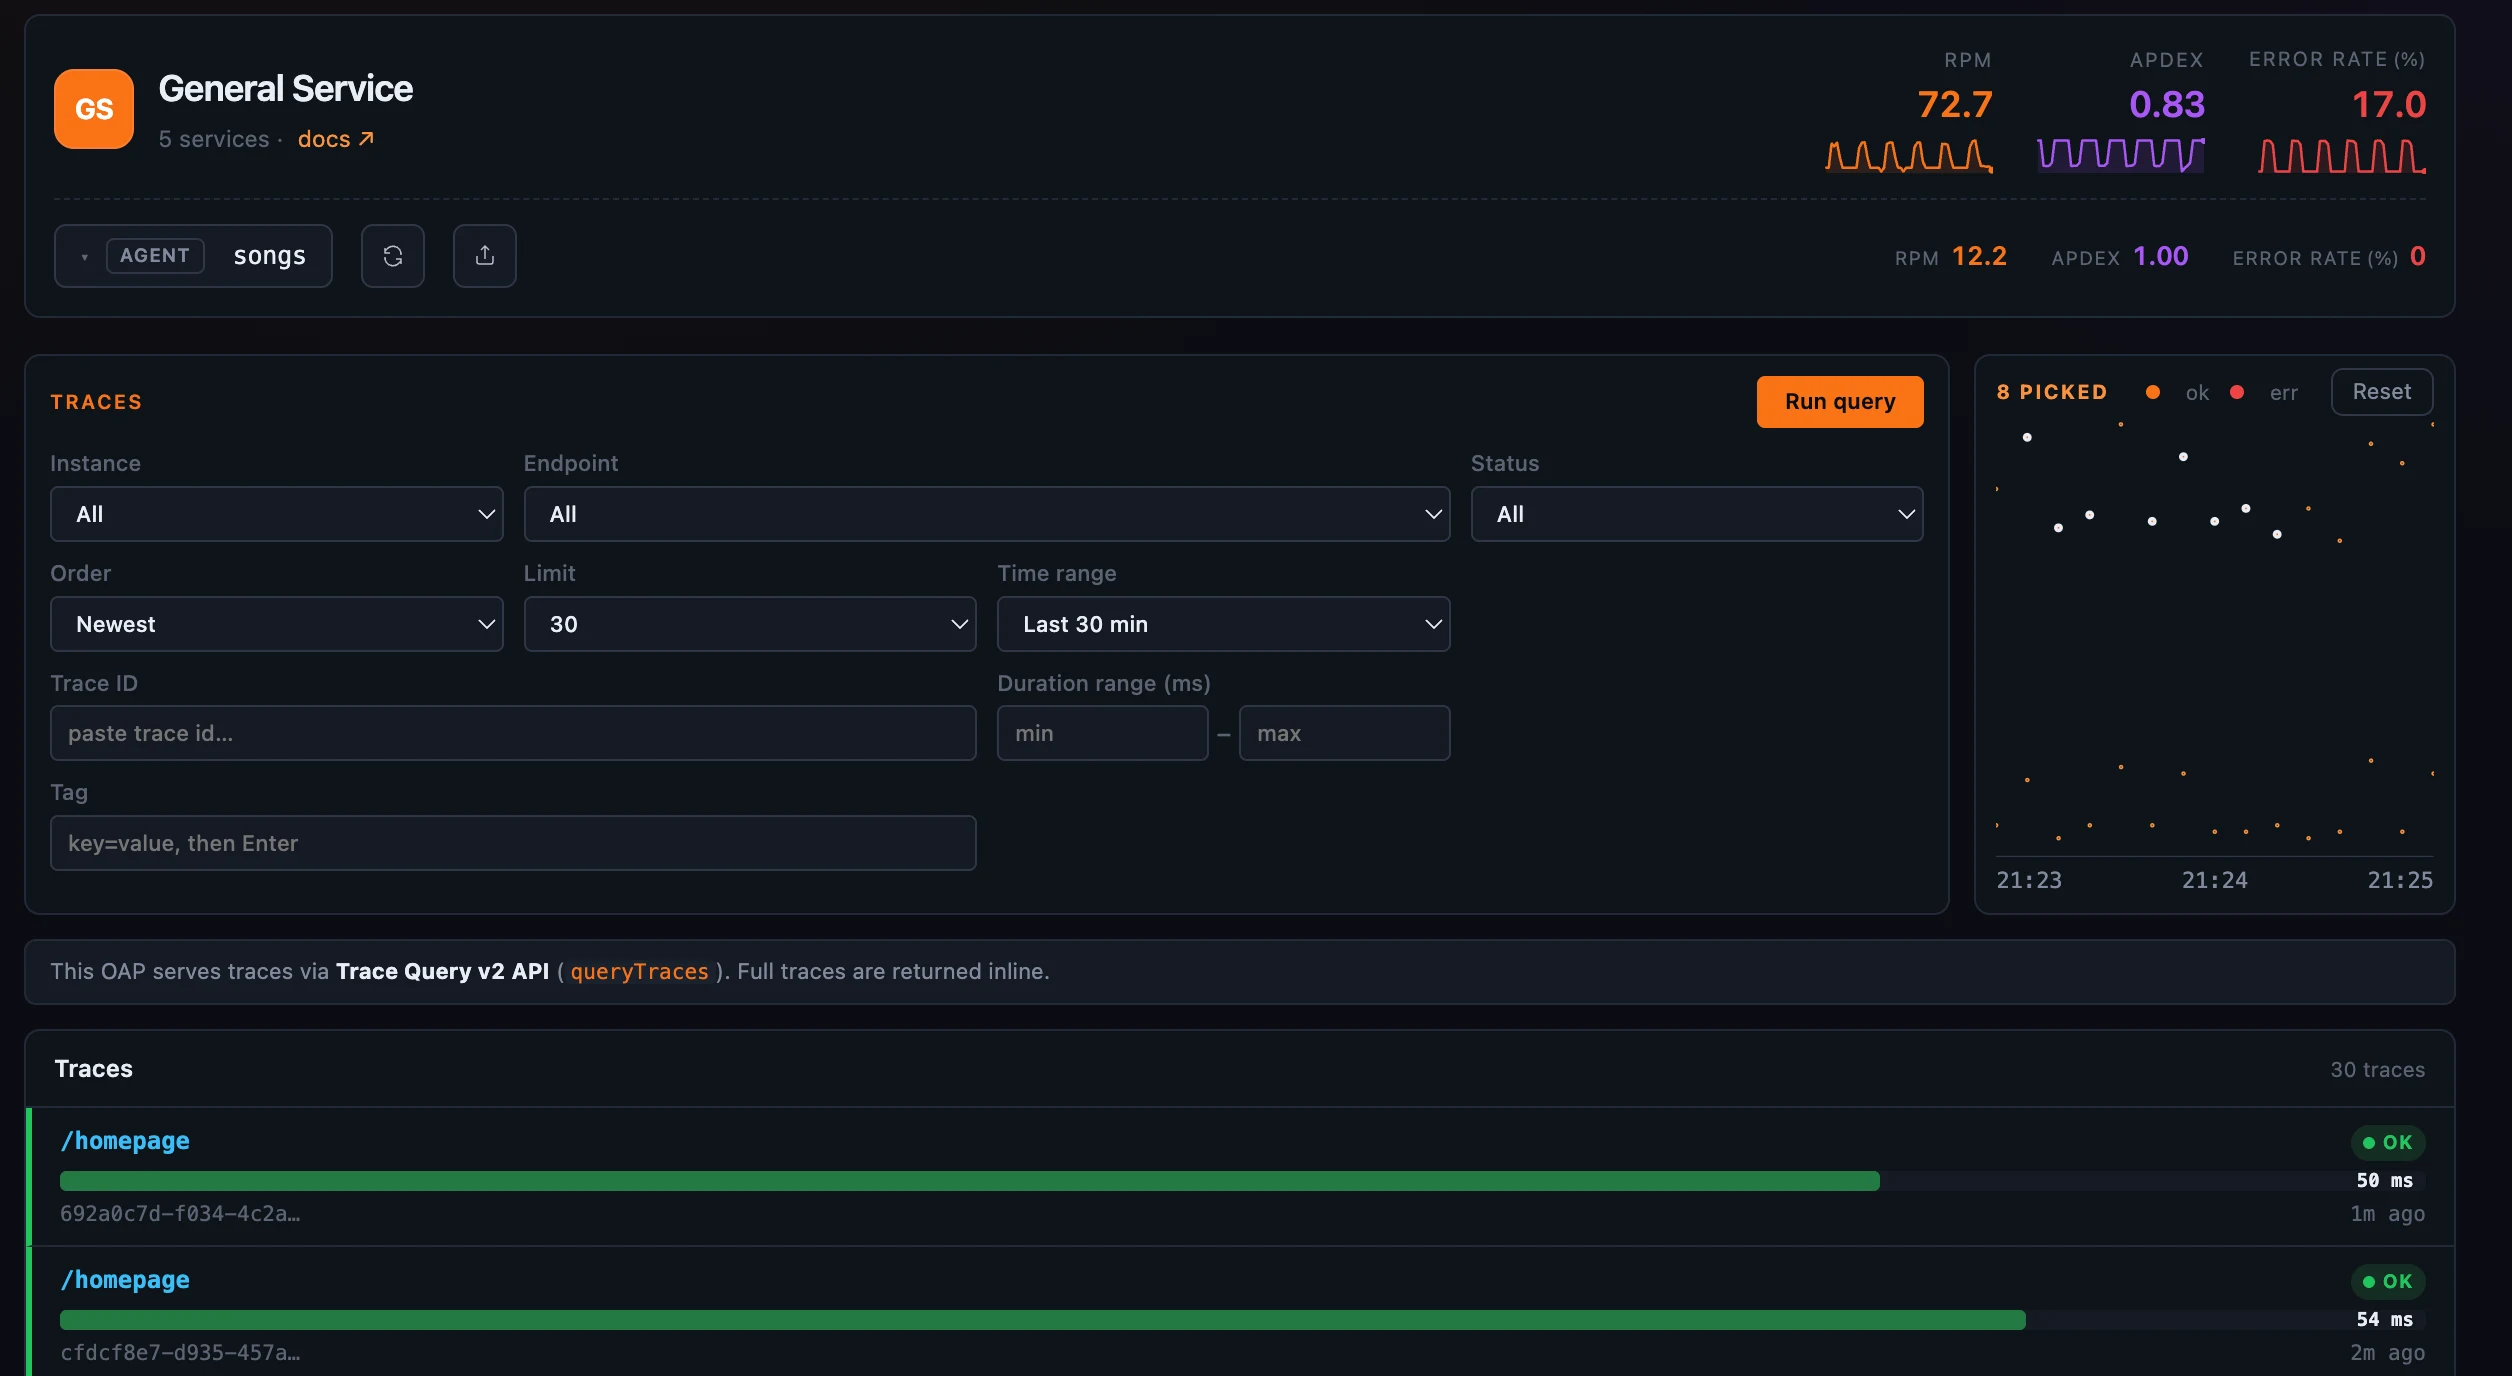
图 2-1 · Trace 查询面板:按服务、端点、耗时等条件过滤,再进入瀑布图下钻。
**验收口诀:**服务名出现在 UI → 有新 Trace → Endpoint 有数据 → 告警规则能打到测试通道。四步都过,才算「快速开始」完成,而不是只看到 Agent 进程起来。
§3 DataBuff 接入 SkyWalking
保留 SkyWalking Agent;用 databuff-proxy 双写并行验证,再决定切流
DataBuff 的 Ingest 直接实现 SkyWalking 原生 gRPC v3(Trace / JVM / Log),端口默认同样是 11800,因此不必先换成 OTLP 探针。对已经在生产挂好 SkyWalking Agent 的团队,这是迁移成本最低的切入点:探针 jar、插件集合、服务名命名规范都可以原样保留,变更集中在「上报地址指向哪里」以及「对照期如何回滚」。
3.1 双写(databuff-proxy)
架构示意
业务进程(SkyWalking Agent)
        │  gRPC :11800
        ▼
   databuff-proxy
        ├──▶ SkyWalking OAP   :11800(或迁端口后的地址)
        └──▶ DataBuff Ingest  :11800
proxy 做 gRPC fan-out:同一批 Segment / JVM / Log 对称抄送两路,不做协议转换。某一路故障或被关掉写入时,另一路继续工作;管理页可观察成功/失败/丢弃与熔断状态。设计上的关键点是「对称抄送」而不是「转换后再写」——对照期两边看到的应是同一批原始探针数据,差异主要来自各自后端的聚合、存储与 UI 能力,而不是两套埋点。
前置条件
-
DataBuff 与 SkyWalking OAP 均已在线,且 proxy 主机能访问两边的 gRPC 口(常见
:11800;K8s 上 DataBuff 也可能是 NodePort31180)。 -
准备一台(或容器)部署 proxy;若要「业务零改配置」,也可让 proxy 接管原 OAP 宿主机的
:11800,并把 OAP 迁到新端口——两种落地方式等价于「流量经 proxy」,文档默认写法是 Agent 改指 proxy。 -
记录当前 OAP 地址、变更单与回滚负责人;对照期建议固定时间窗(例如两周),避免无限双写占用带宽。
安装并配置 proxy
从 databuff-proxy Releases 下载对应系统包并解压,编辑 config.yaml:
backends:
  - name: skywalking
    addr: "<oap-host>:11800"
    enabled: true
  - name: databuff
    addr: "<databuff-ingest-host>:11800"
    enabled: true
./start.sh    # 后台运行;./stop.sh 停止
# 管理页默认 http://<proxy-host>:9090/(以 admin.addr 为准)
Docker 镜像亦可用环境变量声明后端,例如把两路地址写入 BACKENDS,并映射 11800(Agent)与 9090(管理页)。启动后先打开管理页确认两路健康,再改 Agent——避免「Agent 已指向 proxy,但下游地址写错」造成两侧同时空白。
Agent 改指 proxy
# agent.config
agent.service_name=my-service
collector.backend_service=<proxy-host>:11800

# 或 JVM
-Dskywalking.collector.backend_service=<proxy-host>:11800
重启应用或滚动 Pod。此后流量经 proxy 双写。迁移文档亦写作 agent.backend_service,与 collector 配置项指向同一上报地址,按你使用的 Agent 版本文档核对键名即可。金丝雀建议:先改 1–2 个非核心服务,完成下一节验收表,再按业务域扩批。
并行验证
| 检查 | 预期 |
|---|---|
| SkyWalking UI | 原有服务、Trace 仍正常出现 |
| DataBuff Web | 出现相同 service_name;新请求可查 Trace;data.source 为 SkyWalking |
| proxy 管理页 | 两路成功转发、无持续丢弃;熔断状态正常 |
| JVM / Log | 若 Agent 开启对应上报,两侧可见 |
| 调用关系 | 同一时间窗内,关键边(如 A→B、A→DB)在两侧拓扑均可解释 |
公开稳定性验证给出的量级结论:QPS=35 量级双写时,proxy 进程占用不到 1 核、内存约数十 MB 且过夜不涨;一路挂掉或手动关写入时另一路不受影响。应用团队应以自身流量复测,并把「管理页丢弃计数持续为 0」写进对照期日报。
切走与回滚
**切走 SkyWalking:**确认 DataBuff 达标后,任选其一——在 proxy 管理页关掉 skywalking 写入(立刻只写 DataBuff);或把 Agent 直接改为 DataBuff Ingest 地址并下线 proxy / OAP。
**回滚:**双写阶段可关掉 databuff 写入,或把 Agent 改回 OAP;若已切走,则 Agent 改回 OAP,或重新打开 proxy 的 skywalking 一路。注意:OAP 历史 Trace/指标与告警 YAML 不会自动迁入 DataBuff,告警需在 DataBuff 侧重建。切流当天建议保留「只关写入、不下线 OAP」的缓冲,便于一键回到双写或单写 OAP。
3.2 接入效果
双写跑通后,价值不在「多一个 UI」,而在同一批探针数据能否在两侧同时验收,并在 DataBuff 侧使用其原生排障路径。下列效果均可在公开 Demo 或文档中对照验证。
**(1)两侧可见同一批服务与 Trace。**SkyWalking 侧继续用熟悉的 Horizon 拓扑 / Trace Explorer;DataBuff 侧「应用性能 → 服务」应出现相同服务名。公开 Demo 中可见 Java 服务(如 service-a / service-b)的调用数、平均响应时间与错误率趋势——证明 Ingest 已按 SkyWalking 协议消化 Segment。对照时建议固定同一时间窗,避免「一侧看 15 分钟、一侧看 1 小时」造成的错觉差异。
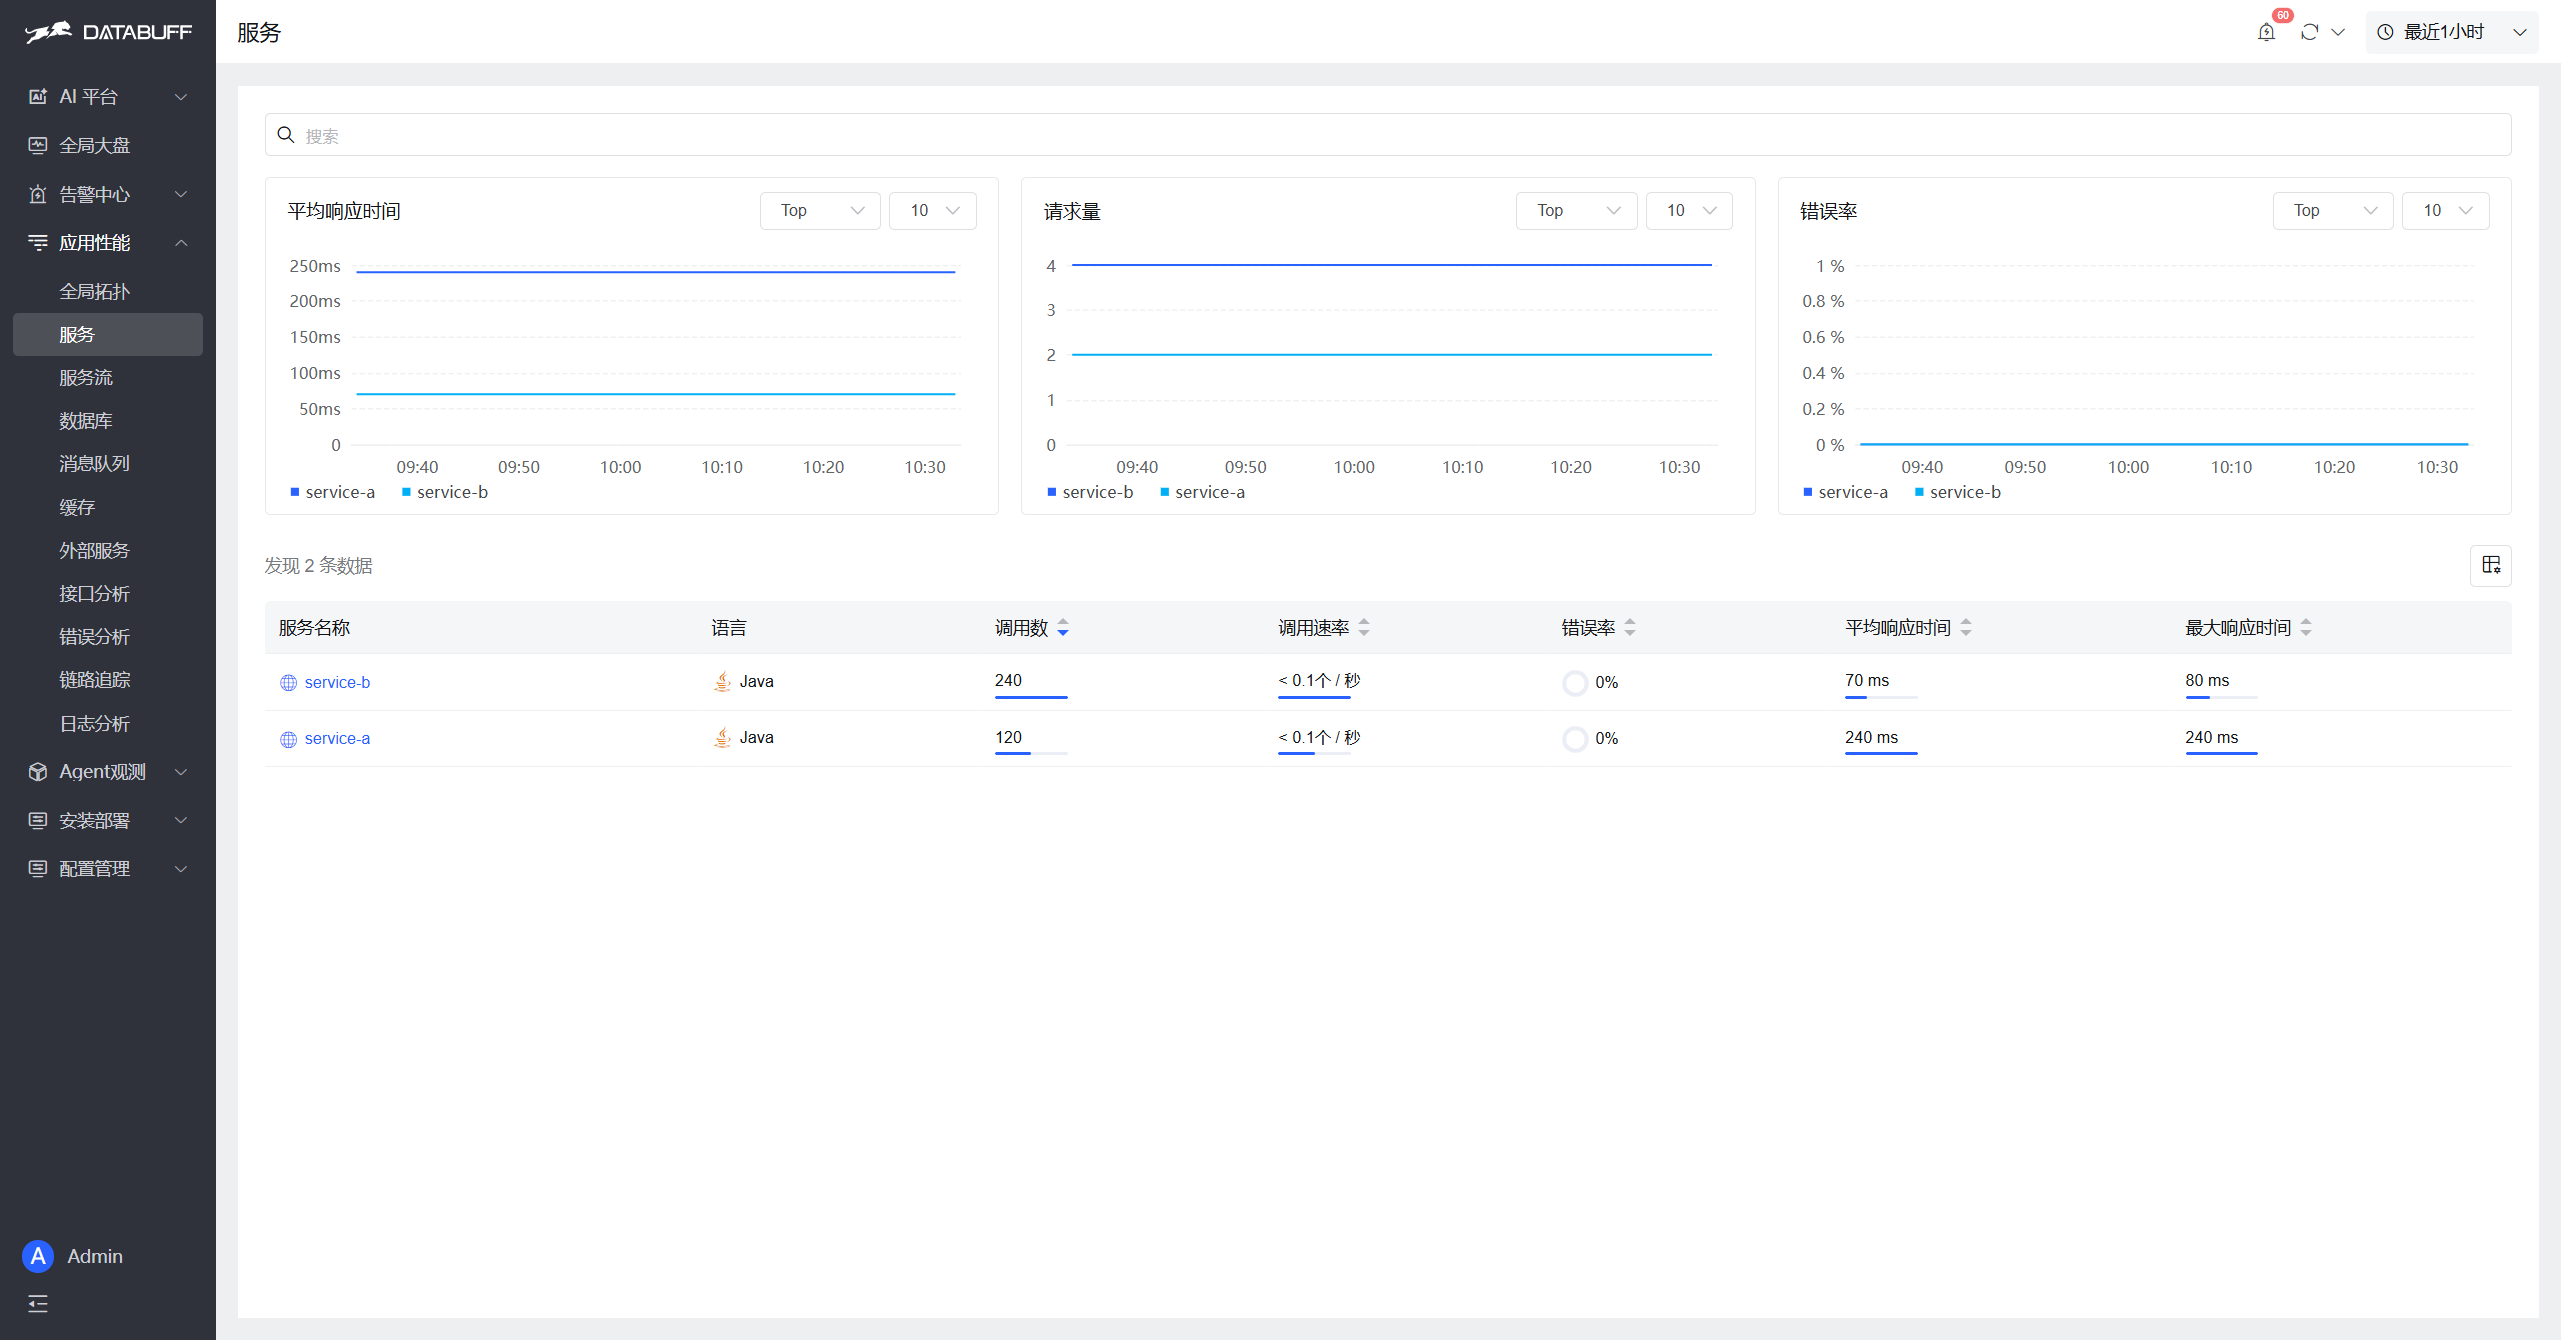
图 3-1 · 服务列表展示语言、调用数、错误率与响应时间;双写验收时对照 SkyWalking 侧服务名是否一致。
**(2)拓扑增益:中间件与外部依赖同屏。**DataBuff 全局拓扑不仅画服务节点,还把 MySQL、Redis、Elasticsearch、Kafka、外部 HTTP 等依赖画进同一张图,异常节点可用颜色强调。对「慢在自身还是慢在下游」这类问题,比只看服务六边形更直接。版本说明中的「接口耗时分解」进一步把接口自身耗时从下游 DB/Redis/MQ/HTTP 中拆出,适合在对照期用同一慢接口两边交叉验证。
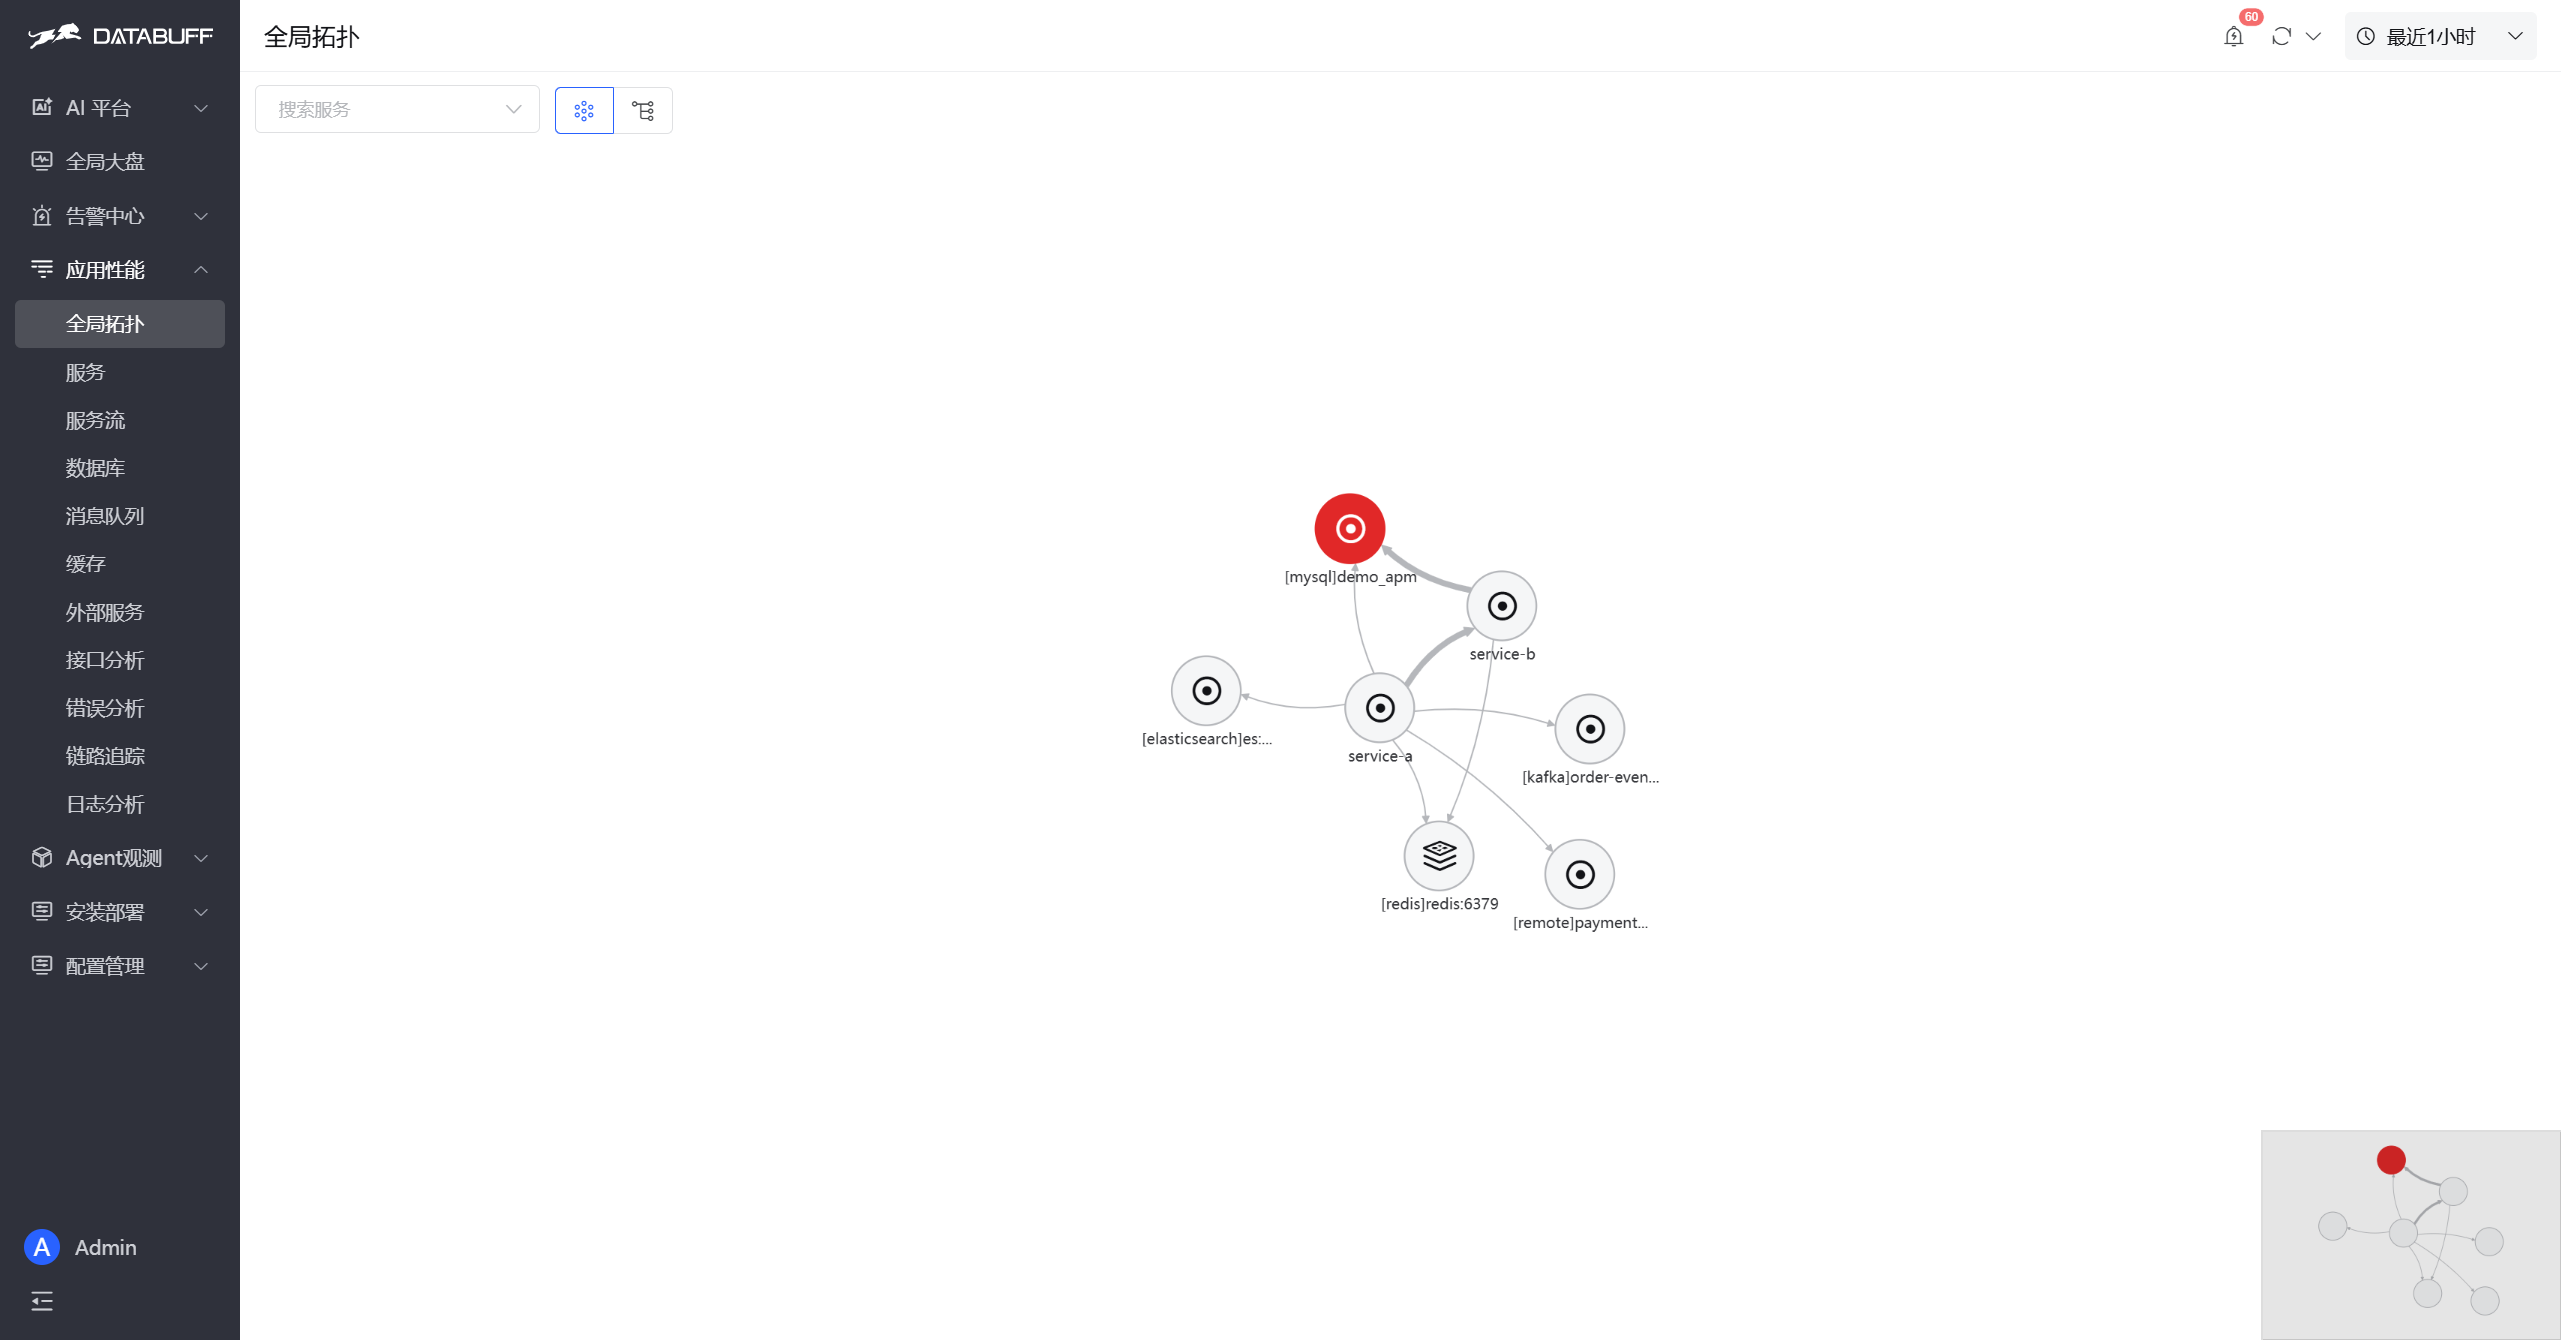
图 3-2 · service-a / service-b 与 DB、缓存、队列、外部支付等依赖同图;便于双写对照期做调用关系核对。
(3)链路追踪列表与下钻。「链路追踪」页可按时间窗检索 Trace,再进入瀑布/Span 细节;接入文档要求验收时确认 data.source=SkyWalking,以区分 OTLP 与 SkyWalking 原生协议入库的数据。若环境同时开了 OTLP 与 SkyWalking 双协议,务必用该字段避免「看错数据源」导致误判迁移成功。
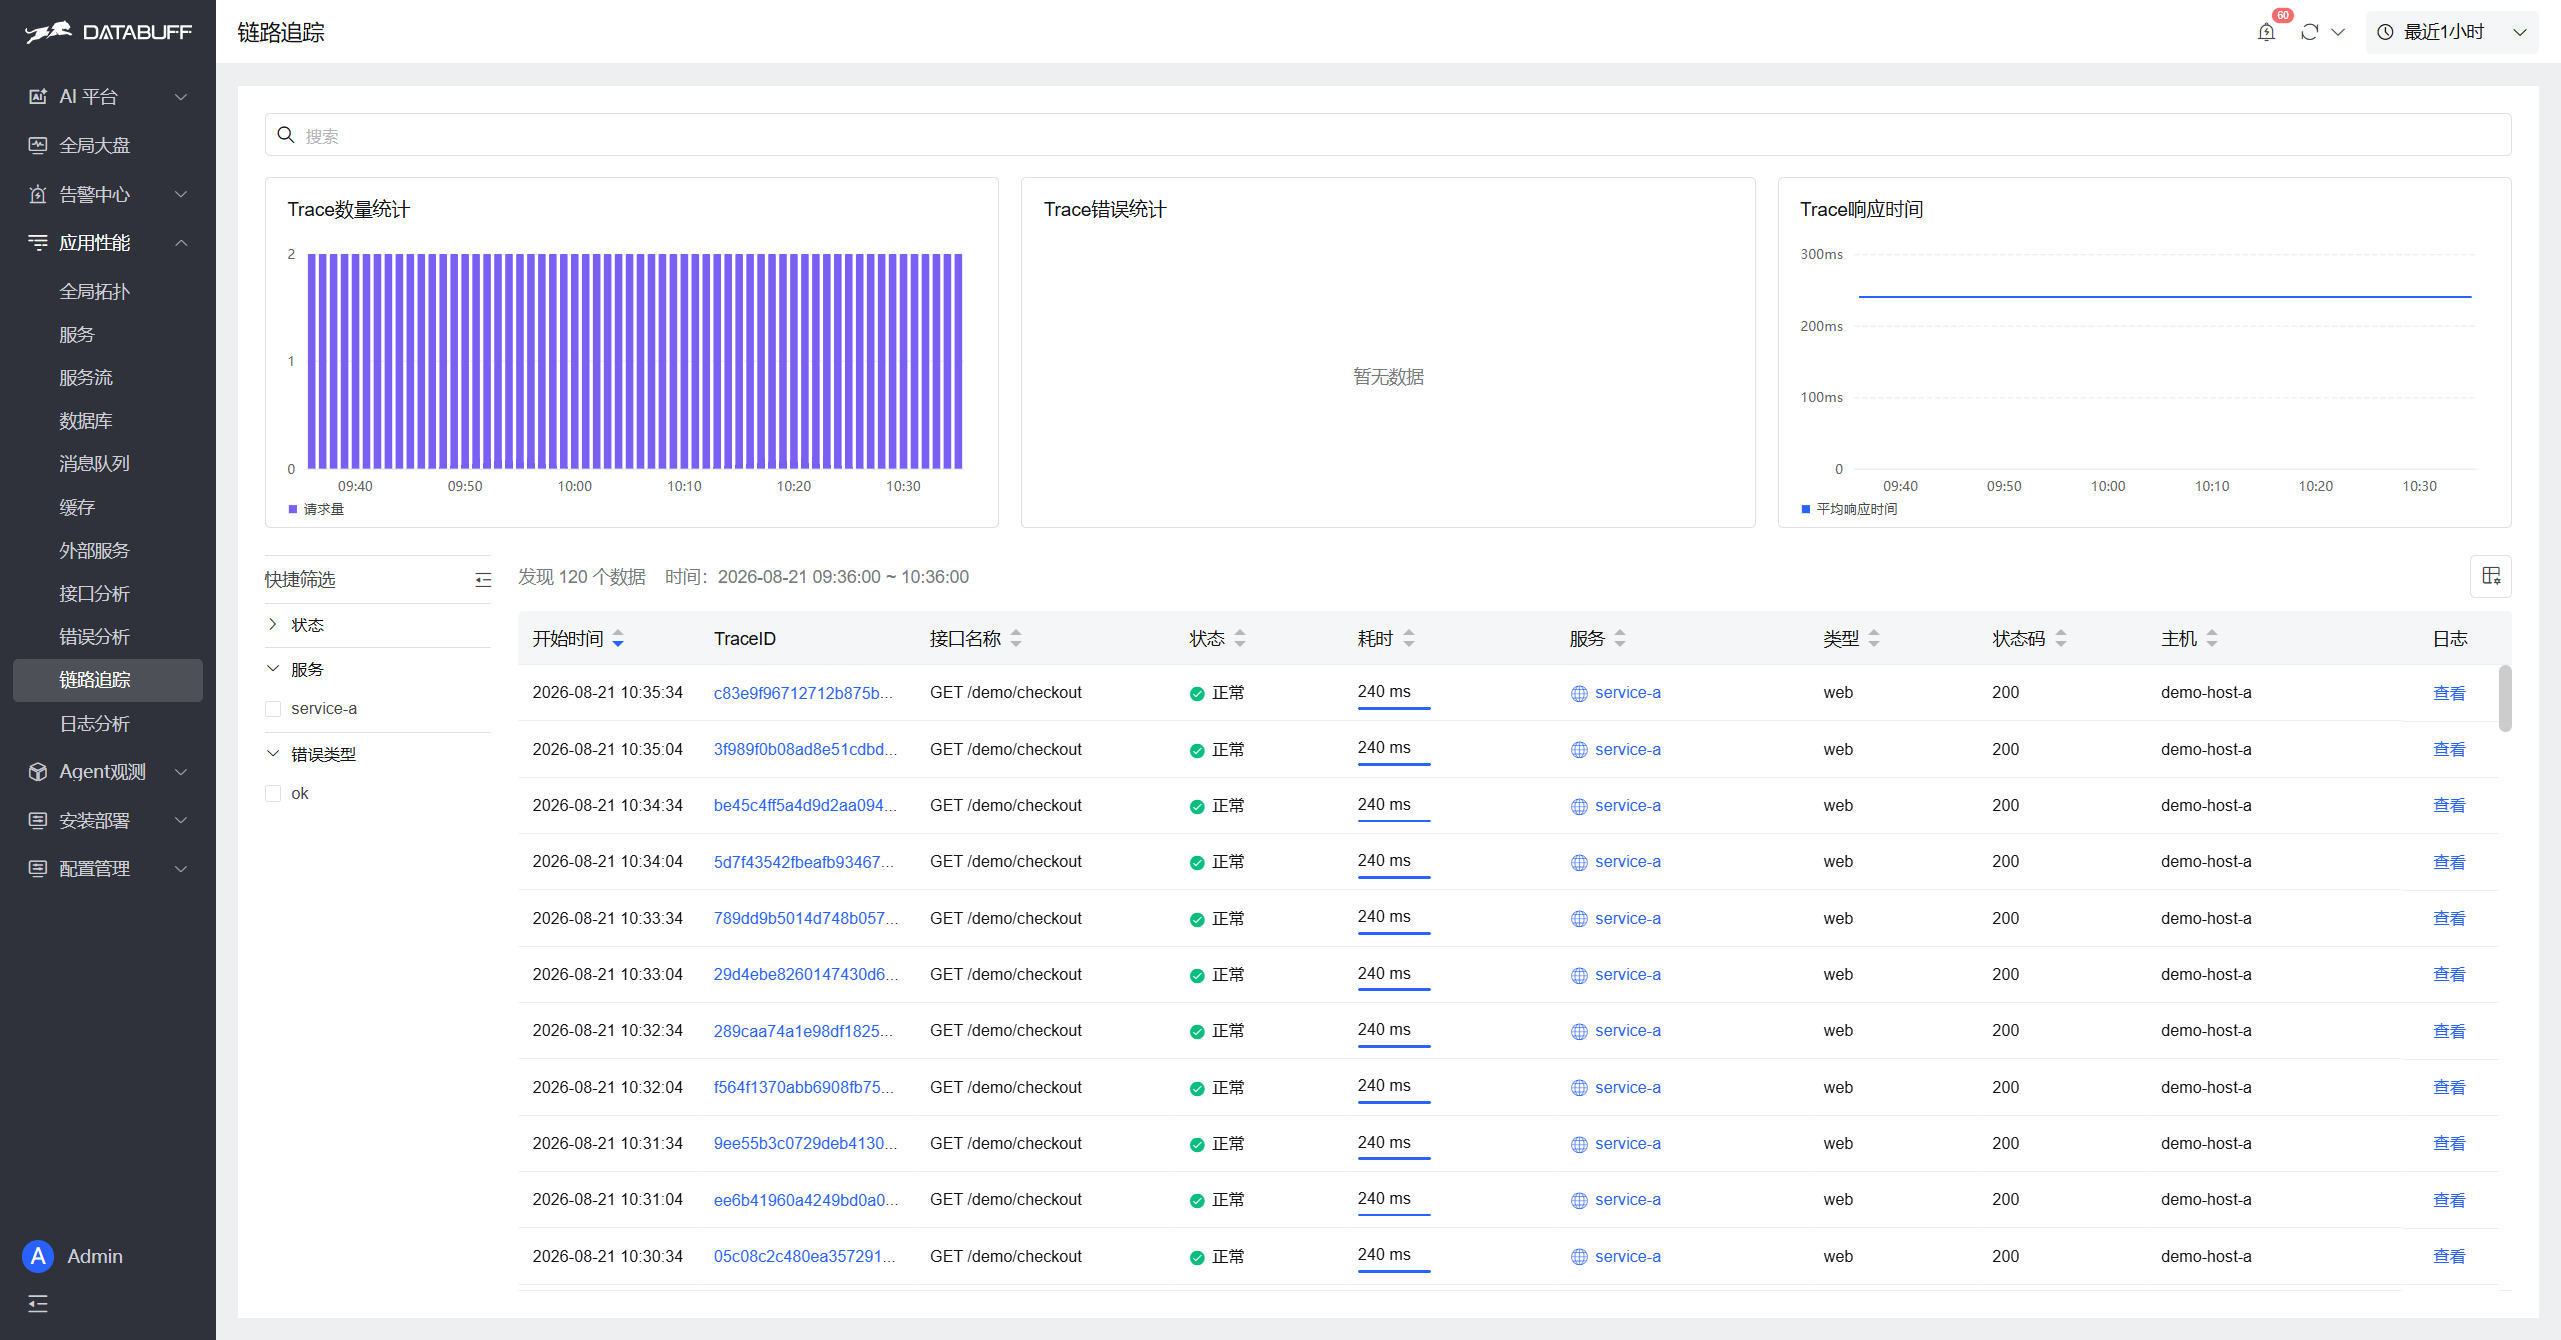
图 3-3 · 双写后新请求应在列表中可查;再与 SkyWalking Trace Explorer 对同一时间窗交叉验证。
**(4)AI 问数 / 巡检等可验证能力。**DataBuff 将 AI 对话作为一等入口:可用自然语言查询最近一小时服务列表、某服务上下游拓扑、请求量/异常量趋势等。这对「保留 Agent、增强分析面」的团队很关键——探针层不动,分析层多一条对话式路径。公开版本说明亦强调 proxy 双写让 SkyWalking 用户在业务零改探针的前提下并跑 DataBuff。对照期可以把「同一问题:SkyWalking 点选 vs DataBuff 问数」做成内部演练,记录耗时与结论是否一致,再决定是否扩大切流范围。
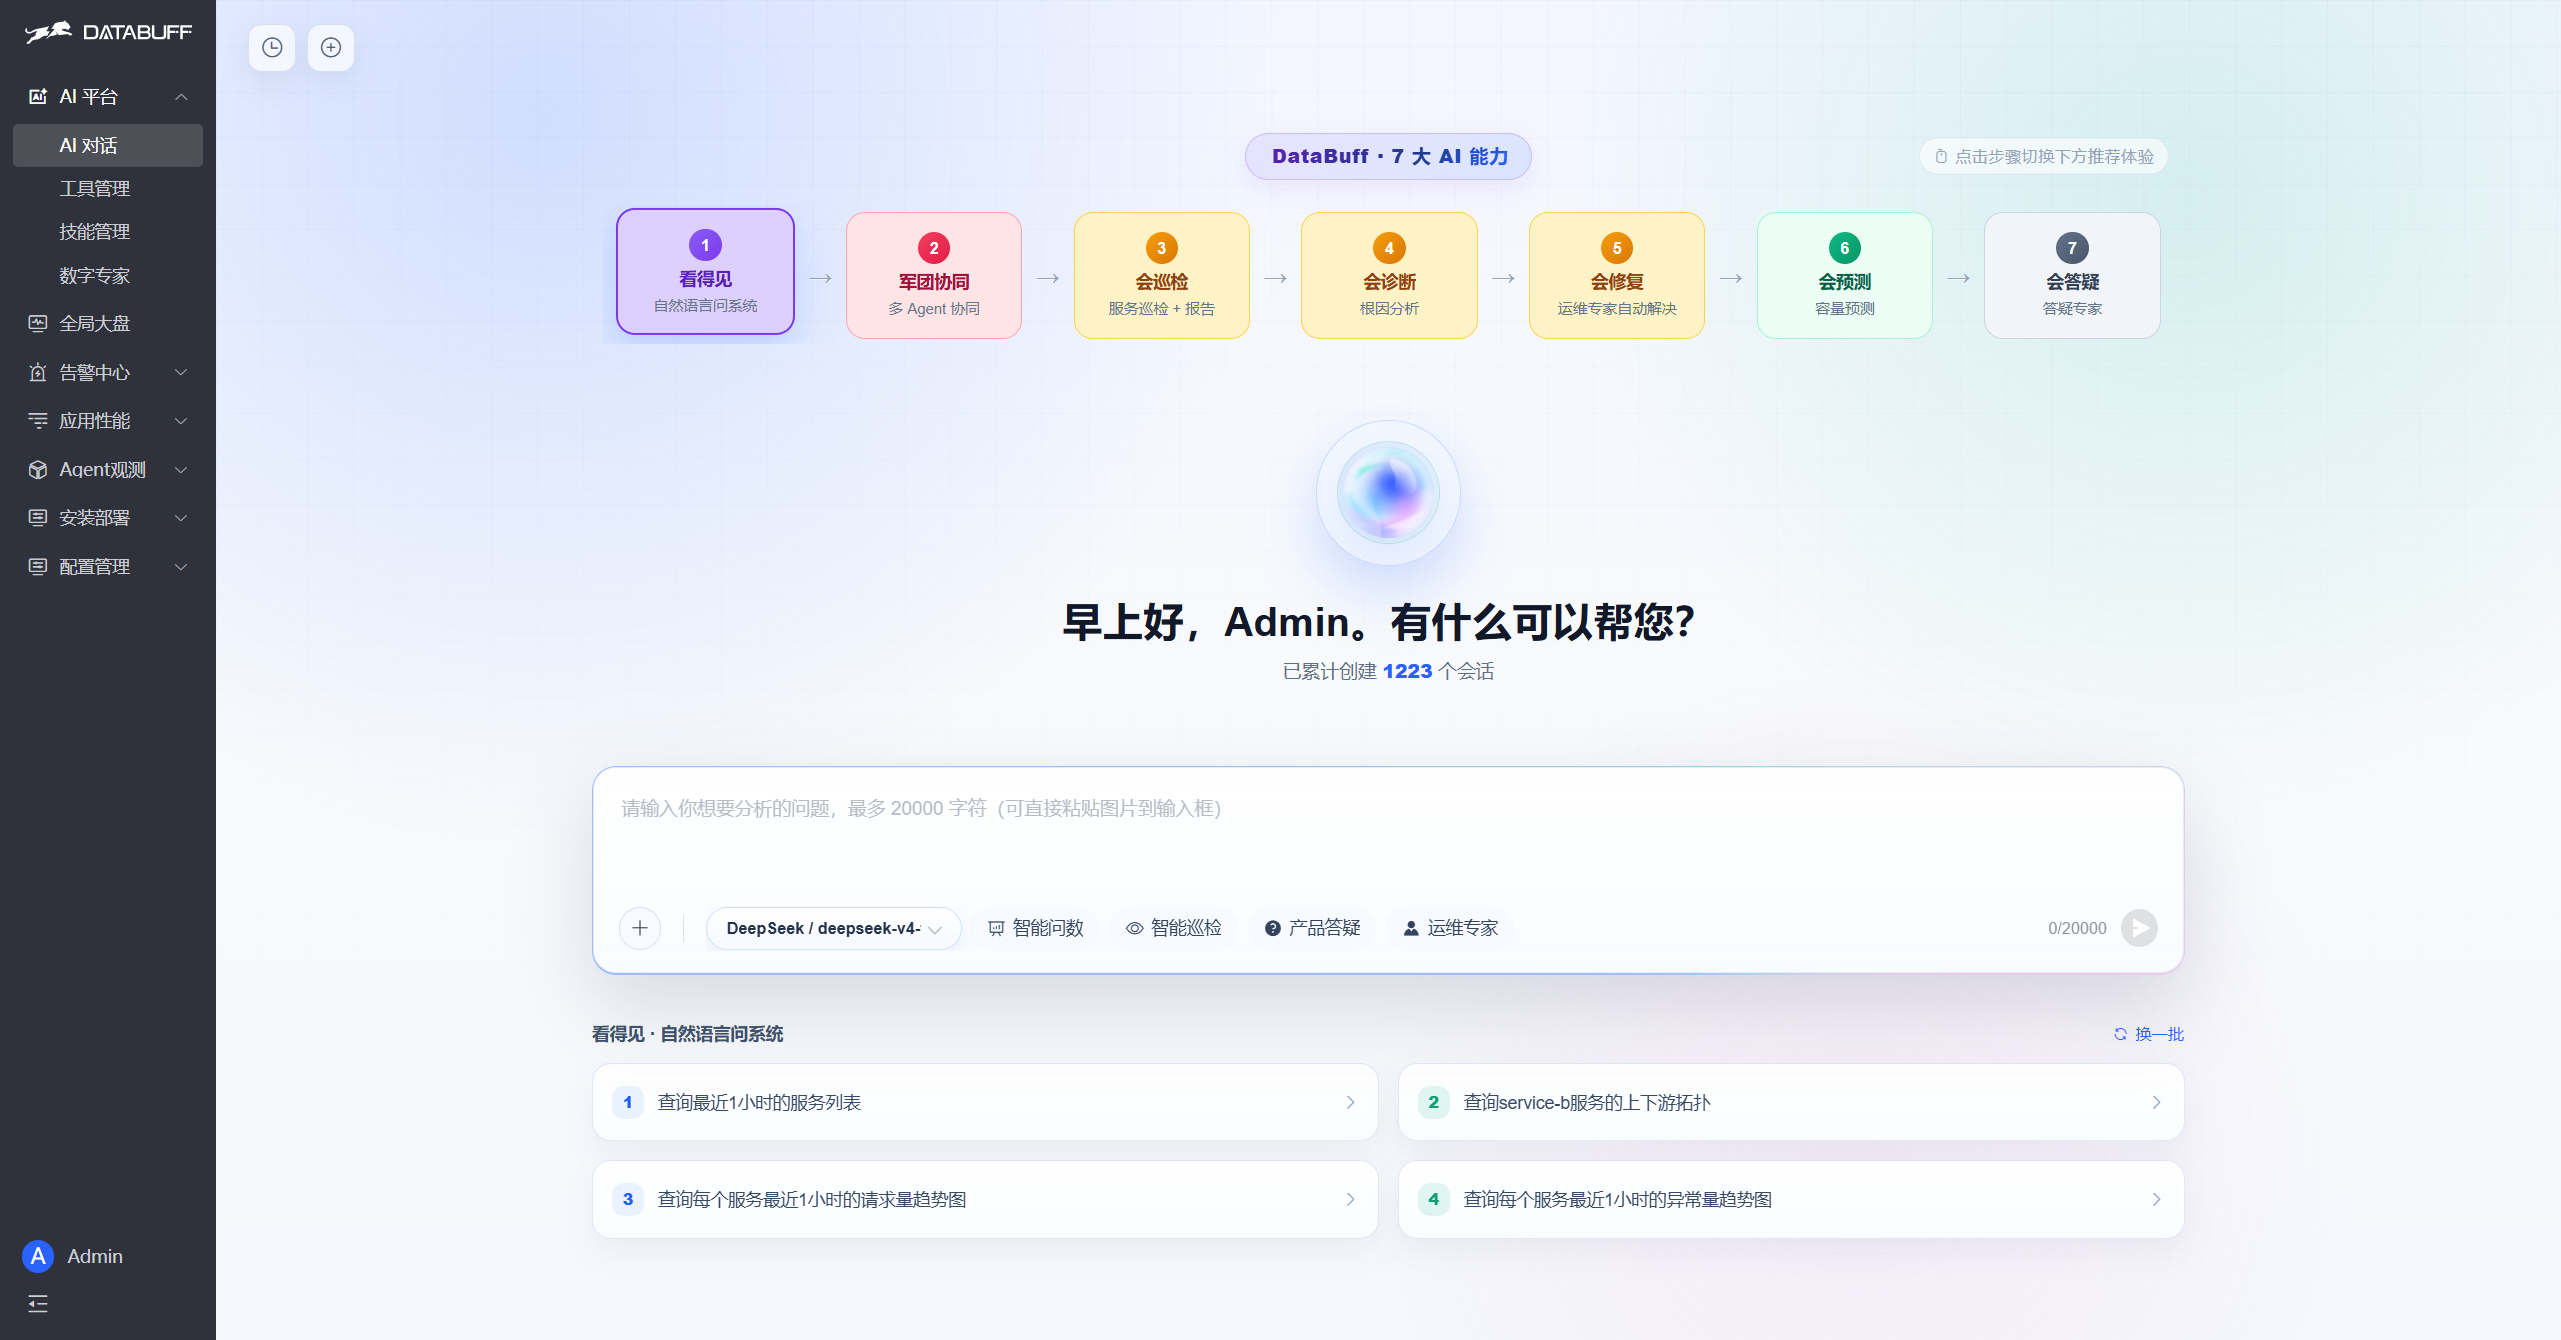
图 3-4 · AI 对话提供问数、巡检等入口;双写有数据后即可用自然语言交叉验证服务与拓扑。
**§3 收束:**目标不是「立刻下线 SkyWalking」,而是用 proxy 换一段可回滚的对照期:Agent 只改一次(或端口接管一次),两侧同时看见同一批 Trace;DataBuff 侧用服务列表、全局拓扑、链路追踪与 AI 问数完成验收后,再关 OAP 写入或直连 Ingest。告警与历史数据需按清单重建,避免误以为「双写等于配置自动迁移」。
§4 行业视角:APM / 可观测正在与 AI 交汇
摘录 IDC、Gartner 等公开论述,帮助把「探针 + 链路」放到更大的采购与能力演进语境里
把 SkyWalking Agent 继续用下去、再叠加一层可对话、可对照的分析面,并不只是工具偏好问题。近两年分析机构对 APM / 可观测市场的表述,越来越强调两件事:遥测要能支撑决策,以及 AI 要能站在真实信号上辅助运维——而不是单独再叠一层黑盒。
4.1 IDC:可观测是数字决策底座,AI 在改写运维软件
IDC 在 2025 年首次发布的 Worldwide Observability Platforms MarketScape 研究中指出:观察(observe)与定向(orient)是决策过程的关键环节;对数字资产进行可观测,因而成为现代数字业务「规模化决策」的基础。研究同时把可观测平台概括为:统一 metrics、events、logs、traces 与体验类数据,加速排障,并为 AI 辅助的 IT 运维提供证据底座[1]。换言之,链路与指标不再只是「运维大盘」,而是后续自动化与智能分析能否站得住脚的前提。
同一脉络下,IDC 对基础设施软件趋势的公开摘要也强调:AI 能力正在倒逼企业系统管理、AIOps 与可观测产品形态变化——包括 AI observability 演进、AIOps 从「降噪」走向更广的运维决策支持,以及多 Agent 协作等方向[2]。对已有 SkyWalking 探针资产的团队,这给出一个务实读法:先保证 Segment / 拓扑 / Trace 证据完整,再谈问数、巡检或事件关联,才符合分析机构对「有证据的 AI 运维」的叙事,而不是先上对话、后补数据。
4.2 Gartner:从 APM 到可观测平台,再到 AI 可观测
Gartner 侧,市场研究口径已从偏「Application Performance Monitoring」扩展到更宽的 Observability Platforms:强调从日志、指标、事件与链路等多种遥测中理解应用与基础设施的健康与行为,并把遥测转化为洞察与行动——「仅有传统 APM」往往不够[3]。近年 Magic Quadrant / 市场评述亦反复点到:买家在评估平台时,会看全栈可观测能力,以及路线图在 AI observability、OpenTelemetry 互通、对 AI Agent 工作负载的可观测与治理等方面是否可信;同时提醒:许多「自治运维 / 自动修复」主张仍超前于普遍落地,当前更扎实的能力多集中在辅助调查、事件摘要与根因分析辅助[4]。
与「用 AI 管应用」并行的另一条线,是「管 AI 本身」。Gartner 公开预测指出:到 2028 年,部署 AI 的组织中将有约 40% 采用专门的 AI observability 能力,以监控模型表现、偏差与输出等;动因不仅是基础设施健康,也包括对复杂模型与 agentic AI 的风险管理需求[5]。对应用侧 APM / 链路团队,这并不要求立刻换栈,但提示:同一套遥测管道(OTLP 或 SkyWalking 原生协议)若能把服务调用与(未来的)推理调用放进可关联的上下文,会更接近分析机构描述的演进方向。
引用资料
[1] https://my.idc.com/getdoc.jsp?containerId=US53004325
[2] https://my.idc.com/getdoc.jsp?containerId=US53121225
[3] https://www.gartner.com/en/documents/5663323
[4] https://www.networkworld.com/article/4197973/ai-workloads-shake-up-observability-market.html
[5] https://www.apmdigest.com/gartner-40-organizations-deploying-ai-will-use-ai-observability-monitor-model-performance-2028

 2065


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


