


导读:数据入仓看似只是“把文件导进表里”,真正上线后却会遇到调度、重试、去重、凭证管理和失败恢复等一连串工程问题。本文用一个最小可跑通的示例,演示如何用 Airflow 编排本地 CSV / NDJSON 文件,经 S3 暂存后导入 Databend Cloud,并进一步说明这条链路如何扩展成一套可重跑、低运维、面向云原生数仓的数据入仓实践。阅读时间约为 6 分钟。
为什么需要一条可重跑的数据入仓链路?
数据入仓听起来简单,真正做起来却很容易变成一串细碎问题:文件从哪里来、先落在哪里、什么时候导入、失败后如何重试、重复执行会不会产生脏数据、源文件是否还能回溯。
手工跑一次没有问题。但如果这条链路要每小时运行一次、持续运行一年,还要在失败后自动恢复,就需要一个可靠的调度系统,以及一个适合对象存储和云端分析的数仓底座。
这篇文章用一个最小可跑通的例子,演示如何用 Apache Airflow 编排整条链路,把本地文件经 AWS S3 暂存后,导入 Databend Cloud。这条链路的特点是:单一调度源、依赖明确、可重跑、便于扩展。
读完你会得到:
- Airflow 与 Databend Cloud 在数据入仓链路中的职责划分;
- 一个可以直接运行的 DAG 和启动脚本;
- 从启动服务、配置连接、执行 DAG,到在 Databend Cloud 中查询数据的完整流程;
本文用到的全部代码,包括启动脚本、DAG、样例数据和依赖清单,都已经放在 GitHub 上:databendcloud/airflow-demo。下文会贴出关键片段并逐段讲解,想直接上手或查看完整文件,可以 clone 仓库运行。
Airflow 与 Databend Cloud 的职责分工
Apache Airflow:用代码定义工作流
Apache Airflow 是一个用 Python 定义、调度和监控工作流的开源编排平台,最早由 Airbnb 开源,现为 Apache 顶级项目,也是数据工程领域广泛采用的事实标准。
它的核心概念并不复杂:
- DAG(有向无环图):一个工作流就是一张 DAG,用来描述有哪些任务,以及任务之间的依赖关系。
- Task(任务):DAG 里的一个节点,是实际执行工作的最小单元。
- Operator(算子):任务模板。比如执行 Python 函数的
PythonOperator,以及把本地文件上传到 S3 的LocalFilesystemToS3Operator。 - Scheduler(调度器):按照 DAG 的时间表触发任务,并根据依赖关系决定执行顺序。
- Connection / Variable:Airflow 管理连接信息和配置的机制。Connection 适合存连接凭证,Variable 适合存桶名、表名、连接串等参数。
Airflow 的价值在于 workflow as code。依赖关系、调度周期、重试策略都写在 Python 里,可以版本化、审查和复用。任务失败后,Airflow 可以按策略自动重试,运行状态也能在 Web UI 中直接查看。
Databend Cloud:面向对象存储的云原生数仓
Databend 是一个用 Rust 编写的云原生数据仓库,采用存算分离架构。数据存放在对象存储上,计算资源通过 Warehouse 按需使用,存储和计算可以独立扩展、独立计费。
Databend Cloud 是 Databend 的全托管服务版本,适合希望减少运维成本、直接使用云端数仓能力的团队。
对这篇文章来说,最关键的是 Databend 的 COPY INTO 命令:
COPY INTO my_table
FROM 's3://my-bucket/path/to/file.ndjson'
CONNECTION = (
    ACCESS_KEY_ID = '...'
    SECRET_ACCESS_KEY = '...'
)
FILE_FORMAT = (TYPE = NDJSON);
COPY INTO 允许 Databend 直接从对象存储加载文件入表,支持 CSV、NDJSON、Parquet、ORC、Avro 等格式。它也默认具备文件去重能力:同一个文件已经导入过时,再次执行不会重复加载。这一点是本文链路“重跑安全”的基础。
这也符合 Databend Cloud 的典型使用方式:原始数据先落在 S3,Databend 直接从对象存储加载并查询,计算资源按需启动和扩展。对于日志、事件、NDJSON、Agent trace 等半结构化数据,后续还可以结合 VARIANT、全文检索、Stream / Task 做进一步清洗、检索和增量聚合。
整体架构:Airflow 编排,S3 暂存,Databend Cloud 入仓
本文的最小示例只有两步:
本地 CSV / NDJSON
      │
      │  Task 1: LocalFilesystemToS3Operator
      ▼
AWS S3 暂存层
      │
      │  Task 2: PythonOperator -> COPY INTO
      ▼
Databend Cloud
设计思路很直接:
- Airflow 负责跨系统编排:什么时候上传、什么时候导入、失败后如何重试,都交给 Airflow。
- S3 负责原始数据暂存:文件先落到对象存储,保留一份可回溯、可重导的原始数据。
- Databend Cloud 负责高效入仓和查询:通过
COPY INTO从 S3 拉取文件,完成批量导入,并利用对象存储原生架构承接后续分析。
在这个最小示例中,调度统一交给 Airflow,Databend 端不再额外启动 Task 去轮询 S3。这样做的好处是链路更容易理解,出了问题只需要先看 Airflow 一个地方。
进入生产环境后,也可以按照职责进一步拆分:Airflow 负责跨系统编排,Databend Stream / Task 负责库内增量清洗、聚合和物化结果。这样既保持调度边界清晰,也能利用 Databend 在库内处理上的能力。
为什么不让 Airflow 直接把数据一行行写进 Databend?
因为 Databend 的 COPY INTO 本身就是为对象存储上的批量导入设计的路径。对于文件型数据入仓,先落 S3 再由 Databend 拉取,通常比应用侧逐行写入更适合吞吐、回溯和重跑。
准备环境与样例数据
环境依赖
本示例使用 Python 3.11 虚拟环境(.venv/),依赖如下:
apache-airflow>=2.7.0
apache-airflow-providers-amazon>=8.0.0
databend-driver>=0.20.0
其中:
apache-airflow:工作流调度核心。本例使用2.9.3,并通过官方 constraints 文件锁定依赖版本。apache-airflow-providers-amazon:提供 AWS 相关 Operator,例如LocalFilesystemToS3Operator。databend-driver:Databend 官方 Python 驱动,DAG 中用它执行COPY INTO。
安装命令(用官方 constraints 锁版本):
python3.11 -m venv .venv
source .venv/bin/activate

pip install "apache-airflow==2.9.3" \
  --constraint "https://raw.githubusercontent.com/apache/airflow/constraints-2.9.3/constraints-3.11.txt"

pip install apache-airflow-providers-amazon databend-driver
准备样例数据
示例文件为 data/sample.ndjson,每行是一个 JSON 对象:
{"id": 1, "name": "alice", "amount": 10.5}
{"id": 2, "name": "bob", "amount": 20.0}
{"id": 3, "name": "carol", "amount": 33.3}
在 Databend Cloud 创建目标表
登录 Databend Cloud 控制台,在 Worksheet 中创建目标表:
CREATE TABLE IF NOT EXISTS airflow_demo (
    id     INT,
    name   VARCHAR,
    amount DOUBLE
);
如果你的真实数据是字段经常变化的日志或事件,也可以考虑使用 VARIANT 承接半结构化字段,再通过后续 SQL、虚拟列或增量任务做清洗和聚合。本文为了让示例足够直接,使用固定字段表结构。
启动 Airflow 本地调度环境
启动 Airflow 的脚本 start_airflow.sh 如下:
#!/usr/bin/env bash
# 启动 Airflow(standalone 模式,含 web UI + scheduler)。
# 首次启动会自动建 admin 账号,账号密码打印在终端日志里。
set -euo pipefail

cd "$(dirname "$0")"

export AIRFLOW_HOME="$(pwd)/airflow_home"
export AIRFLOW__CORE__DAGS_FOLDER="$(pwd)/dags"
export AIRFLOW__CORE__LOAD_EXAMPLES=False

# standalone 会 spawn 子进程,按名字 `airflow` 从 PATH 查找。
# 必须把 venv 的 bin 放到 PATH 最前,否则会命中 Homebrew 全局的旧 airflow,
# 触发 `ImportError: cannot import name 'escape' from 'jinja2'`。
export VIRTUAL_ENV="$(pwd)/.venv"
export PATH="$(pwd)/.venv/bin:$PATH"

exec .venv/bin/airflow standalone
几个关键点:
AIRFLOW_HOME指向项目内的airflow_home/,避免污染系统目录。AIRFLOW__CORE__DAGS_FOLDER指向dags/,告诉 Airflow 从哪里加载 DAG。AIRFLOW__CORE__LOAD_EXAMPLES=False关闭官方示例 DAG,让 UI 更干净。- 将
.venv/bin放到PATH最前面,确保 Airflow 子进程使用当前虚拟环境中的版本,而不是系统里可能存在的旧版本。
standalone 模式会一次性启动 Web Server、Scheduler 和 Triggerer,适合本地开发和演示。
启动:
./start_airflow.sh
首次启动时,Airflow 会自动创建 admin 账号,用户名和密码会打印在终端日志里,也会写入 airflow_home/standalone_admin_password.txt。
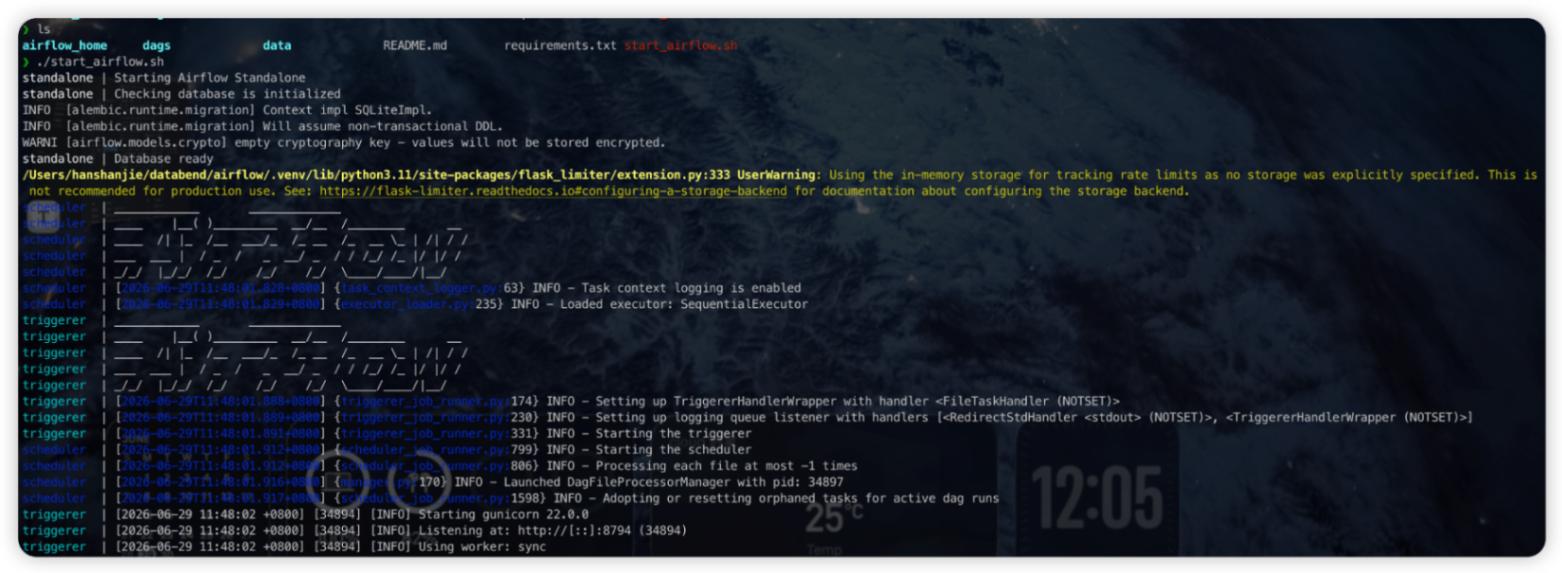
看到日志稳定后,打开 localhost,用 admin 账号登录即可。
DAG 代码详解
完整 DAG 位于 dags/csv_ndjson_to_databend.py。
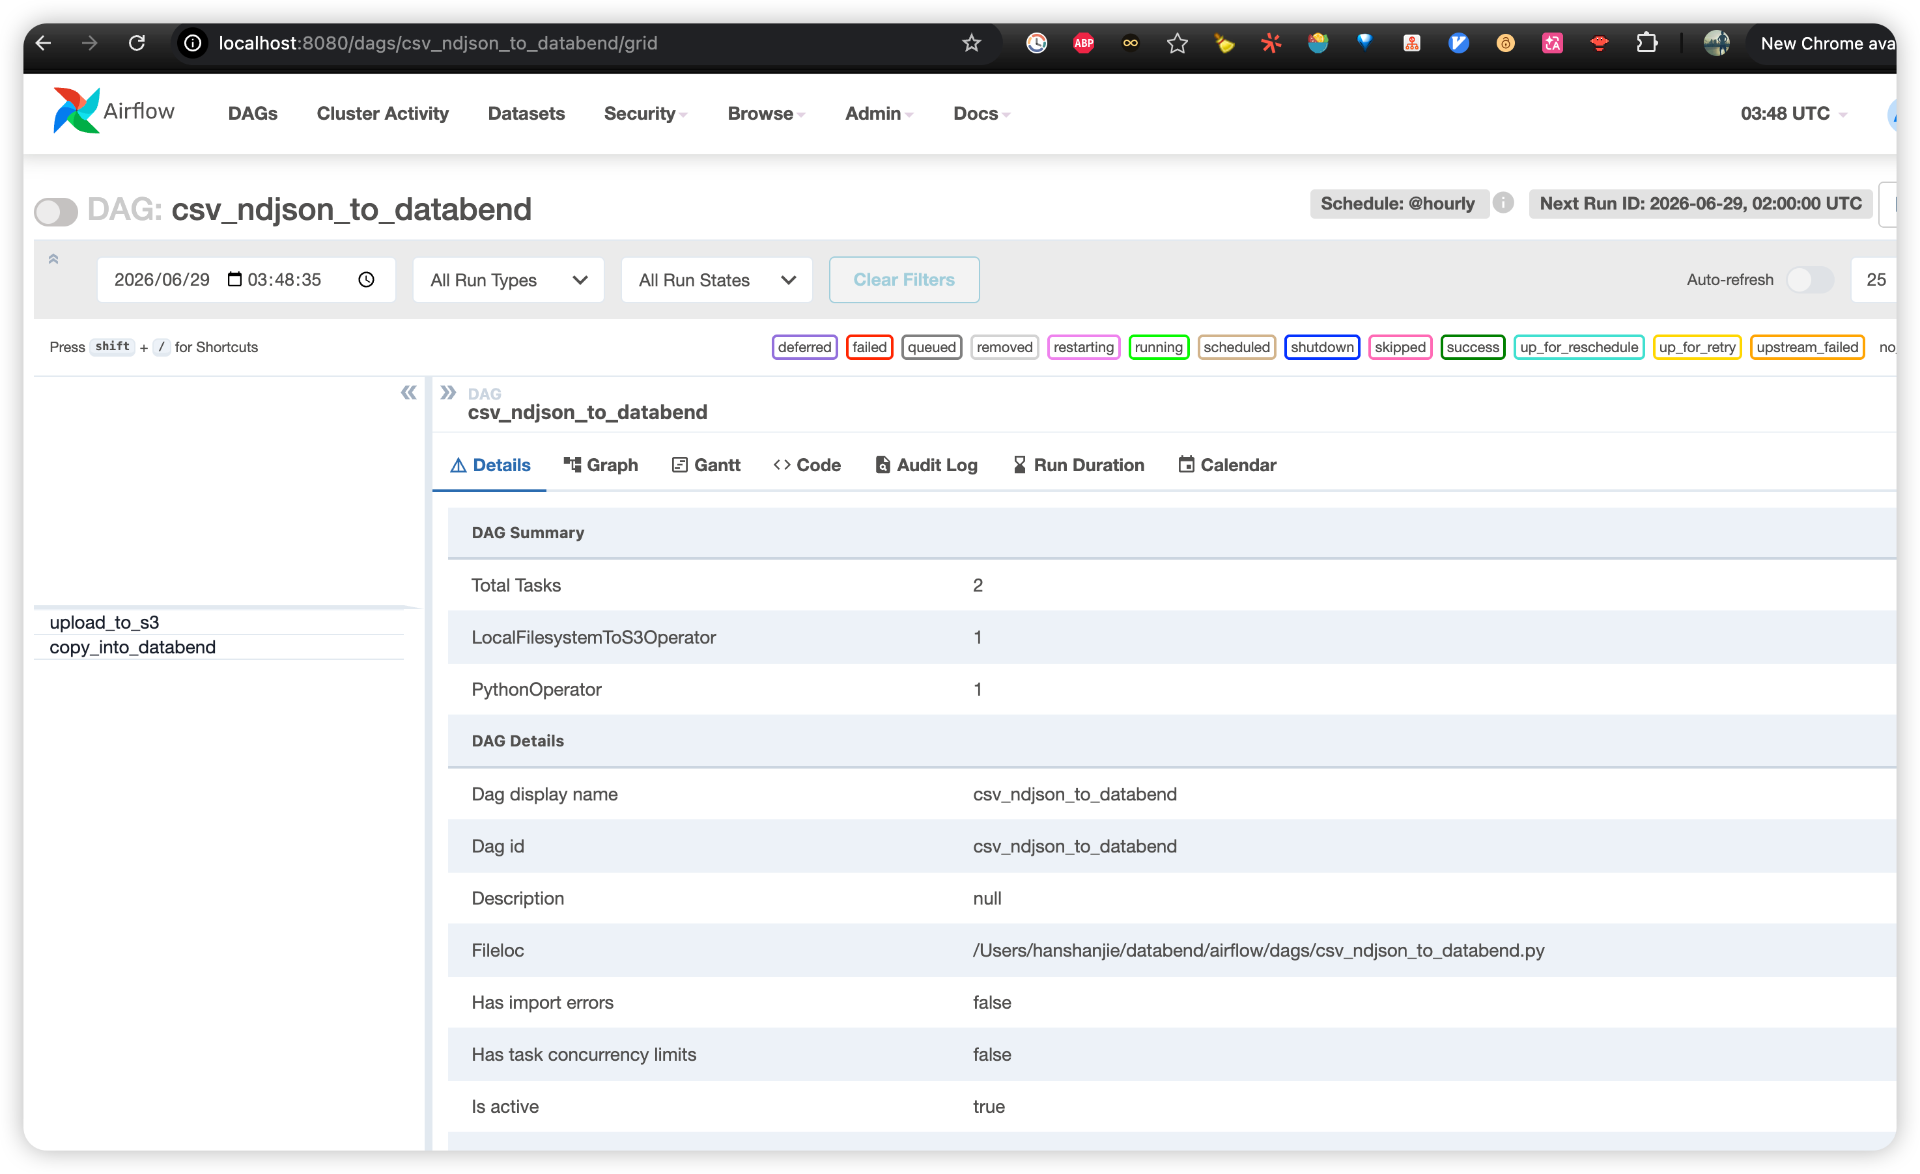
顶部可调参数
LOCAL_FILE_PATH = "/Users/hanshanjie/databend/airflow/data/sample.ndjson"  # 待导入的本地文件
S3_KEY = "ingest/sample.ndjson"   # S3 暂存路径(桶内 key)
TARGET_TABLE = "airflow_demo"     # Databend 目标表
FILE_FORMAT = "NDJSON"            # 或 CSV
这些参数集中放在文件顶部,便于后续替换数据源、目标表或文件格式。
第二个任务:执行 COPY INTO
核心逻辑在 copy_into_databend 函数中:
def copy_into_databend(**context) -> None:
    """对 Databend Cloud 执行 COPY INTO,从 S3 拉取暂存文件入表。"""
    from databend_driver import BlockingDatabendClient

    dsn = Variable.get("databend_dsn")
    bucket = Variable.get("s3_bucket")
    aws_key = Variable.get("aws_access_key_id")
    aws_secret = Variable.get("aws_secret_access_key")

    if FILE_FORMAT.upper() == "CSV":
        file_format_clause = (
            "FILE_FORMAT = (TYPE = CSV SKIP_HEADER = 1 FIELD_DELIMITER = ',')"
        )
    else:
        file_format_clause = "FILE_FORMAT = (TYPE = NDJSON)"

    copy_sql = f"""
        COPY INTO {TARGET_TABLE}
        FROM 's3://{bucket}/{S3_KEY}'
        CONNECTION = (
            ACCESS_KEY_ID = '{aws_key}'
            SECRET_ACCESS_KEY = '{aws_secret}'
        )
        {file_format_clause}
        PURGE = FALSE
        ON_ERROR = ABORT
    """

    client = BlockingDatabendClient(dsn)
    conn = client.get_conn()
    rows = conn.exec(copy_sql)
    print(f"COPY INTO 完成,受影响行数返回:{rows}")
这里有几个值得注意的点:
- 凭证和配置都从 Airflow Variable 中读取,不写死在代码里。
- 根据
FILE_FORMAT动态生成FILE_FORMAT子句,便于在 CSV 和 NDJSON 之间切换。 PURGE = FALSE表示导入完成后不删除 S3 源文件,方便回溯、审计和重导。ON_ERROR = ABORT表示遇到坏数据立即中止,避免静默吞掉错误。databend-driver的 import 放在函数内部,可以避免 Airflow 在解析 DAG 时加载重依赖,减轻 Scheduler 负担。
组装 DAG
with DAG(
    dag_id="csv_ndjson_to_databend",
    schedule="@hourly",                       # 定时批量;按需改 cron
    start_date=pendulum.datetime(2024, 1, 1, tz="UTC"),
    catchup=False,
    max_active_runs=1,
    tags=["databend", "s3", "ingest"],
) as dag:

    upload_to_s3 = LocalFilesystemToS3Operator(
        task_id="upload_to_s3",
        filename=LOCAL_FILE_PATH,
        dest_key=S3_KEY,
        dest_bucket="{{ var.value.s3_bucket }}",
        aws_conn_id="aws_default",
        replace=True,
    )

    copy_task = PythonOperator(
        task_id="copy_into_databend",
        python_callable=copy_into_databend,
    )

    upload_to_s3 >> copy_task
几个配置决定了这条链路的运行方式:
schedule="@hourly":每小时运行一次,可以替换成任意 cron 表达式。catchup=False:不补跑历史时间窗口,只从当前开始调度。max_active_runs=1:同一时间只允许一个 DAG 实例运行,避免并发导入冲突。dest_bucket="{{ var.value.s3_bucket }}":使用 Jinja 模板在运行时读取 Airflow Variable。upload_to_s3 >> copy_task:明确依赖关系,只有上传成功后才会执行导入。
配置 Airflow 连接与变量
DAG 运行前,需要在 Airflow Web UI 中配置连接和变量。
Connection
进入 Admin -> Connections,创建:
aws_default—— S3 上传用的 AWS 凭证(Access Key / Secret Key)。LocalFilesystemToS3Operator就靠它把本地文件传上 S3。
Variable
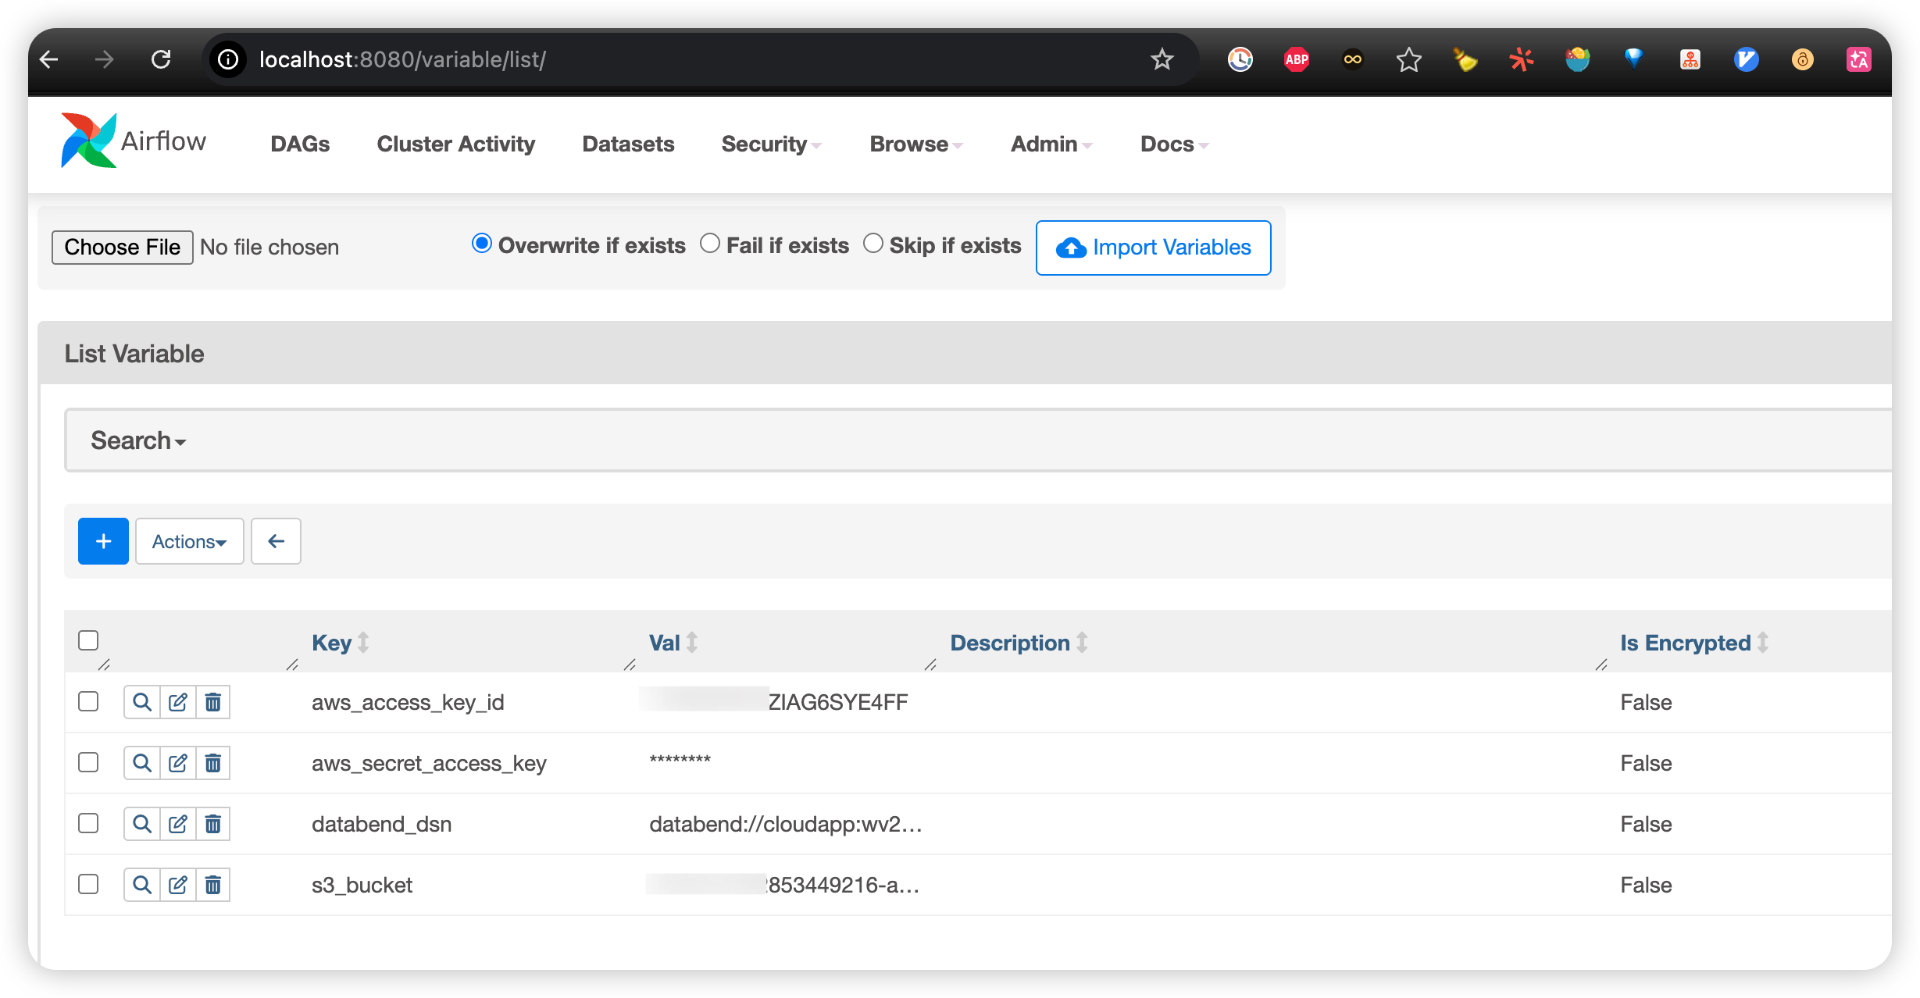
进入 Admin -> Variables,创建以下变量:
s3_bucket:暂存桶名,例如my-ingest-bucket;databend_dsn:Databend Cloud 连接串;aws_access_key_id/aws_secret_access_key:演示版本中供 Databend 读取 S3 使用。
databend_dsn 可以从 Databend Cloud 控制台的 Connect 页面获取,格式类似:
databend://<user>:<password>@<host>:443/<database>?sslmode=enable&warehouse=<wh>
配置完成后,Variables 列表大致如下:
运行 DAG 并验证入仓结果
一切就绪后,在 Airflow UI 的 DAG 列表中找到 csv_ndjson_to_databend:
- 打开 DAG 右上角开关,让它进入可调度状态。
- 点击右侧的 Trigger DAG,手动触发一次。
- 进入 Grid / Graph 视图,确认
upload_to_s3先成功,随后copy_into_databend成功。 - 打开
copy_into_databend日志,查看COPY INTO 完成的输出。
回到 Databend Cloud Worksheet,查询目标表:
SELECT * FROM airflow_demo;
三行数据如期落表:
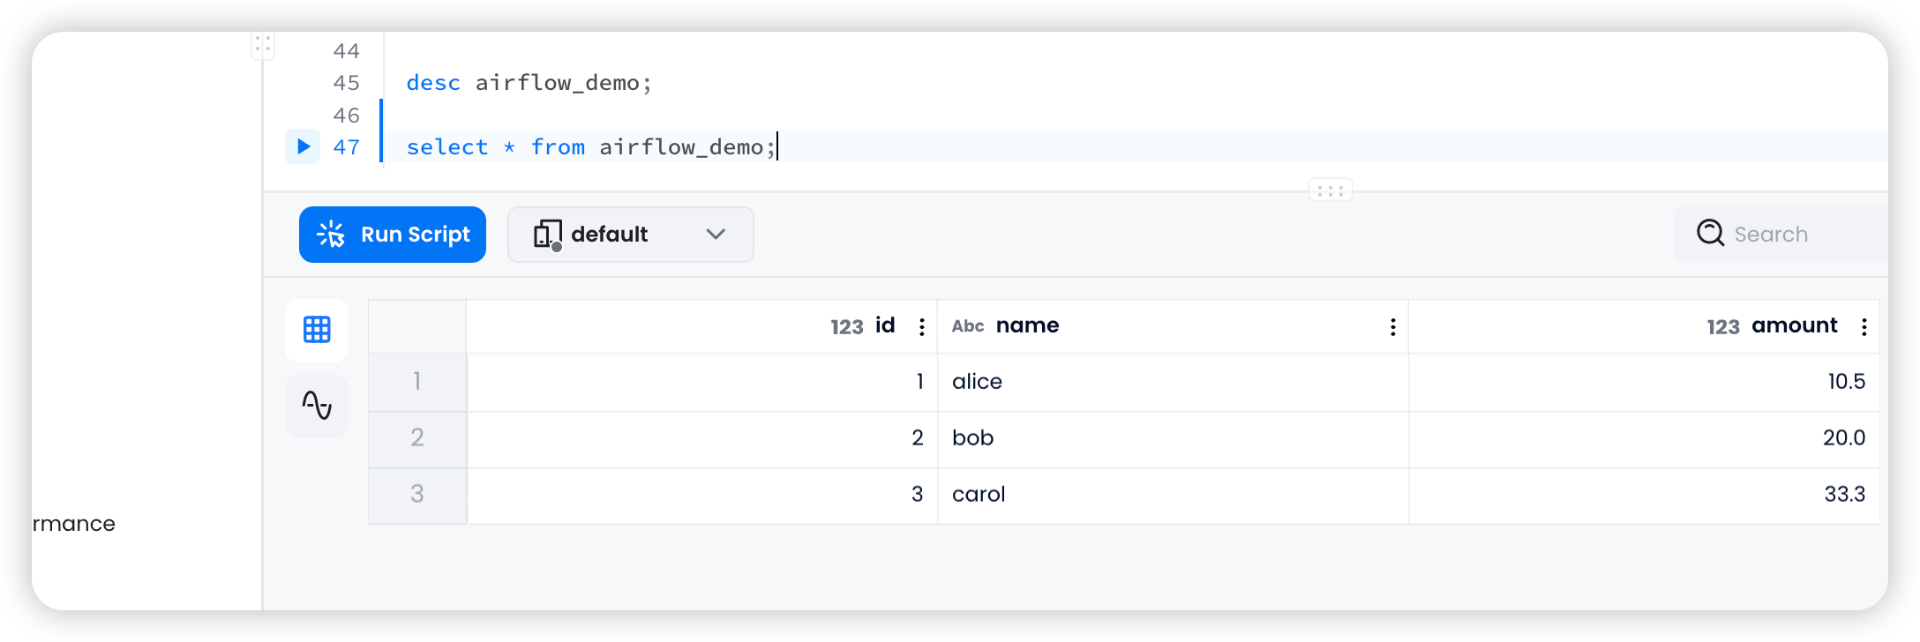
到这里,整条链路已经跑通:本地文件 → S3 暂存 → Databend Cloud 入表,全程由 Airflow 一手编排。
生产环境加固建议
这个示例为了演示,把凭证直接放进了 Variable、把 AWS key 拼进了 SQL。真正上生产前,建议做这几处加固:
- 凭证别明文存 Variable。改用 Airflow 的 Secrets Backend(如 AWS Secrets Manager、HashiCorp Vault),凭证集中托管、自动轮转。
- 别把 AWS key 拼进
COPY INTO的 SQL。在 Databend Cloud 侧预先创建CONNECTION对象,DAG 里只引用连接名,凭证不出 Databend。 - 用唯一的 S3 key。如果文件名固定、内容会被覆盖,要确认
COPY INTO的去重行为符合预期。更稳妥的做法是每批数据用带时间戳的唯一 key(如ingest/2026-06-29/sample.ndjson),既保证幂等,又留下清晰的数据血缘。 - 加重试和告警。给 Task 配置
retries、retry_delay,再接上失败回调(邮件、Slack),让失败能被及时发现。
总结:从示例链路走向云原生入仓实践
这篇文章用一个最小例子串起了 Airflow、S3 和 Databend Cloud:
- Airflow 负责调度、依赖、重试和可观测性;
- S3 作为原始数据暂存层,保留可回溯的数据副本;
- Databend Cloud 通过
COPY INTO直接从对象存储加载数据,并提供后续 SQL 查询和分析能力。
这条链路的价值不只在于“把文件导入表里”,而在于给数据团队提供一个更云原生的数据入仓骨架:对象存储承接原始数据,Airflow 管理跨系统编排,Databend Cloud 负责低运维、高性能的入仓和分析。
从这个骨架出发,可以继续扩展到更真实的数据工程场景:日志分析、事件数据入仓、半结构化 JSON 处理、实时增量聚合,以及面向 AI / Agent workload 的 trace 数据分析。
对于希望降低传统云数仓运维和成本压力,同时保留对象存储开放性和数据可回溯性的团队来说,这是一条轻量、清晰、可演进的数据入仓路径。
完整启动脚本和 DAG 代码可参考 GitHub 仓库:databendcloud/airflow-demo。
 17万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


