Databend 向量索引:加速 AI 应用的数据引擎

Java实战:Databend向量索引加速AI应用 本文介绍了在Java中利用Databend向量索引加速AI应用的方法,主要包括:1. 通过向量化查询、近似最近邻搜索和批量插入优化数据处理性能;2. 结合传统SQL与向量搜索实现混合查询;3. 使用不同索引类型进行性能对比测试;4. 实现向量聚合分析、动态索引调整和并行扫描等高级功能。同时介绍了华为开发者空间与DeepSeek、Dify的集成方案,以及向量化执行在数值计算、图像处理等领域的应用实例。最后概述了Java性能分析工具的使用方法,重点讲解了Intel VTune Profiler在CPU热点、内存 阅读详情

上周六,Databend Meetup·北京站圆满举办。本次线下活动聚焦“迈向 AI 驱动的数据平台”,汇聚了国内数据库领域多位一线专家,以及来自各行各业的技术负责人、DBA、开发与运维工程师,围绕“AI Ready 数据平台”的主题,共同探讨了大模型时代数据库和数据平台的创新演进与实战应用。

Databend 数据库研发工程师白珅以《Databend 向量索引:加速 AI 应用的数据引擎》为主题,系统梳理了向量数据、向量检索与索引技术在 Databend 平台上的最新实践与技术挑战,并以具体案例直观展示了产品在 AI 时代的能力进展与不足。

Databend 数据库研发工程师白珅

近年来,随着 AI 和大模型技术的发展,向量数据在各个领域的应用日益广泛。如何高效地存储、索引和查询向量数据,已成为一个重要的挑战。

Databend 作为一款云原生的 OLAP 数据库,也在积极拥抱向量数据。本文重点介绍 Databend 最近开发的向量数据类型和向量分析技术,帮助用户深入了解 Databend 在向量数据处理方面的能力。

一、向量索引的实践与性能优化
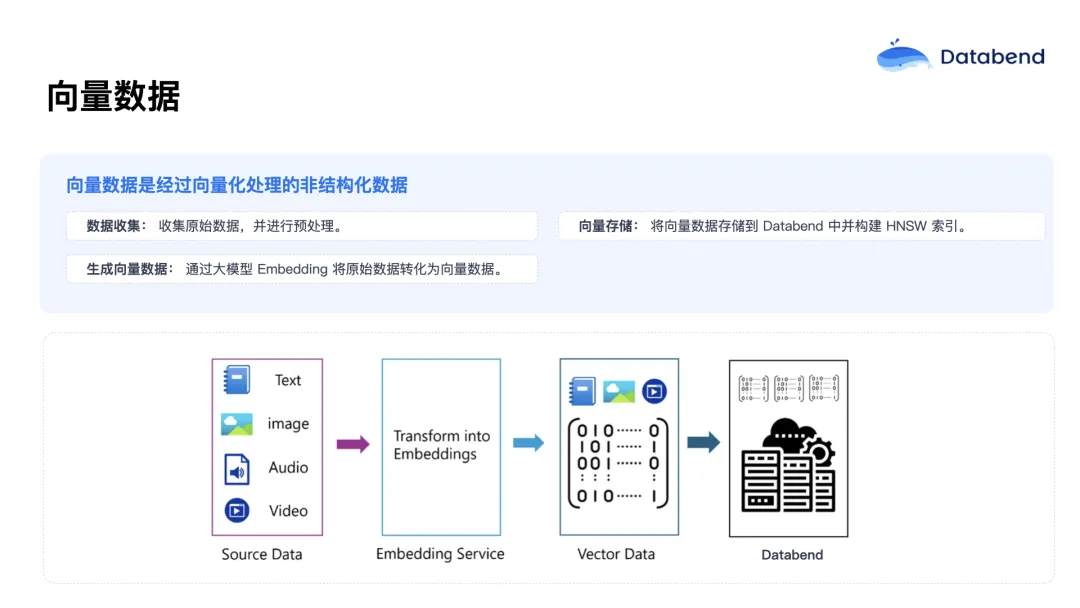
向量数据是将非结构化数据经过 embedding 向量化处理后得到的一种数据。非结构化数据包括图像、视频、文本、音频等,这些数据不像传统表格数据那样规整,而是以更加自由、多样化的形式存在,蕴含着巨大的价值。例如,通过分析用户的浏览记录和购买行为,我们可以构建更为精准的推荐系统。

为了将这些非结构化数据转化为计算机可处理的形式,通常需要使用大模型对数据进行处理,将其转换为数字化的向量。这些向量能够捕捉原始数据的各个维度信息,为后续分析和应用奠定基础。然而,传统数据库主要针对结构化数据设计,对于向量数据的处理能力有限,无法高效地存储和索引。为满足新需求,越来越多的数据库开始支持向量数据,并通过索引技术加速相关查询。Databend 同样支持向量数据,能够实现高性能的检索。
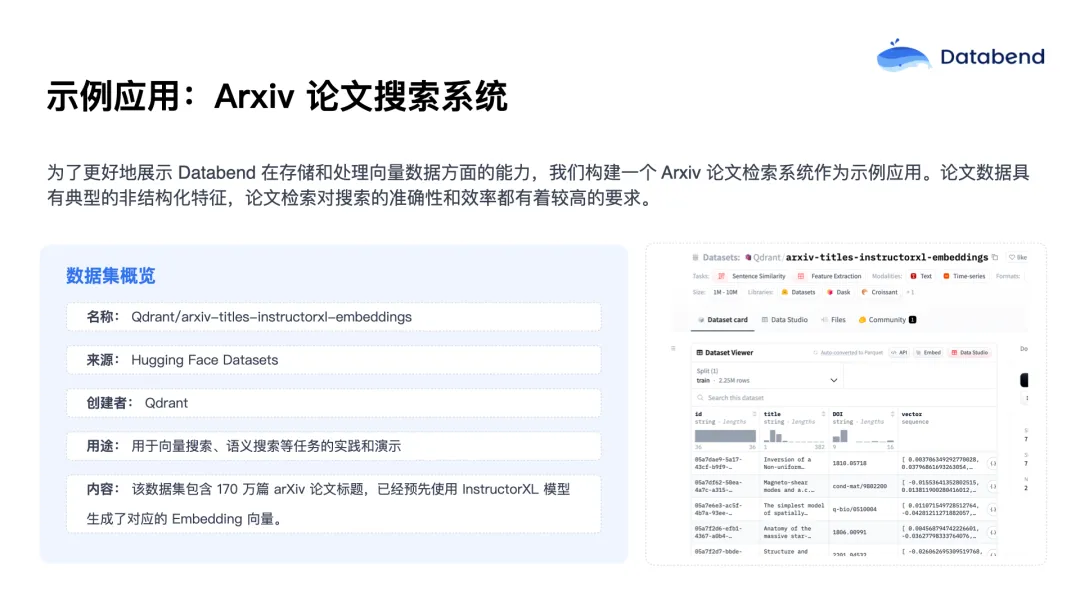
下面通过一个 Arxiv 论文检索系统的示例应用,展示 Databend 在向量数据存储和处理方面的能力。之所以选择论文检索系统,是因为其数据具备典型的非结构化特征,论文的标题和摘要都是文本,需要经过 embedding 技术转换成向量数据。同时,论文检索对搜索的准确性和效率要求很高,能够充分体现向量索引技术的优势。

这里选用了一个公开的数据集——托管在 Hugging Face Datasets 的 arxiv-titles-instructorxl-embeddings 数据集,包含 170 多万篇论文的标题,并已通过训练生成了对应的向量,可直接用于存储和查询,无需额外 embedding 处理。这让我们可以更专注于向量数据存储和检索能力的展示。

构建该搜索系统主要分三步:

第一步、表结构设计。 得益于 Databend 原生支持向量类型,我们可以直接将向量数据定义为 vector 字段,同时增加如 ID、title 等描述性字段,以提升数据可观测性。此外,还需要选择合适的索引类型,并通过参数调优优化性能。
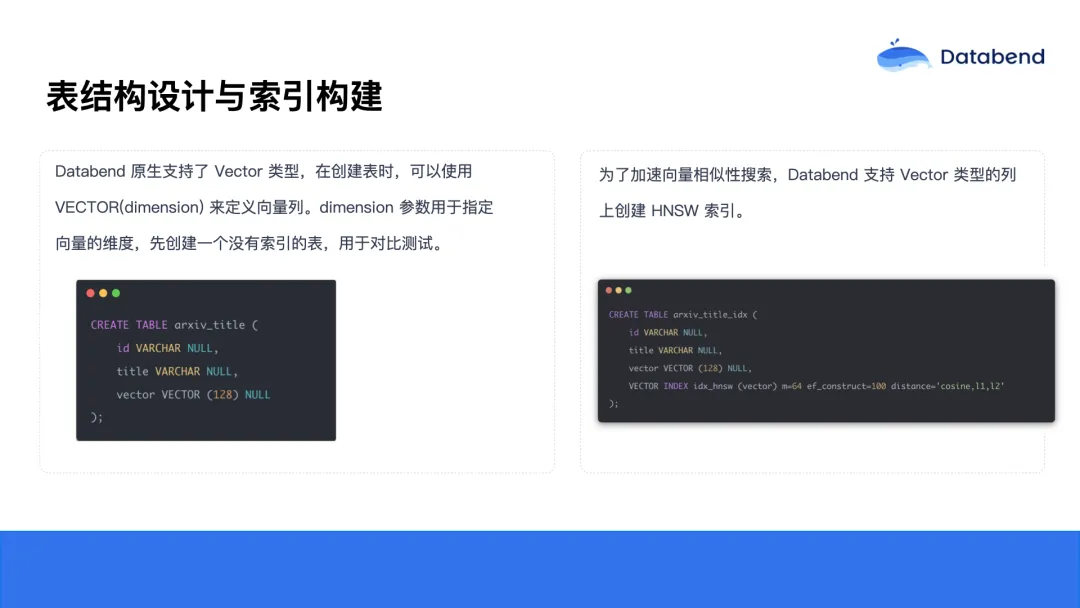
在表结构设计中,我们首先定义了一个 arxiv_titles 的表,用于存储论文标题及对应向量数据,字段主要包括 ID、title 和 vector(向量),vector 是 128 维。这个表是用于测试的,未加索引,主要用于对比。

第二个表是 arxiv_titles_idx。结构与第一个表类似,但增加了向量索引,并设置了如 M、ef_construct 等参数,具体含义后面会详细说明。

第二步、数据导入。 由于我们已经有了预先 embedding 好的向量数据,因此可以直接批量导入。 Databend 支持多种导入方式,包括 COPY INTO、INSERT 等语法。

数据导入流程如下:首先创建一个 stage。Databend 中的 可以理解为数据存放区,既可以是本地文件系统,也可以是像 S3 这样的云平台,或者这里用到的 Hugging Face。通过 stage,能够高效地将外部数据读取到 Databend 中,非常适合大规模数据集。

创建好 stage 后,可以通过 INSERT 和 SELECT 语句,将 stage 中的 Parquet 文件读取出来,再分别导入到两个表中。

第三步、实现相似度搜索和应用。 用户查询词会先转换为向量,然后利用 Databend 的向量索引大幅缩短查询时间,最终将查询结果与上层应用结合起来。

首先需要创建一个 UDF(用户自定义函数)。Databend 的 UDF 允许用户自定义,像使用内置函数一样,在 SQL 中扩展所需功能。由于Databend本身还未内置 embedding 的函数,因此我们自定义了一个 ai_embed_128 的 UDF,实现将文本转化为128维向量,具体实现调用了外部的 embedding 服务。

接下来就是核心的查询语句。我们使用 SELECT 语句在arxiv_titles 表中查询相关数据,通过 cosine 函数计算向量与用户查询词之间的距离并排序,最终返回最接近的五条记录。

下面是在 Databend Cloud 中的演示效果:

 测试结果中,未加索引的表在查询时通常耗时都在一秒以上,大约 1.3s 左右。而加了索引后是 200ms,差距为 6 倍。此外,我们还对写入性能进行了测试。由于加索引会同步写入索引数据,写入耗时也有所增加:无索引时写入约需20秒,带索引时则增加到120秒。尽管写入速度变慢,但在实际业务中,查询的频率通常远高于写入,因此这一牺牲是可以接受的。

二、向量数据类型介绍

为什么需要向量?

由于计算机只能理解数字,而人类交流主要依赖于文本、图像、音频等丰富的信息,这些数据存在大量歧义和复杂的上下文。如果没有合适的向量类型,计算机很难理解和处理这些非结构化数据。向量数据正好充当了桥梁,把人类复杂的信息转化为计算机能够处理的数字空间,从而让机器能够“理解”人类的信息。

使用向量主要有两个主要优势:

  • 第一,向量能够对语义进行压缩。例如,文本信息经过向量化后可以转换为固定长度的向量。以图中示例为例,像 cat、kitty、dog、house 这些词汇都可以通过向量处理变成七维向量,去除原始数据中的冗余信息,仅保留关键特征。
  • 第二,向量化之后,数据之间的关系可以用数学方法进行量化。我们可以通过向量之间的距离来判断相似性。例如,在示意图中,cat 和 kitty 的距离比 dog 要近,这反映了语义上的接近性。此外,像 man 和 woman、king 和 queen 这两组词,其向量间的距离也类似,说明它们在语义空间中具有一定的对应关系。

前面我们介绍了距离的计算方式。实际应用中,常见的距离函数有三种:余弦距离(cosine)、L1 距离和 L2 距离。三者的主要区别在于计算公式不同,适用场景也有差异。一般来说,如果数据是高维且稀疏,并且只关注向量的方向,则适合用余弦函数;如果数据稠密,只需要计算向量的直线距离,L2 距离更合适;若数据中包含较多异常值、各维度差异较大,则 L1 距离更为合适。实际应用中,可根据具体场景进行选择和调优。

三、向量索引原理:HNSW 算法详解

随着 AI 技术普及和各类 AI 应用涌现,向量数据量呈现爆发式增长。在海量数据中做相似性搜索,如果不使用索引,只能进行暴力搜索——即对每一条向量都计算一次距离,这种方式效率极低、计算复杂度高,耗时严重。数据量越大,查询时间可能达到几秒甚至十几秒。

许多实际场景如推荐系统、图像搜索等对响应时间有极高要求,需要毫秒级的实时反馈,暴力搜索显然无法满足需求。使用索引则能大幅提升检索效率。例如,Spotify 开源的向量搜索库 Voyager,用于音乐推荐系统后,检索性能提升了 10 倍,同时内存消耗减少了4倍,充分说明向量索引在实际中的巨大价值。

HNSW,全称“Hierarchical Navigable Small World graph ” (分层可导航小世界图),源自 2016 年的一篇论文。这一算法已成为向量检索领域的核心参考,大多数主流向量索引实现都基于此论文。如果大家感兴趣,可以在 arXiv 等网站上查阅原文。

HNSW 主要包含两项关键技术:

第一,NSW(Navigable Small World) ,即小世界图结构,每个数据点是一个节点,节点之间通过边相连,形成可导航的网络。查询时,可以从任意节点出发,沿着最短路径逐步靠近目标。例如,从点a出发,比较其相邻点b和d与目标的距离,选择更近的d,然后继续比较d的邻居,依次前进,最终找到最接近目标的点。

第二项技术是跳表(Skip List) ,引入了分层结构。最底层包含所有原始数据,越往上每层包含的数据越少,最顶层仅有极少数抽样节点。检索时,从顶层开始,逐层向下缩小范围,大幅减少搜索路径。比如在查找 20 这个数时,从第三层仅需遍历 3 个节点,而若从最底层遍历则要经过 6 个节点,分层结构显著提升了检索效率。 

HNSW 融合了这两种技术的优点,通过多层的小世界图,每一层都是一个独立的 NSW 结构。搜索时从顶层开始,快速筛选最接近的节点,然后逐层下降,最终定位到最优解。这一机制保证了极高的检索性能。

HNSW 中有几个重要参数:

  • M: 表示每层中每个节点允许的最大连接数,M 越大邻居越多,连通性越好,能加快检索速度,但同时会增加内存消耗和索引构建时间;
  • ef_construct: 主要控制索引构建过程中搜索范围,值越大检索效果越好,但构建时间也会相应增长;
  • distance: 即距离计算函数(如cosine、L1、L2等),可以按需选择和构建,减少不必要的计算。实际应用中,这些参数需根据具体数据和场景调优,以实现最佳效果。

接下来介绍一项关键的向量压缩技术——向量量化。向量量化的主要目的是对原始向量数据进行压缩。因为在索引和检索的过程中,需要频繁计算查询向量与原始向量之间的距离。如果每次都读取全部原始数据,将导致数据读取量过大,影响查询效率。为了减少数据体积、提升检索速度,我们通常会对原始向量进行量化压缩处理。

常用的量化方法有两种。

第一种是标量量化(Scalar Quantization)。其原理是将原始向量数据从 float32 类型转换为 int8 类型。由于 float32 占用 4 个字节,而 int8 只占 1 个字节,因此经过这种转换后,数据体积可以缩小 4 倍。

第二种是乘积量化(Product Quantization)。这种方法是将一个高维的向量拆分成多个低维子向量,对每个子向量分块后,取其聚类中心的平均值,再由这些均值组成新的紧凑向量。这样不仅可以极大地压缩数据体积(子块数目可以根据需求灵活调整),也能显著减少内存占用。但与此同时,数据压缩后不可避免地会引入一定误差。

向量索引可以对大规模向量数据进行预处理,构建高效的检索结构,从而大幅加速搜索过程。当然,向量索引并非万能,也有一些局限,因此在实际应用中需要充分理解其优缺点,合理选型。

其主要优点有两个。第一是查询速度极快,相较于暴力查询,向量索引通常能够将检索速度提升数个数量级,实现近乎实时的相似性搜索。正因为有了高性能的索引技术,才使得诸如推荐系统、视频和图像检索等智能应用成为可能。

但向量索引也存在一些缺点。首先,使用索引会增加数据写入时的延迟。因为每写入一条新数据,都需要同时更新索引结构,这会导致写入操作耗时变长。其次,索引和量化压缩等技术会引入一定的检索误差,导致最终结果不完全精确。但这种误差通常在可控范围内,可以通过合理选择参数进行调优。

四、总结与展望

目前业界已经有多种专门面向向量检索的数据库产品,例如 Qdrant、Milvus、Lancedb 等。这类数据库的优势是生态成熟、工具完善、针对相似性搜索做了专门优化。但其不足也比较明显:第一,易形成数据孤岛,难以与业务数据关联分析;第二,功能较为单一,无法支持更复杂的数据分析场景;第三,架构封闭,难以充分利用云原生平台的弹性和资源优化能力。此外,部署独立的向量数据库通常还需要额外的运维成本。

Databend 作为云原生 OLAP 数据库,在原生支持向量数据类型后,可以为需要融合结构化和向量数据分析的场景,提供更强大的能力。用户可以通过标准 SQL 语句进行向量数据的查询和搜索,充分利用 Databend 自带的弹性扩缩架构优势,无需单独部署和运维向量数据库,极大降低了整体运维成本。同时,向量数据也可以与其他业务数据融合分析,助力更多创新应用的落地。当然,目前 Databend 在向量方面的功能和生态还不如专业向量数据库丰富,工具链也有待完善。

Databend 现阶段已经具备了原生向量数据类型的支持,提供了基本的向量函数和 HNSW 索引。未来将不断完善功能,持续提升索引的性能与稳定性,丰富应用场景,开发更多与向量数据相关的工具,优化文档体验,方便广大用户使用。

目前 Databend 向量索引功能已经上线 Databend Cloud,感兴趣的朋友可以点击阅读原文试用体验!

关于 Databend

Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式湖仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。

👨‍💻‍ Databend Cloud:databend.cn

📖 Databend 文档:docs.databend.cn

💻 Wechat:Databend

✨ GitHub:github.com/databendlab…

5张图,搞懂三方支付机构的“备付金账户”体系 本文将详细解析第三方支付机构各类备付金账户的功能定位、所承载的支付业务处理流程以及日常管理。 阅读详情

相关推荐

华为开发岗暑期实习笔试(2025年4月16日)

第一题怀疑测试样例不完整,贪心法不应该能够解决该题。第二题使用0-1BFS解决单源最短路径的问题,往往搭配双端队列实现。第三题是运用动态规划解决最大不重叠子区间个数的问题,难点在于满足3重判断规则,所需数据结构及相关操作较多。

csy031117的博客 3661

软件工程实践范式的解构与重构 ——《软件工程实务》学习的全维度进阶之路

本文回顾《软件工程实务》课程学习历程,阐述从对软件开发的片面认知到构建完整框架认知的转变,分享团队协作中应对沟通问题的经验,强调质量保障与测试的重要性及要点,表达持续学习决心与未来应用所学开发高质量软件的展望。

QiXiangGuanHai的博客 522

深入解析TI C2000 ePWM模块:峰值电流模式Buck与LLC谐振变换器实战配置

脉宽调制(PWM)技术是电力电子与数字电源控制的核心,它通过调节开关信号的占空比或频率,实现对功率变换器输出电压、电流的精确控制。其基本原理是利用微控制器内部的定时器和比较器,生成具有特定时序的方波信号,驱动功率开关器件。这项技术的核心价值在于将复杂的模拟控制环路数字化,从而提升系统的可控性、灵活性和可靠性。在电机驱动、不间断电源(UPS)、服务器电源和新能源逆变器等广泛应用场景中,PWM技术都是实现高效能量转换的基石。本文聚焦于德州仪器(TI)C2000系列微控制器中功能强大的增强型PWM(ePWM)模块

weixin_30410119的博客 341

揭秘 Databend 向量索引,加速 AI 应⽤的数据引擎

由于计算机只能理解数字,而人类交流主要依赖于文本、图像、音频等丰富的信息,这些数据存在大量歧义和复杂的上下文。如果没有合适的向量类型,计算机很难理解和处理这些非结构化数据。向量数据正好充当了桥梁,把人类复杂的信息转化为计算机能够处理的数字空间,从而让机器能够“理解”人类的信息。第一,向量能够对语义进行压缩。例如,文本信息经过向量化后可以转换为固定长度的向量。以图中示例为例,像 cat、kitty、dog、house 这些词汇都可以通过向量处理变成七维向量,去除原始数据中的冗余信息,仅保留关键特征。

Databend的博客 1054

PyQt5混搭qfluentwidgets实战:用FramelessWindow快速打造现代化界面

本文详细介绍了如何将PyQt5与qfluentwidgets组件库结合,利用FramelessWindow快速打造现代化无边框界面。通过环境配置、核心特性解析、组件混用技巧及高级样式定制,帮助开发者提升桌面应用的用户体验和美观度,特别适合需要现代UI设计的Python开发者。

sugar的博客 969

告别代码丢失!用Git+Gitee管理你的Keil5单片机项目(保姆级图文教程)

本文详细介绍了如何利用Git和Gitee高效管理Keil5单片机项目,解决嵌入式开发中的代码丢失问题。通过精准配置.gitignore文件、设计适合团队的协作流程以及搭建安全备份体系,开发者可以轻松实现版本控制,提升工作效率。特别针对Keil工程的特殊文件类型,提供了实用的过滤规则和操作技巧。

weixin_33686714的博客 470

AI编程会让程序员和软件定制企业消失吗?

上一篇文章我分享了我在0编程基础下用了哪些AI能帮助我开发软件系统,在使用AI帮我开发软件的时候,也给了我不少对互联网职业与行业的一些思考,特别是我也算是在互联网领域从业了快20年,在软件定制开发公司待过,也在互联网产品公司待过,所以今天分享一些我对未来互联网职业和企业的一些看法。我把我用AI开发出来的软件给一些程序员朋友看了之后,他们都笑了笑说谢谢你让我死心了...

鼓狮知识库的博客 736

海思HiMPP开发避坑指南:MMZ内存与系统内存傻傻分不清?一个例子讲透

本文深入解析海思HiMPP开发中MMZ内存与系统内存的关键差异与应用场景,帮助开发者避免常见的内存混淆问题。通过实际案例和性能对比,详细介绍了MMZ内存的特性和优化策略,提升多媒体处理效率。

weixin_30772105的博客 467

DeepSeek 云原生分布式部署的深度实践与疑难解析—— 从零到生产级落地的全链路避坑指南

云原生环境下 DeepSeek 的部署既是技术挑战,更是工程艺术的体现。本文从架构设计、性能调优到安全防护,构建了完整的解决方案体系。建议读者结合自身环境特点,灵活运用文中提供的调试命令与配置模板,同时持续关注 DeepSeek 社区的最新动态。

Yi_An_Jie的博客 2933

CANape快速上手

文章帮助记录CANape学习过程。

小弱鸡的博客 1万+

ZYNQ GP总线实现PS与PL交互

3,完成 ZYNQ7 Processing System 的配置更改后,回到 Diagram 界面中,可以看到新出现了名为 M_AXI_GP0_ACLK、M_AXI_GP0 和 FCLK_CLK0 的接口,下面我们要对这些接口进行连接或引出。此处的偏移量,AXI的相邻寄存器偏移量相差4个字节,默认slv_reg0的偏移量是0,可以推导出slv_reg1,slv_reg2的偏移量分别为4和8,这里只用到了slv_reg0,所以偏移量为0。当然了,窗口数量的增加,势必会使得单个窗口的采样深度变小。

wangjie36的博客 7094

Java反射机制

与传统编程方式不同,反射使得程序能够在编译期不确定类型和方法的情况下,对类的构造函数、方法、字段等进行操作。//获得指定名称的成员变量,包含私有的。//获得指定名称的成员变量,包含私有的。在运行状态中,在仅知道一个类名时,就可以动态获得类中的信息,创建对象,调用对象成员的机制成为Java反射机制。cla.getDeclaredField("account") ----> 拿去所有的,包括可以获取私有的成员变量。Field类将类的属性进行封装,可以获得属性的基本信息、属性的值,也 可以对属性进行赋值.

xncvo8925的博客 823

使用MATLAB实现PAC2002轮胎模型的TIR文件解析和模型计算详解

PAC2002轮胎模型是由荷兰TNO公司开发的一种半经验的轮胎模型,用于描述轮胎在不同工况下的力学特性。该模型基于一系列物理和经验参数,通过复杂的数学表达式来模拟轮胎的力学行为,包括纵向力、侧向力、回正力矩等。

qq_38334677的博客 2428

迈向 AI 驱动的数据平台新时代 | Databend Meetup·北京站活动回顾

今年的 AI 热潮给数据基础设施带来了巨大变革。大模型及生成式 AI 的落地,让金融、零售、制造、医疗等行业都在加速推进数据平台的智能化升级。与之对应,数据体量和复杂性不断提升,企业对数据库系统的性能、扩展性、多模融合与 AI 支持能力提出了更高要求。

Databend的博客 904

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

构建海量记忆:基于 Databend 的 2C Agent 平台 | 沉浸式翻译 @ Databend meetup 上海站回顾及思考

文章根据沉浸式翻译技专家陈琦在 Databend Meeup 上海站分享总结和思考构建。 通过本次活动也让我初步去理解 AI 长记忆体的实现及用途。 陈琦分享属于一个比较硬核的技术分享,所以在回顾这个 PPT 时,我在陈琦分享的思路的基础上长了一些案例,来帮助读者更容易理解这个实践。沉浸式翻译(Immersive Translate),作为 AI 翻译领域的头部产品,拥有近千万用户。在 Databend Meeup 上海站沉浸式翻译团队透露他们启起阶段是自我搭建一个HTAP库用于承接业务及数据分析,但面临运

Databend的博客 715

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

在 AWS 中国峰会逛了一天,我在 Databend 展台看到了 Agent 数据基础设施的新思路

今年 AWS 中国峰会逛下来最大的感受是,大家已经不太讨论模型参数、排行榜或者谁家的模型更聪明了。无论是 Keynote 还是展区交流,讨论最多的话题其实是 Agent 如何真正进入生产环境。

Databend的博客 416

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

SaaS 出海:Databend Cloud 的定位与实践

提到 “SaaS 出海”这个词大家肯定并不陌生,SaaS 企业将业务拓展到海外市场已经成为许多 SaaS 公司的重要战略方向。随着企业对于灵活性、可扩展性以及成本效益需求的不断增长, SaaS 模式提供了理想的解决方案。对于寻求出海机会的 SaaS 企业来说,全球化市场的巨大潜力尤为吸引人。在许多地区,尤其是发展中市场, SaaS 服务的普及率还远远没有饱和,这也为企业提供了非常广阔的成长空间。随着全球数字化转型的不断加速, SaaS 服务需求也在持续增长。

Databend的博客 1208

001:一个快速、可嵌入、模块化的分析查询引擎

通过插件开发,我们能够极大地释放Typora的潜力,使其从一个优秀的Markdown编辑器进化为一个高度定制化的“写作操作系统”。回顾核心要点:从环境搭建、API学习到实战开发与性能优化。未来可能性:AI辅助写作集成、云同步插件、多人在线协作编辑等。行动号召:鼓励读者从一个小需求开始,动手开发自己的第一个Typora插件,共同丰富Markdown写作的工具生态。

336

分享一些实用的PHP函数(对比js/ts实现)

php通过count方法来获取数组的长度,而js/ts则可以直接通过length来获取数组的长度。php的filter方法名叫,而js/ts则是叫filter。与all的总结一致。php的获取绝对值的方法名叫abs,而js/ts则是从Math对象中获取,即Math.abs。php可以直接使用array_sum方法求数字数组的和,js/ts需要循环自己计算(或者自己实现一个sum方法)。php的获取最小值和最大值的方法名叫min和max,而js/ts则是从Math对象中获取,即Math.min和。

pantouyuchiyu的博客 1087

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 167

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 316

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 1万+

在Codex 让AI模型 拥有长期智能记忆

本文介绍Claude-Mem V15新功能——智能记忆召回,解决AI遗忘、重复提示、执行不一致等问题。通过本地部署claude-mem,实现自动记录决策(如数据库选型)、跨会话智能召回,支持记忆写入、检索、遗忘全流程闭环。相比传统记忆方案,其基于Hooks自动捕获工具调用,结构化存储,可追溯、可共享、可清理,显著提升工程效率与协作一致性,是长期项目中理想的“工作黑匣子”与“工程脑”。

米莱虾 261

医疗 AI 有两种,别混着谈:一个改流程,一个改范式

InfoXMed 是面向医生、医学生和医学科研人员的 AI 医学工具平台,提供文献检索、全文翻译、AI 解读、指南查询和题库练习等功能,辅助临床学习、科研汇报与医学备考。原文是日本医学会杂志(JMA Journal)的一篇综述(Review Article):基本事实:这一点必须先说清:这篇论文提出的是一个研究纲领。它文中的"预测"指的是科学设想,不是可以拿来用的临床预测能力。文中甚至自己承认了一个硬缺口(见第三节)。本文只谈它的术语辨析与科学方法论,不转述任何可作为临床依据的预测或处置主张。这篇论文的全部

2601_96948740的博客 207

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 226

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 171
上一篇: 迈向 AI 驱动的数据平台新时代 | Databend Meetup·北京站活动回顾
下一篇: SeaTunnel Databend Sink Connector CDC 功能实现详解
Databend
博客等级 码龄5年 1458粉丝 362原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值