Databend 实现高效实时查询:深入解读 Dictionary 功能

开源、云原生且实时分析型的现代数据仓库DataBend的介绍,及其与其它开源文件存储的结合使用实例_databend功能 Databend 是一个开源、云原生且实时分析型的现代数据仓库,旨在提供高效的数据存储和处理能力。它采用 Rust 语言开发,并支持 Apache Arrow 格式以实现高性能列式存储与查询处理。主要特点:云原生设计:Databend 构建在 Kubernetes 之上,具备弹性伸缩、水平扩展的能力,可轻松部署在公有云或私有云环境中。SQL 支持:Databend 具备完善的 SQL 查询功能,兼容 MySQL 协议,使得用户可以利用熟悉的 SQL 语法进行数据查询和处理。性能优化。 阅读详情

作者:洪文丽

开源之夏2024“支持 External Dictionaries”项目参与者

东北大学软件工程专业云计算方向大二在读,喜欢挑战自我,尝试新鲜事物

背景介绍

在大型系统中,数据通常存储在多个不同的数据源中,例如 PostgreSQL、MySQL 和 Redis 负责存储在线数据,而 Databend 和 ClickHouse 则用于存储分析数据。传统的分析查询方法往往需要同时使用到多种不同的数据,通常通过 ETL 过程将数据导入一个系统后进行查询,但这种方式存在以下问题:

  1. 数据变动导致不一致性:

在多源数据系统中,数据可能会在不同的系统中以不同的频率和时间点进行更新。例如,在线数据源如 MySQL 和 Redis 可能会实时更新,而分析系统如 Databend 更新频率较低。这种时间差异可能导致数据不一致,分析结果可能与实际在线数据不符。

  1. 多表 join 操作性能低下:

在传统的 ETL 过程中,将数据从多个源导入到一个分析系统后,进行多表 join 操作时可能会遇到性能瓶颈。大规模的 join 操作需要对多个表进行复杂的匹配和计算,这可能导致查询响应时间变长,特别是在数据量大且 join 操作复杂的情况下。

  1. 数据系统管理复杂度高:

在大型系统中,管理多个数据源意味着需要处理不同的存储和查询机制。例如,MySQL 和 PostgreSQL 需要数据库管理和优化,Redis 需要确保缓存有效性,而 Databend 需要优化分析数据的存储和查询。每种系统都有不同的配置和维护要求,这增加了管理的复杂度和运维成本。数据备份、恢复、监控和性能调优等任务也需要分别在多个系统中进行。

为了解决这些问题,Databend 实现了字典功能。通过集成 MySQL、Redis 等外部数据源,Databend 实现了数据的实时查询与分析,不仅显著提升了查询性能,还确保了数据的一致性,减少了传统 ETL 流程的复杂性,特别适用于需要快速响应的实时分析场景。用户通过字典函数 dict_get 能够直接从外部数据源检索数据,简化了数据管理,并优化了大数据处理的效率。如图所示为字典功能示意图: 
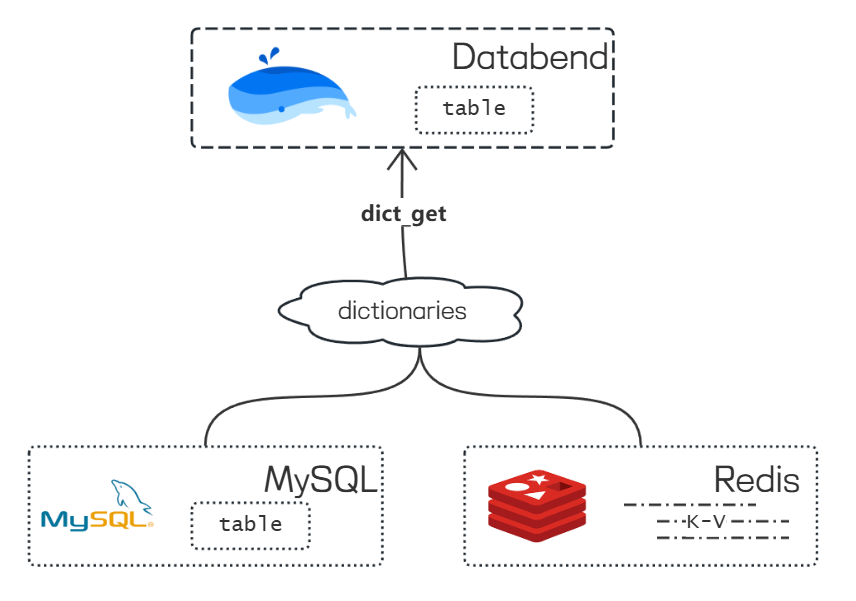
字典功能介绍

2.1 DDL 语法

  1. 基本语法
CREATE OR REPLACE DICTIONARY [db_name].dictionary_name
(
 field1 type1 [DEFAULT expr1],
 field2 type2 [DEFAULT expr2],
 ...
)
PRIMARY KEY primary_key
SOURCE(source_type [source_options]);
  1. 字典的配置参数 PRIMARY KEY:字典的主键,用作查找数据的 key。 SOURCE:字典的数据源类型,如 MySQL、Redis 等。

  2. 数据源配置

    1.   目前支持 MySQL 和 Redis 作为数据源

    2.   MySQL 数据源

    3. host (必填):MySQL 服务器的主机名或 IP 地址。

    4. port (必填):MySQL 服务器的端口号,默认为 3306。

    5. username (必填):用于连接 MySQL 服务器的用户名。

    6. password (必填):用户的密码。

    7. db (必填):要连接的数据库名称。

    8. table (必填):数据库中的具体表名。

    9.   示例配置:

    10. SOURCE(MYSQL(
      host='your_host'
      port='3306'
      username='your_username'
      password='your_password'
      db='your_db'
      table='your_table'
      ))
    11.   Redis数据源

    12. host (必填):Redis 服务器的主机名或 IP 地址。

    13. port (必填):Redis 服务器的端口号,默认为 6379。

    14. username (选填):如果 Redis 服务器设置了用户认证,则提供用户名。

    15. password (选填):用户的密码。

    16. db_index (选填):指定要使用的 Redis 数据库,默认为 0,最大值为 15。

    17.   示例配置:

    18. SOURCE(REDIS(
      host='your_host'
      port='6379'
      username='your_username'
      password='your_password'
      db_index='db_index'
      ))
  3. 字段类型配置

    1. MySql数据源支持:boolean,string,number类型,其中 number 类型涵盖了整型(如 int、bigint)和浮点型(如 float32、float64)。
    2. Redis数据源支持:string类型,用于键值对的简单存储和检索。
    3. 值得注意的是,在 dict_get 函数中,若无法从外部数据源检索到对应的键值,系统会返回用户指定的默认值,或者使用系统的默认值。这一机制确保即使在外部数据源中未找到匹配的键,Databend 依然能够返回合理的结果,从而避免数据缺失对后续操作的影响,提高了系统的鲁棒性和查询的稳定性。

2.2 查询函数语法

Databend 支持使用 dict_get 函数查询字典数据。

dict_get([db_name].dict_name, 'attr_name', key_expr)
  • [db_name].dict_name:外部字典的名称,可能包括数据库名(如果字典存储在特定的数据库中)和字典名。如果当前会话已经选择了一个特定的数据库,那么可以省略数据库名,只提供字典名。
  • 'attr_name':要查询的字典中字段的名称,必须为字符串。
  • key_expr:查询的 key 表达式,与字典中的 PRIMARY KEY 类型相同。

使用示例

假设我们有一个学生成绩管理系统,我们需要存储和查询学生的成绩信息、课程信息等数据。这些信息分别存储在 Databend、MySQL 和 Redis 中。

  • Databend 中有一个学生成绩表

    • CREATE TABLE student_scores (
       student_id INT,
       course_id INT,
       score INT
      );

插入一些测试数据

INSERT INTO student_scores
VALUES (1, 1, 62),(1, 2, 75),(1, 3, 88),(2, 1, 93),
        (2, 2, 54),(2, 3, 99),(3, 1, 67),(3, 2, 80),
        (3, 3, 57),(4, 1, 66),(4, 2, 83),(4, 3, 91); 
  • MySQL 中有一个课程信息表

    • CREATE TABLE courses (
       course_id INT PRIMARY KEY,
       course_name VARCHAR(255),
      );

插入一些测试数据

INSERT INTO courses
VALUES (1, 'math'),(2, 'english'),(3, 'chinese');
  • Redis 中存储了学生的姓名

    • 127.0.0.1:6379> set 1 'Andy'
      127.0.0.1:6379> set 2 'Nancy'
      127.0.0.1:6379> set 3 'Lucy'
      127.0.0.1:6379> set 4 'Jack'

在 Databend 中创建字典

CREATE DICTIONARY courses_dict
(
    course_id INT,
    course_name STRING
)
PRIMARY KEY course_id
SOURCE(MYSQL(
    host='localhost'
    port='3306'
    username='root'
    password='123456'
    db='test'
    table='courses'
));
CREATE DICTIONARY student_name_dict
(
    student_id string,
    student_name string
)
PRIMARY KEY student_id
SOURCE(REDIS(
    host='127.0.0.1'
    port='6379'
));

通过 Databend 的字典功能,可以轻松关联多个数据源并进行查询:

  • 查询同学选课的信息,关联课程名称和学生姓名

    • SELECT student_id,
          dict_get(student_name_dict, 'student_name', to_string(student_id)) as student_name,
          course_id,
          dict_get(courses_dict, 'course_name', course_id) as course_name
      FROM student_scores;
    • +------------+--------------+-----------+-------------+
      | student_id | student_name | course_id | course_name |
      +------------+--------------+-----------+-------------+
      | 1          | Andy         | 1         | math        |
      | 1          | Andy         | 2         | english     |
      | 1          | Andy         | 3         | chinese     |
      | 2          | Nancy        | 1         | math        |
      | 2          | Nancy        | 2         | english     |
      | 2          | Nancy        | 3         | chinese     |
      | 3          | Lucy         | 1         | math        |
      | 3          | Lucy         | 2         | english     |
      | 3          | Lucy         | 3         | chinese     |
      | 4          | Jack         | 1         | math        |
      | 4          | Jack         | 2         | english     |
      | 4          | Jack         | 3         | chinese     |
      +------------+--------------+-----------+-------------+
  • 查询同学平均成绩的排名

    • SELECT student_id,
          dict_get(student_name_dict, 'student_name', to_string(student_id)) as student_name,
          avg(score) as avg_score
      FROM student_scores
      GROUP BY student_id
      ORDER BY avg_score DESC;
    • +------------+--------------+-----------+
      | student_id | student_name | avg_score |
      +------------+--------------+-----------+
      | 2          | Nancy        | 82.0      |
      | 4          | Jack         | 80.0      |
      | 1          | Andy         | 75.0      |
      | 3          | Lucy         | 68.0      |
      +------------+--------------+-----------+
  • 查询各门课程的平均分数

    • SELECT course_id,
          dict_get(courses_dict, 'course_name', course_id) as course_name,
          avg(score) as avg_score
      FROM student_scores
      GROUP BY course_id;
    • +-----------+-------------+-----------+
      | course_id | course_name | avg_score |
      +-----------+-------------+-----------+
      | 2         | english     | 73.0      |
      | 1         | math        | 72.0      |
      | 3         | chinese     | 83.75     |
      +-----------+-------------+-----------+

通过以上的示例,可以看到字典功能可以有效地结合 Databend、MySQL 和 Redis 处理学生成绩管理系统中的联合查询,提高查询效率和数据管理能力。

四、总结

在这篇文章中,我们介绍了字典功能的基本用法,并通过一个简单的例子展示了使用字典来查询多个数据源的数据。字典功能在很多应用场景都可以使用,特别是有外部数据源需要定期同步场景,例如,一个金融分析系统需要实时分析股票价格数据,通过为股票价格数据创建字典,可以从数据源实时读取最新的股票价格数据,结合其它数据进行实时的分析计算。字典功能在提高查询性能、简化数据管理、确保数据一致性等方面具有广泛的应用价值。

目前,Databend 字典已经支持了对 MySQL 和 Redis 数据源的访问,未来会支持更多数据源,包括 PostgreSQL、MongoDB、Sqlite、HTTP 接口等,满足更多数据处理和分析场景的需求。同时,字典查询的性能也会继续优化,通过引入缓存和批量查询机制,减少外部数据源的查询延迟,提升并发查询性能。

关于 Databend

Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式数仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn

📖 Databend 文档:docs.databend.cn/

💻 Wechat:Databend

✨ GitHub:github.com/datafuselab…

Databend 的安装配置和使用 了解新型数据库,介绍 Databend 的安装配置和使用。 阅读详情

相关推荐

Aloudata 荣登“数智技术系列榜单”和“数据智能服务商 TOP30”

持续助力各行业数智化先进企业突破数据管理技术瓶颈,以更加敏捷、精准和可靠的数据交付驱动企业业务创新与经营提效

Aloudata的博客 672

Databend 设计概述 | 白皮书

Databend 是一个开源的、完全面向云架构的新式数仓,它提供快速的弹性扩展能力,并结合云的弹性、简单性和低成本,使 Data Cloud 构建变得更加容易。 Databend 把数据存储在像 AWS S3 ,Azure Blob 这些云上的存储系统,可以使不同的计算节点挂载同一份数据,从而做到较高的弹性,实现对资源的精细化控制。 Databend 在设计上专注以下能力: 弹性 在 Databend 中,存储和计算资源可以按需、按量弹性扩展。 安全 Databend 中数据文件和网络传输都是端到端加密,

Databend的博客 1189

【CIC-IDS数据集+机器学习】实现网络流量异常检测

本项目基于CIC-IDS数据集,使用多种机器学习算法实现网络流量异常检测系统。项目采用了完整的机器学习工作流程,从数据预处理到模型部署,实现了高精度的网络入侵检测。

XiaoMu_001的博客 1939

Databend:下一代云数据仓库解决方案

Databend是一个用Rust语言开发的开源云数据仓库,旨在为大规模数据分析提供高性能、低成本的解决方案。作为Snowflake的替代品,Databend专注于快速查询执行和数据摄取,适用于复杂的大规模数据集分析。云原生架构: 与AWS S3、Azure Blob、Google Cloud等云存储服务无缝集成高性能: 基于Rust构建,采用先进的向量化执行技术成本效益: 设计用于可扩展的存储和计算,在提高性能的同时降低成本AI驱动分析: 通过AI函数支持高级分析数据简化。

2401_87458778的博客 1770

论文阅读笔记--Grid Anchor based Image Cropping: A New Benchmark and An Efficient Model

基于网格锚的图片裁剪:一种新的标准和高效的模型摘要1.介绍2.相关工作2.1 图像裁剪数据集和评估指标 摘要 图像裁剪的目的是通过去除图像中无关的内容来改善图像的组成和美学质量。现有的图像裁剪数据库大多只提供一个或多个人工标注的边界框作为基准,难以反映实际中图像裁剪的非唯一性和灵活性。 采用IoU等评价指标也不能可靠地反映裁剪模型的真实性能。本文回顾了图像裁剪的问题,并通过考虑图像裁剪的特殊特性和要求(如局部冗余、内容保存、高宽比),提出了基于网格锚的公式。 我们的公式将候选裁剪窗口的搜索空间从数百万减少到

qq_22565865的博客 2950

Unity分包下载实战:AssetBundle+CDN+热更新全链路指南

分包下载是移动应用资源管理的核心技术,本质是将大体积安装包拆解为按需加载的独立资源单元,以解决用户安装意愿低、首屏启动慢、热更新不可控等关键问题。其底层依赖资源打包机制(如Unity AssetBundle)、全球分发网络(CDN)与安全热更新策略三者协同。AssetBundle提供资源隔离与依赖管理能力,CDN保障低延迟高可用下载,而热更新策略则决定版本控制、灰度发布与异常恢复的工程鲁棒性。该方案广泛应用于中重度游戏、大型工具类App及需要频繁内容迭代的商业项目,直接提升次日留存、过审成功率与用户在线时长

weixin_29762151的博客 360

Databend 集群部署 | 新手篇(2)

,其中 databend-query 是计算节点,无状态模式,这种架构也有直接用于生产的。实际上生产环境推荐至少部署三个 databend-meta 组成集群,其中 databend-query 可以是一个节点,而且可做到不使用就关闭。如果你使用的是公有云上对象存储,就不用担心对象存储的高可用。下面我们描述一下 Databend 的集群环境搭建。在 Databend 集群中分为两个角色:databend-meta 集群和 databend-query 集群。

Databend的博客 823

谷粒商城篇章9 ---- P248-P261/P292-P294 ---- 消息队列【分布式高级篇六】

RabbitMQ消息队列、RabbitMQ延时队列。

weixin_48568302的博客 1551

SaaS 出海:Databend Cloud 的定位与实践

提到 “SaaS 出海”这个词大家肯定并不陌生,SaaS 企业将业务拓展到海外市场已经成为许多 SaaS 公司的重要战略方向。随着企业对于灵活性、可扩展性以及成本效益需求的不断增长, SaaS 模式提供了理想的解决方案。对于寻求出海机会的 SaaS 企业来说,全球化市场的巨大潜力尤为吸引人。在许多地区,尤其是发展中市场, SaaS 服务的普及率还远远没有饱和,这也为企业提供了非常广阔的成长空间。随着全球数字化转型的不断加速, SaaS 服务需求也在持续增长。

Databend的博客 1208

Spark中Application、Job、Stage和Task区别详解

在Spark中,有一些关键的概念,如Application、Job、Stage和Task,它们描述了Spark作业的不同层次和组成部分。下面我将详细介绍每个概念,并通过示例说明它们之间的区别。

优快云 精品推荐 907

基于爬虫+词云图+Kmeans聚类+LDA主题分析+社会网络语义分析对大唐不夜城用户评论进行分析

本项目是基于携程网中关于大唐不夜城评论的文本分析,项目中用到了Python爬虫、词频分析、词云图分析、kmeans聚类、LDA主题分析、情感分析、社会网络语义分析等。本次实验我们使用了爬虫、词云图、情感分析、LDA主题分析、TF-IDF+Kmeans、社会网络语义分析等对大唐不夜城的评论进行了分析。关于博文中的源码大家可以关注派森小木屋公众号进入粉丝群领取,如对文章有疑惑,请评论区留言。

m0_64336780的博客 1万+

Databend 特性系列(1)|Databend 数据生命周期

在上面的文章中我们演示了 snapshot 在 Databend 对于数据生命周期的访问控制。这里有一个核心就是云对象存储不能炸了。每天备份一下对应的表结构。每天备份一下对应表的 fuse_snapshot 对应输出。如果是自建的存储可以增加副本数来增加安全性。

Databend的博客 620

【报错解决】OpenClaw 报错 ENOENT: no such file or directory, open ‘/root/.npmrc‘:配置文件路径不存在

本文分析了OpenClaw平台在国产操作系统环境下运行时出现的ENOENT: no such file or directory, open '/root/.npmrc'错误。该问题源于容器环境中root用户的npm配置文件缺失,导致插件依赖安装失败。文章详细解释了npm配置加载机制和容器环境的特殊性,提出了四种解决方案:手动创建配置文件、写入基础配置、使用全局配置替代以及容器启动时自动初始化。最后指出该错误暴露了工程中对默认路径盲目信任的问题,强调显式声明运行环境依赖的重要性。

博客 2016

Databend v1.2 版本发布!Data + AI

各位社区小伙伴们,Databend 于 2023 年 6 月 29 日迎来了 v1.2.0 版本的正式发布!相较于 v1.1.0 版本,开发者们一共新增了次 commit,涉及个文件变更,约行代码修改。在 v1.2.0 版本中,Databend 新增了等特性,大幅提升的性能。

Databend的博客 385

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

使用 Databend 全新体验!一文看懂 Databend 可视化管控平台 BendDeploy

Databend 提供了一套基于 Kubernetes 的标准化私有部署管控平台——BendDeploy,帮助用户快速、安全地实现 Databend 多集群、多租户的部署和管理。BendDeploy 提供了简单易用的可视化运维体验,极大地提升运维效率,减少错误和中断。通过 BendDeploy,用户可以实现多租户管理、集群部署、集群扩缩、集群升级、节点管理等操作。此外,BendDeploy 还提供了日志收集、查询和分析能力,将日志收拢到一个平台中,简化了操作。

Databend的博客 1091

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Tapdata 和 Databend 数仓数据同步实战

Databend: 是新一代基于对象存储的弹性云数仓产品。地址:OpenDAL :是 Databend 中负责和底层存储打交道的一个组件,目前被 Rust 多数据库产品及 Rust sccache 中大量使用,估计不远的将来会成为一个多云对象存储支持最好的产品。地址:Openraft: 是 Databend 中负责 Databend Meta 中的集群组件,目前被 SAP 及 许多交易所使用。

Databend的博客 804

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Databend 2024 年度总结:乘势而上,创新无止境

2024 年对 Databend Labs 来说是非凡的一年,也是具有里程碑意义的一年。这一年,Databend 不仅迎来了成立三周年,更迈入了商业化元年。Databend Labs 在过去一年里,以卓越的产品能力和社区贡献,推动了云数据仓库领域的变革,也让更多企业通过 Databend 实现了降本增效的目标。让我们一起回顾 Databend 的 2024 年,并展望更加值得期待的 2025 年!

Databend的博客 966

Databend使用入门

云数仓Databend使用的一些重要的笔记

hys__handsome的博客 1085

开源、云原生且实时分析型的现代数据仓库DataBend的介绍,及其与其它开源文件存储的结合使用实例

Databend 是一个开源、云原生且实时分析型的现代数据仓库,旨在提供高效的数据存储和处理能力。它采用 Rust 语言开发,并支持 Apache Arrow 格式以实现高性能列式存储与查询处理。

zrc_xiaoguo的博客 2410

释放无限潜力:Databend 存算分离架构如何让企业数据管理焕然一新?

存算分离架构的出现为云原生数据库带来了新的可能性。通过计算与存储资源的解耦,Databend 实现了高扩展性、弹性使用和更高的资源利用率,解决了传统存算一体架构中存在的扩展性和成本问题。作为一款云原生数据仓库,Databend 的设计思路从一开始就围绕存算分离架构展开,最终为用户提供了一种高效灵活的数据处理解决方案。Databend 存算分离架构的设计与实现不仅是当前技术发展的体现,更为未来数据库系统的发展指明了方向。

Databend的博客 1300

【Databend】数据类型

介绍 Databend 数据类型,并且记录工作使用中可能遇到的问题。

小发菜 1109

Databend 数据写入实测:从 3千行/秒 到 230万行/秒,4种方式该怎么选

本文对比了Databend支持的四种数据写入方式性能差异及适用场景:INSERT(云上直接写入对象存储)、INSERT_NO_PRESIGN(私有化转发写入)、STREAMING_LOAD(实时流式写入)和STAGE_LOAD(批量加载)。测试显示STREAMING_LOAD在200k批次可达127k行/秒,STAGE_LOAD最高达800k行/秒。建议私有化场景优先考虑简单实现,云上则应结合成本选择INSERT或STAGE_LOAD以节省流量费用,避免使用可能产生高成本的INSERT_NO_PRESIGN

Databend的博客 878

Databend Operator: 打造开源的数据仓库部署利器

Databend Operator 是我们最新在 Github 上开源的项目,旨在通过 Kubernetes 原生方式管理 Databend 的核心组件,尤其是面向私有化和混合云部署场景。Tenant和Warehouse。Tenant 定义对象存储端点、Meta 信息和用户配置;Warehouse 通过 tenantRef 引用 Tenant,并声明计算镜像、实例数、Disk Cache 配置与日志策略。

Databend的博客 721

Databend 存储架构总览

通过本篇文章带大家理解一下 Databend 的存储结构。Databend 内置的 Table 引擎为 Fuse table engine ,也是接下来要花重点篇幅要讲的。

Databend的博客 900

告别 Kafka,拥抱 Databend:构建高效低成本的用户行为分析体系

用户行为数据埋点指标是数据仓库中不可或缺的重要数据源之一,同时也是企业最宝贵的资产之一。通常情况下,用户行为数据分析包含两大数据源:用户行为分析日志和上游关系型数据库(如 MySQL)。基于这些数据,企业可以进行用户增长分析、用户行为研究,甚至通过用户行为分析精准排查用户问题。

Databend的博客 1618

【Databend】基础函数应用

本文主要介绍 Databend 中常用的函数,并配合实际操作演示相应的函数结果。

小发菜 1237
上一篇: 探索 Snowflake 与 Databend 的云原生数仓技术与应用实践 | Data Infra NO.21 回顾
下一篇: 释放无限潜力:Databend 存算分离架构如何让企业数据管理焕然一新?
Databend
博客等级 码龄5年 1458粉丝 363原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值