


🌐 社群导航
🔗 点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群
最新论文解读系列
论文名:VEGGIE: Instructional Editing and Reasoning Video Concepts with Grounded Generation
论文链接:https://arxiv.org/pdf/2503.14350
开源代码:https://veggie-gen.github.io/
导读
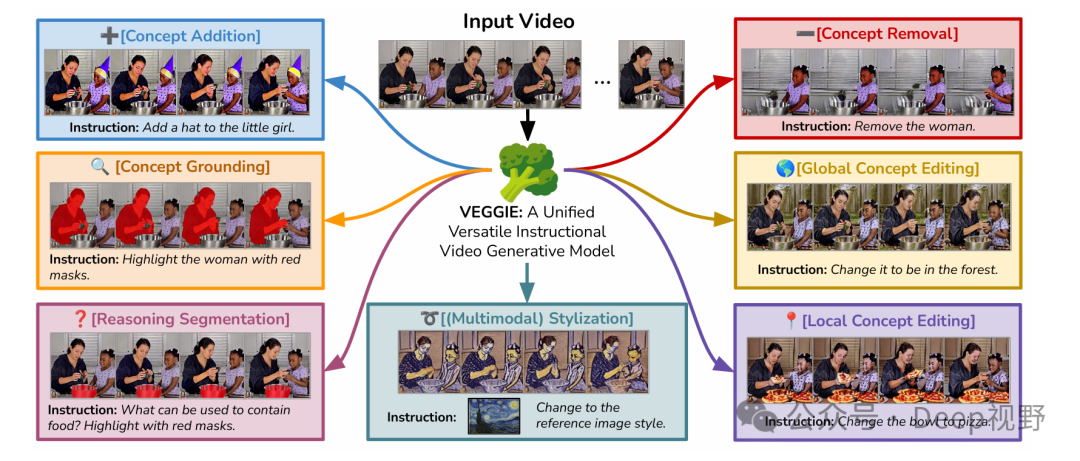
基于视频扩散模型(Vid - DMs)的进展,视频编辑方法已成为视频设计工具,允许用户操纵视频概念,如添加、删除、更改对象以及进行风格转换。为了提升用户体验,指令式视频编辑方法 应运而生,使用文本提示、源视频和目标视频三元组进行训练。由于这些方法在理解用户意图和多模态语义方面的性能有限,一些方法引入了多模态大语言模型(MLLMs)来处理复杂指令/推理。
简介
近期的视频扩散模型推动了视频编辑的发展,但在统一框架内处理指令式编辑和多样化任务(如添加、删除、更改)仍然具有挑战性。在本文中,我们介绍了VEGGIE,即基于指令基础生成的视频编辑器,这是一个简单的端到端框架,可基于不同的用户指令统一进行视频概念编辑、定位和推理。具体而言,给定一个视频和文本查询,VEGGIE首先利用多模态大语言模型(MLLM)解读用户指令中的意图,并将其与视频上下文关联起来,生成针对特定帧的基础任务查询以获得像素空间响应。然后,扩散模型根据这些计划生成符合用户意图的编辑后视频。为了支持多样化任务和复杂指令,我们采用了课程学习策略:首先使用大规模指令式图像编辑数据对齐多模态大语言模型和视频扩散模型,然后在高质量多任务视频数据上进行端到端微调。此外,我们引入了一种新颖的数据合成流程,用于生成成对的指令式视频编辑数据以进行模型训练。该流程通过利用图像转视频模型注入动态,将静态图像数据转换为多样化、高质量的视频编辑样本。VEGGIE在指令式视频编辑中展现出了强大的性能,具备不同的编辑技能,作为一个通用模型超越了最佳指令式基线,而其他模型在多任务处理方面则面临困难。VEGGIE在视频对象定位和推理分割方面也表现出色,而其他基线模型则无法胜任。我们进一步揭示了多个任务之间如何相互促进,并强调了零样本多模态指令式和上下文内视频编辑等有前景的应用。
方法与模型
在本文中,我们介绍了一种基于指令的定位生成视频编辑器(VEGGIE),这是一个统一且通用的生成式视频模型。它将多模态大语言模型(MLLMs)的复杂指令理解和推理能力与视频扩散模型(VidDMs)的生成能力相结合。该模型仅使用扩散损失进行端到端训练。VEGGIE能够高效处理各种用户输入,包括直接指令、需要深入推理的复杂问题以及多模态条件。它可以执行各种像素级操作,根据用户指令实现视频概念的添加、移除、更改、风格化、定位和推理分割等任务。我们将详细介绍模型设计、训练和推理过程以及数据策划。
1. 模型架构
VEGGIE由四个主要组件组成(见图2):(1)一个多模态大语言模型;(2)一组可学习的定位任务查询;(3)一个对齐网络(单层多层感知机),用于将多模态大语言模型的输出投影到扩散模型的条件空间;(4)一个从教学图像编辑模型[82]初始化的视频扩散模型。我们的模型首先通过使用多模态大语言模型查询多模态上下文为目标视频帧生成潜在条件,然后通过视频扩散模型在像素级别渲染这些条件,具体细节如下。
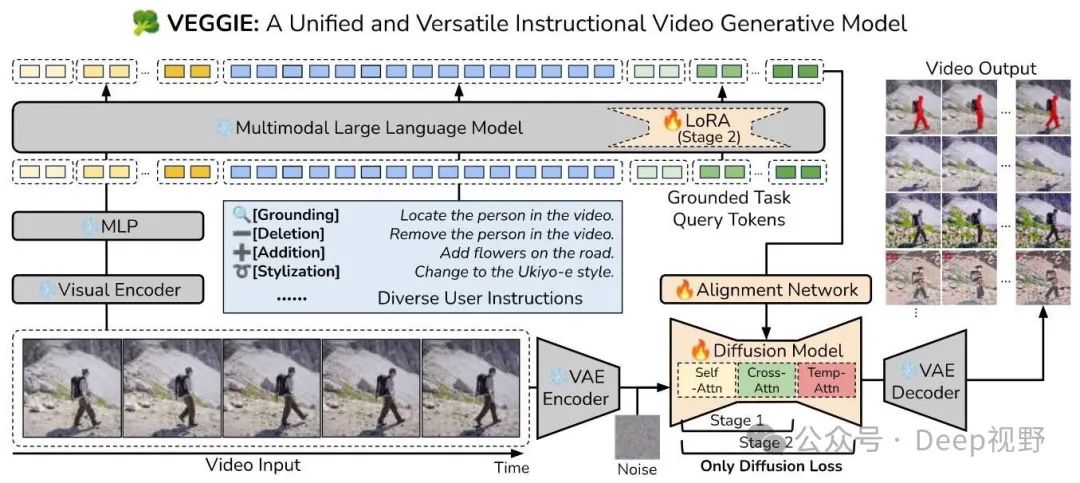
图2. 我们提出的端到端VEGGIE框架概述。我们的多模态大语言模型首先理解输入的视频帧和各种用户指令,然后生成逐帧推理查询,为视频扩散模型维护每帧的编辑条件。视频扩散模型将MLLM生成的条件渲染到像素空间,以完成各种任务,包括视频编辑(添加/删除/更改)、视频定位以及带问题的视频推理分割。我们仅对整个流程训练应用扩散损失。
用于生成有根据的任务指导的多模态大语言模型(MLLM)。如图2左侧所示,给定一个由一系列帧组成的视频,其中是给定视频的帧数,以及用户指令/问题,我们的目标是在像素空间中获得响应,该响应能如实反映用户针对给定视频的指令。MLLM模块处理输入视频和用户指令,为每一帧生成一系列有根据的任务令牌:,这些令牌并行输入和输出。这些令牌作为任务指导,隐式编码目标操作,如对象属性、空间关系或风格转换参数。MLLM确保模型既能捕捉到用户的明确指令,又能满足隐式推理需求。
用于在像素空间渲染MLLM指导的视频扩散模型(VidDM)。如表2右侧所示,VidDM将原始视频和有根据的任务令牌作为条件,合成目标视频。原始视频与噪声体积拼接,任务令牌输入到交叉注意力机制中。在去噪步骤中加入有根据的任务指导,生成过程确保输出能如实遵循用户指令,同时保留视频的结构和运动动态。通过迭代去噪,它在保持时间一致性的同时细化每一帧,连贯地应用像素修改,以生成平滑且视觉上一致的输出视频。
2. 从图像到视频的课程学习
直接在视频任务上训练模型存在两个关键挑战:(1)MLLM和扩散模型表示之间的不一致,使得扩散模型在有限的微调数据下难以解释MLLM生成的任务查询;(2)由于在多样化任务上的训练不足,即使是图像任务,扩散模型也缺乏多任务处理能力。我们最初的实验还发现,当整个流程直接用所有数据进行训练时,模型会崩溃。这些挑战/观察结果凸显了MLLM和扩散模型之间进行预对齐的必要性,以便能够从语言空间的任务查询无缝适应到像素空间的修改。为此,我们为提出的VEGGIE框架采用了两阶段课程学习策略。
阶段1:对齐扩散空间和语言空间。在第一阶段,我们使用大规模图像级指令编辑数据将扩散模型与MLLM对齐。在更新对齐网络、有根据的任务查询和扩散UNet时,MLLM保持冻结。这个过程微调扩散模型的权重,使其与语言空间对齐,使模型能够解释MLLM生成的指导,并将用户指令转化为像素级编辑,同时保留MLLM理解指令和用户意图的强大能力。
阶段2:增强时间一致性和动态性。在MLLM和扩散模型对齐后,对多样化的指令性视频编辑数据进行微调,能更有效地提高在像素空间遵循指令的能力,包括时间一致性、动态连贯性和编辑忠实性。在这个阶段,我们使用MLLM对框架进行微调,包括对齐网络、有根据的任务查询和扩散UNet的所有三个维度,使用精心策划的多任务指令性视频编辑数据进行端到端训练。遵循先前的工作[22, 66],我们为第一阶段的二维UNet添加时间注意力层,以适应视频处理。对于阶段1和阶段2,我们使用单一的扩散损失来优化框架,实现统一学习,在保持简单性和效率的同时提高指令性视频编辑性能。
测试期间的无分类器引导。我们采用无分类器引导来平衡扩散生成样本的质量和多样性。遵循先前的工作 [3, 17],我们考虑两种条件,将无分类器引导应用于指令性视觉编辑:基于任务的标记(task tokens)和原始视频。为了获得无条件引导,我们为任务标记和输入视频都设置空值 。在这种情况下,我们的得分估计为:
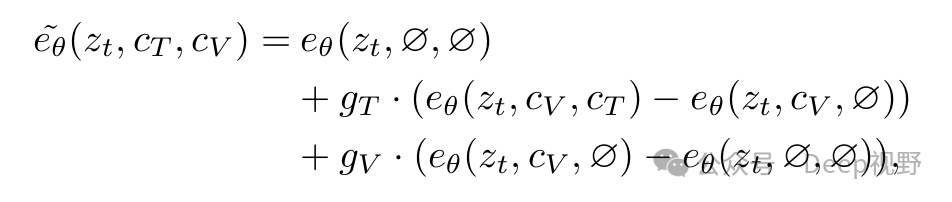
其中 表示模型参数, 和 分别表示任务标记和视频条件, 是空值, 是时间戳 处的加噪潜变量, 和 分别是任务引导和视频引导的缩放因子。
3. 数据整理流程
现有的视频编辑模型,无论是指令性还是非指令性的,由于缺乏高质量的多任务微调数据,在多样化的编辑技能方面都存在困难。在本节中,我们介绍我们的数据整理策略,以支持 VEGGIE 实现多功能的视频编辑技能。如表 1 所示,我们从不同来源收集了 340 万张图像和 13.39 万个视频数据,以支持我们在 3.2 节中讨论的 VEGGIE 课程学习。我们从两个来源创建训练数据集:(1) 收集现有的图像和视频数据,并将其转换为指令性编辑格式;(2) 使用现有数据集和生成模型合成新的指令性视频编辑样本。
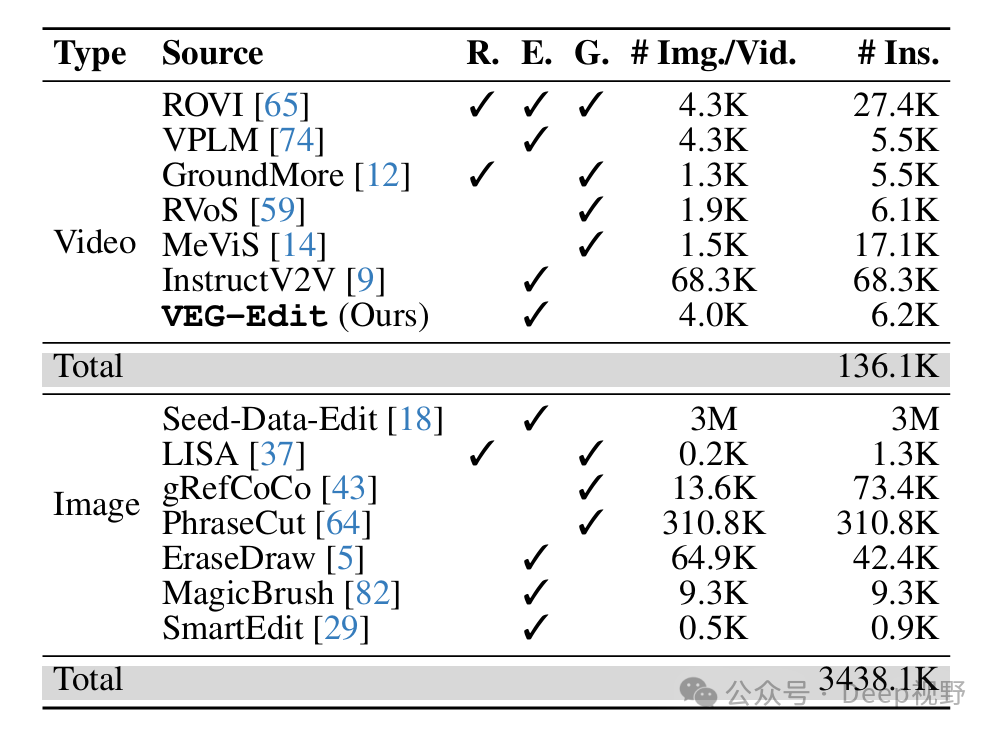
表1. 我们用于VEGGIE训练的数据总结。R.:推理,E.:编辑,G.:定位。# Img/Vid表示图像或视频的数量,# Ins.表示指令 - 图像/视频对的数量。
收集多样化的多任务图像和视频数据。我们整合了来自图像(Seed - Data - Edit [18]、MagicBrush [82]、EraseDraw [5])和视频(InstructV2V [9]、VPLM [74])来源的指令编辑数据。这些数据集提供了带有用户指令的原始和编辑后的视觉内容对。任务包括添加、移除和更改对象、风格化以及进行全局/局部编辑。除了编辑数据集,我们还纳入了图像级别(gRefCoCo [43]和Phrase - Cut [64])和视频级别(RVoS和MeViS)的分割数据。这些分割任务被重新表述为填色挑战,以指导模型学习指称定位(即理解要编辑的对象或区域)并加强其概念学习。为了通过多模态大语言模型(MLLM)进一步解锁复杂指令理解,我们纳入了需要更高级推理和隐式指称的数据。具体来说,我们纳入了:推理分割(LISA [37])、推理编辑(SmartEdit [29])、交互式视频修复(LGVI [65])和基于运动的视频推理(GroundMoRe [12])。这些任务帮助VEGGIE学习隐式指称和推理。
通过图像到视频动画合成指令性视频编辑数据。最近的方法通过首先使用大语言模型(LLM)创建文本指令,然后通过文本到视频(T2V)模型和提示到提示编辑[23]获取编辑后的视频,来生成合成的指令性视频编辑数据。虽然这些方法将基于图像的编辑流程[9]应用于视频,但生成的数据存在时间一致性问题。为了解决这一差距,我们提出了一种新颖的图像到视频动画策略,该策略利用了丰富的高质量图像级指令编辑数据集[63, 82],这些数据集提供了标注良好的指令、配对的编辑后图像和组织良好的编辑技能类别。如图3所示,给定一个来自指令性图像编辑数据集[63]的原始图像、一个编辑后的图像和一条指令,我们的方法包括三个关键步骤。首先,我们使用一个离线的多模态大语言模型(MLLM)[60, 71]生成一个图像描述和一个描述图像内合理运动的动画提示。接下来,一个图像到视频(I2V)模型将图像动画化为视频。最后,我们使用一个以第一帧为条件的视频编辑模型[35]生成相应的编辑后视频,利用作为强先验来确保各帧之间的一致编辑。最后,为了确保数据质量,我们使用自动视频质量评估指标[30]评估每对原始 - 编辑后视频,这些指标从不同维度评估生成的视频,例如运动平滑度、图像质量和背景一致性。这个流程将精心策划的基于图像的数据集转换为指令性视频编辑资源,同时保留原始编辑的精度。因此,我们的数据方法扩大了高质量合成视频编辑数据的可用性,支持我们的端到端统一框架中更广泛的编辑任务。
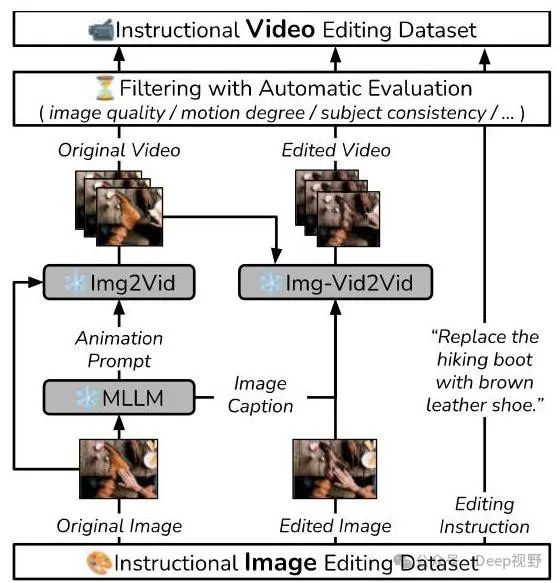
图3. 我们用于合成指令性视频编辑数据的数据生成流程。它通过图像到视频(I2V)模型为构建良好的指令性图像编辑数据集注入动态,并生成用于指令编辑的配对视频数据。
实验与结果
我们首先介绍VEG - Bench基准测试,然后展示VEGGIE在各种视频指令编辑技能方面的优越性。更多可视化、评估和实现细节见附录。
1. VEG基准数据集(VEG-Bench)和评估指标
由于目前没有专门为细粒度指令性视频编辑技能设计的基准数据集,我们手动收集并标注了VEG基准数据集(VEG-Bench),其中包含132个视频 - 指令对,均衡涵盖了8种不同的视频生成技能(每种技能有15 - 20个样本)。除了标准指标,包括文本 - 视频对齐度(CLIP文本指标 [54])、视频平滑度(CLIP - F指标 [54])和图像质量(MUSIQ指标 [32])之外,我们还首次引入了以多模态大语言模型(MLLM)作为评判器的方法,根据给定的原始视频、编辑后的视频和用户指令给出一个整体评估分数。这是通过提示GPT - 4o [21] 来评估是否实现了所要求的语义变化,评分范围为1到10分。对于添加和移除操作,我们还引入了一个目标检测器(GroundingDiNo [44])来检测目标是否被如实地添加/移除。对于定位和推理分割任务,我们参考视频定位任务 [12, 14, 33, 57] 并采用杰卡德指数(Jaccard index)、F - 度量(F - measure) 及其平均值 。我们还计算了生成视频与用真实标注掩码(GT masks)掩蔽后的原始视频之间的结构相似性指数(SSIM)。更多评估/指标细节见附录。
2. 实验设置
实现细节。我们的多模态大语言模型(MLLM)使用LLaVA - OneVision - 7B(LLaVA - OV)[38] 进行初始化。我们的视频扩散模型(VidDM)从指令性图像编辑模型MagicBrush [82] 初始化,其骨干网络采用Stable Diffusion v1.5 [56]。我们按照AnimateDiff [22] 的方法,用时间注意力层对二维卷积层进行扩展以适配视频。我们的VEGGIE模型采用两阶段课程训练策略(第3.2节)。在第一阶段,我们在图像数据上对U型网络(UNet)中的二维卷积层、对齐网络和多模态大语言模型中的任务查询令牌进行全量微调,可训练参数为 。在第二阶段,我们训练U型网络中的所有三维参数、对齐网络、任务查询令牌以及多模态大语言模型中的低秩自适应(LoRA),可训练参数达到13亿。两个阶段均采用端到端训练,仅使用扩散损失。更多细节见附录。
基线模型。我们主要将我们的模型与强大的指令编辑模型[9, 19, 65]进行比较。此外,为了完整性,我们还纳入了非指令编辑模型,尽管这些模型并非公平的基线,因为它们不是端到端的,并且依赖于额外的条件,如深度图或中间字幕。
3. 实验结果
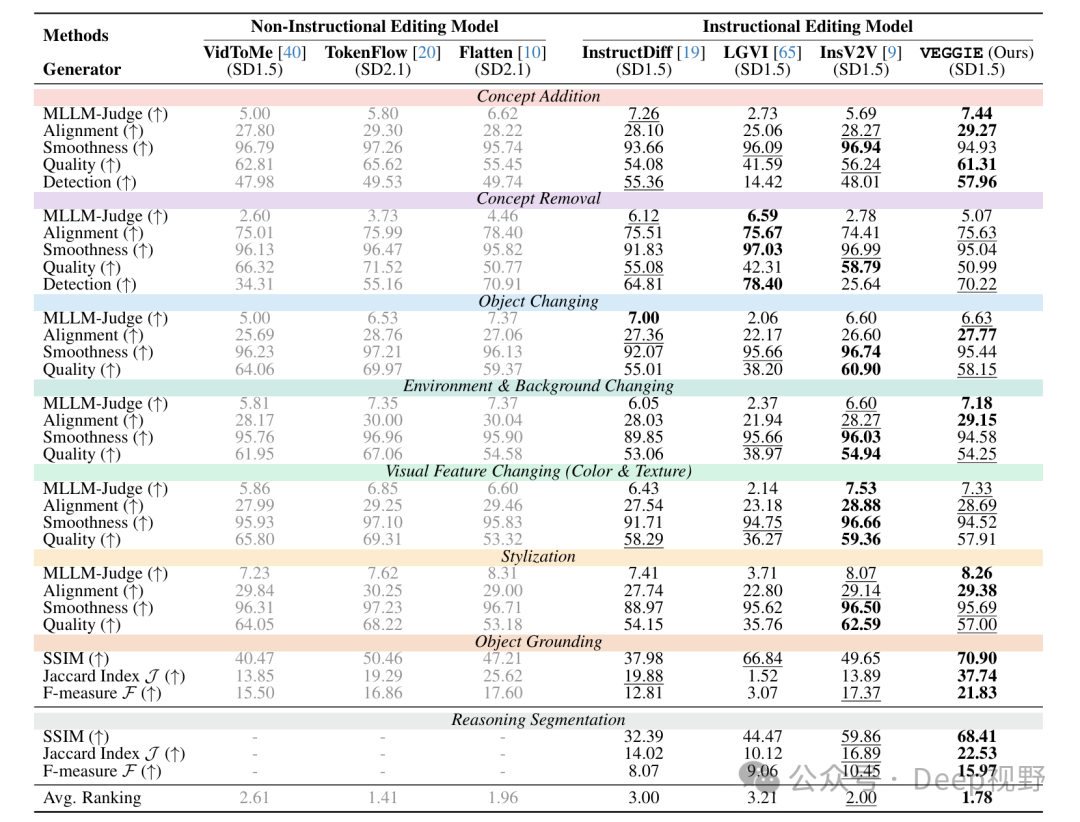
表2. VEG基准测试中视频编辑任务在有指令/无指令模型上的比较。-:无指令模型无法完成该任务。我们将不同类别的无指令模型的数据进行了灰色显示。
多样化技能的指令视频编辑。如表2所示,我们在VEG-Bench上针对8种不同的编辑技能评估了7种不同的模型。总体而言,VEGGIE在指令视频编辑模型中表现最佳。与VEGGIE相比,非指令模型在概念移除和添加方面往往存在困难。这一局限性源于这些模型依赖于注意力控制或额外条件(如深度图),这些条件施加了强先验,限制了模型,使得对象添加或移除具有挑战性。我们还观察到,InsV2V在质量和平滑度指标上取得了高分,但在对齐和MLLM判断方面表现不佳,这些指标需要忠实的语义变化。图4中的定性示例表明,InsV2V通常对输入视频进行最小的更改,从而导致视频质量高但输出不忠实。相比之下,VEGGIE实现了更好的平衡,既提供了高质量的视觉效果,又与预期编辑实现了准确的语义对齐。
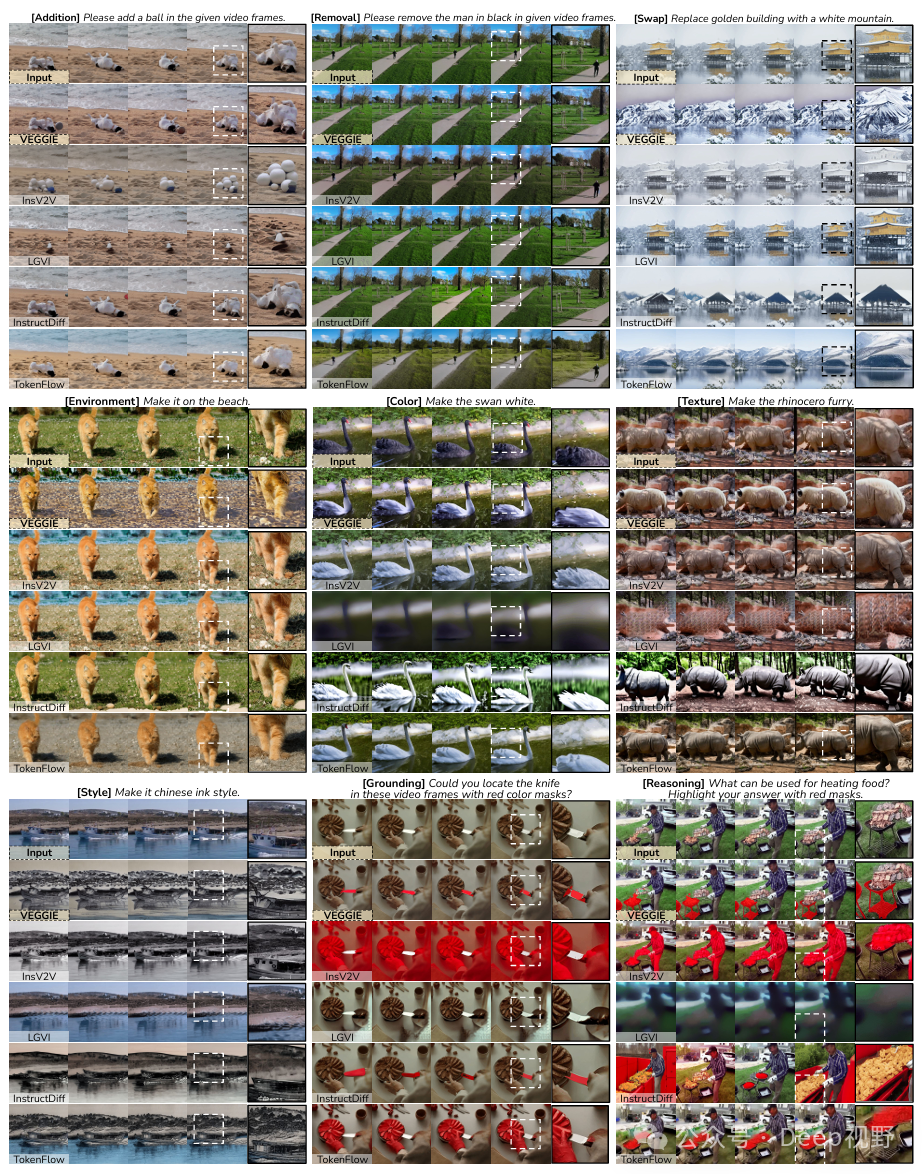
图4. 8种不同能力(将视觉特征分为颜色和纹理)的编辑结果定性比较。我们提供放大细节以进行更详细的比较。彩色查看效果最佳。更多内容见附录。我们在补充材料中提供了视频。
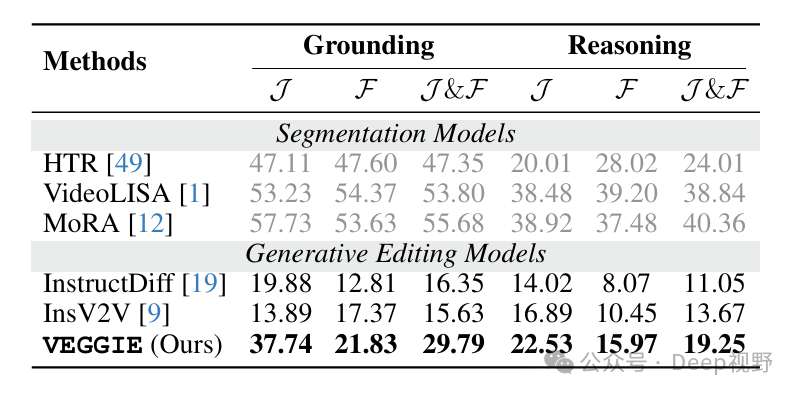
表3. 视频概念定位和推理分割任务与其他指令生成模型和专家分割模型的比较。
视频概念定位与推理分割 我们在表3中提供了关于视频概念定位和推理分割的额外结果。VEGGIE显著优于基于扩散的基线模型,展示了其在精确定位细粒度对象引用和处理复杂推理任务方面的卓越能力。我们假设,通过基于定位的生成,VEGGIE在概念编辑方面表现出了非凡的精度。例如,如附录图11所示,VEGGIE可以在不改变附近女孩的情况下移除女人。
4. 进一步分析与讨论
多任务能相互促进吗?为了验证之前的假设,我们在VPLM [74]数据集上训练我们的模型,该数据集包含配对的定位和移除任务(每个任务约个样本)。由于这些任务相对于真实标签的评估较为直接,我们将其作为代表性示例。如表4所示,多任务训练产生了较低的FVD分数和较高的SSIM分数,表明学习定位和移除视频概念可以相互增强性能。我们在图5中展示了一个示例。然而,这一结论仅在数据组合平衡的情况下成立。我们还观察到,过多的定位数据会引入更多的伪影,并对视觉编辑技能产生负面影响。
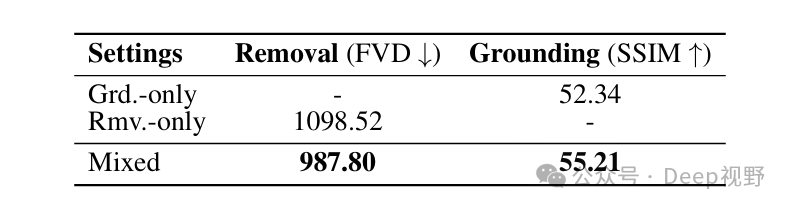
表4. 关于多任务学习是否能提供可迁移的益处,从而提升跨任务性能的消融研究。我们以移除和定位任务作为代表性示例。
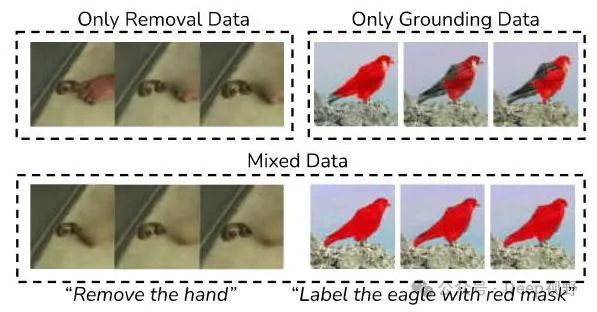
图5. 单技能模型与使用混合数据训练的多技能模型的可视化比较。我们发现定位和移除等任务可以相互促进。
通过t-SNE进行任务查询可视化与分析。为了分析任务/技能的相关性,我们使用PCA和t-SNE将它们的定位查询投影到低维空间。如图6所示,每个类别(如添加)形成了不同的聚类,表明模型能够有效区分。推理和定位在右侧显示在一起。这可能是因为它们都需要认知/语义理解或逻辑参考。颜色、环境和更改聚类彼此更接近,表明模型将它们视为侧重于改变不同视觉属性的相似操作。风格位于左下方区域,但仍与颜色、环境和更改相对接近。这种接近性可能反映出“风格化”在概念上与这些视觉属性任务相似,尽管它针对的是不同的转换。移除在顶部单独存在,尤其与添加相距较远,表明模型将它们视为不同的操作,而非相反的操作。相比之下,添加与推理和定位等任务更接近。这表明添加元素的行为可能依赖于相似的语义或参考过程(例如,决定添加什么以及如何引用新添加的元素)。
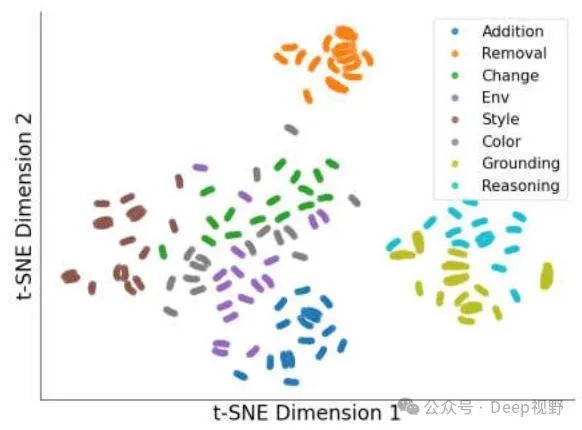
图6. 不同任务查询分布的t-SNE可视化。不同颜色代表不同的任务/技能。彩色视图效果最佳。
新兴的零样本多模态指令跟随。我们还强调了VEGGIE在多模态指令跟随方面的新兴行为,即使没有针对这种特定编辑指令的专门训练数据。值得注意的是,VEGGIE展示了执行零样本多模态指令性视频编辑的能力。如图7所示,VEGGIE可以根据指令将参考图像中的风格进行迁移,或将物体添加到输入视频中。
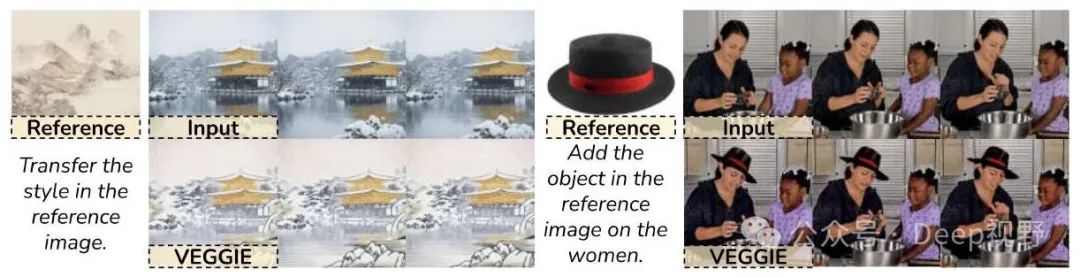
图7. VEGGIE中出现了多模态指令跟随,允许从参考图像进行风格迁移或对象添加。
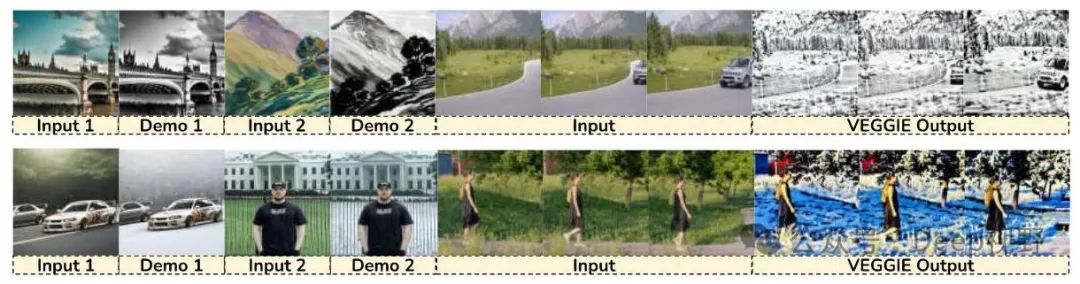
图8. VEGGIE中出现了上下文内编辑,允许通过配对图像演示进行编辑任务的少样本学习。
新兴的少样本上下文内编辑。如图8所示,VEGGIE可以有效地利用少量示例图像对,将预期的编辑更改无缝迁移到输入视频中。我们观察到,VEGGIE在无需语言指令的情况下,展现出了用于图像编辑的上下文内学习能力。相反,它使用图像对作为示例,直接推断并应用所需的编辑意图。
总结
我们提出了VEGGIE,这是一个用于指令性视频编辑的统一端到端模型,可处理各种像素级任务,包括概念添加、移除、风格迁移、定位和推理分割。VEGGIE利用多语言大语言模型(MLLM)实现强大的指令理解,并采用视频扩散模型执行像素级编辑。我们的框架使用单一的扩散损失,以一致的格式对各种不同的任务/技能进行端到端优化。我们还引入了一种新颖的合成数据生成流程和VEG - Bench,这是一个评估广泛编辑技能的基准。我们的VEGGIE作为一种通用的一体化解决方案,优于以往的最先进方法。我们希望我们的模型、数据和基准能够推动指令性生成视频模型的研究发展。
 3145


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


