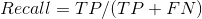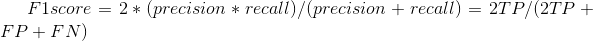分类结果的评估方法

ArcGIS+ENVI实现遥感分类精度评估(分层抽样法) 最近修改论文已经到了最后的关口,结果被质疑分类精度评估的方法。 我原来的方法是利用ArcGIS建立格网,格网中心点作为我的目视解译点,然后再从其中收集信息。 ... 阅读详情

模型评估可以用在模型类型、调节参数及特征组合中。通过模型评估来估计训练得到的模型对于非样本数据的泛化能力,并且还需要恰当的模型评估度量手段来衡量模型的性能表现。

通常在回归问题可以采用平均绝对误差(Mean Absolute Error)、均方误差(Mean Squared Error)、均方根误差(Root Mean Squared Error),而分类问题则采用分类准确率和混淆矩阵的方法,也就是今天要讲述的方法。

分类准确率

分类准确率分数是指所有分类正确的百分比。sklearn库中有直接调用它的方法

sklearn.metrics.accuracy_score(y_true, y_pred, normalize=True, sample_weight=None)

参数含义
y_ture真实标签值
y_pred预测标签值
normalize返回结果的形式,False返回正确分类的样本数,True返回正确分类样本的分数
sample_weight样本权重

分类准确率可能是一个较好的结果评估方法,但却不是一个好的模型度量方法,不能通过它观察任何有关测试数据的潜在分布。

换句话说,该训练的模型可能会在比例较高的那项类别的预测中预测正确,而在另外一种类别的预测中预测失败,而我们没法从分类准确率这项指标中发现这个问题。

那么就得通过混淆矩阵来解决这个问题。

混淆矩阵

混淆矩阵可以理解为就是一张表格,话不多说,先把表格放上。(positive代表1,negative代表0,即一般的二分类问题)


               真实值

positivenegative

      预测值

positiveTPFP
negativeFNTN
  • True Positive(TP): 被正确预测为正类的正类样本数量;
  • False Positive(FP): 被错误预测为负类的正类样本数量;
  • False Negative(FN): 被错误预测为正类的负类样本数量;
  • True Negative(TN): 被正确预测为负类的负类样本数量。

只通过这些数据可能无法直观的观察模型的优劣,则需要下面的四个指标:

准确率(Accuracy): 评价分类器性能的一般性指标就是分类的准确率,它统计的是在给定的测试集上,分类器正确分类的样本数与总测试样本数之比:

                                                       Accuracy=TP+TN/TP+FN+TN+FP

精确率(Precision): 精确率在数据挖掘中也可以称为置信度,它关注的是在给定的测试数据集上,被正确预测为正类的样本数占总的被预测为正类样本数的比例: 

                                                                      Precision= TP/(TP+FP)

召回率 (Recall): 召回率,又可以称为查全率,它关注的是在给定的测试数据集上,被正确预测为正类的样本数占测试数据中正类样本数的比例:

                                                                         Recall= TP/(TP+FN)

F1分数(F1 score或F1 measure): F1分数是精确率和召回率的调和均值:

                                 F1 score=2*(precision*recall)/(precision+recall)=2TP/(2TP+FP+FN)

同样的,sklearn也提供了相应的工具以便直接使用:

准确率:sklearn.metrics.accuracy_score(y_test, y_pred)
精确率:sklearn.metrics.precision_score(y_test, y_pred)
召回率:sklearn.metrics.recall_score(y_test, y_pred)
F1分数:sklearn.metrics.f1_score(y_test, y_pred)
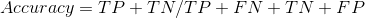
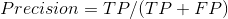
混淆矩阵使得我们对一个分类器性能的表现有了更全面的认识,同时通过计算各种分类后的指标,进行模型选择。

除此之外,还有另外两个指标ROC曲线和AUC值,感兴趣的同学可参考ROC曲线和AUC面积理解和ROC曲线与AUC值

【阶段三】Python机器学习06篇:模型评估函数介绍(分类模型) Python机器学习06篇:模型评估函数介绍(分类模型) 阅读详情

相关推荐

23、《回归评估与分类方法详解》

本文详细介绍了机器学习中的回归评估和分类方法。在回归评估部分,讨论了交叉验证、残差分析以及常用的评估指标MAD和RMSE,并通过代码示例展示了如何实现模型预测与评估。对于分类方法,重点讲解了决策树、支持向量分类器、逻辑回归和判别分析的基本原理、代码实现及适用场景。文章还提供了选择合适分类方法的建议,并结合实例说明了各种方法的优缺点及应用技巧。

sat99的博客 61

分类问题的 8 种评估方法(全)

对于地震的预测,我们希望能够对所有要发生的地震都预测到,即使预测有地震了但是没有发生也能接受,但是不能接受预测没有地震却发生地震的情况。再比如,对于犯罪嫌疑人的定罪,我们不能本着宁可错杀也...

菜鸟学Python数据分析 3387

人力资源研究评估方法论:深度分析与实践

本章深入探讨了人力资源研究项目评估的目标、方法和程序。评估的目的是确保项目资源的最优分配,以最大化公共价值。评估过程包括对项目对目标人群及社会影响的全面审查,收集关键利益相关者的深入访谈数据。项目被分为人力资源发展和教育系统开发两大类,采用混合方法评估其内容连贯性、价值、影响和可持续性。评估框架强调了SMART原则在确定结果指标中的应用,并通过综合分析数据来提出有价值的建议。

weixin_34640289的博客 507

python + sklearn ︱分类效果评估——acc、recall、F1、ROC、回归、距离

之前提到过聚类之后,聚类质量的评价: 聚类︱python实现 六大 分群质量评估指标(兰德系数、互信息、轮廓系数) R语言相关分类效果评估: R语言︱分类器的性能表现评价(混淆矩阵,准确率,召回率,F1,mAP、ROC曲线).一、acc、recall、F1、混淆矩阵、分类综合报告1、准确率第一种方式:accuracy_score# 准确率 import numpy as np from skl

素质云笔记 8万+

人力资源研究评估方法论的深入分析

本文深入探讨了人力资源研究项目的评估目标和方法论框架。重点介绍了如何通过混合方法收集和分析定量及定性数据,以确保评估的可靠性和有效性。文章还详细阐述了如何对项目的影响进行评估,并讨论了如何将结果转化为具有实际意义的建议和推荐。

weixin_28850145的博客 255

auto.js梦幻西游游戏脚本,梦幻西游脚本开发思路

本篇文章给大家谈谈梦幻西游脚本用什么语言写,以及auto.js梦幻西游游戏脚本,希望对各位有所帮助,不要忘了收藏本站喔。

npy199331的博客 1939

【深度学习】【机器学习】分类结果分析指标和方法(混淆矩阵、TP、TN、FP、FN、精确率、召回率)(附源码)

模型分类效果主要是通过计算混淆矩阵已经准确率、召回率和F Score来分析,下面对以上指标进行详细的介绍。

https://github.com/Donvink,专注于计算机视觉、目标检测、目标跟踪等方向 1万+

(35)远程识别(又称无人机识别)(一)

Ardupilot官网关于《Peripheral Hardware》的翻译 —《(35) 远程识别(又称无人机识别)》。

无人机开发(开源Ardupilot) 4万+

机器学习评估分类结果——精准率、召回率、F1Score

机器学习评估分类结果——混淆矩阵、精准率、召回率、F1Score

m0_58700887的博客 6953

Cadence Allegro 17.4学习记录开始00

Cadence Allegro 有三个版本,16.6,17.2,17.4。现在主要学习最新的版本17.4.原理图设计:OrCADPCB设计:Allegro主要用到的就下面三个图片软件:PCB Editor 17.4 是用来画PCB和元器件封装的;Padstack Editor 17.4 是用来画元器件焊盘的;Capture CIS 17.4 是用来画原理图和原理图库的。其实Cadence还有很多功能,现在计划先学习以上内容,后面熟悉了这个软件,还可以继续学习放仿真等功能。

qq_31444421的博客 7441

别再只盯着GPS了!手把手教你用Python仿真UWB定位,30厘米精度是怎么算出来的?

本文详细解析了UWB(超宽带)室内定位技术的原理与实现,通过Python代码演示如何从三边测量法到实现30厘米精度的定位。文章涵盖了UWB的核心数学模型、Python仿真环境搭建、误差分析及优化策略,为开发者提供了实用的技术指南和应用场景。

weixin_26873711的博客 252

mmdetection多类目标训练查看单类准确率(AP)以及使用模型测试看结果(show)

本文主要是个人笔记,以后便于查询,也供借鉴。通常我们在mmdetection平台上就训练一类目标,训练过程中每跑完一个epoch就可以查看到该目标的0.5,0.75等阈值下的准确率,还有一个整体的mAP。但是,当你跑多类目标时,多个目标一起训练怎么看单类的准确率?mmdetection默认的设置是多类目标一起训练时,打印整体的准确率,如果要在训练和测试的时候查看单类的准确率,可以如下操作(以下操作的前提是已经训练起来了,相关多类训练的多类配置文件修改好了): 在mmdetection/mmdet/datas

qq_44442727的博客 1万+

全志Longan和Tina系统T113-S3-(Tina Linux 系统介绍)

Tina Linux是全志科技基于Linux内核开发的针对智能硬件类产品的嵌入式软件系统。Tina Linux基于openwrt-14.07 版本的软件开发包,包含了 Linux 系统开发用到的内核源码、驱动、工具、系统中间件与应用程序包。Tina系统软件架构如图所示。从下至上分别为Kernel && Driver、Libraries、System Services、Applications 四层。

szembed的博客 6332

全面解析 classification_report:评估分类模型性能的利器

还会计算加权平均(weighted avg)、宏平均(macro avg)和微平均(micro avg),从而全面评估模型的整体表现。在机器学习中,分类任务是最常见的应用场景之一。无论是垃圾邮件过滤、图像识别还是情感分析,分类模型的性能评估都是至关重要的一步。为了更好地展示分类报告的结果,可以结合 Matplotlib 或 Seaborn 绘制条形图或热力图。是 Scikit-learn 提供的一个强大工具,用于快速生成分类模型的性能报告。如果希望将分类报告的结果用于后续分析或可视化,可以设置。

hello! 2474

STM32+ST7789屏实战:手把手教你打造物理按键控制的3级菜单GUI(附完整代码)

本文详细介绍了如何使用STM32和ST7789屏构建物理按键控制的3级菜单GUI系统。从硬件架构设计、SPI驱动配置到菜单状态机实现,提供了完整的代码示例和优化技巧,帮助开发者快速掌握嵌入式GUI开发的核心技术。

iii12的专栏 236

不加行也能填满:用 ABAP BDC 驯服 Table Control 滚动录制缺陷,批量维护供应商银行账户

摘要 本文探讨了在SAP ECC/S4HANA系统中处理供应商主数据时,Table Control控件带来的批量导入挑战。文章指出,银行账户维护界面中Table Control的滚动动作难以被录制工具捕捉,导致批量导入数据时仅能填充前5行。解决方案是通过BDC_OKCODE显式触发翻页(如=P+),并配合行号拼接(如(01)~(05))将数据写入不可见行。文中提供了完整的ABAP程序示例,展示了如何读取外部文件、动态生成BDCDATA、处理表格翻页逻辑,最终通过CALL TRANSACTION执行XK01事

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 271

Spark2.0机器学习系列之8:多类分类问题(方法归总和分类结果评估)

一对多(One-vs-Rest classifier) 将只能用于二分问题的分类(如Logistic回归、SVM)方法扩展到多类。 参考:http://www.cnblogs.com/CheeseZH/p/5265959.html “一对多”方法 训练时依次把某个类别的样本归为一类,其他剩余的样本归为另一类,这样k个类别的样 本就构造出了k个binary分类器。分类时将未知样本分类为...

weixin_30325793的博客 331

在 SAP S/4HANA Public Cloud 中做产品扩展:从 Key User 到 ABAP Cloud 与 BTP 的三轨实践指南

摘要:SAP S/4HANA Public Cloud 提供三种扩展方式(key user、developer extensibility 和 side-by-side),遵循 clean core 原则确保升级稳定。key user 扩展适合无代码轻量改良,developer extensibility 用于受控 ABAP 开发,side-by-side 则适用于云原生独立应用。文章通过销售订单优先级字段、退货审批微服务和采购校验等案例,说明不同扩展路径的适用场景与实现方法,帮助开发者在三系统景观中合理选

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 293

classification_report进阶:针对top-k的结果计算precision@k、recall@k、f1-score@k

sklearn自带的classification_report方法可以针对二分类或多分类问题,计算分类器的precision、recall和f1-score。 示例: from sklearn.metrics import classification_report y_true=[0,1,2,2,0] y_pred=[1,0,2,1,1] print(classification_repo...

dipizhong7224的博客 1万+

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

scikit-learn------classification_report简介

sklearn中的classification_report函数用于显示主要分类指标的文本报告.在报告中显示每个类的精确度,召回率,F1值等信息。 主要参数: y_true:1维数组,或标签指示器数组/稀疏矩阵,目标值。 y_pred:1维数组,或标签指示器数组/稀疏矩阵,分类器返回的估计值。 labels:array,shape = [n_labels],列表,需要评估的标签名称。 target...

Famidlistimo的博客 2032

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Spark2.0机器学习系列之7:多类分类问题(方法归总和分类结果评估)

One-vs-Rest classifier将只能用于二分问题的分类方法扩展到多类Spark中那些方法可以用于多类分类多类分类结果评估(MulticlassClassificationEvaluator类) 在前面一篇文章里面介绍的关于二分问题的评估方法,部分评估方法可以延伸到多类分类为问题。这些概念可以参考 下面的文章: (http://blog.youkuaiyun.com/qq_34531825/a

qq_34531825的博客 6548

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

多分类模型评估:混淆矩阵与分类报告协同诊断实战

多分类模型评估不仅是计算准确率,更是对模型决策逻辑与业务风险的深度诊断。其核心原理在于:混淆矩阵揭示错误流向,分类报告将原始数据转化为Precision、Recall等可解释指标;二者结合才能规避平均值掩盖小类缺陷、高准确率隐藏致命误判等技术陷阱。该方法具备显著技术价值——支撑医疗分诊的漏诊防控、金融风控的欺诈识别、工业质检的缺陷归因等高容错场景。本文聚焦真实项目中反复验证的协同分析路径,深度融合混淆矩阵热力图可视化与classification_report加权/宏平均对比,帮助工程师从‘跑出指标’迈向‘

abxlep7702的博客 354

机器学习笔记,使用metrics.classification_report显示精确率,召回率,f1指数

sklearn中的classification_report函数用于显示主要分类指标的文本报告.在报告中显示每个类的精确度,召回率,F1值等信息。主要参数:y_true:1维数组,或标签指示器数组/稀疏矩阵,目标值。y_pred:1维数组,或标签指示器数组/稀疏矩阵,分类器返回的估计值。labels:array,shape = [n_labels],报表中包含的标签索引的可选列表。tar...

weixin_30527423的博客 344

c++实现决策树分类汽车评估数据集_R语言比较机器学习分类方法的预测结果以及模型优缺点对比...

咕咕了那么久的第二篇,实在抱歉。本篇是续上一篇的内容:R语言实现分类算法 - https://zhuanlan.zhihu.com/p/99848813首先是建立评估模型准确性的函数(在网上找的)performance <- function(table,n=2){ if(!all(dim(table)==c(2,2))) stop('Must be a 2×2 table')...

weixin_30146171的博客 342

FiftyOne 分类模型评估功能(Classification)

使用 FiftyOne 的。

askein的博客 1166

深入解析 Emotion English DistilRoBERTa-base 模型的性能评估与测试方法

在当今的文本分析领域,情感分类是一个至关重要的任务,它能够帮助我们理解和处理人类情感。Emotion English DistilRoBERTa-base 模型作为一款强大的情感分类工具,其性能评估和测试方法显得尤为重要。本文将详细介绍该模型的评估指标、测试方法、测试工具以及结果分析,旨在为研究人员和开发者提供一个全面的理解和参考。 ## 主体 ### 评估指标 评估模型的性能,我们通常关注...

gitblog_02892的博客 1007
上一篇: 学习朴素贝叶斯算法的5个简单步骤
下一篇: 数据标准化的方法
DataCastle
博客等级 码龄10年 870粉丝 202原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值