(1)单层感知机

单层感知机(Single Layer Perceptron)详解 本文着重阐述单层感知机的结构、损失函数构造、梯度的推导与模型训练方法。 阅读详情

1. 概念介绍:

假设输入空间(特征空间)是 X \subseteq R^{n},输入空间是Y={+1,-1}. 输入x\in X 表示实例的特征向量,对于应于输入空间(特征空间)的点;输出y\in Y表示实例的类别.由输入空间到输出空间的如下函数:

                                                                        \large f(x)=sign(w\cdot x+b)


称为感知机。其中,w和b为感知机模型参数,w\in R^{n}叫做权值或者权值向量,b\in R叫做偏置,w\cdot x表示w和x的内积,sign是符合函数,即

                                                                       sign(x)=\left\{\begin{matrix} +1, \quad x \geq 0\\ -1, \quad x<0 \end{matrix}\right.

感知机一种线性分类模型,属于判别模型。

单层感知机形象化理解:

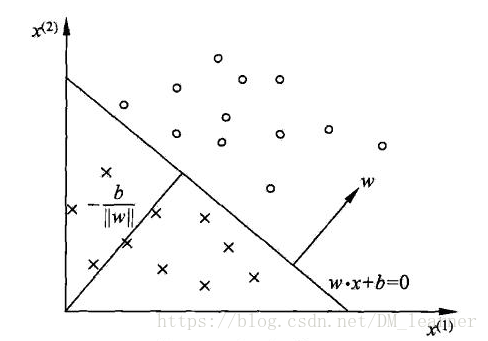
感知机的几何解释:线性方程

                                                                           \large w\cdot x+b=0

对应于特征空间的R^{^{n}}中的一个超平面S,其中w是超平面的法向量,b是超平面的截距,这个超平面将特殊空间划分为两部分,位于两部分的点(特征向量)分别被分为正、负两类。因此,超平面S成为分离超平面,如图所示:


2. 感知机的学习策略

2.1关于数据集的线性可分性

定义(数据集的线性可分性)给定一个数据集 T=\left \{ (x_{1},y_{1}),(x_{2},y_{2}),...,(x_{N},y_{N}) \right \},其中x\in X=R^{^{n}},y_{i}\in Y=\left \{ +1,-1 \right \},\quad i=1,2,...,N,如果存在某个超平面S能够将数据集的正实例点和负实例点完全正确地划分到超平面的两侧,即对于所有的y_{i}=+1的实例i,都有w\cdot x_{i}+b>0,对所有的y_{i}=-1的实例i,有w\cdot x_{i}+b<0,则称数据集T线性可分数据集,否则,称数据集T线性不可分。

2.2感知机的学习策略

假设训练数据集是线性可分的,感知机学习目标的要求是求得一个能够将训练集正实例点和负实例点完全分开的分离超平面。为了找到这样的超平面,需要知道感知机模型参数w和b,需要确定一个学习策略,即定义经验损失函数(R_{emp}(f)=\frac{1}{N}L(y_{i},f(x_{i})))并将损失函数极小化。

损失函数的一个自然选择是误分类点的总数,但是,这样的损失函数不是参数w和b的连续损失函数,不易优化。我们需要转变思路,可以使用误分类点到超平面的总距离来计算损失函数。思路如下:

首先写入输入空间R^{n}中任一点x_{0}到超平面的距离:

                                                                              \large \frac{1}{\left \| w \right \|}\left | w\cdot x_{0}+b \right |  

这里,\left \|w \right \|是w的L_{2}的范数。

对于正确分类的点满足y_{i}(w\cdot x_{i}+b)>0,而对于那些误分类的数据(x_{i},y_{i})来说,满足-y_{i}(w\cdot x_{i}+b)>0,因为误分类点线性不可能,那么误分类点x_{i}到超平面S的距离为:

                                                                           \large -\frac{1}{\left \| w \right \|}y_{i}\left (w\cdot x_{0}+b \right )

这样,假设超平面S的误分类点的集合为M,那么所有的误分类点到超平面S的总距离为

                                                                           \large -\frac{1}{\left \| w \right \|} \sum_{x_{i}\in M}^{ } y_{i}\left (w\cdot x_{i}+b \right )

不考虑\frac{1}{\left \| w \right \|},就得到感知机学习的损失函数。

给定训练数据集

                                                                 \large T=\left \{ (x_{1},y_{1}),(x_{2},y_{2}),...,(x_{N},y_{N}) \right \}

其中,x\in X=R^{^{n}},y_{i}\in Y=\left \{ +1,-1 \right \},\quad i=1,2,...,N,感知机sign(w\cdot x+b)学习的损失函数定义为

                                                                   \large L(w,b)=- \sum_{x_{i}\in M}^{ } y_{i}\left (w\cdot x_{i}+b \right )

其中M为误分类点的集合,这个损失函数就是感知机学习的经验风险函数。

\large \Rightarrow损失函数L(w,b)是非负的,如果没有误分类点,损失函数值是0,而且,误分类点越少,误分类点离超平面的就越近,损失函数值就越小。一个特定的样本点的损失函数:在误分类时是参数为w,b的线性函数,在正确分类时0,因此,给定训练数据集T,损失函数L(w,b)是w,b的连续可导函数。

\Rightarrow感知机学习的策略就是在假设空间中选取损失函数式最小的模型参数w,b,即感知机模型。


2.3 感知机学习算法

2.3.1 感知机学习算法的原始形式

感知机学习算法是对以下最优化问题的算法,给定一个训练数据集

                                                                 \large T=\left \{ (x_{1},y_{1}),(x_{2},y_{2}),...,(x_{N},y_{N}) \right \}

其中,x\in X=R^{^{n}},y_{i}\in Y=\left \{ +1,-1 \right \},\quad i=1,2,...,N,求参数w和b,使其为以下损失函数极小化问题的解

                                                                  \large \min_{w,b}^{ }L(w,b)=-\sum_{x_{i}\in M}^{ }y_{i}(w\cdot x_{i}+b) \quad \quad (2.5)         

其中M为误分类点的集合

感知机学习算法是误分类点驱动的,具体采用随机梯度下降算法。首先,任意选取一个超平面w_{0},b,然后用梯度下降算法不断地极小化目标函数(2.5)。极小化过程不是一次使得M中所有误分类点的梯度下降,而是一次随机选取一个误分类点使其梯度下架。

假设误分类点集合M是固定的,那么损失函数L(w,b)的梯度由

                                                                     \triangledown _{w} L(w,b)=-\sum_{x_{i}\in M}^{ }y_{i}x_{i}

                                                                     \triangledown _{b} L(w,b)=-\sum_{x_{i}\in M}^{ }y_{i}

给出。

随机选取一个误分类点(x_{i},y_{i}),对w,b进行更新:

                                                                      w\leftarrow w+\eta y_{i}x_{i}

                                                                      b\leftarrow b+\eta y_{i}

式中\eta (0< \eta \leq 1)是步长,在统计学习中又称为学习率,这样通过迭代可以期待损失函数L(w,b)不断减小,直到为0.综上所述,可以得到如下算法:

感知机学习算法的原始形式

输入:训练数据集T=\left \{ (x_{1},y_{1}),(x_{2},y_{2}),...,(x_{N},y_{N}) \right \},其中x\in X=R^{^{n}},y_{i}\in Y=\left \{ +1,-1 \right \},\quad i=1,2,...,N;学习率\eta (0< \eta \leq 1);

输出:w,b;感知机模型f(x)=sign(w\cdot x+b)

(1)选取初值w_{0},b_{0}

(2)在训练集中选取数据(x_{i},y_{i})

(3)如果y_{i}(w\cdot x_{i}+b)\leq 0

                                                                      w\leftarrow w+\eta y_{i}x_{i}

                                                                      b\leftarrow b+\eta y_{i}

(4)转至(2),直至训练集中没有误分类点。

例1.如图所示的训练数据集,其正实例点是x_{1}=(3,3)^{\mathrm{T}},x_{2}=(4,3)^{\mathrm{T}}, 负实例点是x_{3}=(1,1)^{\mathrm{T}},试用感知机学习算法的原始形式求感知机模型f(x)=sign(w\cdot x+b).这里,w=(w^{(1)},w^{(2)})^{\mathrm{T}},x=(x^{(1)},x^{(2)})^{\mathrm{T}}.


 解构建最优化问题:

                                                             \min_{w,b}^{ }L(w,b)=-\sum_{x_{i}\in M}^{ }y_{i}(w\cdot x_{i}+b)

按照感知机学习算法的原始形式,求解w,b。这里\eta=1.

(1)去初值w_{0}=0,b_{0}=0

(2)对x_{1}=(3,3)^{\mathrm{T}},y_{1}(w_{0}\cdot x_{1}+b_{0})=0,未能被正确分类,更新w,b

                                         w_{1}=w_{0}+y_{1}x_{1}=(3,3)^{\mathrm{T}},b_{1}=b_{0}+y_{1}=1

得到线性模型

                                         w_{1}\cdot x+b_{1}=3\cdot x^{(1)}+3\cdot x^{(2)}+1

(3)对于x_{1},x_{2},显然,y_{i}(w_{1}\cdot x_{i}+b_{1})> 0,被正确分类,不修改w,b;

对x_{3}=(1,1)^{\mathrm{T}},y_{3}(w_{1}\cdot x_{3}+b_{1})< 0,被误分类,更新w,b.

                                         w_{2}=w_{1}+y_{3}x_{3}=(2,2)^{\mathrm{T}},b_{2}=b_{1}+y_{3}=0

得到线性模型

                                         w_{2}\cdot x+b_{2}=2\cdot x^{(1)}+2\cdot x^{(2)}

如此继续下去,直到

                                         w_{7}=(1,1)^{\mathrm{T}},b_{7}=-3

\Rightarrow   线性模型:                w_{7}\cdot x+b_{7}=\cdot x^{(1)}+\cdot x^{(2)}-3

\Rightarrow对于所有的数据点y_{i}(w_{7}\cdot x_{i}+b_{7})> 0,即没有误分类点,损失函数达到极小。

分离超平面为                    x^{(1)}+\cdot x^{(2)}-3=0

感知机模型为                   f(x)=sign(x^{(1)}+x^{(2)}-3)


代码如下:

#!usr/bin/env python3

#coding=utf-8

import numpy as np

import matplotlib.pyplot as plt

import matplotlib.animation as animation


"感知机的原始形式"

x=np.array([[3,3],[4,3],[1,1]]) #建立数据集,共是三个实例

y=np.array([1,1,-1]) #创建标签

store=[]

w=np.array([0, 0])

b=0 #初始化参数w,b

k=0 #k计算迭代次数

learnrate=1 #设置学习率为1

condition=True

while condition:

    count=0

    for i in range(len(x)):

        if y[i]*(np.dot(w,x[i].T)+b)<=0:        #用来检测误分类

            w=w+learnrate*y[i]*x[i].T           #更新w

            b=b+learnrate*y[i]                  #更新b

            store.append([w,b])

            count=count+1

            k=k+1

            print('w的值:{0}  b的值:{1}  迭代次数:{2}'.format(w, b, k))

    if count==0:

        k=k+1

        print('w的值:{0}  b的值:{1}  迭代次数:{2}'.format(w, b, k))

        store.append([w,b])

        condition=False

print(store)

fig=plt.figure()

ax=plt.axes(xlim=(-7,7),ylim=(-7,7))

line,=ax.plot([],[],'b',linewidth=3)

label=ax.text([],[],'')

#用来画出是三个实例点

def plot_three_point():

    global x, y, line, label

    plt.axis([-6,6,-6,6])

    p1=plt.scatter(x[0:2,0],x[0:2,1],c='b',marker='o',s=60)

    p2=plt.scatter(x[2,0],x[2,1],c='r',marker='x',s=60)

    plt.grid(True)

    plt.xlabel('x1')

    plt.ylabel('x2')

    plt.legend([p1,p2],['正实例点','负实例点'],loc=1)

    plt.rcParams['font.sans-serif'] = ['SimHei']

    plt.rcParams['axes.unicode_minus'] = False

    plt.title('感知机迭代过程图')

    return line,label

#画出动态的图形

def animate(index):

    global store,ax,line,label

    w=store[index][0]

    b=store[index][1]

    if w[1]==0:

        return line,label

    x1=-6

    y1=-(b+w[0]*x1)/w[1]

    x2=6

    y2=-(b+w[0]*x2)/w[1]

    line.set_data([x1,x2],[y1,y2])

    x1=0

    y1=-(b+w[0]*x1)/w[1]

    label.set_text("w:{}".format(str(store[index][0])) + '  ' +"b:{}".format(str(b)))

    label.set_position([x1,y1])

    return line,label

ani=animation.FuncAnimation(fig,animate,init_func=plot_three_point,frames=len(store),interval=1000,repeat=True,blit=True)

plt.show()

ani.save('perceptron.gif',fps=200,writer='imagemagick')

2.3.2  算法的收敛性

关于线性可分数据集感知机学习算法原始形式收敛问题,我们可以转换为即通过有限次迭代可以得到一个将训练数据集完全正确划分的分离超平面及感知机模型。

为了便于推导,在这里我们将偏置b并入权重向量w,记作\widehat{w}=(w^{\mathrm{T}},b)^{\mathrm{T}},同样也将输入向量加以扩充,加进常数1,记作\widehat{x}=(x^{\mathrm{T}},1)^{\mathrm{T}}。这样,\widehat{x}\in R^{n+1},\widehat{w}\in R^{n+1}。显然, \widehat{w}\cdot \widehat{x}=w\cdot x+b

  • 定理:设训练数据集T=\left \{ (x_{1},y_{1}),(x_{2},y_{2}),...,(x_{N},y_{N}) \right \}是线性可分的,其中x\in X=R^{^{n}},y_{i}\in Y=\left \{ +1,-1 \right \},\quad i=1,2,...,N,则有

(1)存在满足条件\left \| \widehat{w}_{opt} \right \|=1的超平面\widehat{w}_{opt}\cdot \widehat{x}=w_{opt} \cdot x+b_{opt}=0将训练数据集完全正确分开;且存在\gamma>0,对所有i=1,2,...,N,  则有

                                                                  y_{i}(\widehat{w}_{opt}\cdot \widehat{x_{i}})=y_{i}(w_{opt} \cdot x_{i}+b_{opt})\geq \gamma \quad \quad \quad \quad \quad \quad \quad \quad(2.8)

(2)令    \small R=\max_{1\leq i\leq N}^{ }\left \| \widehat{x_{i}} \right \|  ,感知机学习算法的原始形式在误分类次数k满足不等式

                                                                                       \small k\leq \left ( \frac{R}{r} \right )^{2} \quad \quad \quad \quad \quad \quad \quad \quad \quad \quad \quad \quad \quad \quad \quad (2.9)


   证明如下图所示:

证明(1)


 证明(2)


2.3.3  感知机学习算法的对偶形式

对偶形式的基本思想:将w和b表示为实例\small x_{i}和标记\small y_{i}的线性组合形式,通过求解其系数而求得w和b。不失一般性,在感知机学习算法的原始形式中,可初始化\small w_{0},b_{0}均为0,对于误分类点(x_{i},y_{i})通过

                                                                         w\leftarrow w+\eta y_{i}x_{i}

                                                                         b\leftarrow b+\eta y_{i}

逐步修改w,b,设修改n次,则w,b关于(x_{i},y_{i})的增量分别是\large \alpha y_{i}x_{i}和\large \alpha y_{i},这里\large \alpha_{i} =n_{i}\eta。这样,从学习过程不难看出,最后学习到的w,b可以分别表示为

                                                                        \large w=\sum_{i=1}^{N}\alpha_{i}y_{i}x_{i} \quad \quad \quad \quad \quad \quad \quad \quad \quad (2.14)

                                                                        \large b=\sum_{i=1}^{N}\alpha_{i}y_{i} \quad \quad \quad \quad \quad \quad \quad \quad \quad \quad(2.15) 

这里,\alpha \geq 0,i=1,2,...,N,当\eta=1时,表示第i个实例点由于误分而进行更新的次数。实例点更新次数越多,意味着它距离分离超平面越近,也就越难正确分类。换句话说,这样的实例对学习结果影响最大。

感知机学习算法的对偶形式

输入:线性可分的数据集T=\left \{ (x_{1},y_{1}),(x_{2},y_{2}),...,(x_{N},y_{N}) \right \},其中x\in X=R^{^{n}},y_{i}\in Y=\left \{ +1,-1 \right \},\quad i=1,2,...,N;学习率\eta (0< \eta \leq 1);

输出:\alpha,b;感知机模型     f(x)=sign(\sum_{j=1}^{N}\alpha _{j}y_{j}x_{j}\cdot x+b)

其中,\alpha =(\alpha _{1},\alpha_{2} ,...,\alpha _{N})^{\mathrm{T}}.

(1)\alpha \leftarrow 0, b\leftarrow 0

(2)在训练集中选取数据(x_{i},y_{i})

(3)如果    y_{i}(\sum_{j=1}^{N}\alpha _{j}y_{j}x_{j}\cdot x_{i}+b)\leq 0,执行

                                                              \alpha _{i} \leftarrow \alpha_{i} +\eta

                                                              b\leftarrow b+\eta y_{i}                                                            

(4)转至(2)直到没有误分类数据

对偶形式中训练实例仅以内积的形式出现,为了方便,可以预先将训练集中的实例间的内积计算出来并以矩阵的形式存储,这个矩阵就是所谓的Gram矩阵

                                                             G=\left [x_{i}\cdot x_{j} \right ]_{N\times N}

例2.数据同例1,正样本点是x_{1}=(3,3)^{\mathrm{T}},x_{2}=(4,3)^{\mathrm{T}},负样本点是x_{3}=(1,1)^{\mathrm{T}},试用感知机学习算法对偶形式求感知机模型。

解 按照感知机算法对偶形式求感知机模型

(1)取\alpha _{i}=0,i=1,2,3,b=0,\eta =1

(2)计算Gram矩阵

                                                         G=\left[ \begin{matrix} 18 & 21 & 6 \\ 21 & 25 & 7 \\ 6 & 7 & 2 \end{matrix} \right]

(3)误分条件

                                                         y_{i}(\sum_{j=1}^{N}\alpha _{j}y_{j}x_{j}\cdot x_{i}+b)\leq 0

参数更新

                                                         \alpha _{i}\leftarrow \alpha _{i}+1,\quad b\leftarrow b+y_{i}

(4)经过多次迭代和更新\alpha _{i},b值可以得到最终结果

                                                          w=2x_{i}+0x_{2}-5x_{3}=(1,1)^{\mathrm{T}}

                                                           b=-3

分离超平面

                                                           x^{(1)}+x^{(2)}-3=0

最终得到感知机模型

                                                          f(x)=sign(x^{(1)}+x^{(2)}-3)


运行的代码如下所示:

#!usr/bin/env python3
#coding=utf-8
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.animation as animation

"感知机的对偶形式"
x=np.array([[3,3],[4,3],[1,1]]) #建立数据集,共是三个实例
y=np.array([1,1,-1]) #创建标签
list_1=[] #用于存储w,b参数
list=[] #用于存储变化的alpha,b值

gramMatrix=x.dot(x.T)
alpha=np.zeros(len(x))
b=0 #参数b初始化
k=0 #k计算迭代次数
learnrate=1 #设置学习率为1
condition=True
while condition:
    count=0
    for  i in range(len(x)):
        if y[i]*(np.sum(alpha*y*gramMatrix[i])+b)<=0:
            alpha[i]=alpha[i]+learnrate
            b=b+learnrate*y[i]
            list_1.append([(alpha*y.T).dot(x),b])
            list.append([np.array(alpha),b])
            print(alpha)
            k=k+1
            count=count+1
            print('alpha:{0} b:{1} k:{2}'.format(alpha, b, k))
    if count==0:
        condition=False
#print(list_1)
#print(list)

fig=plt.figure()
ax=plt.axes(xlim=(-7,7),ylim=(-7,7))
line,=ax.plot([],[],'b',linewidth=3)
label=ax.text([],[],'')

#用来画出是三个实例点
def plot_three_point():
    global x, y, line, label
    plt.axis([-6,6,-6,6])
    p1=plt.scatter(x[0:2,0],x[0:2,1],c='b',marker='o',s=60)
    p2=plt.scatter(x[2,0],x[2,1],c='r',marker='x',s=60)
    plt.grid(True)
    plt.xlabel('x1')
    plt.ylabel('x2')
    plt.legend([p1,p2],['正实例点','负实例点'],loc=1)
    plt.rcParams['font.sans-serif'] = ['SimHei']
    plt.rcParams['axes.unicode_minus'] = False
    plt.title('感知机对偶形式迭代过程图')
    return line,label

#画出动态的图形
def animate(index):
    global list_1,ax,line,label
    w=list_1[index][0]
    b=list_1[index][1]
    if w[1]==0:
        return line,label
    x1=-6
    y1=-(b+w[0]*x1)/w[1]
    x2=6
    y2=-(b+w[0]*x2)/w[1]
    line.set_data([x1,x2],[y1,y2])
    x1=0
    y1=-(b+w[0]*x1)/w[1]
    label.set_text("alpha:{}".format(str(list[index][0])) + '  ' +"b:{}".format(str(b)))
    label.set_position([x1,y1])
    return line,label
ani=animation.FuncAnimation(fig,animate,init_func=plot_three_point,frames=len(list_1),interval=1000,repeat=True,blit=True)
plt.show()
ani.save('perceptron_dual_form.gif',fps=200,writer='imagemagick')



深度学习笔记(一)——感知机模型(Perceptron Model) 感知机,也叫单层神经网络,是最基础的神经网络模型结构。 阅读详情

相关推荐

Python深度学习笔记第二周——感知机

感知机 基本概念描述 和我们学过的数字电路的知识相同,感知机可以接收多个输入信号并且输出一个信号。并且,信号有0/1两种形式。 举个小栗子来体现感知机的运行原理: x1,x2为输入的两个信号,y1为输出的信号,w1和w2分别是两个输入信号所占的权重,我们定义一个阈值(界限),观察x1w1+x2w2的值与阈值(θ)的关系: x1w1+x2w2≤θ---->输出0 x1w1+x2w2>θ---->输出1 阈值这里和图像处理里面的二值化很相似。同时,我们将输出为1称作神经元被激活。 PS:感知

frank______123的博客 1054

单层感知机模型及其学习算法

感知机模型及其学习算法分析

Morefree_AI的博客 6516

【深度学习的灵魂】单层感知器(MCP人工神经元模型)

在我的第一篇《深度学习的发展历史(深度学习入门、学习指导)-优快云博客》中,介绍了深度学习模型发展的一个全进程。在这一个深度学习历史上最早出现的就是MCP人工神经元模型,这个模型有一个相当有名的算法——感知器(也称为单层感知机本篇文章,我们就来讲一讲这个神经网路\深度学习邻域的老祖宗模型单层感知机是机器学习中最基础的方法之一,其本质和逻辑回归有一定的相似,两者都是接受输入,然后会根据输入返回一个输出(两者的区别在于损失函数激活函数选择不同)。单层感知机选用sign函数作为激活函数,选用。

十二月的猫 4442

【机器学习】简单理解单层感知器

机器学习入门教程:单层感知机 参考文章: 深度学习之(神经网络)单层感知器(python)(一) 超详细!带你走进单层感知器与线性神经网络 一、单层感知机的由来 神经元结构 输入神经元(x):input 传出神经元(y):output 刺激强度(w1,w2,w3) 细胞体自身信号(偏置值b) 单层感知机只有输入层、输出层,没有隐藏层;多层感知机,既有输入层,又有输出层,还有...

IT菜鸟 9044

TwinCAT3实战:从零搭建倍福PLC的Modbus-TCP Server

本文详细介绍了如何使用TwinCAT3从零搭建倍福PLC的Modbus-TCP Server,包括环境准备、工程配置、参数设置、客户端连接测试及常见问题排查。通过实战步骤和实用技巧,帮助工程师快速掌握倍福PLC与Modbus-TCP的通信实现,提升工业自动化项目的开发效率。

weixin_30797199的博客 174

shopee app算法分析第一篇

shopee app算法分析第一篇分析完整算法大概要好几篇,耐心等待下.国内只会发律师函,牛逼,一个律师套话,一个律师发函,大意了(警惕卡通律师头像),希望law可以保护好你,还是干国外好.

2533

Matlab学习笔记 1 单层感知机的简介和组成结构及原理

Matlab 单层感知器的简介和结构及原理

weixin_41918150的博客 657

为什么异或问题对单层感知机是难题

flyfish

二分掌柜的 975

PADS导出PCB正反面丝印为CAD文件的方法

本文介绍如何将PADS绘制的pcb格式的PCB文件顶底层丝印及板框导出为CAD的dxf文件格式,并且将底层丝印进行镜像为正常视角

luguodeyo的博客 3298

Ubuntu快速安装miniconda

以下是卸载anaconda的步骤,记录下来给我自己看,因为学校平台anaconda版本较老,且平台不好用,每次需要卸载anaconda,我记性又不好,所以简单记录下步骤~删除类似这样的行(因为已经卸载成功了,没有截图了,拿miniconda来充当一下,样子是很像的)本次安装Ubuntu版本:18.04 但是miniconda版本是最新的。退出编辑,输入命令,清除索引缓存,保证用的是镜像站提供的索引。直接复制粘贴清华源的索引(如果是第一次安装,这个文件是空的)重启终端出现(base)2.初始化conda。

xiang_muran的博客 5368

第四周---感知机跟多层感知机

先读出蓝色分类器的结果在读出黄色分类器的结果,最后得出灰色分类器的结果。最后的输出我们需要计算softmax函数值。(后续迭代继续,直到所有样本被正确分类)循环执行直到所有训练样本被正确分类。​:W1​∈Rm×n(m*n的矩阵)​:x∈Rn (n*1的矩阵)单隐藏层:隐藏层的大小是超参数。算法等价于使用批量大小为 ​。​(因参数变化需再验证)以上算法核心的步骤为。

weixin_46160157的博客 741

llama.cpp 参数调优大全(4060 最优配置)

本文针对NVIDIA RTX 4060(8GB显存)显卡,提供了llama.cpp参数调优的实战指南。核心策略是采用小模型(7B/8B)配合Q4_K_M量化,通过合理设置GPU层数(-ngl 28)、上下文长度(-c 2048)和批量大小(-b 512)来平衡性能和显存占用。重点推荐启用flash-attn加速和mlock内存锁定,并给出标准、高性能和保守三种配置方案。调优优先级为:GPU利用率>吞吐量>显存>线程数,同时警示避免常见错误如过大上下文或GPU层数设置。最终推荐4060最佳配置为7B Q4_

刘一说的IT专栏 3410

深度学习(十四)——感知机

单层感知机 b=w0*x0,其中x0=1 多层感知机

weixin_43633568的博客 159

YOLOv11【第六章:模型压缩与极致优化篇·第4节】Lamp 剪枝算法:无需超参的自动化剪枝策略!

🏆 本文收录于专栏 《YOLOv11实战:从入门到深度优化》。本专栏围绕 YOLOv11 的改进、训练、部署与工程优化 展开,系统梳理并复现当前主流的 YOLOv11 实战案例与优化方案,内容目前已覆盖 分类、检测、分割、追踪、关键点、OBB 检测 等多个方向。

**My Coding Family** 1217

2025年5月架构设计师论文真题回顾,附写作技巧、所涉知识点及参考范文(三)

本文主要回顾2025年上半年(2025-5-24)系统架构设计师考试下午论文的题目,同时附带写作技巧、所涉知识点及参考范文。试题三:多模型数据库及应用。

一几文的编程学习笔记。 634

tensorflow 训练权重不更新_TensorFlow学习Program1——15.权重和偏置更新要点、单层感知机、反向传播算法BPN...

写在前面:关于权重和偏置更新权重W更新采用+或-的两种情况可以很明显看到,关于权重更新存在2种情况,本质没什么区别,只不过在自己写代码手动更新权重和偏置时,这点就很容易混淆出错。本帖第一个单层感知机示例,采用第一种方式;第二个BPN示例,采用第二种方式;通常情况下,推荐采用第二种。因为一般数学推导中都是写成W=W-dW,这样就和以前的帖子一致<线性回归、逻辑回归与正则化>,避免以后自我...

weixin_39564510的博客 1248

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

深度学习pytorch——感知机(Perceptron)(持续更新)

感知机是由美国学者FrankRosenblatt在1957年提出来的。感知机是作为神经网络(深度学习)的起源的算法。因此,学习感知机的构造也就是学习通向神经网络和深度学习的一种重要思想。感知机接收多个输入信号,输出一个信号。这里所说的“信号”可以想象成电流或河流那样具备“流动性”的东西。像电流流过导线,向前方输送电子一样,感知机的信号也会形成流,向前方输送信息。但是,和实际的电流不同的是,感知机的信号只有“流/不流”(1/0)两种取值。这里我们认为0对应“不传递信号”, 1对应“传递信号”。

2201_76139143的博客 899

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

深度学习---感知机

感知机是什么 简单逻辑电路 感知机的实现 感知机的局限性 多层知感机 1.感知机 感知机接受多个信号,输出一个信号(感知机的信号只对应1/0两种情况) x1,x2为输入信号,w1.w2为一开始给定的权重,y为输出的信号,每个圈为一个神经元,神经元会计算传送过来的信号的总和,只有当这个总和超过了某个界限值时,才会输出 1。这也称为“神经元被激活”。这里将这个界限值称为阈值,用符号θ...

CalbisLiveLikeThe_的博客 353

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

深度学习起源的算法---感知机

感知机是一种接收多个输入信号并输出0/1值的算法。感知机通过权重控制信号重要性,偏置调整激活阈值。单层感知机能实现与门、或门等线性可分逻辑电路,但无法表示异或门。通过组合两层感知机(如与非门和或门相与)可解决非线性问题。文中用Python实现了几种基本逻辑门,展示了参数调整如何改变感知机行为,并指出多层感知机理论上能模拟计算机功能。

m0_58724126的博客 690

杂项

L2 (w^2)正则化导数是2*w,到后期变化是比较平缓的,很难达到0 L1 (|w|) 正则化导数是1,到后期会震荡,有可能会把权重压到0 如果权重为0了,网络梯度消失无法训练,所以神经网络一般用L2, dropout 是在当前批次中随机的抑制神经元,让其不参与训练。在测试网络时,要调用evel(),不做神经元抑制 ...

kfyong的专栏 274

深度学习----多层感知机

感知器 多层感知机

凡夫俗子lb 682

深度学习入门|第二章 感知机

感知机 前言 此为本人学习《深度学习入门》的学习笔记 一、感知机是什么 感知机接受多个输入信号,输出一个信号。感知机的信号只有“流/不流“(1/0)两种取值,0对应不传递信号,1对应传递信号。 图2-1 有两个输入的感知机 神经元会计算传送过来的信号的总和,只有当这个总和超过了某个界限值时,才会输出 1。这也称为“神经元被激活”。这里将这个界限值称为阈值,用符...

weixin_30699741的博客 291

Chapter2 感知机(perception)

基本原理 感知机接收多个信号,输出一个信号,信号只有0和1两种取值。 图中圆圈为神经元 改变权重和阈值的值即可实现门电路 与 与非 或 或非 均可实现 区别仅在于参数值 引入权重和偏置 具体实现与门 单层感知机的局限性 只能线性划分(w1x1+w2x2+b),无法解决异或门 多层感知机(mlp) 用与 与非 或 可实现异或 ...

joshuani的博客 143

深度学习入门:基于Python的理论与实现——学习笔记1

感知机

w2463069311的博客 389

深度学习入门:基于Python的理论与实现2感知机PLA

感知机:接收多个输入信号。 权重(w)、偏置(b):前者控制输入信号,后者调整神经元被激活的容易程度,超过|b|则被激活。 单层感知机、多层感知机:前者无法分离非线性空间与异或门。 ......

weiyusi的博客 359
上一篇: 决策树
下一篇: anaconda和tensorflow的安装
DM_learner
博客等级 码龄9年 21粉丝 23原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值