


第41章 并发(Concurrency)
目录
41.2.2 指令重排(Instruction Reordering)
41.3.2 标识和阻隔(Flags and Fences)
41.3.2.1 atomic标识(atomic Flags)
41.1 引言(Introduction)
并发——即同时执行多个任务——被广泛用于提高吞吐量(通过使用多个处理器进行单个计算)或提高响应速度(通过允许程序的一部分继续执行,而另一部分等待响应)。
§5.3 以教程的方式介绍了 C++ 标准对并发的支持。本章和下一章将提供更详细、更系统的观点。
我们将可能与其他活动并发执行的活动称为任务(task)。线程是计算机执行任务的系统层表示。标准库thread(§42.2)可以执行任务。线程可以与其他线程共享地址空间。也就是说,同一地址空间中的所有线程都可以访问相同的内存位置。并发系统开发的程序员面临的核心挑战之一是确保线程以合理的(sensible)方式访问内存。
标准库对并发的支持包括:
• 内存模型:一组保证并发访问内存的机制(§41.2),它基本确保简单普通的访问能够按照人们通常的预期运行。
• 无锁编程支持:避免数据竞争的细粒度底层机制(§41.3)
• 线程库:一组支持传统线程与锁风格的系统级并发编程的组件,例如thread, condition_variable , 和mutex (§42.2)
• 任务支持库:一些支持任务级并发编程的工具:future,promise,packaged_task 和 async()(§42.4) 。
这些主题按从最基础、最底层到最上层的顺序排列。内存模型是所有编程的通用模型。为了提高程序员的效率并最大限度地减少错误,应尽可能在最上层级上进行工作。例如,在交换信息时,优先使用 future 而不是mutex锁;除了简单的计数器等操作之外,其他任何操作都应使用mutex而不是atomic操作。尽可能将复杂性留给标准库的实现者。
在 C++ 标准库的语境中,一个锁(lock)是指mutex(一个互斥访问的变量)以及任何基于一个mutex构建的抽象,用于提供对资源的互斥访问或同步多个并发任务的进度。
本书并未探讨进程这一主题,即在各自地址空间中执行并通过进程间通信机制进行通信的线程[Tanenbaum,2007]。我猜想,在阅读了有关共享数据的问题及管理技术之后,你可能会认同我的观点,即最好避免显式共享数据。当然,通信必然包含某种形式的共享,但这种共享通常无需由应用程序员直接管理。
另请注意,只要你不将指向本地数据的指针传递给其他线程,你的本地数据就不会出现此处提到的问题。这也是避免使用全局数据的另一个原因。
本章并非并发编程的全面指南,甚至也不是对 C++ 标准库中并发编程功能的完整解释。它仅提供以下内容:
• 对程序员在系统层面处理并发问题时面临的基本描述;
• 对标准提供的并发功能进行较为详细的概述;
• 介绍标准库并发特性在线程和锁级别及以上的基本用法:
它不包含以下内容:
• 放宽内存模型或无锁编程的细节;
• 教授高级并发编程和设计技巧。
并发和并行(parallel)编程一直是热门的研究课题,并已广泛应用超过 40 年,因此积累了大量的专业文献(例如,关于基于 C++ 的并发编程,参见 [Wilson,1996])。特别是,几乎任何 POSIX 线程的实现都可以作为示例的来源,并且可以通过使用此处描述的标准库功能轻松改进这些示例。
与 C 风格的 POSIX 机制以及许多较旧的 C++ 线程支持库不同,标准库的线程支持是类型安全的。因此,不再需要使用宏或 void** 来在线程间传递信息。同样,我们可以将任务定义为函数对象(例如 lambda 表达式),并将其传递给线程,而无需使用类型转换或担心类型冲突。此外,也无需发明复杂的线程间错误报告约定;future(§5.3.5.1,§42.4.4)可以传递异常。鉴于并发软件通常很复杂,并且运行在不同线程中的代码通常是独立开发的,我认为类型安全和标准的(最好是基于异常的)错误处理策略对于并发软件而言比对于单线程软件更为重要。标准库的线程支持也极大地简化了代码的表示法。
41.2 内存模型(Memory Model)
C++ 并发机制大多以标准库组件的形式提供。这些组件依赖于一组被称为内存模型的语言保证。内存模型是机器架构师和编译器编写者之间讨论如何最好地表示计算机硬件的结果。正如 ISO C++ 标准中所规定的,内存模型代表了(编译器)实现者和程序员之间的一种契约,旨在确保大多数程序员不必考虑现代计算机硬件的细节。
要理解其中的问题,请记住一个简单的事实:对内存中对象的操作永远不会直接在对象本身上执行。相反,对象会被加载到处理器寄存器中,在那里进行修改,然后再写回内存。更糟糕的是,对象通常先从主内存加载到高速缓存中,然后再从高速缓存加载到寄存器中。例如,考虑递增一个简单的整数 x :
(译注:下面是伪代码)
// add one to x:
load x into cache element Cx
load Cx into register Rx
Rx=Rx+1;
store Rx back into Cx
store Cx back into x
内存可以由多个线程共享,缓存内存(取决于机器架构)可以在运行于相同或不同“处理单元”(通常称为处理器、内核或超线程等;这方面的系统功能和术语都在快速发展)上的线程之间共享。这使得简单的操作(例如“x 加 1”)很容易出错。机器架构专家显然会发现我在这里做了简化。对于少数注意到我没有提到存储缓冲区的人,我推荐参考 [McKenney, 2012] 的附录 C。
41.2.1 内存位置(Memory Location)
考虑两个全局变量 b 和 c :
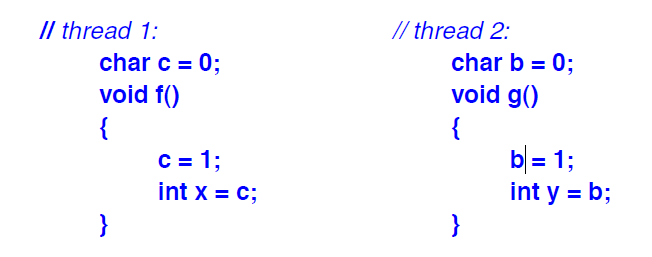
现在,正如大家所料,x==1 且 y==1 。那么,这又有什么意义呢?想想可能发生的事情吧。
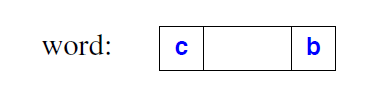
如果没有定义明确且合理的内存模型,线程 1 可能会读取包含 b 和 c 的字,修改 c,然后将该字写回内存。同时,线程 2 也可能对 b 执行相同的操作。那么,哪个线程先读取了该字,哪个线程最后将结果写回内存,将决定最终结果。我们可能会得到 10, 01 或 11( 但不会得到 00 )。内存模型避免了这种混乱;我们得到了 11。之所以不会出现 00,是因为 b 和 c 的初始化(由编译器或链接器完成)在两个线程启动之前就已经完成。
C++ 内存模型保证两个执行线程可以更新和访问不同的内存位置而不会相互干扰。这正是我们理所当然的预期。编译器的职责是保护我们免受现代硬件有时非常奇怪和微妙的行为的影响。编译器和硬件如何协同工作来实现这一点,则取决于编译器。我们编程实现的“机器”是由硬件和非常底层的(编译器生成的)软件共同提供的。
位域(§8.2.7)允许访问字的一部分。如果两个线程同时访问同一个字的两个字段,则所有规则都无法保证。如果 b 和 c 是同一个字的两个字段,大多数硬件在不使用某种形式的(可能非常昂贵的)加锁机制的情况下,无法避免 b 和 c 示例中的问题(竞争条件)。加锁和解锁操作的开销无法隐式地施加到位域上,而位域通常用于关键设备驱动程序。因此,该语言将内存位置定义为排除单个位域以保证合理行为的内存单元。
内存位置可以是算术类型的对象(§6.2.1),也可以是指针,或者是由宽度非零的相邻位域组成的最大序列。例如:
struct S {
char a; // location #1
int b:5; // location #2
unsigned c:11;
unsigned :0; // note: :0 is ‘‘special’’ (§8.2.7)
unsigned d:8; // location #3
struct { int ee:8; } e; // location #4
};
这里,S 恰好有四个独立的内存位置。不要尝试在没有显式同步的情况下从不同的线程更新位域 b 和 c。
根据以上解释,你可能会得出结论:如果 x 和 y 是同一类型,那么 x=y 必然导致 x 是 y 的副本。这仅在不存在数据竞争(§41.2.4)且 x 和 y 是内存地址时才成立。然而,如果 x 和 y 是多字结构体,它们就不是同一个内存地址。如果存在数据竞争,所有行为都是未定义的。因此,如果共享数据,请确保已采取适当的同步措施(§41.3,§42.3.1)。
41.2.2 指令重排(Instruction Reordering)
为了提升性能,编译器、优化器和硬件会对指令进行重排。请考虑以下几点:
// thread 1:
int x;
bool x_init;
void init()
{
x = initialize(); // 在初始化中未使用 x_init
x_init = true;
// ...
}
对于这段代码,并没有明确说明为什么要在给 x_init 赋值之前先给 x 赋值。优化器(或硬件指令调度器)可能会为了加快程序运行速度而先执行 x_init=true。
我们原本可能想用 x_init 来指示 x 是否已被 initializer() 初始化。然而,我们并没有明确说明这一点,因此硬件、编译器和优化器都不知道。
向程序中添加另一个线程:
// thread 2:
extern int x;
extern bool x_init;
void f2()
{
int y;
while (!x_init) // if necessary, wait for initialization to complete
this_thread::sleep_for(milliseconds{10});
y = x;
// ...
}
现在我们遇到了一个问题:线程 2 可能永远不会等待,因此会将未初始化的 x 赋值给 y。
即使线程 1 没有“错误地”设置 x_init 和 x,我们仍然可能会遇到问题。在线程 2 中,没有对 x_init 进行赋值,因此优化器可能会决定将 !x_init 的计算移出循环,导致线程 2 要么永远不会休眠,要么会一直休眠下去。
41.2.3 内存序(Memory Order)
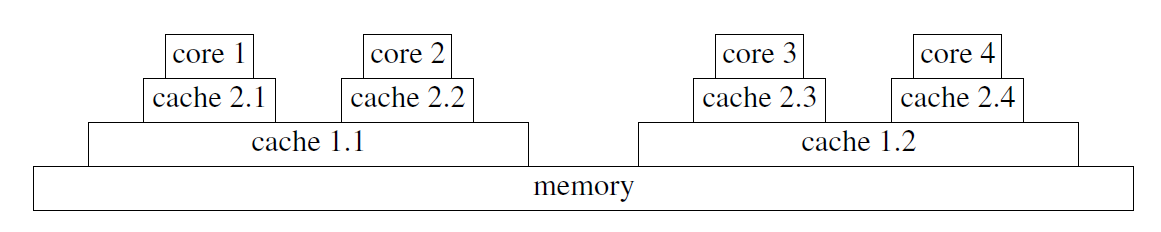
将一个字的值从内存加载到缓存,然后再加载到寄存器中,所需的时间(在处理器的时间尺度来看)可能非常长。理想情况下,可能需要执行 500 条指令才能将值加载到寄存器中,然后再执行 500 条指令才能将新值加载到其目标位置。500 这个数字只是一个估计值,它取决于机器架构,并且会随时间变化,但在过去几十年中,这个数字一直在稳步增长。当计算针对吞吐量进行了优化,因此无需急于加载和存储特定值时,所需的时间可能会更长。一个值可能在数万个指令周期内“远离其目标位置”。这正是现代硬件拥有惊人性能的原因之一,但也带来了巨大的混乱风险,因为不同的线程会在不同的时间、不同的内存层次结构位置访问同一个值。例如,我简化的描述只提到了单级缓存;许多流行的架构都使用三级缓存。为了说明这一点,下图展示了一种可能的两级缓存架构,其中每一个核心都有自己的二级缓存,一对核心共享一级缓存,所有核心共享内存:
内存序是用于描述程序员可以假设的当一个线程从内存观察一个值时其可以看到的内容的术语。最简单的内存顺序称为顺序一致性。在顺序一致性内存模型中,每个线程看到的都是按相同顺序执行的每一个操作的结果。这种顺序就像指令在单个线程中按顺序执行一样。线程仍然可以重新排列操作顺序,但在任何其他线程可能观察到某个变量的点上,之前执行的操作集合(以及由此产生的)所观察到的内存位置的值必须定义明确,并且对于所有线程都是相同的。能够“观察”某个值并强制执行内存位置的一致视图之操作称为原子操作(参见§41.3)。简单的读取或写入操作不会强制执行顺序。
对于给定的线程集,存在许多顺序一致的可能执行顺序。例如:
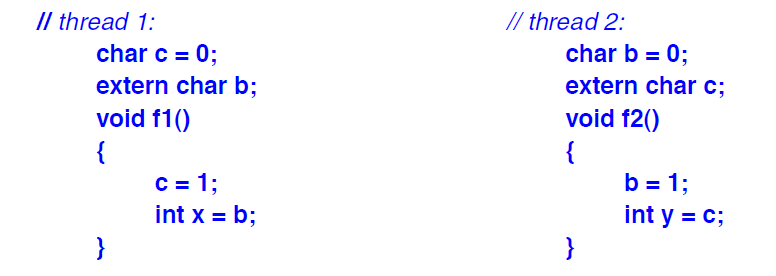
假设 c 和 b 的初始化是静态完成的(在任何线程启动之前),则有三种可能的执行方式:
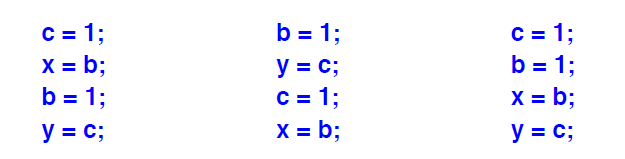
结果分别为 01 , 10 和 11 。唯一无法得到的结果是 00 。显然,要获得可预测的结果,需要对共享变量的访问进行某种形式的同步。
顺序一致性几乎是程序员能够有效推理的全部内容,但在某些机器架构上,它会带来显著的同步开销,而放宽规则可以消除这些开销。例如,运行在不同核心上的两个线程可能会决定在写入 a 和 b 之前,或者至少在写入完成之前,先读取 x 和 y。这可能会导致非顺序一致性的结果 00 。更松散的内存模型允许这种情况发生。
41.2.4 数据竞争(Data Races)
从这些例子可以看出,任何明智的人都会得出结论:在编写线程程序时必须格外小心。那么该如何做呢?首先,我们必须避免数据竞争。如果两个线程可以同时访问同一内存位置(如 §41.2.1 所定义),并且其中至少有一个访问是写操作,则这两个线程之间存在数据竞争。需要注意的是,精确定义“同时”并非易事。如果两个线程之间存在数据竞争,则任何语言保证都无效:其行为是未定义的。这听起来可能有些极端,但数据竞争的影响(如 §41.2.2 所示)确实可能非常严重。优化器(或硬件指令调度器)可能会基于对值的假设重新排列代码,并可能基于这些假设执行或不执行某些代码段(这些代码段可能影响看似无关的数据)。
有很多方式可以避免数据竞争:
• 只使用单线程。这会消除并发的优势(除非使用进程或协程)。
• 对所有可能发生数据竞争的数据项加锁。这会像单线程一样有效地消除并发的优势,因为我们很容易陷入除一个线程外所有线程都在等待的境地。更糟糕的是,大量使用锁会增加死锁的概率,即一个线程永远等待另一个线程,以及其他锁相关的问题。
• 仔细检查代码,并通过选择性地添加锁来避免数据竞争。这可能是目前最流行的方法,但很容易出错。
• 让程序检测所有数据竞争,并报告给程序员修复,或者自动插入锁。能够对商业化的规模和复杂性的程序执行此操作的程序并不常见。能够做到这一点并保证没有死锁的程序还处于研究阶段。
• 设计代码时,应确保线程之间仅通过简单的 put-and-get 式接口进行通信,这样就不需要两个线程直接操作同一个内存位置。(§5.3.5.1,§42.4)。
• 使用更高级别的库或工具,使数据共享和/或并发隐式化,或使其足够规范化,从而便于管理。例如,库中算法的并行实现、基于指令的工具(例如 OpenMP)以及事务内存(通常缩写为 TM )。
理解本章剩余部分的一种方法是采用自下而上的方法,逐步实现对最后一种编程风格的某种变体的支持。在此过程中,我们将遇到几乎所有避免数据竞争方法所需的工具。
为什么程序员必须承受如此复杂的局面?另一种方法是只提供一个简单、顺序一致的模型,尽可能减少(甚至消除)数据竞争的可能性。我给出两个理由:
[1] 事实并非如此。机器架构的复杂性是真实存在的,而像 C++ 这样的系统编程语言必须为程序员提供应对这些复杂性的工具。或许有一天,机器架构师会提供更简单的替代方案,但就目前而言,为了满足客户对性能的要求,程序员必须处理机器架构师提供的各种令人眼花缭乱的底层功能。
[2] 我们(C++ 标准委员会)认真考虑过这一点。我们原本希望提供一个比 Java 和 C# 提供的内存模型更完善的版本。这将为委员会和一些程序员节省大量工作。然而,操作系统和虚拟机提供商实际上否决了这一想法:他们坚持认为,他们需要的内存模型大致相当于当时各种 C++ 实现所提供的内存模型——也就是现在 C++ 标准所提供的内存模型。否则,你们的操作系统和虚拟机运行速度将“降低两倍甚至更多”。我猜想,编程语言的狂热爱好者或许乐于有机会以牺牲其他语言为代价来简化 C++,但这既不实用也不专业。
幸运的是,大多数程序员永远不需要直接接触硬件的底层。大多数程序员根本不需要理解内存模型,他们可以把重排问题看作是有趣的奇闻轶事:
编写无数据竞争的代码,并且不要干扰内存顺序(§41.3);这样,内存模型就能保证代码按预期执行。它甚至比顺序一致性更好。
我发现机器体系结构是一个引人入胜的话题(例如,参见[Hennesey,2011] [McKenney,2012]),但作为理智且高效的程序员,我们会尽可能避免深入软件底层。把那些工作留给专家,尽情享受他们为我们提供的更高层次的编程。
41.3 原子操作(Atomics)
无锁编程是一系列无需显式锁即可编写并发程序的技术。相反,程序员依靠硬件直接支持的基本操作来避免小型对象(通常为单个字或双字)的数据竞争(§41.2.4)。这些不会发生数据竞争的硬件直接支持的基本操作,通常称为原子操作(atomic operations),可以用于实现更上层的并发机制,例如锁、线程和无锁数据结构。
除了简单的原子计数器之外,无锁编程主要面向专业人士。除了对语言机制的理解之外,还需要对特定机器架构有深入的了解,并掌握一些专门的实现技术。切勿仅凭本文提供的信息尝试无锁编程。无锁技术相对于基于锁的技术的主要逻辑优势在于,它不会出现诸如死锁和饥饿之类的经典锁问题。对于每一个原子操作,即使其他线程竞争访问原子对象,也能保证每一个线程最终(通常很快)都能取得进展。此外,无锁技术的速度通常比基于锁的替代方案快得多。
标准的原子类型和操作为表达无锁代码提供了一种可移植的替代方案,取代了传统的无锁代码表达方式。传统的无锁代码表达方式通常依赖于汇编代码或系统特定的原语。从这个意义上讲,对原子操作的标准支持是 C 和 C++ 在增强系统编程的可移植性和相对易理解性方面迈出的又一步。
同步操作是确定一个线程何时看到另一个线程的效果的这样一种东西;它确定了哪些操作视为发生在其他操作之前。在同步操作之间,只要不违反语言的语义规则,编译器和处理器就可以自由地重排代码。原则上,没有人会注意到这种重排,唯一受到影响的是性能。对一个或多个内存位置的同步操作可以是消耗操作、获取操作、释放操作,或者同时是获取和释放操作。(§iso.1.10)
• 对于获取操作,其他处理器会在任何后续操作之前看到它的效果。
• 对于释放操作,其他处理器会在任何后续操作之前看到所有先前操作的效果。
• 消耗操作是获取操作的一种弱化形式。对于消耗操作,其他处理器会在任何后续操作之前看到它的效果,但与消耗操作的值无关的效果可能会在消耗操作之前发生。
原子操作确保内存状态符合指定的内存顺序(§41.2.2)。在默认情况下,内存顺序为 memory_order_seq_cst (顺序一致;§41.2.2)。标准内存顺序如下(§iso.29.3):
enum memory_order {
memory_order_relaxed,
memory_order_consume ,
memory_order_acquire ,
memory_order_release ,
memory_order_acq_rel,
memory_order_seq_cst
};
这些枚举代表:
• memory_order_relaxed:无操作对内存进行排序。
• memory_order_release ,memory_order_acq_rel 和 memory_order_seq_cst:存储操作对受影响的内存位置执行释放操作。
• memory_order_consume:加载操作对受影响的内存位置执行消耗操作。
• memory_order_acquire ,memory_order_acq_rel 和 memory_order_seq_cst:加载操作对受影响的内存位置执行获取操作。
例如,考虑使用原子加载和存储(41.3.1)来表达松散的内存顺序(§iso.29.3):
// thread 1:
r1 = y.load(memory_order_relaxed);
x.store(r1,memory_order_relaxed);
// thread 2:
r2 = x.load(memory_order_relaxed);
y.store(42,memory_order_relaxed);
这样可以产生 r2==42,使线程 2 的时间看起来像是倒流了。也就是说,memory_order_relaxed 允许这种执行顺序:
y.store(42,memor y_order_relaxed);
r1 = y.load(memory_order_relaxed);
x.store(r1,memory_order_relaxed);
r2 = x.load(memory_order_relaxed);
有关解释,请参阅专业文献,例如 [Boehm,2008] 和 [Williams,2012]。
给定的内存顺序是否合理完全取决于具体的架构。显然,松散的内存模型不能直接用于应用程序编程。使用松散的内存模型比一般的无锁编程更为专业。我认为它只适用于操作系统内核、设备驱动程序和虚拟机实现者中的一小部分。它也可以用于机器生成的代码(例如 goto 语句)。如果两个线程确实不直接共享数据,某些机器架构可以通过使用松散的内存模型来显著提升性能,但代价是消息传递原语(例如 future 和 promise;参见 §42.4.4)的实现复杂度增加。
为了允许对具有松散内存模型的架构进行显著优化,该标准提供了一个属性 [[carries_dependency]],用于在函数调用之间传递内存顺序依赖关系(§iso.7.6.4)。例如:
[[carries_dependency]] struct foo∗ f(int i)
{
// let the caller use memory_order_consume for the result:
return foo_head[i].load(memory_order_consume);
}
你也可以在函数参数上添加 [[carries__dependency]],并且有一个函数 kill_dependency() 可以停止传播此类依赖关系。
C++内存模型的设计者之一Lawrence Crowl总结道:“依赖顺序可能是最复杂的并发特性。它真正值得使用的情况是:
• 你拥有一台性能至关重要的机器;
• 你拥有一个高带宽、读取频率极高的原子数据结构;
• 你愿意花几周时间进行测试和外部评审。
这确实是专家级的领域。”
请自行斟酌。
41.3.1 atomic类型(atomic Types)
原子类型是atomic模板的一种特化形式。对原子类型对象执行的操作是原子性的,也就是说,它由单个线程执行,不会受到其他线程的干扰。
原子操作非常简单:对简单对象(通常是单个内存位置;§41.2.1)进行加载、存储、交换、递增等操作。这些操作必须足够简单,否则硬件将无法直接处理它们。
以下表格旨在提供初步印象和概览(仅此而已)。除非另有明确说明,否则内存顺序为 memory_order_seq_cst(顺序一致)。
| atomic<T> (§iso.29.5) x.val 表示原子变量 x 的值;所有操作均为 noexcept 操作。 | |
| atomic x; | x未初始化 |
| atomic x {}; | 默认构造函数:x.val=T{}; constexpr |
| atomic x {t}; | 构造函数:x.val=t; constexpr |
| x=t | T的赋值: x.val=t |
| t=x | 隐式转换到 T: t=x.val |
| x.is_lock_free() | 对 x 的操作是否无锁? |
| x.store(t) | x.val=t |
| x.store(t,order) | x.val=t;内存序是order |
| t=x.load() | t=x.val |
| t=x.load(order) | t=x.val ; 内存序是order |
| t2=x.exchang e(t) | 交换x和t的值; t2是x的上一个值 |
| t2=x.exchange(t,order) | 交换x和t的值; 内存序是 order ;t2是x的上一个值 |
| b=x.compare_exchang e_weak(rt,t) | 若 b=(x.val==rt) ,则x.val=t ,否则 rt=x.val ;rt 是一个 T& |
| b=x.compare_exchang e_weak(rt,t,o1,o2) | b=x.compare_exchang e_weak(rt,t); 当 b==true 时,使用 o1 作为内存序; 当 b==false 时,使用 o2 作为内存序; |
| b=x.compare_exchang e_weak(rt,t,order) | b=x.compare_exchang e_weak(rt,t); 使用 order 作为内存序;(见 §iso.29.6.1[21]) |
| b=x.compare_exchange_strong(r t,t,o1,o2) | 同 b=x.compare_exchang e_weak(rt,t,o1,o2) |
| b=x.compare_exchange_strong(r t,t,order) | 同 b=x.compare_exchang e_weak(rt,t,order) |
| b=x.compare_exchange_strong(r t,t) | 同 b=x.compare_exchang e_weak(rt,t) |
atomic操作不支持复制或移动。赋值运算符和构造函数接受类型 T 的值,并访问该值。
默认atomic (没有显式 {})未初始化,以便与 C 标准库兼容。
is_lock_free() 操作用于测试这些操作是否无锁,或者它们是否使用了锁来实现。在所有主流实现中,is_lock_free() 对整型和指针类型都返回 true。
atomic操作机制专为映射到简单内置类型的类型而设计。如果 T 对象很大,则预期 atomic<T> 会使用锁来实现。模板参数类型 T 必须易于复制(不能包含用户自定义的复制操作)。
atomic变量的初始化并非原子操作,因此初始化操作可能与其他线程的访问发生数据竞争(§iso.29.6.5)。然而,初始化操作导致数据竞争的情况非常罕见。一如既往,应保持非局部对象的初始化简洁,并优先使用常量表达式进行初始化(程序启动前不会发生数据竞争)。
对于共享计数器(例如共享数据结构的使用次数)来说,简单的atomic变量几乎是理想的选择。例如:
template<typename T>
class shared_ptr {
public:
// ...
˜shared_ptr()
{
if (−−∗puc) delete p;
}
private:
T∗p; //pointer to shared object
atomic<int>∗ puc; // pointer to use count
};
这里,∗puc 是一个atomic(由 shared_ptr 构造函数在某处分配),因此递减操作(--)是原子的,并且在销毁 shared_ptr 的线程中正确报告了新值。
比较和交换操作的第一个参数(表中的 rt)是一个引用,以便在操作未能更新其目标(表中的 x)时,可以更新被引用的对象。
compare_exchang e_strong() 和 compare_exchang e_weak() 的区别在于,弱版本可能会因为“虚假原因”而失败。也就是说,硬件或 x.compare_exchang e_weak(rt,t) 实现的某些特殊性可能会导致失败,即使 x.val==rt 也可能发生。允许此类失败使得 compare_exchange_weak() 可以在一些架构上实现,而 compare_exchange_strong() 则难以实现或实现成本相对较高。
经典的比较交换循环可以这样写:
atomic<int> val = 0;
// ...
int expected = val.load(); // read current value
do {
int next = fct(expected); // calculate new value
} while (!val.compare_exchange_weak(expected,next)); // write next to val or to expected
原子操作 val.compare_exchange_weak(expected, next) 读取 val 的当前值并将其与 expected 进行比较;如果相等,则将 next 写入 val。如果在我们读取 val 准备更新之后,其他线程已经写入了 val,则需要重试。重试时,我们使用从 compare_exchang e_weak() 获取到的 expected 的新值。最终,expected 的值将被写入。expected 的值是“此线程看到的 val 的当前值”。因此,由于每次执行 compare_exchang e_weak() 时 expected 都会更新为当前值,因此我们永远不会遇到无限循环。
类似 compare_exchange e_strong() 的操作通常称为比较交换操作(CAS 操作)。所有 CAS 操作(无论使用何种语言,在任何机器上)都存在一个潜在的严重问题,称为 ABA 问题。考虑在一个非常简单的无锁单链表的头部添加一个节点,如果该节点的数据值小于链表头部的数据值:
extern atomic<Link∗> head; // the shared head of a linked list
Link∗ nh = new Link(data,nullptr); // make a link ready for insertion
Link∗ h = head.load(); // read the shared head of the list
do {
if (h−>data<data) break; // if so, inser t elsewhere
nh−>next = h; // next element is the previous head
} while (!head.compare_exchang e_weak(h,nh)); // write nh to head or to h
这是一个简化版的代码,用于在有序链表的正确位置插入data。我读取链head,将其用作新Link的next元素,然后将指向新Link的指针写回head。我重复此操作,直到没有其他线程在我准备 nh 时能够改变head为止。
让我们详细分析一下这段代码。假设我读取的 head 值是 A。如果在我执行 compare_exchang e_weak() 之前没有其他线程修改过 head 的值,那么它会在 head 中找到 A,并成功地将其替换为我的 nh。如果在我读取 A 之后,有其他线程将 head 的值修改为 B,那么 compare_exchang e_weak() 将会失败,我将再次循环读取 head 的值。
这看起来没问题。到底哪里出了问题呢?嗯,在我读取到值 A 之后,另一个线程将head的值改为了 B,并回收了该Link。然后,另一个线程又重用了节点 A,并将其重新插入到Link的head。现在,我的 compare_exchangee_weak() 函数找到了 A 并进行了更新。然而,链表已经发生了变化;head的值从 A 变成了 B,然后又变回了 A。这种变化在很多方面都可能造成显著影响,但在这个简化的例子中,A->data可能已经改变,导致关键的data比较出现错误。ABA 问题可能非常隐蔽,难以检测。有很多方法可以处理 ABA 问题 [Dechev,2010]。我在这里提到它主要是为了提醒大家注意无锁编程的微妙之处。
整数atomic类型提供原子算术和位运算:
| 整数 T 的 atomic<T> (§iso.29.6.3) x.val 表示原子变量 x 的值;所有操作均为 noexcept 操作。 | |
| z=x.fetch_add(y) | x.val+=y; z是之前的x.val |
| z=x.fetch_add(y,order) | z=x.fetch_add(y); 使用order |
| z=x.fetch_sub(y) | x.val−=y; z是之前的x.val |
| z=x.fetch_sub(y,order) | z=x.fetch_sub(y); 使用order |
| z=x.fetch_and(y) | x.val&=y; z是之前的x.val |
| z=x.fetch_and(y,order) | z=x.fetch_and(y); 使用order |
| z=x.fetch_or(y) | x.val|=y; z是之前的x.val |
| z=x.fetch_or(y,order) | z=x.fetch_or(y); 使用order |
| z=x.fetch_xor(y) | x.valˆ=y; z是之前的x.val |
| z=x.fetch_xor(y,order) | z=x.fetch_xor(y); 使用order |
| ++x | ++x.val;返回 x.val |
| x++ | x.val++;返回前一个 x.val |
| −−x | −−x.val; 返回 x.val |
| x−− | x.val−−; 返回前一个 x.val |
| x+=y | x.val+=y; 返回 x.val |
| x−=y | x.val−=y; 返回 x.val |
| x&=y | x.val&=y; 返回 x.val |
| x|=y | x.val|=y; 返回 x.val |
| xˆ=y | x.valˆ=y; 返回 x.val |
考虑一下流行的双重检查锁定机制。其基本思想是,如果初始化某个变量 x 必须在加锁的情况下进行,则每次访问 x 以检查初始化是否完成时,你可能都不希望产生获取该锁的开销。因此,只有当变量 x_init 为 false 时,才进行加锁和初始化:
X x; // we need a lock to initialize an X
mutex lx; // the mutex to be used to lock x dur ing initialization
atomic<bool> x_init {false}; // an atomic used to minimize locking
void some_code()
{
if (!x_init) { // proceed if x is uninitialized
lx.lock();
if (!x_init) { // proceed if x is still uninitialized
// ... initialize x ...
x_init = true;
}
lx.unlock();
}
// ... use x ...
}
如果 init_x 不是原子操作,指令重排序可能会导致 x 的初始化操作被移到看似无关的 init_x 测试之前(参见 §41.2.2)。将 init_x 设为原子操作可以避免这种情况。
!x_init 依赖于从 atomic<T> 到 T 的隐式转换。
使用 RAII(§42.3.1.4)可以进一步简化这段代码。
双重检查锁定惯用法在标准库中由 once_flag 和 call_once()(§42.3.3)表示,因此你无需直接编写此类代码。
标准库也支持atomic指针:
| 指针的atomic<T∗> (§iso.29.6.4) x.val 表示原子变量 x 的值;所有操作均为 noexcept 操作。 | |
| z=x.fetch_add(y) | x.val+=y; 返回前一个 x.val |
| z=x.fetch_add(y,order) | z=x.fetch_add(y); 使用order |
| z=x.fetch_sub(y) | x.val−=y; 返回前一个 x.val |
| z=x.fetch_sub(y,order) | z=x.fetch_sub(y); 使用order |
| ++x | ++x.val; 返回 x.val |
| x++ | x.val++; 返回前一个 x.val |
| −−x | −−x.val; 返回 x.val |
| x−− | x.val−−; 返回前一个 x.val |
| x+=y | x.val+=y; 返回 x.val |
| x−=y | x.val−=y; 返回 x.val |
为了保持与 C 标准库的兼容性,原子成员函数类型具有独立的等效类型:
| atomic_∗ 操作 (§iso.29.6.5) 所有的操作都是noexcept | |
| atomic_is_lock_free(p) | ∗p 类型的对象是原子对象吗? |
| atomic_init(p,v) | 用 v 初始化 ∗p |
| atomic_store(p,v) | 将 v 存入 ∗p |
| x=atomic_load(p) Assign | 将 ∗p 存入x |
| x=atomic_load(p) | 将 ∗p 载入x |
| b=atomic_compare_exchang e_weak(p,q,v) | 比较和交换∗p 和 ∗q; b=(∗q==v) |
| ……更多的大约70个函数…… | |
41.3.2 标识和阻隔(Flags and Fences)
除了对原子类型的支持之外,标准库还提供了两种底层同步机制:原子标志和内存阻隔。它们的主要用途是实现最底层的原子机制,例如自旋锁和原子类型。它们是唯一保证在所有实现中都受支持的无锁机制(尽管所有主流平台都支持原子类型)。
基本上,程序员不需要使用标志或阻隔。使用标志或阻隔的程序员通常处理与机器架构密切相关的工作。
41.3.2.1 atomic标识(atomic Flags)
atomic_flag 是最简单的原子类型,也是唯一一种保证所有实现中操作都具有原子性的原子类型。atomic_flag 表示单个信息位。如有必要,其他原子类型也可以使用 atomic_flag 来实现。
atomic_flag 的两个可能值分别称为 set 和 clear。
| atomic_flag (§iso.29.7) 所有操作都标为 noexcept | |
| atomic_flag fl; | fl的值未定义 |
| atomic_flag fl {}; | 默认构造函数:fl的值是0 |
| atomic_flag fl {ATOMIC_FLAG_INIT}; | 初始化 fl 为clear |
| b=fl.test_and_set() | 设置 fl 且 b 为 fl 的旧值 |
| b=fl.test_and_set(order) | 设置 fl 且 b 为 fl 的旧值, 使用内存序 order |
| fl.clear() | 清除 fl |
| fl.clear(order) | 清除 fl , 使用内存序 order |
| b=atomic_flag_test_and_set(flp) | 设置 flp ; b 为 flp 的旧值 |
| b=atomic_flag_test_and_set_explicit(flp,order) | 设置 flp ; b 为 flp 的旧值; 使用内存序 order |
| atomic_flag_clear(flp) | 清除 flp |
| atomic_flag_clear_explicit(flp,order) | 清除 flp ; 使用内存序 order |
bool返回值为 true 表示设置,值为 false 表示清除。
使用 {} 初始化 atomic_flag 似乎合情合理。然而,并不能保证 0 代表清除状态。据说存在清除状态为 1 的机器。使用 AT OMIC_FLAG_INIT 进行清除是唯一可移植且可靠的初始化 atomic_flag 的方法。ATOMIC_FLAG_INIT 是一个由实现提供的宏。
你可以把 atomic_flag 看作是一个非常简单的自旋锁:
class spin_mutex {
atomic_flag flag = ATOMIC_FLAG_INIT;
public:
void lock() { while(flag.test_and_set()); }
void unlock() { flag.clear(); }
};
请注意,自旋锁很容易变得非常昂贵。
照例,内存序及其正确用法留给专业文献参考。
41.3.2.2 阻隔(Fences)
阻隔(也称为内存屏障(memory barrier))是一种根据某种具体内存序限制操作 重排的操作(§41.2.3)。屏障操作本身不做任何其他事情。可以将其理解为将程序运行速度降低到安全水平,使内存层次结构达到一个相对明确的状态。
| 阻隔(§iso.29.8) 所有操作都是noexcept的 | |
| atomic_thread_fence(order) | 强制内存序 order |
| atomic_signal_fence(order) | 对于一个线程以及在该线程上执行的信号处理程序,强制内存序 order |
阻隔与原子操作结合使用(需要观察阻隔的效果)。
41.4 volatile
volatile 指定符用于标识对象可以被控制线程之外的操作修改。例如:
volatile const long clock_register; // 由硬件时钟更新
volatile 关键字的作用是告诉编译器不要优化掉那些看似冗余的读写操作。例如:
auto t1 {clock_register};
// ...... 在此没有使用 clock_register ......
auto t2 {clock_register};
如果 clock_register 不是 volatile 的,编译器完全有权消除其中一次读取操作,并假设 t1==t2 。
除非在直接操作硬件的底层代码中,否则不要使用 volatile 关键字。
不要假设 volatile 在内存模型中具有特殊含义。它没有。它并非像某些后来的语言那样是一种同步机制。要实现同步,请使用atomic(§41.3),mutex(§42.3.1)或condition_variable(§42.3.4)。
41.3 建议(Advice)
[1] 使用并发来提高响应速度或吞吐量;§41.1。
[2] 尽可能使用最高抽象级别;§41.1。
[3] 优先使用 packaged_task 和 future,而不是直接使用thread和mutex锁;§41.1。
[4] 除了简单的计数器之外,优先使用mutex和 condition_variable,而不是直接使用atomic操作;§41.1。
[5] 尽可能避免显式共享数据;§41.1。
[6] 考虑使用进程来替代线程;§41.1。
[7] 标准库中的并发功能是类型安全的;§41.1。
[8] 内存模型的存在是为了让大多数程序员不必考虑计算机的机器架构层极;§41.2。
[9] 内存模型使内存的运行方式大致符合人们的预期;§41.2。
[10] 不同的线程访问struct的不同位域可能会相互干扰;§41.2。
[11] 避免数据竞争;§41.2.4。
[12] 原子操作允许无锁编程;§41.3。
[13] 无锁编程对于避免死锁和确保每个线程都能顺利执行至关重要;§41.3。
[14] 将无锁编程交给专家;§41.3。
[15] 将松散的内存模型交给专家;§41.3。
[16] volatile 关键字告诉编译器,对象的值可能会被程序之外的操作更改;§41.4。
[17] C++ 的 volatile 关键字不是同步机制;§41.4。
内容来源:
<<The C++ Programming Language >> 第4版,作者 Bjarne Stroustrup


 735


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


