【数据科学赛】Meta AI Video Similarity Challenge #视频检索 #双赛道 #$100,000

视频内容相似度&视频数字版权 综述 视频内容相似度算法 随着视频内容越来越多,通过深度模型理解视频,提取视频内容特征,建立视频搜索引擎,已经成为主流。视频内容相似度检索以及视频内容理解能力越发重要。再业务推进过程以及技术积累过程中,对调研尝试过的数据和方法,做简要的整理和剖析。当前北大满哥视频侵权,说明平台在视频内容审核这一块,严格意义上讲,就平台再视频版权这一块,或多或少的都需要人工运维去做支撑(依据没有运用OCR以及语义等初级的文案审核能力对头部流量视频做内容风控)。显然目前互联网企业的初衷,还在我们的"菜篮子"里,未将精力投入的科技的星 阅读详情

CompHub 实时聚合多平台的数据类(Kaggle、天池…)和OJ类(Leetcode、牛客…)比赛。本账号会推送最新的比赛消息,欢迎关注!

更多比赛信息见 CompHub主页


以下内容摘自比赛主页(点击文末阅读原文进入)
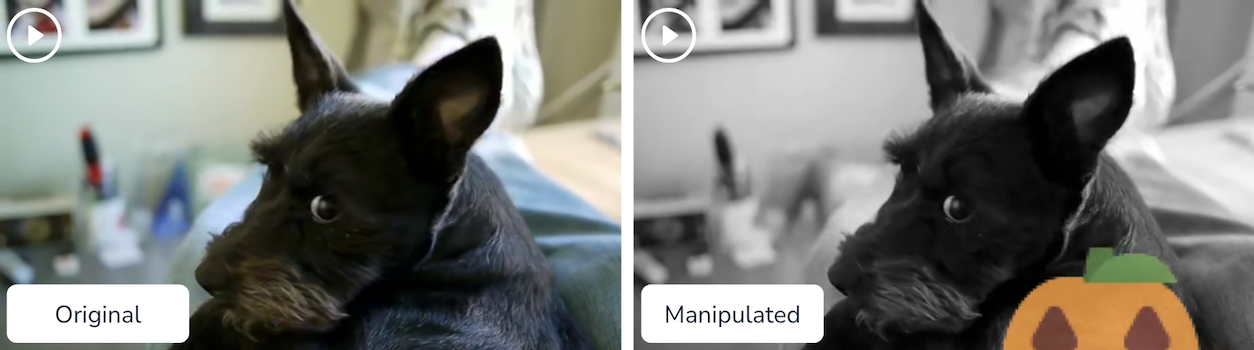
Part1赛题介绍

题目

Meta AI Video Similarity Challenge

  • Descriptor Track: generate useful vector representations of videos

  • Matching Track: detects which specific clips of a query video correspond to which specific clips in one or more videos in a large corpus of reference videos.

举办平台

DrivenData

主办方
背景

Manual content moderation has challenges scaling to meet the large volume of content on platforms like Instagram and Facebook, where tens of thousands of hours of video are uploaded each day. Accurate and performant algorithms are critical in flagging and removing inappropriate content. This competition allows you to test your skills in building a key part of that content tracing system, and in so doing contribute to making social media more trustworthy and safe for the people who use it.

Part2时间安排

Phase 1: Model Development (December 2, 2022 00:00 UTC - March 24, 2023 23:59 UTC): Participants have access to the research dataset to develop and refine their models. Submissions may be made to the public leaderboard and evaluated for the Phase 1 leaderboard. These scores will not determine final leaderboard and rankings for prizes.

Phase 2: Final Scoring (April 2, 2023 00:00 UTC to April 9, 2023 23:59 UTC): Participants will have the opportunity to make up to three submissions against a new, unseen test set. Performance against this new test set will be used to determine rankings for prizes.

Part3奖励机制

PlaceDescriptor TrackMatching Track
1st$25,000$25,000
2nd$15,000$15,000
3rd$10,000$10,000

Part4赛题描述

  • For the Descriptor Track, your goal is to generate useful vector representations of videos for this video similarity task. You will submit descriptors for both query and reference set videos. A standardized similarity search using pair-wise inner-product similarity will be used to generate ranked video match predictions.

  • For the Matching Track, your goal is to create a model that directly detects which specific clips of a query video correspond to which specific clips in one or more videos in a large corpus of reference videos. You will submit predictions indicating which portions of a query video are derived from a reference video.


视频相似性检测 背景 完全一样的视频可以通过MD5判断,但视频可能因为压缩格式、缩放、明暗、尾部截断导致非完全一致,故需要对视频帧进行重复检测。非常相似定义:缩放、亮度、帧率、水印、格式变换等造成的视频差异(旋转的效果不佳)。本文采用一秒一帧切帧,对每帧提取Phash(perceptual hash algortihm 感知hash算法)值,进行相似度对比。 PHash简介 用于提取图像指纹 缩放为32*32的小图 转为灰度图, Gray = R0.299 + G0.587 + B*0.114 DCT离散余弦变换,只保 阅读详情

相关推荐

Video Input with OpenCV and similarity measurement(使用opencv测量两个视频的相似度)

Video Input with OpenCV and similarity measurement(使用opencv测量两个视频的相似度) 参考示例程序及视频文件下载: 一.先决条件 1.两种检查相似度的方法 (1)PSNR: ​ psnr是“Peak Signal to Noise Ratio”的缩写,即峰值信噪比,是一种评价图像的客观标准,它具有局限性,一般是用于最大值信号和背景噪音之间的一...

小马博客 2786

乞丐哥的私房菜(Windows OpenCV 篇 —— Application utils 节 之 Video OpenCV similarity measurement 视频输入 相似性 测量)

本文介绍了一个使用OpenCV进行视频相似性检测的程序。该程序在Windows 7 SP1系统下,通过mingw64 g++ 8.1.0编译,使用OpenCV 4.12.0库实现视频处理功能。主要实现了两个功能:读取视频流和比较视频帧相似度(使用PSNR和SSIM两种算法)。程序通过命令行参数接收两个视频文件和PSNR阈值,逐帧比较两个视频的相似度。当PSNR值低于设定阈值时,会进一步计算SSIM值。该程序可用于评估视频压缩算法的效果,同时展示了OpenCV的基本视频处理能力。代码中包含了视频读取、窗口显示

2501_92378057的博客 1155

基于PCIe的NVMe协议在FPGA中实现方法

NVMe协议是工作在PCIE的最上层协议层的,故需要先搞清楚PCIE。本文基于Xilinx的UltraScale+,开发工具为Vivado2021.2。NVMe的学习仍以spec为主,其它资料辅助理解,有冲突时以spec为准,必要时可对比最新版本spec。(此文重点介绍学习方法及资料,有时间再加细节)。 主要参考的文章是《老男孩读PCIe》,同时参考《古猫先生》,重点学习TLP报文部分,数据链路层和物理层的内容可以先不看。再买一本书《PCI Express 体系结构导读-王齐》用来查阅做笔记。

leixj的博客 1万+

faiss视频内容分析:帧级特征提取和相似性匹配

在当今多媒体内容爆炸的时代,视频数据的分析和检索变得愈发重要。Faiss(Facebook AI Similarity Search)作为一个高效的相似性搜索库,为视频内容分析提供了强大的技术支撑。本文将深入探讨如何利用Faiss实现视频帧级特征提取和相似性匹配,构建高效的视频检索系统。 ## 视频内容分析的技术架构 ### 整体架构图 ```mermaid flowchart TD ...

gitblog_00648的博客 537

深入解析SSD报错“READ FPDMA QUEUED”:从诊断到修复全流程

本文深入解析了SSD报错“READ FPDMA QUEUED”的含义、成因与全流程解决方案。该错误通常指示硬盘硬件或健康状态问题。文章详细介绍了如何通过系统日志定位错误、解读关键的S.M.A.R.T.健康报告(重点关注重分配扇区计数等指标),并逐步进行硬件排查(如更换SATA数据线)、软件修复与数据抢救,最终指导用户根据诊断结果做出维修或更换SSD的决策。

weixin_29233333的博客 398

FFmpeg硬件加速实战:VAAPI驱动配置全攻略(含NVIDIA/Intel避坑指南)

本文详细解析了在Linux环境下配置FFmpeg使用VAAPI接口实现硬件加速的完整流程。针对NVIDIA、Intel等主流显卡,提供了从驱动安装、环境变量设置到多显卡切换的实战指南,并重点解决了闭源驱动冲突、国产系统适配等常见问题,帮助用户有效提升视频处理性能。

weixin_29306011的博客 454

CAMoE——屠榜 video retrieval challenge

关注公众号,发现CV技术之美作者:炎思提原文:https://zhuanlan.zhihu.com/p/425226244本文转自知乎,已获作者授权,请勿二次转载。✎编 者 言 来自今...

我爱计算机视觉 614

跟着团子学SAP CO:基于成本的完工百分比结算:Cost-based POC(以项目为例)

本文以英国及北美会计准则下的基于成本的POC的销售型项目结算对PS模块中的完工百分比进行介绍

Lucas1211的博客 2万+

淘宝直播商品识别大赛开幕,助力视频多模态商品检索技术再升级

阿里巴巴淘系技术与浙江大学深度合作,在多媒体领域顶会ACM Multimedia 2021举办直播中多模态商品识别workshop暨第二届淘宝直播商品识别大赛,共同推动电商直播场景中多模态...

淘系技术 977

QT 实现QStackedWidget切换页面右移动画

首先截取当前界面的图片,渲染到一个QLabel上,然后设置QPropertyAnimation动画,动画的作用对象就是这个QLabel,不断的改变geometry;当动画结束的时候,隐藏并释放这个QLabel。以下是一个QStackedWidget,放了两个QPushButton在上面,点击切换不同的界面。为了方便查看动画特效,设置了每个界面的背景图片。

希望能帮助大家,希望大家多多支持,你们的支持是我前进的动力。 882

论文必备 - 绘制YOLOv8模型在训练过程中,精准率,召回率,mAP_0.5,mAP_0.5:0.95,以及各种损失的变化曲线

文件是模型在训练过程中,实时记录训练的结果,和当时控制台输出的信息一致。当然还包含一些验证损失,学习率变化等数据。epoch:记录训练的轮次,总轮次为训练文件中设置的epochs大小。:边界框损失。在训练过程中,此值逐渐变小,越小表示模型预测的边界框与真实边界框之间的差异越小。:分类损失。在训练过程中,此值逐渐变小,越小表示模型对目标类别的预测越准确。:分布焦点损失。将边界框的回归问题转化为对边界框四个边的分布预测问题,越小表示预测越准确。:精确率也称为查准率。

Limiiiing的博客 1407

计算机视觉最新进展概览(2021年8月1日到2021年8月7日)

COCO数据集共有小类80个,分别为 [‘person’, ‘bicycle’, ‘car’, ‘motorcycle’, ‘airplane’, ‘bus’, ‘train’, ‘truck’, ‘boat’, ‘traffic light’, ‘fire hydrant’, ‘stop sign’, ‘parking meter’, ‘bench’, ‘bird’, ‘cat’, ‘dog...

weixin_36670529的博客 1510

手把手教你学Simulink--控制策略与算法的DC-DC变换器领域仿真领域建模实例:基于Simulink实现一个双闭环控制Buck变换器的仿真建模

目录主要步骤1. 前期准备2. 构建Buck变换器模型3. 定义双闭环控制器4. 设置参考电压和反馈回路5. 实现双闭环控制器逻辑6. 仿真参数设置7. 运行仿真与结果分析示例整合代码片段1. Simulink模型2. 双闭环控制器参数调节3. 仿真结果分析总结双闭环控制是一种常见的控制策略,广泛应用于电力电子系统(如DC-DC变换器)中。它通过内外两个环路的协同工作,分别控制系统的动态性能和稳态性能。对于Buck变换器,通常采用电流内环和电压外环的双闭环控制结构。以下是一个手把手教程,帮助你基于Simul

MHD0815的博客 325

Video Person Re-identification with Competitive Snippet-similarity Aggregation and Co-attentive Snip

一、介绍 在这篇文章中,作者通过“竞争性的片段相似度聚合”和“片段的协同注意力嵌入”的方法来解决视频行人重识别问题。 具体来说,作者将两个要计算相似度的长的视频序列分成若干个等长片段(各自有Np和Ng个片段),然后计算各个片段间的相似度得到NpXNg的相似度矩阵,选择前若干百分比的相似度求平均值作为两个视频序列的相似度。通过这样的方式,可以降低类内variation对视频序列相似度估计的不利影...

han jan的博客 1339

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

CVPR 2018 行人重识别:Video Person Re-identification with Competitive Snippet-similarity Aggregation and..

题目:Video Person Re-identification with Competitive Snippet-similarity Aggregation and Co-attentive Snippet Embedding 作者 : Dapeng Chen, Hongsheng Li, Tong Xiao(商汤) 1.解决的问题 Video Person Re-id ...

Coder_XiaoHui的博客 3198

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 355

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 197

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 2万+

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 235

医疗 AI 有两种,别混着谈:一个改流程,一个改范式

InfoXMed 是面向医生、医学生和医学科研人员的 AI 医学工具平台,提供文献检索、全文翻译、AI 解读、指南查询和题库练习等功能,辅助临床学习、科研汇报与医学备考。原文是日本医学会杂志(JMA Journal)的一篇综述(Review Article):基本事实:这一点必须先说清:这篇论文提出的是一个研究纲领。它文中的"预测"指的是科学设想,不是可以拿来用的临床预测能力。文中甚至自己承认了一个硬缺口(见第三节)。本文只谈它的术语辨析与科学方法论,不转述任何可作为临床依据的预测或处置主张。这篇论文的全部

2601_96948740的博客 237

河道漂浮物目标检测数据集

目标检测,yolo,河道漂浮物目标检测数据集

DL_data_set的博客 191

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 190

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 541

AI前沿日报 · 2026-11-04 | 祛魅时刻:Astra“纯读权重“神话的崩塌

①Astra"裸权重通吃"被spaCy创始人Honnibal精准祛魅——仅1/3实验真裸读,数学能力提升依赖Python+50次迭代;②Simon Willison用Qwen 3.8-27B端侧复现权重空间编程;③Nvidia开源Auto-Ontology自动知识图谱;④$800开源全域抓取机器人Stringman;⑤OpenAI悄然重开Codex训练开关引信任危机;⑥DeepMind发布Gemini 4 Argon机器人基础模型;⑦美国科技巨头隐性AI债务达3.2万亿美元,6个月增90%。

johnsong2009的博客 558

大模型 Embedding 与向量相似度详解

Embedding 解决的问题:计算机不懂文字,但懂数字│▼文本 → 向量(1024维浮点数数组)│▼相似度解决的问题:怎么判断两个向量(文本)有多接近│▼余弦相似度:看向量方向的夹角,越接近0°越相似│▼最终效果:语义搜索——理解意思,而非字面匹配一句话总结:Embedding 把文字变成数字,余弦相似度比较数字的方向,两者结合实现了"理解语义"的搜索。

T3165919332的博客 79
上一篇: 【数据科学赛】1st and Future - Player Contact Detection #视频接触检测 #$100,000
下一篇: 【OJ比赛日历】12.10-12.16 15场比赛 #LeetCode周赛+双周赛
CompHub
博客等级 码龄4年 365粉丝 117原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值