


引言:为什么搞懂它们至关重要?
嗨~我是你们的AI伙伴狸猫算君!想象一下这个场景:你兴奋地克隆了一个最新的开源大模型到本地,准备一展身手。当你满怀期待地输入命令 python run.py 时,等待你的不是模型的回应,而是一行冰冷的红色错误:CUDA out of memory。
“我明明有32GB的内存啊,怎么8GB的显存就不够用了?”
这几乎是每一位AI开发者和科研新手都会遇到的“第一堵墙”。问题的核心,就在于混淆了 内存(RAM) 和 显存(VRAM) 的职责。
在当今这个由AI、高清图形和高性能计算驱动的时代,理解这对“存储兄弟”的差异,不仅仅是硬件知识,更是高效配置资源、优化工作流、乃至节省成本的关键。无论是选择个人电脑、搭建工作站,还是配置云端服务器,对它们清晰的认识都能让你做出更明智的决策。
第一章:核心原理——用“公司团队”比喻秒懂
让我们把整个计算机系统比作一个高科技研发公司。
- CPU(中央处理器) :公司的CEO兼首席架构师。他思维缜密,擅长处理复杂的逻辑判断、任务调度和串行决策(比如制定项目计划、审批流程)。但他一次只能深度思考几件事。
- GPU(图形处理器) :公司里的大规模并行计算团队。这个团队由成千上万个“小工”组成,每个“小工”能力相对简单,但胜在人数众多,行动整齐划一。他们专门负责需要同时进行海量简单计算的任务,比如渲染一帧画面的数百万个像素,或者计算AI模型里巨大的矩阵乘法。
现在,重点来了,他们的“工作资料”放在哪?
-
内存(RAM) :CEO办公室里的超大办公桌和文件架。
- 这张桌子上放着CEO正在处理的所有事情:打开的项目计划书(操作系统)、正在编写的代码(PyCharm/VSCode)、查阅的文献(浏览器标签页)、以及各个部门提交的待审报告(运行中的程序数据)。
- 桌子(内存)足够大,CEO(CPU)就能同时展开更多工作,切换起来也快,不会因为找文件(数据)而卡顿。但桌子再大也是有限的,且只方便CEO本人使用。
-
显存(VRAM) :并行计算团队专属的、超高速的“实验室工作台” 。
- 这个工作台上只摆放该团队当前项目所需的专用材料和工具:比如AI模型的全部参数(权重)、待训练的批量数据、3D模型的顶点和纹理信息。
- 这个工作台是特制的:传送带(带宽)极快,能让成千上万个“小工”(GPU核心)瞬间拿到自己需要的材料;布局(延迟)极优,伸手就能取到。最关键的是,这个工作台只对该团队(GPU)开放,CEO(CPU)不能直接使用。
两者的关键交互:
当CEO(CPU)需要并行计算团队(GPU)处理一个任务(比如训练AI)时,他需要先把任务资料从自己的办公桌(内存)里整理好,然后通过公司内部的“物流通道”(PCIe总线),打包发送到团队的工作台(显存)上。团队处理完后,再把结果通过物流通道送回CEO的办公桌。
这就是为什么“内存无法替代显存”的根本原因: 即使CEO的办公桌(内存)大到能放下整个图书馆,计算团队(GPU)也无法直接在上面对图书馆里的书进行并行处理。数据必须搬运到他们自己的专属工作台(显存)上才行。
第二章:硬核指标对比——数据背后的真相
光有比喻还不够,我们来看看它们在实际参数上的区别,这张表能让你一目了然:
| 对比维度 | 内存 (RAM) - CEO的办公桌 | 显存 (VRAM) - 团队实验室工作台 |
|---|---|---|
| 核心定位 | 系统级 通用 临时存储 | 设备级 专用 高速存储 |
| 服务对象 | CPU 及整个计算机系统 | 专属服务于GPU |
| 存储内容 | 操作系统、所有运行中软件及其临时数据 | GPU计算专用的数据:模型权重、图形纹理、计算张量 |
| 容量范围 | 消费级:16GB - 64GB (主流) 服务器级:可达数TB | 消费级显卡:8GB - 24GB (主流) 数据中心卡:40GB (A100) - 192GB (MI300X) |
| 带宽速度 | DDR5: 约 50 - 100 GB/s (相当于一条双向8车道高速公路) | GDDR6X/GDDR7: 500 - 1000+ GB/s HBM3 (数据中心): 2 - 5 TB/s (是内存的10-50倍!相当于超高速磁悬浮专线) |
| 设计目标 | 低延迟:让CPU快速访问单个数据 | 超高带宽 + 低延迟:让GPU核心洪流同时吞吐海量数据 |
| 物理形态 | 插在主板插槽上,可拆卸升级 | 直接焊接在GPU芯片周围或基板上,不可单独升级 |
| 成本 | 较低,约 1-3 元/GB (DDR5) | 极其昂贵,HBM3显存约100-300元/GB,是内存的百倍以上 |
核心差异解读:
-
性能追求的差异:
- 内存追求“反应快” :CPU的工作像是一位哲学家在深度思考,需要频繁、快速地调用不同的知识片段(数据)。因此,内存强调低延迟,确保CPU“随叫随到”。
- 显存追求“吞吐量大” :GPU的工作像是让一万名画师同时临摹一幅画的不同部分。需要瞬间把画作(数据)铺开在所有人面前。因此,显存的超高带宽至关重要,这是GPU并行计算能力的基石。
-
容量需求的差异:
- 内存容量遵循“木桶定律” :只要够用,保持系统流畅即可。16GB对于多数编程、办公足够;32GB能舒适地进行中型数据科学和AI开发;64GB以上则面向大型虚拟化、超多任务处理。超出需求的容量对性能提升微乎其微。
- 显存容量决定“任务上限” :它直接定义了GPU能处理多大的问题。想加载一个70亿参数的模型?你的显存必须能装下模型本身加上训练/推理所需的中间数据(梯度、优化器状态等)。显存不足,任务直接失败,没有任何商量余地。
第三章:实战指南——AI开发中的显存与内存协作
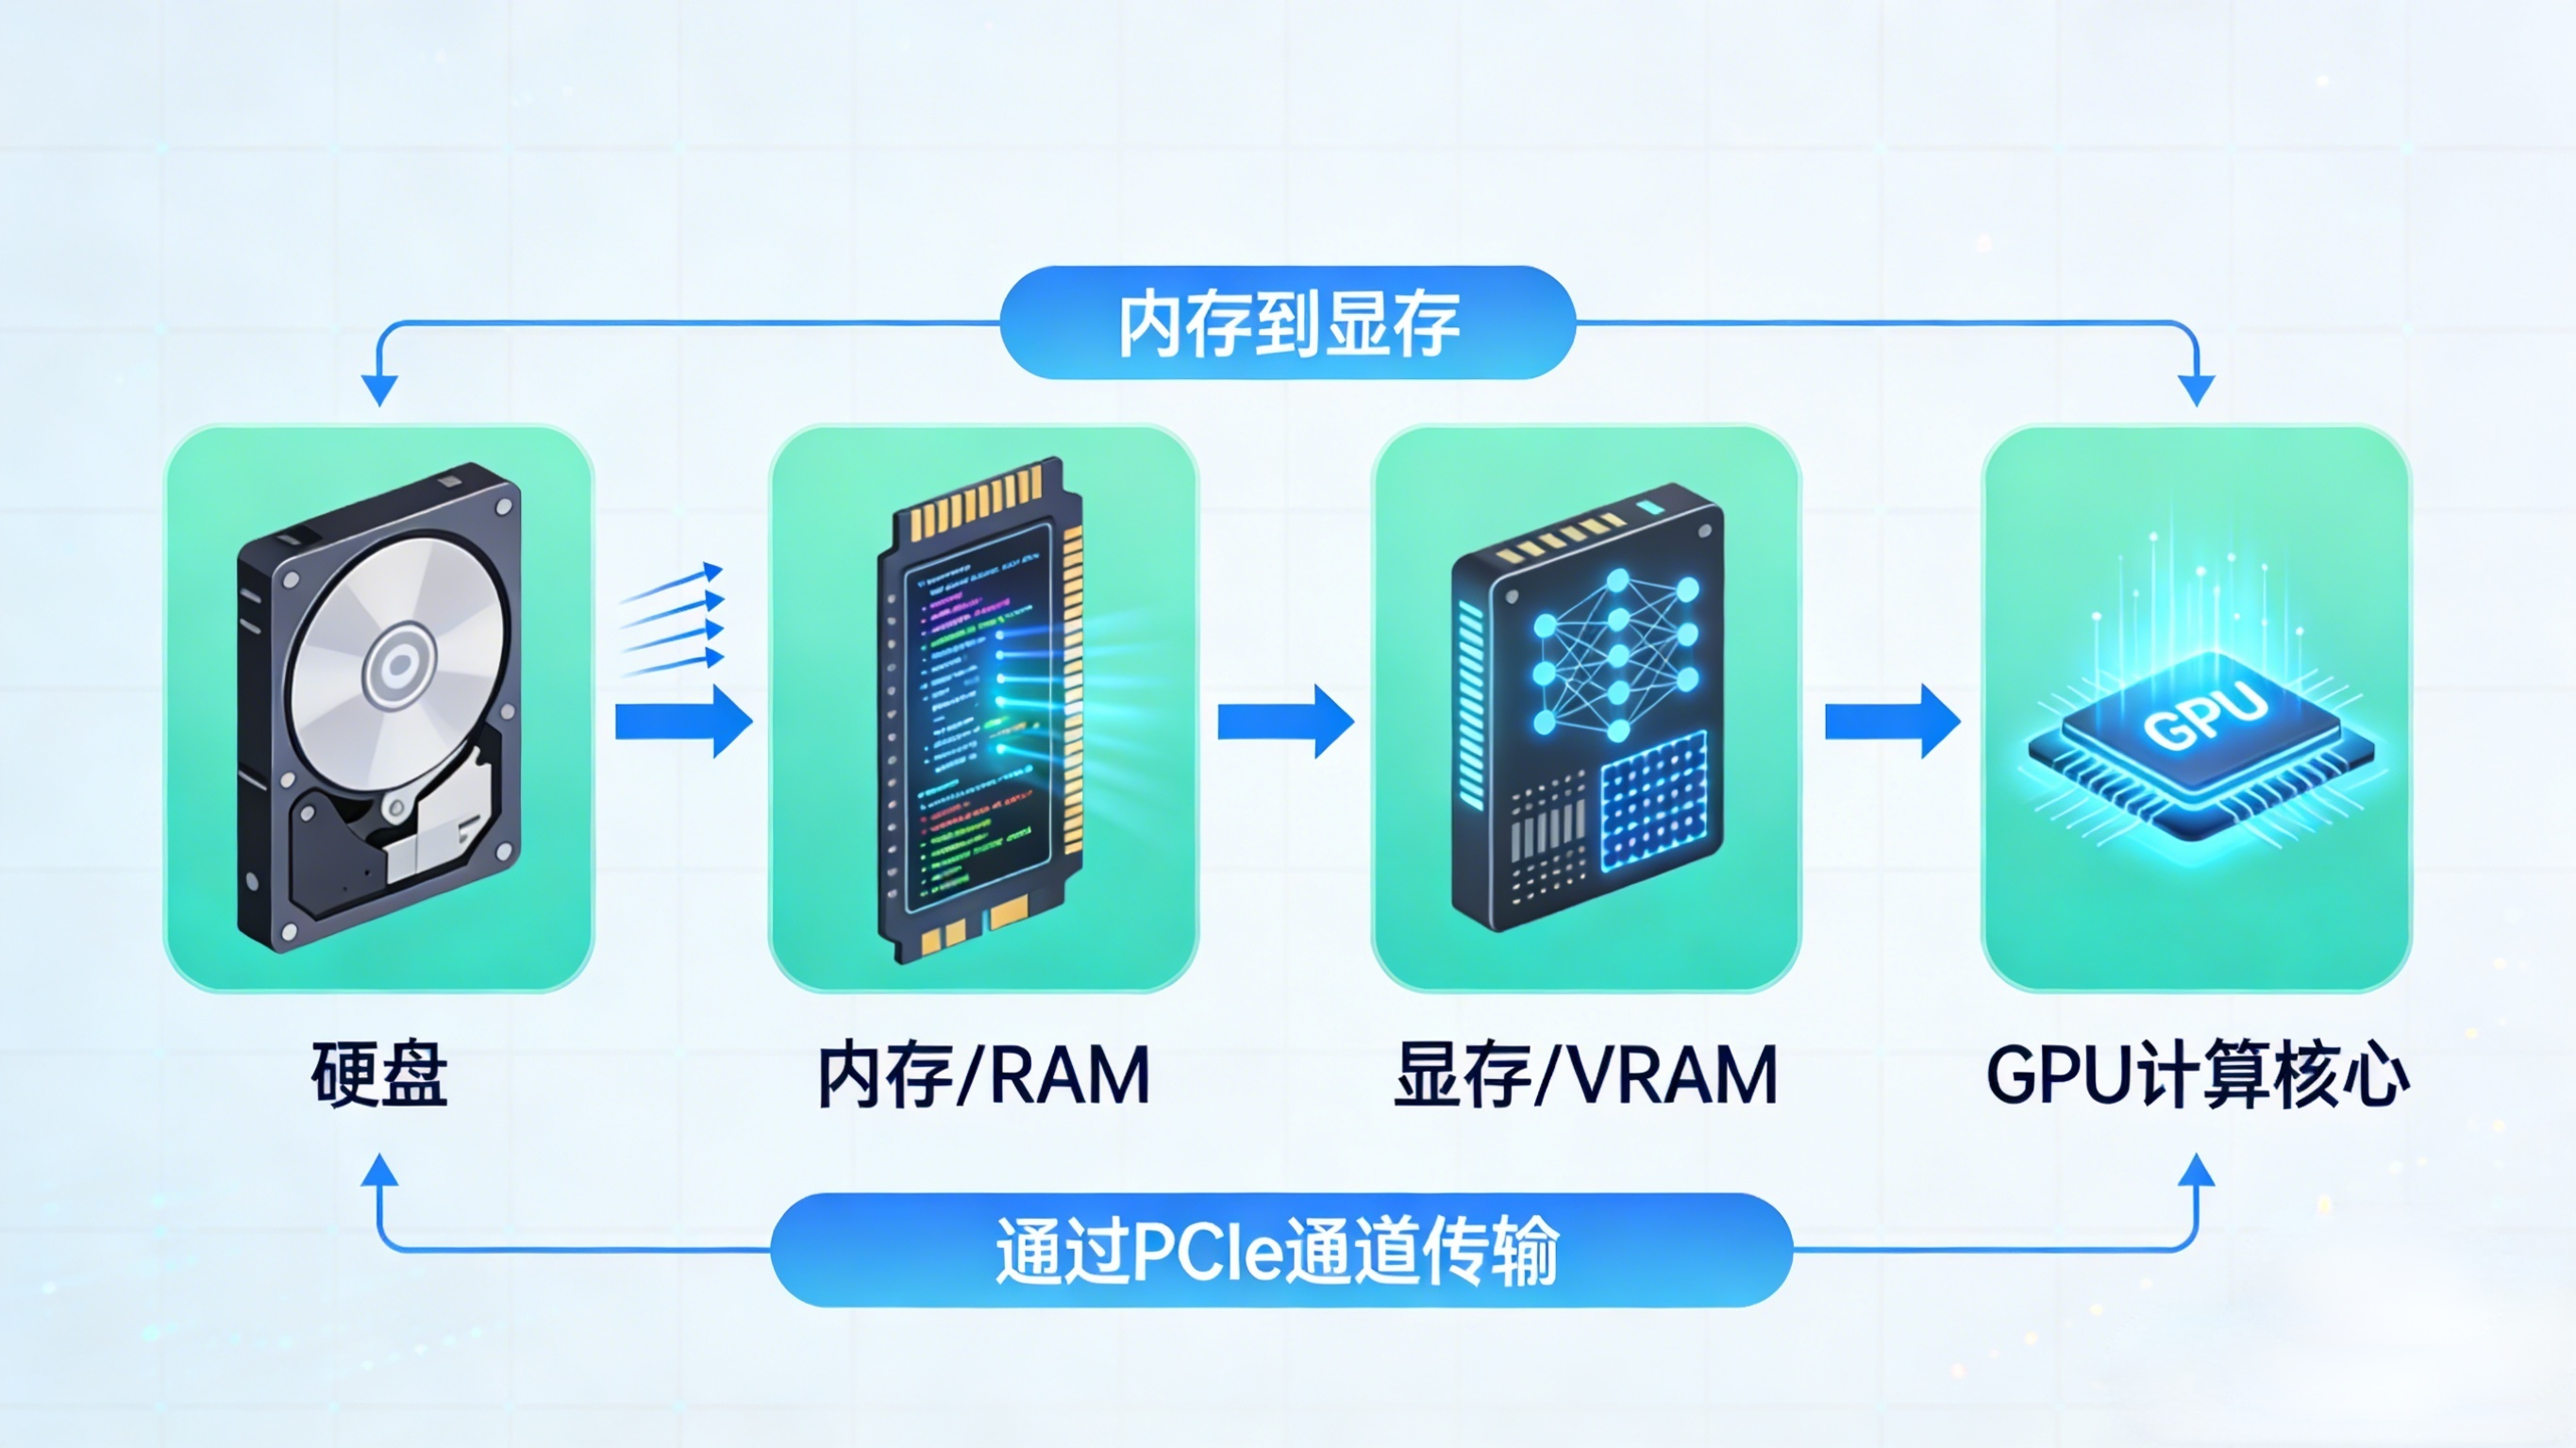
让我们以一个经典的AI模型微调任务为例,看看数据如何在内存和显存之间流动:
步骤1:数据准备与加载(发生在内存)
python
import pandas as pd
from datasets import load_dataset

# 1. 从硬盘读取原始数据集 -> 加载到内存中
dataset = load_dataset('your_dataset')
# 此时,dataset对象、你的Python解释器、PyCharm等都在内存中
这一步主要消耗内存。 如果你的数据集非常大(几十GB),就需要足够大的内存来承载并进行预处理(清洗、分词等)。
步骤2:模型加载(从内存到显存的关键一跃)
python
import torch
from transformers import AutoModelForCausalLM

# 2. 从硬盘加载模型权重文件 -> 首先读入内存
model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-3.2-1B")
# 此时,模型的10亿个参数全部在内存中

# 3. 【最关键的一步】将模型从内存转移到显存
model = model.to('cuda')  # 或 .cuda()
# 执行这行代码后,PCIe通道开始忙碌,将模型参数从内存搬运到显存。
# 此后,GPU才能开始对模型进行计算。
“CUDA out of memory”错误最常发生在这里! 如果模型的参数、优化器状态等所需空间超过了显卡的物理显存容量,搬运就会失败,即使你的内存还有大量空闲。
步骤3:训练循环(核心计算发生在显存)
python
optimizer = torch.optim.Adam(model.parameters())

for batch in dataloader:
    # 4. 将一个批次的数据从内存搬到显存
    inputs, labels = batch['input_ids'].cuda(), batch['labels'].cuda()

    # 5. GPU在显存中进行前向传播、损失计算、反向传播
    outputs = model(inputs)
    loss = compute_loss(outputs, labels)
    loss.backward()
    optimizer.step()
    optimizer.zero_grad()
    # 所有这些计算涉及的海量矩阵操作,都依赖显存的高速带宽。
步骤4:检查点保存(从显存回传内存,再写入硬盘)
python
# 6. 将训练好的模型权重从显存传回内存
cpu_model_state = model.state_dict()  # 这个操作会触发数据从显存->内存

# 7. 从内存写入硬盘保存
torch.save(cpu_model_state, "fine_tuned_model.pth")
对于初学者或想快速验证想法的研究者来说,配置本地硬件环境可能是一道门槛。此时,云平台或在线工具就显得非常友好。我个人比较推荐直接上手做一次微调,比如用 LLaMA-Factory Online 这类低门槛大模型微调平台,它提供了Web界面和预置环境,你只需要上传自己的数据,选择基础模型,就能在线完成微调流程,无需操心显存配置、CUDA版本等底层问题。这能让你在实践中最快地理解数据是如何“喂”给模型,并让它“更像你想要的样子”的。
第四章:效果评估与瓶颈诊断
如何判断你的任务是受限于内存还是显存?
-
监控工具是你的眼睛:
- Windows:任务管理器 -> “性能”标签页,分别查看“内存”和“GPU”的使用情况。
- Linux/macOS:使用
htop(内存/CPU) 和nvidia-smi(Linux下监控NVIDIA GPU,显存、利用率、温度) 命令。 - Python:可以使用
psutil库监控内存,用pynvml库监控显存。
-
典型症状判断:
-
症状:程序运行缓慢,系统整体卡顿,硬盘灯狂闪。
-
诊断:查看内存使用率接近100%。这表示“办公桌”满了,CEO(CPU)不得不频繁地把一些不常用的文件临时扔到“仓库”(硬盘/虚拟内存)里,需要时再取回来,这个过程极慢。
-
解决方案:增加物理内存,或关闭不必要的程序。
-
症状:AI训练/推理直接报错
RuntimeError: CUDA out of memory,或3D渲染软件闪退。 -
诊断:查看
nvidia-smi,显存使用在出错前瞬间达到峰值并溢出。 -
解决方案:这是更棘手的问题,因为显存无法直接升级。你可以尝试:
- 减小批次大小(Batch Size) :这是最直接有效的方法。
- 使用梯度累积:模拟大批次训练,但每次计算用小批次。
- 采用混合精度训练(AMP) :使用
torch.cuda.amp,用FP16代替FP32存储数据和计算,可显著减少显存占用并加速。 - 启用激活检查点(Gradient Checkpointing) :用时间换空间,重新计算部分中间激活值而非全部存储。
- 考虑模型并行或分布式训练:将模型拆分到多个GPU上。【产品推荐位】对于想深入探索分布式训练的研究者,可以考虑从 Amazon SageMaker 或 Google Cloud Vertex AI 这类托管服务开始,它们简化了多卡、多节点的集群管理和训练任务部署,让你更专注于算法本身。
-
总结与展望
让我们最后总结一下这对“黄金搭档”:
- 内存(RAM) 是通用、经济、容量大的系统工作台,它确保了整个计算机环境的流畅与稳定,是所有任务的起点和终点。
- 显存(VRAM) 是专用、昂贵、带宽极高的加速器工作台,它直接决定了GPU(尤其是应用于AI和高性能计算时)的任务处理能力和上限。
未来展望:
随着AI模型参数规模指数级增长,以及计算任务复杂度的提升,显存(特别是其带宽和容量)正成为更核心的瓶颈。未来的技术趋势也围绕着它们展开:
- 更先进的显存技术:如HBM3e、HBM4,继续推高带宽天花板。
- 异构统一内存架构:像AMD的Infinity Fabric、NVIDIA的Grace Hopper超级芯片(CPU和GPU通过NVLink-C2C紧密耦合),旨在模糊内存与显存的物理界限,让CPU和GPU能更高效、更低延迟地访问同一块大内存池,减少数据拷贝开销。
- 计算存储一体化:直接在存储介质(如SSD)附近或内部集成计算单元,挑战传统的“CPU-内存-硬盘”分层架构。
希望这篇超过3000字的详解,能帮你彻底理清内存与显存的关系。理解它们,不仅是读懂硬件配置单,更是你优化代码、设计高效算法、合理利用计算资源的起点。下次再遇到“CUDA out of memory”时,相信你一定能胸有成竹,精准排障!
 6484


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


