Dify 解析-RAG

Dify与RAGFlow结合:智能应用开发与深度文档理解的优化 RAGFlow是一个专为深度文档理解和检索增强生成而设计的引擎,它结合了预训练的大型语言模型(LLMs)和高效的检索技术,为用户提供了一个强大的工具来处理复杂的问题和场景。RAGFlow的核心优势在于其混合检索能力,它能够从大规模知识库中检索相关文档,然后将这些信息与模型的生成能力相结合,生成更准确、更全面的答案。这种混合方法特别适用于处理需要深度理解和综合多个信息源的问题,如智能客服、搜索引擎和知识库应用。RAGFlow的工作流程包括两个主要部分:检索和生成。 阅读详情
AI摘要

本文介绍了 RAG(检索增强生成)技术,它利用外部知识库增强大模型生成能力。还阐述了 Dify 这一开源大模型应用开发平台,其工作流程包含数据预处理、检索等步骤。重点解析了 Dify 的 RAG 架构,涵盖知识库管理、检索引擎等组件,可提升大模型生成内容质量。

一、什么是 RAG?

(一)RAG 的基本概念

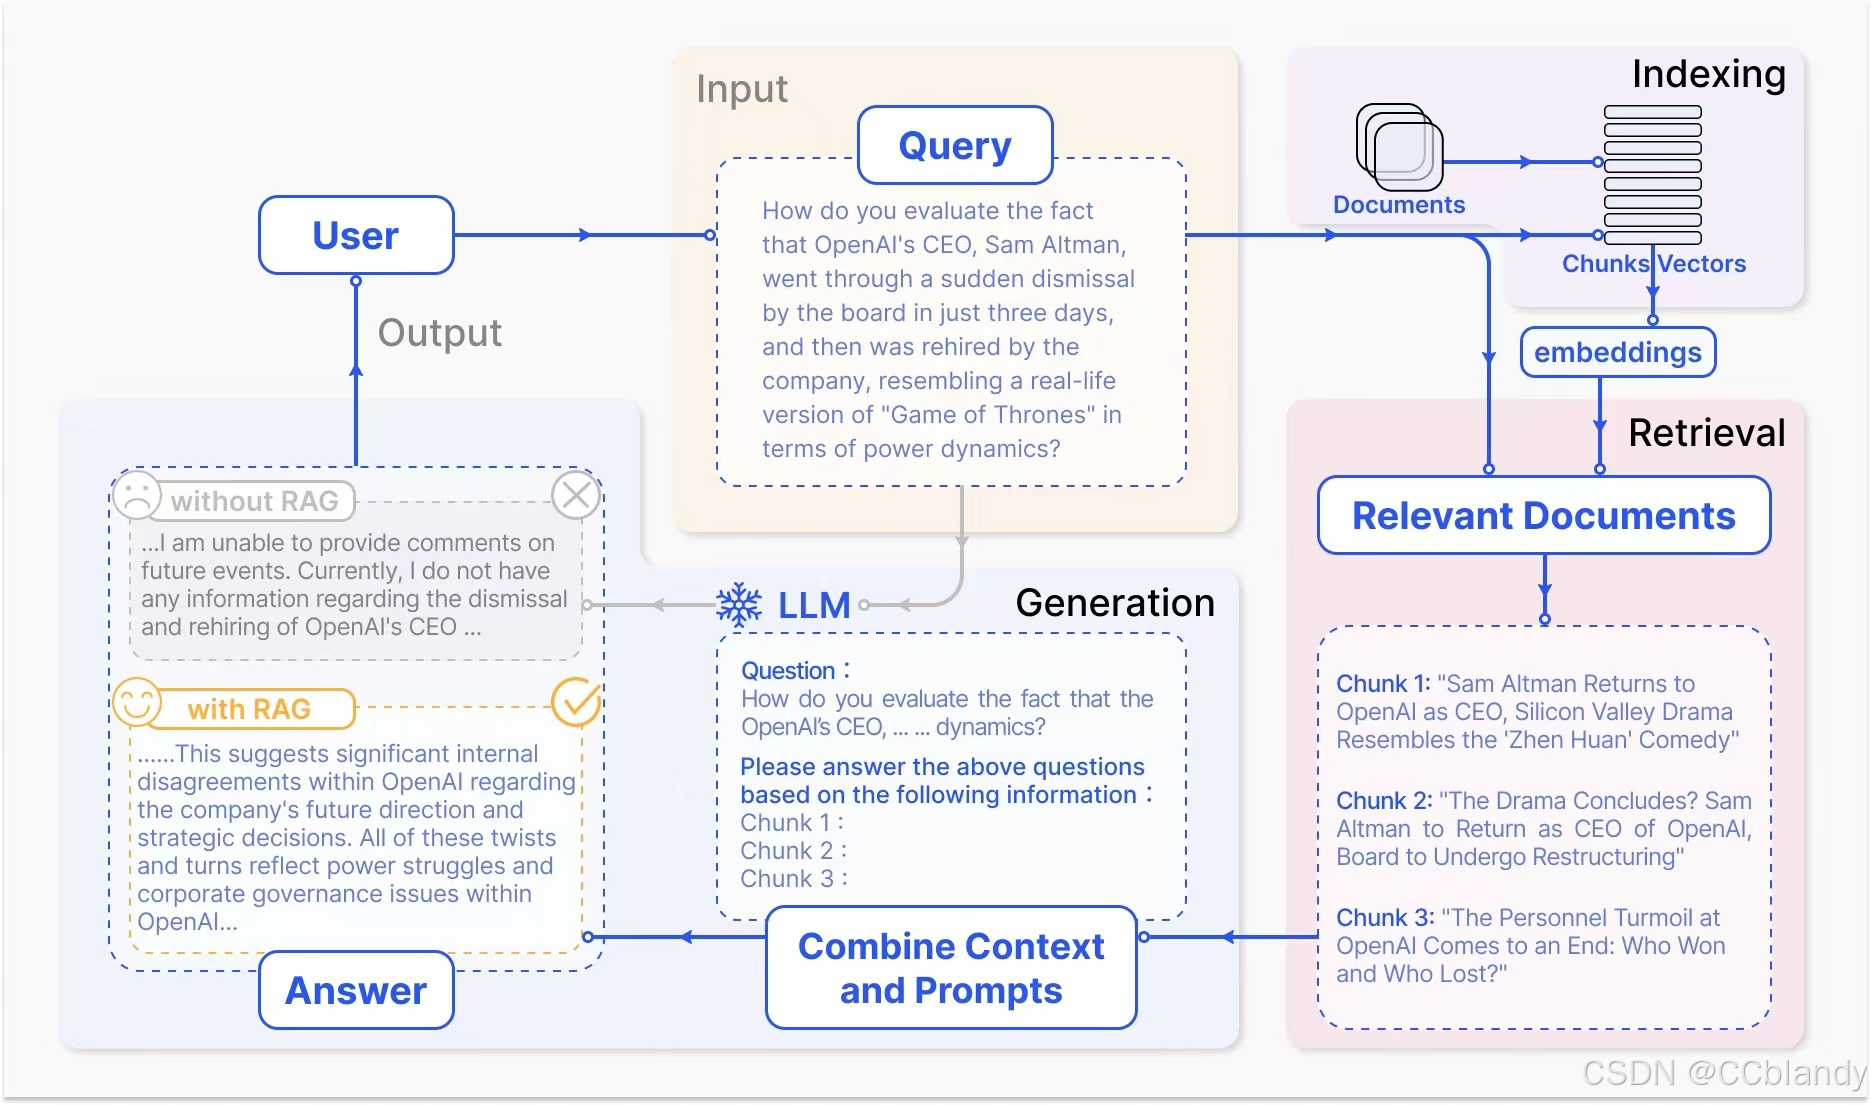
RAG(Retrieval Augmentation Generation)即检索增强生成。简单来说,RAG 是一种利用外部知识库中的信息来增强大模型生成能力的技术。通过从外部知识库检索相关信息,并将其作为输入提示词的上下文,从而提高大模型生成文本的相关性、准确性和多样性。

(二)RAG 的架构与执行流程

RAG 本质上是一套给大模型提供足够信息的上下文系统。其基本架构如下图所示:
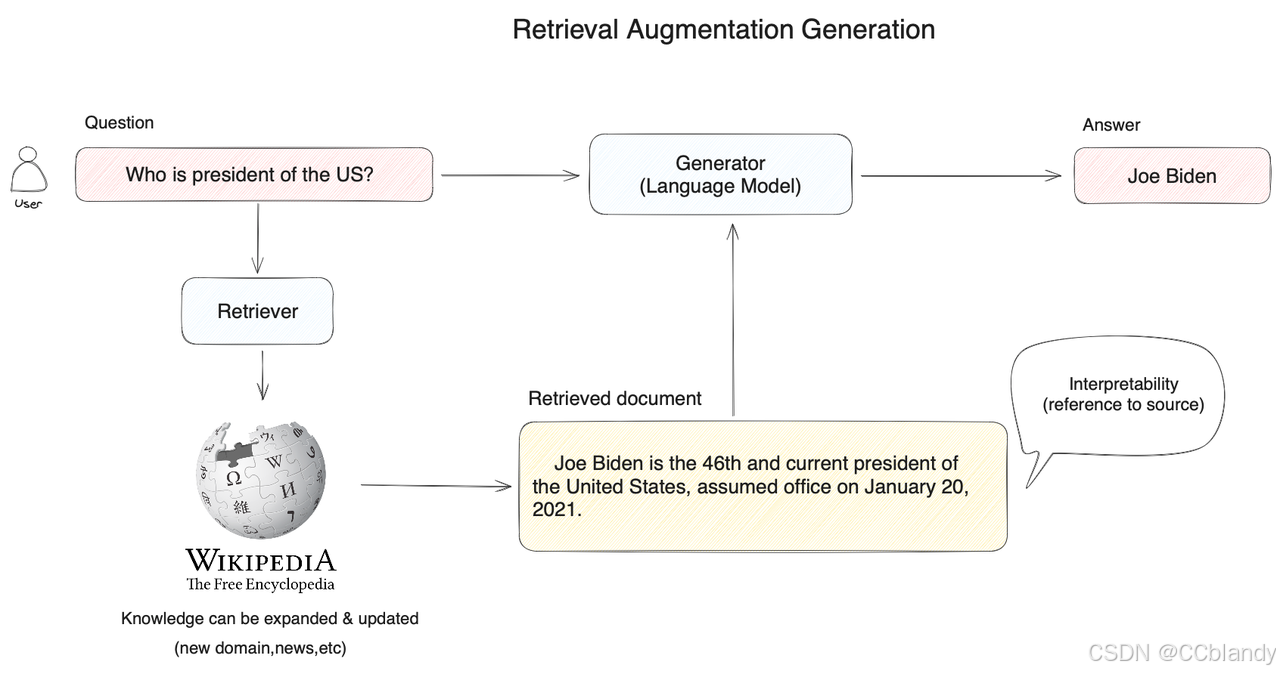
  1. 知识库管理:负责存储和管理外部知识,包括文本数据、多媒体数据等。

  2. 检索引擎:用于从知识库中检索与用户查询相关的信息。

  3. 提示词管理:负责生成和优化提示词。

  4. 模型推理服务:提供大模型的推理能力。

RAG 的执行流程如下图:

具体步骤如下:

  1. 用户输入查询请求。

  2. 检索引擎从知识库中检索相关信息。

  3. 提示词管理生成合适的提示词。

  4. 模型推理服务调用大模型进行推理。

  5. 输出优化生成最终的回答。

(三)RAG 的优势

RAG 的优势在于它只利用大模型的逻辑能力来得到准确的输出,而不使用大模型的任何记忆能力。这种设计方式符合吴恩达课程中的观点,将大模型视作一个逻辑推理引擎。

二、什么是 DIFY?

(一)DIFY 的基本概念

Dify 是一个流行的开源大模型应用开发平台。其核心理念是 "Do It For You"。Dify 内置了构建 LLM 应用所需的关键技术栈,包括插件、代理/反向代理、数据库/缓存、实验训练和可观测(Open Telemetry)。

(二)DIFY 的工作流程

Dify 的工作流程包括以下几个步骤:

  1. 数据预处理:将原始数据转换为适合模型学习的格式。

  2. 数据检索:根据用户的查询请求,从预先构建的知识库或数据集中检索相关信息。

  3. 提示词生成:将检索到的信息与用户的查询意图相结合,生成合适的提示词。

  4. 内容生成:将提示词输入到大模型中进行推理,生成最终的文本内容。

  5. 输出优化:对生成的内容进行后处理,以提高其质量和可读性。

三、Dify 的 RAG 架构

在 Dify 中,RAG 的实现主要涉及以下几个核心组件:

(一)知识库管理

知识库管理负责存储和管理外部知识,包括文本数据、多媒体数据等。这些知识可以来自多种来源,如企业内部文档、公开数据集、网络资源等。知识库需要具备高效的存储和检索能力,以支持大规模数据的快速访问。

(二)检索引擎

检索引擎用于从知识库中检索与用户查询相关的信息。常见的检索方法有基于关键词的检索、基于向量相似度的检索以及混合检索方法。

召回模式
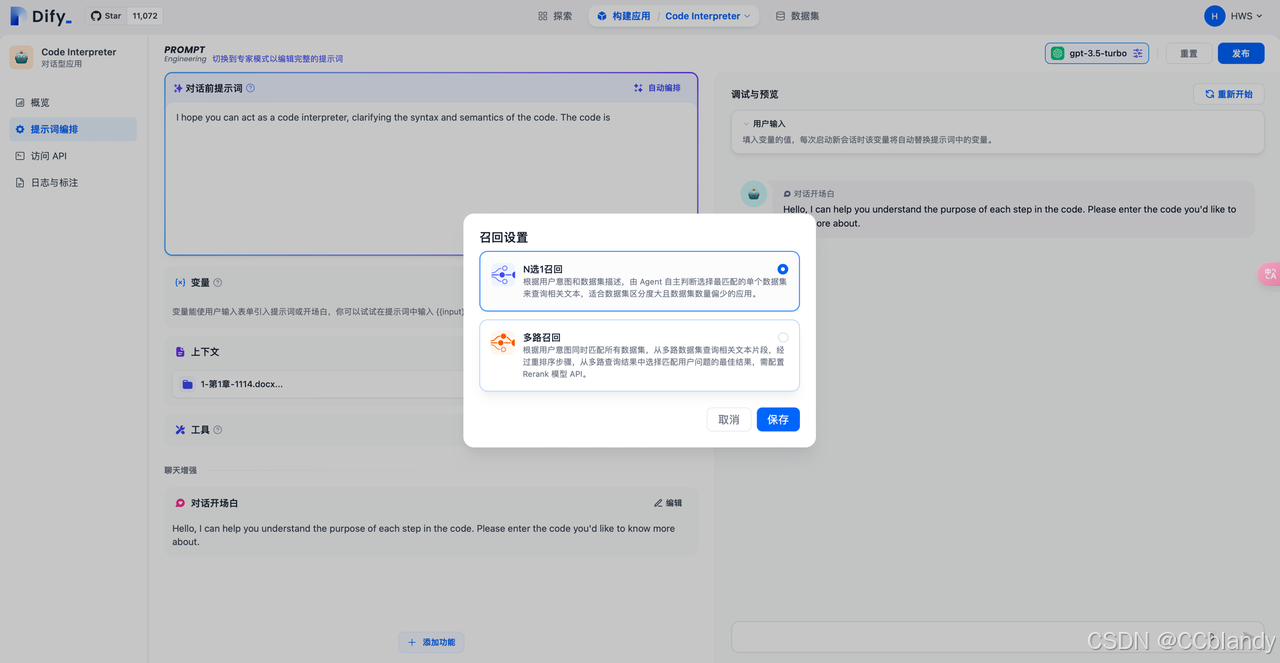
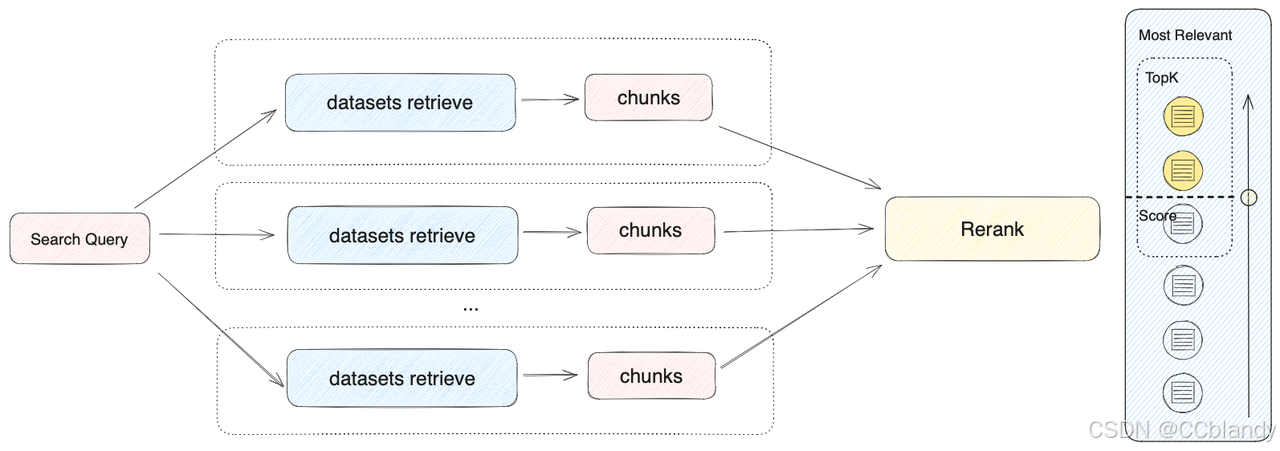
当用户构建知识库问答类的 AI 应用时,如果在应用内关联了多个数据集,Dify 在检索时支持两种召回模式:N选1召回模式和多路召回模式。
1.N选1召回模式
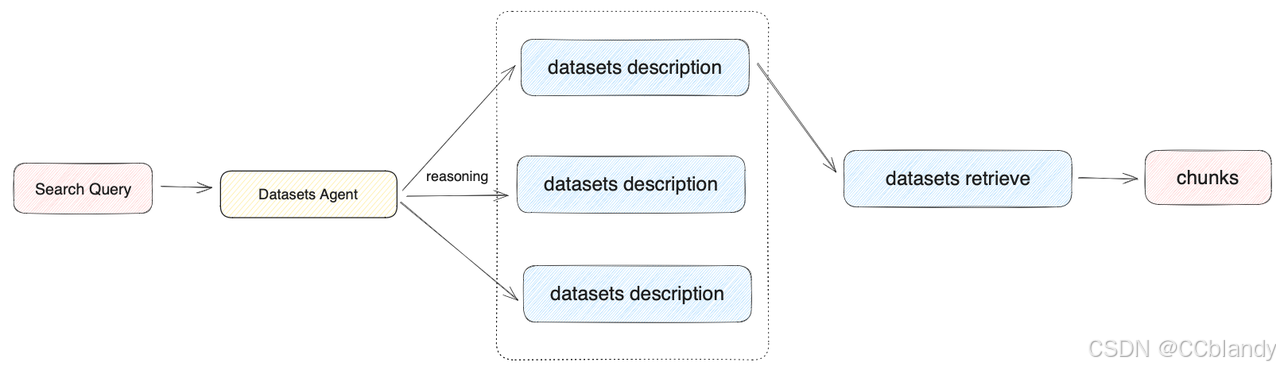
在用户上传数据集时,系统将自动为数据集创建一个摘要式的描述。为了在该模式下获得最佳的召回效果,可以"数据集->设置->数据集描述"中查看到系统默认创建的摘要描述,并检查该内容是否可以清晰的概括数据集的内容。根据用户意图和数据集描述,由 Agent 自主判断选择最匹配的单个数据集来查询相关文本,适合数据集区分度大且数据集数量偏少的应用。
提示:OpenAI Function Call已支持多个工具调用,Dify将在后续版本中升级该模式为"N选M召回"。

2.多路召回模式(推荐)
根据用户意图同时匹配所有数据集,从多路数据集查询相关文本片段,经过重排序步骤,从多路查询结果中选择匹配用户问题的最佳结果,需配置 Rerank 模型 API。在多路召回模式下,检索器会在所有与应用关联的数据集中去检索与用户问题相关的文本内容,并将多路召回的相关文档结果合并,并通过 Rerank 模型对检索召回的文档进行语义重排序。
(三)提示词管理

提示词管理负责生成和优化提示词。提示词的生成可以根据用户查询和检索结果自动完成,也可以由用户手动输入。此外,还可以通过模板或动态生成策略来优化提示词。

(四)模型推理服务

模型推理服务提供大模型的推理能力。当接收到提示词后,模型推理服务会调用相应的大模型进行推理,生成最终的回答。

四、总结

Dify 通过 RAG 技术,实现了对外部知识的高效利用,极大地提升了大模型生成内容的质量和相关性。RAG 架构中的知识库管理、检索引擎、提示词管理和模型推理服务等组件相互配合,共同构成了一个完整的 RAG 系统。在实际应用中,企业可以根据自身的需求和数据特点,对这些组件进行定制和优化,以满足特定业务场景下的要求。

参考文献
[1] 检索增强生成(RAG):https://docs.dify.ai/v/zh-hans/learn-more/extended-reading/retrieval-augment

[2] 知识库:https://docs.dify.ai/v/zh-hans/guides/knowledge-base

[3] Unstructured:https://docs.unstructured.io/welcome

[4] dify源码解析-RAG:https://zhuanlan.zhihu.com/p/704341817

【Dify】RAG开源框架Dify:技术深度剖析与实践指南 Dify作为一个开源的RAG框架,凭借其强大的数据集管理功能、可视化的Prompt编排、高效的RAG管道、灵活的Agent功能以及多种大型语言模型的支持,为开发者提供了一个快速搭建生产级AI应用的平台。无论是对于技术人员还是非技术人员来说,Dify都大大降低了AI应用开发的复杂度,使得更多人能够参与到AI应用的开发和创新中来。未来,随着技术的不断进步和应用场景的不断拓展,Dify有望在人工智能领域发挥更加重要的作用。例如,通过引入更多的自然语言理解和生成技术,Dify可以进一步提升其问答和文本生成的能力。 阅读详情

相关推荐

集成mineru解析引擎:优化Dify知识库PDF文档的RAG处理效能

本文详细介绍了如何集成mineru解析引擎以优化Dify知识库中PDF文档的RAG处理效能。mineru通过智能识别文档逻辑结构,显著提升复杂PDF(如金融报表、学术论文)的解析质量,确保问答准确率。文章提供了从环境准备到效果验证的完整实操步骤,并探讨了结构化数据抽取等进阶应用场景。

weixin_26782929的博客 366

Dify中的RAG和知识库

向量检索优势:复杂语义的文本查找,相近语义理解,多语言理解,多模态理解,容错性。传统关键词搜索优势:精确匹配,少量字符的匹配,倾向低频词汇的匹配。向量检索和关键词检索在检索领域各有其优势。混合检索通过多个检索系统的组合,实现了多个检索技术之间的互补。

NLP工程化 7833

集成mineru解析引擎:优化Dify知识库PDF文档的RAG处理质量

本文详细介绍了如何将mineru解析引擎集成到Dify知识库中,以优化PDF文档的RAG处理质量。针对Dify默认解析器在处理复杂表格、多栏版式和公式时的不足,通过替换PDF解析模块,利用mineru强大的版面分析和表格还原能力,显著提升文档解析的结构化程度与准确性,从而从根本上改善后续检索与生成的效果。

weixin_29102619的博客 337

一文彻底搞懂大模型 - Dify(Agent + RAG)

该平台结合了后端即服务(Backend as Service, BaaS)和LLMOps的理念,为开发者提供了。

m0_59163425的博客 27万+

MinerU+Docker+Dify:从PDF解析到知识库RAG的完整部署实践

在RAG应用落地过程中,PDF文档的解析质量直接决定知识库检索与问答的上限。传统文本抽取工具面对扫描件、双栏排版、复杂表格时往往力不从心,而基于视觉语言模型的版面还原技术能够重建阅读顺序并输出结构化Markdown,为后续切块和向量化提供干净数据。实际工程中,通过Docker容器化部署解析服务,既规避了Python环境依赖冲突,又能与Dify知识库无缝集成,形成从文档上传到智能问答的自动化流水线。对于内外网隔离的生产场景,离线镜像打包与模型缓存迁移也是必须掌握的技能。本文将完整梳理从Docker Deskt

weixin_30843121的博客 232

深入解析Dify的RAG索引构建流程:从文件上传到向量存储

本文深入解析Dify平台的RAG索引构建流程,从文件上传到向量存储的全过程。详细介绍了文档处理流水线的三个阶段:格式校验、文本分块和向量化,以及IndexingRunner的多阶段处理引擎和动态处理器注册机制。通过实际案例和性能优化技巧,帮助开发者高效构建可检索的知识库。

weixin_29214559的博客 362

Dify知识库-RAG流程解析

代码目录:api/core/rag/index_processor/processor/paragraph_index_processor.py。代码目录:api/core/rag/index_processor/processor/paragraph_index_processor.py。根据文件后缀名调用不同的文档解析器提取文档内容,根据不同的文本格式,调用不同的类,去处理文本,最终会返回提取的文本内容。代码目录:api/core/rag/extractor/extract_processor.py。

一次次探索代码无限可能的旅程,专注于前端、后端、服务器及AI大模型的分享和交流。与我一起踏上这段无尽的技术之旅吧! 2702

Dify RAG技术深度解析:从文本分块到向量检索的全流程优化

本文深入解析Dify RAG技术,从文本分块到向量检索的全流程优化,揭示其在处理多语言、多格式文档中的优势。通过动态分块机制、双索引架构和混合检索技术,Dify RAG显著提升信息提取效率与准确性,适合开发者优化现有系统或构建高性能检索应用。

weixin_30823001的博客 410

mineru+dify改善dify中RAG解析pdf性能和效果

上一篇文章中我们部署了mineru的API,在此基础上,默认dify也已经部署好,想要修改dify中上传知识库的pdf解析效果,联动mineru。主要是增加了mienru_parse函数简单调用了api,并将结果保存dify封装的Document类中。

m0_45070559的博客 1673

Dify 第 8 篇 RAG 必知概念及原理详解

摘要: 本文介绍了检索增强生成(RAG)的基本概念与实现原理。RAG通过结合向量检索与大模型能力,解决大模型知识局限和幻觉问题。核心流程包括离线阶段的文档向量化存储和运行时的语义检索增强。文章还探讨了Embedding技术(文本转化为向量)的作用、模型选择策略,以及混合检索(结合向量与关键词检索)的优势。RAG适用于智能客服、知识库等场景,提升回答准确性。最后比较了RAG与微调、长文本处理的差异,强调其在成本与实时性上的优势。 (字数:149)

甘蓝的专栏 1945

Unified Access Control:从NAS到RRC的5G接入控制全流程解析

本文深入解析了5G统一接入控制(Unified Access Control)的全流程,从NAS到RRC的协同工作机制。通过身份核验、业务分类和动态决策三个核心步骤,UAC实现了智能调度和弹性决策,确保海量设备接入时的网络稳定性。文章详细介绍了USIM卡的身份凭证体系、NAS层的业务分类引擎以及RRC层的动态决策机制,并提供了实战案例和常见问题排查方法。

weixin_30855099的博客 588

Dify中RAG技术实战应用解析

深入探讨Dify平台如何集成RAG技术,通过检索增强生成提升大模型准确性与时效性,减少幻觉问题。涵盖核心原理、配置方法、代码示例及智能客服等企业级应用场景,助力高效构建AI应用。

weixin_33812391的博客 913

如何通过CAD图中的坐标来确定是哪个坐标系

地理坐标系:为球面坐标。参考平面地是椭球面,坐标单位:经纬度。以地球参考为例,坐标系就相当于整个地球,而地理坐标系就是椭球状的完整的立体地球。所以我们可以看到生活中的数据与地图是一定含有地理坐标系的,因为他是客观上来说确确实实存在的。投影坐标系:为平面坐标。参考平面地是水平面,坐标单位:米、千米等。这就相当于把地球当成一个橘子,然后一刀切开,把橘子皮平面铺开,这个过程就是地理投影的过程。严谨一点来说就是建立一个参考系统,按照对应位置把椭球体投射到平面。那坐标系统主要有那些呢?北京54。

vjmap的博客 2万+

大模型RAG开源高星项目,区别全解析(含Dify深度解析)

RAG(Retrieval-Augmented Generation)通过结合信息检索与大模型生成能力,从外部知识库中实时获取相关数据,显著提升回答的准确性和可解释性。它特别适用于需要动态更新知识、减少"幻觉"的场景,如企业知识库问答、医疗诊断支持等。如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!

2401_85373691的博客 948

基于DFT的scanshift sdc模板(DFT)

摘要:本文详细介绍了DFT测试模式下的SDC约束方法。

murphyrong的博客 884

从零开始:手把手教你检查并更新英伟达GPU驱动和CUDA版本(Windows/Linux双平台)

本文详细指导如何在Windows和Linux系统上检查并更新英伟达GPU驱动和CUDA版本,解决版本不匹配导致的常见问题。涵盖驱动更新、CUDA Toolkit安装、版本冲突排解及性能优化技巧,帮助开发者高效管理GPU计算环境。

weixin_29237635的博客 701

Dify为什么总是外接RAGFlow?深度解析这对RAG黄金组合

Dify和RAGFlow是AI开发领域的热门组合,二者各有所长:Dify作为大语言模型应用开发平台,擅长工作流编排和多模型调度;RAGFlow则是专业RAG引擎,专注于深度文档解析和精准检索。Dify内置知识库功能虽能满足基础需求,但在处理复杂文档结构、大规模数据及精细检索优化方面存在不足。RAGFlow凭借视觉化文档理解、灵活的检索策略和可视化干预能力,成为企业级知识库的理想选择。二者的结合实现了能力互补。

qq_67237154的博客 353

Kylin V10 ARM64离线安装ffmpeg实战指南

在国产化替代浪潮下,基于银河麒麟V10和ARM架构(如飞腾、鲲鹏)的内网服务器部署音视频处理服务成为常态。由于系统默认软件源缺乏aarch64包且无法连接外网,常规yum安装方式难以奏效。本文从离线安装的通用概念出发,剖析了在Kylin V10上安装ffmpeg的三大路线及其原理,重点介绍了源码编译法,包括依赖梳理、工具链准备、编译参数配置、常见错误排查等关键环节。同时,将这套依赖管理与离线部署方法论延伸至nginx、node.js、Python库及docker等场景,帮助读者建立一套可复用的国产化系统离线

weixin_33417488的博客 148

从 Dify 学 RAG 工程化:多格式文档解析的统一抽象设计

分层抽象:加载 vs 解析 vs 分块职责分离标准契约:统一输出结构打通下游生产就绪:容错、降级、元数据保留对于服务端开发者而言,这不仅是“怎么用 Dify”,更是“如何设计可维护的 AI 应用架构”。

m0_64363449的博客 1122

深入解析JESD204B Subclass 1中的SYSREF与LMFC同步机制

本文深入解析了JESD204B Subclass 1协议中的核心同步机制,重点阐述了SYSREF信号如何作为系统级参考,对齐所有设备内部的本地多帧时钟(LMFC),从而实现高速多通道数据采集系统中的确定性延迟。文章结合实战经验,详细说明了硬件设计、时序要点及软件配置流程,是解决多ADC芯片同步对齐问题的关键指南。

weixin_29271263的博客 398

RK3588平台MIPI DSI屏幕调试记录

本文是基于RK3588平台,MIPI屏调试总结。调试过程中遇到的问题:一开始很久没亮,测量了电源电压和波形都正常。后来换了一组板子和屏幕做对比。最后是因为屏幕的座子没焊接好,二是接MIPI屏幕的排线太长会影响数据传输。换了一根短的线之后屏幕亮起。vp2vp3。

bingdund的博客 1389

Dify中RAG技术实战解析与企业应用

深入探讨Dify平台如何集成RAG技术,提升大语言模型的准确性与时效性。涵盖检索增强生成的工作原理、关键配置、代码实现及智能客服、搜索等场景的应用,结合真实企业案例展示落地效果。

weixin_42393362的博客 645

Vue3 - 详解播放m3u8视频流+HLS拉流推流完整方案,vue3如何播放m3u8格式文件实时视频播放教程(流媒体播放、直播视频流、实时摄像头监控视频流对接、后端服务器切片分片传输视频流边下边播)

vue3组件播放m3u8格式视频,实现hls流媒体监控摄像头实时播放,vue3播放m3u8视频流格式,实时直播画面视频流播放,摄像头监控画面推流,hls.js,Vue Video.js播放m3u8视频流格式,实现hls流媒体监控摄像头实时播放,vue中使用video.js播放m3u8格式的视频,m3u8格式视频,通过HLS协议播放m3u8格式视频,黑屏不显示怎么办,视频非常卡加载缓慢,拉流报错,推流报错,播放失败,播放监控m3u8视频流格式,苹果ios播放,vue3中使用video标签播放MP4,西瓜视频插

🏆 前端领域优质创作者 5938

Dify数据集管理功能深度解析:打造高质量RAG应用的基础

Dify的数据集管理功能提供从文档上传到向量索引的全链路知识处理,支持多种格式解析、智能分块与清洗,并集成主流嵌入模型和向量数据库。通过可视化操作实现零代码构建高质量知识库,兼顾工程灵活性与业务敏捷性,解决RAG应用中知识更新滞后、检索不准确等核心痛点。

weixin_42181686的博客 935

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

上一篇: 利用大模型视觉能力识别图片结合零代码实现原型一键转系统
下一篇: Deepseek训练与微调
AI低码智造
博客等级 码龄18年 2321粉丝 96原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

AI低码智造

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值