

ollama 部署模型休眠、释放问题

ollama如何保持模型加载在内存(显存)中或立即卸载 阅读详情
AI摘要

ollama部署的LLM模型,默认5分钟无请求就会释放资源,导致下次聊天首句响应慢。可通过两种方式调整模型存活时长:一是在POST参数中设置,负数为无限期保留,0为卸载;二是在Dify应用模型参数中设置,用带单位字符串表示时间。

存在问题

ollama部署的LLM模型,一段时间不发送请求,模型资源就会被释放,下次聊天的时候就得重新调起模型、第一句话响应很慢。

这是因为ollama部署的模型默认是5分钟没有收到请求就会被释放,因此需要根据具体情况调整这个模型存活的时长。

解决思路

第一种情况、在POST参数中设置

在 POST 模型 API 时,有一个可选参数 keep_alive,用于控制模型在请求后加载到内存中的时间(默认:5m,即五分钟)。

如果需要无限期保留模型、模型一直加载在内存里,这个参数可以设置为负数,如 -1。

curl http://localhost:11434/api/generate -d '{
  "model": "llama3.2",
  "keep_alive": -1
}'

如果需要卸载模型,可以设置该参数为0:

curl http://localhost:11434/api/generate -d '{
  "model": "llama3.2",
  "keep_alive": 0
}'

第二种情况、在Dify具体应用的模型参数中设置

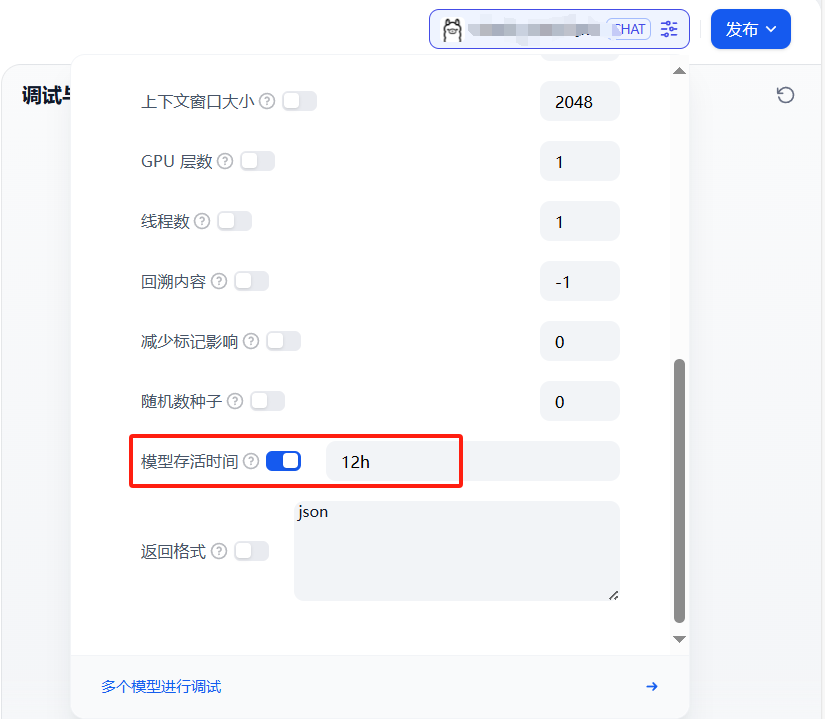
在Dify界面中,设置模型配置参数中的【模型存活时间】,这个是用于设置模型在生成响应后在内存中保留的时间。

这里的时间需要是一个带有单位的持续时间字符串(例如,'10m’表示10分钟,24h’表示24小时)。

负数表示无限期地保留模型,'0’表示在生成响应后立即卸载模型。

有效的时间单位有’s(秒)、‘m’(分钟)、h’(小时)。(默认值:5m)
在这里插入图片描述
例如,我们把这个参数设置为12h,这样在12个小时之内,模型就会加载在内存中,不会被中途释放,隔一段时间进行对话、也不会有重新加载模型的卡顿问题。

参考文档

https://github.com/ollama/ollama/blob/main/docs/api.md#generate-a-chat-completion

OpenClaw+Ollama本地大模型零成本部署实战指南 本地大模型部署正从‘能跑’迈向‘稳快省可扩展’的工程化阶段。其核心原理在于绕过云依赖、精准控制内存与上下文、实现模型-工具-记忆的解耦调度。技术价值体现在零API费用、断网可用、低配兼容与长期免维护,广泛适用于个人知识库、NAS家庭助手、轻量代码审查及离线多模态处理等场景。本文聚焦OpenClaw与Ollama协同落地的关键路径,深度融合params.num_ctx内存优化与keep_alive冷启动加速两大实操要点,提供面向真实硬件(如8GB内存笔记本、树莓派4B)的可验证部署方案。 阅读详情

相关推荐

在安卓学习机上部署本地大模型:Termux与Ollama实战指南

本地大模型部署是当前AI工程实践的热点,其核心原理在于将预训练好的大型语言模型在本地硬件上运行,实现数据隐私保护和离线可用性。这项技术的价值在于为开发者、学生和隐私敏感用户提供了低成本、可掌控的AI实验与开发环境。典型的应用场景包括构建私有AI助手、进行离线代码补全与文本处理,以及作为AI学习与原型验证平台。本文聚焦于一个极具代表性的实践案例:利用Termux和Ollama,在学而思学习机等封闭安卓设备上,成功部署并运行轻量级大模型,解决了在非标准Linux环境下搭建AI服务的关键挑战,为挖掘闲置设备潜力提

weixin_34268753的博客 761

如何让 Ollama 模型始终驻留显存?高效调用 AI 推理服务的秘诀!

本文介绍如何通过Ollama的keep_alive参数优化本地大语言模型部署效率。默认模型5分钟自动卸载导致重复加载损耗性能,可通过API参数(如"24h"或"infinite")或环境变量OLLAMA_KEEP_ALIVE实现模型常驻显存。详细说明Linux系统下systemd服务的配置方法,并提醒注意显存容量与多模型场景的资源管理。该方案可显著减少加载延迟,提升推理响应速度,适用于AI开发者和本地模型部署场景。

携梦问道的博客 4327

开源MoE大模型实战:从Ollama验证到vLLM生产部署

MoE(Mixture of Experts)是一种通过动态路由实现稀疏激活的高效大模型架构,其核心原理在于仅激活部分专家模块处理每个token,显著降低计算与显存开销。相比传统稠密模型,MoE在保持高参数量的同时提升吞吐、压缩显存、缩短延迟,已成为工业级大模型推理的事实标准。该技术尤其适配多模态场景与RAG增强任务,能按需调度文本、视觉等专用专家,大幅提升准确率并抑制幻觉。当前主流开源工具链中,vLLM已深度原生支持MoE调度与专家并行,而Ollama仅适用于轻量验证。本文聚焦真实生产环境下的MoE模型落

weixin_33739523的博客 313

Ollama 可以设置的环境变量

Ollama 可以设置的环境变量

engchina的专栏 2万+

Windows本地部署Qwen3.8-27B大模型:Ollama安装到API调用全指南

大模型本地部署让个人和企业可以在自有设备上运行开源模型,无需依赖云端API,兼顾数据安全与响应速度。其核心原理在于通过量化压缩参数规模,使数十亿参数的模型能在消费级硬件上运行,其中显存和内存容量直接决定推理效率。随着Ollama等工具的出现,模型下载、参数配置和API调用被大幅简化,普通用户无需深入Python或CUDA即可体验。在实际应用中,无论是构建个人知识库、搭建聊天机器人,还是为IDE接入编程助手,本地部署都提供了高性价比方案。本文以Qwen3.8-27B为例,在Windows环境下完整演示Olla

weixin_34209851的博客 474

Ollama+Docker极简部署:本地大模型服务化实战指南

大模型本地部署的核心挑战在于环境一致性、网络可达性与模型加载可控性。Ollama作为轻量级推理引擎,通过封装llama.cpp后端与HTTP API,提供标准化的文本生成接口;Docker则利用容器化隔离机制,统一运行时依赖、固化网络命名空间并支持GPU透传,从根本上规避Python环境冲突、CUDA版本错配及localhost跨平台访问失效等问题。其技术价值体现在开箱即用的服务抽象、低于150MB的镜像体积,以及对GGUF模型的原生支持。典型应用场景包括AI应用快速原型验证、企业内网离线推理服务、多模型微

cuiyingchan0663的博客 416

GPT-OSS本地部署指南:Ollama+MoE实战

通过Ollama在Windows和Ubuntu上轻松部署GPT-OSS-20B模型,支持命令行与WebUI交互,实现代码生成、联网搜索等功能,低配硬件也能运行,为开发者提供完整本地大模型实践路径。

weixin_34945060的博客 1283

Ollama本地大模型部署:断网可用、隐私可控、离线可装

本地大模型推理是指将大语言模型完整加载至终端设备内存中执行计算,无需依赖云端API,其核心原理基于内存驻留式Transformer推理与进程级沙箱隔离。该技术显著提升交互实时性、保障数据不出域,并降低长期使用成本。在金融合规、医疗科研、工业巡检等强隐私与弱网环境中,Ollama凭借零依赖安装、四层隐私防护、国产镜像支持及跨平台适配能力,成为落地私有AI工作流的首选轻量级运行时。本文深入解析其断网可用性设计、内存/磁盘/网络/模型四重隐私机制,以及国内用户最关注的离线部署与避坑实践。

weixin_33702545的博客 291

Ollama模型服务化实战:如何让RAGflow远程调用本地LLM(Ubuntu22.04+Docker方案)

本文详细介绍了在Ubuntu 22.04系统上,通过Docker部署RAGflow并使其远程调用本地Ollama大语言模型的实战方案。文章核心在于将Ollama服务化,暴露给内网访问,并配置Docker网络,实现RAGflow与本地LLM的稳定集成。同时,提供了解决Linux系统挂起后GPU驱动失效等生产环境稳定性问题的具体方法。

9o8p7i6u5y的博客 985

黑群晖AI新玩法:Ollama+Deepseek模型本地化部署与WebUI可视化交互指南

本文详细介绍了在黑群晖上本地化部署Ollama+Deepseek模型的完整指南,包括环境准备、容器配置、模型选择与性能调优,以及WebUI可视化交互的进阶玩法。通过实战案例和避坑技巧,帮助用户实现高效、隐私安全的AI模型本地部署,特别适合需要远程调用和隐私保护的场景。

weixin_28707535的博客 457

『大模型笔记』怎样让Ollama启动的大模型常驻内存(显存)?

怎样让Ollama启动的大模型常驻内存(显存)?

AI新视界 4313

本地部署大模型吃灰?用远程访问释放算力,把AI装进口袋

算力只有在被调用时才产生价值,而本地部署的大模型常常因物理距离和交互门槛沦为“显存里的哑弹”。远程访问技术正是破解这一困局的关键:通过将运行模型的主机与手机、平板、办公电脑组成一张无缝网络,用户能随时随地将模型调用起来。本文从算力释放的底层原理出发,探讨在本地部署场景下,如何借助远程控制工具(如UU远程)降低从“人”到“GPU”的路径摩擦系数,并实操讲解模型选型、推理引擎配置、API密钥权限管理等细节。无论是把7B模型变成随身的AI助手,还是为团队搭建共享推理服务,抑或调度ComfyUI等图形生成任务,都能

weixin_33911824的博客 291

ollama 模型显存常驻OLLAMA_KEEP_ALIVE;支持并发访问OLLAMA_NUM_PARALLEL;支持同时推理多个模型

参考:https://blog.youkuaiyun.com/weixin_42357472/article/details/137666022。

weixin_42357472的博客 5759

Ollama本地模型部署实战:服务暴露、格式构建与前端接入

本地大模型部署已从单纯‘运行命令’演进为涵盖服务管理、模型格式化与API集成的系统工程。Ollama虽轻量,但其核心价值在于提供标准化的本地推理运行时——需理解其守护进程启动机制、原生模型封装原理(非直接加载GGUF),以及REST/SSE双模API协议特性。技术本质是打通‘硬件资源→Ollama服务→HTTP网关→前端调用’全链路,关键挑战包括跨进程网络暴露(突破localhost限制)、模型元数据合规性(Modelfile构建)、流式响应健壮处理(EventSource+AbortController)

weixin_32181267的博客 202

Telegram AI Bot自动化实战:5步用Make搭建业务工作台

Telegram Bot 是一种轻量级、高抵达率的消息自动化载体,其核心价值在于将结构化消息(如text、photo、callback_query)转化为可编程的事件流。基于 Bot API 的简洁设计与 Webhook 机制,开发者无需复杂鉴权即可实现毫秒级响应。结合低代码平台 Make,可快速构建具备上下文识别、条件路由、多系统分发与错误熔断能力的自动化流程。该方案特别适用于客服分发、数据同步、IoT告警等高频、规则明确、需即时反馈的业务场景,显著降低对 Python/Node.js 编程与 DevOp

weixin_33158887的博客 297

CTF命令执行绕过实战:从空格过滤到无回显外带的7种核心姿势

命令执行漏洞是Web安全中的常见高危漏洞,其核心原理在于应用程序未对用户输入进行充分过滤,导致攻击者能够注入并执行系统命令。在真实环境中,安全防护措施(如WAF、输入过滤函数)普遍存在,因此漏洞利用的关键技术在于“绕过”这些过滤机制。理解过滤器的运作逻辑(如黑名单、白名单、转义、长度限制)是成功绕过的前提。通过系统学习**空格绕过**、**命令黑名单绕过**、**编码混淆**等基础技巧,并结合**无回显外带**、**反弹Shell**等高级利用链,安全研究人员能够有效应对复杂防护场景。本文以CTFshow

weixin_29315091的博客 368

macOS上部署OpenClaw+Ollama:打造本地AI数字分身

本地部署大模型正成为AI应用的重要趋势,它兼顾数据隐私与响应速度。Ollama作为高效的本地模型运行工具,通过统一内存架构让Mac流畅运行7B级开源模型;OpenClaw则负责消息渠道接入与工具调度,二者通过OpenAI兼容接口对接,构成完整的AI助理链路。这种架构将模型推理与业务逻辑解耦,用户可自由切换Qwen、Llama等模型,同时消息数据始终留在本机。在macOS上配置微信机器人、实现7x24小时在线服务,是典型的应用场景。本文以OpenClaw和Ollama为核心,详细讲解从环境准备、配置联动到问题

weixin_33901926的博客 416

电赛备赛笔记:用STM32驱动AD9959信号发生器模块,从接线到出波保姆级教程

本文详细介绍了如何使用STM32驱动AD9959信号发生器模块,从硬件接线到软件调试的全流程。AD9959作为高性能DDS芯片,适用于电子设计竞赛中的信号生成需求。文章包含硬件连接指南、寄存器配置解析、多通道控制技巧以及常见问题解决方案,帮助参赛者快速掌握AD9959的应用。

weixin_31858171的博客 364

解决Hiring Agent常见问题:Ollama连接失败与GitHub API限制处理方案

Hiring Agent是一款强大的AI简历评估工具,能够自动解析PDF简历、提取结构化数据并利用GitHub信息进行客观评分。在使用这个智能招聘助手时,用户经常会遇到两个主要问题:**Ollama连接失败**和**GitHub API速率限制**。本文将为您提供完整的解决方案,确保您的Hiring Agent顺利运行。😊 ## 🔧 Ollama连接失败的完整排查指南 ### 问题一:Ol

gitblog_00755的博客 523

手把手教你用GNU Radio和PlutoSDR搭建FM收音机(附完整流程图)

本文提供了一份详细的实践指南,教你如何使用GNU Radio和PlutoSDR搭建一个功能完整的FM收音机。从软硬件环境准备、核心流程图构建,到运行调试与效果优化,手把手带你完成从射频信号接收、下变频、FM解调到音频输出的全过程,是入门软件定义无线电(SDR)的绝佳实践项目。

weixin_29189377的博客 748

解锁RK3588:内核模块签名与安全启动配置全攻略

RK3588作为一款高性能嵌入式SoC芯片,其内核模块签名与安全启动配置是保障系统安全的核心机制。本文详细介绍了RK3588的芯片特性,重点阐述了安全启动的硬件信任链原理和内核模块签名的实现方法。通过具体步骤演示了从密钥生成、模块签名到验证加载的完整流程,并深入解析了安全启动配置的硬件连接、软件工具准备、密钥烧录等关键环节。此外,还提出了防御旁路攻击和动态信任链扩展等高级安全策略,为RK3588在工业控制、智能安防等高安全要求场景中的应用提供了全面的安全解决方案。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 346

gpt-oss本地部署指南:Ollama+MoE架构实战

通过Ollama在Windows和Linux系统轻松部署gpt-oss-20b模型,详解硬件配置、WebUI搭建与联网搜索功能,实现本地化大模型运行与交互,适合开发者学习与轻量使用。

weixin_33773084的博客 1296

BlockUI专栏目录

BlockUI是一个设计NX对话框的工具,是官方推荐使用的对话框制作方法,能够与NX自身风格相统一,并且在实际开发中经常被使用。BlockUI可以帮助用户快速创建NX对话框,支持多种控件类型,如按钮、文本框、标签等。通过使用BlockUI,用户可以轻松地自定义对话框的布局、样式和交互行为。此外,BlockUI还提供了一些高级功能,如动态更新、条件显示和事件处理等,以帮助用户创建更加复杂和灵活的对话框。本专栏讲述了使用BlockUI制作NX对话框的方法,介绍了每个控件的功能,并且分享一些常用操作的源码。

王牌飞行员_里海的博客 1630

指定地址的一键下载ollama的脚本方法

相比于其他的ollama安装,本方法的优势是: 1.应对波动的网络环境,可以自己重复安装 2.将ollama安装到指定目录而非默认目录 3.脚本内设置好模型后,可以一键拉取。

abno_的博客 351

具身智能 | 从具身智能出发谈多传感器融合技术

多传感器融合感知是具身智能系统突破“感知—认知—行动”闭环的核心使能技术。本文从具身智能的视角出发,对多传感器融合技术进行系统综述。首先阐述了具身智能对多传感器融合提出的独特需求,包括异构感知集成、跨模态语义对齐和实时闭环决策。其次,构建了多层级融合技术分类框架,从数据层融合、特征层融合、决策层融合、时序融合到多模态大语言模型(MLLM)融合,逐层梳理主流方法与演进脉络。在此基础上,分析了面向具身智能的通用融合架构设计,涵盖了感知—推理—执行三层架构及其关键组件。

尘世冰封的专栏 310

uniapp - 鸿蒙真机运行报错hvigor ERROR: Failed :entry:default@CompileArkTS...,hvigor ERROR: default@CompileAr

uniapp鸿蒙报错> hvigor ERROR: Failed :entry:default@CompileArkTS... hvigor ERROR: default@CompileArkTS watch work[0] failed. 【HarmonyOS】工程编译后报错hvigor ERROR: Failed :entry:default@CompileArkTS,uniAPP鸿蒙开发无法编译运行启动报错,工程编译后报错,运行不起来,删除掉项目entry下的build和.preview缓存文件后重新

🏆 前端领域优质创作者 4788
上一篇: Xinferece报错:MainActorPool.append_sub_pool() got an unexpected keyword argument ‘start_method‘
虾米小馄饨
博客等级 码龄12年 1万+粉丝 60原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值